
一文搞懂 Redis 五大数据类型:把它想成一场校园运动会
文章目录
操场上正在举行校园运动会。广播站要记录当前比分,检录处要保存运动员档案,接力赛选手排着队入场,老师要统计不重复的参赛班级,主席台还得实时刷新成绩榜。
如果所有信息都只塞进一个大字符串,工作人员大概会当场辞职。好在 Redis 不只是一个“能存字符串的缓存”,它更像运动会总控台:不同的数据,交给不同的窗口处理。
很多人刚学 Redis 时,会把它理解成一个速度很快的 Map<String, String>。这个说法不能算错,但只说对了一小半。
Redis 官方给自己的定位是 data structure server——数据结构服务器。它的 Key 是二进制安全的字符串,而 Value 可以是 String、Hash、List、Set、Sorted Set 等不同结构。选对类型,很多原本要在 Java 里写几十行的逻辑,一条 Redis 命令就能原子完成;选错类型,不仅代码别扭,还可能制造大 Key、慢查询和内存浪费。
本文就把 Redis 想成一场校园运动会,用五个窗口讲透最常用的五种基础数据类型。
说明:Redis 现在远不止五种类型,还支持 Stream、Bitmap、HyperLogLog、Geo、JSON、Time Series、Vector Set 等。本文所说的“五大数据类型”,指最经典、最通用的 String、Hash、List、Set 和 Sorted Set。
一、先把运动会和 Redis 对上号
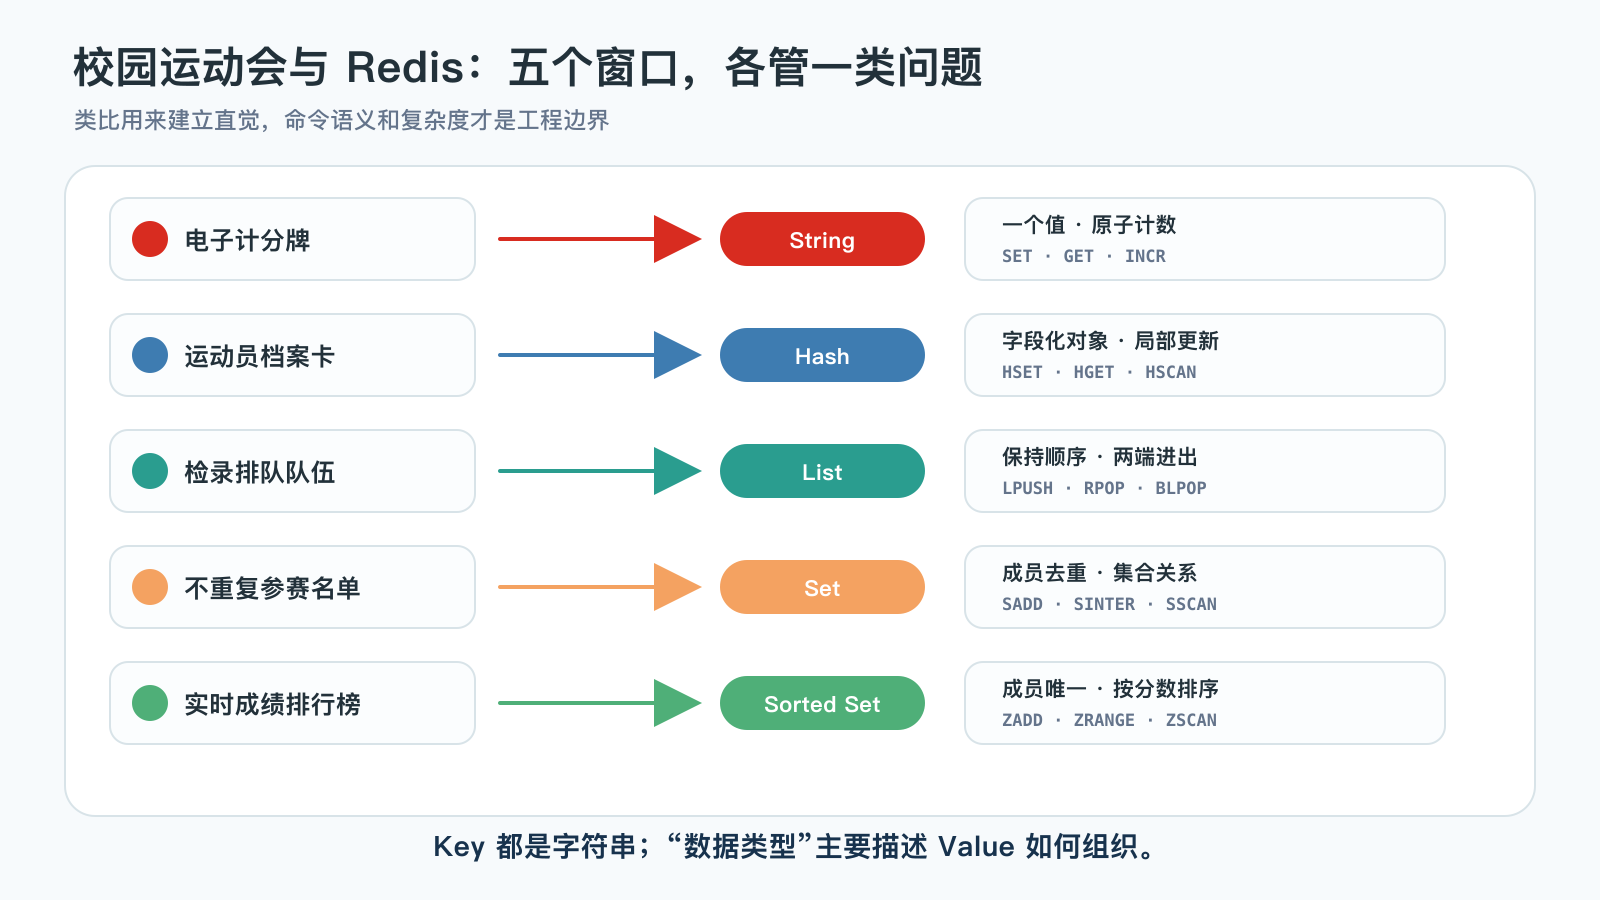
| 运动会里的东西 | Redis 类型 | 最突出的能力 |
|---|---|---|
| 电子计分牌 | String | 保存一个值、原子计数 |
| 运动员档案卡 | Hash | 按字段保存对象 |
| 检录排队队伍 | List | 保持插入顺序、两端进出 |
| 不重复参赛名单 | Set | 去重、成员判断、集合运算 |
| 实时成绩排行榜 | Sorted Set | 成员唯一、按分数排序 |
先记住一句最重要的话:
数据类型不是越高级越好,而是谁最符合业务语义,就让谁上场。
例如,存一名运动员的姓名、班级、项目时,Hash 很自然;如果硬塞成 JSON 字符串,每次只改班级都要把整个 JSON 取出来、反序列化、修改、再写回去。反过来,如果保存的是一段完整的 HTML 或图片二进制,用 Hash 拆字段就没有意义,String 更直接。
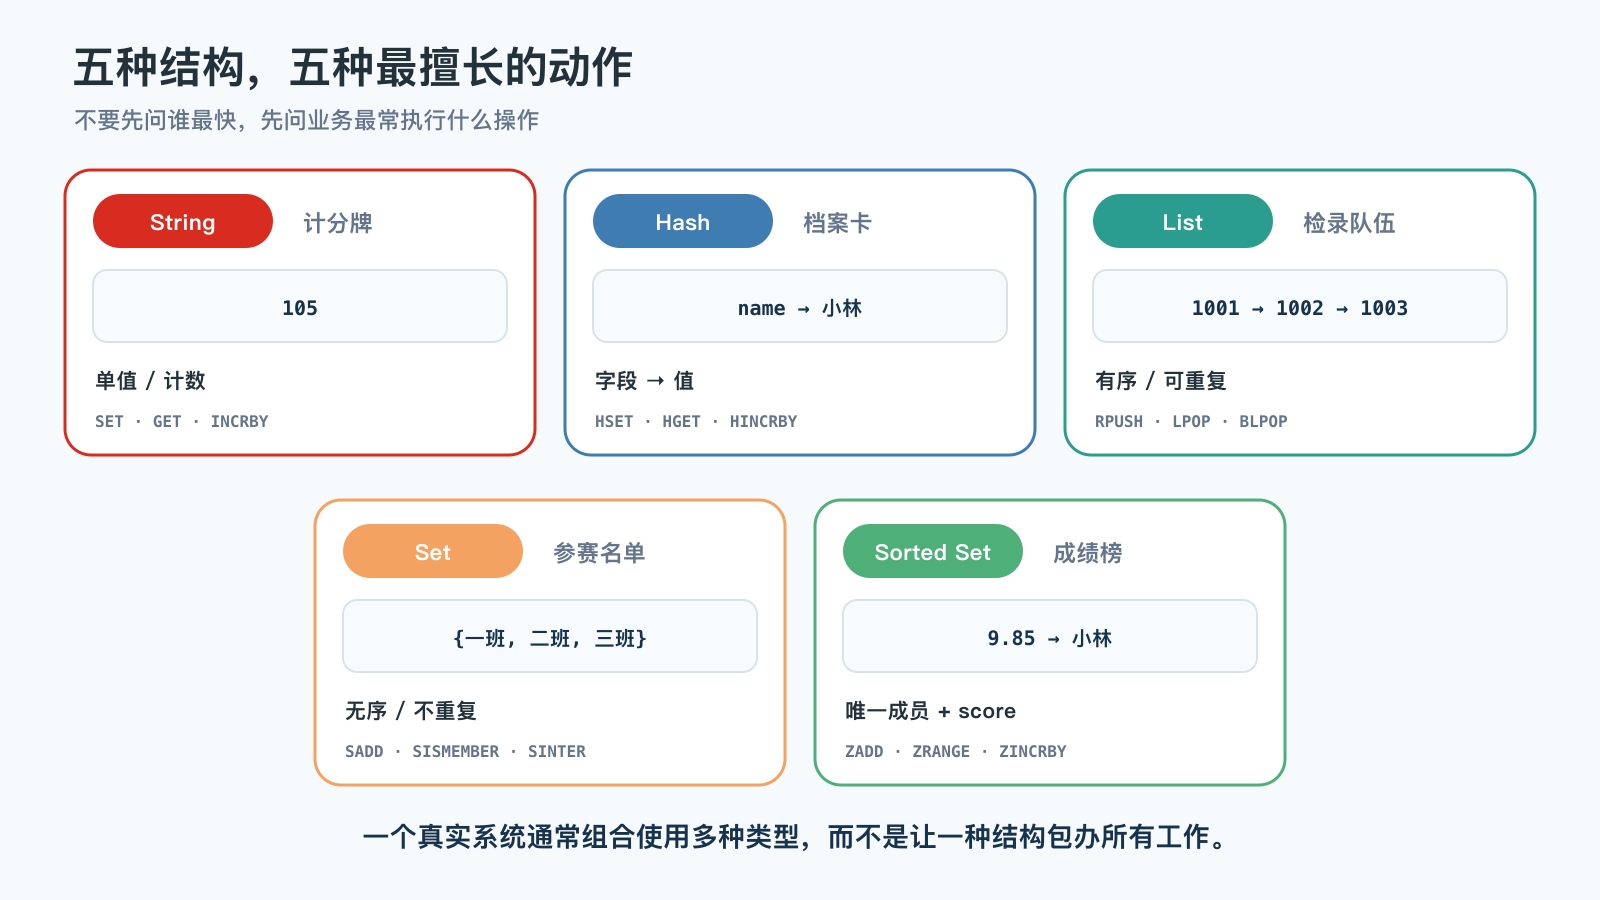
二、String:操场边的电子计分牌
2.1 String 不只是“文本”
运动会的电子屏可以显示:
- 当前总分:
105 - 广播提示:
三年二班请到检录处 - 一段 JSON
- 图片、压缩包等二进制内容
Redis String 也是这样。它是一个二进制安全的字节序列,文本、整数、浮点数字符串、序列化对象都能保存,单个 Value 最大可以达到 512 MB。
最基础的写法:
SET sports:score:class2 100
GET sports:score:class2
输出:
"100"
Redis 返回的是字符串,但如果内容可以表示为整数,Redis 可能用更节省空间的整数编码保存它。更重要的是,可以直接做原子计数:
INCRBY sports:score:class2 5
GET sports:score:class2
结果为:
"105"
这里的“原子”很关键。两个裁判同时给班级加分时,Redis 会把一条 INCRBY 命令完整执行完,再处理下一条,不会出现 Java 中 count++ 那种读、改、写互相覆盖的问题。
2.2 一条 SET,其实有很多玩法
SET 可以同时携带条件和过期时间:
# 只有 Key 不存在时才写入,并在 30 秒后过期
SET sports:ticket:1001 "valid" NX EX 30

# 只有 Key 已存在时才更新
SET sports:notice "比赛延迟十分钟" XX

# 更新内容但保留原 TTL
SET sports:notice "比赛恢复" KEEPTTL
常用选项:
| 选项 | 含义 |
|---|---|
NX | Key 不存在才成功 |
XX | Key 已存在才成功 |
EX n | n 秒后过期 |
PX n | n 毫秒后过期 |
KEEPTTL | 覆盖 Value 时保留原 TTL |
分布式锁经常使用 SET key value NX PX ...,但真正安全的锁还要考虑唯一令牌、超时和安全解锁,不能只看到 NX 就宣布“锁写完了”。
2.3 String 适合什么
- 缓存完整页面、JSON、Token;
- 点赞数、库存预扣计数、访问次数;
- 分布式序号;
- 位图和位操作的底层载体;
- 简单的幂等标记。
2.4 String 的常见坑
第一,不要把一个巨大对象无限塞进 String。Redis 虽然允许很大的 Value,但读写大对象会占用网络带宽,并延长单条命令的执行时间。
第二,MGET 很方便,却不是“免费批量”。它的复杂度是 O(N),一次取十个 Key 和一次取十万个 Key 完全不是一个概念。
第三,计数器必须真的是整数格式:
SET sports:score "一百分"
INCR sports:score
会得到:
ERR value is not an integer or out of range
电子计分牌能显示文字,不代表文字也能参加加法。
三、Hash:一张可以单独修改字段的运动员档案
3.1 为什么不把所有字段拆成多个 Key
现在要保存运动员小林的信息:
编号:1001
姓名:小林
班级:三年二班
项目:100米
积分:92
如果每个字段一个 Key:
athlete:1001:name
athlete:1001:class
athlete:1001:event
athlete:1001:score
当然能用,但 Key 数量会膨胀,管理和批量读取也不够自然。Hash 更像一张档案卡:
HSET sports:athlete:1001 \
  name "小林" \
  class "三年二班" \
  event "100米" \
  score 92
只读取一个字段:
HGET sports:athlete:1001 event
给积分加 3:
HINCRBY sports:athlete:1001 score 3
一次读取多个字段:
HMGET sports:athlete:1001 name event score
3.2 Hash 与 JSON String 怎么选
可以把 Hash 想成纸质档案卡,每个格子都能单独擦写;JSON String 更像整张档案的扫描件。
| 需求 | 更适合 |
|---|---|
| 经常单独修改某个字段 | Hash |
| 经常读取部分字段 | Hash |
| 整体写入、整体读取 | String/JSON |
| 多层嵌套结构 | RedisJSON 或序列化 String |
| 需要对数字字段原子增减 | Hash |
Hash 的 Field 和 Value 仍然是字符串,不支持原生多层嵌套。把 JSON 塞进 Hash 的某个 Field 可以存,但 Redis 并不理解 JSON 内部结构。
3.3 HGETALL 不是永远安全
档案只有五个字段时:
HGETALL sports:athlete:1001
非常方便。但如果一个 Hash 里有几十万个 Field,HGETALL 会一次返回全部内容,执行、网络传输和客户端解析都会产生压力。
大 Hash 应该增量遍历:
HSCAN sports:athlete:1001 0 MATCH "s*" COUNT 100
注意,COUNT 100 是工作量提示,不承诺每次一定返回 100 项;游标重新回到 0,才表示一轮扫描结束。
3.4 Hash 适合什么
- 用户资料、商品信息、设备状态;
- 购物车中“商品 ID → 数量”;
- 一组相关计数器;
- 需要局部更新的扁平对象。
四、List:检录处按顺序排队的运动员
4.1 从左边进,从右边出
List 保存有顺序的字符串序列,允许重复元素。可以把它想成检录处的队伍:
RPUSH sports:checkin 1001 1002 1003
LRANGE sports:checkin 0 -1
输出:
1) "1001"
2) "1002"
3) "1003"
最先来的运动员先检录:
LPOP sports:checkin
如果 LPUSH + RPOP,就是另一种方向的队列;如果同一端压入和弹出,则表现得像栈。
4.2 BLPOP:没人时别一直问,坐下等通知
普通 LPOP 在列表为空时立即返回 nil。很多初学者会在客户端写死循环:
没有任务 → 再问一次 → 还没有 → 再问一次……
这就像学生每隔一秒跑到老师面前问:“轮到我了吗?”老师和学生都很累。
阻塞弹出更自然:
BLPOP sports:relay:baton 30
如果列表为空,这条连接最多等待 30 秒;另一位裁判执行:
RPUSH sports:relay:baton "next-runner"
等待中的客户端立即收到元素。被阻塞的是这条客户端连接,不是整个 Redis,Redis 仍然可以处理其他请求。
4.3 LMOVE:从待检录队伍移动到处理中队伍
LMOVE sports:checkin sports:checking LEFT RIGHT
它可以原子地从一个 List 取出元素,再放到另一个 List。相比“先 LPOP,再 RPUSH”,中间不会出现客户端崩溃导致元素凭空消失的窗口。
不过,List 仍然没有消费组、消息确认和历史重放等完整消息能力。如果业务需要可靠消息队列,应优先评估 Redis Stream 或专业消息中间件。
4.4 List 不擅长随机访问
LINDEX key 50000 可以取第 50001 个元素,但 List 不是数组,中间位置访问通常需要遍历,复杂度可能达到 O(N)。如果业务核心需求是“按 ID 随机找到元素”,List 并不合适。
同样,下面这条命令对小队伍很好用:
LRANGE sports:checkin 0 -1
对百万级 List 就可能变成一次巨大响应。生产环境应该分页或控制范围。
五、Set:一份不会重复登记的参赛名单
5.1 同一个人登记两次,也只算一次
Set 是无序、不重复的字符串集合:
SADD sports:classes "三年一班" "三年二班" "三年二班"
SCARD sports:classes
返回:
(integer) 2
“三年二班”出现了两次,但集合里只保留一个。判断某个班是否参赛:
SISMEMBER sports:classes "三年二班"
存在返回 1,不存在返回 0。这很适合标签、去重名单、黑白名单和关注关系。
5.2 集合运算:两场比赛都参加了谁
接力赛 A 组:
SADD sports:relay:a "小林" "小周" "小陈"
接力赛 B 组:
SADD sports:relay:b "小周" "小陈" "小王"
两组共同成员:
SINTER sports:relay:a sports:relay:b
结果是“小周”和“小陈”。
其他常用运算:
| 命令 | 含义 |
|---|---|
SUNION | 并集:至少参加一组的人 |
SINTER | 交集:两组都参加的人 |
SDIFF | 差集:只在第一组的人 |
SRANDMEMBER | 随机抽取但不删除 |
SPOP | 随机取出并删除 |
抽奖系统常用 SRANDMEMBER 或 SPOP,但是否满足严格公平、审计和防作弊要求,还要结合业务规则设计,不能把“随机命令”直接等同于“完整抽奖系统”。
5.3 Set 的两个误区
第一,Set 没有稳定顺序。今天 SMEMBERS 看到的排列,不能当作明天仍然相同的契约。
第二,交并差集的成本与参与集合的大小有关。几个小集合做交集很轻松,几个超大集合在高峰期直接计算就可能成为慢命令。大规模关系计算应评估集合规模、访问频率,以及是否提前维护结果。
遍历大 Set 使用:
SSCAN sports:classes 0 MATCH "三年*" COUNT 100
而不是无条件 SMEMBERS 全量搬回客户端。
六、Sorted Set:自动按成绩排好的排行榜
6.1 成员不重复,但每个人都带一个分数
Sorted Set,常简称 ZSet。它同时拥有两个特点:
- Member 像 Set 一样唯一;
- 每个 Member 关联一个
score,Redis 按 score 排序。
100 米比赛用时越小越好:
ZADD sports:ranking:100m \
  9.85 "小林" \
  9.91 "小周" \
  10.02 "小陈"
查看前两名:
ZRANGE sports:ranking:100m 0 1 WITHSCORES
结果:
1) "小林"
2) "9.85"
3) "小周"
4) "9.91"
如果是“积分越高排名越靠前”,使用倒序:
ZRANGE sports:ranking:points 0 9 REV WITHSCORES
给某个成员加分:
ZINCRBY sports:ranking:points 5 "三年二班"
6.2 同分时谁排前面
当两个 Member 的 score 相同时,Redis 会按 Member 的字典序排列。不要偷偷假设“先写入的人一定排前面”。
如果业务需要“分数相同按完成时间先后排序”,可以设计复合分数,但要注意 Redis score 使用双精度浮点数,整数可以被精确表示的范围有限。更稳妥的方案是明确排序规则,必要时把时间放进 Member,或者让应用层做二次排序。
6.3 Sorted Set 不只做排行榜
- 延迟任务:执行时间戳作为 score;
- 优先级队列:优先级作为 score;
- 滑动窗口限流:请求时间作为 score;
- 在线玩家排序;
- 热度榜、销量榜。
例如取出已经到期的任务:
ZRANGE jobs:delay 0 1710000000000 BYSCORE LIMIT 0 100
但“查到任务再删除”不是天然原子操作。真正的延迟队列还要处理并发领取、失败重试、幂等和任务丢失。
七、为什么同一种类型,底层编码还会变化
表面上看,Key 的类型始终是 Hash 或 Set;打开仓库门后,Redis 可能使用完全不同的内部结构。
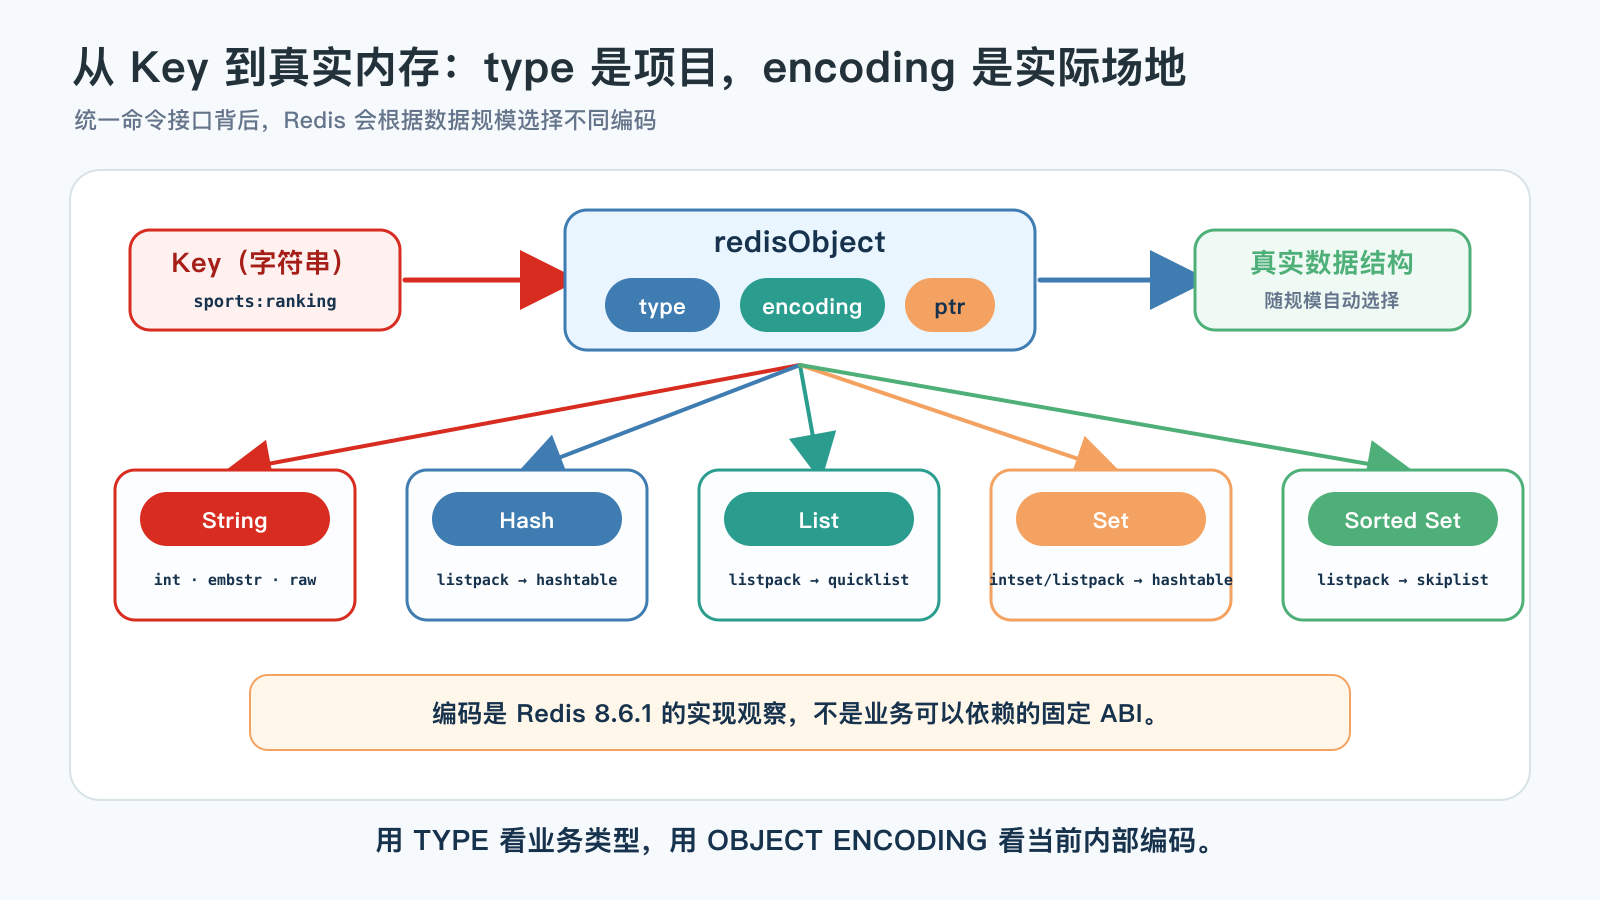
可以把 type 和 encoding 理解成:
type:运动项目,例如“100 米”;encoding:实际使用的场地,例如普通跑道还是室内短跑道。
业务看到的是统一的命令接口,Redis 会根据元素数量和大小选择更省内存或更适合扩展的实现。
查看类型:
TYPE lab:sports:ranking
查看内部编码:
OBJECT ENCODING lab:sports:ranking
7.1 Redis 8.6.1 的实测结果
本文使用独立 Redis 8.6.1 实例验证,观察到:
| 类型 | 小对象编码 | 放大后的通用编码 |
|---|---|---|
| String | int、embstr | raw |
| Hash | listpack | hashtable |
| List | listpack | quicklist |
| Set | intset 或 listpack | hashtable |
| Sorted Set | listpack | skiplist |
这张表描述的是 Redis 8.6.1 的实现观察,不是永远不变的 API 契约。例如网上很多旧图还在讲 ziplist,但 Redis 7.0 之后,许多紧凑结构已经改用 listpack;Redis 7.2 之后,小型字符串 Set 也可以使用 listpack。
7.2 String:int、embstr、raw
SET lab:sports:score 100
OBJECT ENCODING lab:sports:score
# int

SET lab:sports:slogan "GoTeam"
OBJECT ENCODING lab:sports:slogan
# embstr

SET lab:sports:notice "一段足够长的内容……"
OBJECT ENCODING lab:sports:notice
# raw
int:可以表示为 64 位有符号整数的字符串;embstr:较短、适合一次性分配的字符串;raw:更长或需要通用处理的字符串。
官方命令文档当前说明 embstr 的硬编码上限为 44 字节,但仍应把它当作实现细节,而不是业务逻辑判断条件。
7.3 聚合类型:小时紧凑,大时展开
小 Hash、Set、ZSet 使用 listpack,像把少量档案紧凑地装进一个文件夹,节省指针和对象开销。数据变多、单个成员变长后,再换成哈希表、跳表等结构。
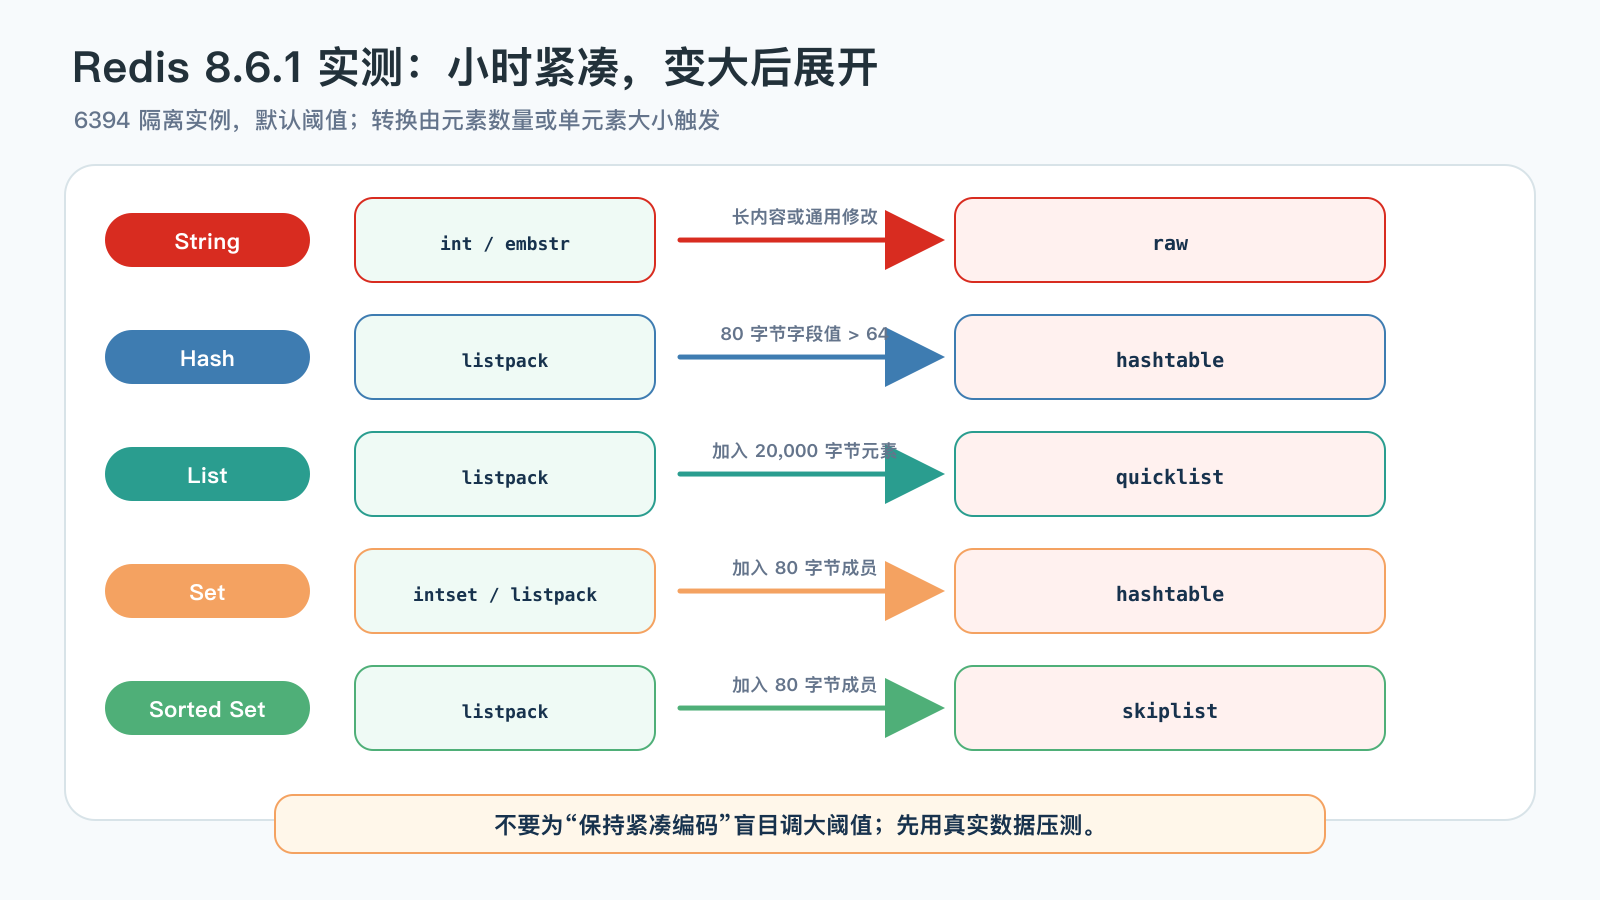
本文临时实例的默认阈值包括:
hash-max-listpack-entries 512
hash-max-listpack-value   64
set-max-intset-entries    512
set-max-listpack-entries  128
set-max-listpack-value    64
zset-max-listpack-entries 128
zset-max-listpack-value   64
例如,小 Hash 开始是 listpack:
HSET lab:sports:athlete:1001 name "小林" event "100米"
OBJECT ENCODING lab:sports:athlete:1001
# listpack
加入一个 80 字节的 Field Value 后:
HSET lab:sports:athlete:1001 bio "一个长度超过阈值的字段……"
OBJECT ENCODING lab:sports:athlete:1001
# hashtable
编码转换的目标是在内存和操作效率之间取平衡。不要为了“强行保持 listpack”随意把阈值调得很大:紧凑结构过大时,转换和遍历的成本也会变高。修改配置前必须基于真实数据做压测。
另外,很多聚合类型转为通用编码后,并不会因为删除几个元素就立刻变回紧凑编码。业务不应该依赖自动回退。
八、动手实验:在 6394 上搭一场临时运动会
我的电脑上,日常 Redis 使用 6379。为了不碰现有数据,实验额外启动了一个只监听 127.0.0.1:6394 的临时实例:
redis-server \
  --bind 127.0.0.1 \
  --port 6394 \
  --protected-mode yes \
  --daemonize yes \
  --dir /tmp/redis-data-types-lab-6394 \
  --save "" \
  --appendonly no
这不是说 Redis 默认端口变成了 6394,而是专门为实验隔离出来的第二个实例。读者也可以使用自己的测试环境,但不要在不确定用途的生产 Key 上执行实验。
连接:
redis-cli -h 127.0.0.1 -p 6394
创建五种类型:
SET lab:sports:score 100

HSET lab:sports:athlete:1001 \
  name "小林" class "三年二班" event "100米" score 92

RPUSH lab:sports:checkin 1001 1002 1003

SADD lab:sports:classes "三年一班" "三年二班" "三年三班"

ZADD lab:sports:ranking 9.85 "小林" 9.91 "小周" 10.02 "小陈"
一次查看类型:
TYPE lab:sports:score
TYPE lab:sports:athlete:1001
TYPE lab:sports:checkin
TYPE lab:sports:classes
TYPE lab:sports:ranking
输出依次为:
string
hash
list
set
zset
查看编码:
OBJECT ENCODING lab:sports:score
OBJECT ENCODING lab:sports:athlete:1001
OBJECT ENCODING lab:sports:checkin
OBJECT ENCODING lab:sports:classes
OBJECT ENCODING lab:sports:ranking
本次 Redis 8.6.1 实测的小对象结果为:
int
listpack
listpack
listpack
listpack
把数据放大后,Hash、List、Set 和 ZSet 分别观察到了:
hashtable
quicklist
hashtable
skiplist
还可以看看 Key 占用的近似内存:
MEMORY USAGE lab:sports:ranking
实验结束,停止临时实例:
redis-cli -h 127.0.0.1 -p 6394 SHUTDOWN NOSAVE
完整脚本会先检查 6394 是否被占用;若端口已有未知进程就直接退出,不会替你杀掉它。脚本也通过 Trap 保证正常结束时停止自己启动的实例。
九、五种类型怎么选:先问业务需要什么动作
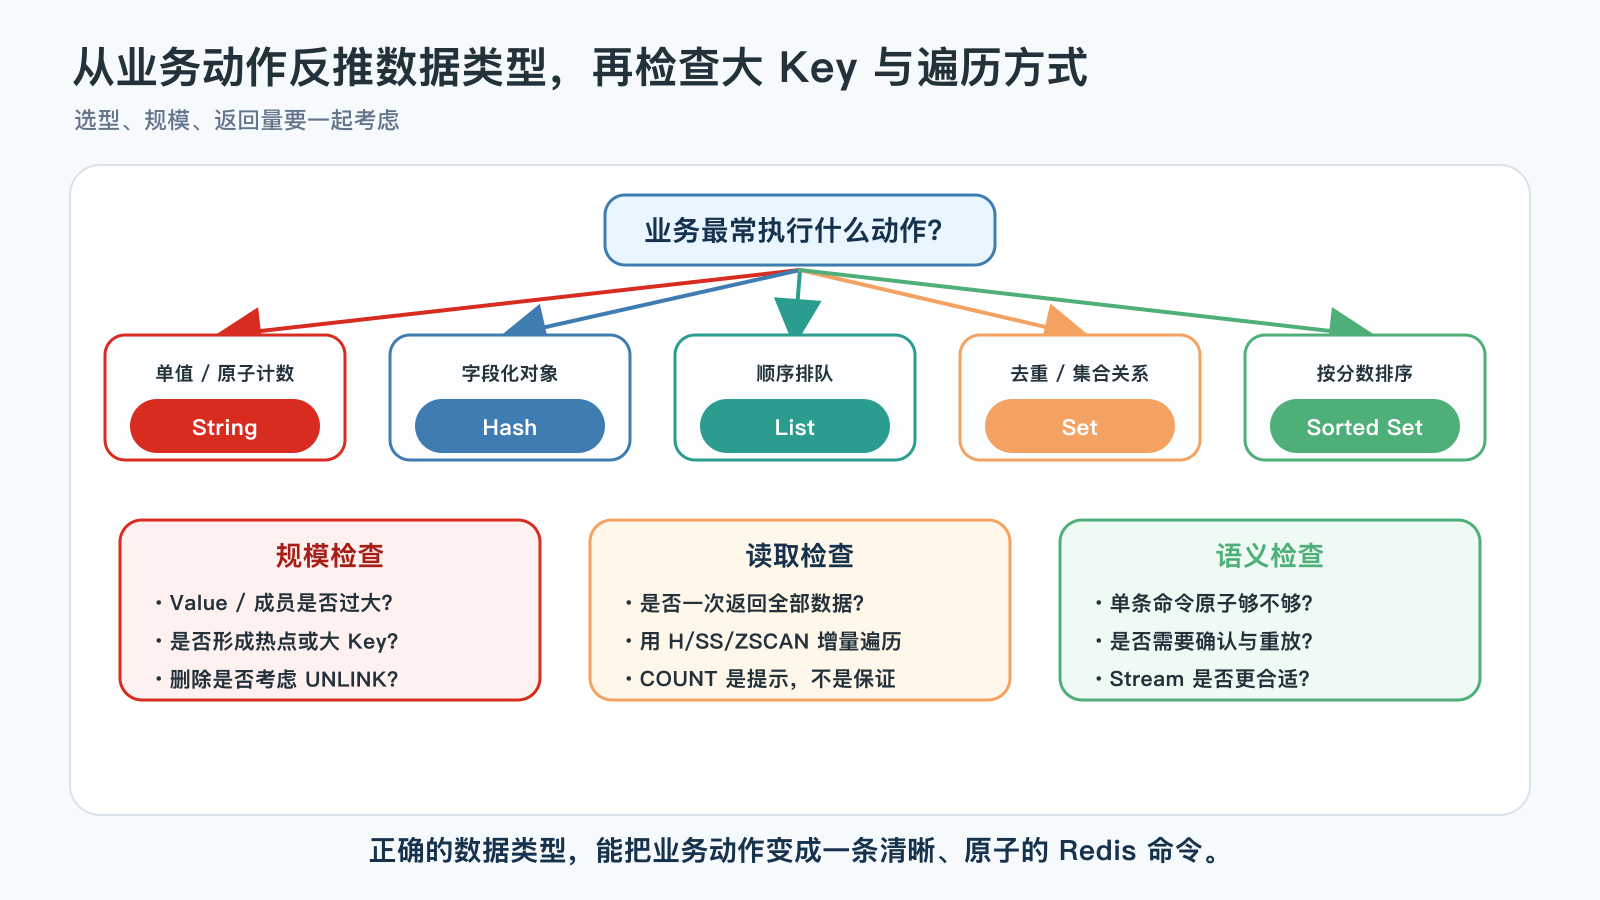
不要先问“哪种结构最快”,先问“业务最常执行的动作是什么”:
| 业务问题 | 首选类型 |
|---|---|
| 就保存一个值,或者原子增减 | String |
| 一个对象有多个可单独更新的字段 | Hash |
| 元素按加入顺序排队,两端进出 | List |
| 只关心成员是否存在,需要去重和集合关系 | Set |
| 成员唯一,并且要按分数排序 | Sorted Set |
| 需要消费组、确认和消息重放 | Stream |
| 需要深层 JSON 字段更新和检索 | RedisJSON |
几个容易选错的例子:
9.1 用 List 做“按用户 ID 查询”
List 适合顺序进出,不适合频繁在中间找某个 ID。改用 Hash:
userId -> userData
9.2 用 String 保存整个排行榜
每次分数变化都要读取、反序列化、重新排序、整体写回,还容易覆盖并发更新。Sorted Set 可以直接 ZINCRBY 和范围查询。
9.3 用 Set 保存带顺序的队伍
Set 不承诺顺序。如果必须“先来先处理”,使用 List;如果按分数或时间排序,使用 Sorted Set。
9.4 用 List 冒充可靠消息队列
简单任务分发可以用阻塞 List;需要确认、重试、消费组、消息历史时,用 Stream 或专业消息队列更合适。
十、把五种类型组合成一个运动会控制台
真实项目很少只使用一种 Redis 类型。数据结构之间不是竞争关系,而是不同岗位的工作人员。
可以为运动会设计这样一组 Key:
sports:meet:2026:status                 String,运动会状态
sports:meet:2026:score:class:2          String,二班总分
sports:meet:2026:athlete:1001           Hash,运动员档案
sports:meet:2026:checkin:100m           List,100 米检录队伍
sports:meet:2026:registered-classes     Set,已报名班级
sports:meet:2026:ranking:100m           Sorted Set,100 米成绩榜
10.1 报名
报名时,先把班级加入不重复集合,再写运动员档案:
SADD sports:meet:2026:registered-classes "三年二班"

HSET sports:meet:2026:athlete:1001 \
  name "小林" \
  class "三年二班" \
  event "100米" \
  status "registered"
这两条命令分别是原子的,但“两条命令合起来”并不会自动成为一个不可分割的事务。如果业务要求班级名单和档案必须同时成功,需要使用事务、Lua 脚本,或者设计可重试、可修复的写入流程。
10.2 检录
运动员到场后进入队列:
RPUSH sports:meet:2026:checkin:100m 1001
检录员阻塞等待下一位:
BLPOP sports:meet:2026:checkin:100m 30
完成后更新档案状态:
HSET sports:meet:2026:athlete:1001 status "checked"
如果客户端取出队列元素后崩溃,元素可能已经离开 List,但档案还没更新。对不能丢的任务,应设计处理中队列、超时补偿,或者改用带确认机制的 Stream。
10.3 比赛结束
写入成绩榜:
ZADD sports:meet:2026:ranking:100m 9.85 "1001"
给班级总分加分:
INCRBY sports:meet:2026:score:class:2 10
再修改运动员档案:
HSET sports:meet:2026:athlete:1001 status "finished" result "9.85"
这套设计中,每个 Key 都只有一个清晰职责。以后发现排行榜压力过大时,可以单独拆分排行榜;运动员档案需要持久化时,也可以明确同步到数据库。相比把整场运动会序列化成一个巨大 JSON,它更容易扩展和排查。
10.4 Key 不是越细越好
“职责清晰”不等于“每个字段一个 Key”。如果把运动员的五十个字段拆成五十个 String,会产生更多 Key 元数据、网络往返和批量管理成本。通常,生命周期一致、经常一起读取的一组扁平字段更适合放在一个 Hash 中。
反过来,也不要把全校所有运动员都塞进一个超级 Hash。那会形成大 Key,迁移、删除和全量读取都很重。常见做法是按实体 ID 拆分,或者根据访问模式适度分片。
十一、时间复杂度:O(1) 也不等于可以随便用
Redis 命令文档会标明时间复杂度,但复杂度必须结合“元素数量”和“返回数据量”理解。
| 命令 | 典型复杂度 | 容易忽略的成本 |
|---|---|---|
GET、SET | O(1) | Value 很大时,网络传输仍然很慢 |
HGET、HSET | 平均 O(1) | 单个 Hash 过大仍会影响迁移和删除 |
LPUSH、RPOP | O(1) | LRANGE 0 -1 可能一次返回全部元素 |
SISMEMBER | 平均 O(1) | SMEMBERS 是 O(N) 并返回整个集合 |
ZADD | O(log N) | 热点大 ZSet 的持续写入仍可能成为瓶颈 |
ZRANGE | O(log N + M) | M 是实际返回的成员数量 |
例如 GET huge:value 的查找是 O(1),但如果 Value 有 200 MB,Redis 仍要读取、复制并通过网络发送 200 MB。复杂度描述的是算法增长趋势,不会让字节凭空消失。
11.1 一条命令原子,不代表一段业务原子
下面每条命令单独执行都不会被其他命令插进中间:
GET sports:stock
SET sports:stock 99
但客户端先 GET 再计算、最后 SET,中间可能有其他客户端修改库存。正确做法可能是直接使用:
DECR sports:stock
如果判断和更新更复杂,可以使用 Lua 脚本或合适的事务方案。选择数据类型时,应该连同“Redis 是否有一条命令能表达这个动作”一起考虑。
11.2 少一次网络往返有时比换数据结构更重要
客户端到 Redis 的网络耗时往往高于一条简单命令本身。批量读取可以使用 MGET、HMGET,大量独立命令可以评估 Pipeline,但批量大小必须受控。一次发送十万条命令,只是把十万次小压力换成一次巨浪。
数据类型、命令粒度、批量大小和网络模型应该一起设计,而不是只盯着某个结构的理论复杂度。
十二、线上高频事故:不是命令不会写,而是边界没想清
12.1 WRONGTYPE:同一个 Key 被当成两种类型
SET sports:notice "比赛开始"
HGET sports:notice title
Redis 会返回:
WRONGTYPE Operation against a key holding the wrong kind of value
常见原因是不同业务复用了同名 Key,或者数据升级后旧 Key 没有迁移。建议统一命名:
业务:实体:标识
sports:athlete:1001
sports:ranking:100m
sports:checkin:grade3
命名前缀是管理方式,不是真正的目录;Redis 不会因为冒号自动建立层级。
12.2 KEYS:让全校停下来帮你找一张名单
KEYS sports:*
KEYS 需要遍历当前数据库的整个 Key 空间。测试库只有几十个 Key 时感觉很快,生产库有几百万 Key 时就可能长时间占用 Redis 主线程。
线上增量扫描:
SCAN 0 MATCH "sports:*" COUNT 100
客户端必须带着返回的游标继续扫描,直到游标回到 0。还要接受这些事实:
COUNT只是提示,不保证返回数量;- 扫描期间数据变化时,结果不是严格快照;
- 一轮扫描可能遇到重复元素,业务需要能容忍;
- Redis Cluster 中每个主节点有自己的 Key 空间,需要分别扫描。
12.3 大 Key:一个班级占满整座操场
大 Key 不只是“大字符串”,还包括:
- 超长 List;
- 成员极多的 Set、ZSet;
- Field 极多的 Hash。
它会带来:
- 单条命令执行时间变长;
- 网络响应和客户端内存暴涨;
- 主从同步、持久化和迁移压力;
- 删除时释放大量对象,可能阻塞。
排查时可以结合:
MEMORY USAGE key
STRLEN key
HLEN key
LLEN key
SCARD key
ZCARD key
避免对大聚合对象直接执行 HGETALL、SMEMBERS、LRANGE 0 -1;使用 HSCAN、SSCAN、ZSCAN 或分段读取。
删除确认过的大 Key 时,可以评估:
UNLINK big:key
UNLINK 会先从 Key 空间摘除,再异步回收内存,通常比同步 DEL 更适合大对象。但它仍然是删除操作,必须先确认 Key、权限和业务影响。
12.4 只看时间复杂度,不看返回数据量
某条命令即使查找部分很快,返回十万条结果仍需要编码、网络传输和客户端解析。“Redis 命令快”不等于“无限量返回也快”。
12.5 以为 Redis 会替业务保证一切
Redis 可以让单条命令原子执行,但无法自动解决:
- 跨多个命令的业务事务;
- 网络超时后“不知道命令是否成功”;
- 客户端重试造成的重复操作;
- 消息消费失败后的补偿;
- 热点 Key 打满单个节点。
数据结构是工具,业务一致性仍要自己设计。
十三、把五个窗口再放回运动会
现在总控台已经井然有序:
- 电子计分牌使用 String,
INCRBY原子加分; - 运动员档案使用 Hash,只修改需要变化的 Field;
- 检录队伍使用 List,没人时用
BLPOP等待; - 参赛名单使用 Set,天然去重并计算交集;
- 成绩榜使用 Sorted Set,分数一变,名次自动更新。
真正值得掌握的不是命令表,而是三层思考:
- 语义层:业务要的是单值、字段、队列、去重还是排序?
- 成本层:命令会扫描多少元素、返回多少数据?
- 实现层:当前版本使用什么编码,什么时候可能转换?
只会背 SET、HSET、LPUSH、SADD、ZADD,相当于认识五种体育器材;知道什么时候用、为什么用、用大了会发生什么,才算真正会组织这场运动会。
十四、快速复习
| 类型 | 一句话记忆 | 典型命令 |
|---|---|---|
| String | 一个 Key 对应一个字节序列 | SET、GET、INCRBY |
| Hash | 一个 Key 对应一张字段表 | HSET、HGET、HSCAN |
| List | 有序、可重复、两端进出 | LPUSH、RPOP、BLPOP |
| Set | 无序、不重复、能做集合运算 | SADD、SISMEMBER、SINTER |
| Sorted Set | 成员唯一,按 score 排序 | ZADD、ZRANGE、ZINCRBY |
最后送你一个选型口诀:
一个值用 String,对象字段用 Hash;
顺序排队找 List,去重关系找 Set;
需要排名和时间轴,就让 Sorted Set 上场。
参考资料
本文实验基于 Redis 8.6.1。命令语义以官方文档为准;
redisObject、listpack、quicklist、hashtable、skiplist 等内部编码可能随 Redis 版本演进,不应当作固定 ABI。
更多推荐

 17
 0
- 0


 已为社区贡献3条内容

所有评论(0)