
让大模型自己设计芯片:ChipMind如何打通数字、模拟与安全全流程
解读2025年IEEE VLSI测试研讨会特邀专场论文
论文:ChipMind: LLMs for Agile Chip Design(VTS 2025)
一颗芯片从规格书走到流片,要穿过代码编写、逻辑综合、仿真验证、测试生成等一连串环节,每一步都依赖资深工程师反复打磨。人力贵、周期长、门槛高,像三座大山一样压在半导体行业头上。大语言模型能不能把这套流程承包下来?
亚利桑那州立大学、德州大学奥斯汀分校和沙希德贝赫什提大学的研究团队给出了答案。在2025年IEEE第43届VLSI测试研讨会上,他们提出了ChipMind,一个由LLM智能体驱动的芯片设计框架,目标是把数字电路、模拟电路和硬件安全三条流程装进同一个自动化体系。论文把它定位为首个面向芯片设计全流程的LLM模块套件。
一、芯片设计这笔账,越来越算不过来
设计一颗芯片,起点往往是领域专家用自然语言描述的设计意图,终点却是精确到每个晶体管的硬件实现。从抽象意图到形式化代码之间的落差被业内称为规格鸿沟,这道翻译工作过去全靠人完成,效率低,还容易因理解偏差埋下错误。
复杂度的压力同样在加码。芯片架构越来越庞大,功耗、性能、面积三个指标互相牵制,工程师要在巨大的设计空间里反复试错,综合、验证、优化循环往复,项目周期动辄按年计算。想快速验证一个设计想法,要付出的代价越来越高。
更现实的问题是钱。为小众应用定制专用芯片,非重复性工程成本高企,潜在市场又有限,很多真实需求只能被放弃。硬件描述语言和EDA工具的陡峭学习曲线,再把一批有想法但缺乏硬件经验的从业者挡在门外。
LLM让行业看到了另一种分工方式:把意图翻译、重复试错、繁琐验证交给模型,让人专注于真正需要判断力的环节。设计想法可以在流片前批量生成、批量评估,各种折中方案先过一遍筛子再投入制造,原型验证的节奏明显加快,风险随之下降。无论是AI加速器、低功耗嵌入式处理器还是高性能计算架构,针对负载特点量身定制的优化设计,成本都有机会降到可接受的区间。硬件安全也跟着受益,模型可以自动排查漏洞、识别异常、评估风险,甚至通过预测性分析提前发现失效隐患。
二、单点工具很多,完整方案没有
用LLM辅助芯片设计并不是新鲜事。Verilog代码生成有VeriGen和CodeGen,后者生成功能正确设计的能力甚至超过了当时的商用模型。英伟达的ChipNeMo通过领域自适应预训练加监督微调,做出了面向芯片设计的聊天助手。RTLFixer把LLM智能体和检索增强生成结合起来自动修复RTL语法错误,GPT-4则在Chip-Chat项目里参与设计了一款8位微处理器。EDA脚本自动生成、设计流程自动调度,也都有ChatEDA等先行者探路。
安全问题同样进入了研究视野。有团队教LLM生成针对拒绝服务攻击和时序攻击的数字木马,有工作用LLM在Verilog代码里寻找适合插入木马的片段,还有研究者让LLM往有限状态机里植入死锁漏洞。这些看似攻击性的探索,实际是在帮防御方摸清木马的生成套路。模拟方向起步稍晚但动作不慢,把电路原理图翻译成SPICE网表、用提示词工程和少样本学习检测模拟木马、在模拟混合信号电路里尝试木马缓解,都已有人做了出来。
问题在于,这些工作各自为战,每个工具只解决流程中的一个孤立环节。代码生成不管综合,综合不管测试,数字不管模拟。论文作者直言,此前没有任何框架能把芯片设计的方方面面统一整合起来,ChipMind正是冲着这个空缺而来。
三、ChipMind:一支分工明确的智能体团队
ChipMind采用模块化、智能体化的架构,整个框架像一支分工明确的工程团队,由三大流程加一个协调者智能体组成。
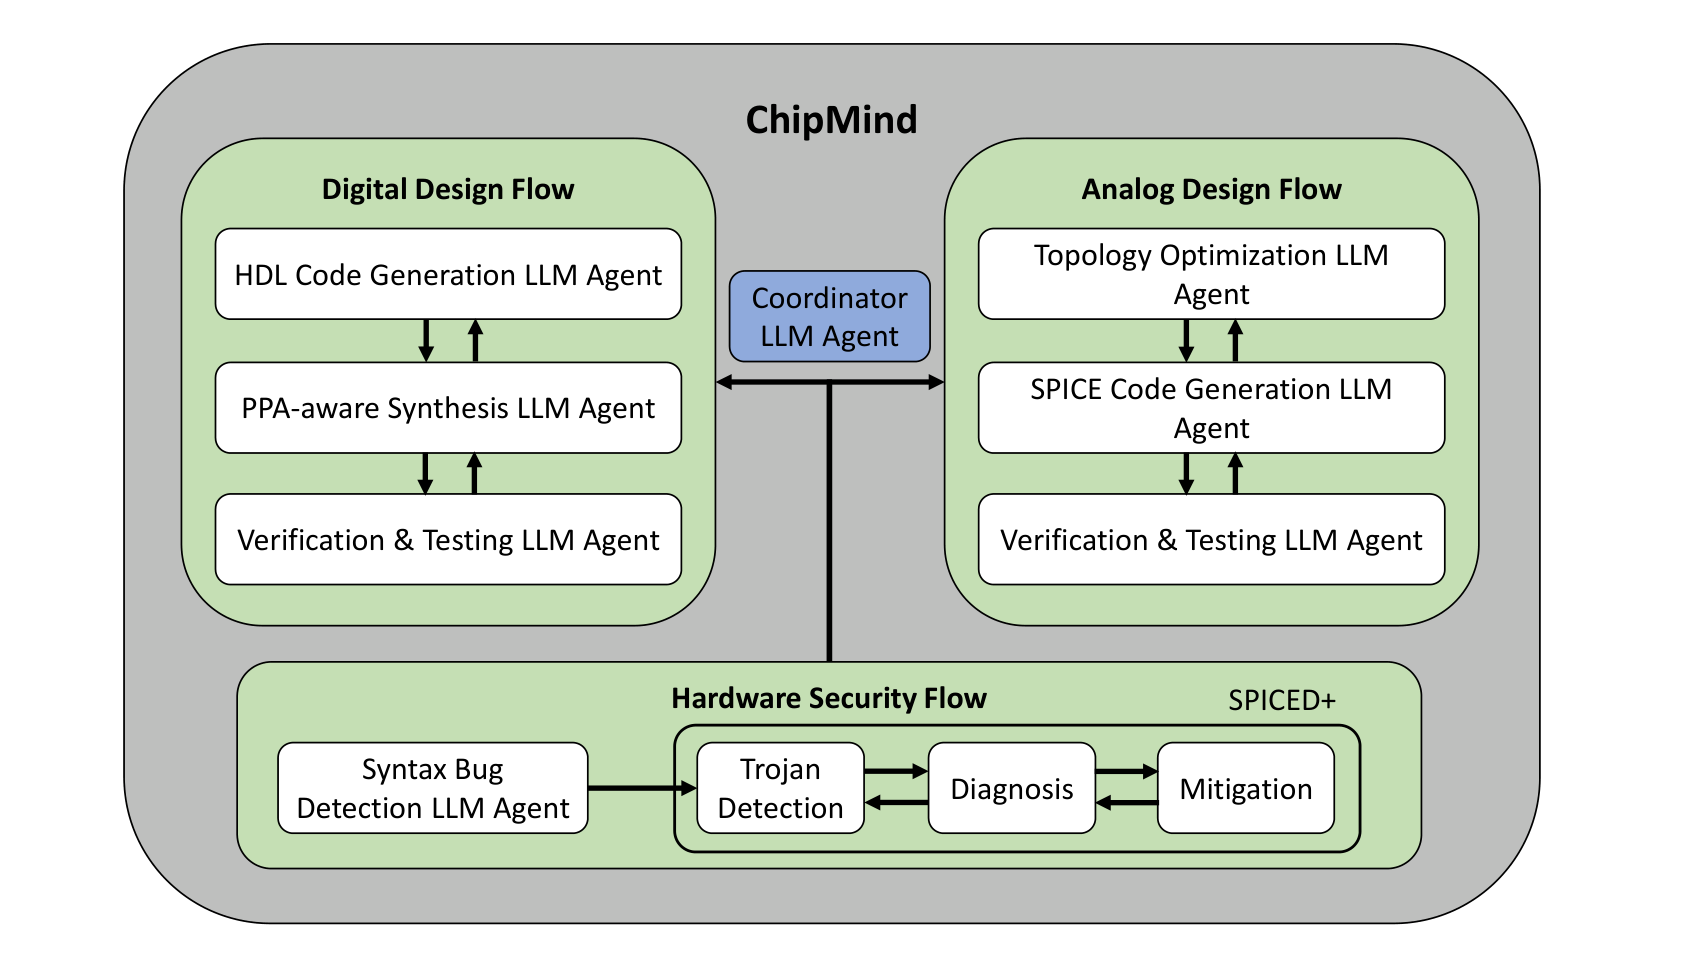
图1:ChipMind框架总览,包含数字设计流程、模拟设计流程、硬件安全流程和居中调度的协调者智能体。
图片来源:改编自原论文图1
数字设计流程配置三个智能体。HDL代码生成智能体负责把高层次规格翻译成可综合的硬件代码,PPA感知综合智能体负责生成并持续调优综合脚本,验证与测试智能体负责自动生成测试脚本并盯住故障覆盖率。
模拟设计流程同样配置三个智能体,拓扑优化智能体、SPICE代码生成智能体和验证测试智能体分别对应模拟设计从电路拓扑到仿真的完整链条。硬件安全流程围绕SPICED+工具展开,语法错误检测智能体打头阵,木马检测、诊断、修复三个环节依次衔接。
每个智能体都能独立完成任务,又遵循统一的设计原则、迭代求精策略和知识驱动的优化方式,协调者智能体居中调度,让各模块围绕共同目标协同。把流程编排交给智能体而不是写死的脚本,框架便多了一层处理意外的弹性:某个环节报错、某项指标不达标,系统能自己决定下一步动作,而不是停下来等人介入。这种结构还便于扩展,未来想接入自动布局布线或者形式化验证,往框架里插一个新模块即可。
四、数字流程:把调参经验装进闭环
数字流程的核心是论文算法1描述的迭代闭环。理解它只需记住一句话:生成、验证、执行、评估,不达标就查知识库再来一轮。
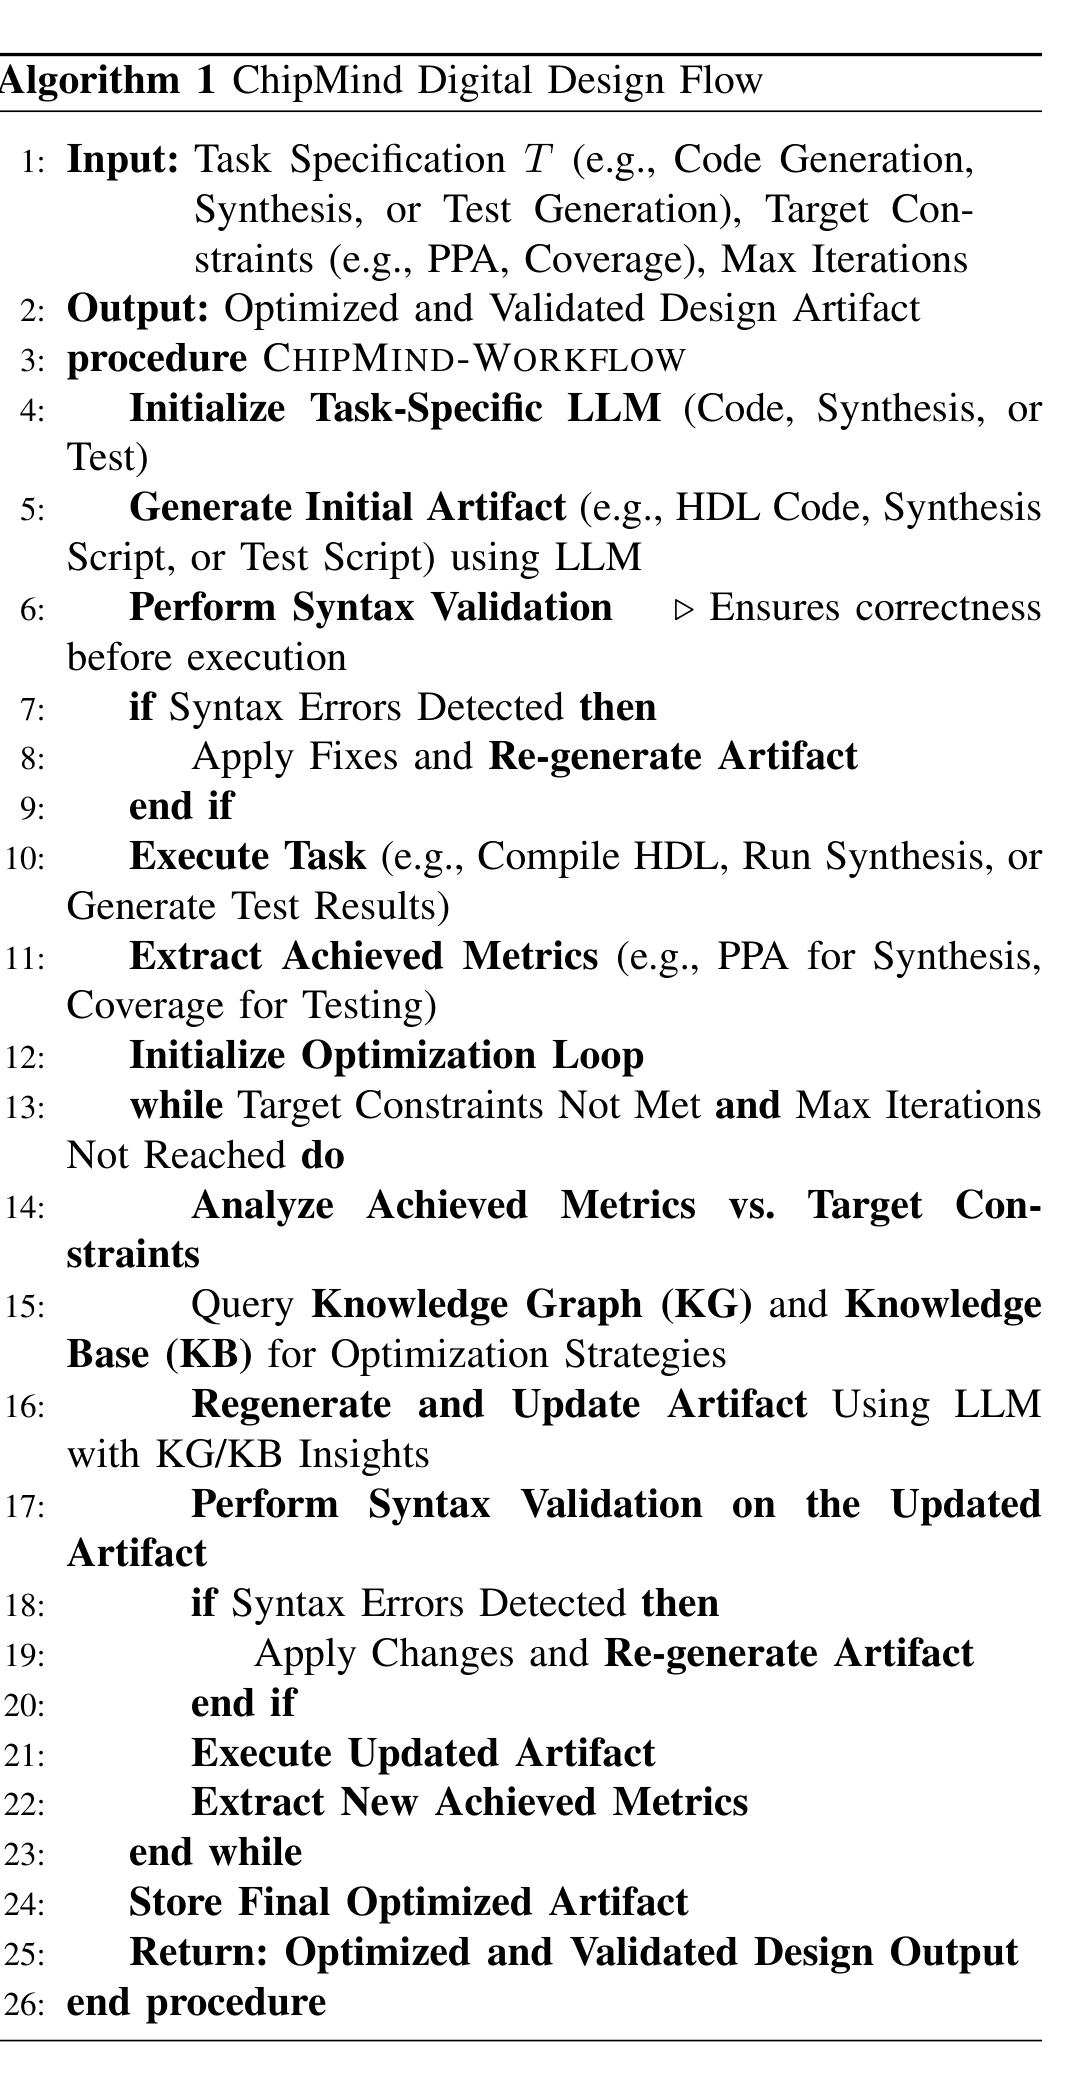 图2:ChipMind数字设计流程伪代码,语法校验与知识库查询构成迭代优化的闭环。
图片来源:改编自原论文算法1
以综合为例走一遍。用户给出模块名、输入输出信号以及可选的架构细节等高层次规格,HDL生成智能体产出代码后先做语法校验,发现错误就让模型自我修正并重新生成,直到通过为止。综合智能体随后生成综合脚本,执行后拿到时序、功耗、面积的实际数据。数据不达标时,智能体不会盲目重试,而是查询知识图谱和知识库,推导出更优的综合约束条件,更新脚本后再跑一轮。
测试生成沿用同一逻辑。芯片量产前要用自动测试向量生成技术筛掉制造缺陷,故障覆盖率就是衡量筛选彻底程度的指标。测试智能体自动生成ATPG测试脚本并执行,分析实际故障覆盖率,覆盖不足就借助知识库优化测试向量,如此迭代直至达标。整个过程中,语法校验、上下文学习和迭代验证始终在场,保证每一轮产出都是可用的。
知识图谱和知识库是这套流程的灵魂。它们把资深工程师多年积累的综合调优经验沉淀成机器可查询的结构化知识,让智能体的每轮迭代都有依据,而不是随机碰运气。闭环不停,设计质量就持续向目标指标收敛。模块化架构还给未来留好了位置,自动布局布线、形式化验证和更高级的优化技术,都被作者列进了扩展清单。
五、模拟设计:啃最硬的骨头
模拟电路设计是芯片行业最依赖老师傅经验的环节。从拓扑选择、器件尺寸到版图生成,每一步都要靠大量仿真反复确认,繁琐且难以规模化。LLM要啃的正是这块硬骨头。
ChipMind的模拟流程站在团队此前的AnalogCoder工作之上。这是一个免训练的LLM智能体,让模型直接生成PySpice代码,代码可以映射成对应的SPICE网表和电路拓扑。它的关键在于反馈增强机制:设计结果要过四级检查,失败的设计自动返回模型修正,成功的电路沉淀进电路工具库,成为后续设计复合电路时可复用的模块。研究团队还配套发布了24个模拟电路基准并完全开源,与GPT-4o、Claude 3.5、Llama 3等基线模型做了系统对比。
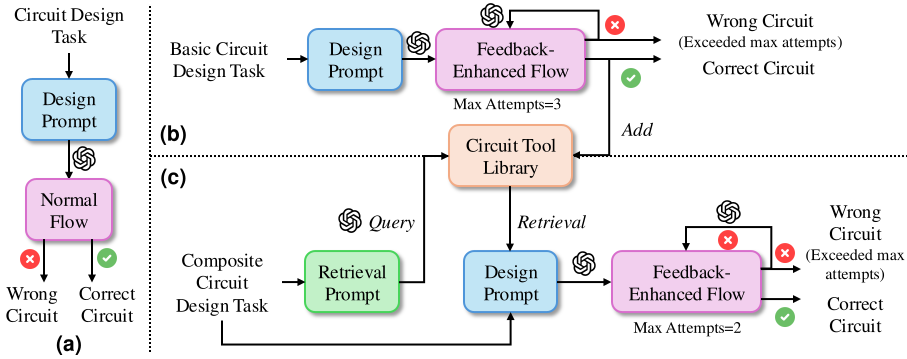
图3:AnalogCoder的反馈增强设计流程,成功电路入库复用,失败设计自动返修。
图片来源:改编自原论文图2
拓扑生成还有另一条路线。AnalogGenie从模拟集成电路教材中收集3000多种功能各异的电路拓扑,用数据增广把规模扩充70倍以上,再配合增强表达能力的图表示和定制分词器预训练GPT模型,让模型学会生成从未见过的新拓扑。
拓扑只是第一步,器件尺寸优化和版图同样绕不开。拓扑定下来之后,每个晶体管做多大,直接决定电路能不能达到指标。这条赛道上已有强化学习和数据驱动搜索的探索,ADO-LLM则把LLM的领域知识注入贝叶斯优化框架,让模型先凭经验生成一批可行的设计点,帮助搜索快速落到高价值区域。版图环节的约束比数字电路苛刻得多,对称摆放、对称走线等要求层出不穷,LayoutCopilot用分类、分析、方案求精、方案适配四个智能体协作,把自然语言指令转成可执行的版图脚本,让设计师能用对话的方式改进版图。
论文也坦率承认短板:高质量大规模的模拟设计数据依旧稀缺,拓扑生成与尺寸优化如何联合满足工业级严苛指标,仍是没有答案的开放问题。作者的长期目标很明确,打通从规格到版图的模拟设计全自动化链条,让LLM与其他优化和机器学习技术协同工作。
六、硬件安全:零成本给电路做体检
模拟电路里的硬件木马相当狡猾。它是对电路网表的恶意修改,占地面积极小,只在特定电压等模拟刺激下激活,其余时间深度休眠,传统检测手段很难抓到。LLM做这件事有独特优势:预训练阶段已经读懂SPICE语法、网表连接关系和仿真日志,注意力机制还能隐约区分正常与异常的节点行为,工程师不必再做繁琐的数据预处理。整个检测过程不需要在芯片上加任何额外硬件,面积和功耗开销都是零,这一点对成本敏感的模拟电路尤其重要。
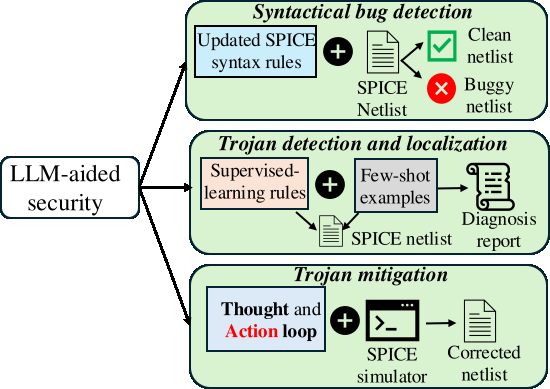
图4:LLM辅助的模拟电路安全分析流程,覆盖语法错误检测、木马检测定位与网表修复。
图片来源:改编自原论文图3
ChipMind的安全流程分三步走。第一步是语法错误检测,悬空节点、元件例化错误、缺失连接点这类问题都在射程内。GPT级别的模型虽然懂SPICE语法,却容易把正确代码误判成有bug。研究者的对策是反馈迭代:根据模型响应不断修正SPICE语法规则,再把更新后的规则写进提示词,让模型输出包含错误位置与修改建议的结构化报告。在AMSNet开源库、运算放大器和带隙滤波器等基准电路上,误报率从23.9%压到了3.8%。
第二步是木马检测与定位。研究者给LLM配上监督学习规则,再附上少量有无木马的对照网表示例,让模型学会识别三类异常:主输出电压偏移、受影响节点的电压异常波动、晶体管电流的异常激增。模型输出的诊断报告列出可疑木马行、受影响节点和完整推理过程,还给每个可疑节点打置信度分,工程师可以按分数高低安排排查顺序。最终成绩是平均84%的木马覆盖率、93.4%的真阳性率和90.3%的精确率。换成直白的说法:大部分藏起来的木马能被揪出来,抓错的情况被控制在较低水平,已经具备工程实用价值。
第三步是修复。SPICED+按预定义的Thought与Action规则迭代删除可疑木马行,每删一轮就用HSPICE重新仿真并与规格对比,确认木马清除且性能不退化。万一误删正常线路,数据管理系统可以把网表回滚到之前的状态,全程无需人工介入。测试数据显示,它平均成功移除94.6%的木马行,误伤正常线路的比例只有1.4%。
七、给AI设计AI,再造一台更快的引擎
论文后半段把视角转了180度。LLM在帮忙设计芯片,LLM自己也跑在芯片上,两者之间是一种共生关系。模型规模膨胀让传统数字加速器压力陡增,GPU吞吐高但功耗可观,FPGA靠结构压缩和数据流优化挤效率,TPU这类ASIC为矩阵运算做了深度定制,可存储墙和功耗墙依旧横在那里。光子计算和存算一体,成了两条备受期待的新路线。
光子加速器用光的传播完成矩阵乘法,速度逼近光速,延迟极低。早期的静态光子张量核把权重烧进光路,适合做固定的矩阵向量乘,可Transformer的自注意力层需要QK转置这类动态矩阵乘法,权重写死的架构就跟不上了。Lightening-Transformer用可高速重构的动态光子张量核支持全范围矩阵运算,配合多波长并行,比此前光子方案能耗降低超2.6倍、延迟降低超12倍,能量延迟积比电子加速器低两到三个数量级。TeMPO换了个思路,用时间复用和光电流聚合绕开模数转换瓶颈,做到368.6 TOPS峰值算力、22.3 TOPS/W能效和1.2 TOPS/mm²算力密度。
两条路线各有软肋。光子方案本质上是模拟计算,怕工艺偏差和热漂移,精度通常只有4到6比特,光电器件面积也远超电子存储单元。存算一体把计算直接搬进存储阵列,数据不用来回搬运,借助比特切片技术能把精度堆到8比特以上,鲁棒性也好,代价是ReRAM这类非易失存储器写入寿命有限,高精度模数转换器同样吃功耗。
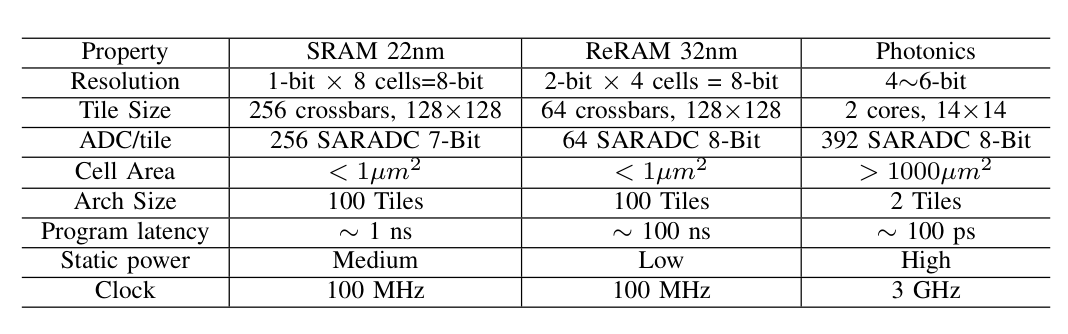
图5:SRAM、ReRAM与光子三条加速器技术路线的关键指标对比。
图片来源:改编自原论文表1
论文用一张表把三条路线的家底摆在一起。光子方案编程延迟只有约100皮秒,时钟频率跑到3GHz,代价是单元面积超过1000平方微米,静态功耗偏高。SRAM和ReRAM单元面积不到1平方微米,集成度占优,编程延迟分别是约1纳秒和约100纳秒,时钟只有100MHz。看清这组数字就不难理解混合架构的动机:没有任何单一技术能同时赢下速度、精度、功耗和灵活性四场仗。
长短互补,论文给出的答案就是异构混合。光子核心负责多头注意力这类高吞吐、对精度容忍度高的计算,存算一体核心负责权重静止、高精度要求的任务,再通过智能负载划分在三个计算层之间调度,用少量高精度存算单元补偿光子噪声带来的精度损失。在Pythia-70M和TinyStories两个语言模型上的评估显示,混合设计相比同构架构或朴素划分,能效提升2.74倍,延迟降低3.47倍。
八、愿景与现实的距离
读这篇论文需要保持一点冷静。作为研讨会特邀专场论文,ChipMind目前更接近一个整合愿景:数字流程的算法框架刚刚搭起,尚无端到端流片的实测数据;给出硬指标的模块,像AnalogCoder、SPICED+和光子加速器,均来自团队已发表的独立工作。模拟数据稀缺、拓扑与尺寸联合优化、形式化验证接入,都是作者自己列出的待办事项。把这些模块真正缝合成一个自动运转的完整系统,还有很长的路要走。
愿景的价值同样不能低估。芯片行业缺人不是新闻,培养一名合格的模拟设计师动辄以十年计。如果LLM智能体真能把门槛降下来,让只懂软件、只懂应用的工程师也能参与芯片设计,专用芯片的经济模型就会被改写,那些因为NRE成本太高而被放弃的小众需求,将重新变得值得做。这条路上每一块踏实的里程碑,都值得认真跟踪。
结语
ChipMind的价值不在某个单点工具的指标,而在于一种组织方式的转变。LLM从被动应答的辅助工具,变成主动调度设计流程的智能体;工程师的经验从口口相传的手艺,变成知识图谱里可复用的资产。AI设计芯片、芯片加速AI,这个互相成就的循环一旦转动,芯片开发的门槛、成本和节奏都会被重新定义。对从业者来说,现在或许该认真想一想:自己的工作流里,哪些环节可以先交给智能体。
芯片设计自动化的故事讲了很多年,每一代EDA工具都在把更多重复劳动交给机器。LLM智能体带来的变化在于,机器开始理解意图、调用知识、自主迭代,而不只是执行命令。ChipMind画出的这张全流程蓝图能否完全兑现,要看后续几年模块之间的缝合功夫,但方向本身已经足够清晰。
参考资料
本文部分图片改编自论文ChipMind: LLMs for Agile Chip Design原文,仅用于论文解读与学术交流。论文发表于2025年IEEE第43届VLSI测试研讨会,DOI为10.1109/VTS65138.2025.11022936。
更多推荐

 6
 0
- 0


 已为社区贡献10条内容

所有评论(0)