
深度学习中的正则化:L1、L2 正则化是什么?
主要术语中英文对照
| 中文术语 | 英文术语 | 简单说明 |
|---|---|---|
| 正则化 | regularization | 通过限制模型复杂度来改善泛化能力的一类方法 |
| L1 正则化 | L1 regularization | 使用权重绝对值之和作为惩罚项 |
| L2 正则化 | L2 regularization | 使用权重平方和作为惩罚项 |
| 损失函数 | loss function | 衡量模型预测结果与目标之间差异的函数 |
| 数据损失 | data loss | 由模型预测误差产生的损失 |
| 正则化惩罚项 | regularization penalty | 为参数复杂度增加的额外代价,也常称正则项 |
| 总损失 | total loss | 数据损失与加权正则化惩罚项之和 |
| 过拟合 | overfitting | 训练集表现很好,但在新数据上表现较差 |
| 欠拟合 | underfitting | 模型没有充分学到数据中的规律 |
| 泛化 | generalization | 模型把学到的规律应用于未见数据的能力 |
| 权重 | weight | 神经网络连接对计算结果的影响强度 |
| 超参数 | hyperparameter | 训练前人为设定、而非由模型直接学习的配置 |
| 梯度下降 | gradient descent | 沿损失减小的方向迭代更新参数的方法 |
| 学习率 | learning rate | 控制每次参数更新步幅的超参数 |
| 稀疏性 | sparsity | 参数中有较多元素为 0 或接近 0 的性质 |
| 权重衰减 | weight decay | 在参数更新时额外缩小权重的方法 |
训练分数很高,为什么换一批数据就不行了?
训练一个深度学习模型时,我们当然希望损失越来越小。但损失小,只能说明模型对已经见过的训练数据掌握得不错,并不能保证它面对新数据时仍然有效。
想象一下备考:一种学习方式是理解题型和解题规律,另一种是把练习册的答案全部背下来。后者在原题测试中可能拿满分,一旦题目换个数字或换种问法,成绩就会明显下降。
模型也会遇到同样的问题。它参数很多、表达能力很强,既能学习数据中的真实规律,也可能记住训练样本中的噪声和偶然细节。这种“训练集表现很好,新数据表现变差”的现象叫作过拟合(overfitting)。
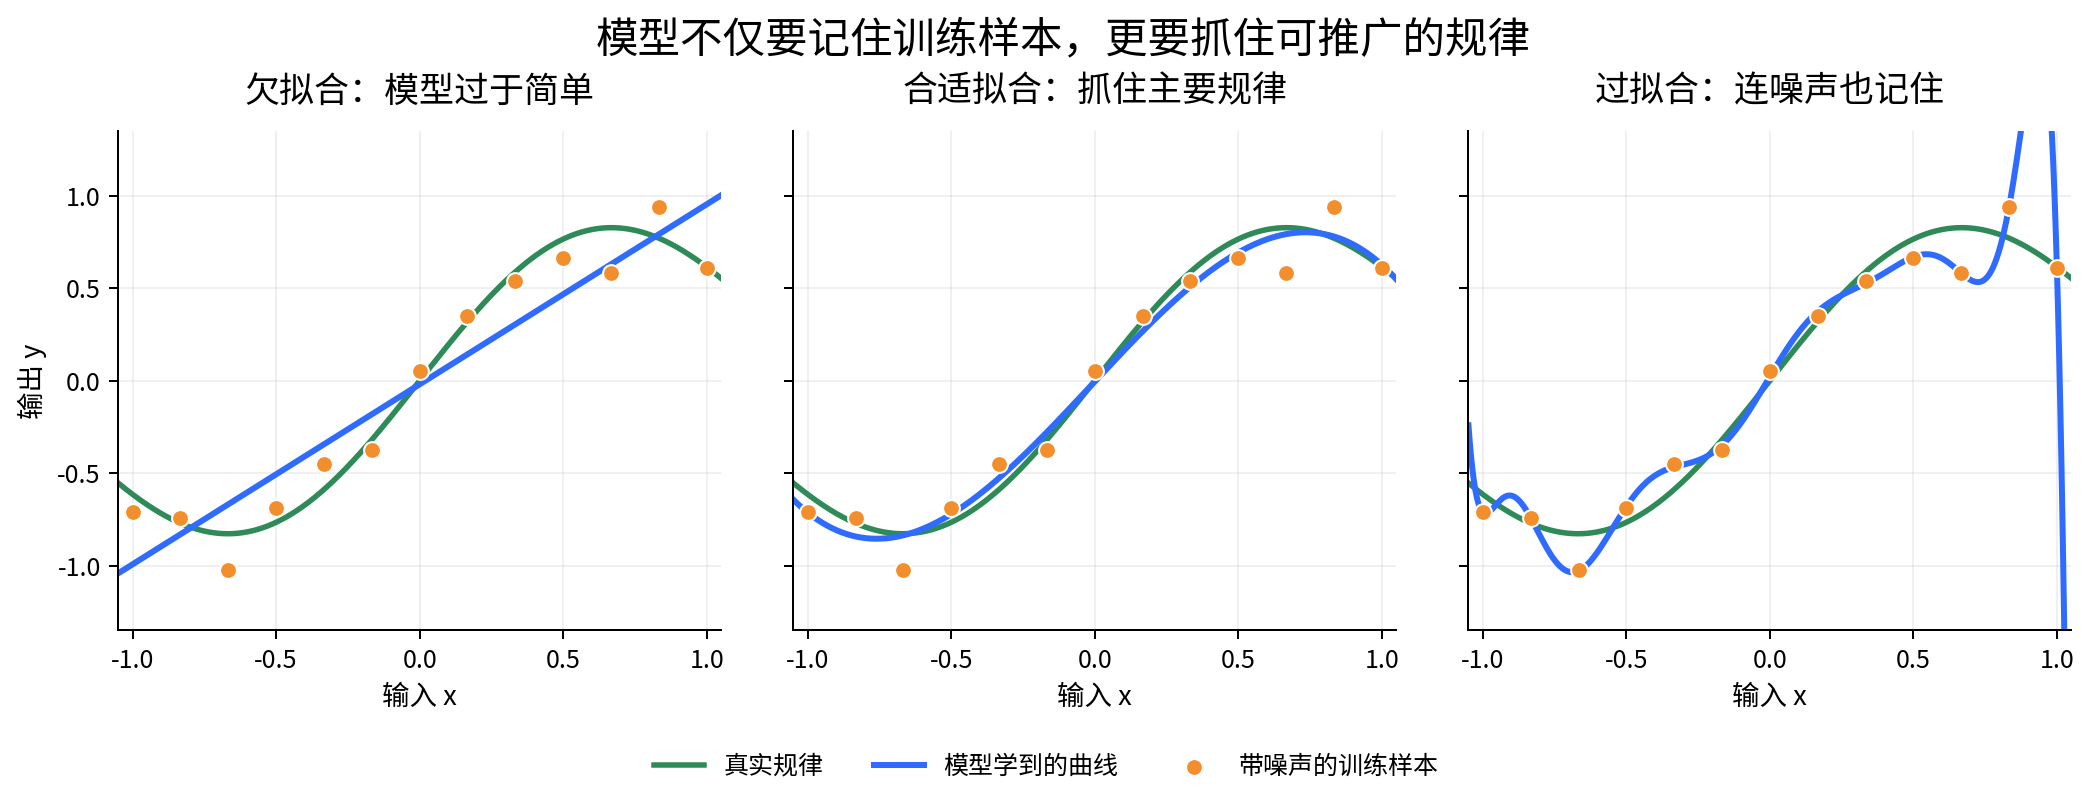
图 1 欠拟合没有学习到数据真实的变化规律,过拟合则连训练样本中的噪声也记住了。理想状态是抓住能推广到新数据的主要规律。
正则化就是缓解这个问题的一类方法。本文从最常见的 L1 和 L2 入手,看看它们究竟在损失函数里加了什么,又怎样影响每一次参数更新。
一、正则化到底是什么?
1. 先认识“泛化”
泛化(generalization),指模型把训练阶段学到的规律应用到未见过数据上的能力。验证集或测试集上的误差,可以用来估计这种能力。
《Deep Learning》第 7 章把正则化概括为:对学习算法做出某种修改,目标是减小泛化误差,而不是单纯追求更低的训练误差[1]。因此,正则化后的训练损失有时反而会高一点,但验证集表现可能更好。
2. 给“拟合数据”增加一项复杂度成本
没有正则化时,模型通常只需要最小化数据损失:
L data = 模型预测与真实答案之间的误差 L_{\text{data}}=\text{模型预测与真实答案之间的误差} Ldata=模型预测与真实答案之间的误差
加入参数正则化后,优化目标变成:
L total = L data + λ L reg L_{\text{total}} =L_{\text{data}}+\lambda L_{\text{reg}} Ltotal=Ldata+λLreg
先看符号怎样命名:字母
L
L
L 来自英文 loss(损失);下标用于说明损失的类型,
total
\text{total}
total、
data
\text{data}
data 和
reg
\text{reg}
reg 分别是 total(总计)、data(数据) 和 regularization(正则化) 的缩写或标签。因此,
L
reg
L_{\text{reg}}
Lreg 应读作“正则化损失(或正则化惩罚项)”,这里的 reg 不是 regulation。
λ
\lambda
λ 是希腊字母 lambda,用作控制正则化强度的系数。
其中:
- L data L_{\text{data}} Ldata:预测错误的代价;
- L reg L_{\text{reg}} Lreg:参数过于复杂的代价;
- λ \lambda λ:正则化强度,是一个需要调节的超参数。该超参数不是模型自己学出的权重,而是训练前由我们设定的配置。
可以把这个过程想成两股力量在“拔河”:数据损失要求模型尽量贴合训练样本,正则项则提醒模型不要为了贴合几个样本而使用过大的权重。 λ \lambda λ 越大,第二股力量越强。
正则化并不只有 L1 和 L2。数据增强、Dropout、提前停止(early stopping)等也属于常见正则化方法。本文只讨论直接约束模型参数的 L1 与 L2。
二、为什么经常要限制权重?
神经网络中的权重(weight),可以粗略理解为一条连接对最终结果的影响强度。某个权重绝对值很大时,对应输入或中间特征的微小变化,可能被后续计算明显放大。
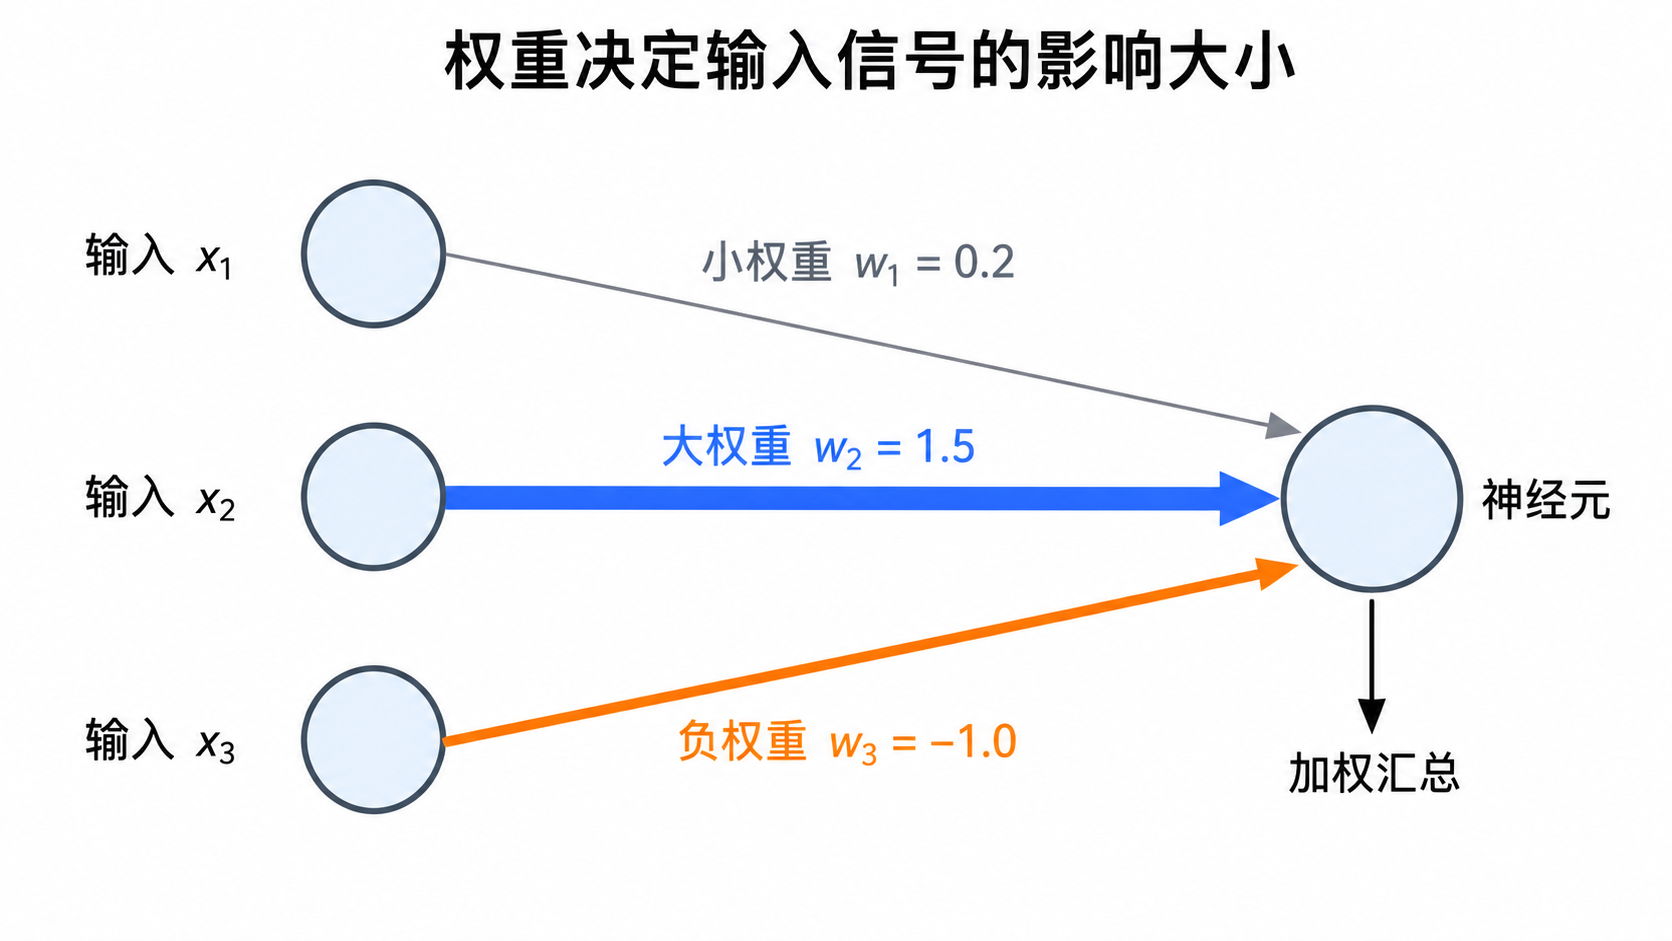
图 2 输入通过带有不同权重的连接传给神经元。连线越粗,表示权重绝对值越大;蓝色和橙色则用来区分正、负权重。
图中把真实神经网络简化成了三个输入和一个神经元。第 i i i 个输入 x i x_i xi 会先乘以对应权重 w i w_i wi,神经元再对这些结果进行加权汇总。在输入值和其他条件相同时, ∣ w i ∣ |w_i| ∣wi∣ 越大,该输入对汇总结果的影响通常越强;负权重表示它对结果的作用方向与正权重相反。
这不代表“大权重一定错误”,但在存在多组都能很好拟合训练集的参数时,偏向较小的权重通常会给模型增加一种“不要过分依赖少数信号”的倾向。模型对输入扰动往往也会更平滑。
L1 与 L2 的共同点,就是让大权重需要付出额外代价。区别在于:它们计算“代价”的方式不同。
三、L1 正则化:惩罚权重绝对值之和
1. L1 惩罚项怎样计算?
L1 正则化把所有权重的绝对值相加:
L reg L 1 = ∑ i ∣ w i ∣ L_{\text{reg}}^{L1}=\sum_i |w_i| LregL1=i∑∣wi∣
这里的 w w w 表示权重(weight),下标 i i i 表示“第 i i i 个权重”, ∑ i \sum_i ∑i 表示把所有权重对应的值相加, ∣ w i ∣ |w_i| ∣wi∣ 表示第 i i i 个权重的绝对值。 L reg L 1 L_{\text{reg}}^{L1} LregL1 中下标 reg \text{reg} reg 说明它是正则项,上标 L 1 L1 L1 用来标记正则化类型,并不是乘方。
总损失写成:
L total = L data + λ ∑ i ∣ w i ∣ L_{\text{total}} =L_{\text{data}}+\lambda\sum_i |w_i| Ltotal=Ldata+λi∑∣wi∣
假设模型只有三个权重:
w = [ 2 , − 3 , 0.5 ] w=[2,-3,0.5] w=[2,−3,0.5]
L1 惩罚为:
∣ 2 ∣ + ∣ − 3 ∣ + ∣ 0.5 ∣ = 5.5 |2|+|-3|+|0.5|=5.5 ∣2∣+∣−3∣+∣0.5∣=5.5
如果 λ = 0.01 \lambda=0.01 λ=0.01,加入总损失的正则化代价就是:
0.01 × 5.5 = 0.055 0.01\times 5.5=0.055 0.01×5.5=0.055
这里使用绝对值,所以正权重和负权重都会被计算;正则化关心的是权重有多大,而不是方向是正还是负。
2. L1 怎样影响参数更新?
先看绝对值函数的导数。在 w ≠ 0 w\ne 0 w=0 时:
∂ ∣ w ∣ ∂ w = { 1 , w > 0 − 1 , w < 0 \frac{\partial |w|}{\partial w}= \begin{cases} 1,&w>0\\ -1,&w<0 \end{cases} ∂w∂∣w∣={1,−1,w>0w<0
也可以简写为 sign ( w ) \operatorname{sign}(w) sign(w),即取权重的正负符号。因此:
∂ L total ∂ w = ∂ L data ∂ w + λ sign ( w ) \frac{\partial L_{\text{total}}}{\partial w} =\frac{\partial L_{\text{data}}}{\partial w} +\lambda\operatorname{sign}(w) ∂w∂Ltotal=∂w∂Ldata+λsign(w)
如果学习率为 η \eta η,梯度下降的更新式是:
w ← w − η ( ∂ L data ∂ w + λ sign ( w ) ) w\leftarrow w-\eta \left( \frac{\partial L_{\text{data}}}{\partial w} +\lambda\operatorname{sign}(w) \right) w←w−η(∂w∂Ldata+λsign(w))
在这个更新式中, ∂ L / ∂ w \partial L/\partial w ∂L/∂w 表示损失对权重 w w w 的偏导数,也就是参数更新所依据的梯度; η \eta η 是希腊字母 eta,通常表示学习率;箭头 ← \leftarrow ← 表示“用右侧计算结果更新左侧变量”。
暂时忽略数据损失带来的梯度:
- 正权重每次减去约 η λ \eta\lambda ηλ;
- 负权重每次增加约 η λ \eta\lambda ηλ;
- 两者都会向 0 靠近。
例如:
w = 2 , η = 0.1 , λ = 0.2 w=2,\quad \eta=0.1,\quad \lambda=0.2 w=2,η=0.1,λ=0.2
只考虑 L1 正则项时:
w new = 2 − 0.1 × 0.2 = 1.98 w_{\text{new}}=2-0.1\times0.2=1.98 wnew=2−0.1×0.2=1.98
无论当前非零权重是 2 还是 0.2,L1 正则项产生的梯度大小都约为 λ \lambda λ。这对小权重尤其“强硬”,因此 L1 会鼓励大量不重要的权重缩小到 0 附近。
3. 为什么说 L1 能产生稀疏性?
如果一个模型的大量权重为 0,称为稀疏(sparse)。某个权重为 0,意味着对应连接在当前计算中不起作用。因此,L1 常被理解为具有一定的自动筛选特征或连接的能力。Lasso 方法就是这类思想在回归问题中的经典代表[2]。
不过,“L1 一定让大量权重精确等于 0”需要加一个条件:坐标下降(轮流优化单个参数)、近端梯度(先按数据梯度更新,再做一次带阈值的收缩)等专门处理 L1 的优化方法,很容易得到严格的零;普通 SGD 或 Adam 直接对 ∣ w ∣ |w| ∣w∣ 求梯度时,通常只能保证权重被推向 0 附近,不保证它正好停在 0。深度学习中说 L1 带来稀疏性,更准确的表述是促进稀疏。
还有一个数学细节: ∣ w ∣ |w| ∣w∣ 在 w = 0 w=0 w=0 处没有唯一的普通导数。优化中通常使用 次梯度(subgradient) 处理,可以把它理解为允许从 [ − 1 , 1 ] [-1,1] [−1,1] 中选择一个合适的斜率。初学时记住“L1 在 0 处有尖角”即可。
四、L2 正则化:惩罚权重平方和
1. L2 惩罚项怎样计算?
L2 正则化把权重平方后再相加:
L reg L 2 = ∑ i w i 2 L_{\text{reg}}^{L2}=\sum_i w_i^2 LregL2=i∑wi2
这里的上标 L 2 L2 L2 仍是正则化类型标签,而 w i 2 w_i^2 wi2 表示对第 i i i 个权重求平方; ∑ i \sum_i ∑i 再把所有权重的平方相加。
为了让求导结果更简洁,推导时经常写成:
L total = L data + λ 2 ∑ i w i 2 L_{\text{total}} =L_{\text{data}}+\frac{\lambda}{2}\sum_i w_i^2 Ltotal=Ldata+2λi∑wi2
前面的 1 2 \frac{1}{2} 21 只是书写约定,可以被吸收到 λ \lambda λ 中,不改变核心思想。
仍使用前面的三个权重:
w = [ 2 , − 3 , 0.5 ] w=[2,-3,0.5] w=[2,−3,0.5]
平方和为:
2 2 + ( − 3 ) 2 + 0.5 2 = 4 + 9 + 0.25 = 13.25 2^2+(-3)^2+0.5^2=4+9+0.25=13.25 22+(−3)2+0.52=4+9+0.25=13.25
如果采用带 1 2 \frac{1}{2} 21 的定义,并令 λ = 0.01 \lambda=0.01 λ=0.01,加入总损失的代价是:
0.01 2 × 13.25 = 0.06625 \frac{0.01}{2}\times13.25=0.06625 20.01×13.25=0.06625
2. L2 怎样影响参数更新?
因为:
∂ ∂ w ( 1 2 w 2 ) = w \frac{\partial}{\partial w}\left(\frac{1}{2}w^2\right)=w ∂w∂(21w2)=w
所以总梯度为:
∂ L total ∂ w = ∂ L data ∂ w + λ w \frac{\partial L_{\text{total}}}{\partial w} =\frac{\partial L_{\text{data}}}{\partial w}+\lambda w ∂w∂Ltotal=∂w∂Ldata+λw
梯度下降更新式为:
w ← w − η ( ∂ L data ∂ w + λ w ) w\leftarrow w-\eta \left( \frac{\partial L_{\text{data}}}{\partial w}+\lambda w \right) w←w−η(∂w∂Ldata+λw)
整理后得到:
w ← ( 1 − η λ ) w − η ∂ L data ∂ w w\leftarrow (1-\eta\lambda)w -\eta\frac{\partial L_{\text{data}}}{\partial w} w←(1−ηλ)w−η∂w∂Ldata
其中 ( 1 − η λ ) w (1-\eta\lambda)w (1−ηλ)w 表示每次更新都把原权重按比例缩小一点。
仍取:
w = 2 , η = 0.1 , λ = 0.2 w=2,\quad \eta=0.1,\quad \lambda=0.2 w=2,η=0.1,λ=0.2
只考虑 L2 正则项:
w new = ( 1 − 0.1 × 0.2 ) × 2 = 1.96 w_{\text{new}}= (1-0.1\times0.2)\times2=1.96 wnew=(1−0.1×0.2)×2=1.96
L2 的收缩力度与 ∣ w ∣ |w| ∣w∣ 成正比:大权重受到的作用更强,小权重受到的作用更弱。因此,它通常让权重整体变小,却不容易把大量参数直接变成严格的 0。岭回归(ridge regression)是这一思想在线性回归中的经典应用[3],权重衰减与神经网络泛化的研究也有很长历史[4]。
五、为什么 L1 容易“清零”,L2 更像“整体收紧”?
到这里,L1 与 L2 的计算方式和参数更新过程都已经介绍完了。先把两者放在同一张图中回顾:左图比较权重变大时惩罚值怎样增长,右图比较正则项对不同大小权重产生的收缩力度。
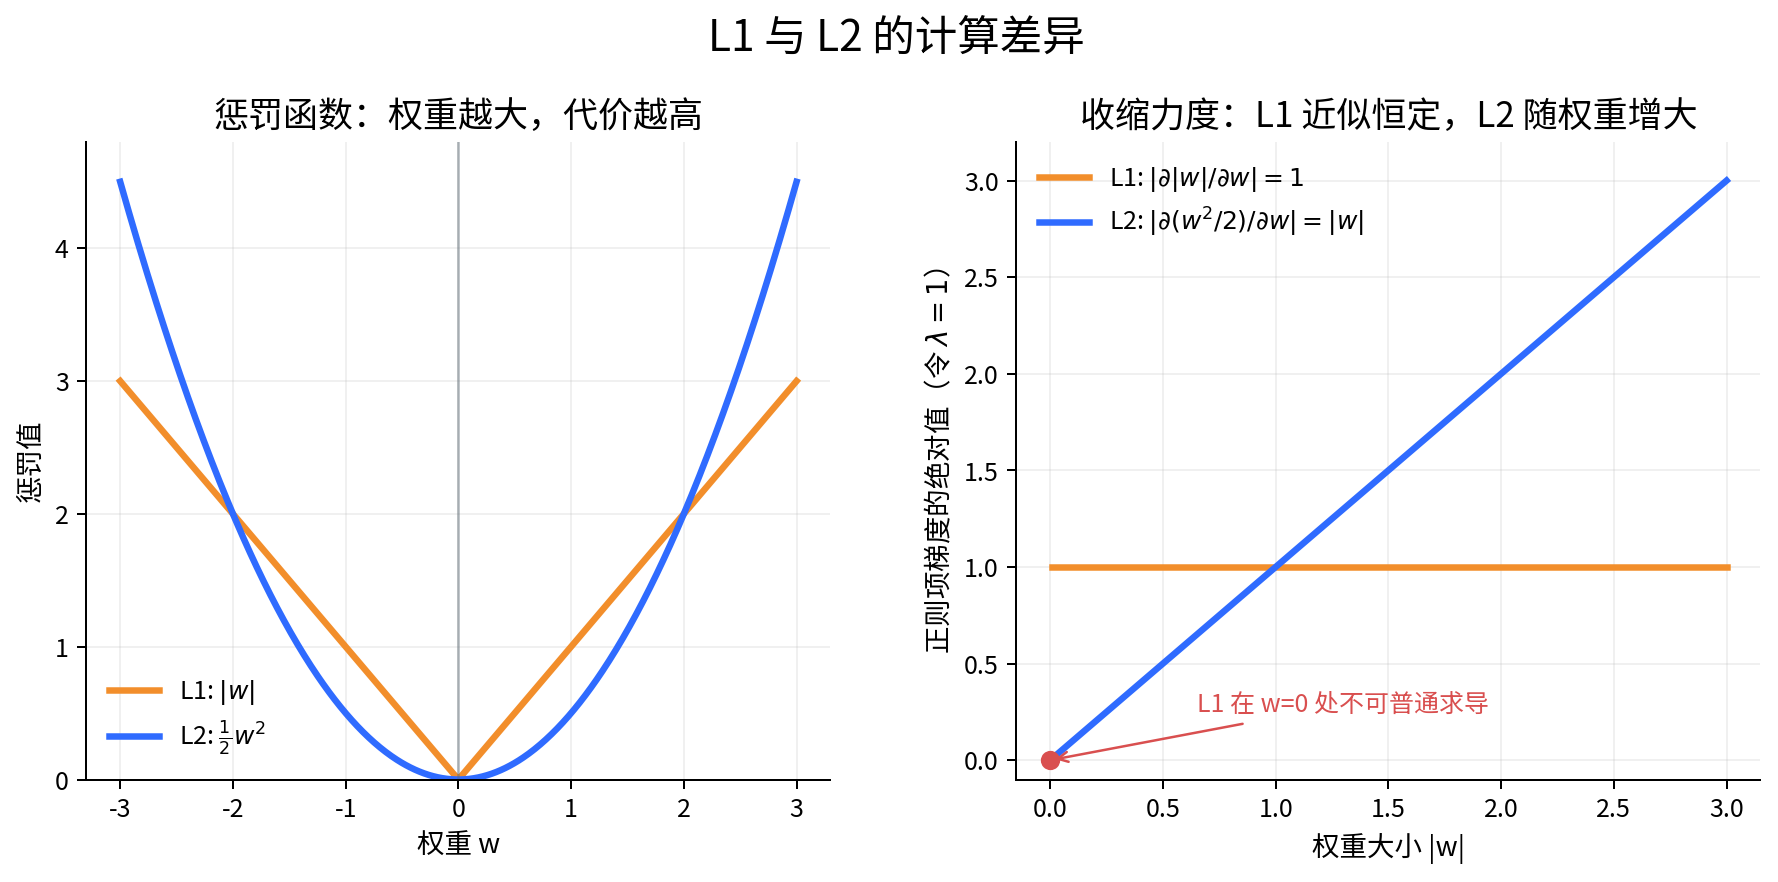
图 3 L1 的惩罚函数是 V 形,对非零权重产生近似恒定的收缩力度,因此对小权重也很“强硬”;L2 的惩罚函数是平滑的抛物线,权重越大,收缩力度越强。
图中的差异说明了两者为何会表现出不同倾向,但还没有解释 L1 为什么更容易得到精确的“零”。
如果“花钱与预算”的视角来比喻:
- 惩罚项:模型仍然可以使用大权重,但权重越大,需要在总损失中支付的“复杂度费用”越高;
- 范围约束:直接给模型一笔“权重预算”,要求它只能在预算范围内寻找预测误差最小的参数。
因此,“惩罚”的本质是在平衡“拟合数据”和“限制权重”。在许多凸优化问题中,我们需要为某个正则化强度 λ \lambda λ 选择合适的最大复杂度预算 c c c。
假设模型只有两个权重 w 1 , w 2 w_1,w_2 w1,w2,L1 和 L2 的预算可以分别写成:
L1: ∣ w 1 ∣ + ∣ w 2 ∣ ≤ c \text{L1:}\quad |w_1|+|w_2|\le c L1:∣w1∣+∣w2∣≤c
L2: w 1 2 + w 2 2 ≤ c \text{L2:}\quad w_1^2+w_2^2\le c L2:w12+w22≤c
其中, c c c 就是预算上限。每一组 ( w 1 , w 2 ) (w_1,w_2) (w1,w2) 都可以画成平面上的一个点:满足预算的点组成彩色区域,区域外的点则因为“超支”而不能选择。
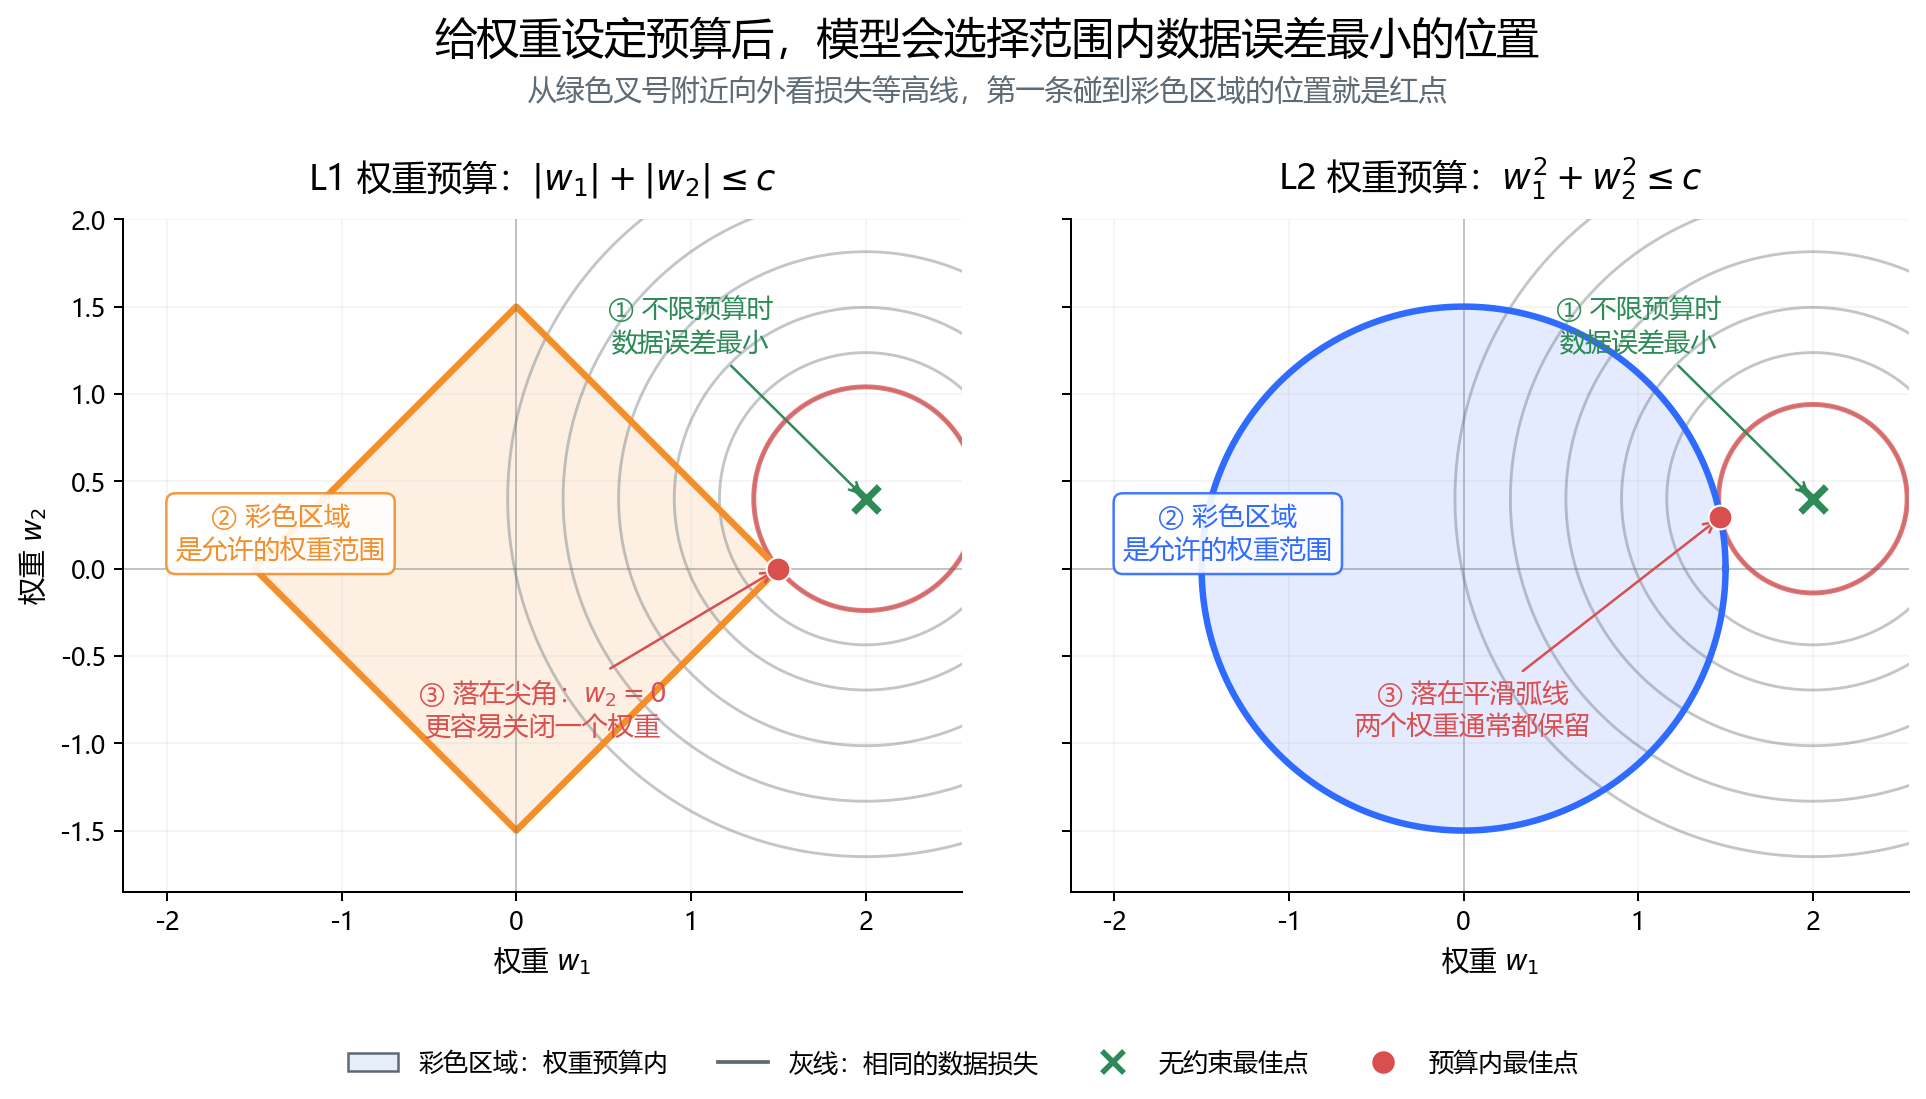
图 4 彩色区域表示允许使用的权重范围,绿色叉号表示不限制权重时数据误差最小的位置,红点表示加入预算限制后能够选择的最佳位置。
在图4中:
- 模型原本最想选择绿色叉号,因为那里只看数据损失时效果最好;
- 绿色叉号位于预算之外,所以模型必须退回彩色区域;
- 从绿色叉号附近向外扩展数据损失等高线,第一条碰到彩色区域的位置就是红点,也就是预算内的数据误差最小点。
真正造成 L1、L2 差异的是彩色区域的形状:
- L1 是菱形:尖角落在坐标轴上,红点更容易碰到尖角。点落在坐标轴上意味着某个权重正好为 0,因此 L1 更容易“关闭”不重要的权重;
- L2 是圆形:边界平滑,红点通常落在圆弧上,两个坐标往往都不是 0。因此 L2 更像是保留各个权重,同时把它们整体缩小。
需要注意,图 4 是帮助理解总体倾向的二维示意;真实深度神经网络通常有大量参数,而且损失是非凸的,实际优化过程会复杂得多。
六、把 L1 和 L2 放在一起比较
先做一个只看正则项的简单比较。假设 η λ = 0.1 \eta\lambda=0.1 ηλ=0.1:
| 原权重 | L1 更新后的示意值 | L2 更新后的示意值 |
|---|---|---|
| w = 10 w=10 w=10 | 10 − 0.1 = 9.9 10-0.1=9.9 10−0.1=9.9 | 10 × ( 1 − 0.1 ) = 9 10\times(1-0.1)=9 10×(1−0.1)=9 |
| w = 0.2 w=0.2 w=0.2 | 0.2 − 0.1 = 0.1 0.2-0.1=0.1 0.2−0.1=0.1 | 0.2 × ( 1 − 0.1 ) = 0.18 0.2\times(1-0.1)=0.18 0.2×(1−0.1)=0.18 |
可以看到:L1 对非零权重近似施加固定大小的收缩,小权重会感到压力很大;L2 按比例收缩,大权重被压得更多,小权重则变化温和。
| 对比项 | L1 正则化 | L2 正则化 |
|---|---|---|
| 惩罚项 | $\sum_i | w_i |
| 非零处的正则梯度 | λ sign ( w ) \lambda\operatorname{sign}(w) λsign(w) | λ w \lambda w λw(采用 λ ∑ w 2 / 2 \lambda\sum w^2/2 λ∑w2/2 时) |
| 收缩方式 | 对非零权重近似固定力度 | 与权重大小成正比 |
| 常见结果 | 促进稀疏,更多权重接近或等于 0 | 权重整体较小,通常仍为非零 |
| 典型用途 | 希望筛掉不重要特征或连接 | 通用的平滑约束、缓解过拟合 |
| 深度学习中的使用情况 | 有特定稀疏需求时使用 | 更常见,通常更容易稳定训练 |
应该选哪一个?
- 如果希望模型具有明显稀疏性,或者后续准备做剪枝(删除不重要的连接)、解释特征重要性,可以先尝试 L1;
- 如果主要目标是缓解过拟合、限制大权重,通常先尝试 L2 或 AdamW 的权重衰减;
- 如果两种需求同时存在,可以使用 L1+L2,也叫 **Elastic Net(弹性网络)**式正则化;
- 最终选择应由验证集结果决定,而不是只看训练损失。
七、成熟框架中如何实现?
下面只看 PyTorch 与 Keras 提供的成熟接口。
1. Keras:把正则器挂到层的权重上
Keras 内置了 L1、L2 和 L1L2。以全连接层为例,可以把正则器交给 kernel_regularizer:
from keras import Sequential, layers, regularizers

model = Sequential([
    layers.Input(shape=(100,)),
    layers.Dense(
        64,
        activation="relu",
        kernel_regularizer=regularizers.L1L2(
            l1=1e-5,
            l2=1e-4,
        ),
    ),
    layers.Dense(1),
])

model.compile(optimizer="adam", loss="mse")
kernel 就是该层的权重矩阵。训练时,Keras 会把这些正则化代价加入模型优化的总损失;也可以通过 layer.losses 或 model.losses 查看它们[7]。
这里特意没有给偏置 bias 加正则。很多项目只约束权重矩阵,不约束偏置和归一化层参数。这是一种常见工程选择。
还要留意不同资料的系数约定:本文推导 L2 时使用
λ
2
∑
w
2
\frac{\lambda}{2}\sum w^2
2λ∑w2,而 Keras 的 regularizers.L2(l2) 计算的是 l2 * sum(square(w)),没有额外的
1
2
\frac12
21。比较超参数时,先确认框架采用的定义。
2. PyTorch:把 L1/L2 加入损失
PyTorch 中,L1 和严格按本文公式定义的 L2,都可以直接用张量运算加入损失:
import torch

# 只选择二维及以上的权重矩阵,跳过偏置和常见归一化参数
regularized_params = [
    p for p in model.parameters()
    if p.requires_grad and p.ndim >= 2
]

prediction = model(features)
data_loss = criterion(prediction, targets)

lambda_l1 = 1e-5
lambda_l2 = 1e-4
l1_penalty = sum(p.abs().sum() for p in regularized_params)
l2_penalty = sum(p.square().sum() for p in regularized_params)

loss = (
    data_loss
    + lambda_l1 * l1_penalty
    + 0.5 * lambda_l2 * l2_penalty
)

optimizer.zero_grad()
loss.backward()
optimizer.step()
如果只需要其中一种正则化,把另一项删除即可。0.5 * lambda_l2 对应本文采用的
λ
2
∑
w
2
\frac{\lambda}{2}\sum w^2
2λ∑w2 写法。
如果使用 Adam 系列优化器并希望加入权重衰减(weight decay),通常使用 AdamW。权重衰减是指每次更新时直接把权重额外缩小一点;AdamW 会把这个动作与 Adam 的自适应梯度更新分开处理[5][6]:
decay_params = []
no_decay_params = []

for parameter in model.parameters():
    if not parameter.requires_grad:
        continue
    if parameter.ndim >= 2:
        decay_params.append(parameter)      # 权重矩阵
    else:
        no_decay_params.append(parameter)   # 偏置、归一化参数等

optimizer = torch.optim.AdamW(
    [
        {"params": decay_params, "weight_decay": 1e-2},
        {"params": no_decay_params, "weight_decay": 0.0},
    ],
    lr=1e-3,
)
weight_decay 的作用是让指定参数在每次优化时额外缩小。参数分组则让权重矩阵使用衰减,而偏置、归一化参数不使用衰减。
手动加入 L2 惩罚和设置 AdamW 的 weight_decay 是两种不同机制。除非实验设计明确要求同时使用,否则不要把两者叠加。
八、正则化强度 λ \lambda λ 怎么选?
λ \lambda λ 太小,约束几乎不起作用; λ \lambda λ 太大,模型可能连真正的规律也学不到,这叫作欠拟合(underfitting)。
一个实用流程是:
- 先训练一个不加或只加很弱正则的基线模型;
- 按数量级搜索几个候选值,例如 10 − 6 10^{-6} 10−6、 10 − 5 10^{-5} 10−5、 10 − 4 10^{-4} 10−4、 10 − 3 10^{-3} 10−3、 10 − 2 10^{-2} 10−2;
- 保持数据划分和其他训练条件一致;
- 同时观察训练集与验证集指标;
- 选择验证集表现较好、训练过程稳定的配置,再在附近细调。
可以用下面的现象帮助判断:
| 训练现象 | 可能原因 | 下一步 |
|---|---|---|
| 训练很好,验证明显落后 | 过拟合,正则可能偏弱 | 适当增大正则,或结合数据增强、Dropout、提前停止 |
| 训练和验证都不好 | 模型能力不足、训练不足或正则过强 | 先检查优化过程,再尝试减小正则 |
| 验证表现波动很大 | 数据量、学习率或随机性等因素影响 | 多次重复实验,不要只凭一次结果下结论 |
不同任务的损失缩放、批大小、网络结构和训练轮数都可能影响合适的 λ \lambda λ。没有一个通用答案。
九、总结
为了让模型在没见过的新数据上更可靠:
- L1 使用绝对值和,对非零权重施加近似固定力度的收缩,因此促进稀疏;
- L2 使用平方和,大权重受到更强收缩,小权重变化更温和,因此让参数整体变小;
- λ \lambda λ 决定数据拟合与参数约束之间的平衡,应该基于验证集来选择。
参考资料
[1] Ian Goodfellow, Yoshua Bengio, Aaron Courville. Deep Learning, Chapter 7: Regularization for Deep Learning. MIT Press, 2016.
[2] Robert Tibshirani. Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society: Series B, 58(1):267–288, 1996.
[3] Arthur E. Hoerl, Robert W. Kennard. Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics, 12(1):55–67, 1970.
[4] Anders Krogh, John A. Hertz. A Simple Weight Decay Can Improve Generalization. Advances in Neural Information Processing Systems 4, 1991.
[5] Ilya Loshchilov, Frank Hutter. Decoupled Weight Decay Regularization. ICLR, 2019.
[6] PyTorch Documentation. torch.optim.AdamW.
[7] Keras Documentation. Layer weight regularizers.
更多推荐



 9
 0
- 0


 已为社区贡献5条内容

所有评论(0)