
【C++】STL进阶容器set与map的介绍与使用详解
前言:前面已经接触过string、vector、list等序列式容器,它们主要按照元素所在的位置组织数据。本篇继续认识STL中的关联式容器,重点介绍有序容器set、multiset、map和multimap的特点与常用接口,并结合代码理解set的去重与排序、map的键值对存储以及operator[]的复合功能。
1.关联式容器与序列式容器
序列式容器主要按照元素的位置组织数据,例如vector中的第一个元素、第二个元素之间存在明确的先后位置;关联式容器则按照关键字以及比较规则组织数据,插入一个新元素以后,容器会自动把它放到合适的位置,而不是简单地追加到末尾。
二者可以先做一个简单对比:
| 容器类型 | 常见容器 | 组织数据的主要依据 | 查找特点 |
|---|---|---|---|
| 序列式容器 | vector、list、deque | 元素所在的位置 | 通常不提供按关键字查找接口,按值查找取决于容器和数据是否有序 |
| 有序关联式容器 | set、map、multiset、multimap | 关键字与比较规则 | 查找、插入和删除通常为O(log N) |
set和map都属于有序关联式容器,默认使用std::less进行比较,因此遍历时通常会看到关键字按升序排列。它们之间最明显的区别在于节点中保存的内容:set只保存关键字,map保存的是“关键字—映射值”组成的键值对。
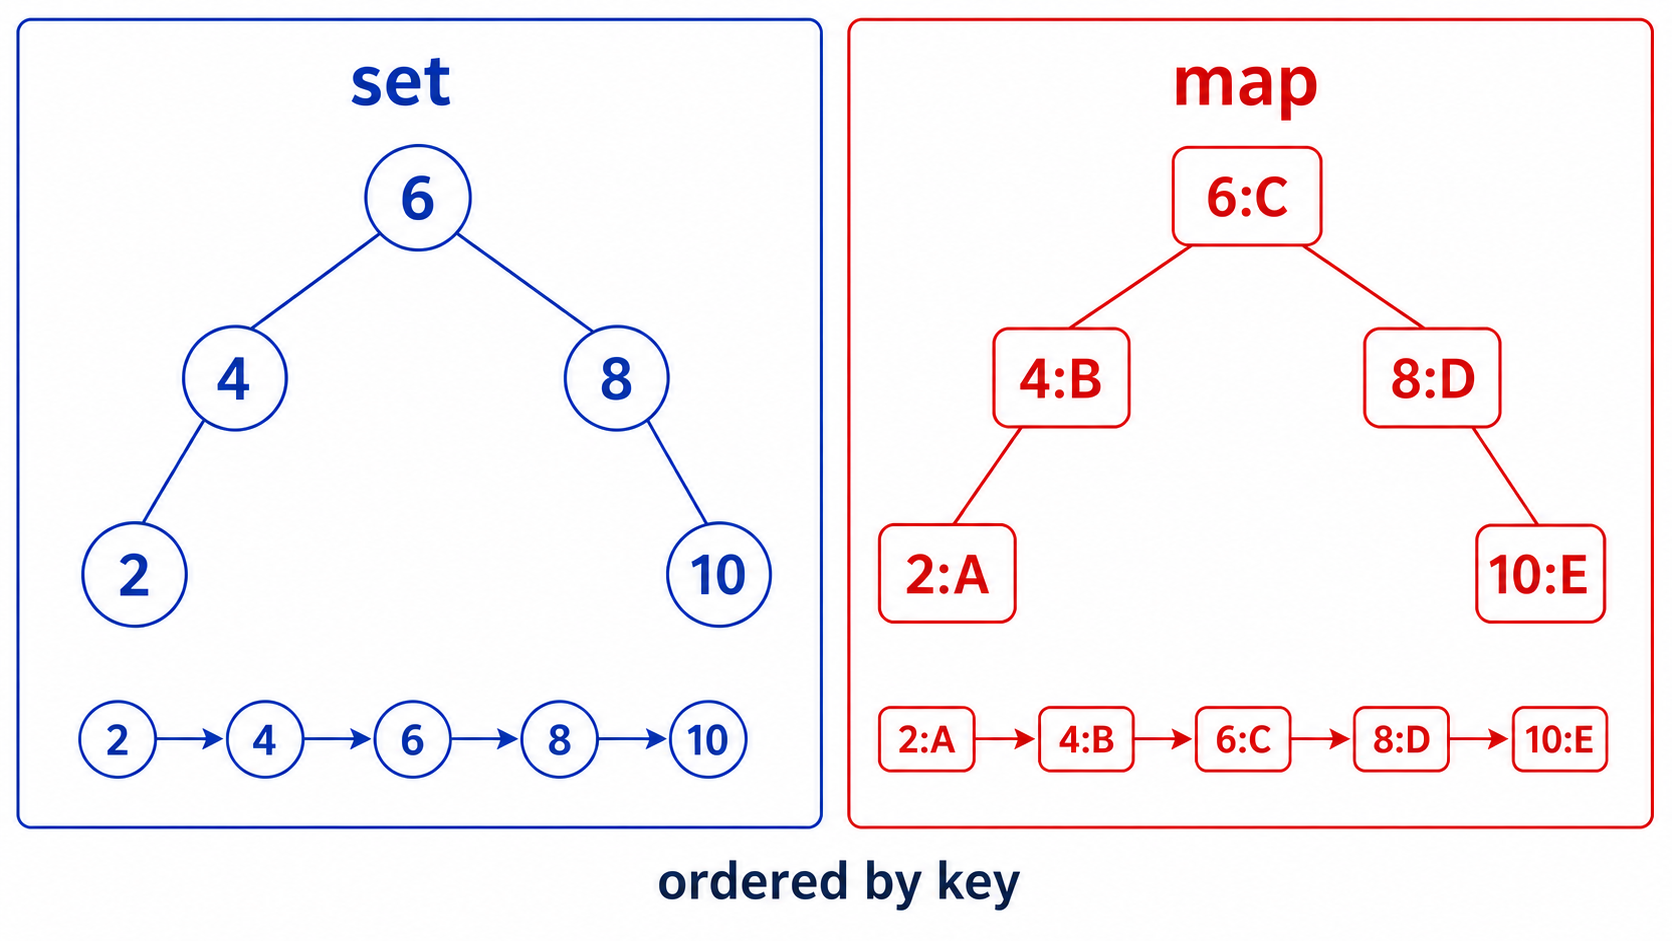
上图只用普通二叉搜索树的形式表示“按照key组织和遍历”的逻辑关系,并不表示标准库节点的真实布局。C++标准规定了这些容器的排序性质、接口和复杂度要求,但没有强制底层必须采用某一种树结构;常见标准库实现通常会使用红黑树这样的平衡搜索树。
这四个容器可以先这样区分:
| 容器 | 保存的内容 | 关键字能否重复 | 是否支持operator[] |
|---|---|---|---|
| set | key | 否 | 否 |
| multiset | key | 是 | 否 |
| map | key和value | 否 | 是 |
| multimap | key和value | 是 | 否 |
这里所说的“重复”并不是只看operator==的结果,而是由比较器定义的等价关系决定。假设比较器为comp,当comp(a, b)与comp(b, a)都为false时,容器就会把二者看成等价关键字。
2.set系列容器的使用
2.1 set的特点、构造与遍历
set可以理解成一个只保存key的有序集合。它最常见的两个特点就是:
- 插入数据以后会按照比较规则自动排序。
- 等价的关键字只保留一份,可以同时完成排序和去重。
set的模板参数中,第一个参数是元素类型,第二个参数是比较器,第三个参数是空间配置器。平时最常见的写法是std::set<int>,后两个参数直接使用默认值即可;如果希望得到降序遍历结果,可以把比较器改成std::greater<int>。
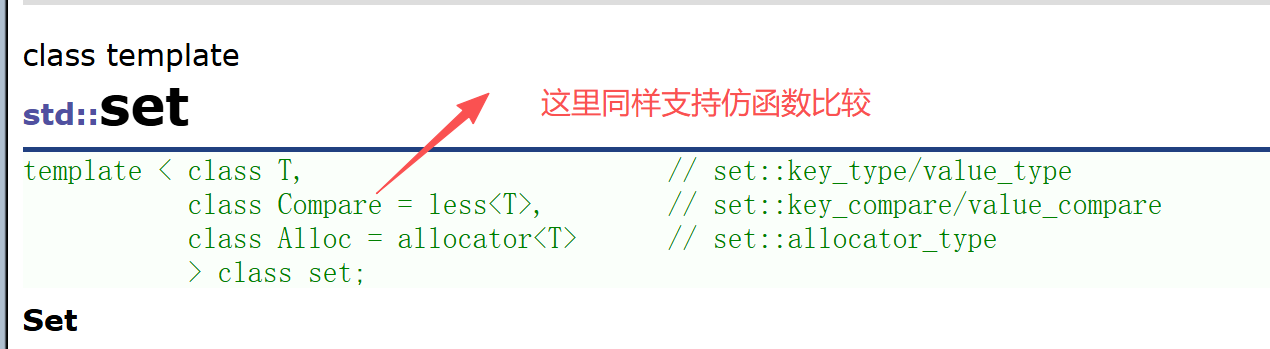
set支持默认构造、迭代器区间构造、拷贝构造和初始化列表构造。它的迭代器属于双向迭代器,可以使用++和--前后移动,也能够配合范围for遍历,但是不支持像vector迭代器那样随意进行随机跳转。
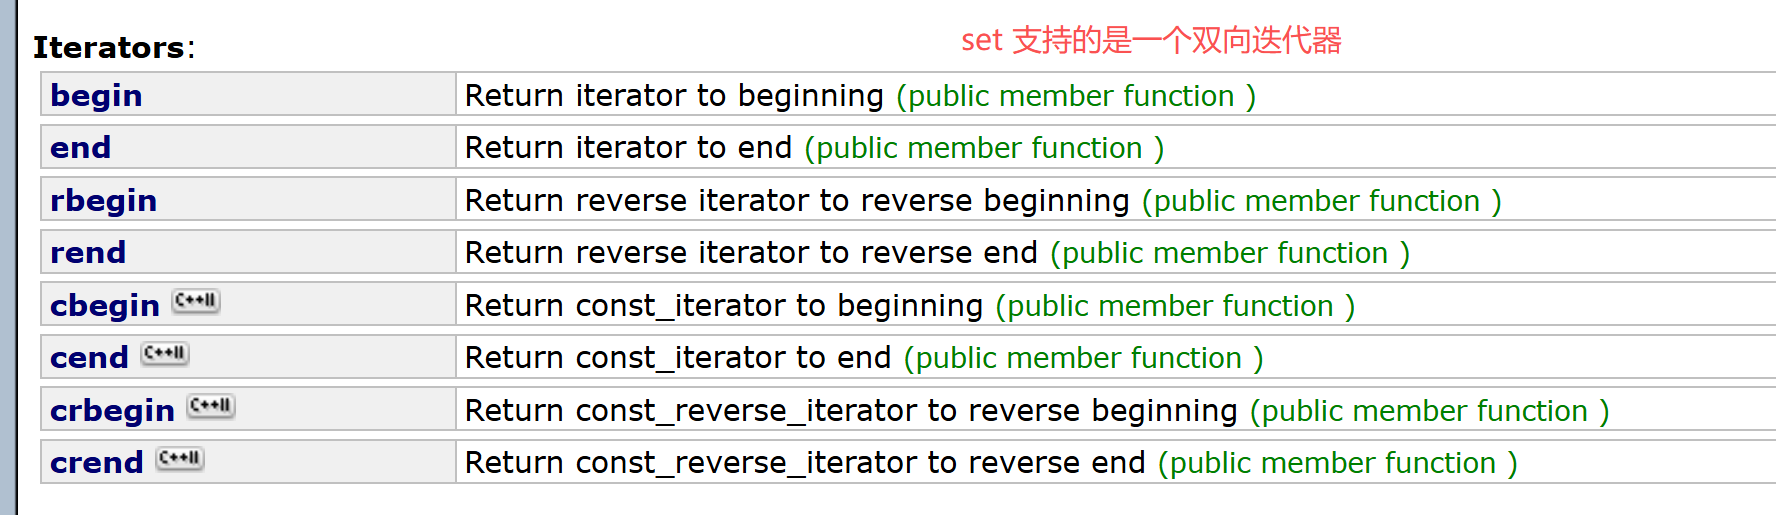
下面的代码先插入几个整数,再通过普通迭代器和范围for完成遍历。后面的示例仍然按照源文件中的Test1到Test6分段展示,使用时在main中按需调用对应函数即可:
#include <iostream>
#include <set>
#include <map>

void Test1()
{
	// 排序加去重
	std::set<int> s;
	// 可以传入仿函数,相当于改变了比较逻辑让大的走左边
	// 具体可以看我前面搜索二叉树的文章
	//std::set<int, std::greater<int>> s;
	s.insert(1);
	s.insert(4);
	s.insert(-1);
	s.insert(5);
	s.insert(5);

	// 支持迭代器
	std::set<int>::iterator it = s.begin();
	while (it != s.end())
	{
		std::cout << *it << ' ';
		++it;

		// 不支持修改迭代器,这样会破坏树的结构
		// *it = 1
	}
	std::cout << std::endl;


	// C++11 支持的写法,相当于是去调用 initializer_list
	s.insert({ 2,8,3,9,2 });
	for (auto e : s)
	{
		std::cout << e << " ";
	}
	std::cout << std::endl;

}
第一次遍历时,虽然数据并不是按照大小顺序插入的,而且5插入了两次,最终结果仍然会自动排序并去重:
-1 1 4 5
继续插入初始化列表以后,列表中重复出现的2同样只会保留一份:
-1 1 2 3 4 5 8 9
这里需要注意的是,不能通过set的迭代器修改元素。set中的元素本身就是决定节点位置的关键字,如果允许直接把某个值改成其他值,原有的有序关系就可能被破坏。因此即使写的是iterator而不是const_iterator,解引用以后得到的元素也不能被修改。
2.2 set的增删查与区间接口
set的接口和前面接触过的STL容器有不少相似之处,不需要把所有接口逐个记忆,先掌握下面这些常用操作即可:
| 接口 | 作用 |
|---|---|
insert(value) | 插入一个值,单元素版本会返回pair<iterator, bool> |
find(value) | 查找关键字,找到返回对应迭代器,否则返回end() |
count(value) | 返回等价关键字的数量;对set而言只能是0或1 |
erase(pos) | 删除迭代器所指元素 |
erase(value) | 按值删除,并返回实际删除的元素数量 |
erase(first, last) | 删除左闭右开区间[first, last)中的元素 |
lower_bound(value) | 默认比较规则下,返回第一个不小于value的位置 |
upper_bound(value) | 默认比较规则下,返回第一个大于value的位置 |
单元素insert返回值中的first是一个迭代器,它会指向新插入的元素,或者指向容器中已经存在的等价元素;second表示是否真的完成了新元素插入。对于不允许重复关键字的set来说,这个返回值可以同时完成“插入、查找、判断是否插入成功”三件事。
下面的代码演示了按照迭代器删除、按照值删除以及使用count判断元素是否存在:
void Test2()
{
	std::set<int> s = { 4,2,7,2,8,5,9 };
	for (auto e : s)
	{
		std::cout << e << " ";
	}
	std::cout << std::endl;

	// 删除最小值
	s.erase(s.begin());
	for (auto e : s)
	{
		std::cout << e << " ";
	}
	std::cout << std::endl;


	int x;
	std::cin >> x;
	size_t num = s.erase(x);
	// 返回的是一个无符号整形, 返回的是删除了几个 x
	// 这里之所以显得奇怪是因为为了和 multise_set 做对称
	if (num == 0)
	{
		std::cout << x << "->不存在" << std::endl;
	}
	else
	{
		std::cout << "删除成功" << std::endl;
	}


	// 可以利用 count 间接实现快速查找
	std::cin >> x;
	if (s.count(x))
	{
		std::cout << x << "在" << std::endl;
	}
	else
	{
		std::cout << x << "不存在" << std::endl;
	}
}
初始化列表中的2虽然出现了两次,容器中仍然只有一个2。erase(s.begin())会删除当前最小值,按值调用erase(x)时,返回值就是实际删除的数量,所以set中的结果只可能是0或1。count同样只会得到0或1,因此可以间接判断某个值是否存在。
如果想删除一段连续的关键字,可以把lower_bound和upper_bound组合起来:
void Test3()
{
	std::set<int> myset;
	for (int i = 1; i < 10; i++)
		myset.insert(i);

	for (auto e : myset)
	{
		std::cout << e << " ";
	}
	std::cout << std::endl;

	auto itlow = myset.lower_bound(3);
	auto itup = myset.upper_bound(5);
	// 删除 3 ~ 5
	//
	// 删除这段区间的值
	myset.erase(itlow, itup);
	for (auto e : myset)
	{
		std::cout << e << " ";
	}
	std::cout << std::endl;
}
默认比较规则下,lower_bound(3)会找到第一个不小于3的位置,upper_bound(5)会找到第一个大于5的位置,因此二者组成的左闭右开区间正好覆盖3、4、5。删除以后会得到:
1 2 6 7 8 9
如果更换了比较器,就应该按照新的比较规则理解lower_bound与upper_bound,不能再简单地把它们固定理解成数值上的“大于等于”和“大于”。
2.3 multiset与set的区别
multiset与set的接口和遍历方式基本相同,最大的区别是multiset允许保存多个等价关键字,所以它只能完成排序,不能完成去重。
void Test4()
{
	// 相比set不同的是,multiset是允许重复元素存在的
	std::multiset<int> s = { 4,2,7,2,4,8,4,5,4,9 };
	auto it = s.begin();
	while (it != s.end())
	{
		std::cout << *it << " ";
		++it;
	}
	std::cout << std::endl;

	// 相比set不同的是 x 可能会存在多个find会查找中序的第一个
	int x;
	std::cin >> x;
	auto pos = s.find(x);
	while (pos != s.end() && *pos == x)
	{
		std::cout << *pos << " ";
		++pos;
	}
	std::cout << std::endl;


}
遍历结果中,重复的2和4都会被保留下来,而且等价元素在有序序列中会连续出现:
2 2 4 4 4 4 5 7 8 9
这里还需要补充一个边界:标准只保证multiset::find返回某个等价元素,并不保证它一定是这一组等价元素中的第一个。因此,如果要稳定地得到全部重复元素,应该使用equal_range直接取得完整等价区间,或者使用lower_bound与upper_bound确定区间。对于multiset,count(x)会返回x的实际数量,而按值调用erase(x)会删除所有等价的x。
3.map系列容器的使用
3.1 pair键值对与map的基本使用
set只保存一个key,而map需要同时保存key以及与它对应的value,因此map中的元素类型并不是单独的Key或T,而是:
pair<const Key, T>
pair可以把两个类型不同的数据组合在一起,成员first保存第一个值,成员second保存第二个值。放到map中以后,first就是key,second就是与key对应的映射值。make_pair则可以根据传入的数据构造一个pair并返回。
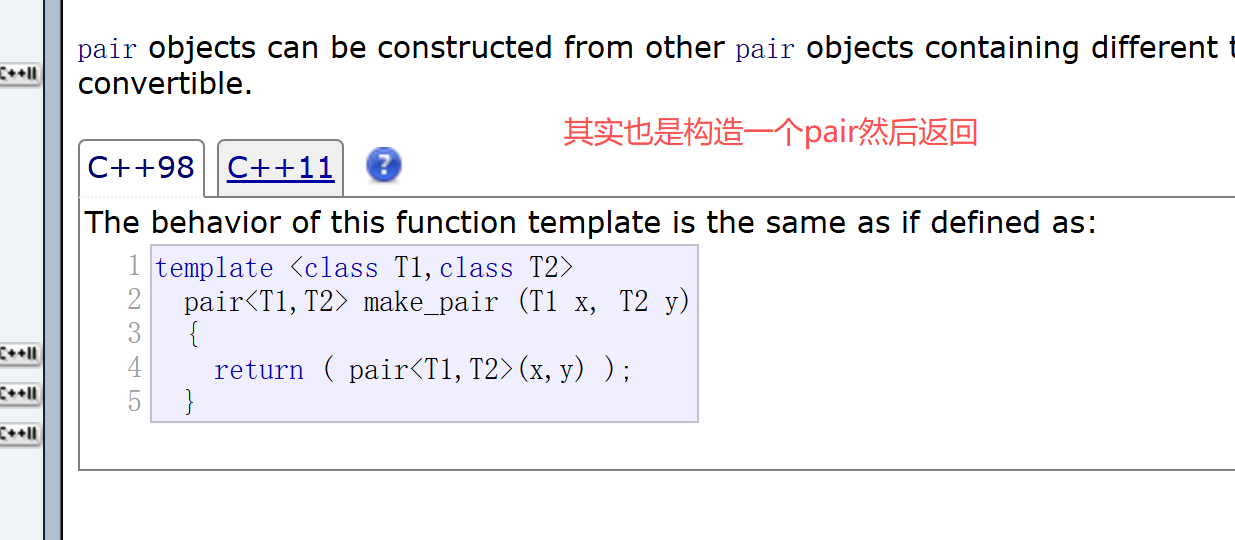
上图适合帮助理解make_pair的基本语义,不代表现代标准库中的完整实现细节。实际使用时,只需要知道它能够根据两个实参得到一个pair对象即可。
下面的代码继续沿用前文相同的头文件,使用多种方式向map中插入键值对,并通过迭代器完成遍历:
using namespace std;

void Test5()
{
	map<string, string> mp;
	pair<string, string> p1("电脑", "computer");
	mp.insert(p1);

	// 下面这两种方式本质上是一样的
	mp.insert(pair<string, string>("时间", "time"));
	mp.insert(make_pair("咖啡", "coffee"));

	// C++11 支持的多参数隐式类型转化
	mp.insert({ "miku", "初音未来" });


	map<string, string>::iterator it = mp.begin();
	while (it != mp.end())
	{

		cout << (*it).first << "->" << (*it).second << endl;
		it++;
	}
	cout << endl;


	// key 不可以修改,但是 value 可以修改
	it = mp.begin();
	it->second = "39";
	cout << (*it).first << "->" << (*it).second << endl;

}
pair<string, string>、显式构造pair、make_pair以及花括号初始化都可以用来准备键值对。遍历map时,迭代器会按照key的比较规则移动,所以常见写法是通过it->first访问key,通过it->second访问映射值。
map的key不能通过迭代器修改,这是因为它同样决定着节点在搜索结构中的位置;映射值不参与节点排序,所以可以通过非const迭代器修改second。这正是pair<const Key, T>中Key带有const,而T没有带const的原因。
3.2 map的增删查与operator[]
map的查找和删除接口与set非常相似,只是操作时使用key进行定位,找到以后还能同时得到对应的映射值:
| 接口 | 作用 |
|---|---|
insert(kv) | 插入键值对,key已经存在时不会覆盖原映射值 |
find(key) | 查找key,找到后可通过迭代器访问first和second |
count(key) | 对map返回0或1,对multimap可能大于1 |
erase(key) | 按key删除,并返回实际删除的键值对数量 |
lower_bound(key) | 返回第一个不排在key之前的位置 |
upper_bound(key) | 返回第一个排在key之后的位置 |
map的单元素insert同样会返回pair<iterator, bool>。这里容易出现两个pair:第一个是map节点中保存的pair<const Key, T>,第二个是insert为了同时返回迭代器和插入结果而构造的pair<iterator, bool>。
如果插入成功,返回值中的迭代器指向新节点,bool为true;如果key已经存在,新的键值对不会插入,迭代器会指向已有节点,bool为false。也就是说,即使插入失败,仍然可以通过返回的迭代器找到原来key对应的位置。
map还有一个非常常用的接口operator[]。它并不只是简单查找,而是把查找、插入和修改组合在了一起:
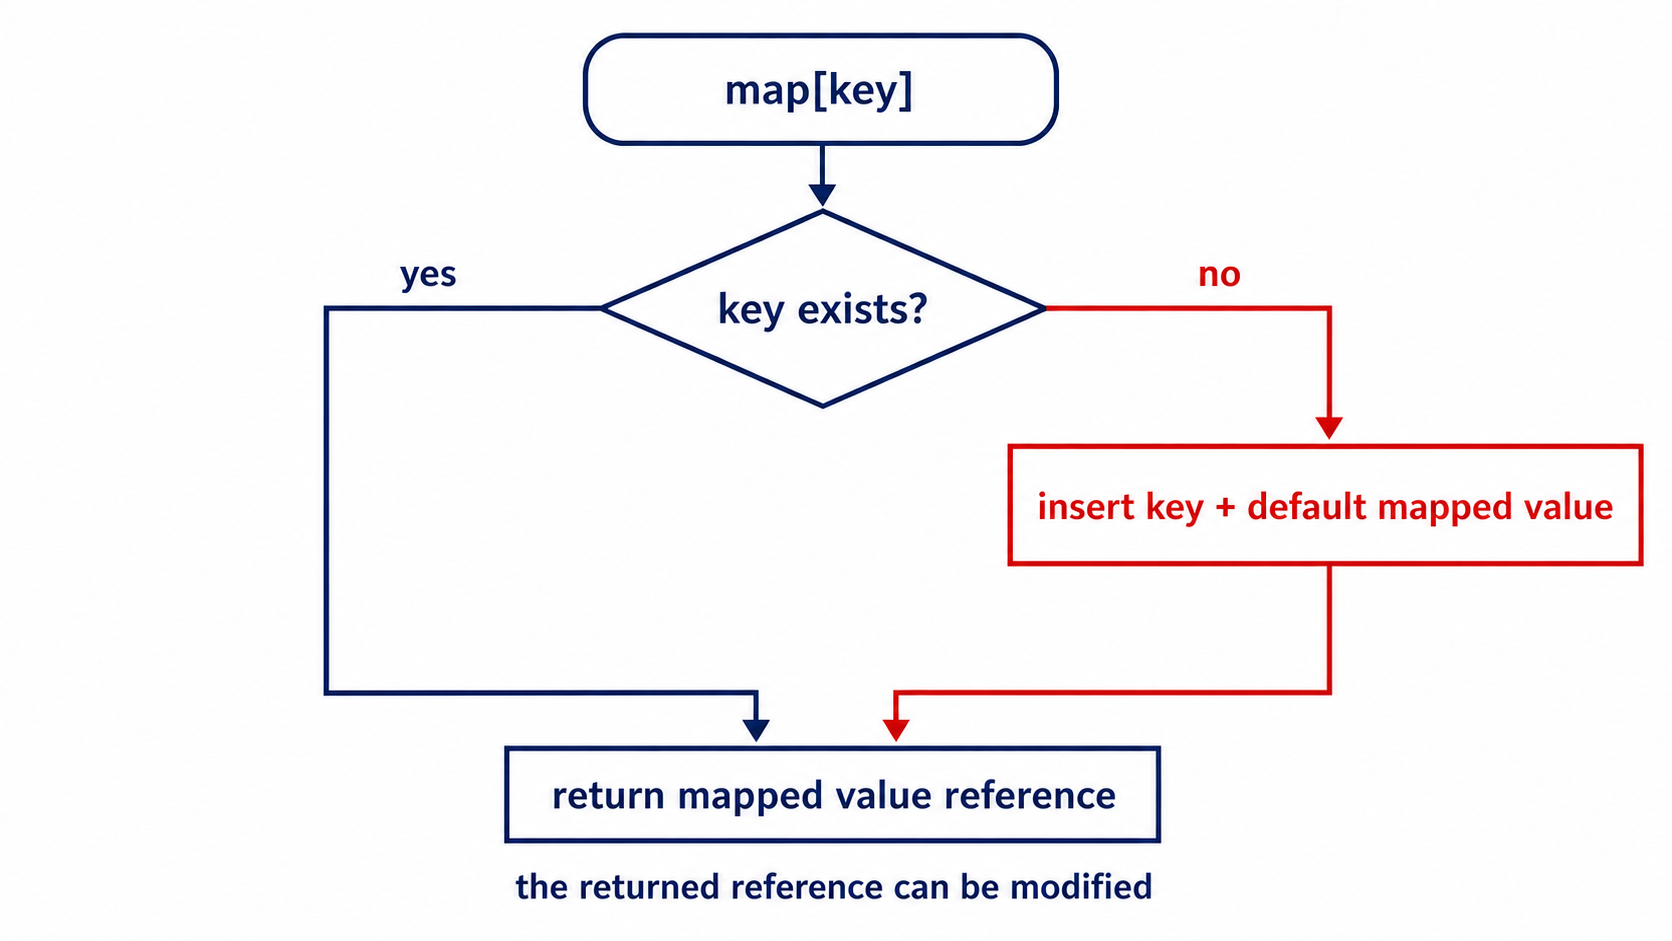
- key已经存在时,返回对应映射值的引用。
- key不存在时,先插入这个key和一个值初始化的映射值,再返回该映射值的引用。
- 返回的是引用,因此可以继续赋值或者执行自增等修改操作。
例如在词频统计中,countMap[str]++之所以能够直接工作,就是因为第一次遇到str时会先插入{str, 0},随后再把返回的次数引用加一;后面再次遇到相同字符串时,则直接找到原来的次数并加一。
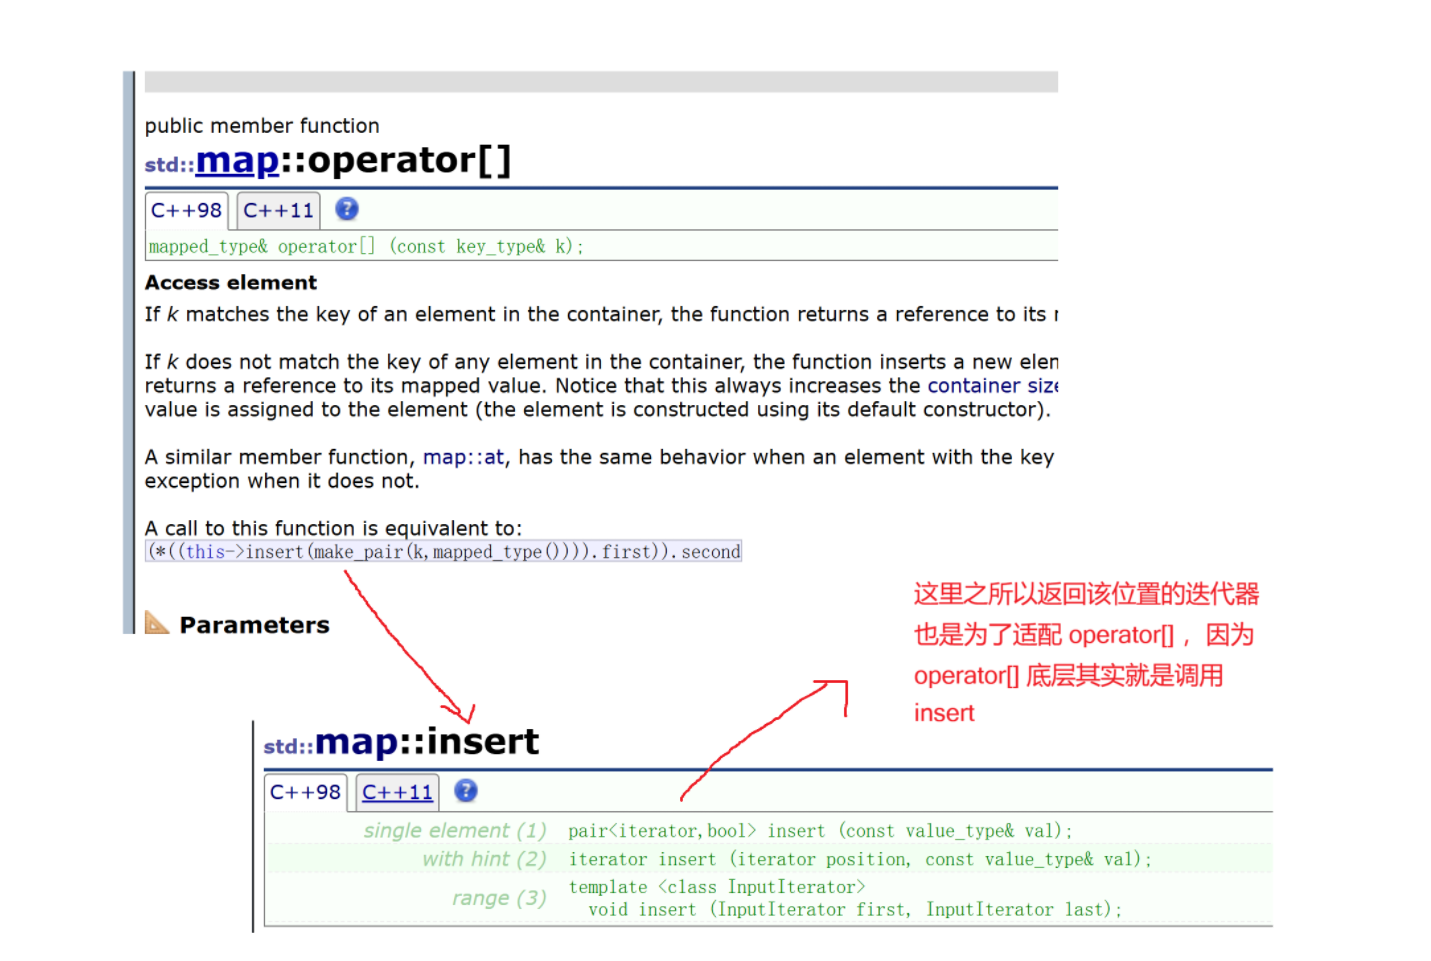
需要注意的是,operator[]的流程只能理解成它必须表现出的等价行为,并不代表所有标准库都一定在内部直接调用insert。另外,它在key不存在时会改变容器,所以不能把它当作完全没有副作用的查询接口;只想判断key是否存在时,使用find会更加直接。也正因为下标运算可能插入数据,const map不能使用这个接口。
3.3 multimap与map的区别
multimap与map之间的关系和multiset与set十分相似:multimap允许不同键值对拥有等价的key,因此同一个key可以对应多个value。
void Test6()
{
	multimap<string, string> mulmp;

	// 与 map 不同的是,multimap 的插入除非内存不够
	// 不然是几乎不会失败的
	mulmp.insert({ "RPG", "魔兽世界" });
	mulmp.insert({ "RPG", "最终幻想" });
	mulmp.insert({ "RPG", "仙剑奇侠传" });
	mulmp.insert({ "RPG", "埃尔登法环" });

	auto it = mulmp.begin();
	while (it != mulmp.end())
	{
		cout << (*it).first << "->" << (*it).second << endl;
		it++;
	}
	cout << endl;

}
四次插入使用的key都是RPG,但对应的value不同,multimap会把它们全部保存下来。这里所强调的是:它不会因为key已经存在而拒绝插入;正常的对象构造、比较和内存分配过程仍然可能出现异常,并不是任何情况下都绝对不会失败。
multimap不支持operator[],因为一个key可能对应多个value,此时下标运算无法确定应该返回哪一个映射值的引用。查找重复key时,find同样只保证返回某个匹配位置,如果要处理这个key对应的全部键值对,可以使用equal_range取得完整区间。按key调用erase时,则会删除所有拥有等价key的键值对,并返回实际删除数量。
4.四种容器应该如何选择
最后可以根据保存内容和是否允许重复快速选择容器:
- 只需要保存唯一且有序的关键字时,使用set。
- 需要保留重复关键字并保持有序时,使用multiset。
- 需要建立唯一key到value的映射关系时,使用map。
- 一个key需要对应多个value时,使用multimap。
set与map系列容器最大的价值,是把“按照关键字组织数据”以及对应的高效查找封装进了统一接口。
完
更多推荐
 11
 0
- 0


 已为社区贡献6条内容

所有评论(0)