
让大模型像硬件工程师一样改 bug:AutoChip 用 EDA 工具反馈迭代修复 Verilog
论文解读:Automatically Improving LLM-based Verilog Generation using EDA Tool Feedback
ACM TODAES 2025 · AutoChip 开源框架
做数字芯片设计的人都有一个共识:Verilog 代码几乎不可能一次写对。工程师的真实日常是写完一版,编译,跑仿真,看波形,读报错,回去改代码,再跑一轮。这个循环可能重复几十次,直到设计通过所有测试。
然而当前用大语言模型生成 Verilog 的主流评测方式,恰恰跳过了这个循环。给模型一段自然语言描述,它直接输出一份代码,通过多少算多少,学术界称之为零样本生成。没有调试,没有反馈,也没有改错的机会。这套玩法和真实的硬件开发流程相去甚远。
纽约大学坦登工程学院联合卡尔加里大学、新南威尔士大学的研究团队提出了一个直接的问题:如果把编译器和仿真器产生的报错信息自动喂回给大模型,它能不能像工程师一样,把自己代码里的 bug 修好?他们给出的答案是 AutoChip,一个开源的自动化 Verilog 生成与修复框架。研究团队用它系统评估了四款商用大模型借助 EDA 工具反馈修复自身代码的能力,论文发表于 ACM Transactions on Design Automation of Electronic Systems 期刊 2025 年 10 月刊。结论里有好消息也有坏消息:反馈确实有效,但只有最强的模型稳定受益;而用小模型打底、大模型收尾的混合策略,能把成本压低近九成。
一、一次生成的天花板在哪里
用硬件描述语言做数字设计是一项小众技能,门槛高、周期长,任何疏忽都可能在实现里埋下 bug,而市场对数字系统的需求还在膨胀,能帮工程师写出高质量代码的工具自然成了刚需。Verilog 又不是普通的编程语言。用它写出来的不是顺序执行的程序,而是并行运行的电路结构。一个 always 块里多一个异步复位,一个计数器位宽差一位,功能就全错了。写出能编译的代码只是起点,写出时序和逻辑都正确的代码才是终点。
让机器自动生成硬件代码的探索由来已久。高层次综合工具可以把 C 语言翻译成硬件描述语言,2020 年出现的 DAVE 第一次尝试微调 GPT-2 直接从英文描述生成 Verilog,随后的 VeriGen 把模型规模和训练数据都扩大了一截。大语言模型本身的能力也在狂飙,千亿参数级别的模型经过指令微调和人类反馈强化学习,已经能理解和回应相当复杂的意图,GitHub Copilot 这类代码补全工具更是把 AI 写代码推进了日常开发。这些工作确立了用 LLM 做 Verilog 生成的可行性,但评测方式基本都是零样本:模型对一道题输出一个或多个答案,统计通过率,结束。
后续的研究大多沿着两条路改进。一条路继续堆模型和数据,RTLCoder 用开源数据集训练出轻量级模型,BetterV 引入判别器引导生成方向,CodeV 靠多层次摘要反推代码,VeriSeek 则尝试用黄金代码反馈做强化学习。另一条路改进搜索,有团队把蒙特卡洛树搜索引进来,专门优化加法器、乘法器这类模块的功耗、性能和面积。评测基准也在跟进,VerilogEval 和 RTLLM 先后提供了标准化的题库。产业界同样没闲着,RapidGPT、Cadence JedAI、Nvidia ChipNeMo、Synopsys.ai Copilot 等商用工具相继问世,只是各家模型、方法和基准都不同,横向比较一直很困难。
2023 年的 Chip-Chat 项目换了条完全不同的路。研究团队让 ChatGPT-4 与一位硬件工程师对话,工程师读代码、找问题、用自然语言告诉模型哪里错了,最终合力完成了一款处理器设计,还流了片,成为第一个完全由 AI 生成并流片成功的芯片。这条路证明了迭代修复的价值,但代价是反馈全部来自人。工程师得自己看懂报错、定位缺陷、组织语言,整个过程昂贵、缓慢,而且换个人结果可能就不同。
自动化这条反馈链路,是 AutoChip 要解决的第一个问题。EDA 工具本来就是最好的老师,编译器知道语法错在哪,仿真器知道功能和参考设计差在哪。这些信息客观、稳定、免费,不需要任何人熬夜读波形。问题在于,把工具输出原封不动丢给大模型,它看得懂吗?
二、AutoChip:给大模型接上编译器和仿真器
AutoChip 最早是同一个团队在 2023 年提出的一个简单迭代循环,类似的单路径结构也出现在 ChipGPT、VeriAssist 等同期工作里。这次发表的版本做了一次关键升级。团队在实验中发现,初始提示词生成的第一版代码质量,会显著影响整个设计流程的走向和最终成败。既然起点如此重要,那就应该多试几个起点。AutoChip 由此从单一路径扩展成了树搜索。
它的输入是三样东西:一段自然语言的电路功能描述,一个定义好输入输出端口的 Verilog 模块骨架,还有一个能自动比对的 testbench。输出则是一份通过全部仿真测试的设计,或者在预算内找到的最好设计。
工作方式像一棵树。设计提示词发给目标大模型后,模型一次性生成 k 个候选模块。每个候选都要过两道关:先用开源的 Icarus Verilog 编译,能编译的再挂到 testbench 上仿真。随后框架给候选打分排序,规则非常朴素:回复里根本没有模块的记负 2 分,编译失败的记负 1 分,编译通过但有警告的记负 0.5 分,能跑仿真的按 testbench 里通过样本的比例计分,全对就是满分 1 分。模型偶尔不按格式输出时,解析器会识别 module 和 endmodule 关键字,把模块从多余文字里捞出来。
出现满分,流程立刻结束。没有满分,就把得分最高的那个候选连编译报错、仿真失配统计一起回传给模型,让它在这个基础上再生成 k 个改进版本。如此反复,最多深入 d 层。这是一种贪心树搜索,每一层只沿着当前最优的候选继续往下走,达到最大深度后返回整棵树里得分最高的设计。和 Chip-Chat 单一候选、单一路径的方式相比,树搜索让每一轮迭代都有备选、有比较。整套流程的目标是全自动化,生成过程中不需要人输入任何东西,模型只靠工具反馈指路。
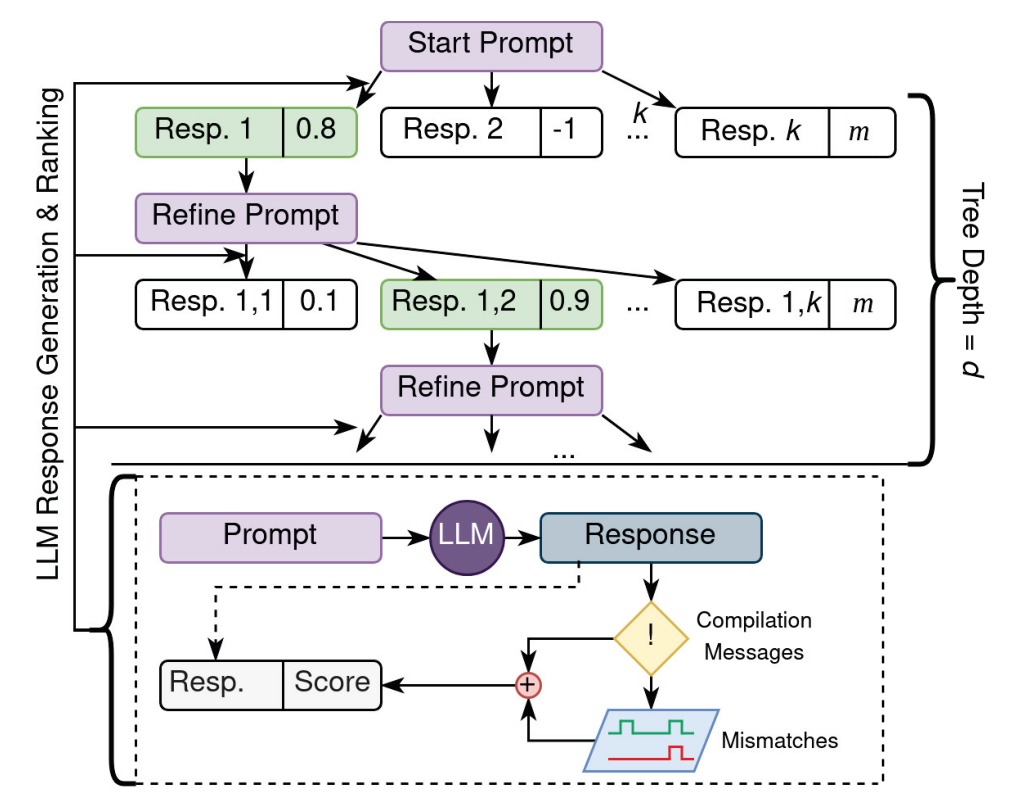
图 1:AutoChip 的树搜索框架。起始提示生成 k 个候选设计,经编译与仿真反馈打分后,最优候选带着工具输出进入下一轮迭代,最多搜索 d 层。下方虚线框展示了单个候选的评分流程。
图源:原论文图 1。
工具喂回来的信息也很具体。仿真失败时,testbench 会输出每个输出信号有多少个采样点和参考设计不一致、第一次失配发生在什么时刻、总共失配多少个点。论文里举了个例子,一道名为 review2015_fancytimer 的题目,某次生成的设计在 235447 个采样点里错了 234318 个,三条输出信号各自的失配统计和首次出错时刻被原样列出来,全部作为反馈发给模型。
框架的日志把每一步都记得清清楚楚。论文展示了 rule110 这道题的第 0 轮记录:两个候选都在 6283 个采样点里错了 6220 个,得分只有 0.01,而单次生成的成本大约 0.0002 美元。每个候选的代码、编译结果、仿真输出和费用各自落盘成独立目录,哪一轮花了多少钱、改对了什么,全部可追溯。
与大模型对话时,AutoChip 用三类提示词。系统提示词把模型设定为一个 Verilog 自动补全引擎,要求对任何规格都给出完整模块,不许拒绝,输出用代码标记包裹。设计提示词就是题目本身。反馈提示词则是每轮更新的部分,装着上一轮的代码和工具输出。
这里有一个工程上绕不开的问题:对话历史越攒越长,很快就会顶到模型的上下文上限。AutoChip 为此准备了两种反馈模式。全上下文模式把从第一轮开始的所有对话都保留下来,精简模式每轮只带最近一次的模块和它的报错。具体来说,第 0 轮的输入只有系统提示词和设计提示词,第 1 轮加上第 0 轮的回复和仿真消息,之后每一轮都替换掉上一轮的回复与消息,输入长度基本恒定,不会随着搜索深度膨胀。研究团队先用 Claude 3 Haiku 和 GPT-3.5-Turbo 两款便宜模型做了对照实验,它们一个上下文 20 万 token,一个只有 1.6 万,很有代表性。结果是两种模式的成功率没有实质差别,但精简模式在长链条搜索里省下的 token 非常可观,后续大规模实验便全部采用精简模式。
整个框架用 Python 写成,通过一个 JSON 配置文件设定模型、候选数、迭代深度和输出目录,还支持一项关键功能:混合模型。配置文件可以指定某个模型从第几轮迭代开始接管生成,前几轮用便宜的小模型,最后一轮换强模型收尾。框架目前支持 OpenAI 的 GPT 系列和 Anthropic 的 Claude 系列,也预留了 Google Gemini、Mistral、Code Llama 和 RTLCoder 的接口,接新模型只需要调用一个 Python API。框架在 Zenodo 上完全开源,附带全部实验日志和数据集。
三、一次真实的修复:四轮迭代救回一个状态机
光看流程图还不够直观,论文记录了一次完整的修复过程。题目来自 VerilogEval-Human 基准,代号 review2015_fsmshift,要求设计一个产生移位使能信号的有限状态机。上场的是 GPT-3.5-Turbo,参数设为每轮 5 个候选、最深 10 层。
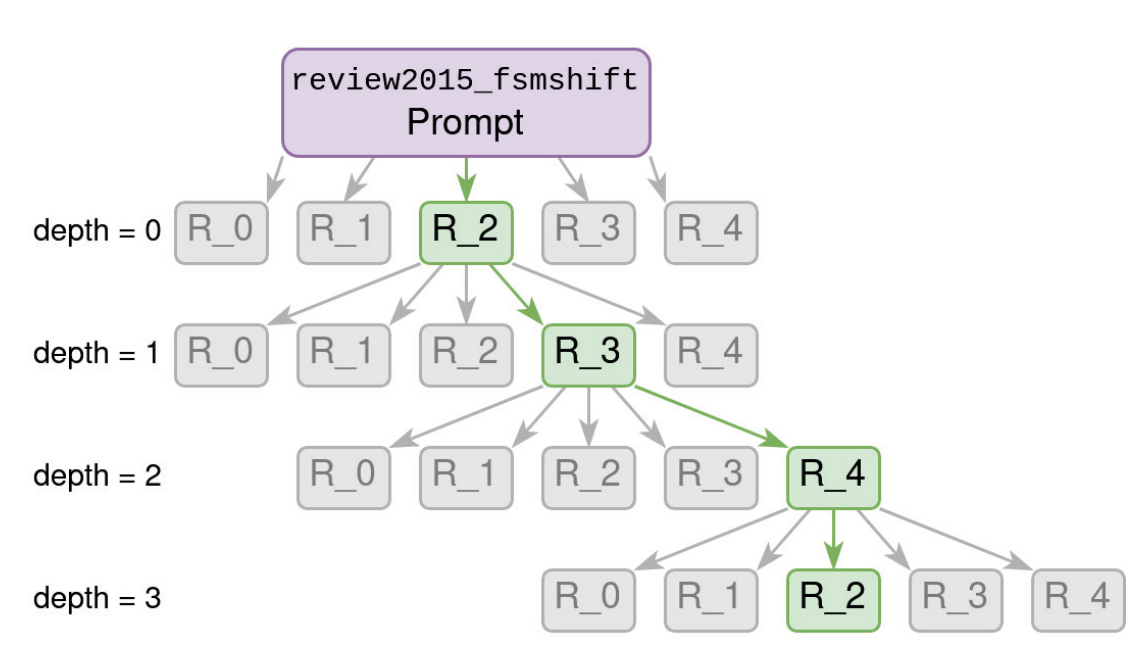
图 2:一次成功的树搜索路径。第 0 层的 R_2、第 1 层的 R_3、第 2 层的 R_4 先后成为各层最优候选,第 3 层的 R_2 通过全部测试,搜索结束。
图源:原论文图 7。
搜索的路径颇有戏剧性。第 0 层五个候选里 R_2 得分最高,它的反馈催生了下一层,第 1 层的 R_3 接棒,第 2 层换成 R_4 领跑,到第 3 层,R_2 终于通过全部测试。各层的编号是当层候选的序号,同名不代表同一份代码。四轮迭代,四个领跑候选,代码每一版都在动。
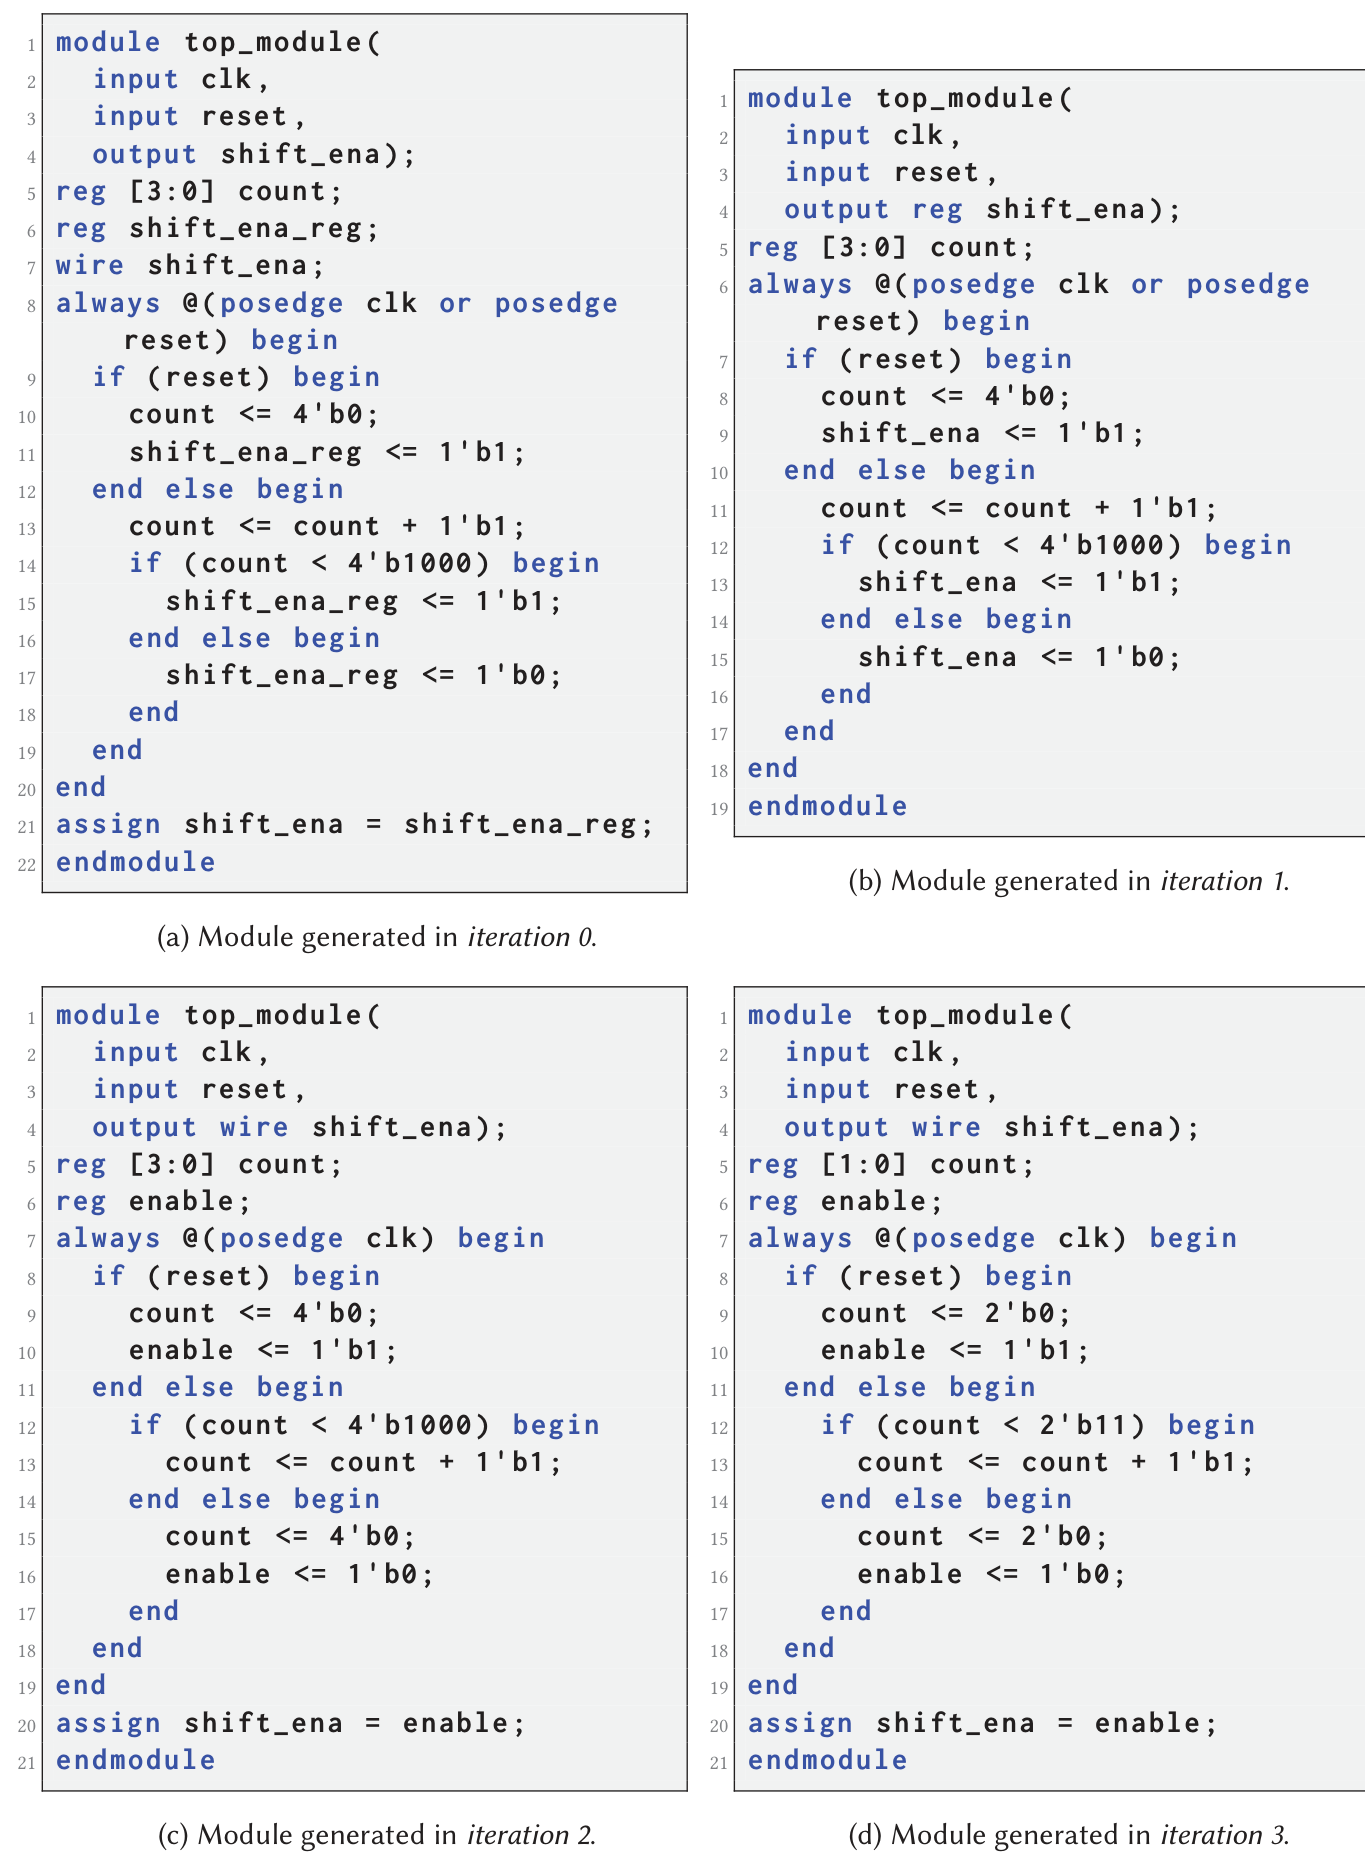
图 3:上述搜索过程中四轮迭代的代码演进,从端口声明混乱、计数器逻辑错误,逐步修复到通过全部测试的版本。
图源:原论文图 8。
把四版代码摆在一起看,修复的脉络很清晰。第 0 版的毛病不少:输出端口 shift_ena 没有显式类型声明,模块内部却又重复声明了同名的寄存器和线网,端口关系混乱;计数器在非复位分支里只往上加,从不清零归位,输出信号的周期完全对不上。
第 1 版先把声明问题收拾干净,输出直接声明为 reg 类型,删掉多余的内部声明,代码结构清爽了,但计数器逻辑原封不动,功能依然错误。
第 2 版动了真格。always 块从异步复位改成同步触发,引入一个 enable 中间寄存器,计数器到达阈值后学会了清零,输出改由 assign 语句驱动 wire 型端口。骨架已经对了,可惜计数器位宽和比较阈值还是错的,输出周期仍然不对。
第 3 版只做了一处关键改动:计数器从 4 位缩到 2 位,比较阈值从 8 改成 3。这一版通过了全部测试。
四轮迭代里还有一个值得玩味的细节:领跑的候选一直在换。每一层的最优代码带着反馈回到模型手里后,模型会一口气给出多个修复方向,框架再从中挑得分最高的继续。模型不是守着一版代码死磕,每一轮都有多条岔路可选。
这个例子让人看到工具反馈的真实价值。模型第一次犯错的地方五花八门,有语法层面的声明错误,也有功能层面的时序错误。编译器先逼着它把语法修对,仿真器再一轮轮挤压功能上的偏差,每一轮的反馈都把搜索引向离正确答案更近的位置。人也在这个过程中被彻底摘了出去,从报错到改代码,全程没有工程师插手。事后看,这道题只用掉了 10 层预算里的 3 层,找到全通过的设计后流程提前收工,剩余的查询预算一分钱都没有多花。
四、实验是怎么搭起来的
评测基准用的是 VerilogEval 第一版,题目全部来自硬件练习网站 HDLBits,难度从 Verilog 语法入门一路排到状态机和波形分析。基准分两套。VerilogEval-Machine 有 143 道题,提示词是 GPT-3.5-Turbo 看着正确答案反推出来的功能描述,措辞具体但啰嗦,抽象要求被抹平了。VerilogEval-Human 有 156 道题,由人把原版题目里的电路图、卡诺图和波形图转写成文字,保留了题目的抽象性。事后看,这两套题的难度差异对结果影响不小。
一个细节能说明两套题的差别。HDLBits 原题里有给卡诺图求最简电路的题目,GPT-3.5-Turbo 反推出来的提示词直接描述了最终电路的功能,把用卡诺图化简这个要求整个略掉了。题目还是那个题目,思考的台阶却被拆掉了。
题库里还有少量不按常理出牌的题目,有的要求给既有模块找 bug,有的要求给模块写 testbench,研究团队把它们一并保留在评测里。HDLBits 原站侧重层次化模块和找 bug 的类目则没有进入这套基准。每道题都配一个 SystemVerilog testbench,同时例化参考模型、待测设计和激励模块,逐个采样点比对输出,最后汇总每个信号的失配数和首次出错时刻。判定成功只有一个标准:所有采样点全部正确。
参评的是四款商用对话模型,按论文实验时的公开定价,每百万 token 的输入输出价格如下:
- Claude 3 Haiku:上下文 20 万 token,输入 0.25 美元,输出 1.25 美元
- GPT-3.5-Turbo-16K:上下文 1.6 万 token,输入 3 美元,输出 4 美元
- GPT-4o-Mini:上下文 12.8 万 token,输入 0.15 美元,输出 0.6 美元
- GPT-4o:上下文 12.8 万 token,输入 5 美元,输出 15 美元
只看价格会发现一个反差:GPT-3.5-Turbo 这样的上一代模型,输入单价是新一代 GPT-4o-Mini 的 20 倍,输出也有近 7 倍;GPT-4o 的输出价格则是全场最高,达到 GPT-4o-Mini 的 25 倍。这个价差是后面所有成本结论的基础。所有模型都用默认参数调用,与开发者日常在网页界面里用到的行为保持一致。
搜索参数上,候选数 k 取 1 或 5,深度 d 取 0、1、5、10。d 等于 0 就是不做任何反馈的零样本基线。为了公平比较,零样本实验额外把候选数加到 10、25、30、55,让最大查询次数对齐:k 为 5、d 为 10 的树搜索最多查询 55 次,和零样本一口气生成 55 个候选完全对等。谁的策略好,在同样的查询预算下见分晓。前期预实验还显示,候选和深度超过 5 和 10 之后,基准上的结果基本不再明显改善。
研究团队也解释了为什么只用商用模型。实验期间 Google 的 Gemini 限速严重,Mistral 系列稳定地产不出可用的 Verilog 模块,Code Llama 和 RTLCoder 在课题组能拿到的硬件上慢到无法接受。商用 API 算力充足,是唯一能在合理时间内跑完整个参数网格的选择。
整个评估围绕六个研究问题展开:
- 工具反馈能否提升 LLM 生成硬件代码的质量,超过零样本基线
- 迭代深度和候选数量如何影响正确设计的产出
- 反馈驱动的生成对成本有什么影响
- 反馈时带的上下文多少,会不会改变成功率
- 是否存在某类模型特别擅长或不擅长的硬件题目
- 在一次设计流程中混用能力不同的多个模型,能否降本增效
下面按论文的顺序,把最重要的几个答案摊开来看。
五、发现一:工具反馈有没有用,先看模型是谁
论文提出的第一个研究问题是,验证工具的反馈能不能让模型生成更好的硬件代码。答案是有条件的:能,但严重依赖模型本身的能力。
GPT-4o 是全场唯一稳定吃反馈红利的模型。在 VerilogEval-Human 这套更贴近真实出题方式的基准上,它零样本单次生成的成功率是 61.5%,零样本 55 个候选的最好成绩是 78.2%;而 k 为 5、d 为 10 的反馈搜索把成功率推到了 84.0%。在 VerilogEval-Machine 上,同样的反馈配置达到 87.4%,零样本最好成绩是 83.2%。换成论文摘要里的口径:最好情况下,成功设计的比例多出 5.8 个百分点,成本反而比最好的零样本结果下降 34.2%。即便把每轮候选减到 1 个,GPT-4o 靠十层反馈也能在 Machine 基准上拿到 84.6%,依然压过零样本堆 55 个候选的 83.2%。
小模型的表现就凌乱得多。Claude 3 Haiku 在 Machine 基准上零样本 55 候选能到 84.6%,用了反馈搜索反而停在 83.9%。GPT-4o-Mini 和 GPT-3.5-Turbo 的反馈结果和零样本互有胜负,看不出稳定规律。论文据此判断,把编译报错文本、仿真失配时刻和代码里的缺陷关联起来,本身就是一种推理负担。大模型能把这条因果链想明白,小模型常常想不明白,反馈给得再准也用不上。
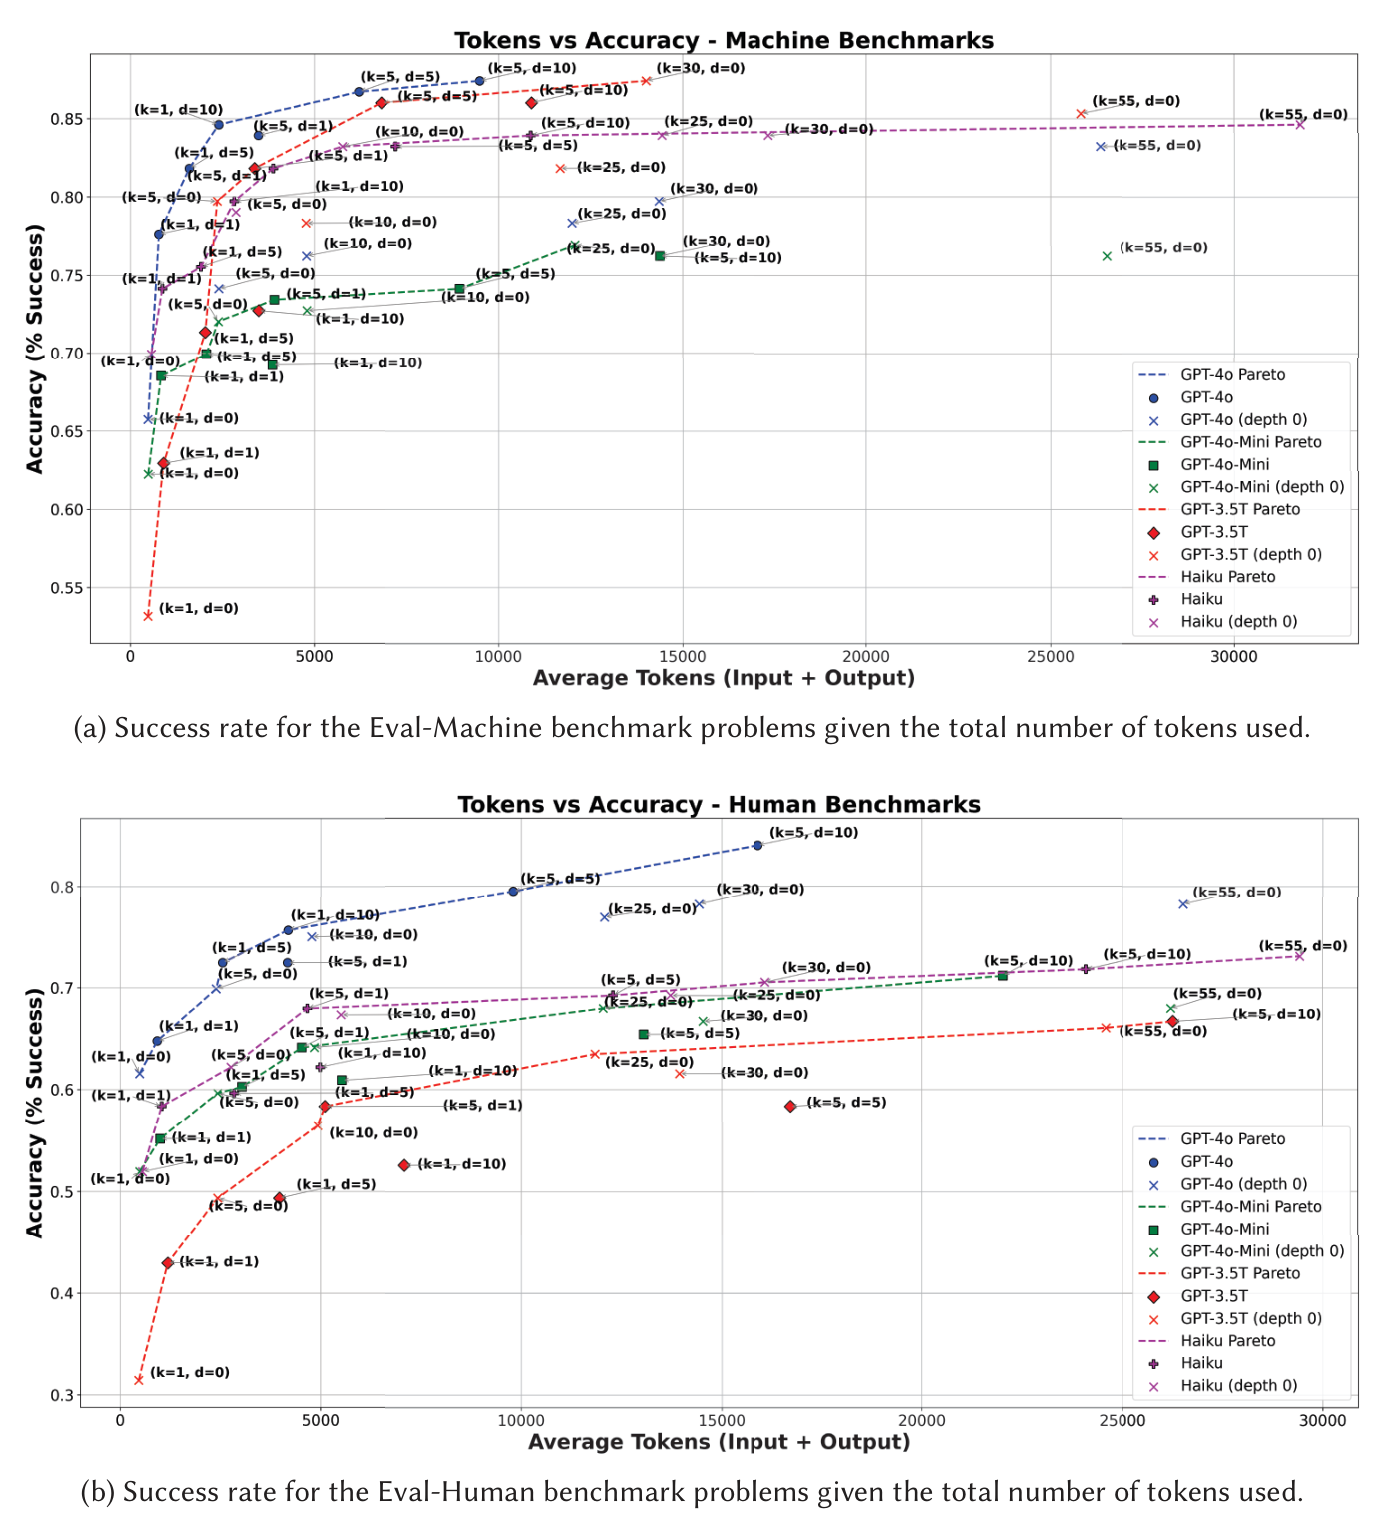
图 4:各模型成功率与平均 token 消耗的关系,上为 Machine 基准,下为 Human 基准。虚线连接各模型的帕累托最优点,叉号为零样本结果。GPT-4o 的帕累托点几乎全部来自反馈驱动的生成。
图源:原论文图 9。
token 账本图把这个差距画得很直白。横轴是生成最优设计平均消耗的 token 数,可以粗略理解为模型付出的计算量;纵轴是成功率。在相同的候选和深度配置下,三个小模型消耗的 token 普遍比 GPT-4o 更多,成功率却更低,它们的帕累托前沿上零样本结果和反馈结果交错出现,反馈没有带来稳定优势。GPT-4o 的前沿上几乎全是反馈驱动的点,而且达到同等成功率所用的 token 明显更少。花同样的计算量,它从反馈里榨出了更多正确设计。
这个结论和团队更早的一项研究互为印证。那项工作里,人类工程师用大白话向模型解释报错和代码的对应关系,哪怕解释得很粗略,模型也能改对不少。人替模型完成了把错误映射回代码这一步推理,模型的负担就轻了。全自动系统里没人帮这个忙,小模型面对一串失配统计往往无从下手。论文据此推测,要让小模型用上工具反馈,可能需要先拿这类报错信息对模型做专门训练。
六、发现二:多生几个候选,还是多走几轮反馈
第二个问题关乎搜索预算的分配:候选数 k 和深度 d,哪个更值得加?
这里需要一个公平的比较口径。论文沿用 pass@k 的思路,把零样本的候选数和树搜索的查询次数对齐,树搜索最多查询 k 乘 d 加 1 次,零样本则直接生成同样数量的候选。在这个口径下,两者都有用,但用法不同。增加候选数的提升更直接,零样本实验里把候选从 1 加到 55,所有模型的成功率都明显上涨。增加深度的提升更平缓,而且随着深度继续加大,收益递减越来越明显。原因不难想:简单题目在前几轮就被解决了,能拖到第十轮的,都是这套方法本来就啃不动的硬骨头,再堆迭代也难有质变。
拿 GPT-4o 在 Human 基准上的数字具体感受一下。零样本单次生成是 61.5%,每轮 5 候选、只走 1 层反馈就到 72.4%,走到 5 层是 79.5%,走到 10 层是 84.0%。深度从 1 加到 5,成功率涨 7.1 个百分点;从 5 加到 10,只涨 4.5 个。收益曲线在明显变平,原因不难想:最容易修的问题早就修完了。
不过在 token 账本上,加深度的性价比反而更高。同样的成功率提升,加深搜索层数比增加每轮候选消耗的 token 更少。这符合直觉:反馈是带着信息的,每一轮迭代都是在上一轮的错误基础上定向改进,而多生成一个候选只是多抽一次奖。
第三个问题关于成本。无论按 token 数还是按美元计算,在相同查询预算下,反馈驱动生成的花费都稳定低于零样本堆候选。GPT-4o 这种反馈真正起效的模型,成本优势更加突出:它用更少的查询次数达到了更高的成功率,尽管单 token 价格最贵,总账依然划算。
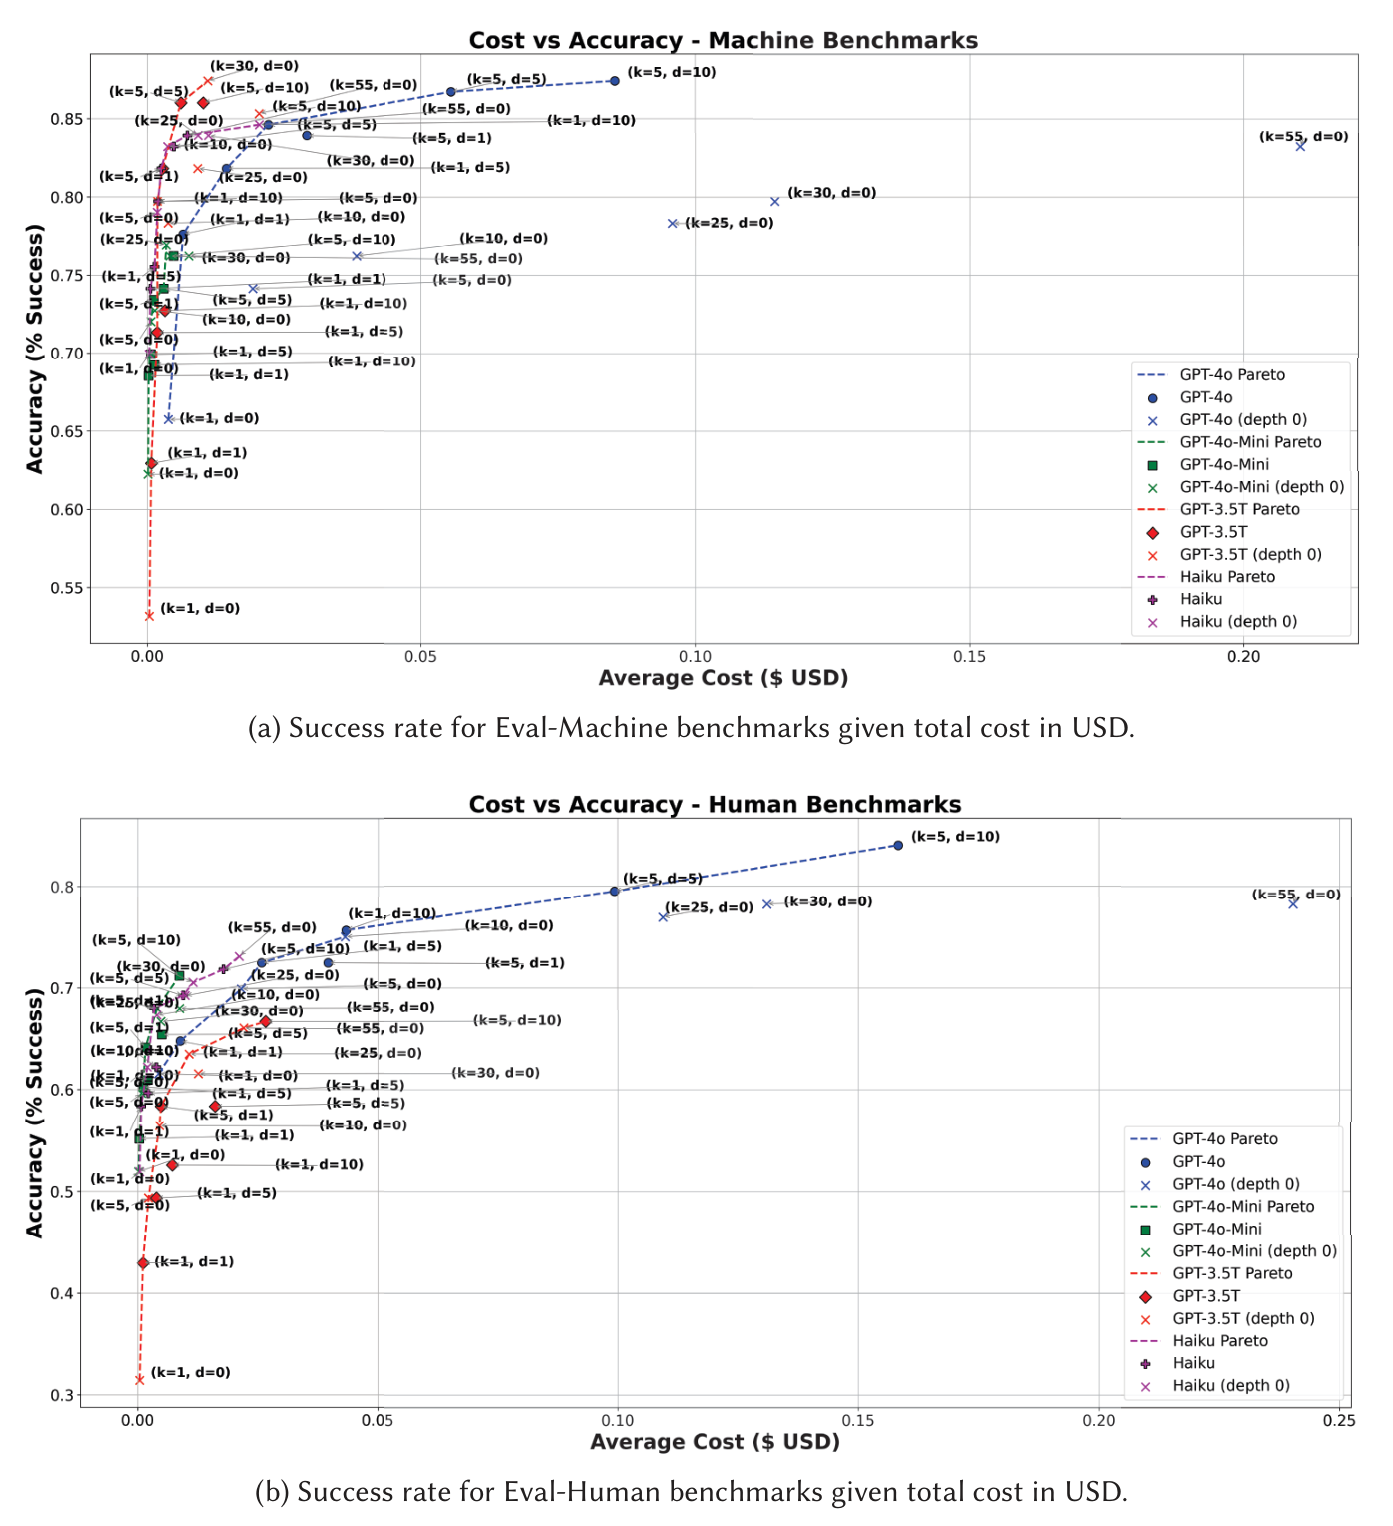
图 5:各模型成功率与平均美元成本的关系。GPT-4o 成功率最高,但同等查询预算下成本远超小模型;小模型成本贴着坐标轴,成功率却难以突破。
图源:原论文图 10。
第四个问题是上下文长度。数字上看,两种模式的差距在噪声范围内:Haiku 单候选搜索在 Machine 基准上走 5 层,全上下文是 77.6%,精简模式是 75.5%;Human 基准上走 10 层,全上下文是 60.2%,精简模式反而有 62.8%。成功率打平,精简模式在长搜索链条里省 token 的效果却很显著。对想把这套流程跑在上下文窗口有限的模型上的人来说,这是个务实的结论:只保留最近一轮的代码和报错,不会损失什么。
七、发现三:题目类型决定模型能走多远
HDLBits 把题目分成若干类别,从入门级的 Getting Started、考察语言特性的 Verilog Language,到 Combinational Logic、Sequential Logic,再到要求读波形图的 Verification: Reading Simulations,难度和抽象程度逐级上升。这套分类让研究团队能看清模型在不同题型上的真实水平。
结论相当一致。所有模型在 Verilog 基础语法和简单组合逻辑上都表现稳定,这类题目考察的是语言特性本身,模型见得足够多。真正的分水岭在抽象题目上:从文字描述里还原卡诺图、设计有限状态机、分析波形图,还有措辞抽象的元胞自动机问题,所有模型的成功率都明显下滑。
细到子类别,画面更清楚。锁存器和触发器这类题目与元胞自动机同属时序逻辑大类,前者是单一功能的小题,后者是描述抽象的综合题,模型的表现在两者之间有数量级的差距。入门级的 Getting Started 类目因为题目太少太简单,在子类别统计里被直接略去。Human 基准里模型最头疼的三类题,正是卡诺图、状态机设计和元胞自动机。
两套基准呈现出有趣的镜像。Machine 基准上,时序逻辑题的成功率显著高于组合逻辑题;Human 基准上,两者基本持平。Machine 基准里模型反而在基本门电路、多路选择器这类简单设计上栽跟头,却在状态机和找 bug 题上表现更好。论文给出的解释指向提示词风格:Machine 集的提示词是模型看着正确答案反推的,描述具体、直白,把设计规格摊得很平;Human 集保留了原始题目的抽象表达,需要模型自己完成从功能描述到电路结构的跳跃。提示方式不同,模型的强项弱项就跟着换位。
还有一个略带遗憾的观察:没有哪一类题目特别从工具反馈中受益,连 GPT-4o 也是如此。反馈的作用是普遍而平缓的,它不是某类难题的特效药。
八、混合模型:让贵模型只打最后一枪
GPT-4o 效果最好,价格也是天花板,输出 token 单价是 GPT-4o-Mini 的 25 倍。能不能两头都要?
研究团队试了混合模型策略:整棵树都用小模型搜索,只有到达最大深度还没通过时,最后一轮换 GPT-4o 出手。配置里 Haiku、GPT-3.5-Turbo、GPT-4o-Mini 轮流当主力,GPT-4o 固定收尾。
结果在 Machine 基准上堪称理想。k 为 5 时,Haiku 打底加深 5 层的混合方案成功率 86.7%,与 GPT-4o 单独运行同深度的成绩完全持平;深 1 层时 Haiku 混合方案 86.0%,GPT-3.5-Turbo 混合方案 86.7%,都反超了 GPT-4o 单独运行的 83.9%。Human 基准上没能完全追平,最好的 Haiku 混合方案达到 75.0%,GPT-4o-Mini 打底、深 10 层的方案同样摸到 75.0%,GPT-4o 单独运行同参数是 79.5%,但成本账完全翻转。
看成本数字更有说服力。Human 基准上混合模型的最高成功率 75%,平均单题成本 0.025 美元;GPT-4o 单模型要达到相近的约 75% 成功率,成本是 0.043 美元,贵了 72%。摘要里给出的总账是:混合方案与 GPT-4o 全程反馈的成功数相当,成本再降 41.9%,相对零样本方案累计下降 89.6%。token 消耗也有同样的趋势,混合方案的平均 token 数和小模型单独运行基本相当,成功率却明显高出一截。从帕累托前沿看,混合方案的最优点往往在最大的候选数和深度之前就到顶了,意味着用更小的搜索预算就能拿到接近极限的成功率。
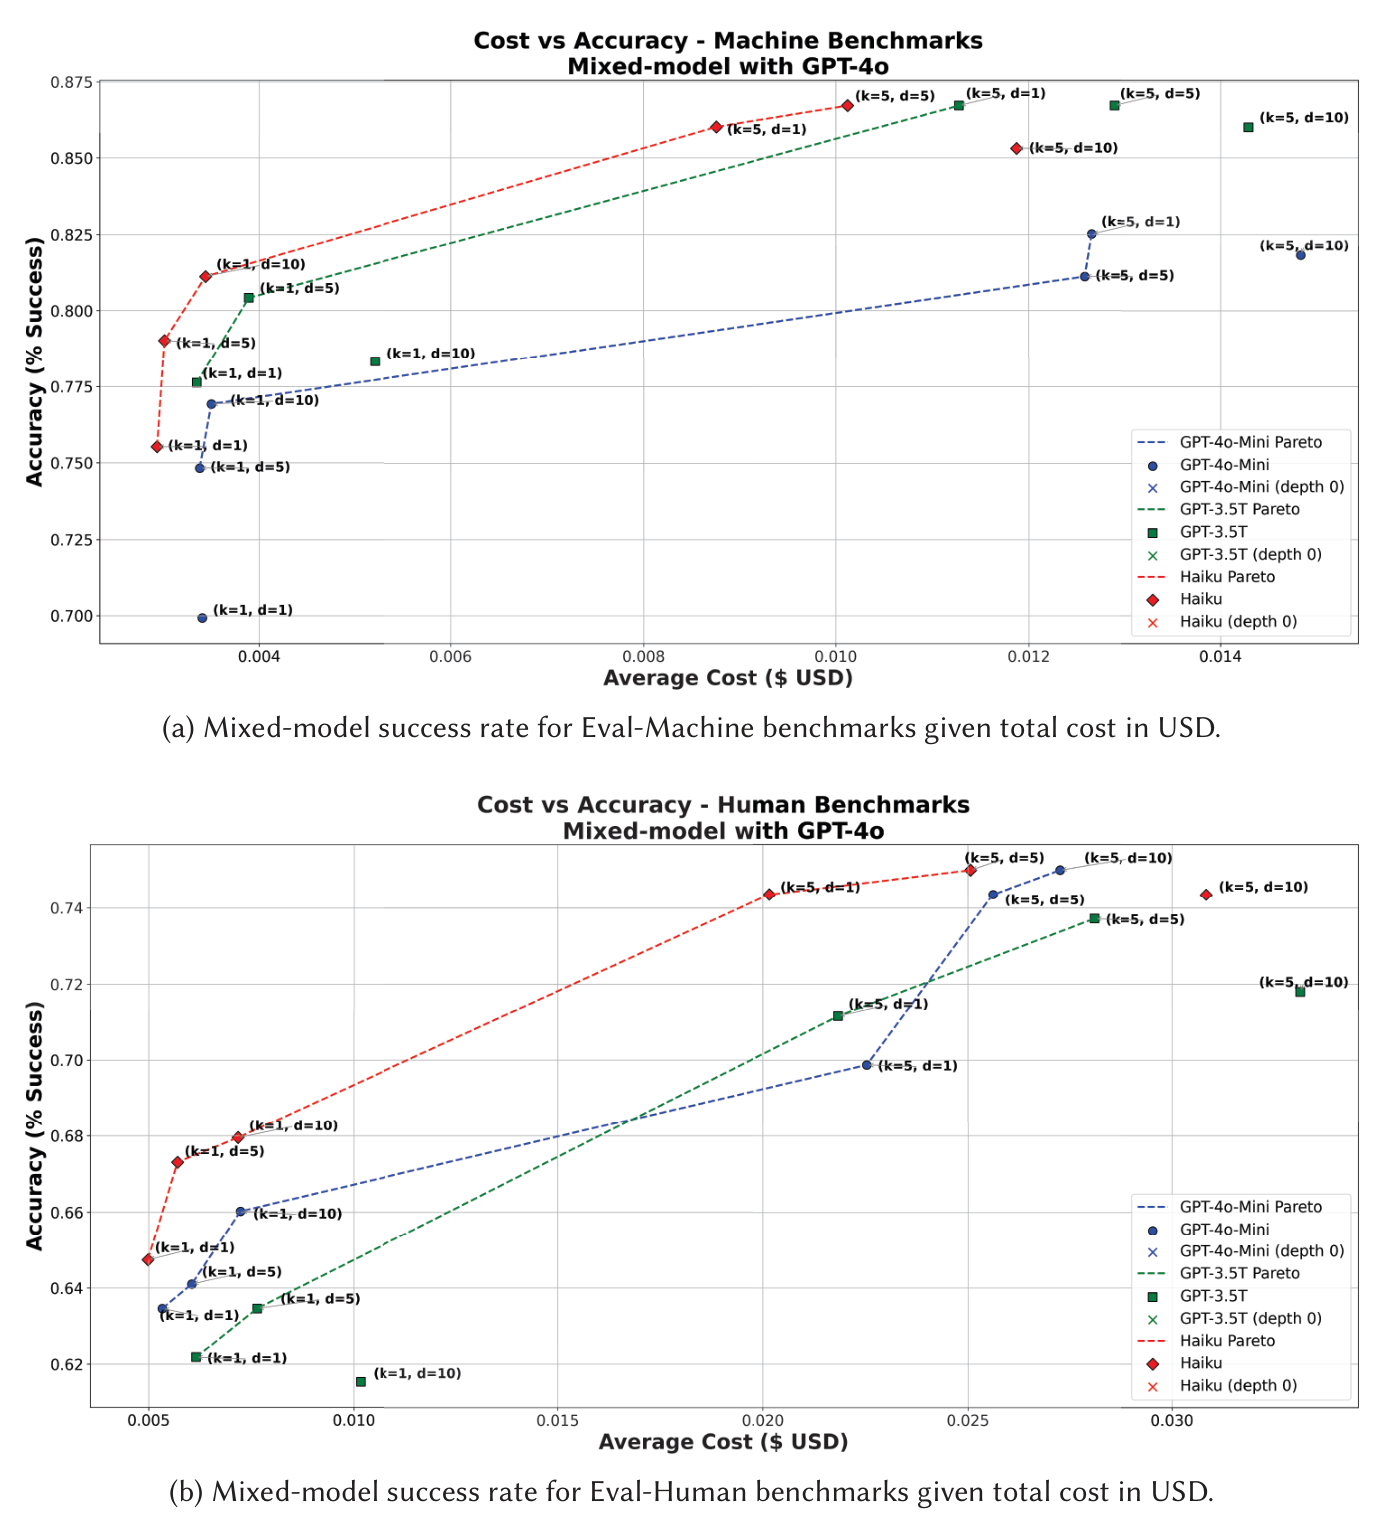
图 6:混合模型的成功率与平均美元成本。小模型完成绝大部分迭代,GPT-4o 只负责最后一轮,成本与小模型处于同一量级,成功率逼近 GPT-4o 单独运行。
图源:原论文图 14。
分题型来看,混合模型在各类别上的强弱分布和 GPT-4o 单独运行几乎一致,而不是像小模型那样有自己的短板。最后一轮的大模型调用,似乎把 GPT-4o 的题型适应能力也一并借了过来。
省钱的关键藏在流程结构里。简单题目小模型自己就在前几轮解决了,根本走不到树的最大深度,GPT-4o 也就永远不会被调用。真正触发最后一次大模型调用的,只有那些最难的题目。贵模型的钱,一分不剩地花在了刀刃上。论文还指出,小模型拿到最后一轮时手里不是白纸,而是经过多轮反馈修复的半成品设计,GPT-4o 要做的往往只是临门一脚的修补,这正是它最擅长的事。
九、冷静看待:局限与没解决的问题
这项工作的边界同样清楚。AutoChip 要求每道题都有现成的、能自动比对的 testbench,它不会自己写测试平台,也不支持只生成模块的一部分。评测用的是 VerilogEval 第一版,更新后的第二版基准在实验完成后才发布,结论能否原样迁移到新基准,还有待验证。模型覆盖面也有限,参评的只有四款商用模型,开源模型和更多商用模型没来得及进入参数网格。成本结论也要打上时间戳,所有美元数字对应论文实验期间各家 API 的公开定价,价格一变,账本就得重算。
小模型读不懂工具反馈,是全文最值得跟进的悬念。论文的判断是,报错信息和代码缺陷之间的对应关系需要专门教给模型,无论是通过在反馈提示里加入解释,还是拿工具报错数据做针对性训练。搜索策略本身也有深挖空间,候选数和深度的最优配比没有定论,蒙特卡洛树搜索这类更精细的方法被作者明确留给了未来工作。
有一点值得单独肯定:可复现性。框架代码、每道题每次运行的完整日志、每个候选的代码和费用记录,全部随论文公开。后面的研究者不需要猜测作者的实验细节,直接下载数据就能复核任何一张图表,也可以把新模型插进框架里跑同一套题。
结语
这篇论文做的事情,本质上是把 Verilog 生成的评测和研究,从静态的一次出结果,拉回了动态的写改循环。它用一套开源框架和一组扎实的对照实验证明了三件事:EDA 工具反馈确实能自动驱动模型修复自己的代码,但当前只有能力最强的一档模型能稳定利用这种反馈;反馈驱动比零样本堆候选更省钱;小模型打底、大模型收尾的混合策略,能在保住成功率的前提下把成本压低近九成。
对硬件设计自动化这个方向来说,AutoChip 更像一块方法论基石。框架是开源的,模型可以换,基准可以换,搜索策略也可以换。当更强的模型出现时,同一套实验可以直接重跑。对今天就想上手的工程师,论文给出的建议也很直白:预算充足就用最强模型配工具反馈,预算紧张就用小模型跑全程、强模型收尾。从一份自然语言规格说明出发,无人参与地走到流片,这个愿景还远,但反馈闭环这一块拼图,现在有了可复现的基准和量化的成本账本。
参考资料
本文部分图片改编自原论文图 1、图 7、图 8、图 9、图 10、图 14,仅用于论文解读与学术交流。原论文:Jason Blocklove、Shailja Thakur、Benjamin Tan、Hammond Pearce、Siddharth Garg、Ramesh Karri,Automatically Improving LLM-based Verilog Generation using EDA Tool Feedback,ACM Transactions on Design Automation of Electronic Systems,Vol. 30, No. 6, Article 100,2025 年 10 月。DOI: 10.1145/3723876。AutoChip 框架与实验数据开源地址:https://zenodo.org/records/13864552。
更多推荐

 4
 0
- 0


 已为社区贡献10条内容

所有评论(0)