
机器学习测试:使用机器运行时的传感器数据预测机器是否会发生故障
预测性维护:机器故障分类建模
本 Notebook 基于 predictive_maintenance.csv,使用机器运行时的传感器数据预测机器是否会发生故障。
该数据来源于kaggle 数据库
整体流程
- 数据探索:了解数据分布、缺失值、目标变量是否平衡
- 数据预处理:去掉标签泄漏列,对数值特征标准化,对类别特征 one-hot 编码
- 模型训练:逻辑回归 + 随机森林
- 模型评估:准确率、精确率、召回率、F1、混淆矩阵
- 特征重要性分析:找出最关键的传感器
注意:这份数据里的
TWF / HDF / PWF / OSF / RNF是故障原因的细分标签,它们和Machine failure高度绑定,不能直接当作输入特征,否则会出现“标签泄漏”。
1. 导入依赖
这里导入数据分析、可视化、建模和评估常用的库:
pandas/numpy:数据处理matplotlib/seaborn:画图sklearn:机器学习工具(预处理、模型、评估指标)%matplotlib inline:让图表直接显示在 Notebook 里
# 1. 导入依赖库
import warnings
warnings.filterwarnings('ignore')  # 忽略一些不影响结果的警告

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

# 让图表在 Notebook 中直接显示
%matplotlib inline
sns.set_style('whitegrid')  # 统一图表风格

# scikit-learn 相关工具
from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score, precision_score, recall_score, f1_score,
    confusion_matrix, classification_report
)
2. 加载数据
读取 CSV 文件,查看数据的基本面貌。pd.read_csv() 会把表格数据读成一个 DataFrame。
# 2. 读取数据
# 因为 Notebook 和 CSV 文件放在同一个文件夹里,所以直接用文件名即可
df = pd.read_csv('predictive_maintenance.csv')

print('数据形状(行数, 列数):', df.shape)
print('\n前 5 行:')
df.head()
3. 数据探索(EDA)
建模前先了解数据:有没有缺失、目标变量长什么样、各特征分布如何。这一步能帮我们发现异常、选择处理方式。
3.1 基本信息与缺失值
shape:看有多少行、多少列dtypes:看每列的数据类型isnull().sum():统计每列缺失值个数duplicated().sum():统计重复行数
缺失值和重复行会影响模型训练,所以先检查清楚。
# 3.1 查看数据形状、列类型、缺失值、重复行
print('数据形状:', df.shape)
print('\n列类型:')
print(df.dtypes)

# 缺失值检查
print('\n缺失值统计:')
print(df.isnull().sum())

# 重复行检查
print('\n重复行数:', df.duplicated().sum())
3.2 目标变量分布
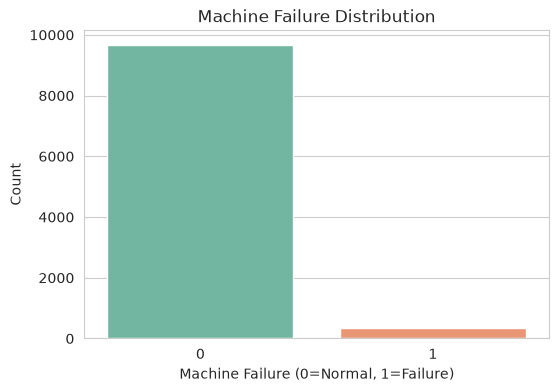
目标 Machine failure 只有两种取值:
0:机器正常1:机器故障
如果两类样本数量差距很大(比如故障样本极少),就叫做类别不平衡,这时不能只看准确率。
# 3.2 统计目标变量分布
print('Machine failure 分布:')
print(df['Machine failure'].value_counts())

print('\nMachine failure 占比:')
print(df['Machine failure'].value_counts(normalize=True).round(4))

# 可视化目标分布
plt.figure(figsize=(6, 4))
sns.countplot(data=df, x='Machine failure', palette='Set2')
plt.title('Machine Failure Distribution')
plt.xlabel('Machine Failure (0=Normal, 1=Failure)')
plt.ylabel('Count')
plt.show()
3.3 数值特征的统计描述
describe() 可以快速得到每个数值特征的:
- 均值、标准差
- 最小值、最大值
- 四分位数
这能帮我们判断特征的量级是否一致,以及有没有异常值。
# 3.3 定义数值特征列并查看统计描述
numeric_features = [
    'Air temperature', 'Process temperature', 'Rotational speed',
    'Torque', 'Tool wear'
]

df[numeric_features].describe()
3.4 按故障状态看各传感器分布
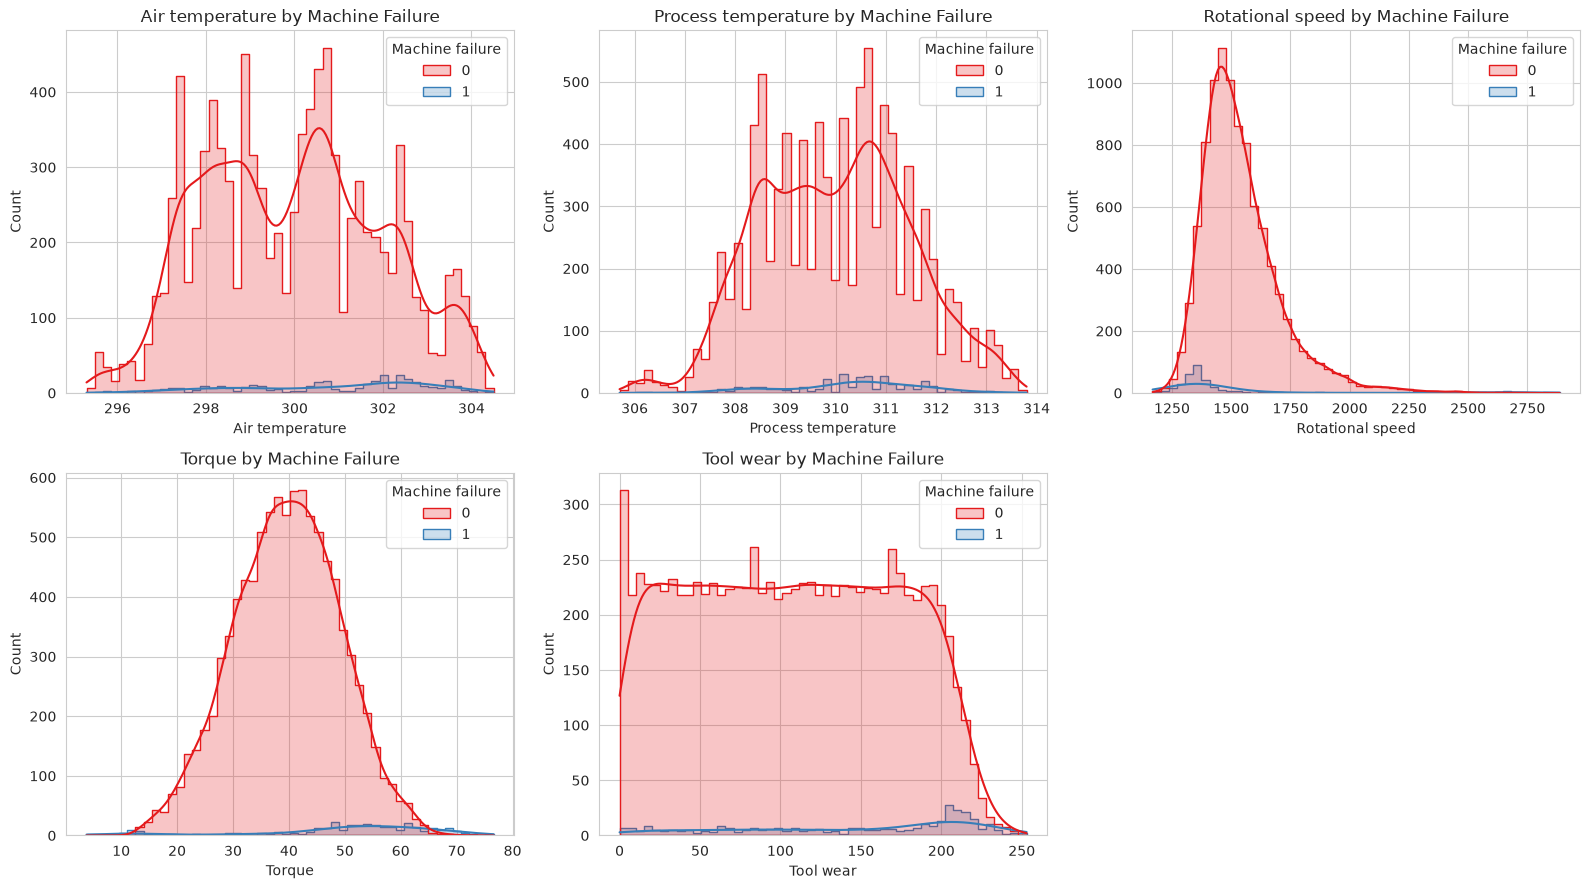
把每个数值特征按 Machine failure 分组画直方图:
- 如果两类分布重叠很多,说明这个特征区分能力弱
- 如果分布明显分开,说明这个特征对判断故障有帮助
这里用半透明叠加的方式展示,避免样本量差距大导致看不清。
# 3.4 画出每个数值特征在“正常”和“故障”两类下的分布
fig, axes = plt.subplots(2, 3, figsize=(16, 9))
axes = axes.flatten()

for idx, col in enumerate(numeric_features):
    sns.histplot(
        data=df, x=col, hue='Machine failure', bins=50,
        kde=True, ax=axes[idx], palette='Set1', element='step'
    )
    axes[idx].set_title(f'{col} by Machine Failure')

# 第 6 个子图没有内容,关闭它
axes[-1].axis('off')

plt.tight_layout()
plt.show()
3.5 产品类型与故障的关系
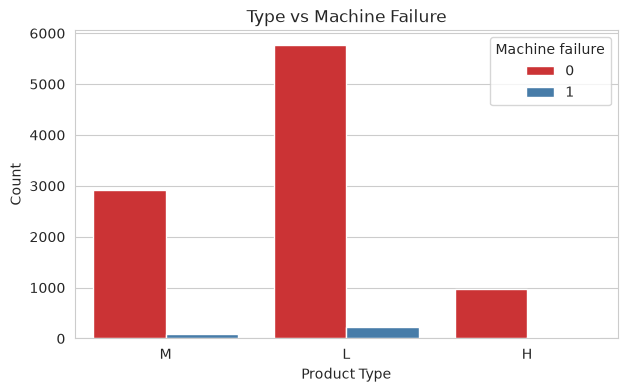
Type 表示产品质量等级(L=Low, M=Medium, H=High)。不同等级的产品设计参数不同,故障率可能也不一样。
# 3.5 画 Type 与 Machine failure 的计数图
plt.figure(figsize=(7, 4))
sns.countplot(data=df, x='Type', hue='Machine failure', palette='Set1')
plt.title('Type vs Machine Failure')
plt.xlabel('Product Type')
plt.ylabel('Count')
plt.show()
3.6 特征相关性热力图
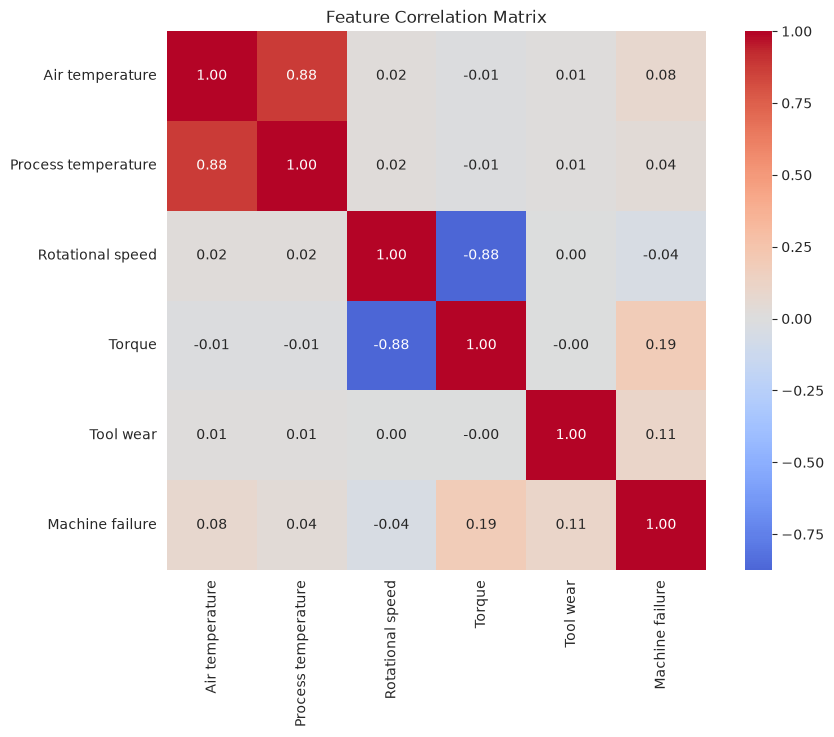
相关性系数范围是 -1 到 1:
- 越接近 1,两个特征越同向变化
- 越接近 -1,越反向变化
- 越接近 0,越没有线性关系
这里主要看各特征与 Machine failure 的相关性强弱。
# 3.6 计算数值特征与目标的相关性并画热力图
plt.figure(figsize=(10, 7))
corr_cols = numeric_features + ['Machine failure']

sns.heatmap(
    df[corr_cols].corr(),
    annot=True,      # 在格子里显示数字
    fmt='.2f',       # 保留两位小数
    cmap='coolwarm', # 颜色方案
    center=0,        # 以 0 为中心
    square=True
)
plt.title('Feature Correlation Matrix')
plt.show()
4. 特征工程与预处理
在建模之前,要先确定:
- 哪些列能作为输入特征(不能泄露目标信息)
- 数值特征要不要标准化
- 类别特征要不要编码
4.1 为什么要删除 TWF / HDF / PWF / OSF / RNF?
这几列表示具体发生了哪种故障模式。根据数据集定义:
只要
TWF、HDF、PWF、OSF、RNF中任意一个为 1,Machine failure就为 1。
也就是说,它们和 Machine failure 是因果关系。
如果把它们当作输入特征,模型就等同于“提前知道了部分答案”,这叫标签泄漏(Data Leakage)。训练时分数会很好看,但到真实预测时根本不知道这些故障模式会发生,模型就失去了实用价值。
所以建模时只保留机器正常运行时就能观测到的数据:Type 和五个数值传感器。
# 4.1 定义输入特征 X 和预测目标 y

# 这些列属于标签泄漏,不能作为输入特征
leakage_cols = ['TWF', 'HDF', 'PWF', 'OSF', 'RNF', 'Machine failure']

# X:输入特征(去掉泄漏列)
X = df.drop(columns=leakage_cols)

# y:预测目标
y = df['Machine failure']

print('输入特征列:', X.columns.tolist())
print('\n目标变量分布:')
print(y.value_counts(normalize=True).round(4))
4.2 划分训练集和测试集
把数据分成两部分:
- 训练集(80%):用来训练模型
- 测试集(20%):用来评估模型在“没见过”的数据上表现如何
由于故障样本很少,划分时要使用 stratify=y,保证训练集和测试集中的故障比例一致。否则测试集里可能只有几个故障样本,没法准确评估。
4.3 构建预处理流水线
不同的特征需要不同的处理方式:
| 特征类型 | 处理方式 | 原因 |
|---|---|---|
| 数值特征(温度、转速、扭矩等) | StandardScaler 标准化 | 把不同量纲的特征缩放到同一数量级,避免“数值大的特征”对模型产生过大影响 |
类别特征 Type | OneHotEncoder 独热编码 | 模型只能处理数字,需要把 L/M/H 转成 0/1 列 |
ColumnTransformer 的好处是:可以一次性对不同类型的列做不同处理,而且和模型一起封装在 Pipeline 里,避免手动处理时出错。
drop='first':把 L/M/H 转成两列而不是三列,避免信息重复(多重共线性),逻辑回归更稳定。
# 4.3 构建预处理流水线

# 类别特征只有 Type
categorical_features = ['Type']

preprocessor = ColumnTransformer(
    transformers=[
        # 数值特征:标准化(均值为 0,标准差为 1)
        ('num', StandardScaler(), numeric_features),
        # 类别特征:one-hot 编码,drop='first' 避免冗余
        ('cat', OneHotEncoder(drop='first'), categorical_features)
    ]
)

# 用训练集拟合预处理器,学习均值、方差、类别取值
preprocessor.fit(X_train)

# 获取预处理后的特征名,方便后续特征重要性可视化
feature_names = (
    numeric_features +
    list(
        preprocessor.named_transformers_['cat']
        .get_feature_names_out(categorical_features)
    )
)
print('预处理后的特征名:', feature_names)
5. 模型训练
这里训练两个经典模型进行对比:
- 逻辑回归(Logistic Regression):简单、可解释性强,适合线性可分问题
- 随机森林(Random Forest):基于决策树的集成模型,能捕捉非线性关系
因为故障样本很少(约 3.4%),属于类别不平衡问题,两个模型都使用 class_weight='balanced',让模型在训练时多关注少数类(故障样本)。
5.1 逻辑回归
逻辑回归输出的是一个概率值,默认以 0.5 为阈值判断类别。这里用 Pipeline 把预处理和模型打包在一起。
参数说明:
max_iter=1000:增加最大迭代次数,确保模型收敛class_weight='balanced':自动根据类别比例调整权重random_state=42:固定随机种子,结果可复现
# 5.1 逻辑回归模型
logreg = Pipeline([
    ('preprocessor', preprocessor),  # 先进行数据预处理
    ('classifier', LogisticRegression(
        max_iter=1000,
        class_weight='balanced',  # 处理类别不平衡
        random_state=42
    ))
])

# 用训练集拟合模型
logreg.fit(X_train, y_train)
print('逻辑回归训练完成')
5.2 随机森林
随机森林由多棵决策树组成,通过“集成投票”做预测。它对异常值不敏感,能自动捕捉特征之间的非线性交互。
参数说明:
n_estimators=200:森林里有 200 棵树class_weight='balanced':同样处理类别不平衡n_jobs=-1:使用所有 CPU 核心加速训练
# 5.2 随机森林模型
rf = Pipeline([
    ('preprocessor', preprocessor),  # 先进行数据预处理
    ('classifier', RandomForestClassifier(
        n_estimators=200,          # 树的数量
        class_weight='balanced',   # 处理类别不平衡
        random_state=42,
        n_jobs=-1                  # 并行训练,使用全部 CPU
    ))
])

# 用训练集拟合模型
rf.fit(X_train, y_train)
print('随机森林训练完成')
6. 模型评估
对于二分类问题,常用的四个指标:
- 准确率(Accuracy):预测正确的样本占全部样本的比例。类别不平衡时容易被多数类“拉高”。
- 精确率(Precision):在所有预测为故障的样本中,真正故障的比例。高精确率意味着“误报少”。
- 召回率(Recall):在所有真正故障的样本中,被模型找出来的比例。高召回率意味着“漏报少”。
- F1-Score:精确率和召回率的调和平均,综合衡量模型对少数类的识别能力。
在这份数据里,F1 比 Accuracy 更有参考价值。
6.1 统一的评估函数
# 6.1 统一的评估函数
def evaluate_model(model, X_test, y_test, model_name):
    """计算并打印模型的分类指标"""
    y_pred = model.predict(X_test)

    # 计算各项指标
    acc = accuracy_score(y_test, y_pred)
    prec = precision_score(y_test, y_pred, zero_division=0)
    rec = recall_score(y_test, y_pred, zero_division=0)
    f1 = f1_score(y_test, y_pred, zero_division=0)

    print(f'\n===== {model_name} =====')
    print(f'准确率  Accuracy : {acc:.4f}')
    print(f'精确率  Precision: {prec:.4f}')
    print(f'召回率  Recall   : {rec:.4f}')
    print(f'F1 分数 F1       : {f1:.4f}')
    print('\nClassification Report:')
    print(classification_report(
        y_test, y_pred,
        target_names=['Normal', 'Failure'],
        zero_division=0
    ))
    return y_pred

# 分别评估两个模型
logreg_pred = evaluate_model(logreg, X_test, y_test, 'Logistic Regression')
rf_pred = evaluate_model(rf, X_test, y_test, 'Random Forest')
6.2 指标对比表
把两个模型的指标汇总到一张表,方便直观对比。
# 6.2 生成指标对比表
metrics = []
for name, model in [('Logistic Regression', logreg), ('Random Forest', rf)]:
    y_pred = model.predict(X_test)
    metrics.append({
        'Model': name,
        'Accuracy': accuracy_score(y_test, y_pred),
        'Precision': precision_score(y_test, y_pred, zero_division=0),
        'Recall': recall_score(y_test, y_pred, zero_division=0),
        'F1-Score': f1_score(y_test, y_pred, zero_division=0)
    })

metrics_df = pd.DataFrame(metrics)
print(metrics_df.round(4))
7. 混淆矩阵
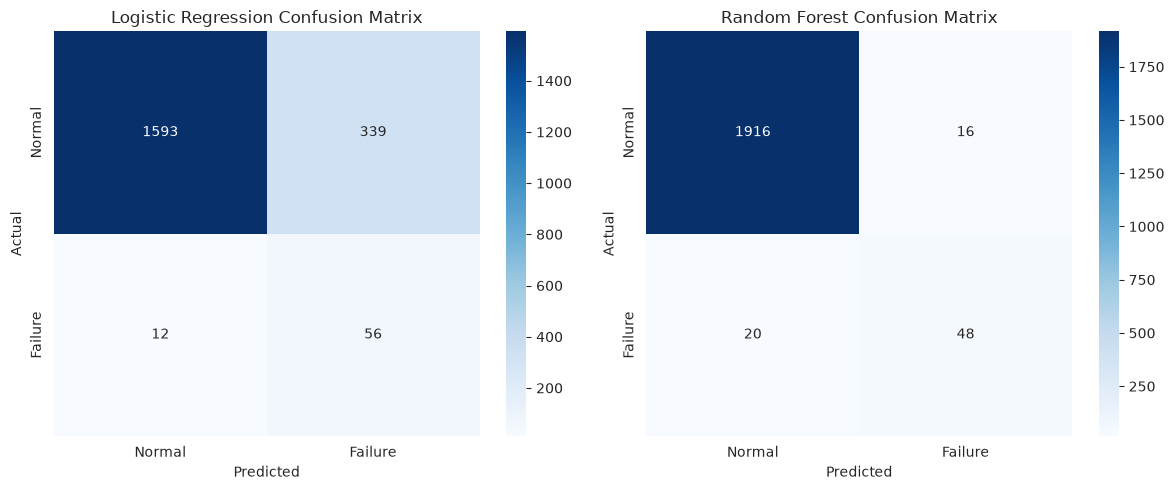
混淆矩阵能直观看出模型错在哪里:
| 预测为 Normal | 预测为 Failure | |
|---|---|---|
| 实际 Normal | True Negative(正确) | False Positive(误报:正常被当成故障) |
| 实际 Failure | False Negative(漏报:故障没被发现) | True Positive(正确) |
对于预测性维护,漏报通常比误报更危险(故障没被发现会导致停机)。
7.1 绘制两个模型的混淆矩阵
# 7.1 绘制两个模型的混淆矩阵
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

for idx, (name, model) in enumerate([
    ('Logistic Regression', logreg),
    ('Random Forest', rf)
]):
    y_pred = model.predict(X_test)
    cm = confusion_matrix(y_test, y_pred)

    sns.heatmap(
        cm,
        annot=True,    # 在格子里写数字
        fmt='d',       # 整数格式
        cmap='Blues',
        ax=axes[idx],
        xticklabels=['Normal', 'Failure'],
        yticklabels=['Normal', 'Failure']
    )
    axes[idx].set_title(f'{name} Confusion Matrix')
    axes[idx].set_xlabel('Predicted')
    axes[idx].set_ylabel('Actual')

plt.tight_layout()
plt.show()
8. 特征重要性分析
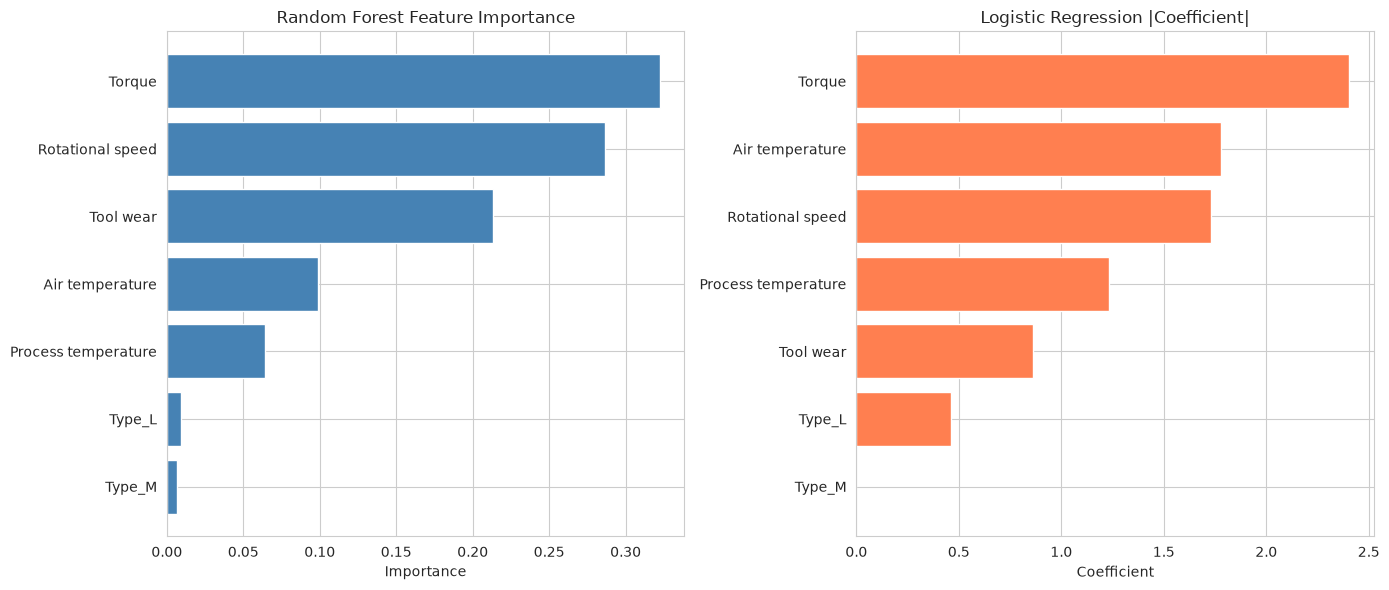
不同模型给出的“重要性”含义不同:
- 随机森林:
feature_importances_表示该特征在所有树中对降低不纯度的贡献。 - 逻辑回归:
|coef_|表示特征对预测结果的影响大小(绝对值越大,影响越强)。
两者量纲不同,所以分开画两张图,各自排序即可。
8.1 提取两个模型的特征重要性
# 8.1 提取两个模型的特征重要性
rf_importance = rf.named_steps['classifier'].feature_importances_
lr_importance = np.abs(logreg.named_steps['classifier'].coef_[0])

importance_df = pd.DataFrame({
    'Feature': feature_names,
    'Random Forest': rf_importance,
    'Logistic Regression': lr_importance
})

print(importance_df.round(4))
8.2 可视化特征重要性
通过水平条形图对比各特征在两个模型中的重要性。
# 8.2 可视化特征重要性
fig, axes = plt.subplots(1, 2, figsize=(14, 6))

# 随机森林特征重要性
rf_sorted = importance_df.sort_values('Random Forest', ascending=True)
axes[0].barh(rf_sorted['Feature'], rf_sorted['Random Forest'], color='steelblue')
axes[0].set_title('Random Forest Feature Importance')
axes[0].set_xlabel('Importance')

# 逻辑回归系数绝对值
lr_sorted = importance_df.sort_values('Logistic Regression', ascending=True)
axes[1].barh(lr_sorted['Feature'], lr_sorted['Logistic Regression'], color='coral')
axes[1].set_title('Logistic Regression |Coefficient|')
axes[1].set_xlabel('Coefficient')

plt.tight_layout()
plt.show()

# 输出最重要的特征
top_rf = importance_df.sort_values('Random Forest', ascending=False).iloc[0]
top_lr = importance_df.sort_values('Logistic Regression', ascending=False).iloc[0]
print(f"随机森林认为最重要的特征:{top_rf['Feature']}(重要性 {top_rf['Random Forest']:.4f})")
print(f"逻辑回归认为最重要的特征:{top_lr['Feature']}(|系数| {top_lr['Logistic Regression']:.4f})")
9. 结论
-
数据不平衡
Machine failure正样本仅占约 3.4%。评估模型时应重点看 Precision / Recall / F1,而不是单纯 Accuracy。 -
模型表现
- 逻辑回归:召回率高(约 0.82),但精确率低(约 0.14),会误报很多正常设备为故障。
- 随机森林:Accuracy 约 0.98,Precision 约 0.75,Recall 约 0.71,F1 约 0.73,整体表现更好,是更优选择。
-
关键特征
两个模型一致认为Torque(扭矩) 是最重要的预测特征:- 随机森林重要性:0.3224
- 逻辑回归 |系数|:2.4053
其次是
Rotational speed(转速)和Tool wear(刀具磨损)。 -
后续可优化方向
- 调整分类阈值,在“误报”和“漏报”之间取得业务平衡
- 尝试 SMOTE 等过采样方法
- 使用 XGBoost / LightGBM 等更强的模型
- 把问题转化为异常检测,专门识别罕见的故障模式
10. 进一步优化方向测试
根据第 9 节结论里的建议,这里对四个优化方向进行实际测试:
- 调整分类阈值:在误报和漏报之间取得业务平衡
- SMOTE 过采样:缓解类别不平衡
- XGBoost / LightGBM:尝试更强的树模型
- 异常检测:用无监督方法专门识别罕见故障模式
更多推荐


 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)