
云服务器跑LiveTalking数字人连不上?两个 TCP 端口全搞定
在云 GPU 服务器上跑 LiveTalking 数字人,最崩溃的瞬间不是模型加载慢,而是——画面推不出去。
WebRTC 默认走 UDP,而 AutoDL、企业防火墙、家庭对称型 NAT,统统把 UDP 封得死死的。你兴冲冲部署好,浏览器一打开:黑屏、转圈、连不上。端口开了几十个还是不行?其实你只需要开放两个 TCP 端口:nginx 服务端口和 MediaMtx 的媒体端口。
为什么 WebRTC 这么"挑剔"
WebRTC 媒体流默认用 UDP(SRTP)传输,还要做 ICE 连通性检查,常常需要在 1~65535 整个 UDP 区间里"试端口"。在自有服务器上这没问题,但在云环境里:
-
算力平台(AutoDL 等):只放行少量 TCP 端口,UDP 基本全封;
-
企业网络:防火墙策略严格,UDP 入站直接拒绝;
-
家庭宽带:对称型 NAT,UDP 穿透几乎必败。
结果就是——服务端在,客户端也在,但媒体流就是过不去。
MediaMtx 代理:把 UDP 流"拐"进 TCP
MediaMtx 是一个开源媒体服务器,原生支持 WebRTC,关键能力是可以通过 TCP 传输 WebRTC 媒体(webrtcLocalTCPAddress)。
部署思路如下:
-
LiveTalking 把数字人画面作为 WebRTC 源,推给同机的 MediaMtx;
-
MediaMtx 按客户端请求,主动从 LiveTalking 拉流;
-
然后 MediaMtx 以 WHEP 协议,通过单个 TCP 媒体端口(例如
:8189)对外服务; -
客户端浏览器只跟 nginx 和这个 TCP 端口打交道。
换句话说,对外只暴露两个 TCP 端口(nginx 服务端口 + MediaMtx 媒体端口),UDP 那一套全在服务器内网闭环,根本不需要出网。
三种方案对比,看清差异
LiveTalking 的网络部署有三套方案:
| 方案 | 需开放端口 | 适用环境 |
|---|---|---|
| A. WebRTC 全端口 | TCP 8010 + UDP 1-65536 | 自有服务器 |
| B. MediaMtx 代理 | 2 个 TCP 端口(nginx 服务端口 + MediaMtx :8189) | 云环境 / 防火墙首选 |
| C. SRS中转 | 2 个 TCP 端口(nginx 服务端口 + srs :8000) | 需要用rtcpush推流模式 |
方案 B 的核心优势:在 AutoDL 这类只给 TCP 的环境里,它几乎是唯一能跑通 WebRTC 推流的方案。MediaMtx 主动拉流 + TCP 承载,天然绕开 UDP 封锁和对称 NAT 穿透难题——UDP 被拒就换 TCP,客户端连的是 TCP,穿透难度天差地别。
offer 接口 vs WHEP 接口:差在哪
LiveTalking 默认是直连方式:前端把 WebRTC 的 SDP offer 直接 POST 到 LiveTalking 自己的 /offer(或类似自定义)接口(:8010),LiveTalking 作为 WebRTC 对端直接回 answer,随后把数字人画面用 UDP 推给浏览器。这条链路里,浏览器和 LiveTalking 是直接点对点的连接,所有 ICE、NAT 穿透、UDP 端口问题都得自己扛。
WHEP(WebRTC-HTTP Egress Protocol,RFC 8865)是一套标准化的 WebRTC 信令协议:客户端把 SDP offer 用一次 HTTP POST 发给服务端 WHEP 端点,服务端回 answer,并给一个资源 URL 用于断开。它把"建连"变成了一个简单的 HTTP 请求。
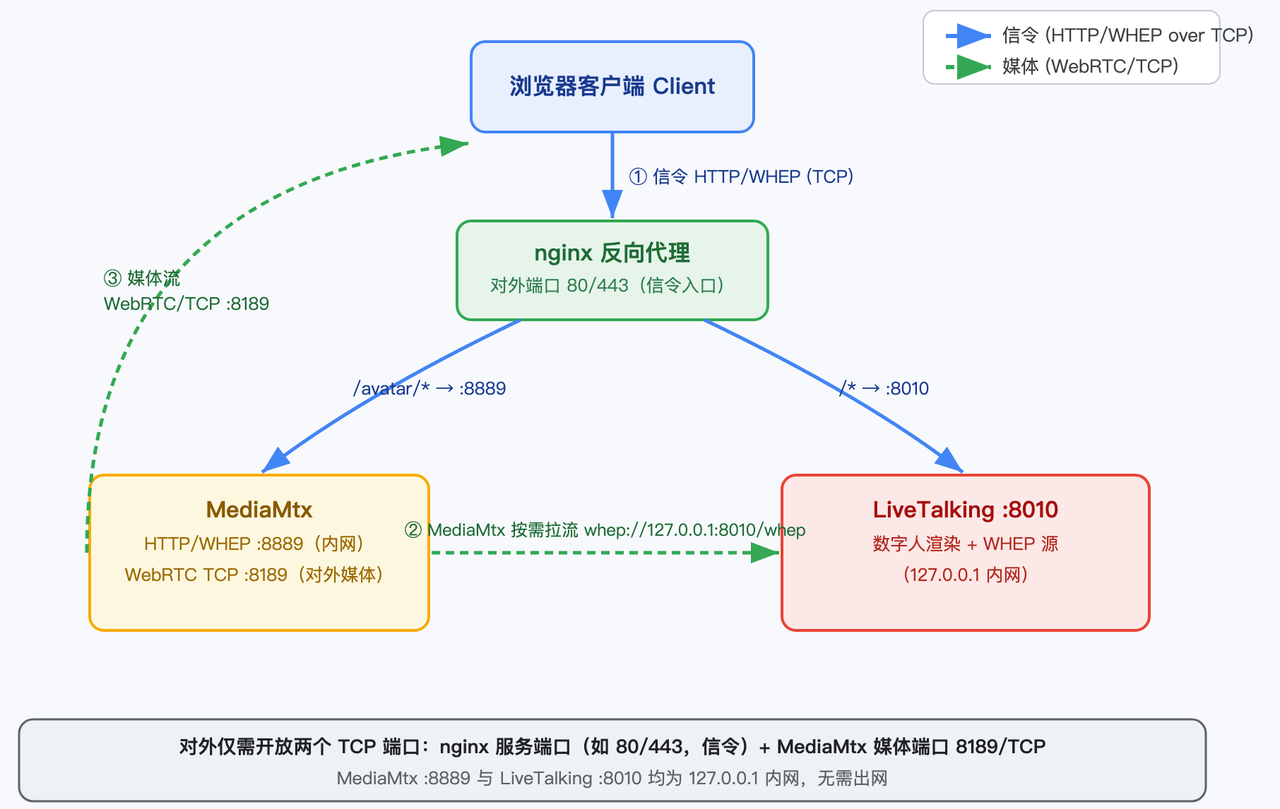
引入 MediaMtx 后,WHEP 端点从 LiveTalking 转移到了 MediaMtx 上:客户端不再直连 LiveTalking,而是把 offer 发给 MediaMtx 的 /avatar/<sessionid>/whep;MediaMtx 作为面向客户端的 WebRTC 对端,再用 WHEP 客户端身份反向去 LiveTalking 的 whep://127.0.0.1:8010/whep 拉流。区别一目了然:
-
offer 接口:客户端 ↔ LiveTalking 直连,LiveTalking 既是业务端又是 WebRTC 对端,媒体走 UDP 直推;
-
WHEP 接口(经 MediaMtx):客户端 ↔ MediaMtx(WebRTC 对端,TCP
:8189),MediaMtx ↔ LiveTalking(内网 WHEP 拉流:8010)。媒体流量被 MediaMtx 兜了一层,对外只走 TCP。
一句话:offer 接口是"客户端直接怼 LiveTalking",WHEP 接口是"客户端怼 MediaMtx,MediaMtx 再去怼 LiveTalking"——多了一跳,但换来了只用 TCP 端口的部署自由。
配置实战:三处改动
① MediaMtx(mediamtx.yml) — 关掉 UDP(webrtcLocalUDPAddress: ""),只留 TCP(:8189);path 用正则 ~^avatar/(.+)$,每个 sessionid 对应独立的 source 连接,source 指向 LiveTalking 的 WHEP:
# mediamtx.yml
webrtcLocalUDPAddress: ""
webrtcLocalTCPAddress: :8189  # 配置 tcp 映射端口
webrtcAdditionalHosts: []      # 配置外网 ip 地址

paths:
  # 用正则匹配:每个不同的 sessionid 创建独立的 source 连接
  # 客户端访问: /avatar/<sessionid>/whep?avatar=xxx&tts=yyy
  # $G1 = sessionid, $MTX_QUERY = avatar=xxx&tts=yyy
  ~^avatar/(.+)$:
    source: whep://127.0.0.1:8010/whep?sessionid=$G1&$MTX_QUERY
    sourceOnDemand: yes
② nginx(/etc/nginx/sites-enabled/default) — /avatar 全部转发到 MediaMtx 的 HTTP 端口(:8889),其余(/)转发到 LiveTalking(:8010):
server {
    # /avatar 路由 → MediaMtx
    location ^~ /avatar {
        proxy_pass http://127.0.0.1:8889;
    }
    location / {
        rewrite ^/$ /index-whep.html break;
        proxy_pass http://127.0.0.1:8010;
    }
}
③ LiveTalking 前端 — 把原来访问 /offer 的接口改成访问 MediaMtx 上的 WHEP;sessionid 在客户端生成并拼进路径,参数走 query string,MediaMtx 再代理到 LiveTalking:
// 客户端生成 sessionid,放入路径中(每个不同 sessionid 独立 source 连接)
if (!sessionid) setSessionId(crypto.randomUUID());  // sessionid 在客户端生成
if (avatar) params.set('avatar', avatar);
if (refAudio) params.set('refaudio', refAudio);
if (refText) params.set('reftext', refText);

const queryString = params.toString(); // 参数配置在 query param
// 访问接口由 offer 改成访问 mediamtx 上的 whep,由 mediamtx 代理到 livetalking
return fetch('/avatar/' + sessionid + '/whep' + (queryString ? '?' + queryString : ''), {
    method: 'POST',
    headers: { 'Content-Type': 'application/sdp' },
    body: offer.sdp
});
原本要开的几万个 UDP 端口,被压缩成两个 TCP 端口(nginx 服务端口 + MediaMtx 媒体端口)——这就是 MediaMtx 代理的价值。
已在autodl上跑通整个流程,镜像地址https://www.codewithgpu.com/i/lipku/livetalking/base
下次在云上部署数字人推流卡住,别再死磕 UDP 了。一个 nginx,两个 TCP 端口,问题就解决了。
你踩过 WebRTC 端口的坑吗?用的是哪种方案?评论区聊聊 👇
LiveTalking — 开源实时交互数字人引擎。
GitHub:https://github.com/lipku/LiveTalking
文档:https://doc.livetalking.ai
更多推荐



 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)