
Spark 从筑基到化神
Spark 从零到进阶:数据开发工程师的系统学习指南
写在前面:如果你是一名刚接触 Spark 的数据开发工程师,面对网上零散的教程和概念感到无从下手,那么这篇文章就是为你准备的。我们将从"Spark 是什么"出发,一路走到性能调优与生产踩坑,配合大量代码示例和架构图,帮你建立完整的知识体系。本文基于 Spark 3.5.x 版本编写,并会提及 Spark 4.0 的预览方向。
目录
- Spark 概述
- Spark 架构与运行原理
- 环境搭建
- RDD 编程
- Spark SQL
- Spark Streaming vs Structured Streaming
- Spark 数据湖与 Lakehouse
- Spark 性能调优
- Spark 常见问题与踩坑
- 端到端实战项目
- Spark 3.x 新特性
- 学习路线与实战建议
1. Spark 概述
1.1 什么是 Spark
Apache Spark 是一个开源的统一分析引擎,专为大规模数据处理而设计。它最初于 2009 年在加州大学伯克利分校 AMPLab 诞生,2010 年开源,2014 年成为 Apache 顶级项目。Spark 提供了 SQL、流计算、机器学习和图计算等一整套大数据处理能力,可以运行在 Hadoop YARN、Kubernetes、Standalone 等多种集群管理器上。
1.2 发展历史
| 时间 | 里程碑 |
|---|---|
| 2009 | Spark 在 UC Berkeley AMPLab 诞生 |
| 2010 | BSD 许可开源 |
| 2013 | 捐赠给 Apache 软件基金会 |
| 2014 | Apache 顶级项目;Spark 1.0 发布 |
| 2016 | Spark 2.0:DataFrame/Dataset 成为主流 API,Structured Streaming |
| 2020 | Spark 3.0:AQE、Dynamic Partition Pruning |
| 2023 | Spark 3.4 / 3.5:Spark Connect 稳定、Pandas API 完善 |
| 2024+ | Spark 4.0 预览:更好的 ANSI SQL 兼容、性能持续优化 |
1.3 Spark vs Hadoop MapReduce
很多初学者会问"Spark 会替代 Hadoop 吗?"准确地说,Spark 替代的是 MapReduce 计算引擎,而 HDFS、YARN 依然是重要的存储和资源管理组件。
| 对比维度 | MapReduce | Spark |
|---|---|---|
| 中间结果 | 落盘(HDFS) | 优先内存,可溢写磁盘 |
| 编程模型 | Map + Reduce 两阶段 | DAG(有向无环图),多阶段 |
| 延迟 | 高(批处理) | 低(批流统一) |
| 迭代计算 | 每次迭代读写 HDFS | 内存缓存,迭代效率高 10-100x |
| 生态 | 仅 MapReduce | SQL/Streaming/ML/Graph 一体化 |
| 容错 | 基于磁盘复制 | RDD 血缘(Lineage)重算 |
1.4 核心特性
- 速度快:DAG 执行引擎 + 内存计算,比 MapReduce 快 10-100 倍
- 易用性:支持 Scala、Python、Java、R 四种语言 API,代码简洁
- 通用性:一站式覆盖批处理、SQL、流计算、ML、图计算
- 兼容性:可读写 HDFS、HBase、Cassandra、S3 等数据源,运行在 YARN/K8s/Standalone/Mesos 上
1.5 生态组件全景
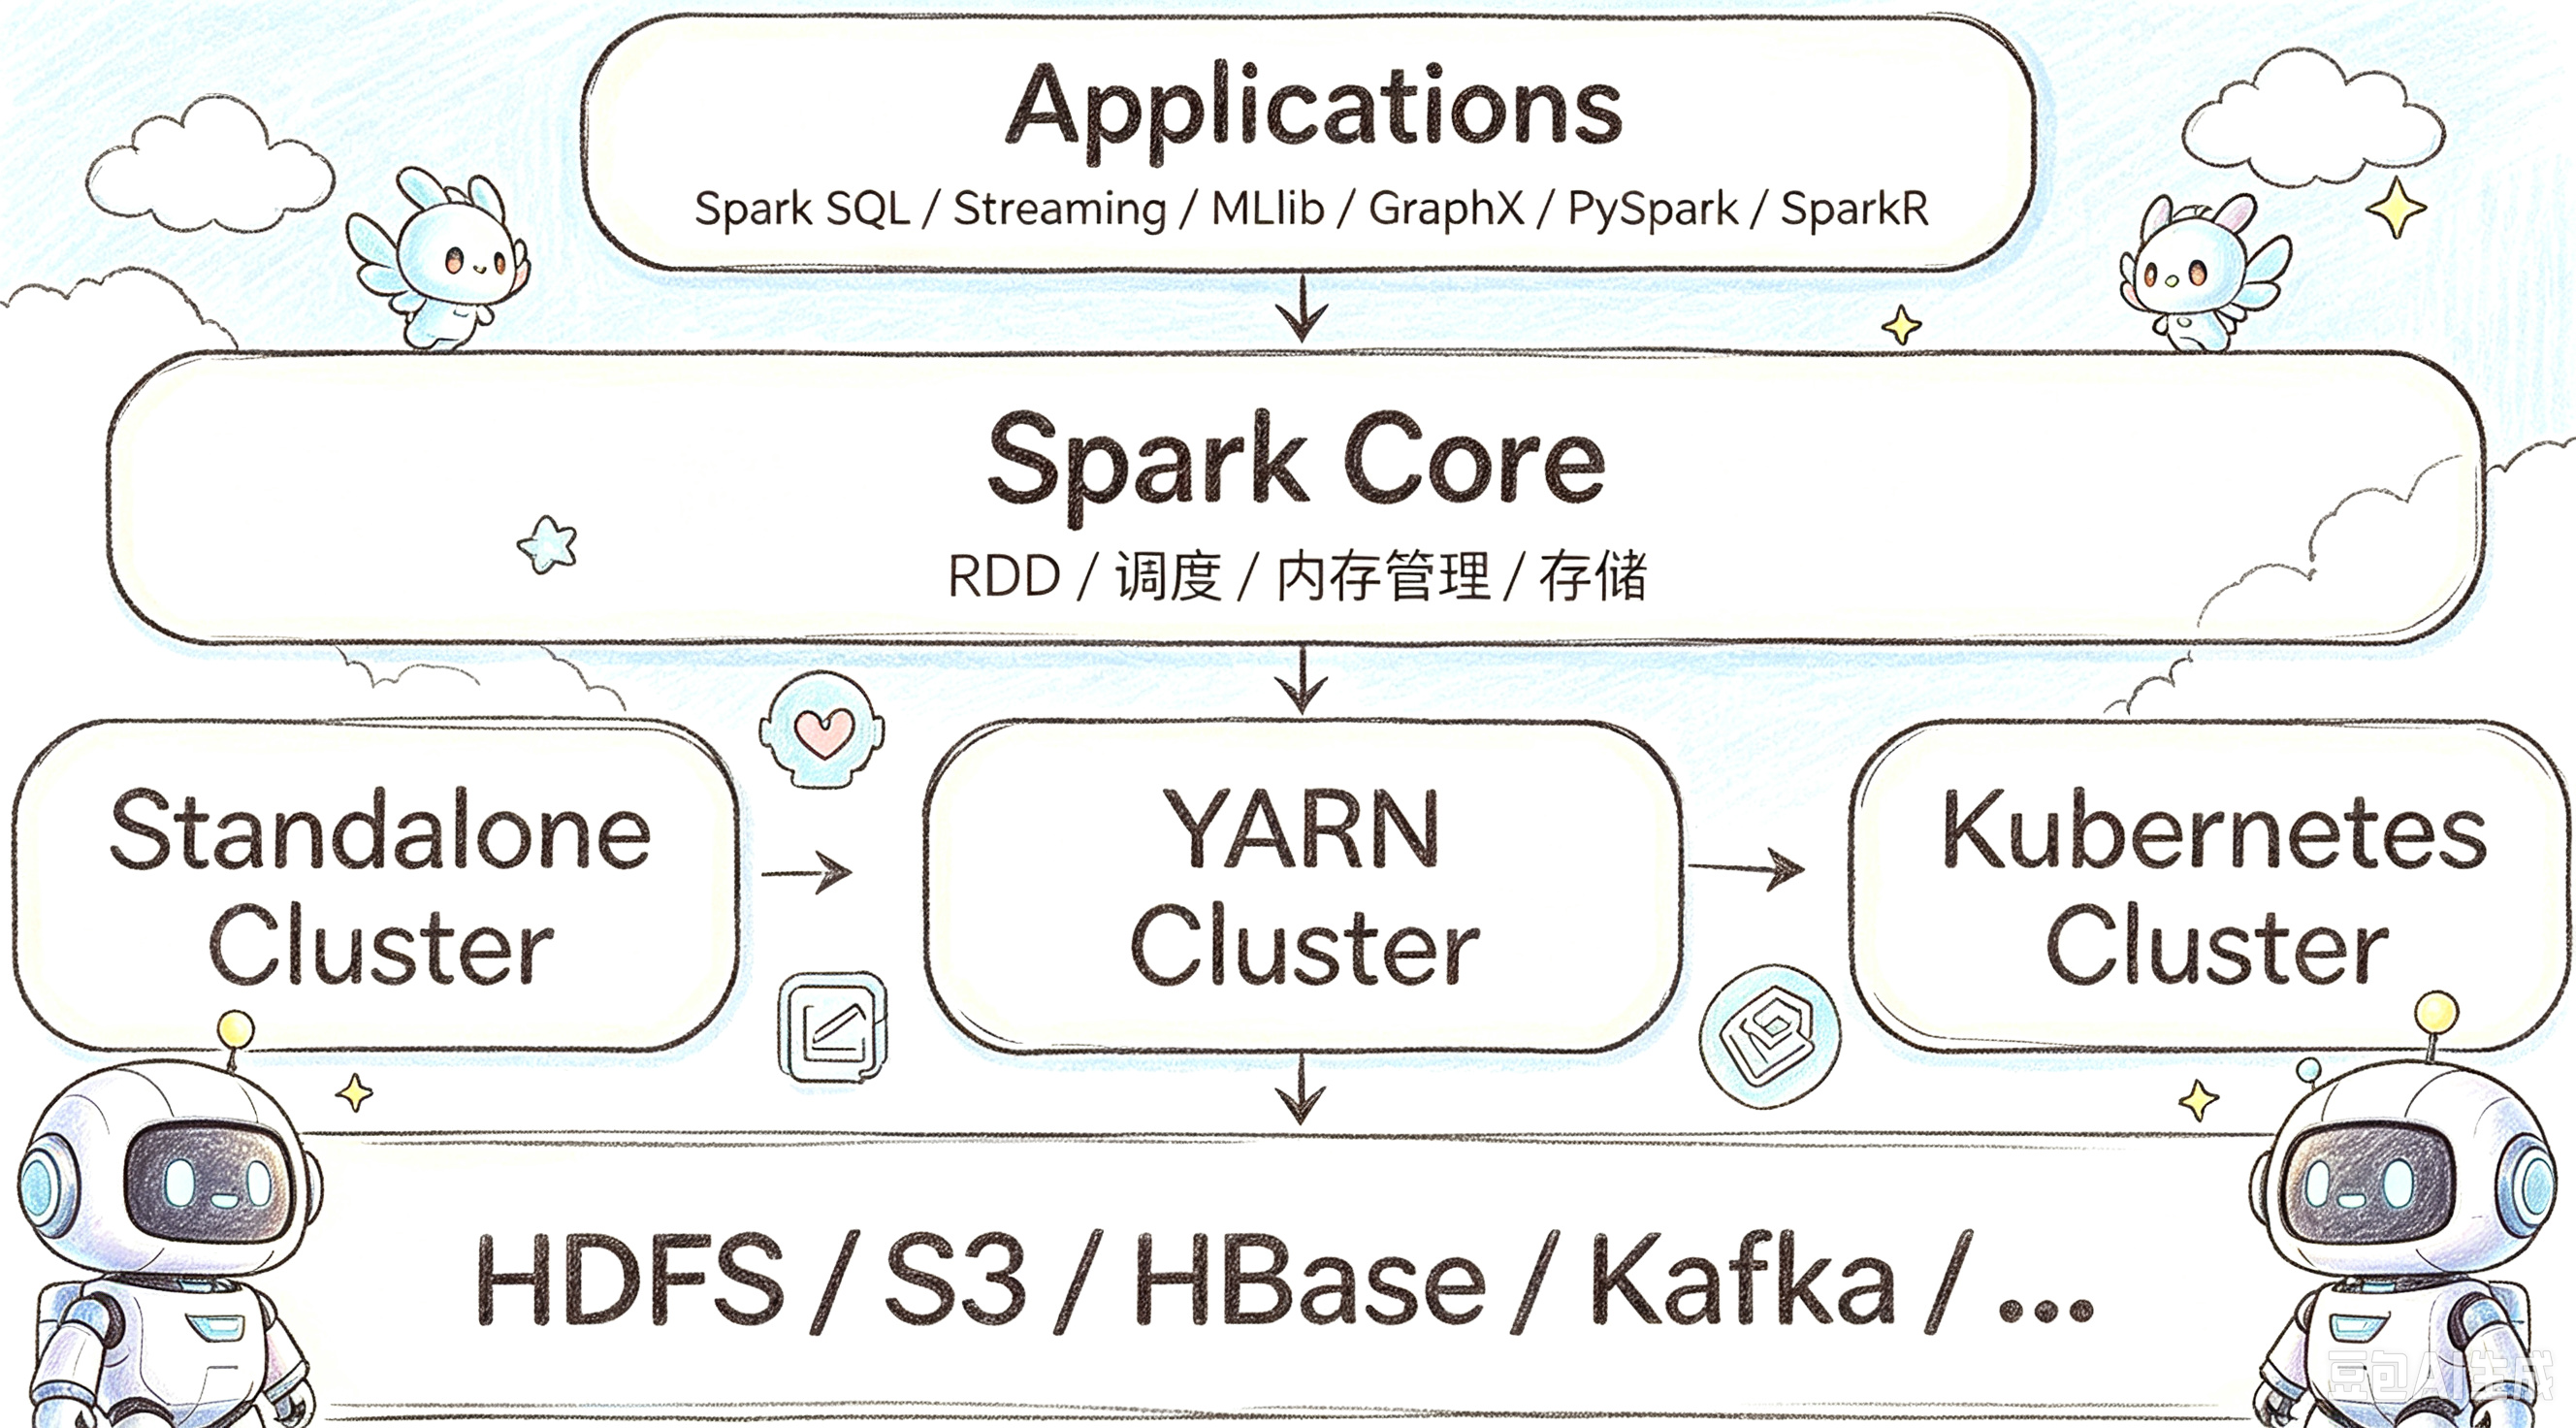
- Spark Core:底层引擎,提供 RDD 抽象、任务调度、内存管理、故障恢复
- Spark SQL:结构化数据处理,DataFrame/Dataset API,兼容 Hive
- Structured Streaming:基于 Spark SQL 的流计算引擎(原 Spark Streaming 已进入维护模式)
- MLlib:分布式机器学习库
- GraphX:图计算引擎
2. Spark 架构与运行原理
2.1 核心组件
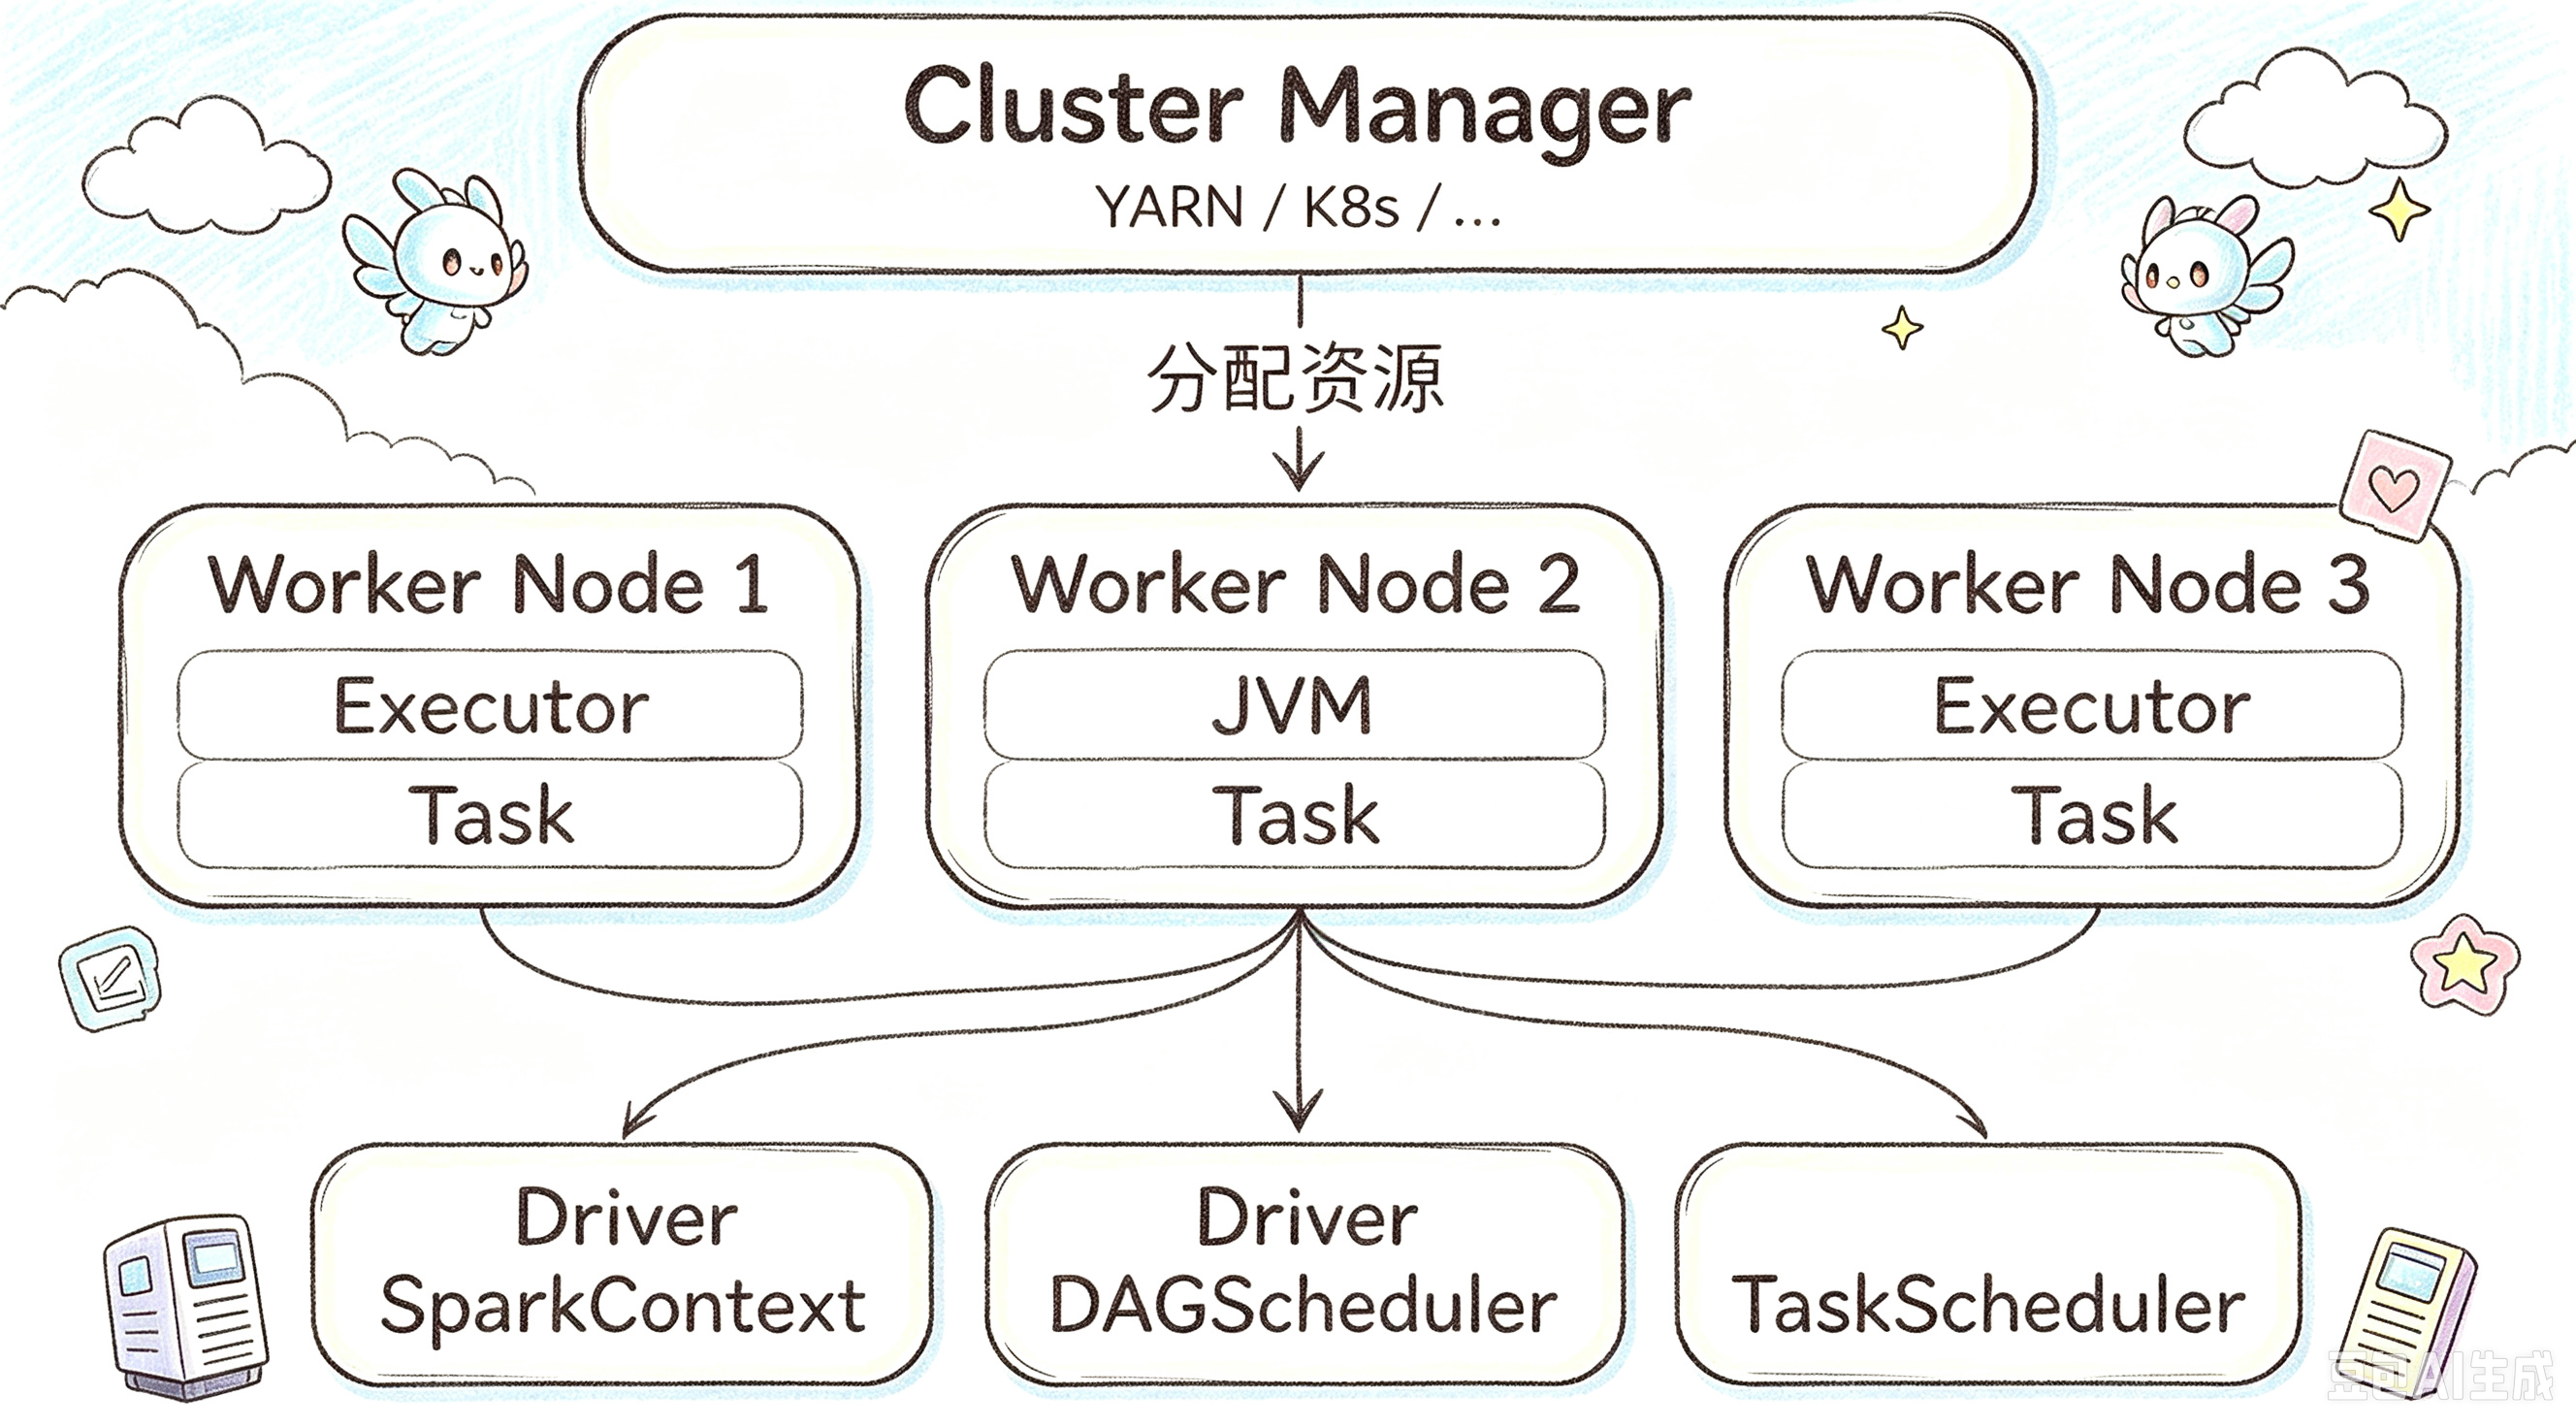
| 组件 | 职责 |
|---|---|
| Driver | 运行 main() 函数,创建 SparkContext,将用户程序转化为 DAG,调度 Task |
| Executor | 在 Worker 节点上启动的 JVM 进程,执行 Task 并缓存数据 |
| Cluster Manager | 集群资源管理器,负责分配 CPU/内存(YARN、K8s、Standalone) |
| Worker | 集群中可运行 Application 代码的节点 |
2.2 部署模式对比
| 模式 | 特点 | 适用场景 |
|---|---|---|
| Local | 单机运行,多线程模拟分布式 | 开发调试、学习 |
| Standalone | Spark 自带集群管理器 | 小规模独立集群 |
| On YARN | 复用 Hadoop YARN 资源管理 | 企业最常用,与 Hadoop 生态融合 |
| On Kubernetes | 容器化部署,弹性扩缩容 | 云原生环境,近年增长迅速 |
YARN 模式又分为 yarn-cluster(Driver 运行在 AM 中,适合生产)和 yarn-client(Driver 在客户端,适合交互调试)。
2.3 Job、Stage、Task 的划分
当一个 Action 算子被触发时,Spark 会提交一个 Job。DAGScheduler 根据 RDD 的依赖关系将 Job 划分为多个 Stage,每个 Stage 内创建一组 Task,由 TaskScheduler 分发到 Executor 执行。
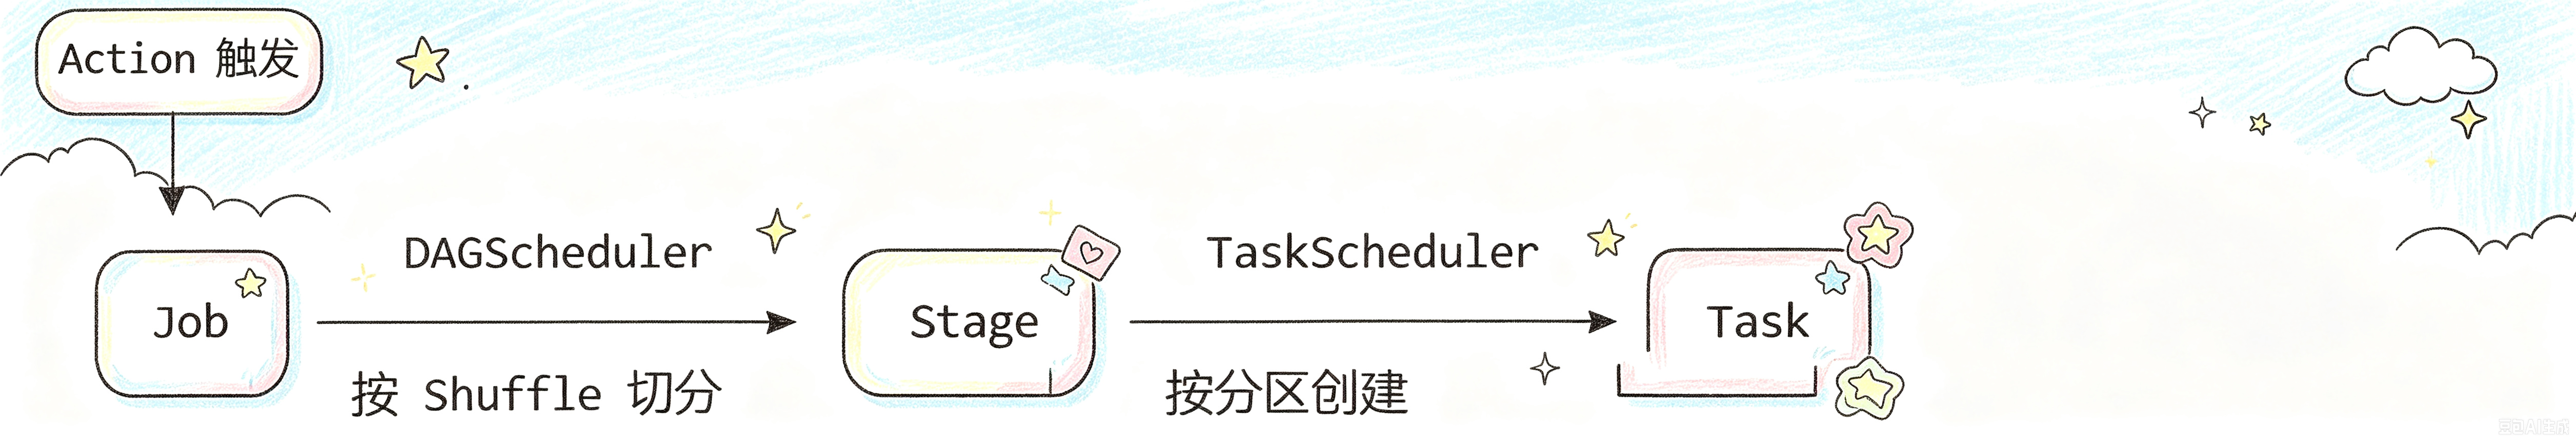
划分规则:
- 遇到宽依赖(Shuffle)就切分 Stage
- 一个 Stage 内的所有 Task 执行完全相同的代码,只是处理的数据分区不同
- Task 数量 = Stage 最后一个 RDD 的分区数
2.4 宽窄依赖与 Shuffle
| 类型 | 说明 | 典型算子 |
|---|---|---|
| 窄依赖 | 父 RDD 每个分区最多被子 RDD 一个分区使用 | map、filter、union、mapPartitions |
| 宽依赖 | 父 RDD 每个分区被子 RDD 多个分区使用,需要 Shuffle | reduceByKey、groupByKey、join、distinct、repartition |
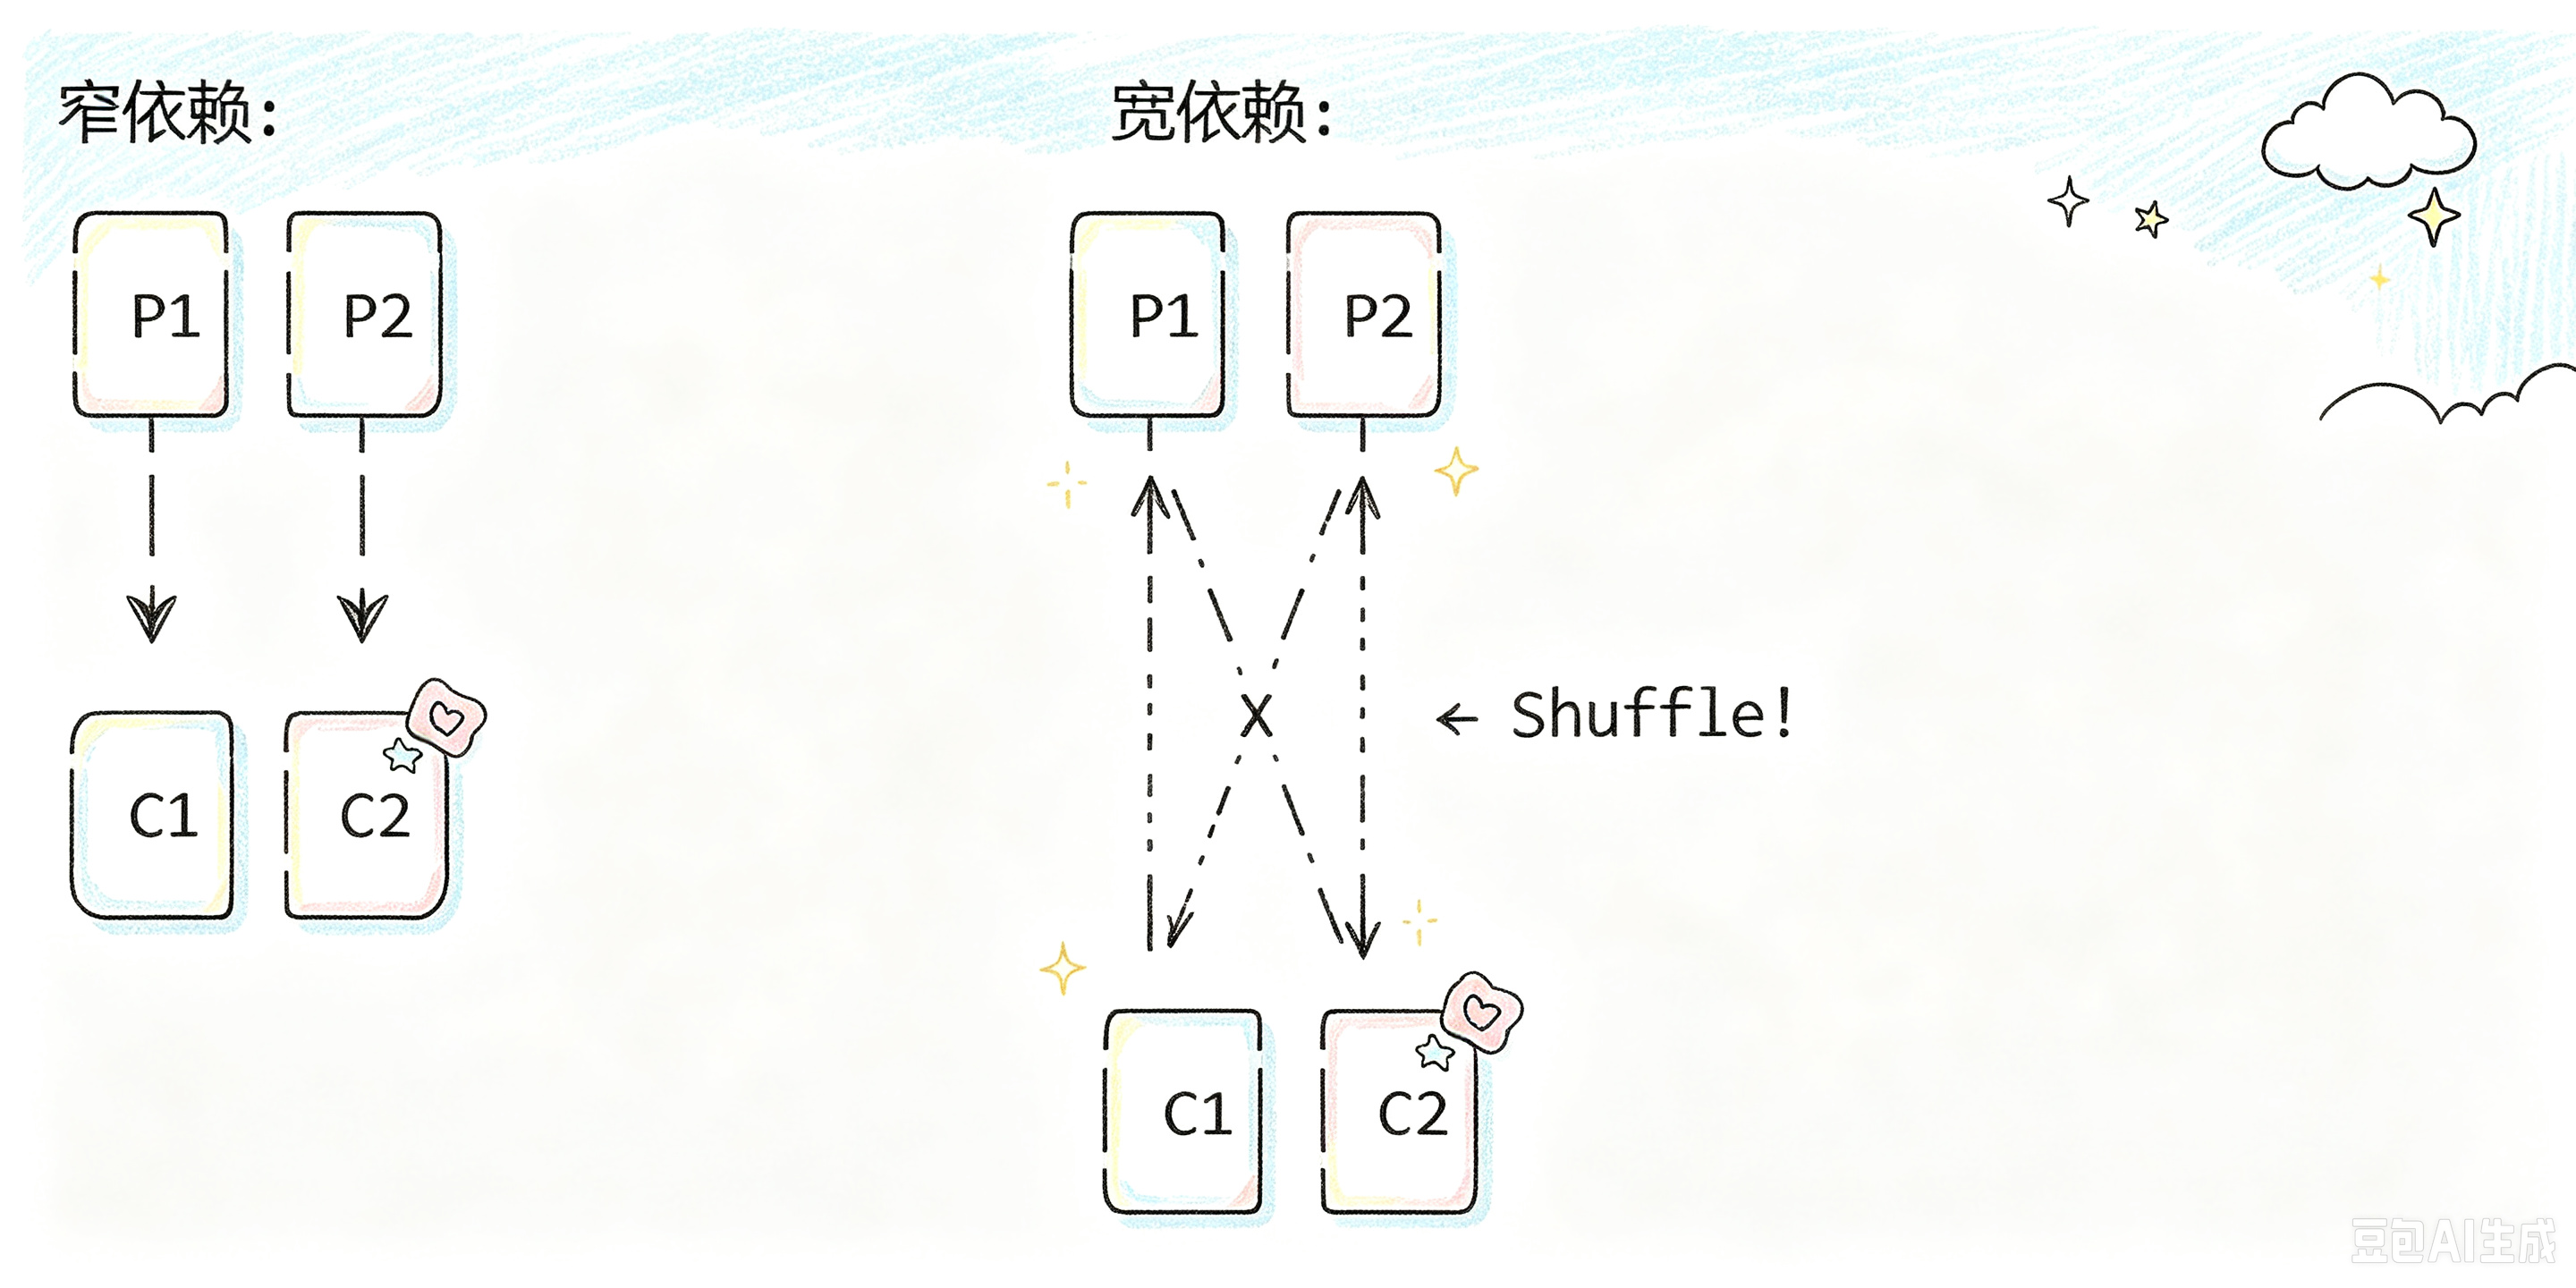
Shuffle 过程:Map 端将数据按 Key 写入磁盘缓冲区,经过排序、合并、溢写后产生 Shuffle 文件;Reduce 端通过 BlockManager 拉取属于自己的数据。Shuffle 涉及磁盘 I/O、网络 I/O 和数据序列化,是 Spark 性能瓶颈的主要来源。
2.5 统一内存模型(Spark 1.6+)
Spark Executor 的内存分为以下区域:
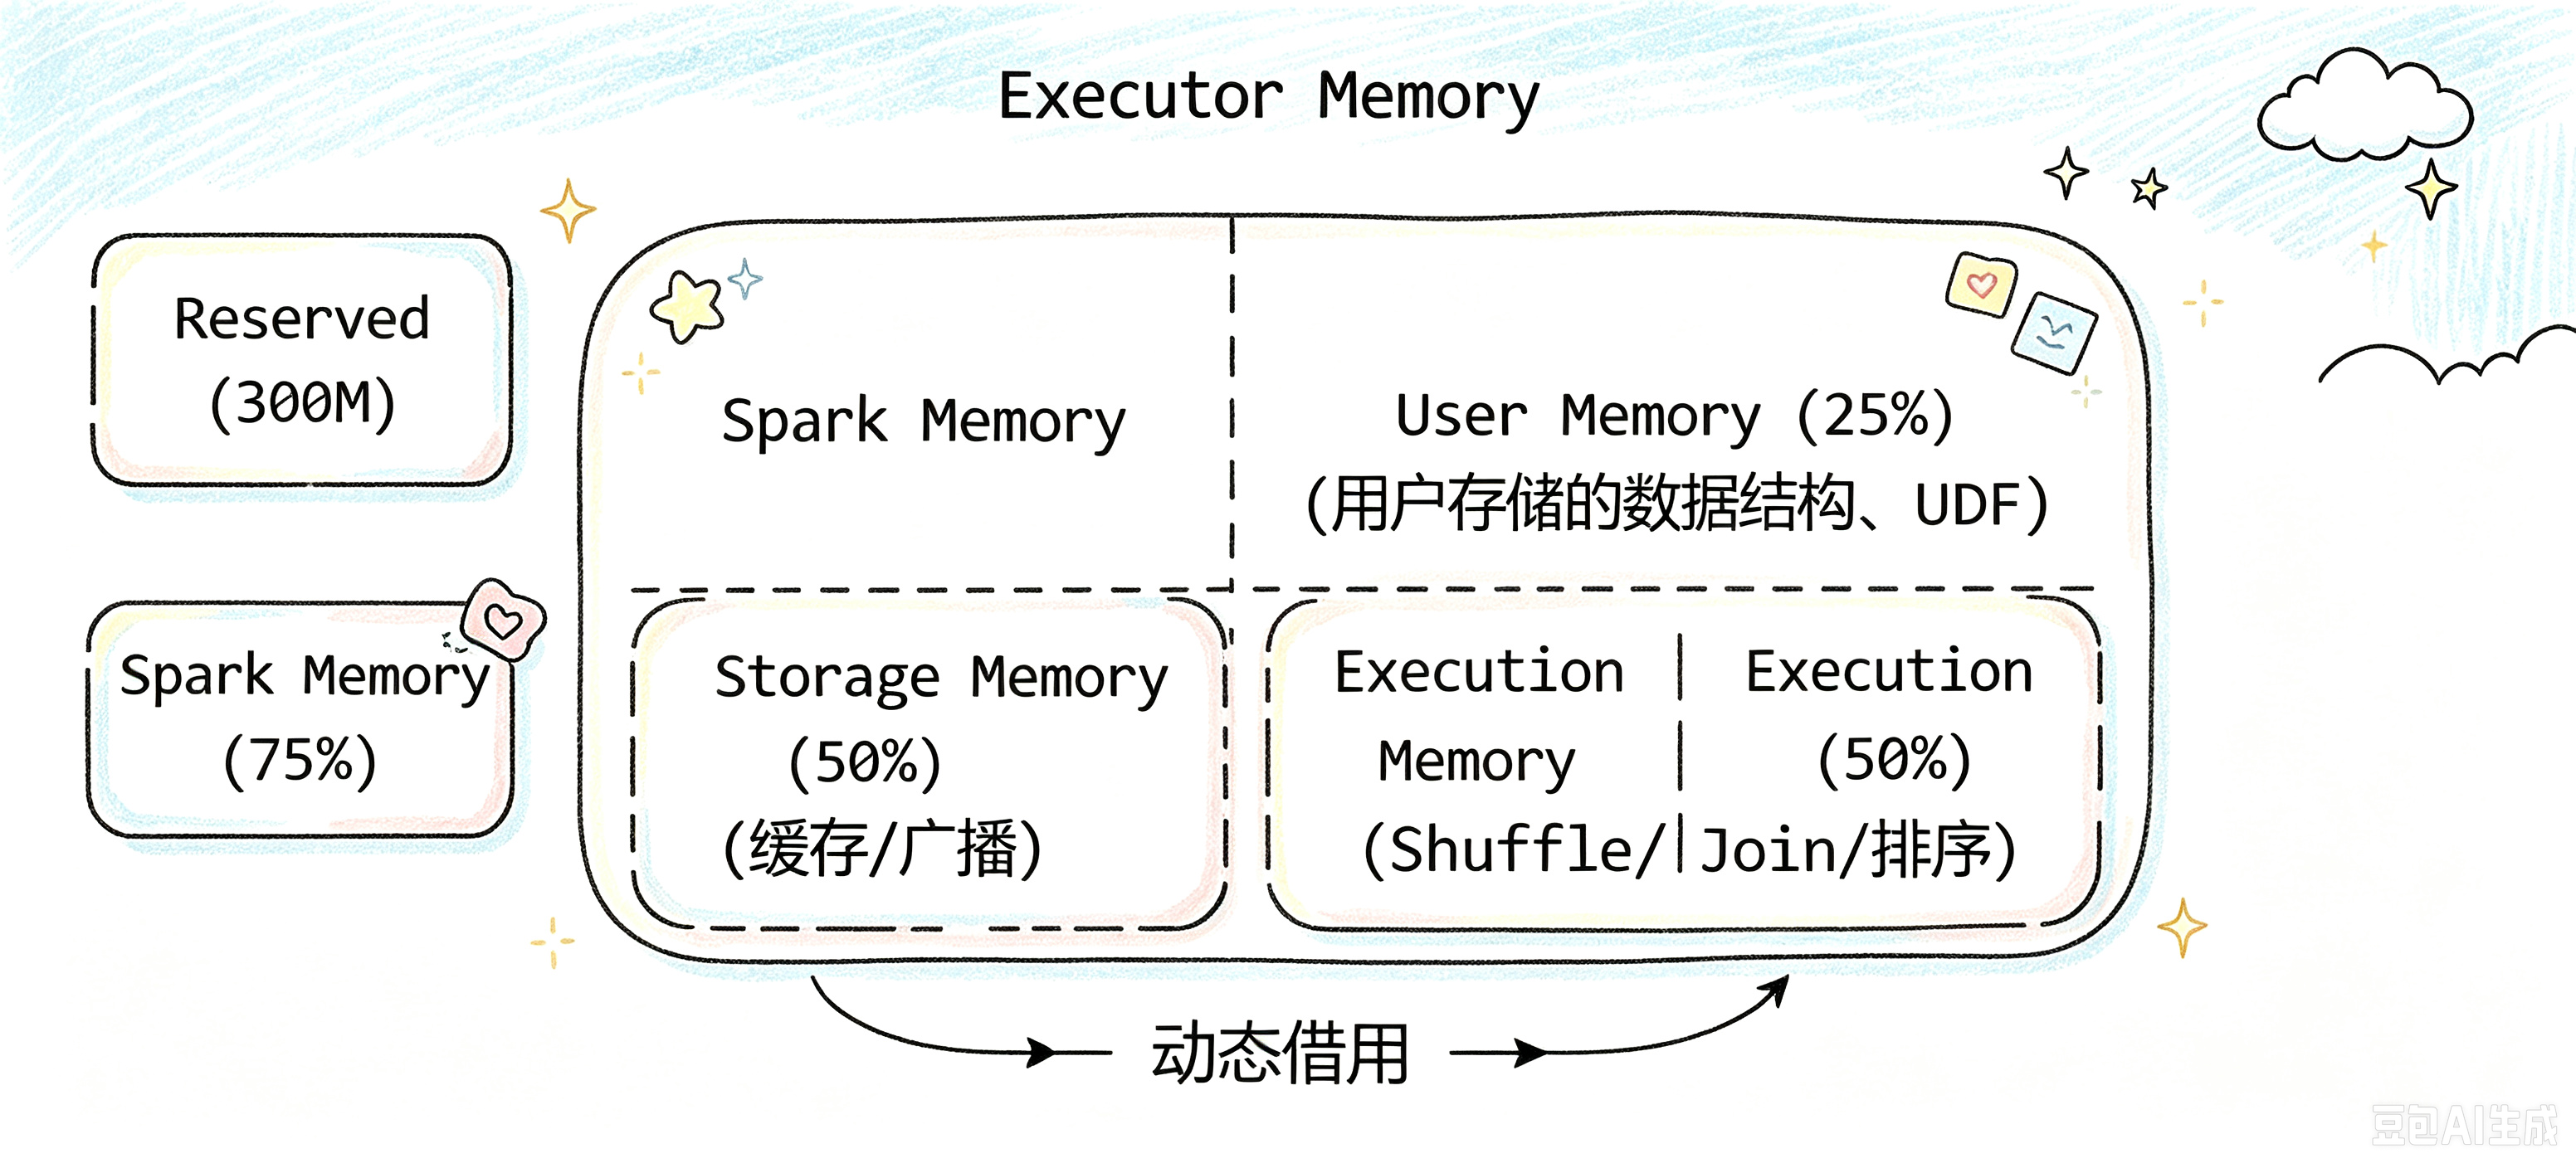
- Storage Memory:缓存 RDD、Broadcast 变量
- Execution Memory:Shuffle、Join、Sort 等执行过程中的临时数据
- 两者之间可以动态借用:Execution 可以借 Storage 的空闲内存,Storage 也可以借 Execution 的,但 Execution 优先级更高,Storage 被借走的部分在需要时会被淘汰
3. 环境搭建
3.1 Local 模式(最快上手)
# 下载(以 3.5.1 为例)
wget https://archive.apache.org/dist/spark/spark-3.5.1/spark-3.5.1-bin-hadoop3.tgz
tar -xzf spark-3.5.1-bin-hadoop3.tgz
cd spark-3.5.1-bin-hadoop3

# 启动 Spark Shell(Scala)
./bin/spark-shell --master local[*]

# 启动 PySpark
./bin/pyspark --master local[*]
local[*] 表示使用所有 CPU 核心。也可以用 local[2] 指定 2 个核心。
3.2 Standalone 模式
# 1. 配置 conf/spark-env.sh
cp conf/spark-env.sh.template conf/spark-env.sh
cat >> conf/spark-env.sh << 'EOF'
export SPARK_MASTER_HOST=master
export SPARK_WORKER_CORES=4
export SPARK_WORKER_MEMORY=8g
EOF

# 2. 配置 workers
echo "worker1" > conf/workers
echo "worker2" >> conf/workers

# 3. 启动集群
./sbin/start-all.sh

# 4. 提交应用
./bin/spark-submit \
  --master spark://master:7077 \
  --class com.example.MyApp \
  myapp.jar
3.3 On YARN 模式
确保 HADOOP_CONF_DIR 或 YARN_CONF_DIR 指向 Hadoop 配置目录:
export HADOOP_CONF_DIR=/etc/hadoop/conf

# 提交到 YARN(cluster 模式)
./bin/spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --driver-memory 2g \
  --executor-memory 4g \
  --executor-cores 2 \
  --num-executors 10 \
  myapp.py
3.4 Spark Shell 与 spark-submit
| 工具 | 用途 |
|---|---|
spark-shell | Scala 交互式 REPL,适合探索和调试 |
pyspark | Python 交互式 REPL |
spark-sql | SQL 交互式命令行 |
spark-submit | 提交应用到集群(生产环境) |
spark-submit 常用参数:
| 参数 | 说明 | 示例 |
|---|---|---|
--master | 集群管理器 URL | yarn / spark://host:7077 / local[*] |
--deploy-mode | Driver 运行位置 | cluster / client |
--name | 应用名称 | MySparkApp |
--class | Java/Scala 主类 | com.example.MyApp |
--jars | 额外依赖 JAR | --jars lib/mysql-connector.jar |
--packages | Maven 依赖自动下载 | --packages org.apache.spark:spark-sql-kafka-0-10_2.12:3.5.1 |
--files | 分发文件到工作目录 | --files config.properties |
--conf | Spark 配置项 | --conf spark.sql.shuffle.partitions=200 |
--driver-memory | Driver 内存 | 4g |
--executor-memory | 每个 Executor 内存 | 8g |
--executor-cores | 每个 Executor CPU 核数 | 4 |
--num-executors | Executor 数量(YARN) | 20 |
--total-executor-cores | 总核数(Standalone) | 100 |
--archives | 分发归档文件并解压 | --archives env.tar.gz#env |
--py-files | 额外 Python 文件/压缩包 | --py-files utils.zip |
3.5 PySpark 环境配置
# 方式一:pip 安装
pip install pyspark==3.5.1

# 方式二:使用 Spark 自带的 PySpark
export SPARK_HOME=/opt/spark
export PYTHONPATH=$SPARK_HOME/python:$SPARK_HOME/python/lib/py4j-0.10.9.7-src.zip:$PYTHONPATH
export PATH=$SPARK_HOME/bin:$PATH

# 验证
pyspark --version
在 Jupyter Notebook 中使用:
pip install jupyter
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS='notebook'
pyspark --master local[*]
3.6 Spark on Kubernetes
Kubernetes(K8s)已成为大数据上云的主流部署方式。Spark on K8s 从 Spark 2.3 开始支持,Spark 3.1 进入 GA,目前在云原生场景下增长迅速。
部署模式原理:
Spark on K8s 将 Driver 和 Executor 直接作为 Pod 运行在 K8s 集群中:
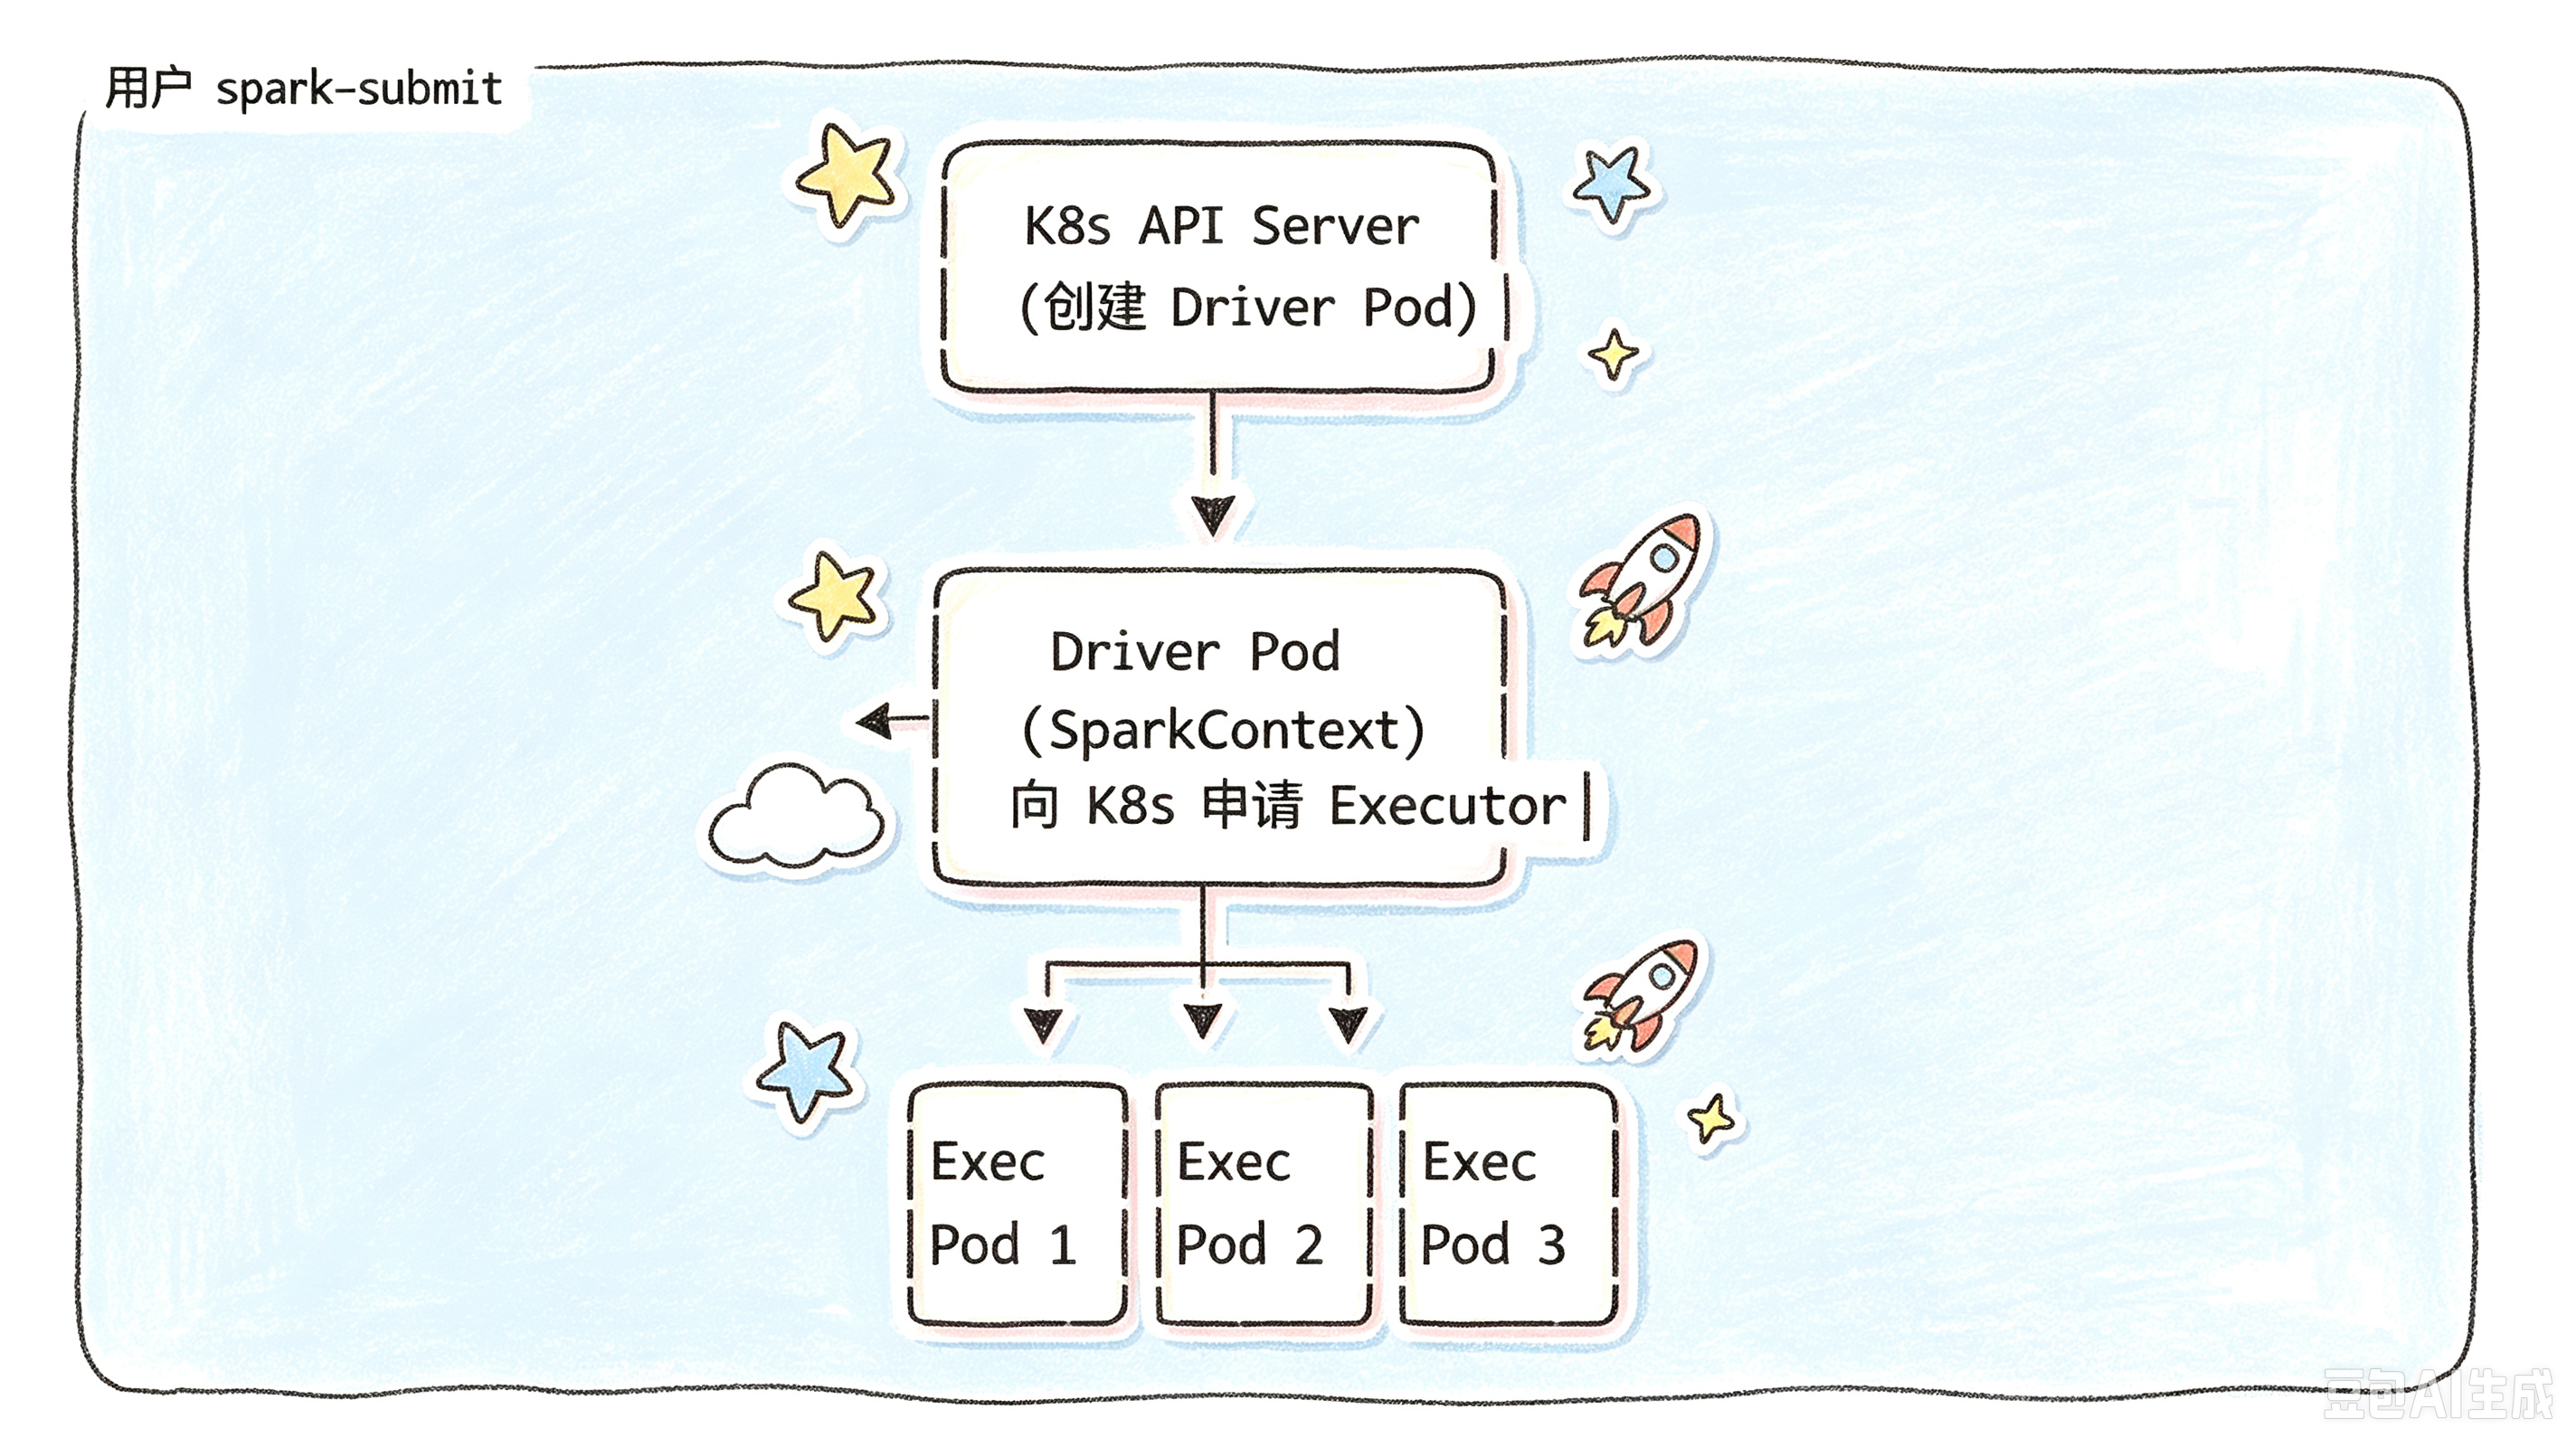
- Driver Pod 启动后,通过 K8s API 动态申请 Executor Pod
- Executor Pod 运行结束后自动销毁,资源归还 K8s
- 支持动态资源分配(Dynamic Allocation),按需扩缩容
与 YARN 模式对比:
| 对比维度 | Spark on YARN | Spark on K8s |
|---|---|---|
| 部署方式 | 依赖 Hadoop YARN 集群 | 容器化部署,镜像打包所有依赖 |
| 弹性扩缩容 | 依赖 YARN 队列配置,扩容较慢 | 秒级 Pod 创建,弹性能力强 |
| 资源隔离 | 队列级隔离,Container 共享 OS | Pod 级隔离,容器边界清晰 |
| 依赖管理 | 通过 --jars/--packages 分发 | 打包进 Docker 镜像,版本一致性好 |
| 生态融合 | 与 HDFS/Hive/HBase 深度集成 | 云原生生态(Prometheus/Istio/Envoy) |
| 运维复杂度 | Hadoop 运维体系成熟 | 需 K8s 运维能力,学习曲线稍陡 |
| 多租户 | YARN 队列 + Linux 用户 | Namespace + RBAC,隔离更彻底 |
| 适用场景 | 传统 Hadoop 集群、离线数仓 | 云原生、混合云、弹性计算、流批一体 |
spark-submit on K8s 命令示例:
./bin/spark-submit \
  --master k8s://https://<k8s-apiserver-host>:<port> \
  --deploy-mode cluster \
  --name spark-pi \
  --class org.apache.spark.examples.SparkPi \
  --conf spark.executor.instances=5 \
  --conf spark.executor.memory=4g \
  --conf spark.executor.cores=2 \
  --conf spark.kubernetes.container.image=registry.example.com/spark:3.5.1 \
  --conf spark.kubernetes.namespace=spark-jobs \
  --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark \
  --conf spark.kubernetes.driver.pod.name=spark-pi-driver \
  local:///opt/spark/examples/jars/spark-examples_2.12-3.5.1.jar
Docker 镜像构建要点:
# 基础镜像
FROM openjdk:11-jre-slim

# 安装 Spark
ARG SPARK_VERSION=3.5.1
ARG HADOOP_VERSION=3
RUN apt-get update && apt-get install -y curl tini && \
    curl -sL https://archive.apache.org/dist/spark/spark-${SPARK_VERSION}/spark-${SPARK_VERSION}-bin-hadoop${HADOOP_VERSION}.tgz | tar xz -C /opt && \
    ln -s /opt/spark-${SPARK_VERSION}-bin-hadoop${HADOOP_VERSION} /opt/spark && \
    apt-get clean

# 安装 Python(PySpark 场景)
RUN apt-get install -y python3 python3-pip && \
    pip3 install pyspark==${SPARK_VERSION} pandas pyarrow

# 拷贝自定义 JAR 依赖(如 JDBC 驱动、数据湖 SDK)
COPY jars/mysql-connector-j-8.0.33.jar /opt/spark/jars/
COPY jars/iceberg-spark-runtime-3.5_2.12-1.5.2.jar /opt/spark/jars/

# 拷贝应用 JAR
COPY app/your-app.jar /opt/spark/user-jars/

ENTRYPOINT ["/usr/bin/tini", "--"]
构建并推送镜像:
docker build -t registry.example.com/spark:3.5.1-custom .
docker push registry.example.com/spark:3.5.1-custom
K8s 特有配置参数:
| 参数 | 说明 | 示例 |
|---|---|---|
spark.kubernetes.container.image | Docker 镜像地址 | registry/spark:3.5.1 |
spark.kubernetes.namespace | K8s 命名空间 | spark-jobs |
spark.kubernetes.authenticate.driver.serviceAccountName | Driver 使用的 ServiceAccount | spark |
spark.kubernetes.driver.pod.name | Driver Pod 名称 | spark-app-driver |
spark.kubernetes.executor.podNamePrefix | Executor Pod 名称前缀 | spark-app-exec |
spark.kubernetes.driver.limit.cores | Driver CPU 限制 | 2 |
spark.kubernetes.executor.limit.cores | Executor CPU 限制 | 4 |
spark.kubernetes.driver.request.cores | Driver CPU 请求 | 1 |
spark.kubernetes.executor.request.cores | Executor CPU 请求 | 2 |
spark.kubernetes.memoryOverheadFactor | 堆外内存比例 | 0.2 |
spark.kubernetes.allocation.batch.size | 每批申请 Pod 数 | 10 |
spark.kubernetes.executor.deleteOnTermination | 完成后删除 Executor Pod | true |
spark.kubernetes.driver.podTemplateFile | Driver Pod 模板文件 | driver-pod.yaml |
spark.kubernetes.executor.podTemplateFile | Executor Pod 模板文件 | executor-pod.yaml |
spark.kubernetes.file.upload.path | 应用依赖上传路径 | s3://spark-uploads/ |
spark.kubernetes.authenticate.caCertFile | CA 证书路径 | /var/run/secrets/... |
适用场景:
- 云原生架构:与公司现有 K8s 平台统一运维,避免 Hadoop/YARN 独立集群
- 弹性扩缩容:利用 K8s Cluster Autoscaler,根据负载自动增减节点,降低成本
- 混合云/多云:同一镜像在不同云厂商 K8s 集群运行,避免厂商锁定
- 流批一体:Streaming 长任务与离线批任务共享 K8s 资源池,通过 Namespace/Quota 隔离
- 依赖隔离:不同应用使用不同镜像,彻底解决"一个集群多版本依赖冲突"问题
💡 生产建议:K8s 上建议启用 External Shuffle Service(或使用 Spark 3.0+ 的 Shuffle Data on PVC 方案),开启 Dynamic Allocation,并配置 Pod 模板以挂载共享存储(如 HDFS/S3/OSS)。
4. RDD 编程
虽然现在 Spark SQL/DataFrame 是主流 API,但理解 RDD(Resilient Distributed Dataset,弹性分布式数据集)是掌握 Spark 底层原理的关键。
4.1 RDD 五大特性
- 分区列表(Partitions):数据被切分为多个分区,每个分区在一个节点上计算
- 计算函数(Compute):每个分区都有一个计算函数来生成数据
- 依赖关系(Dependencies):RDD 之间有血缘关系,用于故障恢复
- 分区器(Partitioner):KV 类型 RDD 可选(Hash/Range),决定数据分布
- 优先位置(Preferred Locations):每个分区的计算优先调度到数据所在节点
4.2 创建 RDD
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("RDDDemo").master("local[*]").getOrCreate()
sc = spark.sparkContext

# 方式一:从集合创建
rdd = sc.parallelize([1, 2, 3, 4, 5], numSlices=3)

# 方式二:从外部存储创建
rdd = sc.textFile("hdfs:///data/input.txt")
rdd = sc.wholeTextFiles("hdfs:///data/logs/")  # 读取目录下所有文件
4.3 Transformation vs Action
Transformation 是懒执行的,只记录转换逻辑,不立即计算;Action 触发真正的计算。
| 类型 | 常见算子 |
|---|---|
| Transformation | map、filter、flatMap、mapPartitions、sample、union、intersection、distinct、groupByKey、reduceByKey、aggregateByKey、sortByKey、join、cogroup、cartesian、coalesce、repartition |
| Action | collect、count、take、first、takeOrdered、reduce、fold、aggregate、foreach、saveAsTextFile、countByKey、collectAsMap |
# Transformation 示例
nums = sc.parallelize([1, 2, 3, 4, 5, 6])

# map:一对一转换
squares = nums.map(lambda x: x * x)        # [1, 4, 9, 16, 25, 36]

# filter:过滤
evens = nums.filter(lambda x: x % 2 == 0)  # [2, 4, 6]

# flatMap:一对多展平
lines = sc.parallelize(["hello world", "hello spark"])
words = lines.flatMap(lambda line: line.split(" "))
# ["hello", "world", "hello", "spark"]

# reduceByKey:按 Key 聚合(Map 端预聚合,性能优于 groupByKey)
pairs = words.map(lambda w: (w, 1))
counts = pairs.reduceByKey(lambda a, b: a + b)
# [("hello", 2), ("world", 1), ("spark", 1)]

# join
rdd1 = sc.parallelize([("a", 1), ("b", 2)])
rdd2 = sc.parallelize([("a", "x"), ("b", "y"), ("b", "z")])
rdd1.join(rdd2).collect()
# [("a", (1, "x")), ("b", (2, "y")), ("b", (2, "z"))]

# sortByKey
sorted_counts = counts.sortByKey(ascending=True)

# Action 示例
print(counts.collect())      # 返回所有结果到 Driver
print(counts.count())        # 元素数量
print(counts.take(2))        # 取前 2 个
print(counts.first())        # 第一个
total = nums.reduce(lambda a, b: a + b)  # 聚合
counts.saveAsTextFile("hdfs:///output/wordcount")
4.4 reduceByKey vs groupByKey
这是面试高频考点:
| 对比 | reduceByKey | groupByKey |
|---|---|---|
| Map 端预聚合 | ✅ 有(Combiner) | ❌ 无 |
| Shuffle 数据量 | 小 | 大 |
| 性能 | 好 | 差 |
| 适用场景 | 聚合类操作 | 需要遍历所有值的场景 |
优先使用 reduceByKey / aggregateByKey / foldByKey,它们会在 Map 端做预聚合。
4.5 持久化:cache / persist / checkpoint
from pyspark import StorageLevel

# cache() = persist(MEMORY_ONLY)
rdd.cache()

# persist 支持多种存储级别
rdd.persist(StorageLevel.MEMORY_AND_DISK)      # 内存不够溢写磁盘
rdd.persist(StorageLevel.MEMORY_ONLY_SER)      # 序列化后存内存,节省空间
rdd.persist(StorageLevel.MEMORY_AND_DISK_SER_2) # 序列化 + 磁盘 + 2 副本

# 解除缓存
rdd.unpersist()

# checkpoint:将 RDD 写入 HDFS 等可靠存储,切断血缘
sc.setCheckpointDir("hdfs:///checkpoint")
rdd.checkpoint()
| 方式 | 存储位置 | 血缘 | 适用场景 |
|---|---|---|---|
| cache | 内存 | 保留 | 频繁重用的小数据 |
| persist | 内存/磁盘可选 | 保留 | 根据数据量选择 |
| checkpoint | HDFS | 切断 | 长血缘链、迭代计算 |
4.6 共享变量
默认情况下,Spark 会把函数中用到的变量拷贝到每个 Task,Task 对变量的修改不会回传 Driver。共享变量提供了两种特殊机制:
Broadcast Variable(广播变量):将只读变量缓存到每个 Executor,而不是每个 Task 一份,大幅减少数据传输。
# 大数据量的查找表
lookup_table = {"US": "United States", "CN": "China", "JP": "Japan"}
bc_var = sc.broadcast(lookup_table)

rdd = sc.parallelize(["US", "CN", "JP"])
result = rdd.map(lambda code: bc_var.value.get(code, code)).collect()
# ["United States", "China", "Japan"]
Accumulator(累加器):分布式计数器,只能在 Executor 端 add,在 Driver 端读取 value。
accum = sc.accumulator(0)

def process_line(line):
    global accum
    if "ERROR" in line:
        accum.add(1)
    return line

sc.textFile("hdfs:///logs/app.log").map(process_line).count()
print(f"Error count: {accum.value}")
⚠️ 注意:Accumulator 在 Transformation 中可能因 Task 重试导致重复计数,建议在 Action(如 foreach)中使用,或使用 Named Accumulator 并在 Driver 端确认只读取一次。
5. Spark SQL
Spark SQL 是当前 Spark 最核心、使用最广泛的模块。DataFrame/Dataset API 比 RDD 更高级、更优化。
5.1 DataFrame 与 Dataset
| 特性 | RDD | DataFrame | Dataset |
|---|---|---|---|
| 数据模型 | 无结构 | 带 Schema 的行 | 带 Schema 的强类型对象 |
| 类型安全 | 是(编译时) | 否(运行时) | 是(编译时) |
| 优化 | 无 | Catalyst | Catalyst |
| 语言 | Scala/Java/Python/R | 全部 | 主要 Scala/Java |
| Tungsten | 否 | 是 | 是 |
在 PySpark 中,DataFrame 是主要 API(Python 没有 Dataset 的编译时类型检查)。
5.2 创建 DataFrame
from pyspark.sql import SparkSession
from pyspark.sql.types import *
from pyspark.sql.functions import col, sum as _sum, avg, count

spark = SparkSession.builder \
    .appName("SparkSQLDemo") \
    .master("local[*]") \
    .config("spark.sql.shuffle.partitions", "4") \
    .getOrCreate()

# 1. 从 RDD 转换
rdd = sc.parallelize([(1, "Alice", 25), (2, "Bob", 30)])
df = spark.createDataFrame(rdd, ["id", "name", "age"])

# 2. 显式指定 Schema
schema = StructType([
    StructField("id", IntegerType(), False),
    StructField("name", StringType(), True),
    StructField("age", IntegerType(), True),
])
df = spark.createDataFrame(rdd, schema)

# 3. 读取文件
df = spark.read.csv("data/users.csv", header=True, inferSchema=True)
df = spark.read.json("data/users.json")
df = spark.read.parquet("data/users.parquet")
df = spark.read.orc("data/users.orc")

# 4. 读取 Hive 表
df = spark.sql("SELECT * FROM default.users")

# 5. JDBC
df = spark.read.format("jdbc") \
    .option("url", "jdbc:mysql://localhost:3306/mydb") \
    .option("dbtable", "users") \
    .option("user", "root") \
    .option("password", "xxx") \
    .load()

# 6. toDF
df = [(1, "Alice"), (2, "Bob")].toDF(["id", "name"])  # Scala 风格
# PySpark 中:
df = spark.createDataFrame([(1, "Alice"), (2, "Bob")], ["id", "name"])
5.3 常用 Transformation
# 选择列
df.select("name", "age").show()
df.select(col("name"), col("age") + 1).show()

# 过滤
df.filter(col("age") > 25).show()
df.where("age > 25").show()

# 分组聚合
df.groupBy("department").agg(
    count("*").alias("emp_count"),
    _sum("salary").alias("total_salary"),
    avg("salary").alias("avg_salary")
).show()

# 排序
df.orderBy(col("age").desc()).show()

# 去重
df.select("department").distinct().show()

# 列重命名
df.withColumnRenamed("name", "employee_name")

# 新增列
df.withColumn("age_next_year", col("age") + 1)

# Join
df1.join(df2, on="id", how="inner")           # inner/left/right/outer/semi/anti
df1.join(df2, df1.id == df2.emp_id, "left_outer")

# 窗口函数
from pyspark.sql.window import Window
from pyspark.sql.functions import row_number, rank, dense_rank

window_spec = Window.partitionBy("department").orderBy(col("salary").desc())
df.withColumn("rank", row_number().over(window_spec)).show()

# 写数据
df.write.mode("overwrite").parquet("hdfs:///output/users")
df.write.partitionBy("department").parquet("hdfs:///output/users_by_dept")
5.4 UDF / UDAF
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType, IntegerType

# 标量 UDF
def age_group(age):
    if age < 25:
        return "Young"
    elif age < 40:
        return "Mid"
    else:
        return "Senior"

age_group_udf = udf(age_group, StringType())
df.withColumn("age_group", age_group_udf(col("age"))).show()

# 更高效的方式:pandas UDF(向量化执行,基于 Apache Arrow)
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf(StringType())
def age_group_pandas(age: pd.Series) -> pd.Series:
    return age.apply(age_group)

df.withColumn("age_group", age_group_pandas(col("age"))).show()
💡 性能提示:普通 Python UDF 每行一次 Python/JVM 序列化,性能差;Pandas UDF 以列式批量传输,性能提升 10-100 倍。Spark 3.5 还引入了 Python UDF profiling 和更高效的 Arrow 批处理。
5.5 开窗函数
from pyspark.sql.window import Window
from pyspark.sql.functions import row_number, rank, dense_rank, lag, lead

window_spec = Window.partitionBy("department").orderBy(col("salary").desc())

# 排名
df.select(
    "name", "department", "salary",
    row_number().over(window_spec).alias("rn"),
    rank().over(window_spec).alias("rank"),
    dense_rank().over(window_spec).alias("dr"),
    lag("salary", 1).over(window_spec).alias("prev_salary"),
    lead("salary", 1).over(window_spec).alias("next_salary"),
).show()
5.6 执行计划与 Catalyst 优化器
df.explain()          # 简明物理计划
df.explain(True)      # 含解析/分析/优化/物理计划
df.explain("formatted")  # 格式化输出(Spark 3.0+)
Catalyst 优化器是 Spark SQL 的核心,它将用户的 DataFrame/SQL 代码经过以下阶段优化:
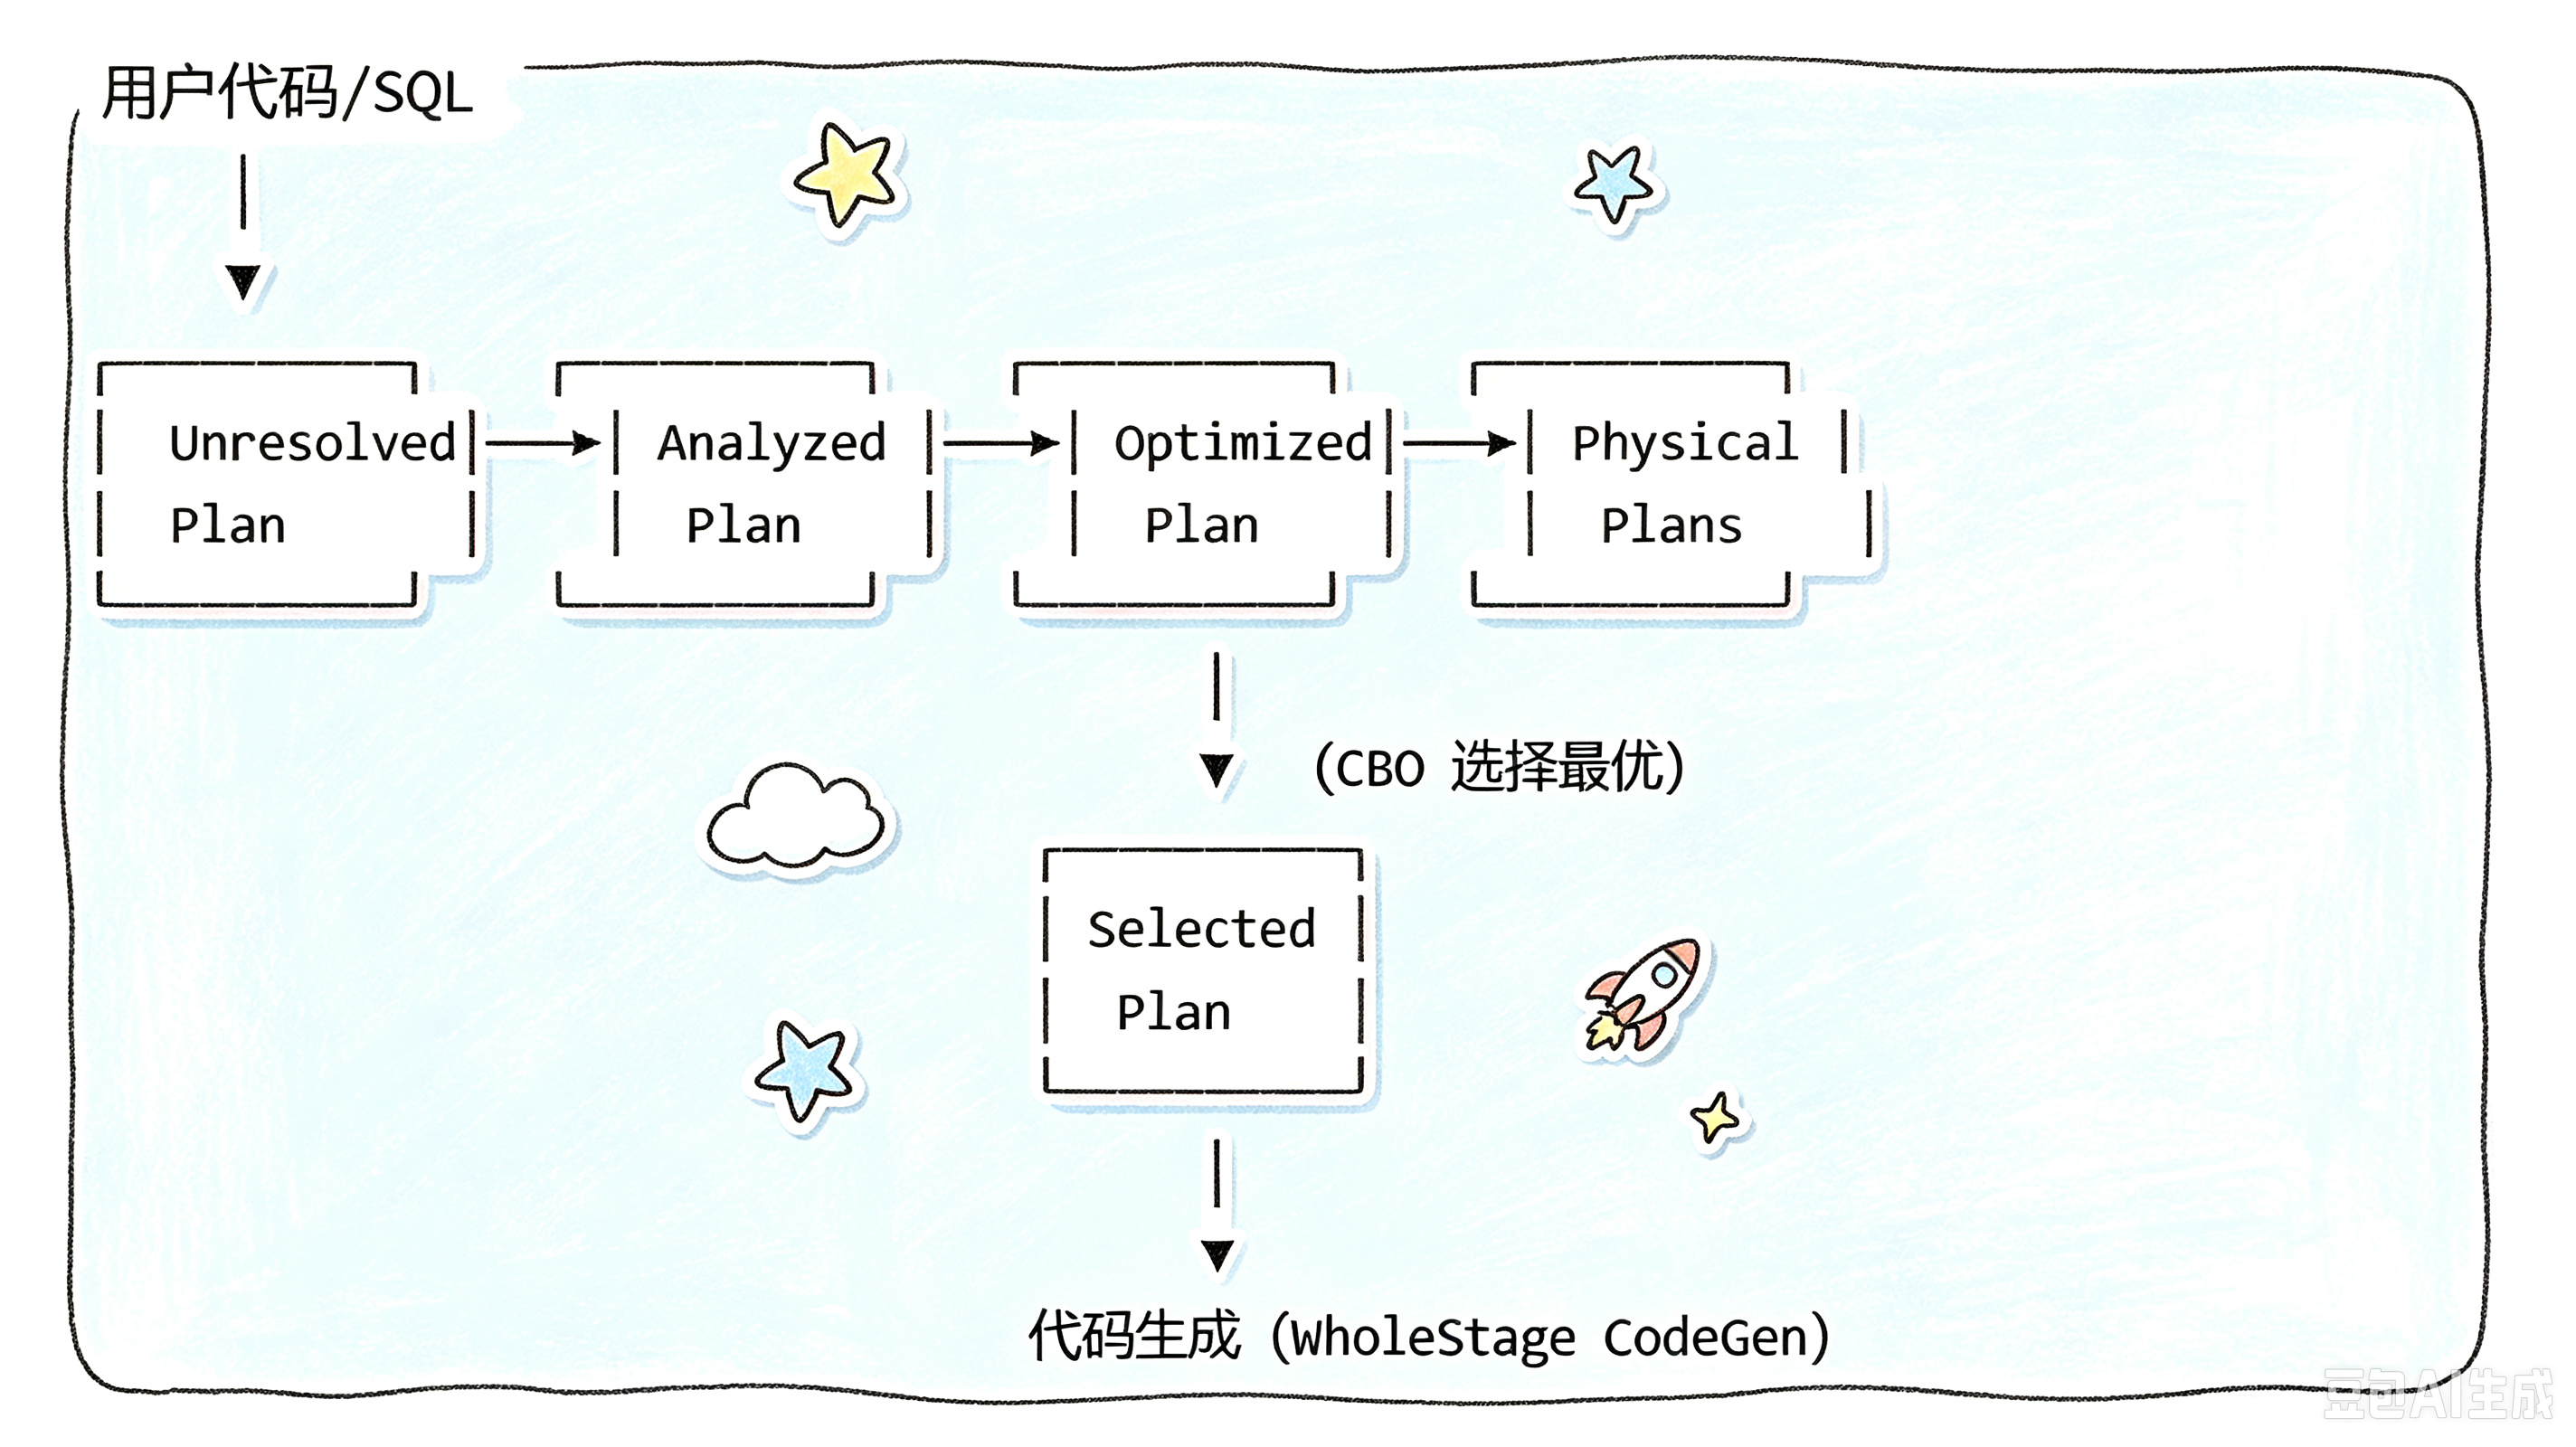
常见优化规则:
- 谓词下推(Predicate Pushdown):将过滤条件尽早下推到数据源
- 列裁剪(Column Pruning):只读取需要的列
- 常量折叠(Constant Folding):预计算常量表达式
- 布尔简化:简化 AND/OR 逻辑
5.7 Tungsten 优化
Tungsten 是 Spark 的执行引擎优化项目,目标是最大化 CPU 效率和内存效率:
- 内存管理:使用堆外内存(off-heap),避免 JVM GC 开销
- 二进制处理:数据以二进制格式存储,避免 Java 对象的序列化/反序列化
- Whole-Stage CodeGen:将整个 Stage 的多个算子融合为一个 Java 函数,消除虚函数调用
- 向量化读取:Parquet/ORC 列式批量读取
5.8 AQE(Adaptive Query Execution,自适应查询执行)
Spark 3.0 引入的重大特性,在 Shuffle Map 阶段完成后根据运行时统计信息动态调整执行计划:
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")
spark.conf.set("spark.sql.adaptive.localShuffleReader.enabled", "true")
三大核心能力:
| 功能 | 说明 |
|---|---|
| 动态合并 Shuffle 分区 | 自动将过小的分区合并,减少 Task 数量 |
| 动态处理数据倾斜 | 自动检测倾斜分区并拆分 Join |
| 动态切换 Join 策略 | 运行时发现小表可广播时,自动从 Sort-Merge Join 切换为 Broadcast Join |
6. Spark Streaming vs Structured Streaming
6.1 Spark Streaming(DStream)
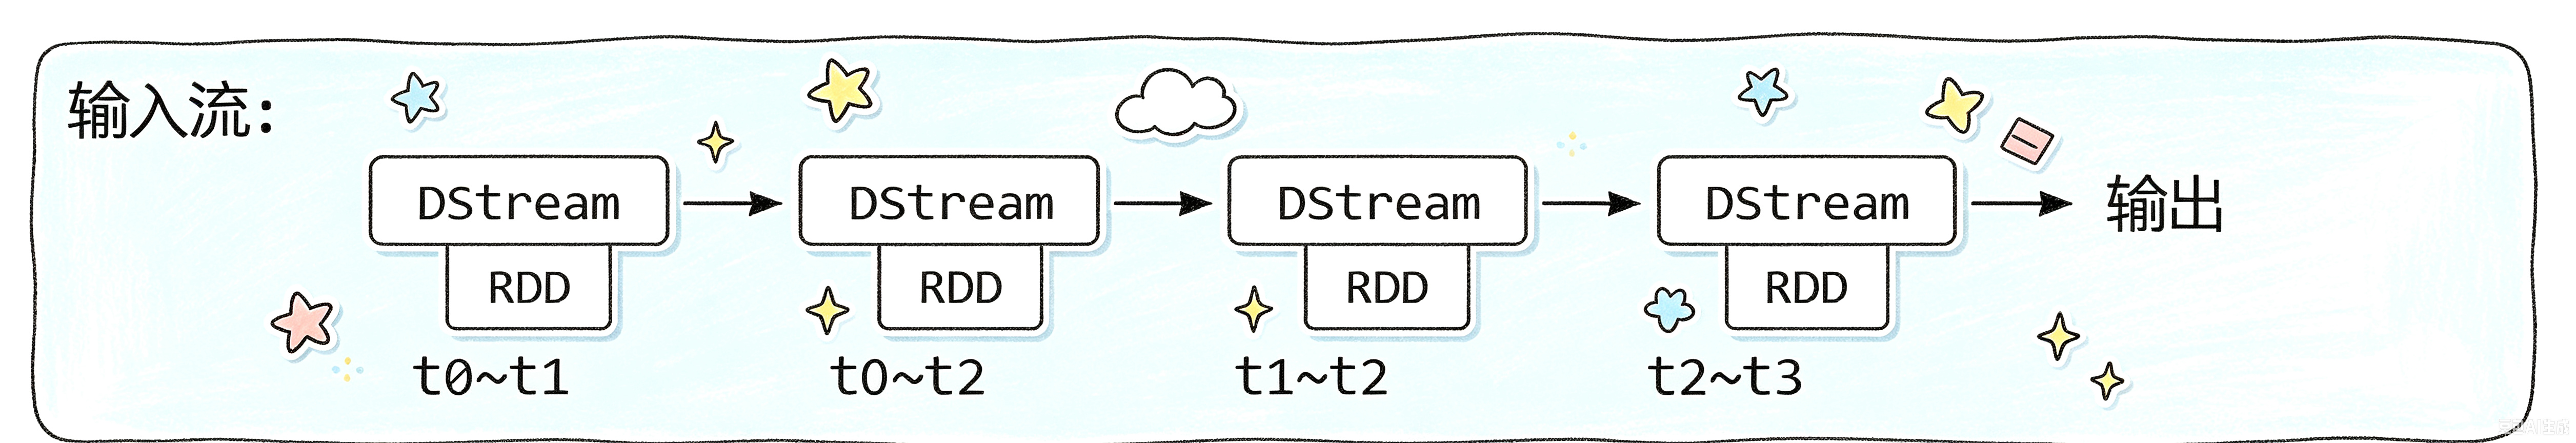
Spark Streaming 是早期的流计算方案,基于微批处理(Micro-Batch),将实时数据流按时间间隔切分为小的 RDD 批处理。
from pyspark.streaming import StreamingContext

ssc = StreamingContext(sc, batchDuration=5)  # 5 秒一个批次
lines = ssc.socketTextStream("localhost", 9999)
counts = lines.flatMap(lambda line: line.split(" ")) \
              .map(lambda w: (w, 1)) \
              .reduceByKey(lambda a, b: a + b)
counts.pprint()
ssc.start()
ssc.awaitTermination()
⚠️ Spark Streaming(DStream)从 Spark 3.4 起已标记为维护模式,新项目应使用 Structured Streaming。
6.2 Structured Streaming
Structured Streaming 是基于 Spark SQL 引擎构建的端到端流计算,将实时数据流视为一张持续追加的"无界表"。
from pyspark.sql.functions import *

# 从 Kafka 读取
df = spark.readStream \
    .format("kafka") \
    .option("kafka.bootstrap.servers", "localhost:9092") \
    .option("subscribe", "orders") \
    .load()

# 解析 JSON
parsed = df.selectExpr("CAST(value AS STRING) as json") \
    .select(from_json("json", schema).alias("data")) \
    .select("data.*")

# 聚合
agg = parsed.groupBy("product_id").agg(
    count("*").alias("order_count"),
    sum("amount").alias("total_amount")
)

# 输出到控制台
query = agg.writeStream \
    .outputMode("complete") \
    .format("console") \
    .trigger(processingTime="10 seconds") \
    .start()

query.awaitTermination()
6.3 核心概念
Event Time(事件时间):数据产生时自带的时间戳,而非 Spark 处理时间(Processing Time)。
Watermark(水位线):定义了系统等待迟到数据的时间阈值,超过阈值的迟到数据将被丢弃。
# 设置 10 分钟 watermark
df_with_watermark = parsed \
    .withWatermark("event_time", "10 minutes") \
    .groupBy(
        window("event_time", "5 minutes"),  # 5 分钟滚动窗口
        "product_id"
    ).agg(count("*").alias("cnt"))
Window(窗口):
| 窗口类型 | 说明 |
|---|---|
| Tumbling Window | 固定大小,不重叠(如每 5 分钟统计) |
| Sliding Window | 固定大小,可重叠(如每 1 分钟统计最近 5 分钟) |
| Session Window | 基于活动间隔动态划分(Spark 3.2+) |
Output Mode(输出模式):
| 模式 | 说明 | 适用聚合 |
|---|---|---|
| Append | 仅输出新行 | 无聚合 |
| Complete | 输出全量结果 | 有聚合 |
| Update | 仅输出更新行 | 有聚合(Spark 2.1+) |
6.4 Source 与 Sink
| Source | 说明 |
|---|---|
| Kafka | 最常用,支持从 Kafka 读取消息 |
| File | 监听目录中新文件 |
| Socket | 测试用,从 TCP Socket 读取 |
| Rate | 测试用,每秒生成指定行数 |
| Sink | 说明 |
|---|---|
| Kafka | 写入 Kafka Topic |
| File | 写入文件(Parquet/JSON/CSV) |
| Console | 控制台(调试用) |
| Foreach/ForeachBatch | 自定义写入逻辑 |
| Memory | 存储为内存表(调试用) |
6.5 Exactly-Once 语义
Structured Streaming 通过以下机制保证精确一次(Exactly-Once):
- 可重放的 Source:如 Kafka,记录 offset 可重新读取
- 幂等的 Sink:或使用事务写入(如 Kafka 事务、文件原子写入)
- Checkpoint + WAL:将 offset 和聚合状态持久化到可靠存储
query = agg.writeStream \
    .format("kafka") \
    .option("kafka.bootstrap.servers", "localhost:9092") \
    .option("topic", "order_summary") \
    .option("checkpointLocation", "hdfs:///checkpoint/orders") \
    .outputMode("complete") \
    .start()
注意:
foreachBatch本身不保证 Exactly-Once,需要 Sink 端实现幂等或使用事务。
7. Spark 数据湖与 Lakehouse
随着大数据从"数据仓库"向"湖仓一体"演进,数据湖格式已成为 Spark 生态不可或缺的一环。本章介绍三大开源数据湖格式及 Paimon,并给出 Spark 实战代码。
7.1 数据湖概念与三剑客对比
数据湖(Data Lake):以原始格式存储海量结构化、半结构化、非结构化数据的集中式存储,支持多种计算引擎直接读写。传统数据湖缺乏事务支持,容易产生脏数据。
Lakehouse(湖仓一体):在数据湖存储之上增加事务层、Schema 管理、ACID 语义,兼具数据湖的灵活性和数据仓库的管理能力。
| 特性 | Delta Lake | Apache Iceberg | Apache Hudi |
|---|---|---|---|
| 定位 | Databricks 主导,强绑定 Spark | 通用表格式,引擎无关 | 流式数据湖,Upsert 优先 |
| ACID 事务 | ✅ | ✅ | ✅ |
| Schema 演化 | ✅(新增/删除列) | ✅(新增/删除/重命名/调序) | ✅ |
| 分区演化 | ❌ | ✅(隐式分区演化) | ✅ |
| 时间旅行 | ✅ | ✅(Snapshot ID/时间戳) | ✅ |
| Upsert/Merge | ✅ MERGE INTO | ✅ MERGE INTO | ✅(原生 Upsert 是核心特性) |
| 删除更新 | ✅ | ✅(V2 Row-Level) | ✅(COW/MOR) |
| 流写入 | ✅ | ✅(Spark Structured Streaming) | ✅(深度流式支持) |
| 计算引擎 | Spark 为主(Delta 2.0+ 支持 Flink/Presto) | Spark/Flink/Trino/Presto/Hive | Spark/Flink/Trino/Presto |
| 社区活跃度 | Databricks 商业驱动 | Apache 顶级项目,中立开放 | Apache 顶级项目,Uber 起源 |
| 典型用户 | Databricks 客户 | Apple/Netflix/LinkedIn | Uber/Grab/字节跳动 |
| 特色 | Z-Order 优化、Delta UniForm | 隐藏分区、分区演化、快照隔离 | COW/MOR 双模式、Compaction/Clustering |
Apache Paimon 简介(原 Flink Table Store):
Paimon 是 Flink 社区发起的流批一体存储项目,2024 年成为 Apache 顶级项目。它的核心定位是流式数据湖:
- 原生支持 Flink CDC 摄入,毫秒级延迟 Upsert
- 同时支持 Spark 读写,流批统一
- LSM Tree 架构,高吞吐写入与查询兼顾
- 适合实时数仓场景(Flink + Paimon + Spark 分析)
选型提示:如果团队以 Spark 为核心且用 Databricks,Delta Lake 最省心;如果追求引擎中立和多引擎生态,Iceberg 是趋势;如果核心需求是流式 Upsert 和增量处理,Hudi/Paimon 更合适。
7.2 Spark + Iceberg 实战
Iceberg 核心概念:
| 概念 | 说明 |
|---|---|
| Snapshot(快照) | 表的一次完整状态,每次写入生成新快照,旧快照保留用于时间旅行 |
| Manifest(清单) | 记录数据文件路径、分区信息、列级统计,Manifest List 管理多个 Manifest |
| Metadata File | 表元数据入口,记录当前 Snapshot、Schema、Partition Spec 等 |
| Partition Spec | 分区规则,支持隐藏分区(如按天分区但查询可按小时过滤) |
| Schema Evolution | 新增/删除/重命名/调整列顺序,无需重写数据文件 |
| Partition Evolution | 修改分区规则后旧数据不受影响,新数据按新规则写入 |
Spark 提交 Iceberg 依赖配置:
spark-submit \
  --packages org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:1.5.2 \
  --conf spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions \
  --conf spark.sql.catalog.spark_catalog=org.apache.iceberg.spark.SparkSessionCatalog \
  --conf spark.sql.catalog.spark_catalog.type=hive \
  --conf spark.sql.catalog.local=org.apache.iceberg.spark.SparkCatalog \
  --conf spark.sql.catalog.local.type=hadoop \
  --conf spark.sql.catalog.local.warehouse=s3://my-bucket/iceberg-warehouse \
  your_app.py
建表与写入:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, current_date, date_format

spark = SparkSession.builder.appName("IcebergDemo").getOrCreate()

# 建表
spark.sql("""
CREATE TABLE IF NOT EXISTS local.db.orders (
    order_id    BIGINT,
    user_id     BIGINT,
    product_id  BIGINT,
    amount      DECIMAL(10,2),
    order_time  TIMESTAMP,
    dt          STRING
) USING iceberg
PARTITIONED BY (dt)
""")

# 批量写入
batch_df = spark.read.parquet("s3://raw-data/orders/2024-01-15/")
batch_df.writeTo("local.db.orders").overwritePartitions()

# 流式写入(Structured Streaming)
from pyspark.sql.functions import from_json, col

kafka_schema = "order_id BIGINT, user_id BIGINT, product_id BIGINT, " \
               "amount DECIMAL(10,2), order_time TIMESTAMP, dt STRING"

stream_df = spark.readStream \
    .format("kafka") \
    .option("kafka.bootstrap.servers", "localhost:9092") \
    .option("subscribe", "orders") \
    .load() \
    .selectExpr("CAST(value AS STRING) as json") \
    .select(from_json(col("json"), kafka_schema).alias("data")) \
    .select("data.*")

stream_df.writeStream \
    .format("iceberg") \
    .option("path", "local.db.orders") \
    .option("checkpointLocation", "s3://checkpoints/orders") \
    .trigger(processingTime="1 minute") \
    .start()
查询与时间旅行:
# 查询当前快照
spark.sql("SELECT * FROM local.db.orders WHERE dt = '2024-01-15'").show()

# Time Travel:按 Snapshot ID
spark.sql("""
SELECT * FROM local.db.orders.snapshotId(12345678901234567)
""").show()

# Time Travel:按时间戳
spark.sql("""
SELECT * FROM local.db.orders.timestampAsOf('2024-01-15 10:00:00')
""").show()

# 查看快照历史
spark.sql("SELECT * FROM local.db.orders.snapshots").show()

# 回滚到指定快照
spark.sql("CALL local.system.rollback_to_snapshot('db.orders', 12345678901234567)")
Schema 演化:
# 新增列
spark.sql("ALTER TABLE local.db.orders ADD COLUMN status STRING")

# 删除列
spark.sql("ALTER TABLE local.db.orders DROP COLUMN status")

# 重命名列
spark.sql("ALTER TABLE local.db.orders RENAME COLUMN amount TO total_amount")

# 调整列顺序
spark.sql("ALTER TABLE local.db.orders ALTER COLUMN order_id AFTER order_time")
分区演化:
# 从按天分区改为按月分区(旧数据不受影响)
spark.sql("ALTER TABLE local.db.orders ADD PARTITION FIELD months(order_time)")
spark.sql("ALTER TABLE local.db.orders DROP PARTITION FIELD dt")
MERGE INTO(Upsert):
# 创建更新数据集
updates_df = spark.createDataFrame([
    (1001, 2001, 3001, 99.99, "2024-01-15 14:30:00", "2024-01-15", "PAID"),
    (1002, 2002, 3002, 59.99, "2024-01-15 15:00:00", "2024-01-15", "PAID"),
], ["order_id", "user_id", "product_id", "amount", "order_time", "dt", "status"])

updates_df.createOrReplaceTempView("updates")

spark.sql("""
MERGE INTO local.db.orders t
USING updates s
ON t.order_id = s.order_id
WHEN MATCHED THEN
    UPDATE SET t.amount = s.amount, t.status = s.status, t.order_time = s.order_time
WHEN NOT MATCHED THEN
    INSERT (order_id, user_id, product_id, amount, order_time, dt, status)
    VALUES (s.order_id, s.user_id, s.product_id, s.amount, s.order_time, s.dt, s.status)
""")
7.3 Spark + Hudi 实战
Hudi 表类型对比:
| 特性 | COW(Copy On Write) | MOR(Merge On Read) |
|---|---|---|
| 写入方式 | 每次写入更新重写整个 Parquet 文件 | 增量写入 Log 文件,定期合并 |
| 写入延迟 | 高(重写文件) | 低(追加日志) |
| 读取延迟 | 低(直接读 Parquet) | 稍高(需合并 Parquet + Log) |
| Compaction | 不需要 | 需要(同步/异步) |
| 适用场景 | 批量更新、读多写少 | 流式 Upsert、写多读多 |
| 存储效率 | 高(列式压缩) | 稍低(Log 行式存储) |
| 典型场景 | 离线 ETL、T+1 报表 | 实时数仓、近实时分析 |
Hudi 核心概念:
| 概念 | 说明 |
|---|---|
| Timeline | 表的操作历史,包含 Commit/DeltaCommit/Compaction/Clean,每个 Instant 记录状态 |
| File Group | 一组文件,由 File ID 标识,包含 Base File(Parquet)和 Log File |
| File Slice | 某一时刻 File Group 的快照 = 一个 Base File + 对应 Log 文件 |
| Compaction | MOR 表将 Log 文件合并到 Base File 的过程,可同步或异步执行 |
| Clustering | 将小文件合并、按列聚簇重写,优化查询性能 |
Spark 写入 Hudi 代码示例:
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("HudiDemo") \
    .config("spark.jars.packages",
            "org.apache.hudi:hudi-spark3.5-bundle_2.12:0.15.0") \
    .config("spark.sql.extensions",
            "org.apache.spark.sql.hudi.HoodieSparkSessionExtension") \
    .config("spark.sql.catalog.spark_catalog",
            "org.apache.spark.sql.hudi.catalog.HoodieCatalog") \
    .getOrCreate()

table_path = "s3://my-bucket/hudi/orders"
table_name = "orders"

# 批量导入(bulk_insert,最高效,不做去重)
df = spark.read.parquet("s3://raw-data/orders/")
df.write.format("hudi") \
    .option("hoodie.table.name", table_name) \
    .option("hoodie.datasource.write.recordkey.field", "order_id") \
    .option("hoodie.datasource.write.partitionpath.field", "dt") \
    .option("hoodie.datasource.write.precombine.field", "order_time") \
    .option("hoodie.datasource.write.operation", "bulk_insert") \
    .mode("overwrite") \
    .save(table_path)

# Upsert(默认操作,按主键更新或插入)
updates_df = spark.read.parquet("s3://raw-data/orders/incremental/")
updates_df.write.format("hudi") \
    .option("hoodie.table.name", table_name) \
    .option("hoodie.datasource.write.recordkey.field", "order_id") \
    .option("hoodie.datasource.write.partitionpath.field", "dt") \
    .option("hoodie.datasource.write.precombine.field", "order_time") \
    .option("hoodie.datasource.write.operation", "upsert") \
    .option("hoodie.upsert.shuffle.parallelism", 200) \
    .mode("append") \
    .save(table_path)

# MOR 表写入(流式场景推荐)
stream_df.writeStream.format("hudi") \
    .option("hoodie.table.name", table_name) \
    .option("hoodie.datasource.write.recordkey.field", "order_id") \
    .option("hoodie.datasource.write.partitionpath.field", "dt") \
    .option("hoodie.datasource.write.precombine.field", "order_time") \
    .option("hoodie.datasource.write.table.type", "MERGE_ON_READ") \
    .option("hoodie.datasource.write.operation", "upsert") \
    .option("checkpointLocation", "s3://checkpoints/hudi-orders") \
    .trigger(processingTime="1 minute") \
    .start(table_path)
Clustering / Compaction 配置:
# 异步 Clustering(写入时自动优化小文件)
hudi_options = {
    "hoodie.table.name": table_name,
    "hoodie.datasource.write.recordkey.field": "order_id",
    "hoodie.datasource.write.partitionpath.field": "dt",
    # Clustering
    "hoodie.clustering.async.enabled": "true",
    "hoodie.clustering.async.max.commits": "4",       # 每 4 次提交触发一次
    "hoodie.clustering.plan.strategy.target.file.max.bytes": "134217728",  # 128MB
    "hoodie.clustering.plan.strategy.small.file.limit": "629145600",       # 600MB
    # MOR Compaction
    "hoodie.compact.inline": "true",
    "hoodie.compact.inline.max.delta.commits": "5",  # 每 5 次 Delta Commit 触发
    "hoodie.compact.inline.trigger.strategy":
        "org.apache.hudi.table.action.compact.strategy.NumCommitsAfterLastCompactionTriggerStrategy",
}

# 离线触发 Clustering
spark.sql(f"""
CALL run_clustering(
    table => '{table_name}',
    path => '{table_path}',
    options => 'hoodie.clustering.plan.strategy.target.file.max.bytes=134217728'
)
""")

# 离线触发 Compaction
spark.sql(f"""
CALL run_compaction(
    table => '{table_name}',
    path => '{table_path}'
)
""")
7.4 Spark + Delta Lake
Delta Lake 核心特性:
| 特性 | 说明 |
|---|---|
| ACID 事务 | 基于事务日志(_delta_log),并发写入通过乐观并发控制保证一致性 |
| Time Travel | 通过版本号或时间戳读取历史数据快照 |
| Schema Enforcement | 写入时严格校验 Schema,类型不匹配直接拒绝 |
| Schema Evolution | 支持新增列、删除列(Delta 1.2+) |
| MERGE INTO | 原生 Upsert 语法,支持复杂条件 |
| OPTIMIZE + Z-ORDER | 合并小文件并按排序列聚簇,加速点查 |
| Change Data Feed | 增量读取变更数据(类似 Hudi 增量视图) |
Spark 读写 Delta 代码示例:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col

spark = SparkSession.builder \
    .appName("DeltaDemo") \
    .config("spark.jars.packages",
            "io.delta:delta-spark_2.12:3.1.0") \
    .config("spark.sql.extensions",
            "io.delta.sql.DeltaSparkSessionExtension") \
    .config("spark.sql.catalog.spark_catalog",
            "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
    .getOrCreate()

# 写入 Delta 表
df = spark.range(0, 1000).withColumn("value", col("id") * 10)
df.write.format("delta").mode("overwrite").save("s3://my-bucket/delta/events")

# 读取
spark.read.format("delta").load("s3://my-bucket/delta/events").show()

# SQL 建表
spark.sql("""
CREATE TABLE IF NOT EXISTS delta_events (
    id LONG, value LONG
) USING delta LOCATION 's3://my-bucket/delta/events'
""")
Time Travel:
# 按版本号
df_v2 = spark.read.format("delta") \
    .option("versionAsOf", 2) \
    .load("s3://my-bucket/delta/events")

# 按时间戳
df_ts = spark.read.format("delta") \
    .option("timestampAsOf", "2024-01-15T10:30:00Z") \
    .load("s3://my-bucket/delta/events")

# SQL 语法
spark.sql("SELECT * FROM delta_events VERSION AS OF 2")
spark.sql("SELECT * FROM delta_events TIMESTAMP AS OF '2024-01-15 10:30:00'")
MERGE / OPTIMIZE / ZORDER:
# MERGE INTO(Upsert)
updates = spark.createDataFrame([(1, 999), (1001, 500)], ["id", "value"])
updates.createOrReplaceTempView("updates")

spark.sql("""
MERGE INTO delta_events t
USING updates s
ON t.id = s.id
WHEN MATCHED THEN UPDATE SET *
WHEN NOT MATCHED THEN INSERT *
""")

# OPTIMIZE:合并小文件
spark.sql("OPTIMIZE delta_events")

# Z-ORDER:按高频过滤列聚簇排序,加速点查
spark.sql("OPTIMIZE delta_events ZORDER BY (id)")

# 清理旧快照(VACUUM,默认保留 7 天)
spark.sql("VACUUM delta_events RETAIN 168 HOURS")
7.5 选型建议
| 场景 | 推荐格式 | 理由 |
|---|---|---|
| Databricks 生态 / Spark 重度用户 | Delta Lake | 官方原生支持,Z-Order + OPTIMIZE 成熟 |
| 多引擎共享(Spark + Flink + Trino) | Iceberg | 引擎中立,社区开放,隐藏分区设计优秀 |
| 流式 Upsert / 实时数仓 | Hudi (MOR) | 原生流式支持,Compaction/Clustering 完善 |
| Flink CDC 实时入湖 + Spark 分析 | Paimon | Flink 原生流批一体,LSM 高吞吐写入 |
| 离线批处理 + 偶尔 Upsert | Iceberg / Delta | COW 模式即可满足,运维简单 |
| 严格 Schema 管理 + 审计合规 | Iceberg | 完整的 Schema/分区演化,快照隔离可审计 |
| 已投入 Hadoop 生态 / Hive 兼容 | Hudi / Iceberg | 均支持 Hive Catalog,迁移成本低 |
总结:没有"最好"的数据湖格式,只有"最合适"的选型。建议根据团队的计算引擎、更新频率、查询模式和运维能力综合决策。新项目若以 Spark 为核心且需要多引擎支持,Iceberg 是当前最安全的中立选择。
8. Spark 性能调优
性能调优是 Spark 工程师的核心能力。以下从多个维度系统讲解。
8.1 数据倾斜诊断与解决
数据倾斜是最常见的性能问题,表现为:大部分 Task 很快完成,但少数 Task 执行极慢甚至 OOM。
诊断方法:
- Spark UI 的 Stages 页面查看 Task 的 Shuffle Read/Write 数据量分布
- 观察是否有 Task 处理的数据量远超其他 Task
- 在 Spark SQL 中查看 AQE 倾斜处理日志
解决方案:
| 方案 | 说明 | 适用场景 |
|---|---|---|
| 加盐(Salting) | 对热点 Key 加随机前缀,分散到不同 Task | 聚合类倾斜 |
| 广播 Join | 小表广播,避免 Shuffle | Join 倾斜(小表 < 100MB) |
| MapJoin / BroadcastHashJoin | AQE 自动或手动 hint | 大小表 Join |
| 拆分热点 Key | 将热点 Key 单独处理后合并 | 复杂聚合 |
| 两阶段聚合 | 先加随机前缀局部聚合,再去前缀全局聚合 | groupBy 倾斜 |
| AQE Skew Join | Spark 3.0 自动检测并拆分 | Join 倾斜(推荐) |
# 加盐示例:对热点 Key 打散
from pyspark.sql.functions import concat, lit, rand, col

# 第一步:加随机前缀
salted = df.withColumn("salted_key", concat(col("key"), lit("_"), (rand() * 10).cast("int")))
partial = salted.groupBy("salted_key").agg(sum("value").alias("partial_sum"))

# 第二步:去掉前缀再聚合
result = partial.withColumn("key", split(col("salted_key"), "_")[0]) \
                .groupBy("key").agg(sum("partial_sum").alias("total"))

# 广播 Join 提示
from pyspark.sql.functions import broadcast
df_large.join(broadcast(df_small), "key")

# SQL Hint
spark.sql("SELECT /*+ BROADCAST(s) */ * FROM large l JOIN small s ON l.key = s.key")
8.2 Shuffle 调优
# 1. 调整 Shuffle 分区数(默认 200,通常需调整)
spark.conf.set("spark.sql.shuffle.partitions", "200")  # 通用建议:总核数的 2-3 倍

# 2. 启用 AQE 自动合并分区
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")

# 3. Shuffle 压缩
spark.conf.set("spark.shuffle.compress", "true")
spark.conf.set("spark.shuffle.spill.compress", "true")
spark.conf.set("spark.io.compression.codec", "zstd")  # zstd 比 snappy 压缩率更好

# 4. Shuffle 文件缓冲区
spark.conf.set("spark.shuffle.file.buffer", "1MB")        # 默认 32KB
spark.conf.set("spark.reducer.maxSizeInFlight", "96MB")   # 默认 48MB

# 5. RDD API 中使用 coalesce 减少分区
small_df = large_df.coalesce(10)  # 窄依赖,不 Shuffle
# repartition 会 Shuffle
repartitioned = df.repartition(200, col("date"))
8.3 内存调优
# spark-submit 内存参数
--driver-memory 4g \
--executor-memory 8g \
--executor-cores 4 \
--num-executors 20 \
--conf spark.memory.fraction=0.6 \          # Spark 内存占比(默认 0.6)
--conf spark.memory.storageFraction=0.5     # Storage 占 Spark 内存比例(默认 0.5)
Executor 内存规划原则:
- 每个 Executor 建议 4-8GB,过大易导致 GC 压力
- 每个 Executor 2-5 个 Core,过多 Core 导致 HDFS I/O 竞争
- 预留系统内存:
spark.memory.fraction默认为 0.6,即 60% 给 Spark,40% 给用户和其他开销
序列化选择:
| 序列化方式 | 优点 | 缺点 |
|---|---|---|
| Java Serialization(默认) | 兼容好 | 慢、体积大 |
| Kryo Serialization | 快 10x、体积小 | 需注册类 |
spark.conf.set("spark.serializer", "org.apache.spark.serializer.KryoSerializer")
# Scala: spark.registerKryoClasses(Array(classOf[MyClass]))
缓存策略:
- 优先使用
MEMORY_AND_DISK_SER而非MEMORY_ONLY,避免 OOM - DataFrame 建议用
spark.catalog.cacheTable()或df.cache(),列式存储更高效 - 及时
unpersist()不再使用的缓存
8.4 并行度调优
- 合理设置分区数:分区太少 → 并行度不足;分区太多 → Task 调度开销大
- 经验值:分区数 ≈ 总 Executor Core 数的 2-3 倍
- 读取时控制并行度:
- HDFS 文件的 InputSplit 数量
spark.sql.files.maxPartitionBytes(默认 128MB)
- AQE 自动调整:Spark 3.0+ 优先使用 AQE
8.5 数据本地性
Spark 倾向于将 Task 调度到数据所在节点,减少网络传输:
| 级别 | 说明 |
|---|---|
| PROCESS_LOCAL | 数据在同一 JVM 中(最快) |
| NODE_LOCAL | 数据在同一节点 |
| RACK_LOCAL | 数据在同一机架 |
| ANY | 数据在任意位置(最慢) |
通常不需要手动调整,但如果集群网络延迟高,可适当增大 spark.locality.wait(默认 3s)。
8.6 小文件问题
问题:大量小文件导致 Task 数量过多,调度开销巨大。
# 1. 写入时合并小文件
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
spark.conf.set("spark.sql.adaptive.advisoryPartitionSizeInBytes", "128MB")

# 2. 读取时合并小文件
df = spark.read.option("mergeSchema", "true").parquet("hdfs:///data/")

# 3. 使用 Hive 的 CombineHiveInputFormat(对 Hive 表)
spark.conf.set("spark.hadoop.hive.input.format",
    "org.apache.hadoop.hive.ql.io.CombineHiveInputFormat")

# 4. 写入后用 DISTRIBUTE BY 控制输出文件数
df.write.partitionBy("dt").saveAsTable("table")
# 或在 SQL 中
# INSERT OVERWRITE TABLE t PARTITION(dt) SELECT ... DISTRIBUTE BY dt
8.7 列式存储与数据格式
| 格式 | 类型 | 压缩 | 特点 |
|---|---|---|---|
| Text/CSV | 行式 | 无/弱 | 通用但慢 |
| JSON | 行式 | 无 | 解析开销大 |
| Parquet | 列式 | Snappy/Gzip/Zstd | Spark 默认推荐,列裁剪高效 |
| ORC | 列式 | Zlib/Snappy/Zstd | Hive 生态好,ACID 支持 |
| Avro | 行式 | Snappy | Schema 演进好,Kafka 常用 |
# 写入 Parquet(推荐格式)
df.write.mode("overwrite") \
    .option("compression", "zstd") \
    .parquet("hdfs:///data/output")

# 分区裁剪 + 谓词下推(Parquet/ORC 自动支持)
spark.sql("SELECT name, age FROM users WHERE dt = '2024-01-01' AND age > 25")
# 只读 dt=2024-01-01 分区,且只扫描 name、age 列
8.8 Join 策略选择
Spark 支持多种 Join 实现,理解其原理对性能调优至关重要:
| Join 策略 | 触发条件 | 特点 |
|---|---|---|
| Broadcast Hash Join (BHJ) | 小表 < spark.sql.autoBroadcastJoinThreshold(默认 10MB) | 无 Shuffle,最快 |
| Sort-Merge Join (SMJ) | 大表 Join 大表(默认) | 需 Shuffle + 排序,稳定但慢 |
| Shuffled Hash Join (SHJ) | 配置开启且大小表均适合构建哈希表 | Shuffle 但不排序,比 SMJ 快 |
| Broadcast Nested Loop Join (BNLJ) | 无等值条件的 Join(如 CROSS JOIN) | 无 Shuffle,但 O(n×m) |
| Cartesian Product | 无条件 Join | 结果集可能极大,慎用 |
# 手动指定 Join 策略 Hint
df1.join(broadcast(df2), "key")  # 推荐:广播小表
spark.sql("SELECT /*+ MERGE(l, r) */ * FROM large l JOIN large r ON l.id = r.id")
spark.sql("SELECT /*+ SHUFFLE_HASH(l, r) */ * FROM large l JOIN medium r ON l.id = r.id")
调优建议:
- 大小表 Join:优先 Broadcast Hash Join,可适当调大
autoBroadcastJoinThreshold(如 100MB) - 大表 Join 大表:确保 Join Key 数据类型一致,避免隐式转换导致 Shuffle
- 多表 Join:注意 Join 顺序,小表尽量先参与
- AQE 开启后,运行时自动切换为 Broadcast Join
8.9 分区策略
合理的分区设计是性能优化的基础:
# 写入时按字段分区(目录分区)
df.write.partitionBy("dt", "region").parquet("hdfs:///data/sales")
# 生成目录结构:/data/sales/dt=2024-01-01/region=CN/part-xxx.parquet

# 分桶(Bucket):相同 Key 的数据落在同一文件,避免 Join 时 Shuffle
df.write.bucketBy(32, "user_id").sortBy("user_id").saveAsTable("bucketed_users")

# 读取时分区裁剪自动生效
spark.sql("SELECT * FROM sales WHERE dt = '2024-01-01'")  # 只读一个分区目录
| 策略 | 适用场景 | 注意事项 |
|---|---|---|
| 分区(Partition) | 高基数的查询过滤字段(如日期) | 分区数不宜过多(< 10000) |
| 分桶(Bucket) | 频繁 Join 或聚合的字段 | 桶数需为 2 的幂,与 Join 表一致 |
| 聚簇(Clustering) | 数据湖中自动优化文件布局 | Iceberg/Hudi/Delta Lake 支持 |
8.10 Spark UI 实战调试指南
Spark UI(默认端口 4040)是性能调优最重要的工具,能直观展示作业执行细节。以下逐页讲解排查思路。
Jobs 页面:
- 展示所有 Job 的状态(Succeeded/Failed/Running)、耗时、Stage 数
- 点击 Job 进入详情,查看 DAG 可视化图:每个方框代表一个 Stage,箭头表示 Shuffle 依赖
- 任务耗时分布:关注 Duration 列,若某 Job 耗时远超预期,进入对应 Stage 排查
- 失败任务定位:Failed Jobs 区域直接显示异常堆栈,点击 Failed Stage 查看 Task 失败日志
Stages 页面(核心!):
- 展示每个 Stage 的 Task 数、输入/输出数据量、Shuffle Read/Write
- Shuffle Read 列:关注
Min / 25th / Median / 75th / Max,若 Max 远大于 Median(如 Max 是 Median 的 5 倍以上),说明数据倾斜 - Shuffle Write 列:Map 端写出的数据量,倾斜同样会表现为分布不均
- Task Time 分布:GC Time 占比过高说明内存压力大;Scheduler Delay 过高说明资源不足
- 点击 Stage 详情可查看每个 Task 的指标,支持排序
倾斜识别要点:在 Stages 页面查看 Summary Metrics 表,比较 Task Max 与 Median 的 Shuffle Read Size。如果 Max 是 Median 的数倍甚至数十倍,基本可以确认倾斜。
Storage 页面:
- 展示缓存的 RDD/DataFrame,包括存储级别(Memory/Deserialized 等)、缓存分区数、占用内存/磁盘大小
- 缓存命中率:Fraction Cached 列显示已缓存分区比例,若偏低说明部分分区未缓存(Executor 丢失或内存不足被淘汰)
- 分区大小:Size in Memory/ExternalBlockStore 列可判断分区是否均匀
- 内存 vs 磁盘:若大量数据在 Disk 上,说明内存不足,需调整缓存策略或增大内存
Environment 页面:
- 展示所有 Spark 配置属性(System Properties、Classpath、Spark Properties)
- 配置排查:确认提交参数是否生效(如
spark.sql.shuffle.partitions、spark.executor.memory) - 可对比运行配置与预期配置,排查"参数没生效"类问题
Executors 页面:
| 列 | 排查意义 |
|---|---|
| Task Time (Total/GC) | GC Time 占 Total 10%+ 说明内存压力大,需调内存或减少缓存 |
| Shuffle Read/Write | 各 Executor 的 Shuffle 数据量,差异大说明倾斜 |
| Input Size/Records | 读取数据量分布,不均匀可能是文件大小不均 |
| Storage Memory | 已用/总缓存内存,满了会溢写磁盘 |
| Failed Tasks | 非零需查看日志,可能 OOM 或数据异常 |
| Log 链接 | 点击 stdout/stderr 查看 Executor 日志(YARN 模式需通过 RM 代理) |
SQL 页面(Spark SQL / DataFrame 作业必看):
- 展示 SQL 查询的完整执行计划 DAG,节点显示 Scan/Filter/Project/Join/Aggregate/Sort 等算子
- 点击节点查看详细指标:行数、数据量、耗时、CodeGen 信息
- Join 识别:节点显示
SortMergeJoin/BroadcastHashJoin/ShuffledHashJoin,确认是否走了预期的 Join 策略 - Broadcast 识别:若看到
BroadcastExchange节点,说明小表被广播;若大表被广播可能 OOM - AQE Skew Partition:开启 AQE 后,倾斜 Join 会显示
CustomShuffleReader节点,标注拆分的分区数 - Scan 节点:查看
number of files read、size of files read、partition filters、data filters,确认分区裁剪和谓词下推是否生效
Structured Streaming 页面:
- Input Rate:每秒输入数据条数,反映流量波动
- Processing Rate:每秒处理数据条数,若持续低于 Input Rate 说明处理能力不足
- Batch Duration:每个微批的处理耗时,若持续接近 Trigger Interval 说明背压严重
- Watermark 信息:展示当前 Watermark 位置、迟到数据丢弃情况
- State Operator:状态算子(聚合/Join)的状态行数、内存占用
实战:通过 UI 定位数据倾斜的步骤:
- 打开 Stages 页面,找到耗时最长的 Stage,点击 Description 进入详情
- 查看 Summary Metrics 表,对比 Shuffle Read 的 Max 和 Median。例如 Median 为 128MB 而 Max 为 8.5GB,确认倾斜
- 点击 Tasks 表,按 Shuffle Read Size 降序排列,找到处理最大数据量的 Task
- 记录该 Task 的 Locality Level 和 Executor ID,排除节点本地性问题
- 返回 SQL 页面,找到对应 Stage 的执行计划,确认是 Join 还是聚合导致倾斜
- 若为 Join 倾斜:检查 Join Key 分布,对热点 Key 加盐或开启 AQE Skew Join
- 若为聚合倾斜:使用两阶段聚合(加盐局部聚合 + 去盐全局聚合)
- 重新提交作业,在 Stages 页面验证 Task 耗时是否均匀
8.11 资源规划与配置参数
Executor 资源规划公式:
推荐配置:
  --num-executors    = ceil(总数据量 / (executor-cores × 单核算力))
  --executor-cores   = 3 ~ 5(建议 4)
  --executor-memory   = 4g ~ 8g(建议 6g)
  --driver-memory     = 2g ~ 4g(复杂作业建议 4g+)

经验法则:
  1. 每个 Executor 分配 4 Core,6GB 内存为黄金配比
  2. YARN 总核数 = num-executors × executor-cores
  3. 预留 10%~20% 集群资源给系统和其他服务
  4. Executor 数量 = 集群总核数 / executor-cores × 0.8
常见踩坑:
| 问题 | 原因 | 解决方案 |
|---|---|---|
| executor-memory 过大导致 GC | 单 Executor 超过 8GB,JVM GC 停顿时间长 | 控制在 4-8GB,增加 Executor 数量而非单 Executor 内存 |
| cores 过多导致 HDFS 并发 | 单 Executor 超过 5 Core,HDFS 客户端并发写导致超时 | 控制在 3-5 Core,HDFS 并发度 = executor-cores × num-executors |
| Driver OOM | collect() 大量数据或广播大表 | 增大 driver-memory;避免 collect 大数据集 |
| YARN Container 被 Kill | 物理内存超 Container 限制 | 增大 spark.yarn.executor.memoryOverhead |
YARN 模式内存开销:
YARN Container 内存 = spark.executor.memory + spark.executor.memoryOverhead

memoryOverhead 默认值 = max(executor-memory × spark.kubernetes.memoryOverheadFactor, 384MB)
YARN 模式默认 factor = 0.10

示例:
  --executor-memory 6g
  默认 memoryOverhead = max(6g × 0.10, 384MB) ≈ 614MB
  Container 总内存 = 6g + 614MB ≈ 6.7GB

调优建议:
  --conf spark.yarn.executor.memoryOverhead=1g   # 显式指定,避免默认不足
关键配置参数速查表:
| 参数名 | 默认值 | 说明 | 推荐值 |
|---|---|---|---|
spark.sql.shuffle.partitions | 200 | Shuffle 后分区数 | 总核数 × 2-3(开启 AQE 后可适当调大) |
spark.executor.memory | 1g | 每个 Executor 堆内存 | 4g-8g |
spark.executor.cores | 1 | 每个 Executor CPU 核数 | 4 |
spark.executor.instances | — | Executor 数量(YARN/K8s) | 按集群资源计算 |
spark.sql.adaptive.enabled | false(3.x 建议 true) | 开启 AQE 自适应执行 | true |
spark.sql.adaptive.coalescePartitions.enabled | true | AQE 自动合并小分区 | true |
spark.sql.adaptive.coalescePartitions.minPartitionNum | 1 | 合并后最小分区数 | 总核数 × 1 |
spark.sql.adaptive.advisoryPartitionSizeInBytes | 64MB | AQE 目标分区大小 | 128MB |
spark.sql.adaptive.skewJoin.enabled | true | AQE 自动处理倾斜 Join | true |
spark.sql.adaptive.skewJoin.skewedPartitionFactor | 5 | 倾斜分区判定因子(倍数) | 5(默认即可) |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes | 256MB | 倾斜分区最小数据量阈值 | 256MB |
spark.sql.autoBroadcastJoinThreshold | 10MB | 小表自动广播阈值 | 100MB(视内存调整) |
spark.serializer | org.apache.spark.serializer.JavaSerializer | 序列化器 | org.apache.spark.serializer.KryoSerializer |
spark.memory.fraction | 0.6 | Spark 内存占 Executor 比例 | 0.6(默认,缓存多可降至 0.5) |
spark.memory.storageFraction | 0.5 | Storage 占 Spark 内存比例 | 0.5(默认) |
spark.speculation | false | 推测执行(慢 Task 备份) | true(集群空闲时开启) |
spark.sql.files.maxPartitionBytes | 128MB | 读取文件时单个分区最大字节 | 128MB(大集群可调至 256MB) |
spark.sql.files.openCostInBytes | 4MB | 打开文件的估算开销(小文件合并用) | 8MB(小文件多时增大) |
spark.sql.broadcastTimeout | 300s | 广播等待超时 | 600(大表广播时) |
spark.network.timeout | 120s | 网络通信超时 | 300s(大 Shuffle 时) |
spark.streaming.kafka.consumer.cache.enabled | true | 缓存 Kafka 消费者 | true(默认,避免重复创建) |
spark.sql.crossJoin.enabled | false | 允许笛卡尔积 | false(默认,禁止意外笛卡尔积) |
spark.shuffle.service.enabled | false | External Shuffle Service | true(YARN 动态分配必须) |
spark.dynamicAllocation.enabled | false | 动态资源分配 | true(配合 ESS) |
spark.sql.session.timeZone | JVM 默认 | 会话时区 | Asia/Shanghai |
9. Spark 常见问题与踩坑
9.1 OOM(OutOfMemoryError)
| 类型 | 原因 | 解决方案 |
|---|---|---|
| Driver OOM | collect() 拉取大量数据到 Driver | 用 take()/sample()/write 替代;增大 driver-memory |
| Executor OOM | 数据倾斜、缓存过多、大表广播 | 解决倾斜;调整缓存策略;增大 executor-memory |
| GC Overhead | JVM 堆外内存不足 | 增大 spark.executor.memoryOverhead(默认 executor-memory × 0.1) |
| Python Worker OOM | Pandas UDF 内存占用大 | 增大 Arrow 批量;分批处理 |
# 堆外内存配置(重要!)
--conf spark.executor.memoryOverhead=2g \
--conf spark.driver.memoryOverhead=1g \
--conf spark.python.worker.memory=2g
9.2 数据倾斜
见 8.1 节。典型症状:99% 的 Task 很快完成,1% 的 Task 卡住不动。
9.3 Shuffle Fetch Failed
org.apache.spark.shuffle.FetchFailedException:
Failed to connect to /xxx:xxxx
常见原因与解决:
- Executor 内存不足导致被 YARN Kill:增大 executor-memory / memoryOverhead
- 网络超时:增大
spark.shuffle.io.maxRetries(默认 3)和spark.shuffle.io.retryWait(默认 5s) - Shuffle 文件过大:增加 Shuffle 分区数
- 节点故障:开启
spark.shuffle.service.enabled=true(External Shuffle Service)
9.4 序列化错误
org.apache.spark.SparkException: Task not serializable
原因:在 RDD/DataFrame 的闭包中引用了不可序列化的对象(如数据库连接、非序列化的外部类)。
解决:
- 在函数内部创建不可序列化对象(如数据库连接),不要在 Driver 端创建后传入
- 使用
foreachPartition/mapPartitions,每个分区创建一次连接 - 使用 Kryo 序列化并注册类
# ✅ 正确:在分区内创建连接
def process_partition(rows):
    conn = create_db_connection()  # 每个分区创建一次
    for row in rows:
        conn.insert(row)
    conn.close()

df.foreachPartition(process_partition)
9.5 时区问题
# Spark 默认使用 UTC 时区,可能导致时间差 8 小时
spark.conf.set("spark.sql.session.timeZone", "Asia/Shanghai")

# 读取时指定时区
df = spark.read.option("timestampFormat", "yyyy-MM-dd HH:mm:ss") \
    .option("timeZone", "Asia/Shanghai").csv("data.csv")
9.6 UDF 性能问题
- Python UDF 性能差,优先使用 Spark SQL 内置函数
- 必须用 UDF 时,使用 Pandas UDF(向量化)
- 避免在 UDF 中创建重型对象,用
mapPartitions替代
9.7 其他常见坑
| 问题 | 说明 |
|---|---|
count() 触发重算 | 未 cache 的 RDD/DataFrame,每次 Action 都从头计算 |
collect() 内存溢出 | 确保结果集不超过 Driver 内存 |
| 隐式类型转换错误 | 数字与字符串比较时注意类型 |
| Hive 分区不生效 | 执行 MSCK REPAIR TABLE 或添加分区 |
| Spark UI 看不到 | YARN cluster 模式下通过 ResourceManager 代理访问 |
| 文件已存在报错 | 使用 .mode("overwrite") 或先删除 |
10. 端到端实战项目
10.1 项目背景:电商用户行为日志分析平台
项目目标:构建一个流批一体的电商用户行为分析平台,实时采集用户点击流数据,结合业务库数据,完成实时指标统计和离线报表分析。
数据源:
| 数据源 | 内容 | 采集方式 |
|---|---|---|
| Kafka 用户点击流 | 页面浏览、点击、搜索、加购等行为事件 | Flume/SDK → Kafka |
| MySQL 订单库 | 订单主表、订单明细 | Flink CDC / Spark JDBC 全量+增量 |
| MySQL 用户库 | 用户基本信息、地域信息 | 每日全量同步 |
| MySQL 商品库 | 商品分类、价格、品牌 | 每日全量同步 |
技术栈:
- 计算引擎:Spark 3.5(Structured Streaming 实时 + Spark SQL 离线)
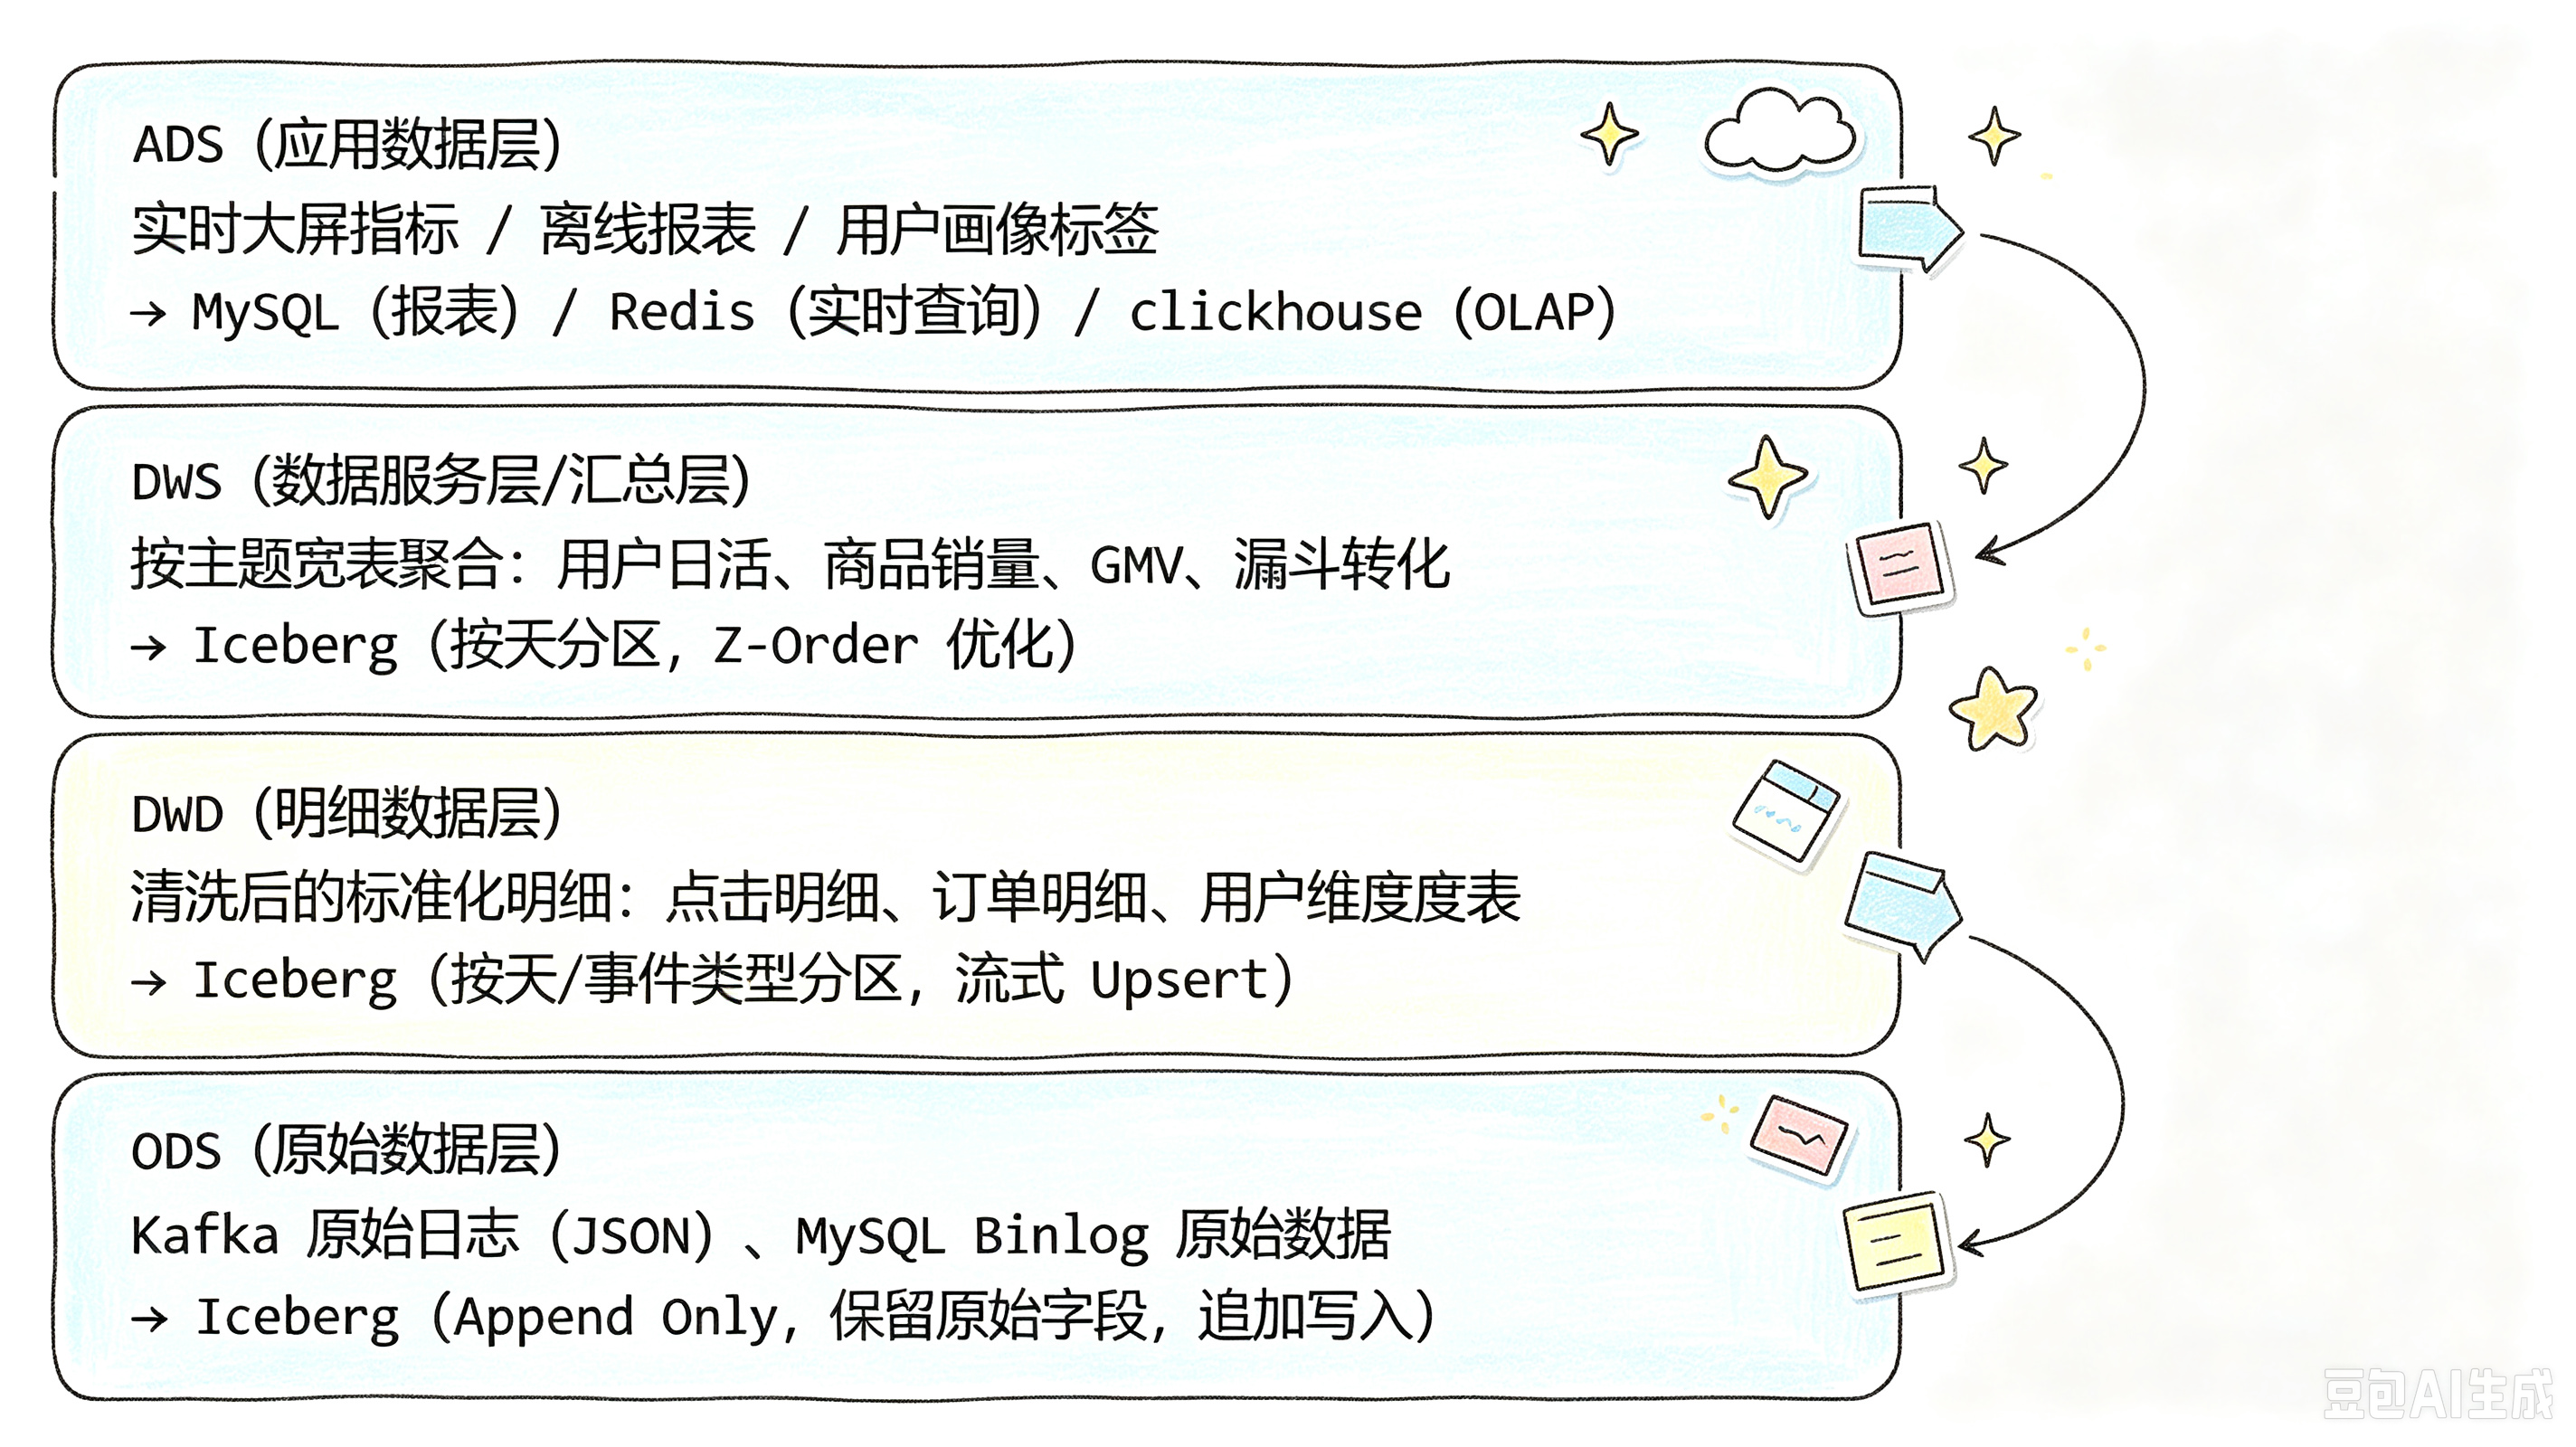
- 数据湖:Apache Iceberg(ODS/DWD/DWS/ADS 分层存储)
- 消息队列:Kafka
- 缓存:Redis(实时指标查询)
- 业务库:MySQL(ADS 报表数据)
- 资源调度:YARN / K8s
- 监控:Prometheus + Grafana
分层架构:
10.2 项目架构图
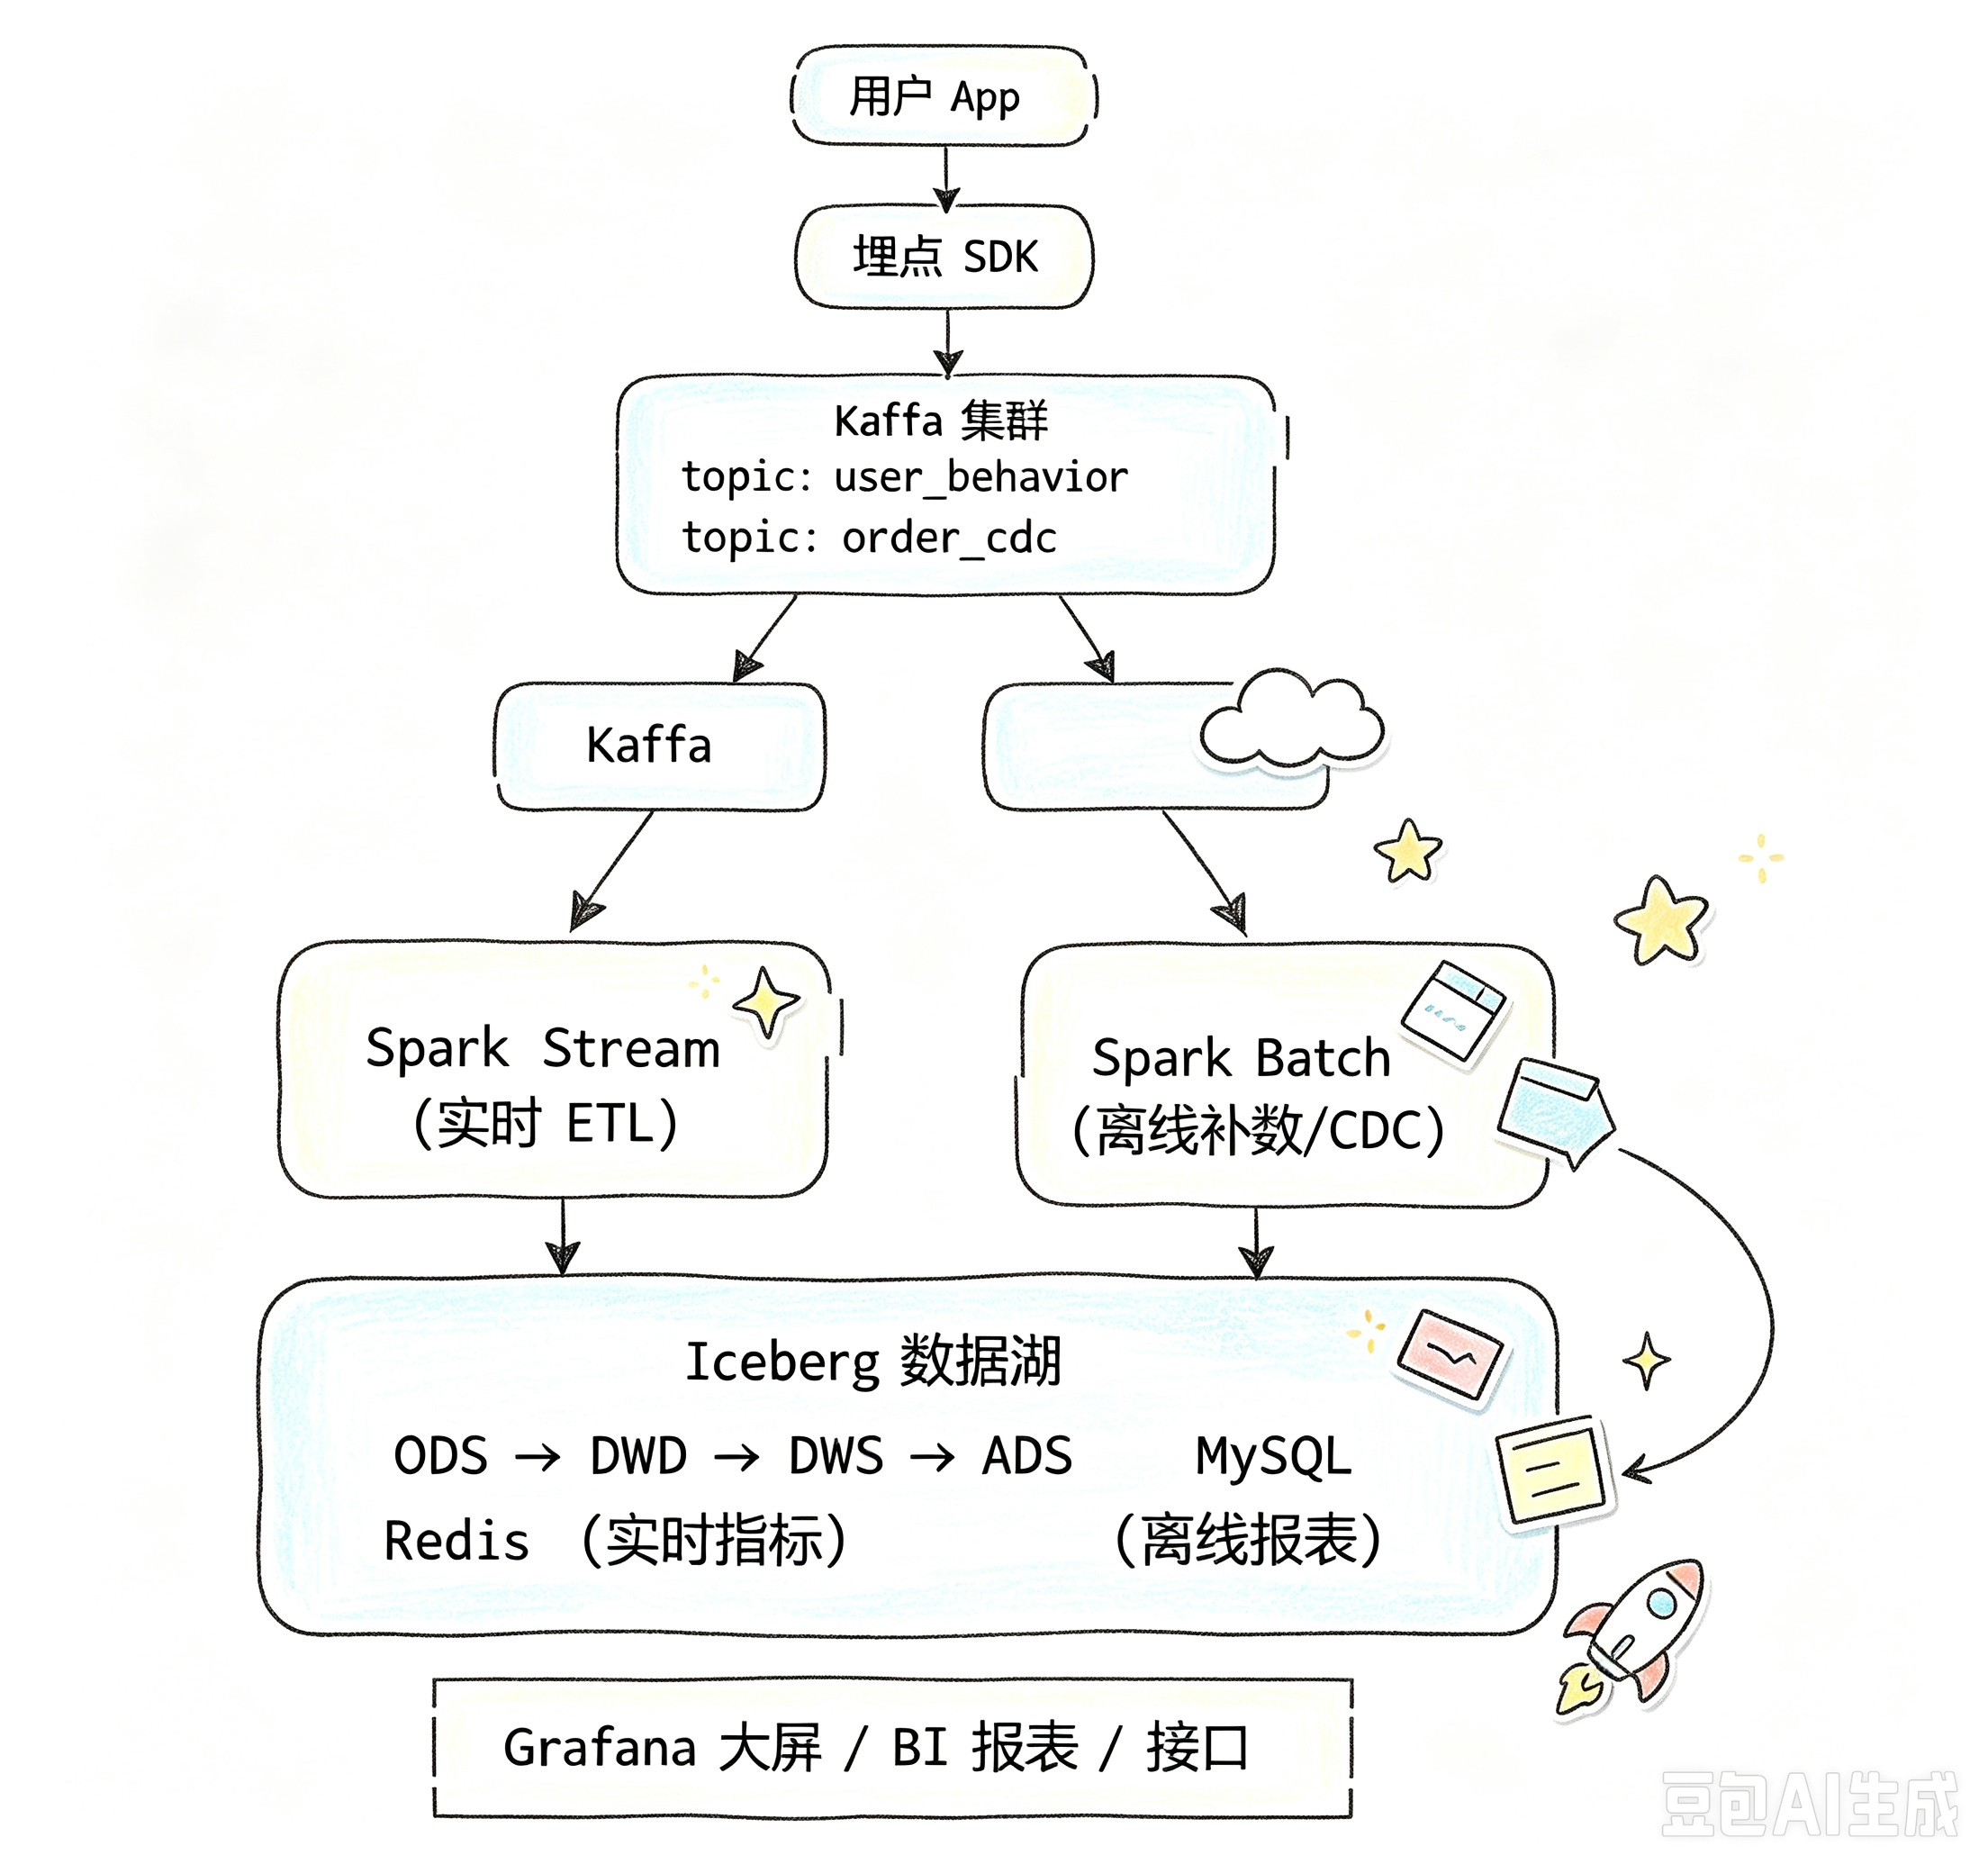
10.3 核心代码
1. Kafka 消费 + 数据清洗写入 Iceberg ODS:
from pyspark.sql import SparkSession
from pyspark.sql.functions import from_json, col, current_timestamp
from pyspark.sql.types import StructType, StructField, StringType, LongType, DoubleType

spark = SparkSession.builder \
    .appName("UserBehaviorODS") \
    .config("spark.sql.catalog.local", "org.apache.iceberg.spark.SparkCatalog") \
    .config("spark.sql.catalog.local.type", "hadoop") \
    .config("spark.sql.catalog.local.warehouse", "s3://lakehouse/warehouse") \
    .getOrCreate()

schema = StructType([
    StructField("user_id", LongType()),
    StructField("event_type", StringType()),   # view/click/cart/search/buy
    StructField("product_id", LongType()),
    StructField("category_id", LongType()),
    StructField("event_time", StringType()),
    StructField("device", StringType()),
    StructField("ip", StringType()),
])

kafka_df = spark.readStream \
    .format("kafka") \
    .option("kafka.bootstrap.servers", "kafka1:9092,kafka2:9092") \
    .option("subscribe", "user_behavior") \
    .option("startingOffsets", "latest") \
    .option("maxOffsetsPerTrigger", 100000) \
    .load()

parsed = kafka_df.select(
    from_json(col("value").cast("string"), schema).alias("data")
).select("data.*") \
 .withColumn("ingest_time", current_timestamp()) \
    .withColumn("dt", col("event_time").substr(1, 10))

# 写入 Iceberg ODS(追加模式)
parsed.writeStream \
    .format("iceberg") \
    .option("path", "local.ods.user_behavior") \
    .option("checkpointLocation", "s3://checkpoints/ods_user_behavior") \
    .trigger(processingTime="30 seconds") \
    .outputMode("append") \
    .start()
2. 维度 Join(Broadcast)写入 DWD:
from pyspark.sql.functions import broadcast

# 加载维度表(小表广播)
dim_user = spark.read.format("iceberg").load("local.dim.dim_user")
dim_product = spark.read.format("iceberg").load("local.dim.dim_product")

# 从 ODS 流式读取
ods_stream = spark.readStream \
    .format("iceberg") \
    .option("stream-from-timestamp", str(int((__import__('time').time() - 86400) * 1000))) \
    .load("local.ods.user_behavior")

# 维度关联:广播小表避免 Shuffle
dwd = ods_stream.alias("o") \
    .join(broadcast(dim_user).alias("u"),
          col("o.user_id") == col("u.user_id"), "left") \
    .join(broadcast(dim_product).alias("p"),
          col("o.product_id") == col("p.product_id"), "left") \
    .select(
        col("o.user_id"),
        col("u.age_group"),
        col("u.city"),
        col("o.event_type"),
        col("o.product_id"),
        col("p.category_name"),
        col("p.brand"),
        col("p.price"),
        col("o.event_time"),
        col("o.dt"),
    )

# Upsert 写入 DWD
dwd.writeStream \
    .format("iceberg") \
    .option("path", "local.dwd.dwd_user_behavior") \
    .option("checkpointLocation", "s3://checkpoints/dwd_user_behavior") \
    .trigger(processingTime="1 minute") \
    .start()
3. 窗口聚合写入 DWS:
from pyspark.sql.functions import window, count, sum as _sum, when, col

# 实时窗口聚合:每 1 分钟滚动窗口,统计各分类 PV/UV/加购数
dws_agg = dwd \
    .withWatermark("event_time", "10 minutes") \
    .groupBy(
        window(col("event_time"), "1 minute"),
        col("category_name"),
        col("dt"),
    ).agg(
        count("*").alias("pv"),
        count("user_id").alias("event_count"),
        _sum(when(col("event_type") == "cart", 1).otherwise(0)).alias("cart_count"),
        _sum(when(col("event_type") == "buy", col("price")).otherwise(0)).alias("gmv"),
    ).select(
        col("window.start").alias("window_start"),
        col("window.end").alias("window_end"),
        col("category_name"),
        col("pv"),
        col("event_count"),
        col("cart_count"),
        col("gmv"),
        col("dt"),
    )

dws_agg.writeStream \
    .format("iceberg") \
    .option("path", "local.dws.dws_category_realtime") \
    .option("checkpointLocation", "s3://checkpoints/dws_category_rt") \
    .outputMode("append") \
    .trigger(processingTime="1 minute") \
    .start()
4. ADS 结果输出到 MySQL/Redis:
def write_to_mysql(batch_df, batch_id):
    """将每批次结果写入 MySQL(幂等:REPLACE INTO)"""
    batch_df.write \
        .format("jdbc") \
        .option("url", "jdbc:mysql://mysql:3306/ads") \
        .option("dbtable", "ads_category_realtime") \
        .option("user", "spark") \
        .option("password", "xxx") \
        .option("driver", "com.mysql.cj.jdbc.Driver") \
        .mode("append") \
        .save()

def write_to_redis(batch_df, batch_id):
    """将实时指标写入 Redis,供大屏查询"""
    import redis
    r = redis.Redis(host='redis', port=6379, db=0)
    for row in batch_df.collect():
        key = f"ads:category:{row['category_name']}:{row['window_start']}"
        r.hset(key, mapping={
            "pv": row["pv"],
            "cart_count": row["cart_count"],
            "gmv": float(row["gmv"]),
        })
        r.expire(key, 86400)

# 双流写入
dws_agg.writeStream \
    .foreachBatch(lambda df, id: (write_to_mysql(df, id), write_to_redis(df, id))) \
    .option("checkpointLocation", "s3://checkpoints/ads_sink") \
    .trigger(processingTime="1 minute") \
    .start()
5. 离线补数(批式回刷历史数据):
from datetime import datetime, timedelta

def backfill(start_date, end_date):
    """批量回刷指定日期范围的数据"""
    spark = SparkSession.builder.appName("Backfill").getOrCreate()

    current = datetime.strptime(start_date, "%Y-%m-%d")
    end = datetime.strptime(end_date, "%Y-%m-%d")

    while current <= end:
        dt = current.strftime("%Y-%m-%d")
        print(f"Backfilling {dt} ...")

        # 读取 ODS 指定分区
        ods_df = spark.read.format("iceberg") \
            .load("local.ods.user_behavior") \
            .where(col("dt") == dt)

        # 关联维度
        dwd_df = ods_df.alias("o") \
            .join(broadcast(dim_user), "user_id", "left") \
            .join(broadcast(dim_product), "product_id", "left")

        # 覆盖写入 DWD 指定分区
        dwd_df.writeTo("local.dwd.dwd_user_behavior") \
            .overwritePartitions()

        current += timedelta(days=1)

    spark.stop()

# 执行回刷
backfill("2024-01-01", "2024-01-15")
10.4 项目要点
幂等写入与 Checkpoint 管理:
- Checkpoint 目录存储 Kafka offset、聚合状态和事务元数据,删除 Checkpoint = 从头消费
- 生产环境 Checkpoint 应放在可靠存储(HDFS/S3),并设置生命周期管理
- 幂等写入策略:Iceberg 通过 MERGE INTO 按主键 Upsert;MySQL 使用
REPLACE INTO或INSERT ... ON DUPLICATE KEY UPDATE - 重新部署时保留 Checkpoint,仅在需要重置时手动删除
延迟数据处理(Watermark + allowedLateness):
# 设置 10 分钟 Watermark:允许事件时间最多比处理时间晚 10 分钟
df.withWatermark("event_time", "10 minutes")

# Iceberg 流式写入可配合 to-snapshot 处理迟到数据
# 超过 Watermark 的数据会被丢弃,但 Iceberg 的 Time Travel 可追溯
# 对于重要的迟到数据,可在 ODS 层保留全量,通过离线补数修复 DWS/DWS
- Watermark 阈值根据业务延迟特征设置(一般 5-30 分钟)
- 对于严重延迟的数据(如客户端断网数小时),建议通过离线批处理补数修正
- 在 ODS 层保留原始数据(Append Only,不删不改),作为"真相源"
监控告警(Streaming Query Listener):
from pyspark.sql.streaming import StreamingQueryListener

class MyListener(StreamingQueryListener):
    def onQueryStarted(self, event):
        print(f"Query started: {event.id}")

    def onQueryProgress(self, event):
        progress = event.progress
        print(f"Batch {progress.batchId}: "
              f"input={progress.numInputRows} rows, "
              f"rate={progress.inputRowsPerSecond:.1f}/s, "
              f"duration={progress.batchDuration}ms")

        # 告警条件:处理速率低于输入速率(消费滞后)
        if progress.inputRowsPerSecond > progress.processedRowsPerSecond * 1.5:
            send_alert(f"Consumer lag! input={progress.inputRowsPerSecond}, "
                       f"processed={progress.processedRowsPerSecond}")

        # 告警:批次耗时异常
        if progress.batchDuration > 120000:  # 超过 2 分钟
            send_alert(f"Batch duration too long: {progress.batchDuration}ms")

    def onQueryTerminated(self, event):
        print(f"Query terminated: {event.id}, exception={event.exception}")
        if event.exception:
            send_alert(f"Streaming query failed: {event.exception}")

spark.streams.addListener(MyListener())

def send_alert(msg):
    """对接 Prometheus AlertManager / 钉钉 / 企业微信"""
    import requests
    requests.post("https://alert-webhook.example.com/", json={"text": msg})
常见问题:
| 问题 | 原因 | 解决方案 |
|---|---|---|
| 小文件过多 | 每批次产生大量小 Parquet 文件 | 开启 Iceberg write.distribution-mode=hash;定期执行 rewrite_data_files 合并 |
| Kafka offset 丢失 | Checkpoint 损坏或被误删 | 备份 Checkpoint;设置 kafka.group.id 配合外部 Offset 管理 |
| Schema 变更 | 上游新增字段导致流解析失败 | 使用 from_json 时开启 mergeSchema=true;Iceberg 支持 Schema 演化新增列 |
| 状态过大 | 无限聚合导致 State 膨胀 | 设置 Watermark 清理过期状态;使用 RocksDB State Backend;定期 Rebalance |
| Executor OOM | 大窗口聚合或数据倾斜 | 增大内存;加盐打散热点 Key;开启 AQE Skew Join |
| 写入冲突 | 并发写同一 Iceberg 表 | Iceberg 支持乐观并发,重试事务;避免流和批同时写同一分区 |
| Kafka 消费积压 | 处理能力不足 | 增加 Executor/分区数;优化处理逻辑;使用 maxOffsetsPerTrigger 限流 |
11. Spark 3.x 新特性
11.1 AQE(自适应查询执行)
Spark 3.0 最重要的特性,详见 5.8 节。Spark 3.x 持续增强:
- Spark 3.2:AQE 支持 BroadcastNestedLoopJoin 优化
- Spark 3.5:AQE 对窗口函数的优化增强
11.2 Dynamic Partition Pruning(动态分区裁剪)
Spark 3.0 引入,在星型模型的 Join 中,自动根据维度表过滤条件裁剪事实表的分区,避免扫描无关数据。
-- 维度表 products 只查询了 category='Electronics'
-- DPP 会自动将事实表 sales 的分区裁剪到相关产品
SELECT * FROM sales s
JOIN products p ON s.product_id = p.id
WHERE p.category = 'Electronics';
11.3 Pandas API on Spark
Spark 3.2 引入(原 Koalas 项目合并),让 Pandas 用户可以几乎无学习成本地使用 Spark:
import pyspark.pandas as ps

# Pandas 风格的 API,自动分布式执行
pdf = ps.read_csv("hdfs:///data/huge_file.csv")
result = pdf.groupby("category")["amount"].sum().reset_index()
result.to_parquet("hdfs:///output/summary.parquet")

# Pandas API on Spark 与 PySpark DataFrame 互转
sdf = result.to_spark()
pdf = sdf.to_pandas_on_spark()
11.4 Spark Connect
Spark 3.4 正式发布,将客户端与 Spark 集群解耦。客户端(瘦客户端)通过 gRPC 与 Spark Driver 通信,支持:
- 任意 IDE / Notebook 作为客户端,无需在本地安装 Spark
- 多语言、多版本客户端连接同一 Spark 集群
- 微服务架构中嵌入 Spark 能力
# 使用 Spark Connect 连接远程集群
spark = SparkSession.builder \
    .remote("sc://spark-driver:15002") \
    .getOrCreate()
11.5 ANSI SQL 模式
Spark 3.0 开始引入 ANSI SQL 兼容模式,Spark 3.4/3.5 大幅完善:
spark.conf.set("spark.sql.ansi.enabled", "true")
启用后:
- 除零报错(而非返回 NULL)
- 整数溢出报错
- 字符串转数字失败报错
- 类型转换更严格
- 保留关键字与标准 SQL 一致
11.6 Python 性能提升
- PySpark 优化:Spark 3.x 大幅改善了 Python API 的性能
- Arrow 优化:Pandas UDF / Pandas API on Spark 使用 Apache Arrow 实现高效数据交换
- Python 进程复用:Python Worker 复用,减少启动开销
- Spark 3.5:Python UDF 支持 profiling,便于性能分析
- Spark 4.0 预览:进一步优化 Python 路径,引入更高效的 DataFrame 内部表示
11.7 其他重要特性
| 版本 | 特性 |
|---|---|
| 3.0 | AQE、DPP、加速器感知调度(GPU/YARN)、Java 11+ |
| 3.1 | Predicate Hint、Session Window、ANSI 间隔类型 |
| 3.2 | Pandas API on Spark、Session Window、ANSI 模式增强 |
| 3.3 | Row-level runtime filtering、TIMESTAMP_NTZ 类型 |
| 3.4 | Spark Connect 稳定、Python Profiler、默认 UTC 时区 |
| 3.5 | Python UDT、Named Variable、Arrow 优化、Lateral Column Alias |
| 4.0(预览) | 更强 ANSI SQL、列式处理优化、更好的 Python 体验、Variant 类型 |
12. 学习路线与实战建议
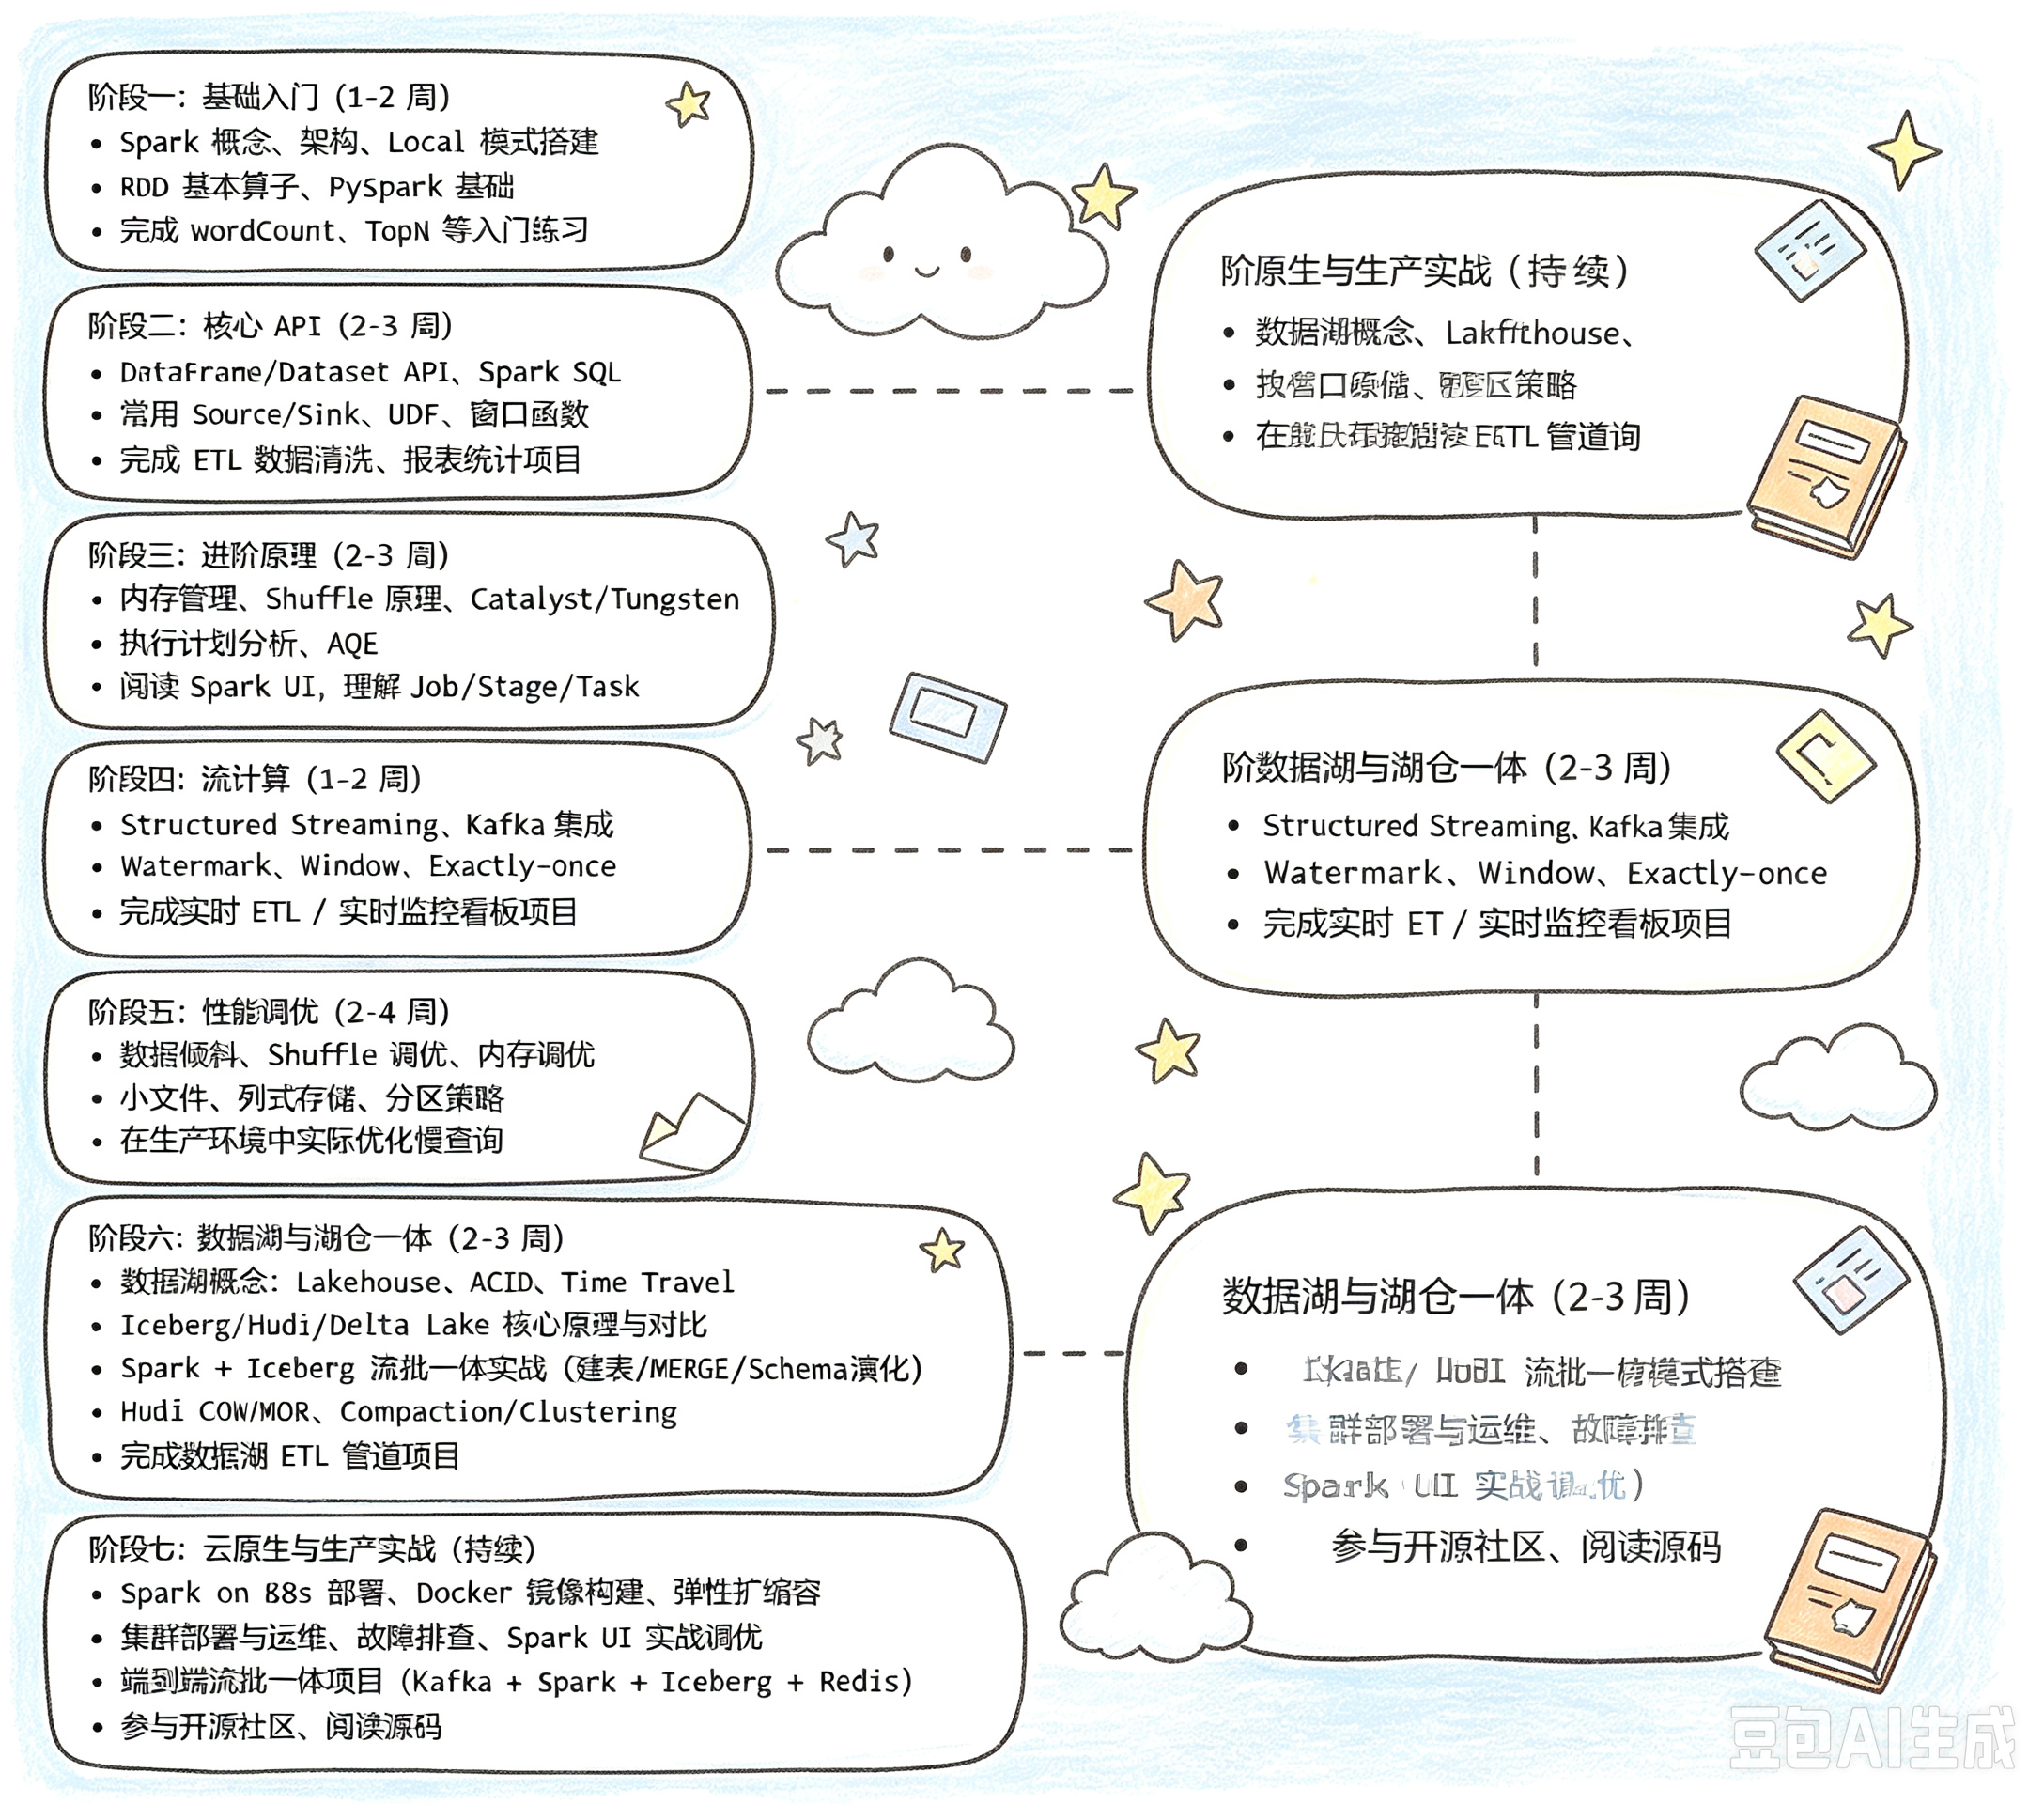
12.1 学习阶段划分
12.2 推荐资源
书籍:
- 《Spark 权威指南》(Bill Chambers 等)—— 最适合入门
- 《Spark 快速大数据分析》(Holden Karau 等)—— RDD 经典
- 《Spark SQL 内核剖析》—— 深入 Catalyst 源码
- 《高性能 Spark》—— 性能调优进阶
官方文档:
在线课程:
- Databricks Academy(官方培训)
- edX / Coursera 上的 Berkeley 大数据课程
源码与社区:
- GitHub: https://github.com/apache/spark
- Stack Overflow 的
apache-spark标签 - Databricks Blog(最佳实践和技术深度文章)
12.3 实战项目建议
| 项目 | 技术点 | 难度 |
|---|---|---|
| 网站日志分析 | RDD/DataFrame、ETL、聚合 | ⭐ |
| 电商用户行为分析 | Spark SQL、窗口函数、漏斗分析 | ⭐⭐ |
| 实时风控系统 | Structured Streaming、Kafka、CEP | ⭐⭐⭐ |
| 推荐系统特征工程 | MLlib、特征拼接、模型训练 | ⭐⭐⭐ |
| 数据湖 ETL 管道 | Iceberg/Hudi、分区演进、流批一体 | ⭐⭐⭐⭐ |
| Spark on K8s 部署实践 | Docker 镜像、K8s 配置、弹性调度 | ⭐⭐⭐⭐ |
| 电商实时数仓 | Kafka + SS + Iceberg + Redis、Watermark | ⭐⭐⭐⭐⭐ |
| 大规模数据倾斜治理 | AQE、加盐、Broadcast Join、Spark UI 排查 | ⭐⭐⭐⭐ |
12.4 面试高频考点
- Spark 架构:Driver/Executor 工作流程,YARN cluster vs client 区别
- RDD 原理:五大特性、宽窄依赖、血缘容错
- Shuffle:Shuffle 过程、SortShuffle 与 HashShuffle 区别、Shuffle 调优
- 数据倾斜:成因、诊断、至少三种解决方案
- Spark SQL:Catalyst 优化流程、AQE 原理、Tungsten
- 内存管理:统一内存模型、各区域比例、OOM 排查
- 持久化:cache/persist/checkpoint 区别
- Join 策略:BroadcastHashJoin、SortMergeJoin、ShuffledHashJoin
- Exactly-Once:Structured Streaming 如何保证
- Spark 3.x 新特性:AQE、DPP、Spark Connect
- 数据湖选型:Delta Lake / Iceberg / Hudi 对比,各自适用场景
- Spark UI 倾斜排查:如何通过 Stages 页面的 Task Max/Median 定位数据倾斜
- Iceberg Time Travel 原理:Snapshot/Manifest 机制,如何实现历史版本读取
- Hudi COW vs MOR:写入/读取差异、Compaction 时机、选型建议
- Spark on K8s vs YARN:架构差异、弹性/隔离/生态对比、适用场景
- Iceberg 分区演化:与 Hive 分区的区别,如何实现隐式分区
- Hudi Compaction/Clustering:作用、触发策略、对读写性能的影响
总结
Spark 作为大数据领域最主流的计算引擎,其生态完整、社区活跃、就业需求旺盛。学习 Spark 的关键路径是:
- 先建立全局认知:理解架构和运行原理,不要只停留在 API 调用
- 动手实践:Local 模式搭起来,写代码跑通比看十篇文章都有用
- 读懂 Spark UI:它是诊断性能问题的最佳工具
- 深入 SQL:Spark SQL 是当前和未来的核心,DataFrame API 和 SQL 都要熟练
- 关注数据倾斜:这是生产环境最常遇到的问题
- 与时俱进:关注 AQE、Spark Connect、Pandas API on Spark 等新特性,以及 Spark 4.0 的方向
大数据技术栈虽广,但 Spark 是那个"牵一发而动全身"的核心引擎。掌握了 Spark,你就拿到了数据工程领域的一把关键钥匙。
希望这份指南能帮你在 Spark 学习路上少走弯路。祝你学习愉快,早日成为 Spark 高手!🚀
更多推荐

 25
 0
- 0


 已为社区贡献6条内容

所有评论(0)