
Java 程序员第 46 阶段15:大模型调用链路追踪,SkyWalking 排查线上性能,集群部署实战OAP集群加高可用存储落地
前面 14 篇我们已经把大模型链路的采集、拆解、关联、告警、存储选型全部打通。但所有这些能力都建立在一个前提上:SkyWalking 自身是稳定可用的。如果 OAP 是单节点,它一宕机,全公司的链路监控就黑屏,正在发生的大模型事故你将完全失明。
本篇是阶段收官,讲如何把 SkyWalking 从"单机演示"升级为"生产级高可用":OAP 横向扩成无状态集群,存储用多节点 ES 加副本,前置负载均衡,并通过故障演练验证真正的高可用。落地这套架构,你才算真正具备"线上大模型性能问题 7x24 可观测"的能力。
- 为什么单节点不够:高可用诉求
- 整体架构:OAP 集群 + 高可用 ES
- 部署实战:OAP 无状态集群
- 高可用存储:ES 多节点 + 副本
- 负载均衡与网关接入
- 灰度发布与故障演练
- 最佳实践与踩坑
1. 为什么单节点不够:高可用诉求
单机 OAP 有三道致命单点:
第一,进程单点。OAP 挂了,Agent 上报失败(数据丢失或堆积在 Agent 缓冲),UI 打不开,告警停发。而在大模型高峰,恰恰最容易因写入压力把单 OAP 压垮。
第二,存储单点。即使是 ES,单节点磁盘损坏 = 历史 Trace 全丢,事故复盘无据。
第三,升级单点。改 OAP 配置或升级版本,必须停服,期间监控空白。
高可用的目标不是"永远不挂"(那不现实),而是"挂一个不影响整体":OAP 任一实例故障,其余实例无缝接管;存储一节点故障,副本保证数据不丢、读写不中断。
2. 整体架构:OAP 集群 + 高可用 ES
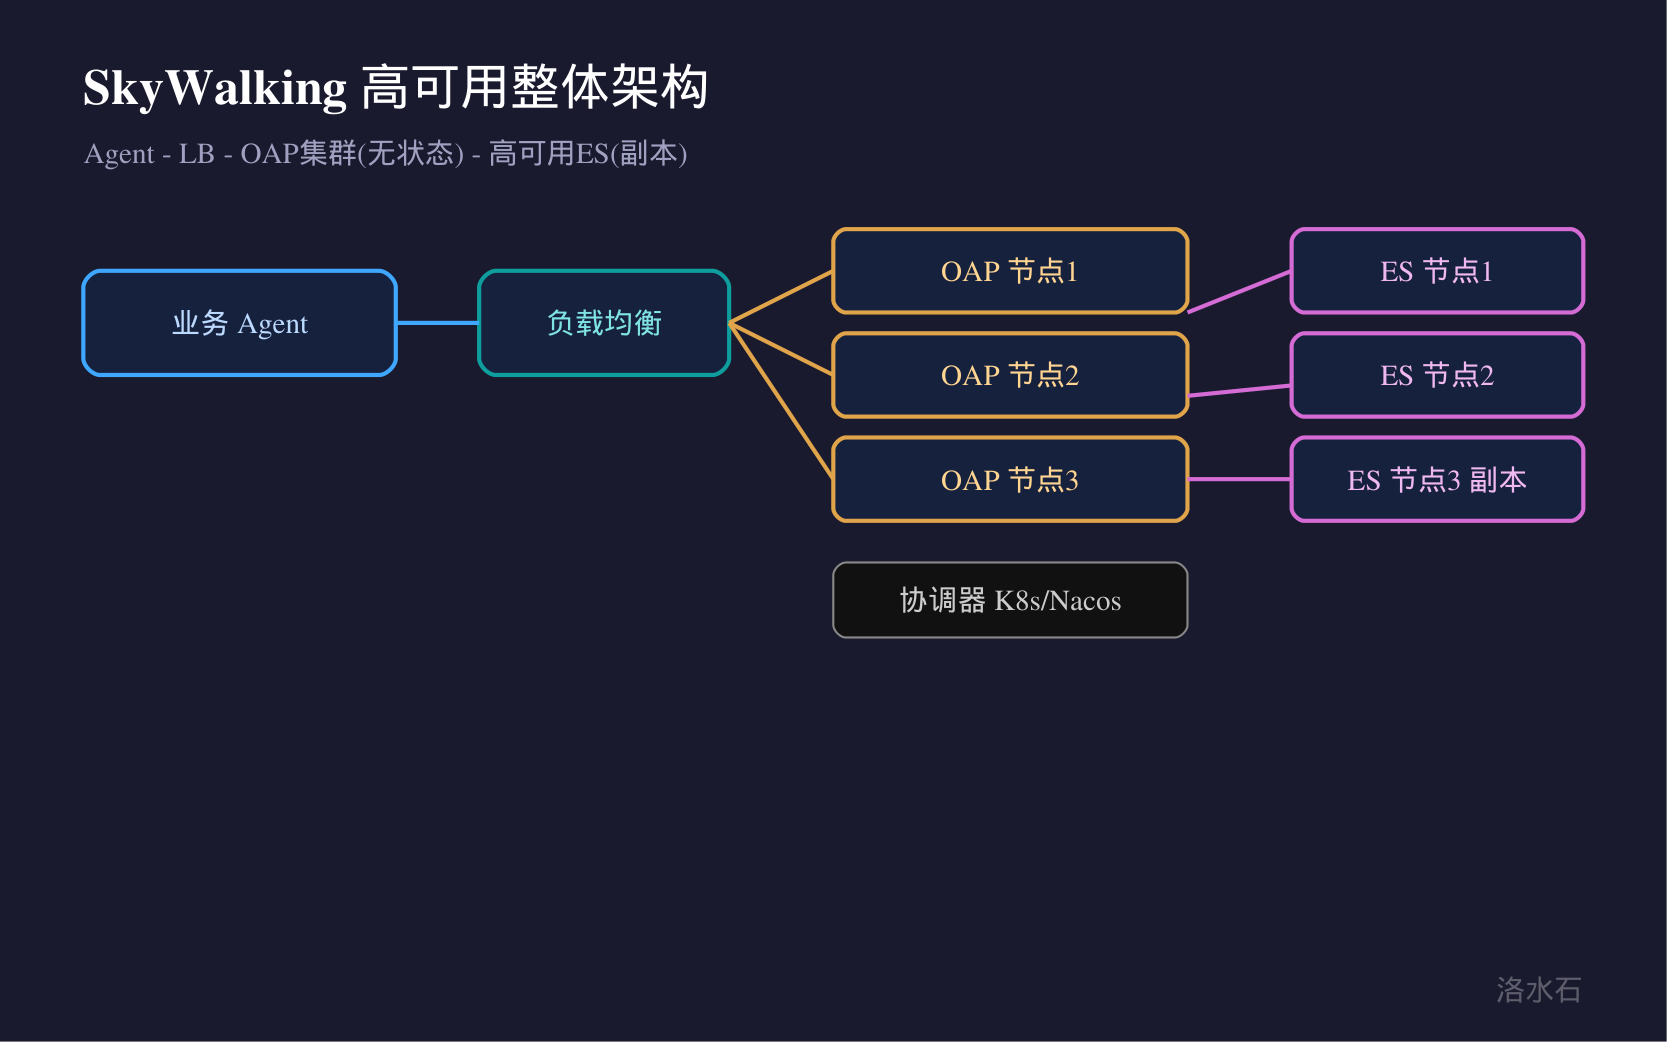
生产推荐架构(自上而下):
- 接入层:Agent 通过环境变量指向 `oap:11800`(gRPC),由 DNS / K8s Service 做客户端负载均衡;UI 前面挂 Nginx/SLB。
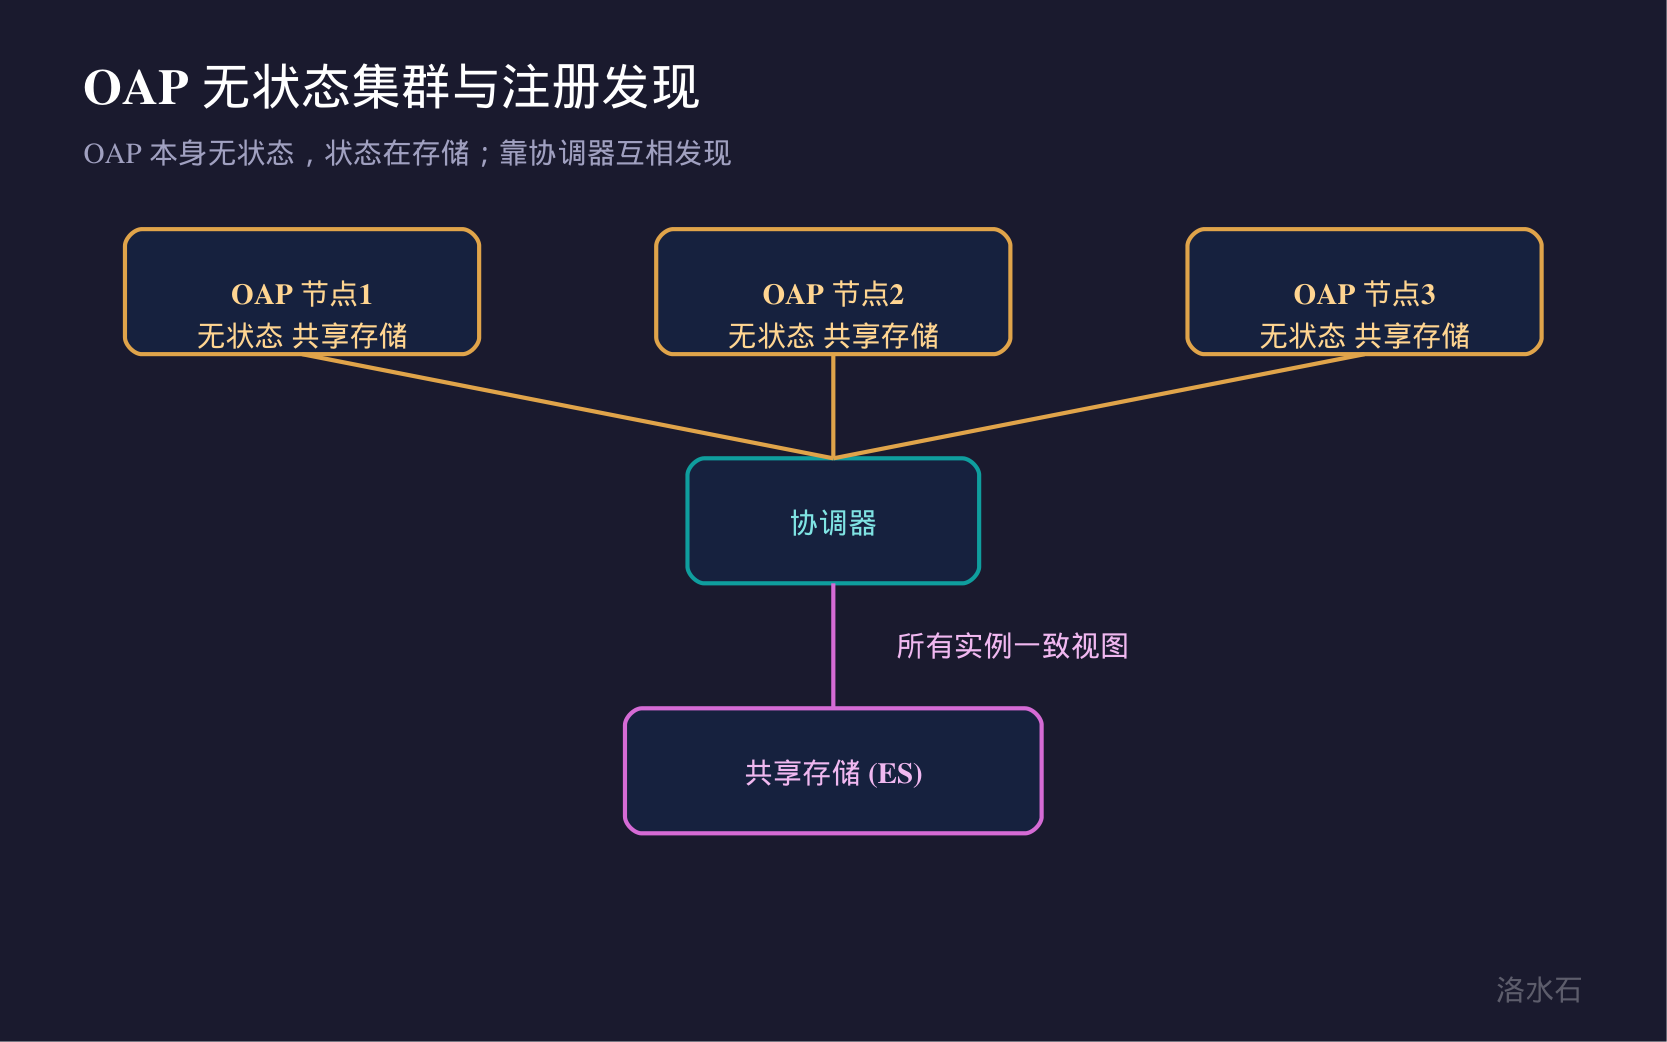
- 计算层:2~N 个 OAP 实例,无状态,共享同一存储,通过集群协调器(Kubernetes / Nacos / Zookeeper / Consul / Etcd)互相发现。
- 存储层:ES 至少 3 节点,索引副本数 >= 1,跨可用区部署。
- 协调层:选一个你们已有的协调服务(K8s 集群内直接用 `cluster.selector=kubernetes` 最省事)。
关键认知:OAP 无状态,正是因为它把状态全交给了存储。所以"集群部署"的重点,一半在 OAP 多实例,一半在存储高可用。两层都冗余,才是真高可用。
3. 部署实战:OAP 无状态集群
OAP 集群配置在 `application.yml` 的 `cluster` 段。以 Kubernetes 为例,最简洁:
cluster:
selector: ${SW_CLUSTER:kubernetes}
kubernetes:
namespace: ${SW_CLUSTER_K8S_NAMESPACE:skywalking}
labelSelector: ${SW_CLUSTER_K8S_LABEL:app=oap}
uidEnvName: ${SW_CLUSTER_K8S_UID:SKYWALKING_UID}
`core` 段固定 gRPC/HTTP 端口(多实例靠 K8s 多 Pod 实现,每个 Pod 内部端口相同):
core:
selector: ${SW_CORE:default}
default:
gRPCHost: ${SW_CORE_GRPC_HOST:0.0.0.0}
gRPCPort: ${SW_CORE_GRPC_PORT:11800}
restHost: ${SW_CORE_REST_HOST:0.0.0.0}
restPort: ${SW_CORE_REST_PORT:12800}
K8s Deployment 关键片段(3 副本):
apiVersion: apps/v1
kind: Deployment
metadata:
name: oap
namespace: skywalking
labels: { app: oap }
spec:
replicas: 3
selector:
matchLabels: { app: oap }
template:
metadata:
labels: { app: oap }
spec:
containers:
- name: oap
image: apache/skywalking-oap-server:9.7.0
env:
- name: SW_CLUSTER
value: kubernetes
- name: SW_STORAGE
value: elasticsearch
- name: SW_ES_CLUSTER_NODES
value: "es:9200"
ports:
- { containerPort: 11800 }
- { containerPort: 12800 }
Agent 侧通过 K8s Service 名访问,无需关心具体实例:
-DSW_AGENT_COLLECTOR_BACKEND_SERVICES=oap.skywalking.svc:11800
扩缩容只需改 `replicas`,OAP 通过协调器自动感知新节点,无数据迁移成本。
4. 高可用存储:ES 多节点 + 副本
ES 高可用靠分片副本。部署 3 个数据节点,SkyWalking 索引副本设为 1(即每份数据存 2 份,分布在 2 个节点):
storage:
elasticsearch:
clusterNodes: ${SW_ES_CLUSTER_NODES:es1:9200,es2:9200,es3:9200}
indexShardsNumber: 3
indexReplicasNumber: 1
副本的作用:某节点宕机,另一节点上的副本立即升为主分片,读写不中断。但副本数也不是越大越好——副本=2 会把写入放大约 2 倍、存储翻倍。大模型高写入场景,`replicas=1` 是性价比最优。
跨可用区部署时,用 ES 的 `shard allocation awareness` 让主副分片落在不同 AZ,避免单 AZ 故障同时丢主副:
# 每个节点标注 zone
# elasticsearch.yml
node.attr.zone: az-a # az-b / az-c
# 集群级
cluster.routing.allocation.awareness.attributes: zone
这样即使 az-a 整体断电,数据仍在 az-b/az-c 完整可用。
5. 负载均衡与网关接入
虽然 Agent 支持配置多个 `backend_service`(逗号分隔),但更稳妥是在前面放一层负载均衡,让 Agent 只认一个稳定地址。
Nginx 对 UI(rest 12800)做反向代理:
upstream oap_rest {
server oap-0:12800;
server oap-1:12800;
server oap-2:12800;
}
server {
listen 12800;
location / {
proxy_pass http://oap_rest;
proxy_set_header Host $host;
}
}
gRPC(11800)建议用支持 HTTP/2 的 LB(如 Nginx Plus、Envoy、或云 SLB 的 TCP 转发)。K8s 环境下直接用 Service 的 ClusterIP + kube-proxy 轮询即可,Agent 配 Service 名。
UI 单独部署(`skywalking-ui`),`SW_OAP_ADDRESS` 指向 LB 地址:
docker run -d --name ui -e SW_OAP_ADDRESS=http://oap-lb:12800 \
-p 8080:8080 apache/skywalking-ui:9.7.0
注意:UI 与 OAP 版本必须一致,否则 GraphQL 接口不兼容会白屏。
6. 灰度发布与故障演练
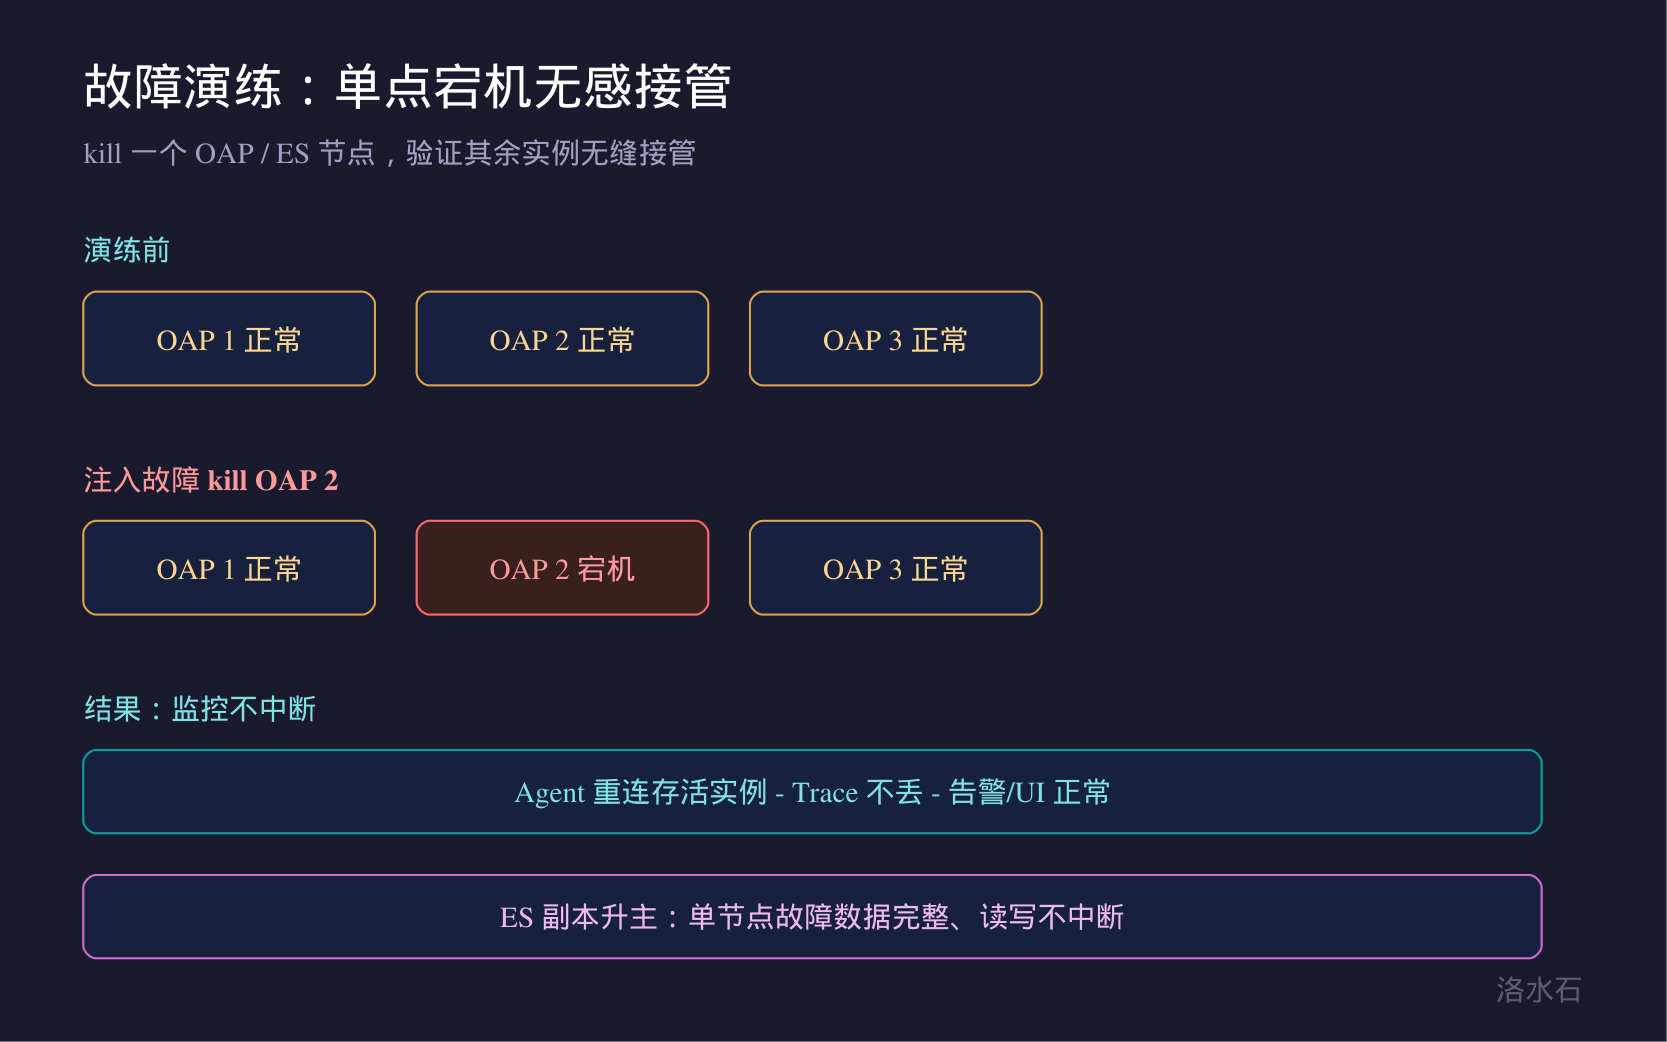
高可用不是"配完就高可用",要靠演练验证。两类必做动作:
第一,滚动发布。OAP 升级用 K8s 滚动更新(maxUnavailable=1),保证始终有实例在跑。因为 OAP 无状态,升级期间 Agent 会自动重连到存活实例,监控不中断。演练命令:
kubectl -n skywalking set image deployment/oap oap=apache/skywalking-oap-server:9.7.1
kubectl -n skywalking rollout status deployment/oap
第二,故障演练(Chaos)。主动 kill 一个 OAP Pod,确认:① 其余实例自动接管;② Agent 侧 Trace 不丢(短暂缓冲后重连上报);③ UI 和告警正常。再 kill 一个 ES 节点,确认:① 副本升主、读写无中断;② 数据完整。
推荐用混沌工程工具(如 Chaos Mesh)定期自动演练,把"我以为高可用"变成"验证过高可用"。
下表给出高可用等级对照,帮你对标:
|
等级 |
OAP |
存储 |
故障影响 |
适用 |
|
--- |
--- |
--- |
--- |
--- |
|
L0 |
单节点 |
H2 |
全盲 |
演示 |
|
L1 |
2 节点 |
单 ES |
实例故障可扛 |
测试 |
|
L2 |
3 节点 |
ES 3 节点副本1 |
单点故障无感 |
生产 |
|
L3 |
3+ 节点 |
ES 跨 AZ 副本 |
AZ 故障无感 |
核心生产 |
7. 最佳实践与踩坑
第一,OAP 版本与存储、UI 必须一致。跨小版本连 ES 常因 mapping 不兼容报错;UI 与 OAP 版本差一级就可能 GraphQL 白屏。升级走"全栈同版本"策略。
第二,协调器别引入新单点。用 Zookeeper/Consul 做集群协调时,协调器本身也要集群化,否则"为去单点引入新单点"。K8s 内部直接用 `cluster.selector=kubernetes` 最省心。
第三,Agent 缓冲要留足。OAP 滚动升级瞬间,Agent 会短暂连不上,靠 Agent 内存缓冲暂存。缓冲有上限(默认几十 MB),升级要快、实例不要同时重启,否则高峰会丢数据。可用 `agent.config` 的 `buffer` 相关参数调大。
第四,ES 磁盘水位线要监控。ES 默认磁盘超 85% 停止分配分片、超 90% 只读。OAP 写不进去时静默失败,监控又恰好依赖 ES——典型的"监控自杀"。务必告警 ES 磁盘使用率。
第五,别把 OAP 和 ES 放同一台机器。它们都吃内存(OAP 堆 + ES 堆 + OS 缓存),混部会互相抢占,反而更易整体崩。计算与存储分离部署。
第六,配置统一走环境变量。所有 `SW_*` 环境变量不要写死在镜像里,用 ConfigMap / 部署变量注入,便于多环境(测试/生产)切换,也方便灰度。
至此,第 46 阶段"大模型调用链路追踪,SkyWalking 排查线上性能"15 篇全部完成:从链路模型、Token 耗时拆解、Trace-Log 联动、OAL 告警,到存储选型、集群高可用,构成了完整的大模型可观测性落地路径。把这套体系接进你的线上大模型服务,下一次性能工单,你将不再是"盲猜的那个人"。
更多推荐
 5
 0
- 0


 已为社区贡献167条内容

所有评论(0)