
初学AI大模型应用1
继昨天简单跟着AI做了两个小型AI应用,感觉很有成就感,取之AI,用之AI,今天继续学。
3 小红书爆款文案生成器
第一步:构造关键词和模型
这个和上一个AI简历优化助手项目很像,我是在其基础上改的,更换了关键提示词promate,具体,如下:
def optimize_resume(Product):
    """
    核心函数:构建 Prompt 并调用大模型
    """
    # 1. 构建结构化 Prompt (提示词工程的核心)
    prompt_template = f"""
    # Role
    你是一位深耕小红书运营的资深博主,粉丝以22-35岁女性为主。

    # Task
    请围绕产品【产品名称+核心卖点】写一篇种草笔记。

    # Constraints
   1. 标题:给出3个备选,每个≤20字,含1个emoji,制造好奇或痛点共鸣
   2. 开头:用一个具体生活场景或"踩坑经历"切入,不要直接夸产品
   3. 正文:分3个小点讲卖点,每点配真实使用细节(数据/对比/感受)
   4. 结尾:给一句行动引导 + 3-5个相关话题标签#
   5. 全文控制在300-400字,多分段,适当加emoji但不堆砌
   避免:说明书式描述、绝对化用词、明显广告腔

    # Input Data
       ## 原始经历:
    {Product }

    # Output
    请直接输出优化后的经历段落,不要包含任何开场白或结束语。
    """
然后,整体的代码如下:
(因为没有简历助手的“目标岗位”,所以上述函数,只有Product的一个变量,所以下面的code也有一丢丢改变.)
import requests
import json

# ================= 配置区域 =================
# 请替换为你自己的 API Key (这里以通义千问为例,下面你要更换自己申请的API_KEY)
API_KEY = "your api_key"
# 通义千问的 API 地址
API_URL = "https://dashscope.aliyuncs.com/api/v1/services/aigc/text-eneration/generation"

def optimize_resume(Product):
    """
    核心函数:构建 Prompt 并调用大模型
    """
    # 1. 构建结构化 Prompt (提示词工程的核心)
    prompt_template = f"""
    # Role
    你是一位深耕小红书运营的资深博主,粉丝以22-35岁女性为主。

    # Task
    请围绕产品【产品名称+核心卖点】写一篇种草笔记。

    # Constraints
   1. 标题:给出3个备选,每个≤20字,含1个emoji,制造好奇或痛点共鸣
   2. 开头:用一个具体生活场景或"踩坑经历"切入,不要直接夸产品
   3. 正文:分3个小点讲卖点,每点配真实使用细节(数据/对比/感受)
   4. 结尾:给一句行动引导 + 3-5个相关话题标签#
   5. 全文控制在300-400字,多分段,适当加emoji但不堆砌
   避免:说明书式描述、绝对化用词、明显广告腔

    # Input Data
       ## 原始经历:
    {Product }

    # Output
    请直接输出优化后的经历段落,不要包含任何开场白或结束语。
    """

    # 2. 构造请求头和数据
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json"
    }

    payload = {
        "model": "qwen-plus",  # 使用 qwen-plus 模型,逻辑能力较强
        "input": {
            "messages": [
                {"role": "system", "content": "你是一个专业的文案生成和优化助手。"},
                {"role": "user", "content": prompt_template}
            ]
        },
        "parameters": {
            "temperature": 0.5,  # 较低的温度让回答更严谨,适合写简历
            "max_tokens": 1000
        }
    }

    # 3. 发送请求
    try:
        response = requests.post(API_URL, headers=headers, json=payload)
        response.raise_for_status()  # 检查是否有 HTTP 错误
        result = response.json()

        # 4. 解析返回结果 (不同厂商的返回结构可能略有不同,需根据文档调整)
        if 'output' in result and 'text' in result['output']:
            return result['output']['text']
        else:
            return f"API 返回格式异常: {result}"

    except Exception as e:
        return f"发生错误: {str(e)}"


if __name__ == "__main__":
    print("--- 🚀 AI 文案生成和优化助手启动 ---")

    # 2. 获取用户输入
    Product = input("👉 请粘贴你的原始描述:\n")
    # target_jd = input("👉 请粘贴目标岗位的 JD:\n")

    print("\n⏳ AI 正在思考并优化中...")

    # 3. 调用函数 (这里就是你报错的地方,需要把参数传进去)
    # optimized_text = optimize_resume(original_exp, target_jd)
    optimized_text = optimize_resume(Product)

    # 4. 打印结果
    print("\n--- ✨ 优化结果如下 ---")
    print(optimized_text)
第二步:检验成果
很完美,我都没想到这么成功。和平常刷小红书种草日记很类似
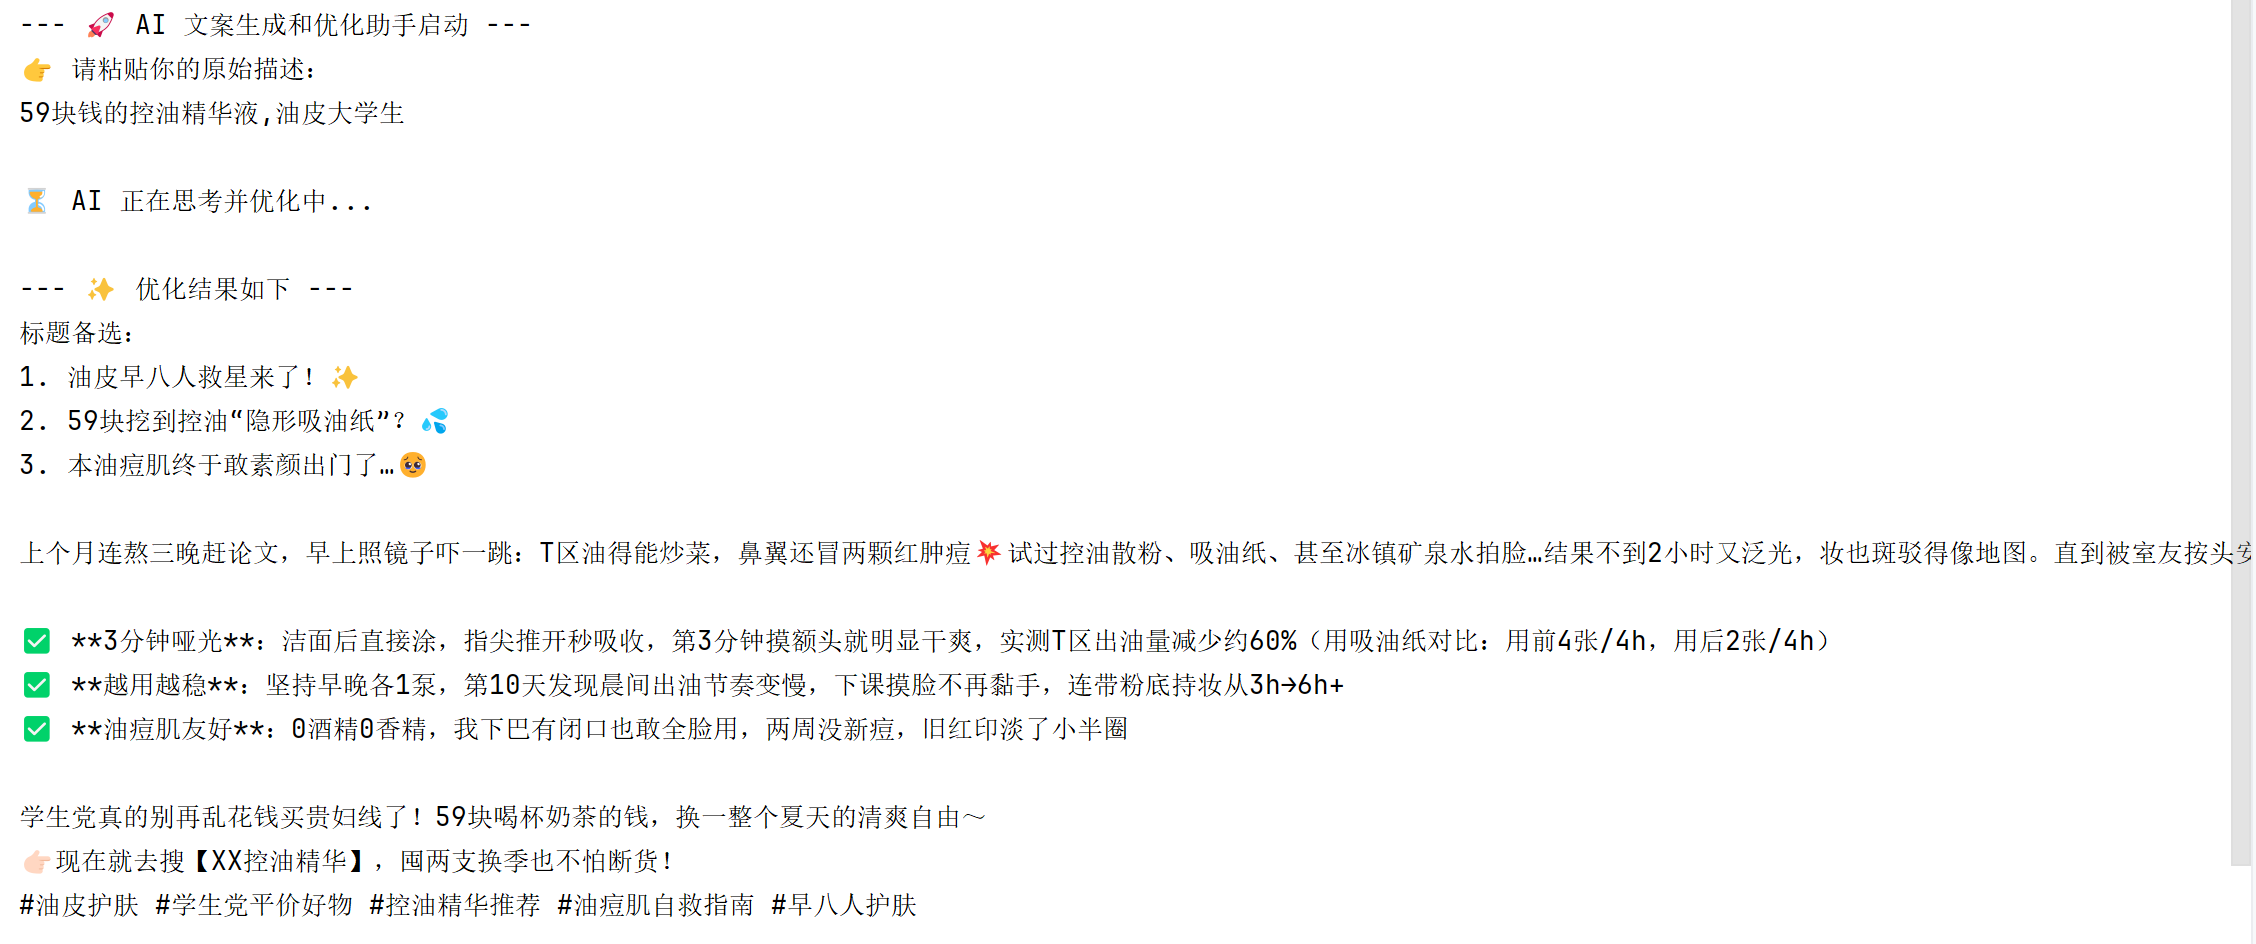
当然,这只是种草日记类型的文案生成,由于时间原因就没再拓展,非常欢迎各位在评论区发出您的成果。
构造智能体时细节方面:
在构造智能体时,"input":{"massage":["role":"system"/"user"/"assisent","content": ]}
messages 列表不仅仅是传一句话那么简单,它是智能体“记忆”和“人设”的载体。
下面详细拆解 messages 中各个字段的作用,以及在实际开发中如何灵活构造它:
messages 列表的核心作用:
messages 是一个列表(List),里面包含了一个或多个字典(Dictionary)。它的核心作用是告诉模型:谁说了什么,以及之前的对话历史是什么。
模型本身是没有记忆的,它每次回答都是基于你传给它的这个 messages 列表来生成的。
关键字段详解
role (角色)
这是最重要的字段,决定了这句话的“身份”。通常有以下三种标准值:
system (系统提示词/人设)
作用: 这是给模型的“最高指令”。它定义了智能体的性格、任务目标、限制条件。它通常放在列表的最前面。
例子: {"role": "system", "content": "你是一个专业的心理咨询师,语气要温柔,多倾听用户的烦恼。"}
场景: 设定日记助手的风格(比如“你是一个文采斐然的作家”)。
user (用户)
作用: 代表人类发出的指令或问题。
例子: {"role": "user", "content": "帮我写一篇日记"}
场景: 你的输入。
assistant (助手/模型)
作用: 代表模型之前的回答。
例子: {"role": "assistant", "content": "好的,请问您今天发生了什么特别的事情吗?"}
场景: 实现多轮对话的关键! 如果你想让模型记得上一句说了什么,必须把上一轮模型的回答也塞回这个列表里。
content (内容)
作用: 具体的文本信息。
注意: 在某些高级用法中(如通义千问VL或GPT-4o),这里不仅可以是字符串,还可以是一个列表,用来传入图片URL或音频数据(多模态)。
因此,在昨天的日记生成器中也修改了一部分massage,增加了一个system,也很成功。完整代码如下:
import requests#只需使用requests库发送一个HTTP POST请求即可
import json

# 替换为你自己的API Key
API_KEY = " "

# 以通义千问为例(DeepSeek接口类似,只需改URL和参数)
url = "https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation"
headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}
original_text = input("👉 请写下你的原始描述:\n")
payload = {
    "model": "qwen-plus",  # 模型名称
    "input": { "messages": [  {"role": "system", "content": "你是一个名为'小文'的散文助手。      你的文风偏向治愈系,喜欢使用emoji。请根据用户提供的描述和心情生成散文"},
                            {"role": "user", "content": original_text }        ]
    },
    "parameters": {
        "temperature": 0.7,  # 控制创造性,0.7比较适中
        "max_tokens": 300    # 限制输出长度
    }
}
# 发送请求并获取结果
response = requests.post(url, headers=headers, data=json.dumps(payload))
result = response.json()

# 打印AI生成的日记
print("\n--- ✨ 加载中请稍等 ---")
print(result["output"]["text"])
更多推荐

 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)