
Java 程序员第 46 阶段16:大模型调用链路追踪,SkyWalking 排查线上性能,与 Prometheus Grafana 联动指标链路双维度观测
- 为什么需要指标与链路双维度观测
- SkyWalking 指标体系与 Prometheus 对接原理
- 部署 Prometheus 抓取 SkyWalking 指标
- 在 Grafana 中构建大模型调用观测大盘
- 指标异常到链路下钻的实战
- 最佳实践与踩坑点
1. 为什么需要指标与链路双维度观测
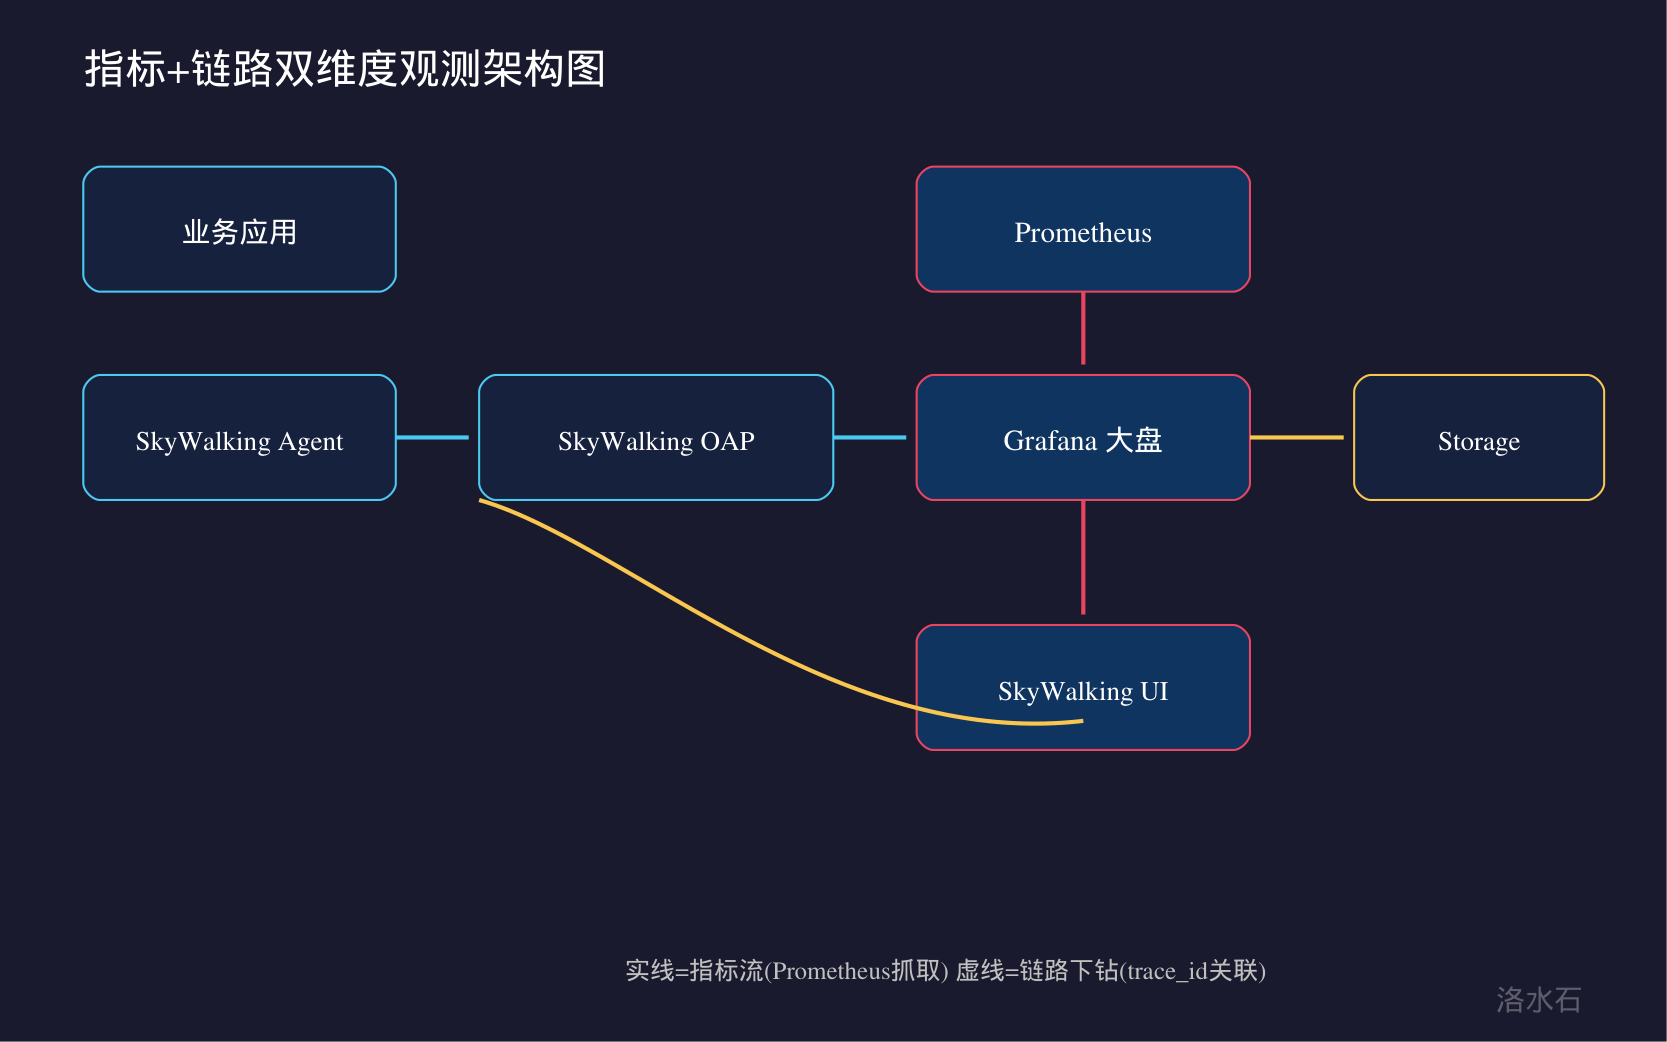
在排查大模型(LLM)线上性能问题时,很多团队会陷入一个误区:要么只看链路追踪(Trace),要么只看指标(Metrics),二者割裂。链路追踪擅长回答"这一次请求慢在哪里",指标擅长回答"最近一小时整体是不是变慢了、慢到什么程度、影响面多大"。当大模型服务出现偶发性超时、Token 消耗异常、并发抖动时,单靠其中一个维度往往既看不到全局趋势,也定位不到具体根因。
举个真实场景:某客服系统接入大模型做意图识别,运营反馈"下午三点左右回答明显变慢"。如果只有 SkyWalking 链路,你需要从历史链路里一条条翻找那个时间窗口的慢 Trace,效率低且容易被采样丢弃;如果只有 Grafana 指标,你能看到 P99 延迟在 15:00 出现尖刺,但不知道是模型推理慢、还是网关排队、还是向量检索拖后腿。只有把二者打通——先在指标大盘上锁定异常时间窗与接口,再一键下钻到该窗口的慢链路——才能形成"宏观趋势 + 微观根因"的闭环。
本篇我们将以 SkyWalking 8.x/9.x 为基座,演示如何把它的指标暴露给 Prometheus,再用 Grafana 统一展示,并通过 `trace_id` 关联实现指标到链路的下钻。
# 双维度观测的核心分工
observability:
metrics: # 宏观趋势、告警、SLO
source: skywalking -> prometheus -> grafana
questions: ["整体 P99 多少?", "哪个接口最慢?", "何时开始劣化?"]
tracing: # 微观根因、单次请求慢点
source: skywalking oap -> storage -> ui
questions: ["这一次请求卡在哪?", "SQL/LLM 调用耗时多少?", "异常堆栈是什么?"]
correlation:
bridge: trace_id # 指标异常 -> 下钻具体链路
2. SkyWalking 指标体系与 Prometheus 对接原理
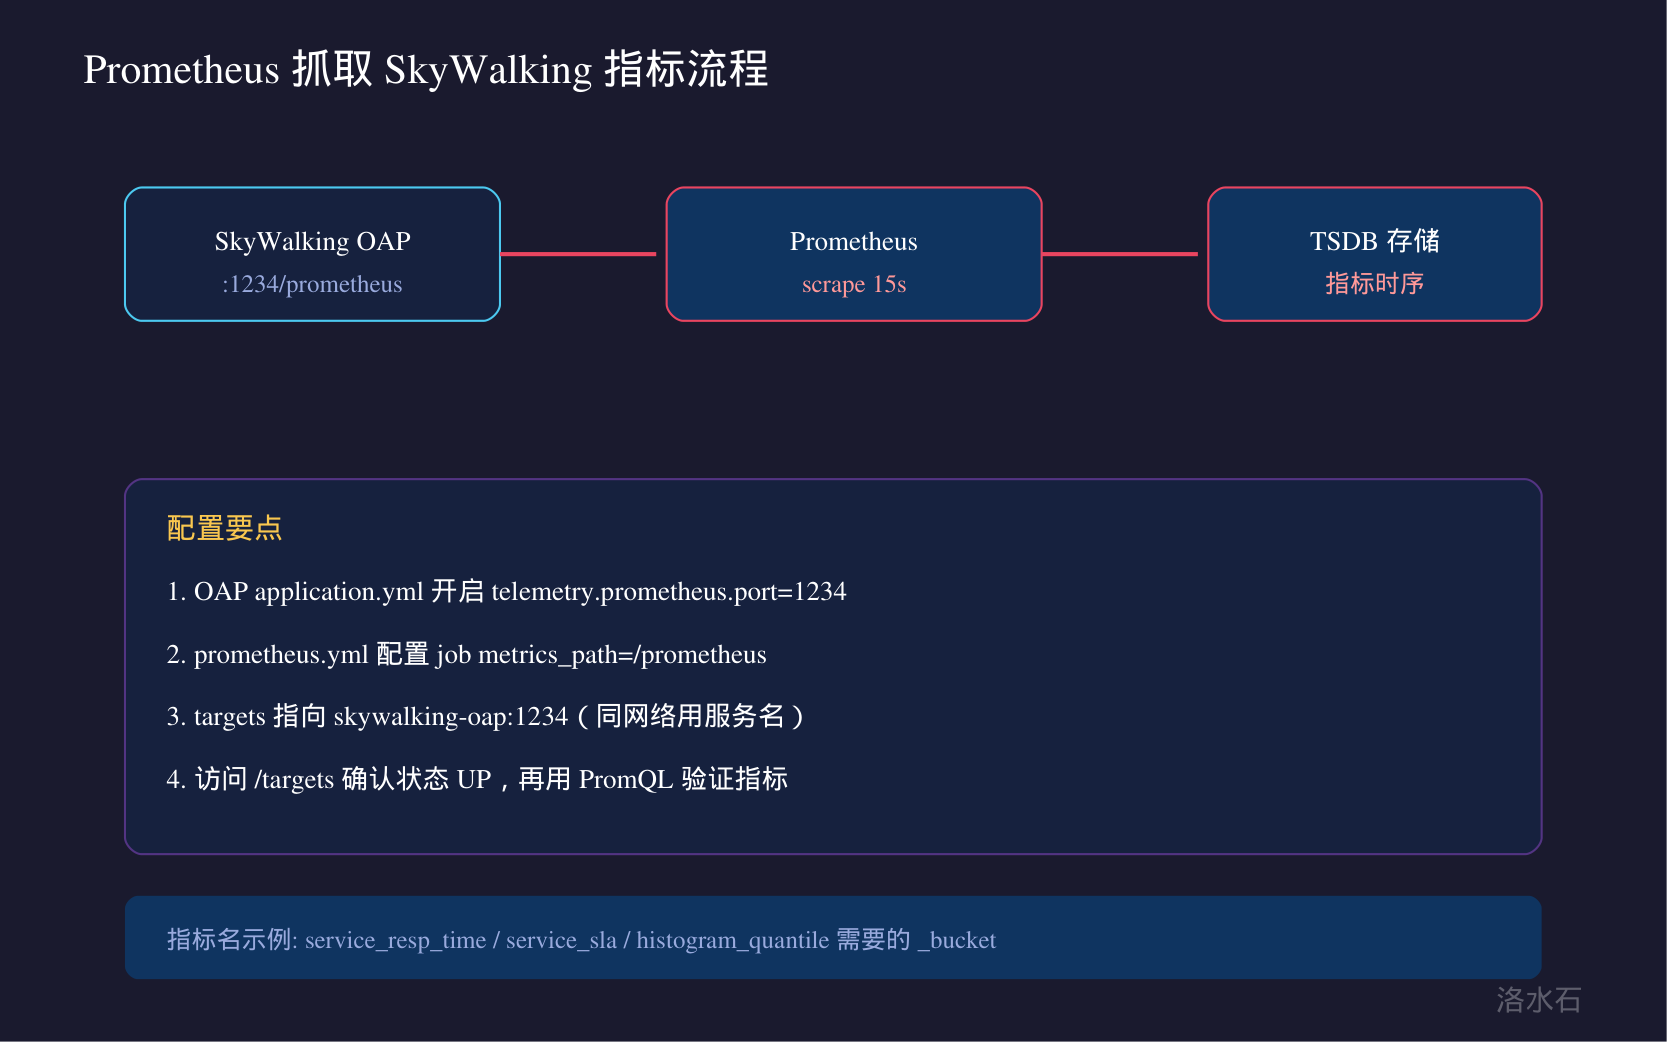
SkyWalking OAP(Observability Analysis Platform)在收集到 Trace、JVM、服务网格等数据后,会在内存中按指标(Metric)聚合,并通过 `Telemetry` 模块暴露给外部抓取。SkyWalking 原生支持的暴露方式有两种:
- **Prometheus 暴露(推荐)**:在 `application.yml` 中开启 `prometheus` 提供者,OAP 会在 `/prometheus` 端点输出符合 Prometheus 文本格式的指标。
- **OpenTelemetry 暴露**:通过 OTel 协议对外推送,再由 OTel Collector 转给 Prometheus。
大模型调用场景里,我们最关心的指标分为四类:
- **服务吞吐与延迟**:`service_sla`、`service_resp_time`、`service_apdex`
- **大模型调用专属埋点**:如果你在调用 LLM 的 SDK 外层用 `@Trace` 或 OpenTelemetry 手动埋点,会生成 `llm_invoke_duration`、`llm_token_cost` 等自定义指标
- **JVM 与线程池**:`jvm_thread`, `jvm_memory_pool`
- **数据库与缓存**:`database_access_latency`, `cache_access_latency`(向量库检索常落在这里)
# config/application.yml(OAP 侧关键片段)
telemetry:
prometheus:
host: 0.0.0.0
port: 1234
sslEnabled: false
# 暴露指标的作用域,ALL 包含服务/实例/端点/数据库等
scope: ALL
注意:SkyWalking 的 Prometheus 指标名会带有 `_sum`、`_count`、直方图桶(histogram bucket)等后缀。例如端点延迟会暴露为 `skywalking_endpoint_latency_percentile` 这类经过转换的指标(取决于版本),新版本通过 `prometheus-fetcher` 与 `PromQL` 风格名称呈现。实战中建议直接用官方提供的 `skywalking-backend` Grafana dashboard,避免自己猜指标名。
3. 部署 Prometheus 抓取 SkyWalking 指标
下面给出一个最小可用的 `prometheus.yml`。关键点:把 job 指向 OAP 的 `:1234` 端口的 `/prometheus` 路径,抓取间隔设为 15s 即可(链路类指标太密意义不大,反而增加存储压力)。
global:
scrape_interval: 15s
evaluation_interval: 15s
scrape_configs:
- job_name: 'skywalking'
metrics_path: /prometheus
static_configs:
- targets: ['skywalking-oap:1234']
labels:
cluster: 'prod-llm'
- job_name: 'skywalking-self'
metrics_path: /metrics
static_configs:
- targets: ['skywalking-oap:1234']
labels:
cluster: 'prod-llm'
启动 Prometheus(Docker 方式):
docker run -d \
--name prometheus \
-p 9090:9090 \
-v $(pwd)/prometheus.yml:/etc/prometheus/prometheus.yml \
prom/prometheus:latest
启动后访问 `http://localhost:9090/targets`,确认 `skywalking` job 状态为 `UP`。若为 `DOWN`,先排查 OAP 的 `telemetry.prometheus.port` 是否真的在监听,以及容器网络是否互通(Docker 网络中用服务名 `skywalking-oap` 解析,宿主机直连要用 `host.docker.internal` 或 IP)。
大模型调用延迟的常用 PromQL:
# 端点级 P99 延迟(秒)
histogram_quantile(0.99,
sum(rate(skywalking_endpoint_latency_bucket[5m])) by (le, endpoint))
# 大模型调用成功率(SLA)
avg(service_sla{service=~"llm-gateway.*"}) by (service)
# Token 消耗速率(自定义埋点)
sum(rate(llm_token_cost_total[5m])) by (model)
4. 在 Grafana 中构建大模型调用观测大盘
Grafana 通过 `Prometheus` 数据源连接上面部署的 Prometheus,再导入或自建 Dashboard。针对大模型调用,建议大盘至少包含以下面板:
|
面板名称 |
指标/PromQL |
作用 |
|
--- |
--- |
--- |
|
接口 QPS 趋势 |
`sum(rate(service_cpm[5m])) by (service)` |
看流量是否突增 |
|
端点 P99 延迟 |
`histogram_quantile(0.99, ...)` |
锁定最慢接口 |
|
LLM 调用耗时分布 |
自定义 `llm_invoke_duration` 直方图 |
区分模型推理 vs 业务处理 |
|
Token 消耗速率 |
`rate(llm_token_cost_total[5m])` |
发现异常 Prompt 放大 |
|
并发线程数 |
`jvm_thread{state="RUNNABLE"}` |
判断是否线程耗尽 |
|
错误率 |
`100 - service_sla` |
触发告警 |
自定义大模型埋点示例(Java + Micrometer + SkyWalking OpenTelemetry 桥接):
// 使用 Micrometer 记录 LLM 调用耗时与 Token 消耗
import io.micrometer.core.instrument.Metrics;
import io.micrometer.core.instrument.Timer;
public class LlmCallMetrics {
private static final Timer LLM_TIMER = Metrics.timer(
"llm_invoke_duration", "model", "gpt-4o");
public String call(String prompt) {
long start = System.nanoTime();
try {
// 实际调用大模型 SDK
return doInvoke(prompt);
} finally {
long costMs = (System.nanoTime() - start) / 1_000_000;
LLM_TIMER.record(java.time.Duration.ofMillis(costMs));
// Token 计数(假设从响应解析)
Metrics.counter("llm_token_cost_total", "model", "gpt-4o")
.increment(estimateTokens(prompt));
}
}
private native String doInvoke(String prompt);
private native long estimateTokens(String text);
}
Grafana 中把指标面板与 SkyWalking 链路入口关联,是下钻的关键。SkyWalking 从 8.9 起支持 `Trace` 查询时通过 `service`、`endpoint`、`duration` 过滤,Grafana 的 panel 可配置 `Data Link` 跳转到 SkyWalking UI 的 trace 查询页。
5. 指标异常到链路下钻的实战
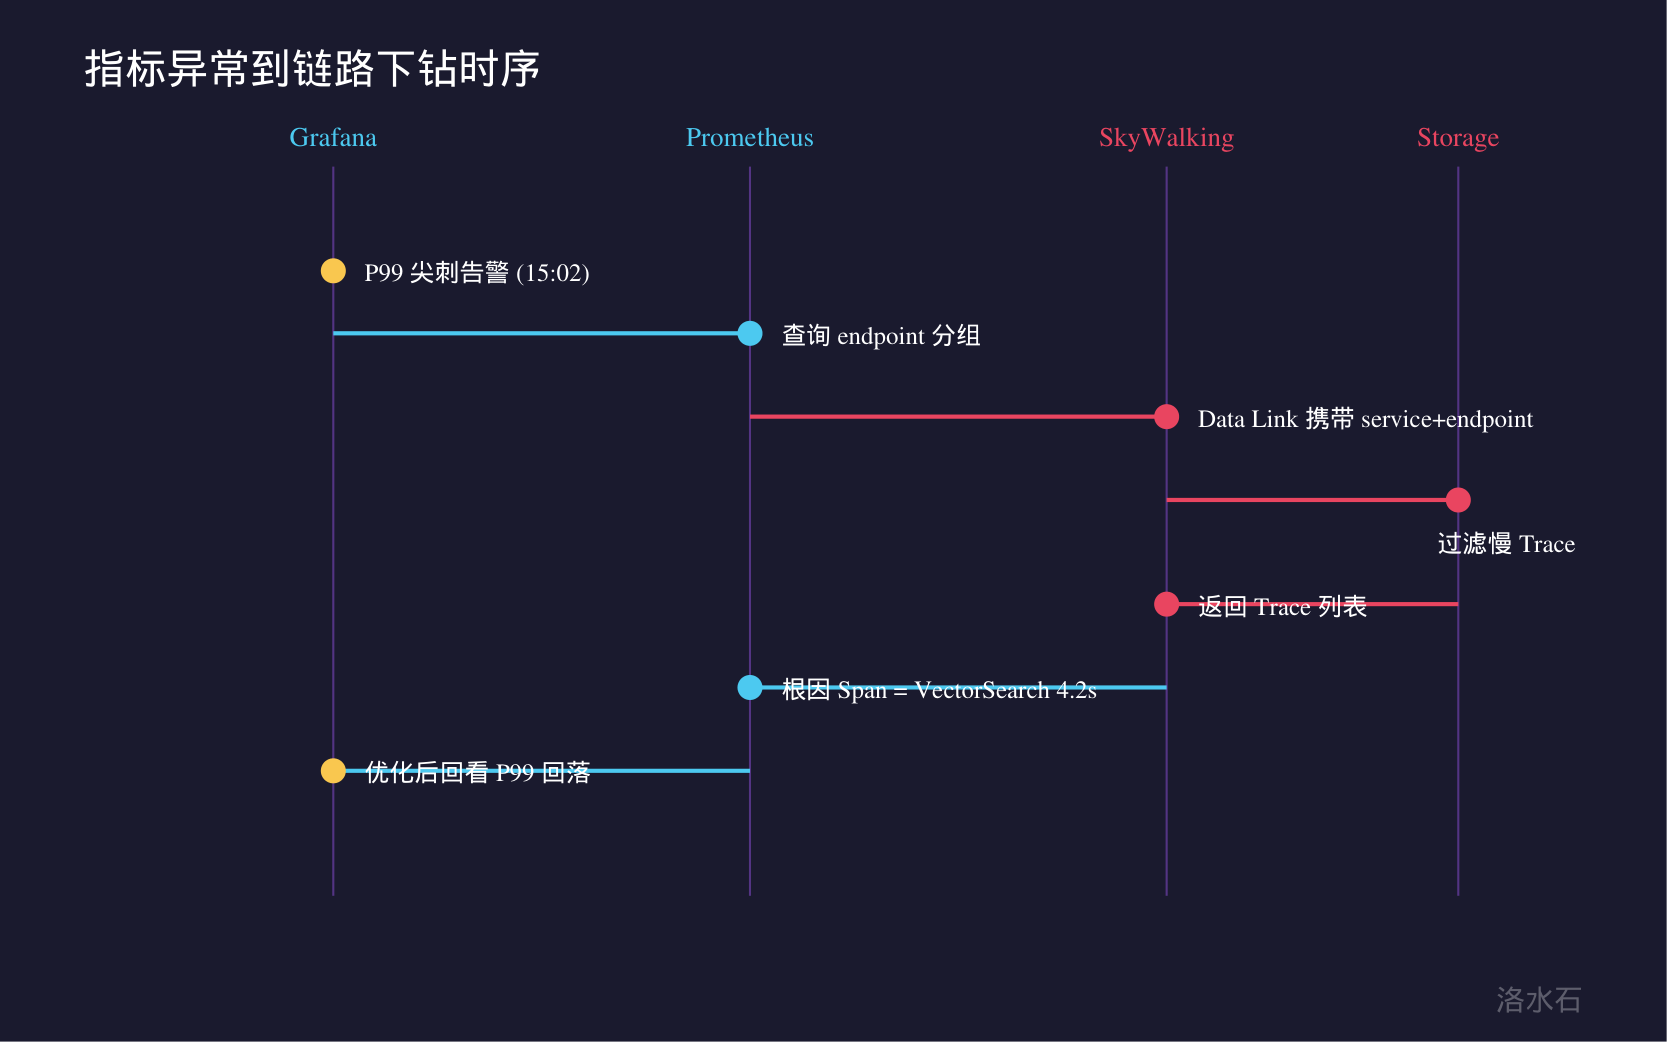
假设 Grafana 大盘在 15:02 发现 `llm-gateway` 服务的 P99 从 800ms 飙升到 6s。排查流程如下:
- **锁定范围**:在 Grafana 用 `by (endpoint)` 分组,确认是 `/v1/chat/completions` 端点变慢,而不是所有接口。
- **缩小时间窗**:把时间窗缩到 15:00~15:10,观察延迟曲线是否和某次发布、流量峰值、或上游限流重合。
- **下钻链路**:点击面板上的 `Data Link`(或手动打开 SkyWalking UI),按 `service=llm-gateway`、`endpoint=/v1/chat/completions`、`minDuration=3000` 查询,拉出这段时间的慢 Trace。
- **定位慢点**:在一条 6s 的 Trace 中,看到 `VectorSearch` 子 Span 占了 4.2s,`LLM.Infer` 占 1.5s,说明根因是向量检索(RAG 召回)而非模型推理。
- **验证修复**:优化向量库索引后,回到 Grafana 看 P99 是否回落,再抽样新 Trace 确认 `VectorSearch` Span 下降到 200ms 以内。
Grafana 指标异常 ──(Data Link / trace_id)──> SkyWalking Trace 列表
│ │
│ 锁定 endpoint + 时间窗 │ 按 minDuration 过滤
▼ ▼
P99 曲线尖刺 慢 Trace 详情
│
▼
Span 瀑布图 -> 根因 Span
这个"指标发现、链路定位"的闭环,是把平均故障定位时间(MTTD)从小时级压到分钟级的核心手段。
6. 最佳实践与踩坑点
**最佳实践**
- 指标与链路统一标签:在 SkyWalking 和 Prometheus 中使用一致的 `service`、`model`、`endpoint` 标签,下钻时才不会"对不上号"。
- 采样策略要合理:链路全量存储成本高,建议错误链路 100% 保存、正常链路按 1%~10% 采样,但指标始终全量,保证宏观趋势不失真。
- 用 Recording Rule 预计算:P99 直方图的 PromQL 很重,在 Prometheus 里配 `recording rule` 预聚合,Grafana 直接查预计算结果,避免大盘卡顿。
- 告警分层:指标层做 SLO 告警(P99 > 2s 持续 5 分钟),链路层做错误样例留存,二者配合减少误报。
**踩坑点**
|
坑 |
现象 |
解决 |
|
--- |
--- |
--- |
|
OAP `/prometheus` 没数据 |
targets UP 但指标为空 |
检查 `telemetry.prometheus.scope` 是否开启,OAP 日志有无暴露报错 |
|
指标名带 `_bucket` 不会算分位 |
P99 算出来是 NaN |
必须用 `histogram_quantile` 且 `le` 标签存在 |
|
Grafana 下钻跳错服务 |
点到 SkyWalking 显示空 |
Data Link 的 `var-service` 变量要和 SkyWalking 服务名完全一致 |
|
容器网络不通 |
targets DOWN |
用 `host.docker.internal` 或在同一 Docker 网络用服务名 |
|
大模型 Token 指标爆量 |
Prometheus 存储撑爆 |
Token 只记 `counter` 速率,不上 `gauge` 明细 |
**小结**:指标给你"何时、何地、多严重",链路给你"为什么"。把 SkyWalking 指标喂给 Prometheus,在 Grafana 统一观测,并用 `trace_id`/过滤条件打通下钻,是大模型服务可观测性的标准姿势。下一篇我们将继续打通第三条主线——日志,实现 Trace 与 Log 的双向关联。
更多推荐
 4
 0
- 0


 已为社区贡献167条内容

所有评论(0)