
Python数据科学实验平台(Streamlit版)- 从基础到深度学习
·
1.概述
大家好,今天给大家分享一个一站式Python数据科学实验平台,基于Streamlit开发,涵盖从Python基础、Numpy、Pandas,到Matplotlib可视化、数据预处理、机器学习、集成学习,再到深度学习的全流程实验案例。无需复杂配置,一键运行,非常适合初学者入门练习和进阶者复习巩固。
平台特点:
- 可视化界面:Streamlit侧边栏选择章节和实验,操作简单直观,无需手动输入命令
- 全流程覆盖:8大章节,60+个实验案例,从基础语法到深度学习无缝衔接,适配不同学习阶段
- 一键运行:点击按钮即可执行对应实验代码,实时查看运行结果、数据输出和可视化图表
- 容错处理:针对文件缺失、数据异常等常见问题做了友好提示,避免运行报错中断,降低使用门槛
- 可扩展性强:支持自行添加实验案例、修改代码逻辑,适配个性化学习和教学需求
2.平台核心功能与使用说明
2.1整体结构(8大核心章节)
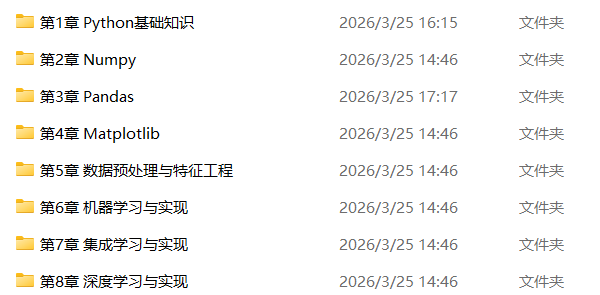
平台按数据科学学习顺序划分章节,每个章节包含多个针对性实验,覆盖核心知识点,具体如下:
- 第一章:Python基础知识:涵盖基本数据类型、索引切片、列表/元组/字符串/字典操作、条件判断、循环结构、函数定义与调用,夯实编程基础
- 第二章:Numpy数值计算:数组创建、维度操作、算术运算、索引切片、数组拼接、保存加载、排序极值、矩阵操作,掌握数值计算核心工具
- 第三章:Pandas基础实战:Series与DataFrame操作、去重判空、统计分析、Excel数据读取与可视化,实现数据清洗与初步分析
- 第四章:Matplotlib数据可视化:函数曲线、折线图、散点图、柱状图、饼图、子图组合,掌握数据可视化技巧,直观呈现数据特征
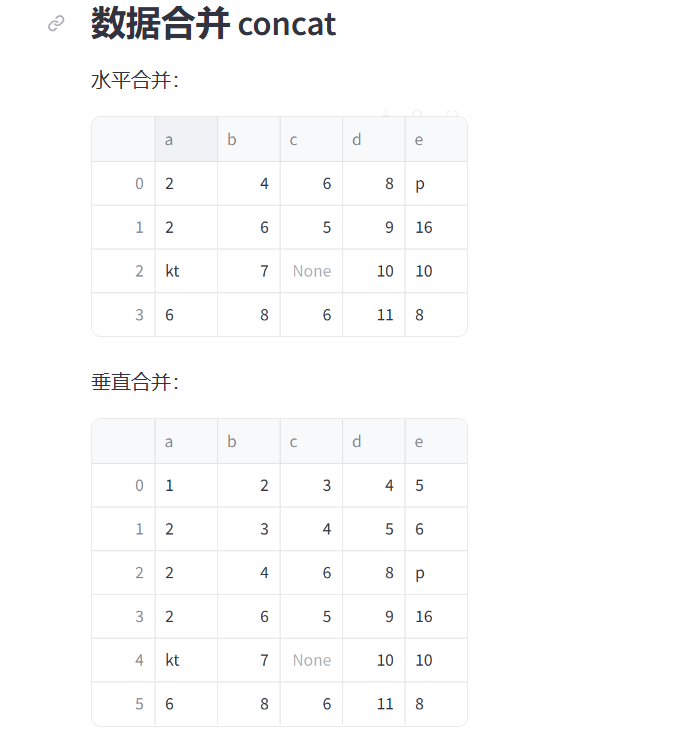
- 第五章:数据预处理与特征工程:重复值处理、数据合并、时间类型转换、数据分箱、缺失值填充、标准化归一化、PCA降维、特征选择,为建模做准备
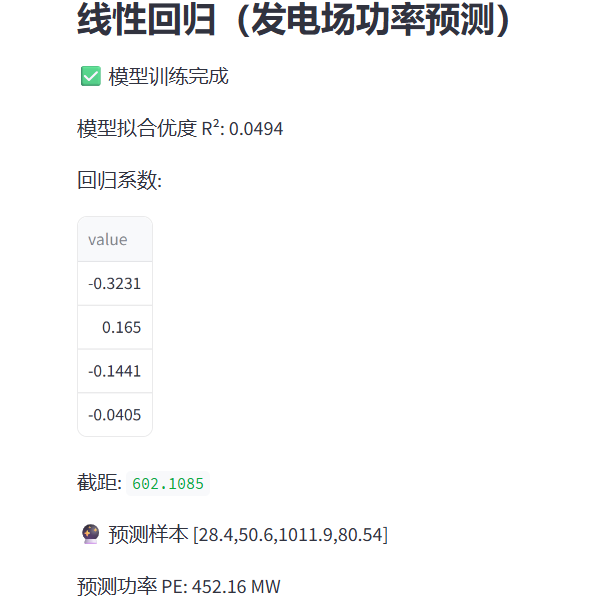
- 第六章:机器学习与实现:线性回归、逻辑回归、神经网络、SVM、K-Means聚类、关联规则挖掘,入门机器学习核心算法
- 第七章:集成学习与实现:Bagging、随机森林、AdaBoost、GBDT、XGBoost,掌握进阶集成算法,提升模型性能
- 第八章:深度学习与实现:TensorFlow基础、MLP神经网络、CNN图像分类、LSTM文本情感分析,入门深度学习应用
2.2平台核心介绍
- 可视化界面:Streamlit侧边栏选择章节和实验,操作简单直观,无需手动输入命令
- 全流程覆盖:8大章节,60+个实验案例,从基础语法到深度学习无缝衔接,适配不同学习阶段
- 一键运行:点击按钮即可执行对应实验代码,实时查看运行结果、数据输出和可视化图表
- 容错处理:针对文件缺失、数据异常等常见问题做了友好提示,避免运行报错中断,降低使用门槛
- 可扩展性强:支持自行添加实验案例、修改代码逻辑,适配个性化学习和教学需求
2.3步骤
2.3.1代码
- 导入依赖库:引入Streamlit、Pandas、Matplotlib等所需工具库,统一配置中文显示、图表样式等基础设置,避免后续运行报错。
-
初始化界面:通过Streamlit搭建可视化框架,设置侧边栏(用于章节、实验选择)、主界面(用于显示实验结果、图表),定义整体布局。
-
实验模块封装:将8大章节的60+实验案例,分别封装为独立函数,每个函数对应一个实验,包含核心代码逻辑和结果输出。
-
交互逻辑实现:绑定侧边栏选择事件与实验函数,添加「运行代码」按钮,实现“选择实验→点击运行→实时显示结果”的交互流程。
-
容错与优化:添加异常捕获、数据源容错(缺失时自动生成模拟数据)、结果格式化显示等逻辑,提升平台使用体验。
2.3.2平台
- 环境准备:安装上述依赖包后,将平台代码保存为app.py
- 启动平台:终端执行命令 streamlit run app.py,自动打开浏览器进入平台界面
- 执行实验:侧边栏选择对应章节和实验,点击「运行代码」按钮,即可查看实时运行结果
3.数据准备
4.关键细节说明
- 中文适配:已配置Matplotlib中文字体,避免图表中文乱码问题,无需额外设置
- 数据容错:针对Excel、CSV等数据源缺失情况,添加了模拟数据生成逻辑,确保实验正常运行
- 可视化优化:采用分栏布局、子图组合等方式,让实验结果更清晰,提升阅读体验
- 代码适配:兼容Python 3.8+版本,所有实验代码经过验证,可直接运行,无需修改
5.可视化页面展示
- 主页面
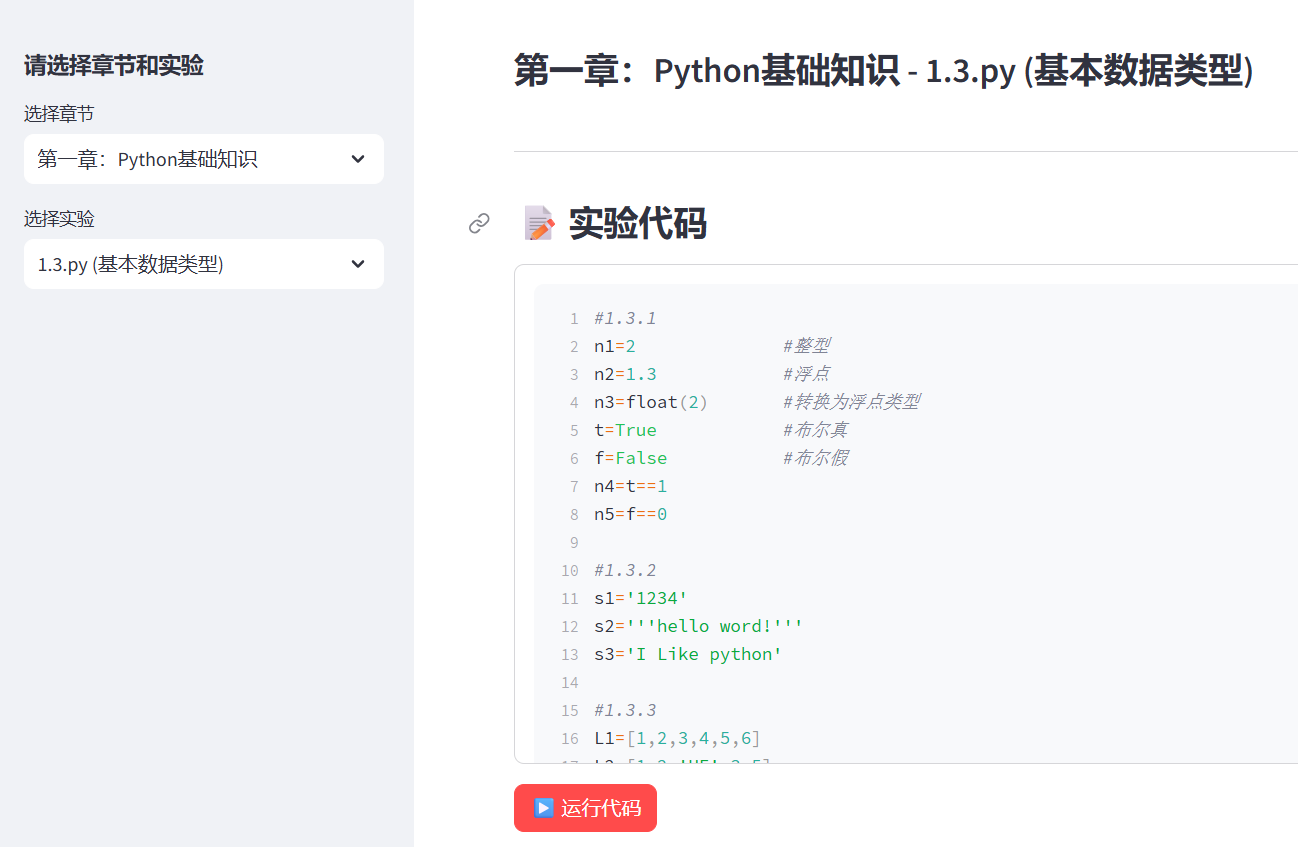
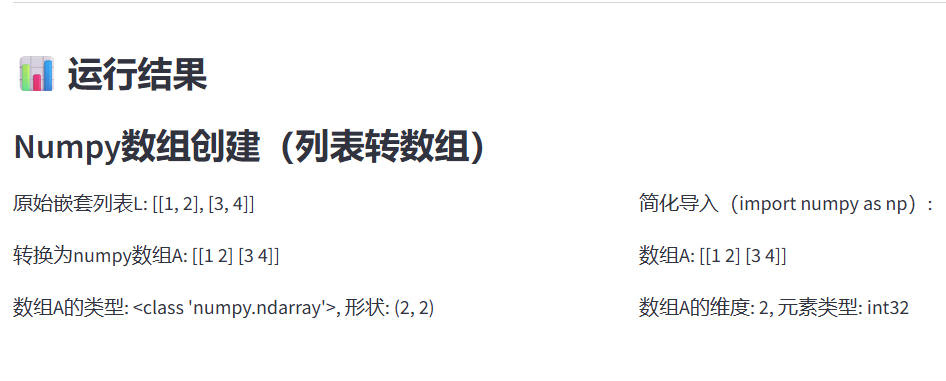
- 第二章Numpy数值计算2.1数组创建
- 第三章pandas基础实战3.4读取数据与分析
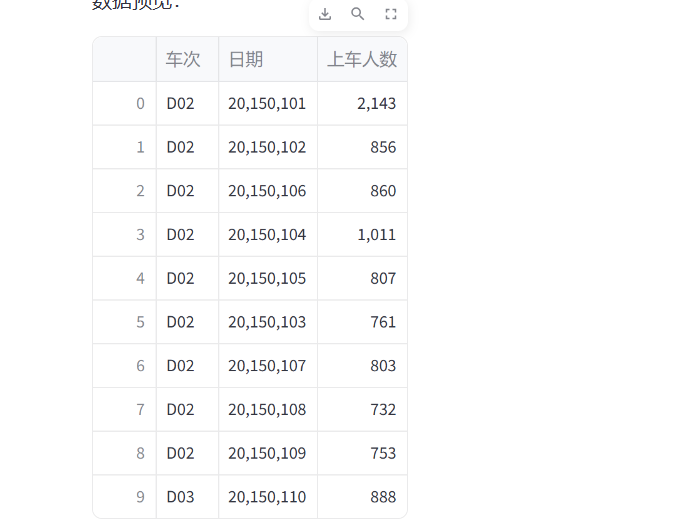
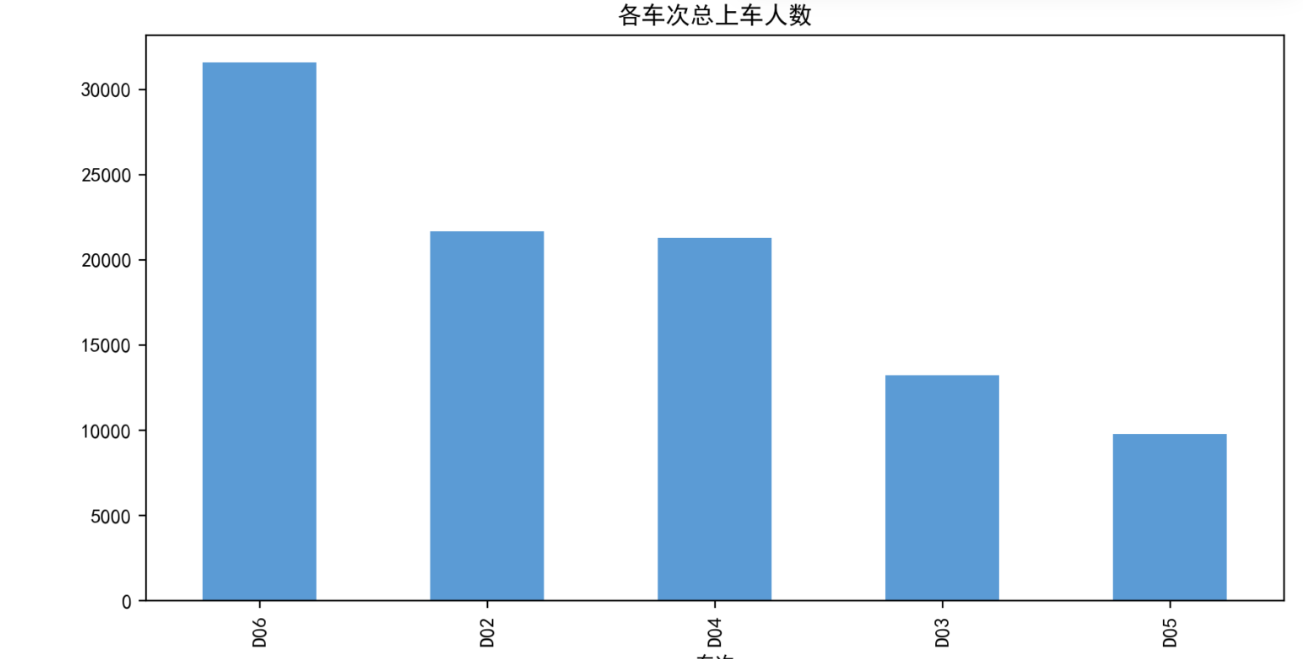
表和图的结合更能直观分析数据
- Matplotlib数据可视化4.2.7六图合一
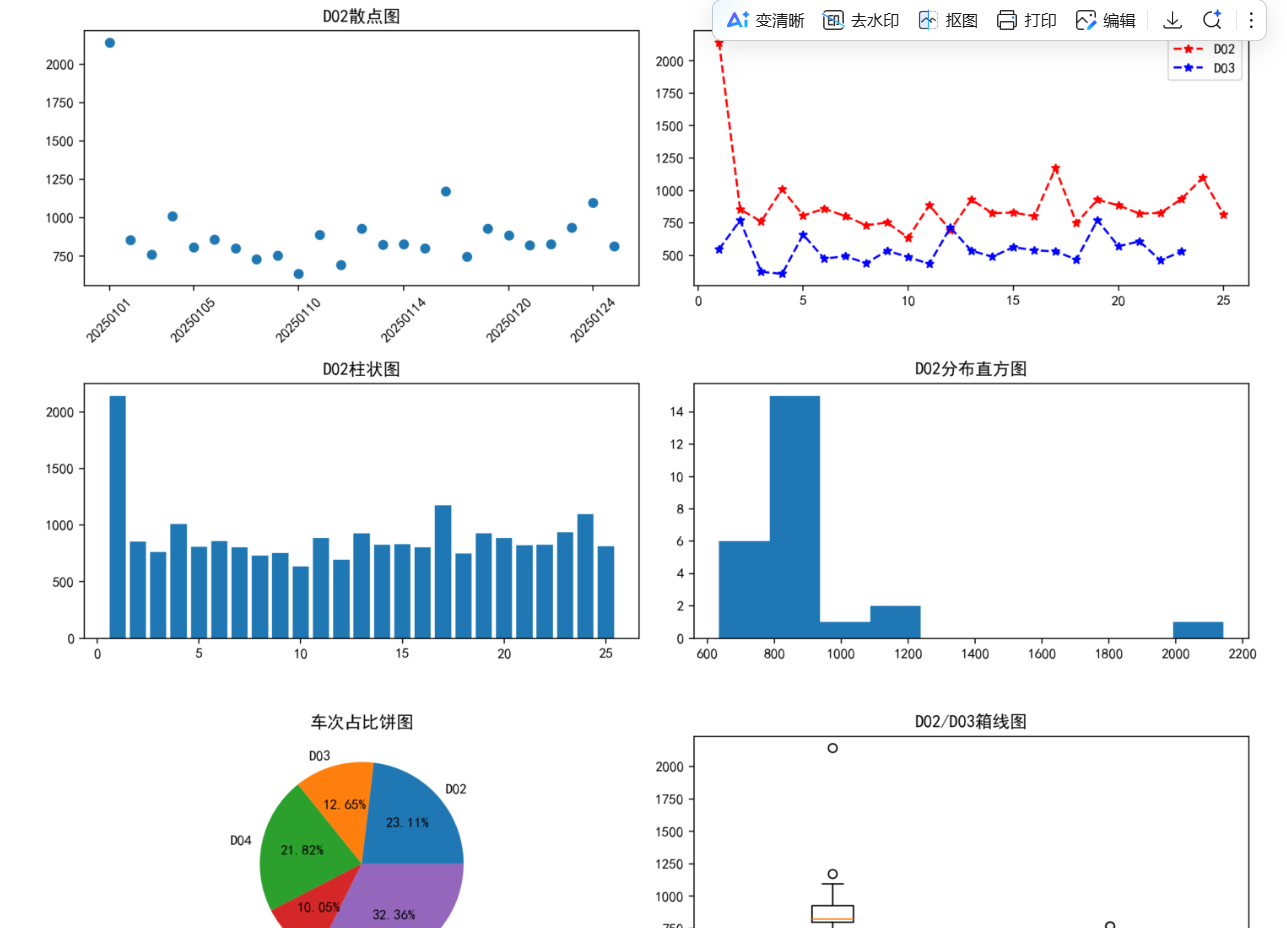
- 第五章数据预处理与特征工程5.2.1数据合并
- 第六章机器学习与实现6.1线形回归
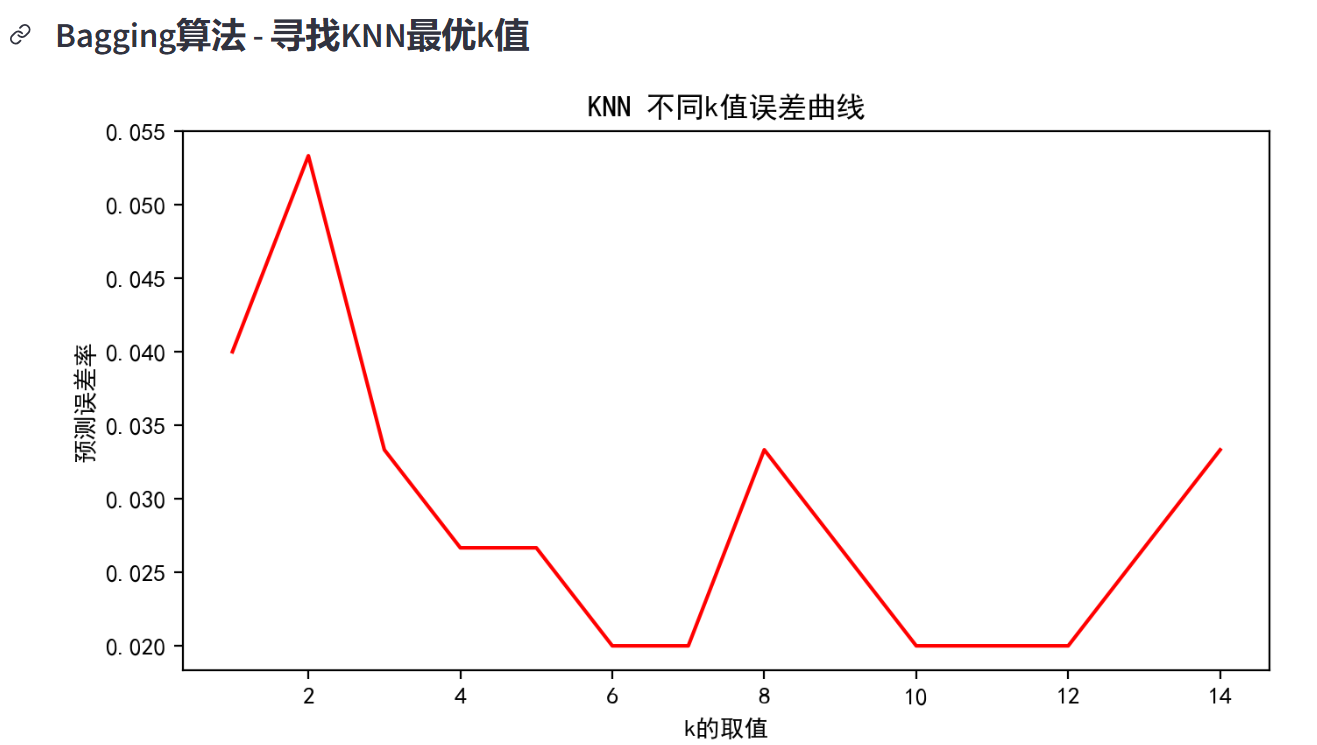
- 第七章集成学习与实现7.2.3.1.Bagging算法 - 寻找KNN最优k值
6.平台优势与适用人群
6.1核心优势
- 无需配置IDE:Streamlit可视化界面,无需手动调试环境,新手也能快速上手
- 实验针对性强:每个实验聚焦一个知识点,从基础操作到实战应用,层层递进
- 实时反馈:点击运行即可查看结果,便于快速调试代码、理解知识点
- 全流程覆盖:从编程基础到深度学习,一站式搞定数据科学核心技能,无需切换多个项目
6.2适用人群
- Python初学者:夯实编程基础,熟悉数据科学常用库的基本操作
- 数据科学入门者:系统学习数据预处理、可视化、机器学习、深度学习流程
- 学生/教师:作为实验教学工具,快速开展课堂实验,提升教学效率
- 进阶学习者:复习巩固核心知识点,快速验证代码逻辑,提升实战能力
7.总结
本次分享的Streamlit版Python数据科学实验平台,先通过简洁的代码步骤解读让大家了解平台底层逻辑,再详细介绍平台功能和使用方法。平台整合了数据科学学习全流程的实验案例,操作简单、覆盖全面,能够帮助大家快速上手Python数据科学相关技能。
更多推荐

 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)