
破壁与重构:hls4ml 如何跨越软硬件鸿沟,开启FPGA深度学习新时代
·
破壁与重构:hls4ml 如何跨越软硬件鸿沟,开启FPGA深度学习新时代
hls4ml 是一个开源的软件平台,旨在将复杂的深度学习模型自动化转化为可部署在 FPGA 或 ASIC 硬件上的高效代码。该工具通过其模块化架构支持 PyTorch 和 TensorFlow 等主流框架,并兼容 AMD、Intel 及 Siemens 等多家厂商的硬件编译器。它特别针对科学研究和工业应用中对超低延迟、低功耗及有限资源的需求进行了深度优化。平台集成了量化感知训练 (QAT) 和权重剪枝等协同设计技术,显著降低了硬件占用并提升了推理速度。目前,该工具已广泛应用于高能物理、自动驾驶、量子计算及卫星监测等前沿领域。作为一种硬件-软件协同设计的桥梁,hls4ml 极大地简化了研究人员在定制化芯片上实现复杂人工智能算法的难度。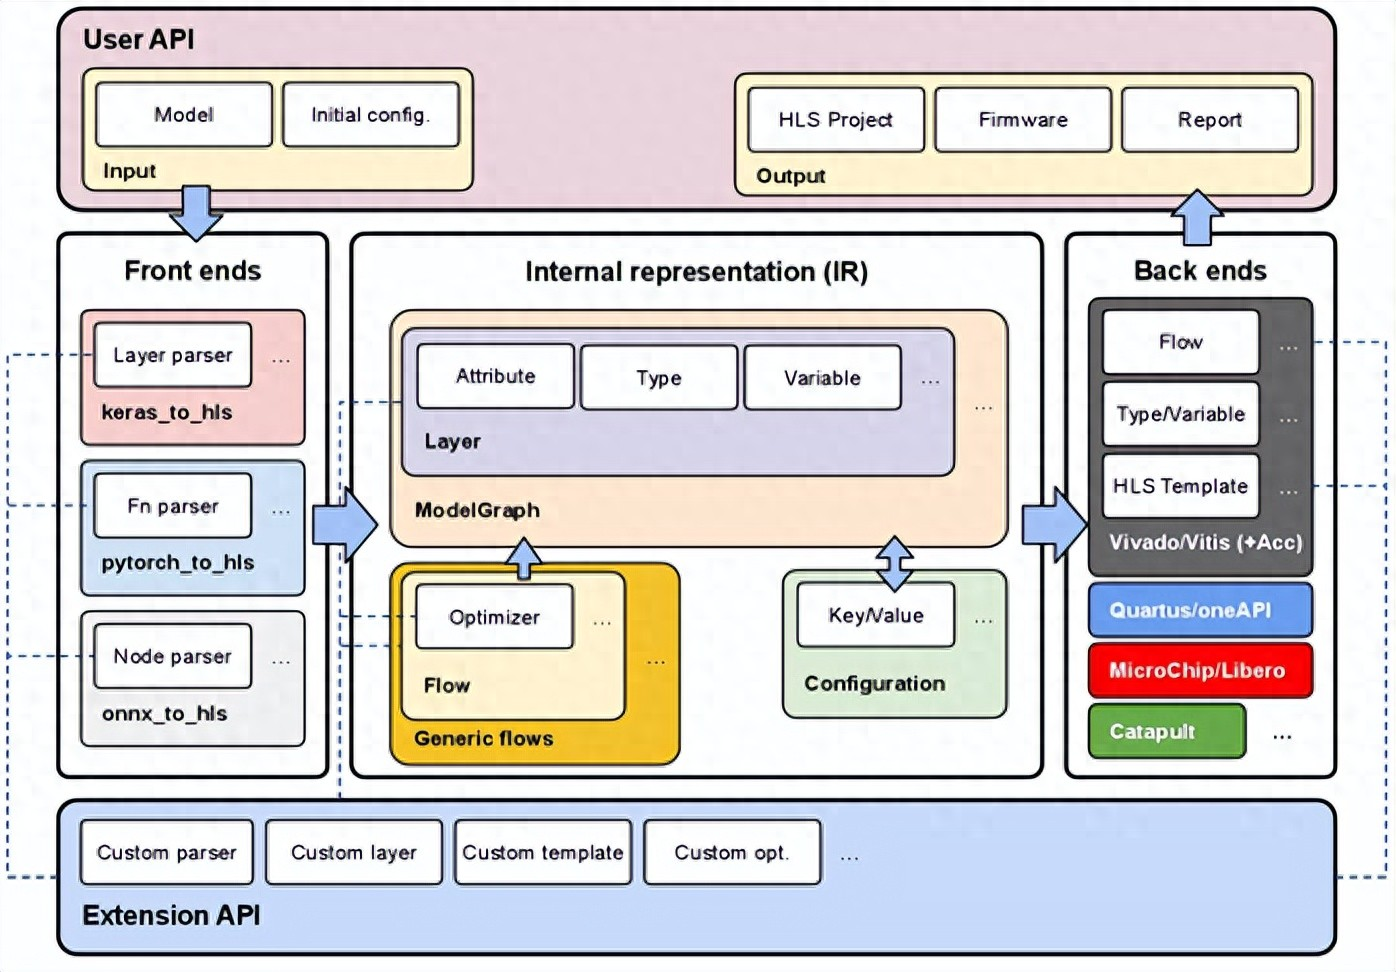
一、 核心观点
- 自动化填补软硬件设计鸿沟: 传统的 FPGA 开发流程(即使采用高级综合 HLS)也难以直接适应由 PyTorch 或 TensorFlow 等现代深度学习框架训练的神经网络,需要开发者具备极高的硬件专业知识和时间投入。hls4ml 充当了“翻译器/编译器”的角色,能够将主流框架导出的模型自动化地转换为高度优化的 HLS 代码,从而让算法工程师也能轻松部署硬件加速应用。
- 模块化的编译器级架构: hls4ml 采用了类似现代编译器的模块化设计:其前端(Front-ends)负责解析不同框架的模型并将其转换为框架无关的中间表示(IR);在 IR 阶段进行一系列与具体硬件无关的优化流程(如精度传播、算子融合);最后由后端(Back-ends)根据用户配置(如时钟周期、重用因子、并行度),调用不同芯片厂商的 HLS 模板库,生成定制化的 HLS 工程代码。
- 深度融合的软硬件协同设计(Co-design): 极致的低延迟和资源控制无法仅靠硬件层面的优化解决。hls4ml 的强大之处在于它深度集成了社区的多款 QAT(量化感知训练)和剪枝工具(如 QKeras、HGQ、da4ml、硬件感知剪枝等)。这种在算法训练阶段就引入硬件约束的协同设计,是在边缘端实现高精度、极低功耗和亚微秒级延迟的关键。
- 极佳的灵活度与设计空间探索: hls4ml 允许用户对生成的硬件设计进行高度定制。例如,通过调整重用因子(Reuse Factor, RF),用户可以在“低延迟优先”(完全展开计算)和“节省资源优先”(复用乘法器)之间自由进行折中平衡,而不需要手动修改或理解底层复杂的 HLS 硬件代码。
二、 关键数据
1. 编译与运行效能提升
- 多子图并行合成:自 v1.2.0 起,hls4ml 支持将模型拆分为多个子图进行并行 HLS 编译。针对 CIFAR-10 分类的量化 ResNet 模型,HLS 合成时间由平均 7 小时大幅缩短至 3 小时。
- 高内核占有率与极高吞吐:在数据中心级加速器(如 AMD Alveo)部署时,通过多线程主机端代码优化重叠数据传输和计算,实现了高达 96% 的核心占有率(core occupancy),在多加速器配置下吞吐量超过每秒 140 万次推理。
2. 量化与优化算法表现
- 高粒度量化 (HGQ):相比常规模型压缩,在 unrolled CMVM 结构中,HGQ 可将片上 LUT 资源占用削减 50% 至 95%,DSP 使用量削减 50% 至 100%,同时实现高达 80% 的延迟降低,且没有任何精度损失。
- 分布式算术 (da4ml):结合 HGQ 使用时,分布式算术(DA)策略可以使 LUT 使用量再降 ~1/3,并且完全消除(100% 节省)DSP 的占用。
- 硬件感知剪枝:该算法将片上原语的开销直接设为优化目标,实现了 DSP 资源降低 2.2× 至 12.2×、BRAM 占用降低 1.4× 至 5.2×,同时仅带来极微小的精度降低。
- 代理预测模型 (rule4ml):作为评估工具,其 MLP 代理模型能够在训练了 15,000 个 HLS 合成结果后,在约 80% 的测试案例中,预测出真实合成结果 10% 以内的资源与延迟数据。
3. 典型基准与应用性能数据
- 高维特征喷注标记器 (Jet Tagger) 基准:
- 极致低延迟(AMD XCVU9P):采用 HGQ + DA 策略时,模型在保持 75.9% 精度的条件下,延迟仅为 3 个时钟周期(即 12.1 ns),且 DSP 占用为 0(II = 1)。
- 低端 FPGA 部署能力(AMD XC7A35T):在低端 Artix-7 设备上,Latency 策略因资源不足而布局失败(Place failed),而 DA 策略成功完成布局部署(利用了 93.6% 的 LUT),证明其在资源极度受限设备的可用性。
- Intel 后端(Altera Agilex7):利用 oneAPI 后端进行优化,在 614 MHz 的 Fmax 下,实现了 50 个时钟周期(81 ns)的极低延迟。
- 街景门牌号 (SVHN) 图像分类:
- 使用 3 卷积层、3 最大池化层和 2 全连接层的 CNN 架构,采用 HGQ + DA 策略,在 93.9% 精度下仅需 1,045 个时钟周期(约 5.2 μμs),同样不消耗任何 DSP(II = 1029)。
- 智能像素传感器 (Smart Pixels):
- 在 28 nm CMOS 工艺下,采用 Catapult 后端,实现每个像素的数字逻辑功耗低于 1 μμW(总功耗预算低于 1W/cm²),并成功减少了 54.4% 至 75.4% 的数据传输带宽。其 1D 卷积变体仅需 0.39 mm² 的芯片面积。
- 其他工业与科研前沿应用:
- 核聚变磁约束反馈控制:实现了 7.7 μμs 的推理延迟以及 17.6 μμs 的端到端延迟,运行帧率超过 100 kfps。
- 100 Gbps 网络安全检测:部署三值模型过滤恶意包,延迟仅 44 ns,且完全不影响 100 Gbps 的线速吞吐。
- 表面纹理分类 (C-RNN):实现仅 6.21 μμs 的推理延迟。
- 微波食品污染检测:在 Kria K26 FPGA 上实现了 27 μμs 的处理延迟。
hls4ml 对于 Transformer 加速效果、实现机制以及局限性的详细说明:
1. 支持状态与架构实现
- 版本引入与算子支持:hls4ml 在 v1.2.0 版本中正式引入了对多头自注意力(Multi-Head Attention, MHA) Transformer 模型的支持。在算子层面上,Keras 3、HGQ 2、PyTorch 和 ONNX 前端均已支持
Einsum(爱因斯坦求和)和Multihead Attention算子。 - 前端与后端限制:目前,这一特性是通过 HGQ 2(基于 Keras 3 的高粒度量化框架)前端引入的,并且在硬件生成端目前仅支持 Vitis 后端(用于 AMD FPGA)。
- 软硬件协同优化:针对物理学等对超低延迟有极致要求的应用场景,研究人员已成功利用 hls4ml 实现了超快速的 Transformer 硬件推理。
2. 核心加速机制与优化技术
为了在可重构硬件上高效运行 Transformer,hls4ml 及其生态系统引入了多项关键的协同设计技术:
- 高粒度量化感知训练(QAT):Transformer 模型的参数量通常很大,直接部署会消耗极高的硬件资源。通过结合 HGQ 2,hls4ml 允许在训练阶段对模型进行极其精细的量化和剪枝,在保持高精度的同时,显著降低所需的片上资源和计算延迟。
- 计算效率变体开发(HEPT):为了进一步优化计算效率,hls4ml 团队目前正在开发一种针对点云数据优化的 Transformer 变体——HEPT(基于局部敏感哈希,Locality Sensitive Hashing)。
3. 当前面临的瓶颈与挑战
由于 Transformer 的结构特性,在 hls4ml 的默认框架下部署会遇到以下瓶颈:
- 片上存储与编译失败风险:hls4ml 默认的设计哲学是采用片上(On-chip)低延迟数据流架构,试图将所有模型权重和中间激活值存放在 FPGA 的片上 BRAM 中。然而,Transformer 模型通常过于庞大,直接编译极其容易因为超出片上逻辑资源或布线拥堵(congestion)而导致 HLS 编译器长耗时甚至合成失败。
- 带宽与内存瓶颈:对于体量较大的 Transformer,常规的片上存储难以为继。虽然一些相关研究提出在新型 FPGA 上使用高带宽内存(HBM)来解决 Transformer 的数据读取问题,但 hls4ml 的原生模板仍需要更深度的适配。
4. 与其他专用 Transformer 工具的对比
在 FPGA 编译生态中,还有其他针对 Transformer 设计的学术或商业工具,其设计选择与 hls4ml 有所不同:
- MASE:这是一个同样支持 PyTorch 模型量化和转换的平台,它重点关注 Transformer 和大语言模型(LLM) 的加速,并使用 SystemVerilog 模板进行硬件生成。
- cgra4ml:与 hls4ml 生成专用的硬连线数据流(Dataflow)硬件不同,
cgra4ml通过在层与层之间复用处理单元(PUs)来支持 MLP、CNN 和 Transformer。最关键的是,它将模型权重存储在片外内存(Off-chip memory)中,从而能够处理比 hls4ml 大得多的模型。
5. 未来发展方向
为了彻底解决大型 Transformer 模型“无法装入单一 FPGA”的硬伤,hls4ml 社区正在朝以下方向努力:
- 分布式推理(Distributed Inference):hls4ml 最近集成了 Coyote v2 这一支持高吞吐网络服务的开源 Shell。未来的工作计划利用 Coyote 提供的集体通信服务,实现跨多个 FPGA 芯片的分布式 Transformer 模型推理,从而突破单卡片上资源的物理极限。
hls4ml 支持并实际部署/测试了以下多款 AMD FPGA 芯片系列及具体型号:
1. 支持的芯片系列与板卡平台
- Alveo 数据中心加速卡:支持部署至 Alveo 加速器(如多核和多加速器配置),利用 Vitis 系统设计流程管理高吞吐量的主机-设备数据传输,在多卡配置下可实现每秒超 140 万次的推理吞吐量。
- Zynq SoC / 开发板系列:hls4ml 提供了开箱即用的支持,允许用户通过几行 Python 代码直接在 Zynq 板卡上验证和快速部署模型。
- UltraScale+ 系列:作为高吞吐、极低延迟应用(如欧洲核子研究中心 LHC 物理实验的触发系统)的主要测试与部署平台。
- Artix-7 / 7系列:针对资源受限、低成本的边缘端或紧凑型应用(如微型辐射安全检测设备)。
- Kria 系列:用于边缘端嵌入式智能系统加速。
2. 论文中明确提及并评估的具体型号
- XCVU9P(具体器件型号如
xcvu9p-flga2104-2L-e):属于 UltraScale+ 系列。它是论文中用于超低延迟基准测试(如 Jet Tagger 喷注标记器、SVHN 街道门牌号分类器)的最核心器件。 - XCVU13P:属于 UltraScale+ 系列。在论文中主要用于评估需要大规模并行但高度稀疏的硬件设计,如基于粒子的喷注标记器(MLP-Mixer 架构)和 MNIST 手写数字分类模型。
- XC7A35T(具体器件型号如
xc7a35tlcsg325-2L):属于入门级 Artix-7 芯片。论文通过该型号展示了使用分布式算术(DA)策略在极度资源受限的低端 FPGA 上成功部署模型的能力。 - ZCU102 开发板:配备 Zynq UltraScale+ MPSoC 芯片,用于原型化和评估自动驾驶汽车中的实时语义分割量化 CNN 模型。
- Kria K26:用于食品污染微波检测系统中 MLP 模型的实时加速部署,实现约 27 微秒的低延迟。
3. 后端编译与集成流程
hls4ml 通过其 Vitis 和 Vivado 后端生成适配 AMD 芯片的硬件工程。
- 工具链兼容性:重点支持 Vitis HLS(2022.2 或更新版本)以及较旧但仍兼容的 Vivado HLS。
- 自动生成组件:后端不仅生成 C++ HLS 代码,还会自动包含用于综合工程的 TCL 脚本、仿真测试平台(Test Benches) 以及支持在 Python 中直接进行硬件调用的 C/C++ 桥接代码。
https://arxiv.org/abs/2512.01463
https://github.com/fastmachinelearning/hls4ml
更多推荐

 5
 0
- 0


 已为社区贡献5条内容

所有评论(0)