
DeepSeek-V4 和 GPT-5.5 几乎同时来了,AI 竞争真的开始变
如果你最近一直在看 AI 行业的动向,应该会有一种很明显的感觉:现在大家比的,已经不只是“谁更聪明”了,真正被拉开差距的,是另一件事——谁更能把事做完
最近,DeepSeek 发布了V4,OpenAI 也正式推出了5.5。两边几乎是前后脚。这种“撞档期”当然有偶然成分,但放在当下的行业节奏里看,它更像是在提醒所有人:AI 的竞争,已经从单点能力,往更完整的系统能力、产品能力和生态能力走了。
说得再直白一点。现在光会回答问题,已经不够了。能不能读长文档,能不能拆复杂任务,能不能调用工具,能不能稳定把结果交出来,这些才越来越关键
如果说前几轮大模型发布还带着一点“跑分秀肌肉”的味道,那这次就现实多了。DeepSeek-V4 和 GPT-5.5 都在试着证明一件更重要的事:自己不仅更聪明,而且真的更能干活。 能读更长的内容,能处理更复杂的任务,最好还别太贵、别太慢。行业现在看的,就是这些。
一、几乎同时发布,背后其实是同一个趋势
先看时间点。OpenAI 在 2026 年 4 月 23 日发布 GPT‑5.5,DeepSeek 这边也在几乎同一时间上线了 DeepSeek-V4 预览版。两家前后脚出牌,给人的直观感受就是:节奏明显更快了。
但我觉得,重点不只是“发得快”。更重要的是,大家在追的东西已经变了。
这两年,大模型厂商嘴上说的还是智能,实际上争夺的重心早就变成了几个更具体的方向:超长上下文、Agent 执行、知识工作落地、推理效率,还有开发者生态。
DeepSeek-V4 讲得很直接。它把 1M 百万上下文作为官方服务标配来推,同时强调自己在 Agent、世界知识和推理性能上的表现。OpenAI 的 GPT‑5.5 走的是另一种表达,更强调“真实工作”——理解复杂任务、拆步骤、调用工具、检查结果,然后在编码、研究、数据分析、文档处理这些场景里,把事情往前推进。
说到底,行业现在没那么在意“你到底有多会聊天”了。更在意的是:你能不能成为一个真的能用、能接进工作流、能稳定产出的系统。 这才是这轮竞争最本质的变化。
二、先说 DeepSeek-V4:它最值得看的,是把长上下文往“标配”上推
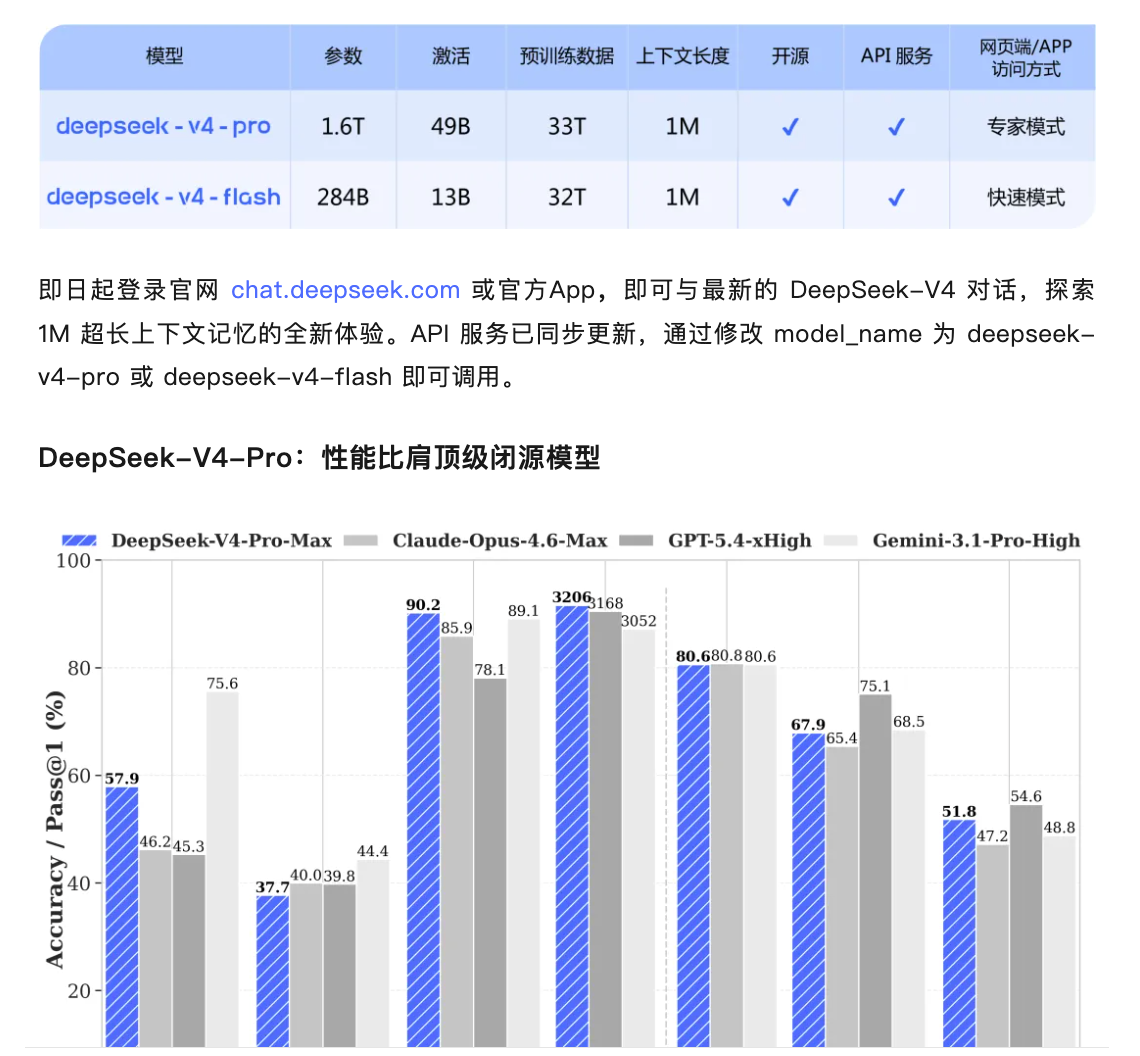
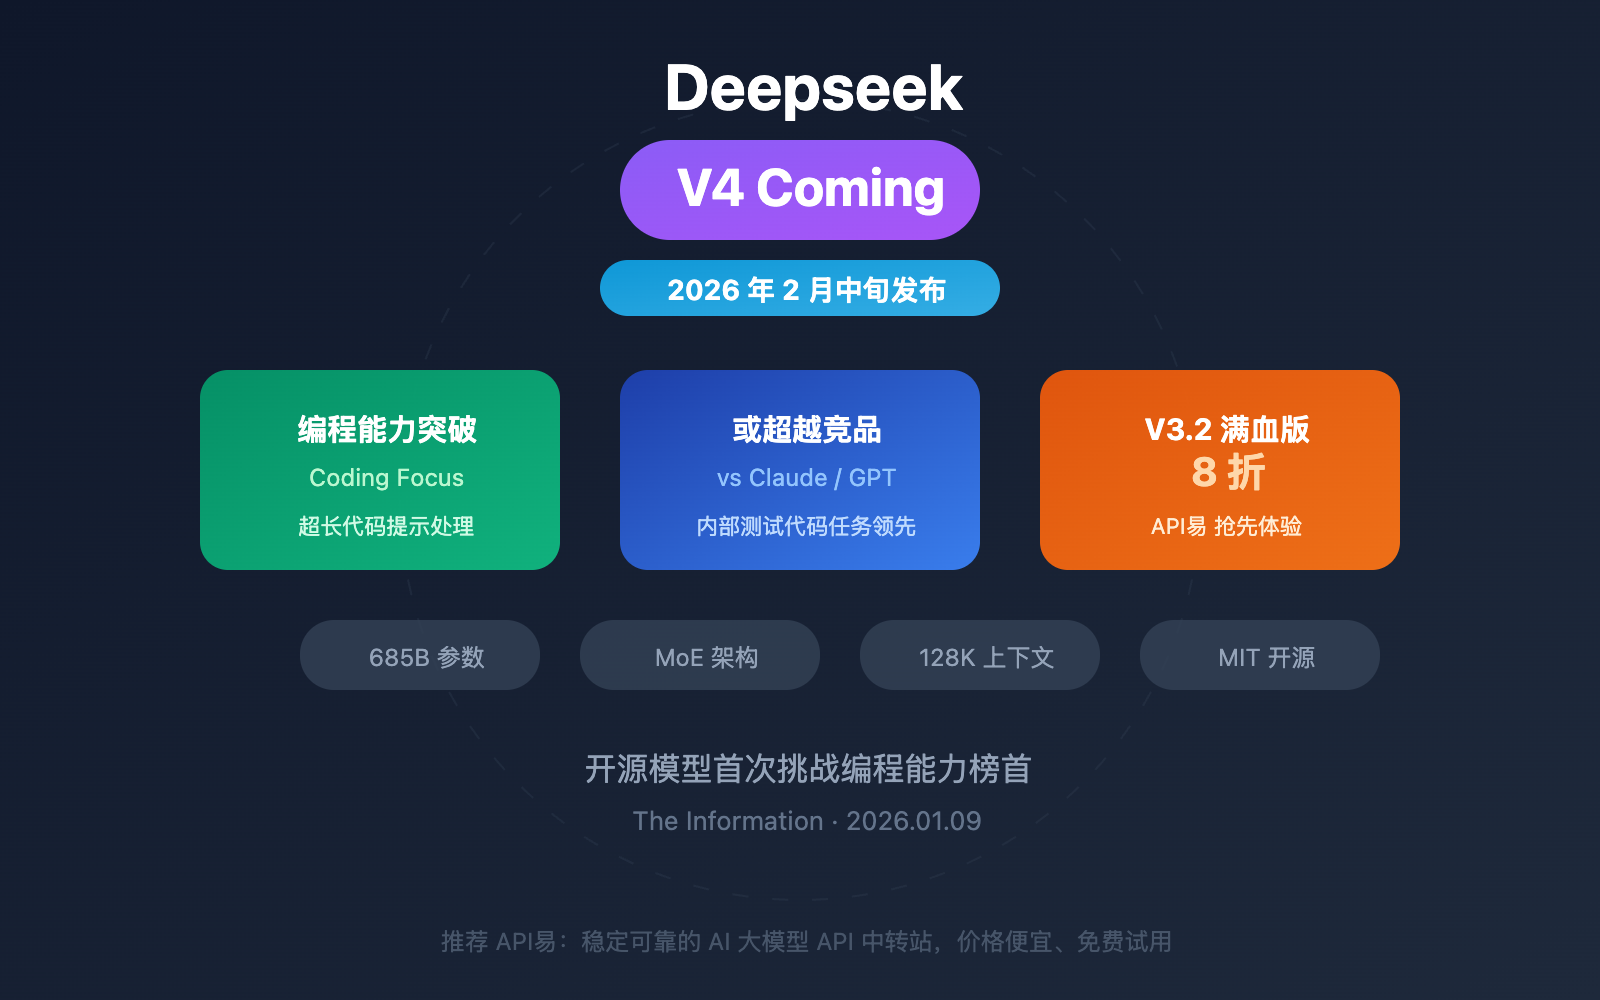
DeepSeek-V4 这次最值得注意的,我觉得不是某一个单独榜单,而是它把长上下文这件事往前推了一大步。根据 DeepSeek 官方介绍,DeepSeek-V4 支持 1M 上下文长度,而且不是拿来做展示,而是直接作为官方服务标配。
这件事很重要。真的不夸张
因为很多人现在已经意识到了,大模型在真实任务里经常“不稳定”,不是因为它不够聪明,而是因为它看得不够全。上下文一短,它就只能抓住局部。前面说了什么,后面忘了。文档一多,代码一长,推理链一复杂,效果就容易掉。
但如果整本手册、完整代码仓、长对话记录,甚至一堆相关资料都能放进同一个上下文里,事情就不一样了。模型的理解范围会更完整,跨段落推理会更顺,很多过去必须拆开做的任务,现在有机会一次性处理。
DeepSeek 还提到,他们用了新的注意力机制和 DSA 稀疏注意力,在 token 维度做压缩,尽量把长上下文的计算和显存成本压下来。这里我觉得它释放出的信号很明确:它不只是想证明“我能做到”,而是想把“做得到”变成“用得起”。
这其实比单纯把数字做大更有意义。如果长上下文开始从少数高价能力,变成更多人都能用的默认能力,那对整个行业的影响会非常实际
另外一个值得看的点,是它把 Agent 能力也摆到了很靠前的位置。官方给出的说法是,V4-Pro 在 Agentic Coding 评测里做到了当前开源模型里的最好水平,在数学、STEM 和竞赛型代码这些推理评测中,也超过了当前所有已公开评测的开源模型。V4-Flash 则更强调速度和成本。
这个组合其实很好理解:一边冲性能上限,一边冲性价比。 这不是花哨的产品线设计,而是很现实。因为今天企业和开发者最关心的,往往也就是这两件事——要么你足够强,要么你足够划算,最好两样都沾一点。
三、再看 GPT-5.5:OpenAI 想讲清楚的,是“AI 到底怎么参与真实工作”
如果说 DeepSeek-V4 这次最亮眼的是长上下文和开源侧的推进,那 GPT‑5.5 更像是在把“能干活”这件事说得更具体
根据 OpenAI 发布说明,GPT‑5.5 被定义为“our smartest and most intuitive to use model yet”。但比起这句标准表述,我更在意后面的内容:写代码、调试、在线研究、分析数据、做文档和表格、操作软件,以及跨工具完成多步骤任务。
这说明 OpenAI 现在想抢的,不再只是对话入口,而是更完整的工作入口。
他们把这些能力归纳成 agentic coding、knowledge work 和 scientific research 三个方向。翻译成人话就是:GPT‑5.5 不只是单轮回答更强,而是在一个更长的任务链里,更知道下一步该做什么,也更能自己检查哪里做错了。
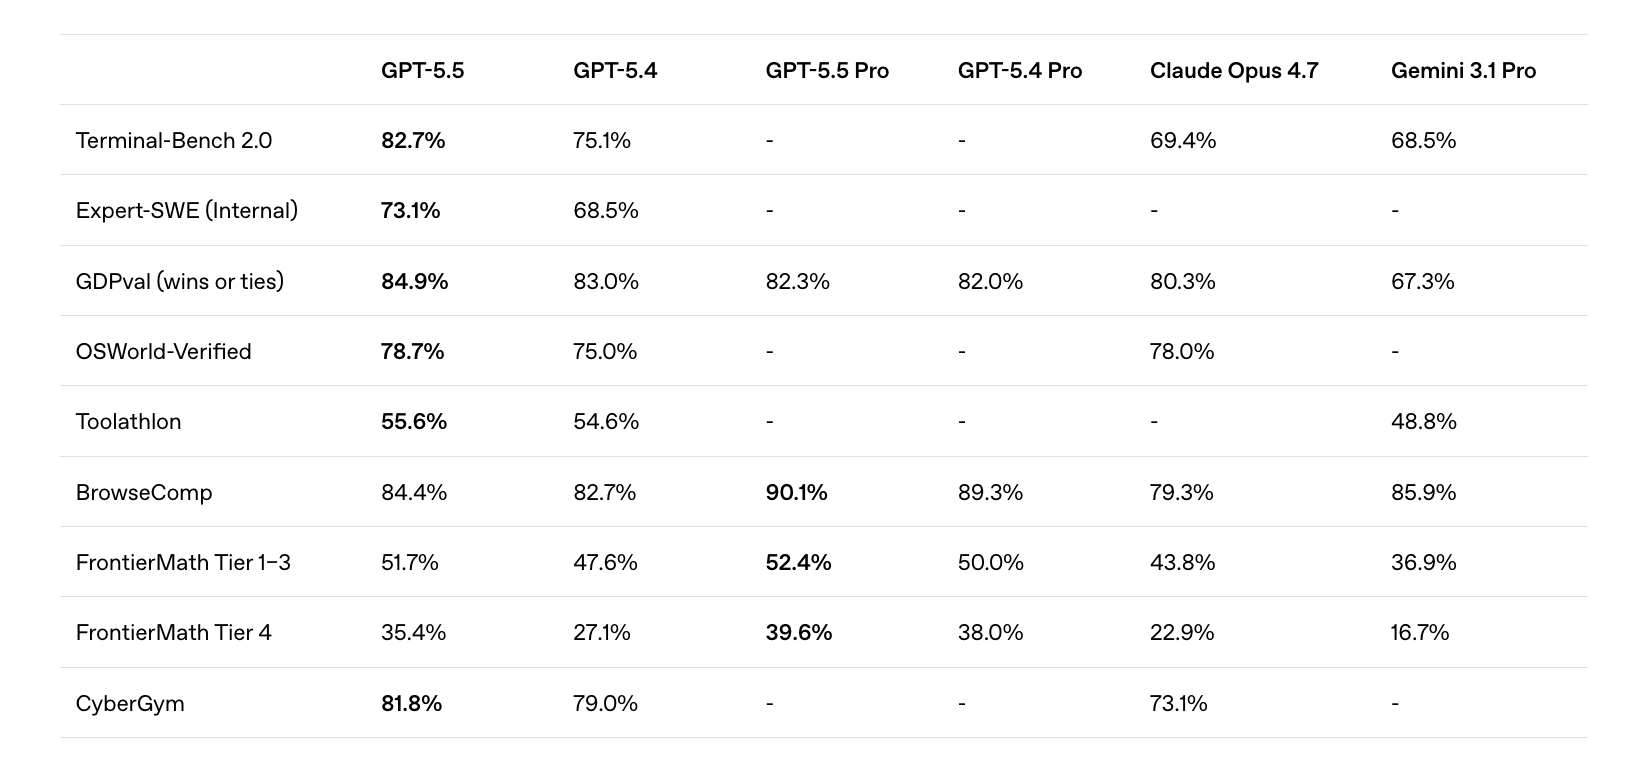
从公开数据看,GPT‑5.5 在 Terminal-Bench 2.0、OSWorld-Verified、BrowseComp、CyberGym 等评测里都拿出了不错的表现。OpenAI 还特别强调了一点:在智能水平更高的同时,它的实际服务延迟接近 GPT‑5.4,而且完成同样任务时,用掉的 token 更少。
这一点其实特别关键。因为真正到了生产环境里,大家最后算的不是“它是不是理论最强”,而是三个问题:稳不稳,快不快,贵不贵。 模型能力再强,如果延迟高、成本高、结果还飘,那就很难真的进业务。
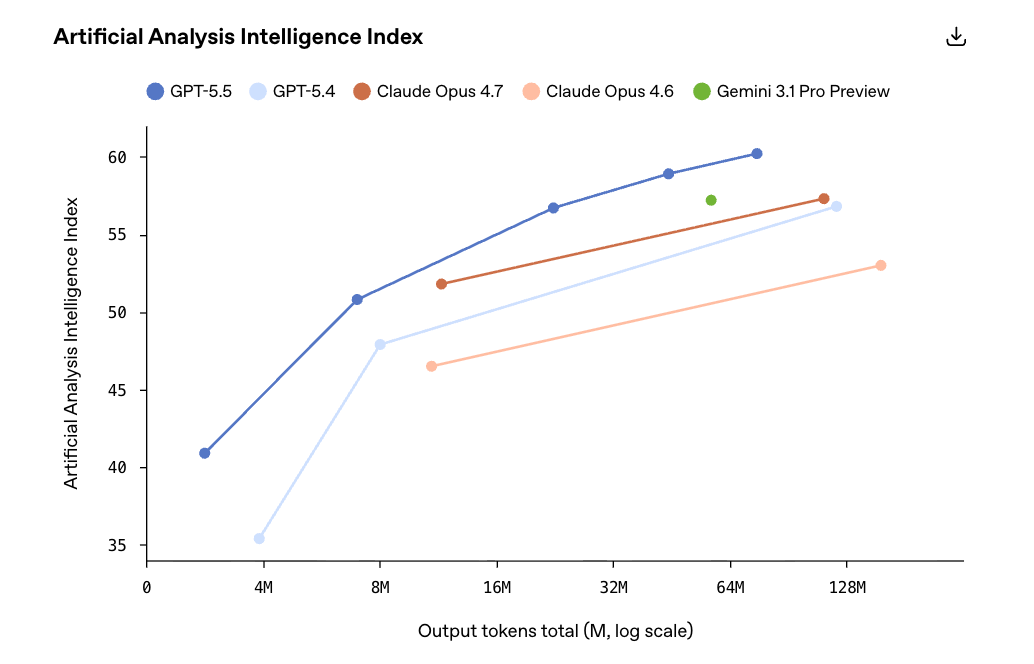
从产品形态看,GPT‑5.5 也明显在往“工作平台”那边走。它不只是服务 ChatGPT,也深度嵌入了 Codex 场景,强调文档、表格、演示、代码、研究这些任务之间的联动。说白了,OpenAI 想做的已经不是一个聊天工具,而是一个能直接接手部分知识工作的系统。
四、真正的较量,其实已经不是参数和分数了
如果把 DeepSeek-V4 和 GPT‑5.5 放在一起看,会发现两边的侧重点确实不一样。DeepSeek-V4 在长上下文和开源普惠上冲得更猛,GPT‑5.5 在 Agent 工作流和知识工作场景上的路径更完整。
但它们其实在回答同一个问题:谁能更深地嵌进真实世界的工作系统里。
DeepSeek-V4 的价值,在于它把“高性能 + 超长上下文 + 开源可得”这个组合往前推了一步。对国内开发者、有私有化部署需求的企业、还有那些要处理海量文档和代码的团队来说,这个吸引力很现实。尤其是官方同时给 API、开源权重和本地部署路径的时候,它就不只是发了一个模型,而是在搭一个生态入口。
GPT‑5.5 的优势则很明显落在另一边:产品化、工作流整合,以及全球开发者生态。它把模型和 Codex、ChatGPT 以及更多软件操作场景连在一起,形成一种更强的“拿来就能用”的体验。对国际化团队,或者高强度知识工作者来说,这种整合能力本身就很有壁垒。
所以这场竞争,真不是一句“开源对闭源”就能概括的。也不是比谁榜单高一点。真正决定胜负的,是:谁更能占住用户每天工作的入口,谁更能成为开发者默认会调用的那层基础设施。
五、这件事为什么值得普通人也认真看
我觉得这轮几乎同步发布,最值得重视的一点是:AI 竞争的门槛又被抬高了。 以后只会答题,肯定不够。模型得同时有长上下文、复杂任务执行、工具协作、成本控制和生态接入能力。少一块都可能不行。
对企业来说,选模型的标准也在变。以前很多人会先看参数、榜单、价格。接下来更该看的,可能是“任务完成率”“接入成本”“上下文容量”“实际使用成本”,以及“它到底适不适合你现在的工作流”。
这点非常现实。公司最终买的,不是一个会说漂亮话的 AI,而是一个能嵌进组织流程、能把具体事情做下去的生产力工具。
对普通用户也是一样。未来你越来越少会把 AI 只当搜索替代品,而是会把它当成一个真正能一起做事的助手。读长文档,查资料,整理信息,写代码,做汇报,跨工具推进任务,这些都会越来越常见。
这也是为什么我觉得这波变化很重要。它不是又多了一个新模型那么简单,而是在慢慢改写大家实际工作的方式。
当然,竞争变激烈,对用户总体还是好事。模型会更强,价格会继续往下打,迭代速度也会更快。不管是 DeepSeek 把百万上下文往普惠方向推,还是 OpenAI 把 agentic work 做得更成熟,最后真正受益的,还是开发者、企业用户,以及越来越多普通人。
结尾
DeepSeek-V4 和 GPT‑5.5 几乎同时出现,在我看来,确实有点像一个分水岭。
一边是 V4 在超长上下文、Agent 能力和开源生态上的继续推进;另一边是 gpt5.5 在真实工作流、知识任务和系统效率上的进一步落地。路线不一样,但目标其实很一致:让大模型从“会回答”,走向“会执行”
这件事为什么重要?因为从这一刻开始,模型之间比的,很可能不再是谁偶尔更惊艳,而是谁能长期稳定地进入真实工作,谁能持续创造实际价值。
所以接下来最值得关注的,也不只是“谁又发了更强的新模型”。更实际的问题是:当这些模型越来越像真正的工作伙伴,我们自己怎么更快学会和它们协作
更多推荐

 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)