
【必收藏】从零手写多智能体系统!不依赖LangChain,小白也能学会的Deep Research Agent实战
近几个月以来,“Agentic AI”(智能体AI)已然成为AI行业的核心热词,无论是技术论坛还是开发者交流群,随处可见相关讨论。但遗憾的是,大多数分享都停留在概念层面的科普——比如ReAct框架是什么、Plan-and-Execute范式有哪些特点、Multi-Agent Collaboration(多智能体协作)的核心逻辑是什么,鲜少有人深入到实操层面。
而对于程序员、AI开发小白来说,最核心的疑问从来都不是“是什么”,而是:你能否摆脱LangChain、LlamaIndex、AutoGen这些高级编排框架,亲手写出一个可运行、可扩展、还能落地使用的多智能体系统?
今天这篇文章,就带你打破“框架依赖”,从零开始手写一个Deep Research Agent(深度研究智能体)。它不仅能自主规划研究方向、并行执行研究任务、反思优化研究过程,还能输出结构清晰、可直接复用的结构化报告。更关键的是,整个系统完全基于原生Python + LLM API构建,没有任何高级编排框架的依赖,小白也能跟着一步步实操,建议收藏备用!
🎯 为什么要做这个项目?
当前,大多数LLM(大语言模型)应用开发都陷入了“框架依赖”的困境——大家都习惯用LangChain这类编排框架快速搭建项目,虽然能提升开发效率,但对于想要真正掌握智能体核心逻辑的小白、程序员来说,反而会形成阻碍。具体来说,主要有3个问题:
- 黑盒化严重:框架已经封装好了底层的通信逻辑、状态管理、错误处理等核心功能,开发者只需要调用API,根本不清楚底层是如何实现的,长期下来只会“调包”,不会“造包”;
- 调试困难:一旦项目出现问题(比如Prompt失效、工具调用失败、链路中断),很难定位问题根源——不知道是Prompt写得不好,还是工具调用逻辑有问题,亦或是框架本身的逻辑冲突,排查起来费时费力;
- 灵活性极差:如果想自定义智能体的协作协议,或者插入自己研发的反思模块、优化模块,往往需要绕过框架的原生设计,甚至需要修改框架源码,对于小白来说几乎不可能实现。
因此,我们做这个实战项目的核心目标,不是“炫技”,而是带大家回归AI开发的本质:用最基础的组件(原生Python + LLM API + 简单工具函数 + 控制流),搭建一个端到端的Agentic系统。通过亲手编写代码,真正理解智能体系统的工程骨架,掌握可迁移的AI开发能力——这才是AI工程师的核心竞争力,也是小白突破“调包困境”的关键。
🧩 系统整体架构
整个 Deep Research Agent 的工作流如下图所示:
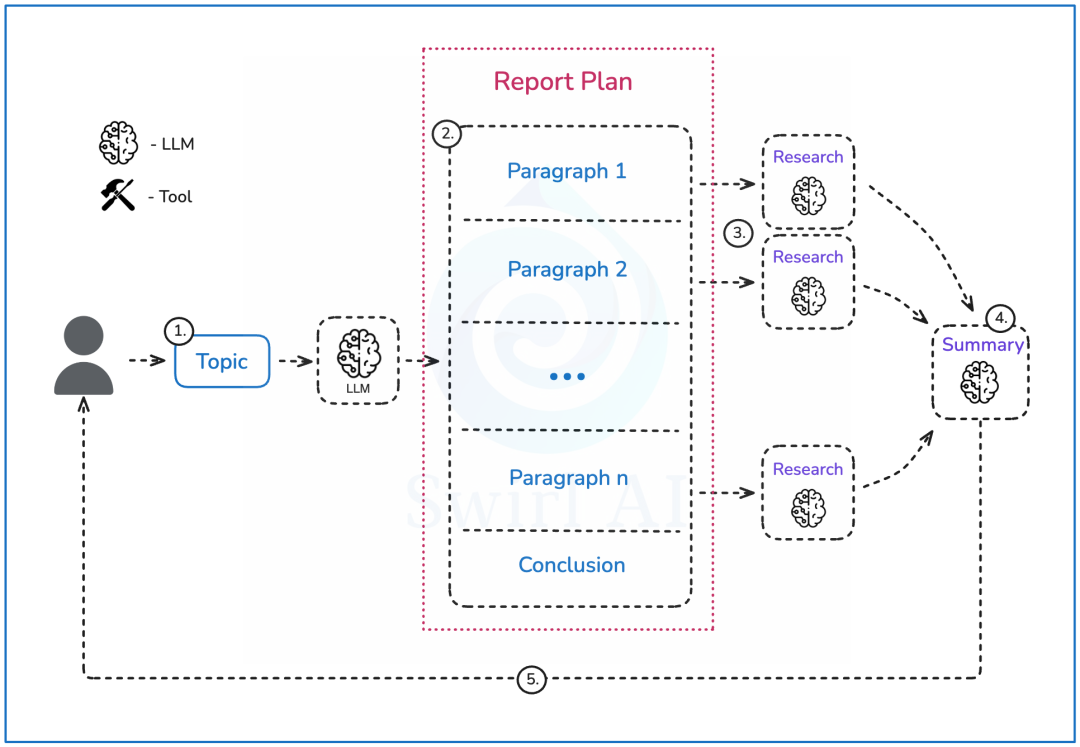
阶段 1:用户输入与大纲生成
- 用户提供一个研究主题,例如:“分析 2025 年全球 AI 芯片竞争格局”。
- 系统调用 LLM(如 DeepSeek-R1、GPT-4o 或 Claude 3.5 Sonnet),要求其:
- 生成一份结构清晰的报告大纲;
- 限制段落数量(例如最多 5 段);
- 每段需包含明确的研究目标描述(如“本段将分析英伟达、AMD、华为在训练芯片市场的份额变化”)。
✅ 关键设计:大纲本身成为后续子任务的“任务契约”(Task Contract),确保研究聚焦。
阶段 2:并行段落研究(Multi-Agent Parallelism)
每个段落描述被独立送入一个 Research Sub-Agent(研究子智能体)。这些子智能体彼此独立、可并行执行,构成典型的 Multi-Agent Topology。
每个子智能体内部执行一个 Reflective Search Loop(反思式搜索循环),这是本系统的核心创新点。
🔁 反思式搜索循环(Reflective Search Loop)
传统 RAG 或单次搜索往往“一锤定音”,但人类研究员会不断调整问题、补充视角。我们的子智能体模拟这一过程:
步骤详解:
- Query Generation(查询生成)
LLM 根据段落目标,生成一个或多个 Web 搜索关键词,并附上推理理由(例如:“为了了解华为昇腾芯片的最新出货量,应搜索‘Huawei Ascend chip shipments 2025’”)。 - Web Search Execution(执行搜索)
调用搜索引擎 API(如 SerpAPI、DuckDuckGo、Google Programmable Search Engine),获取 Top-K 结果(标题、摘要、URL)。 - Reflection & Gap Analysis(反思与缺口分析)
LLM 接收搜索结果,回答两个问题:
- 当前信息是否足以支撑该段落写作?
- 是否存在明显缺失(如缺少竞品对比、时间范围不足、地域覆盖不全)?
- Iterative Query Refinement(迭代查询优化)
基于反思,生成新的、更精准的搜索查询。例如:
- 初始查询:“AI chip market 2025”
- 优化后:“AI training chip market share NVIDIA vs AMD vs Huawei Q3 2025”
- 循环 N 次(默认 2–3 轮)
每轮积累新信息,最终形成一个信息集合(Evidence Pool),用于段落撰写。
💡 工程技巧:我们在每轮之间加入“去重”和“相关性过滤”,避免信息冗余。
📝 最终报告生成
所有子智能体完成研究后,系统将:
- 汇总每个段落的 Evidence Pool;
- 调用一个“Report Writer Agent”,根据原始大纲 + 所有证据,生成连贯、引用清晰的 Markdown 报告;
- 自动添加结论段(Conclusion),总结核心发现。
⚙️ 技术栈与关键实现细节
| 组件 | 选择 | 说明 |
|---|---|---|
| LLM | DeepSeek-R1(主)、GPT-4o(备选) | 选用 DeepSeek 因其在中文+英文混合任务中表现优异,且支持长上下文 |
| 搜索引擎 | SerpAPI + DuckDuckGo Fallback | 保证结果多样性与可用性 |
| 并行控制 | concurrent.futures.ThreadPoolExecutor | 轻量级并行,避免异步复杂度 |
| 输出格式 | Markdown + 引用标注 | 便于阅读与溯源 |
| 错误处理 | 重试机制 + 降级策略 | 如搜索失败则跳过该轮,保留已有信息 |
📌 无框架依赖:未使用 LangChain 的 AgentExecutor、Tool Calling 或 Memory 模块,所有状态通过 Python 字典和列表管理。
💬 结语:真正的 AI 工程,始于动手
在这个“人人都在谈 Agent”的时代,能写 Prompt 的人很多,能写 Agent 系统的人很少。
而真正的分水岭,不在于你知道多少术语,而在于你是否愿意:
- 拆解一个复杂任务;
- 设计状态流转;
- 处理工具调用失败;
- 优化信息召回质量;
- 最终交付一个可靠、可解释、可维护的系统。
这,才是 AI 工程师的核心竞争力。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。我们整理出这套 AI 大模型突围资料包:
- ✅ 从零到一的 AI 学习路径图
- ✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
- ✅ 百度/阿里专家闭门录播课
- ✅ 大模型当下最新行业报告
- ✅ 真实大厂面试真题
- ✅ 2026 最新岗位需求图谱
所有资料 ⚡️ ,朋友们如果有需要 《AI大模型入门+进阶学习资源包》,下方扫码获取~
① 全套AI大模型应用开发视频教程
(包含提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
② 大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
③ 大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
④ AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
⑤ 大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
⑥ 大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
以上资料如何领取?
为什么大家都在学大模型?
最近科技巨头英特尔宣布裁员2万人,传统岗位不断缩减,但AI相关技术岗疯狂扩招,有3-5年经验,大厂薪资就能给到50K*20薪!
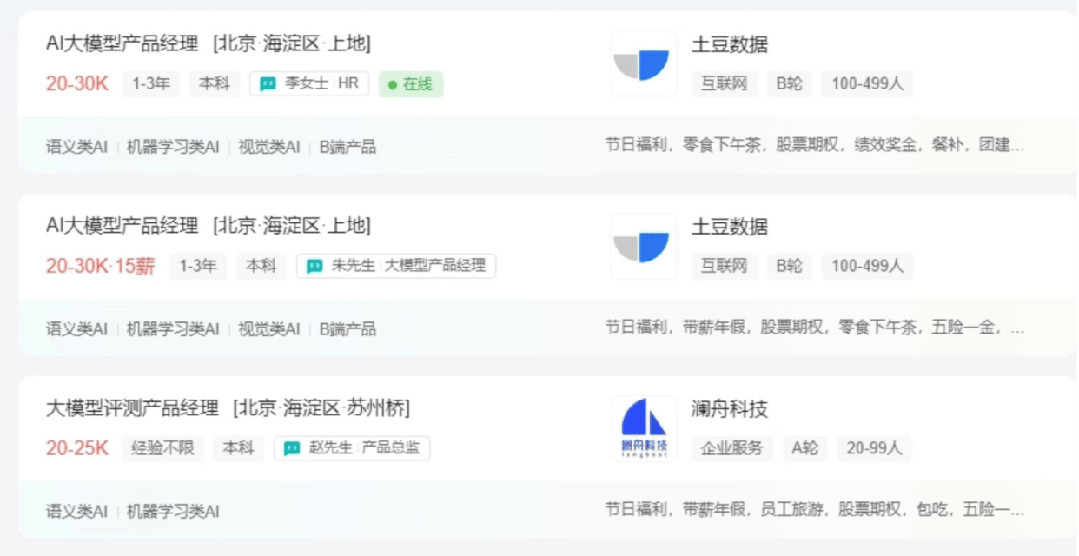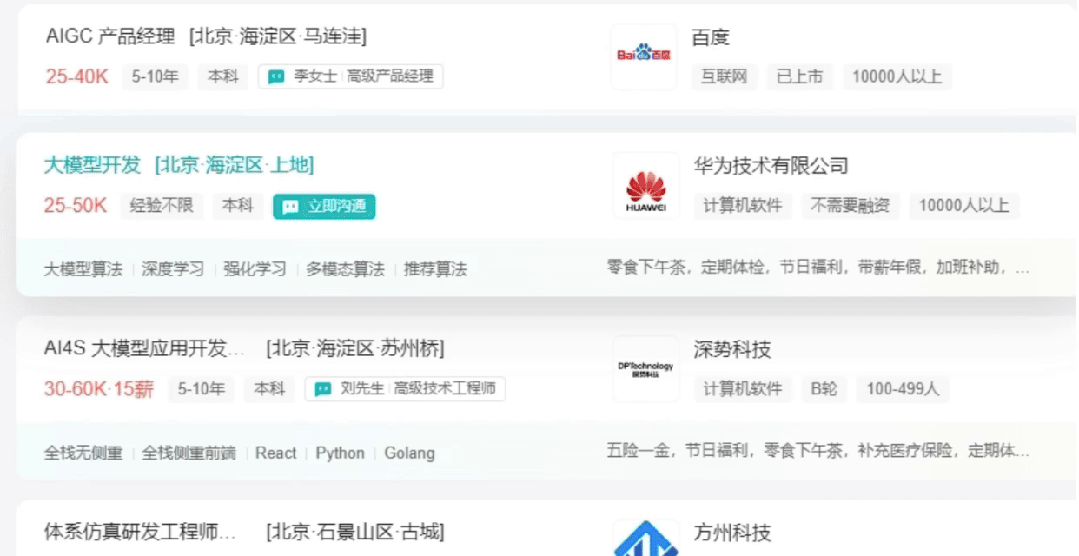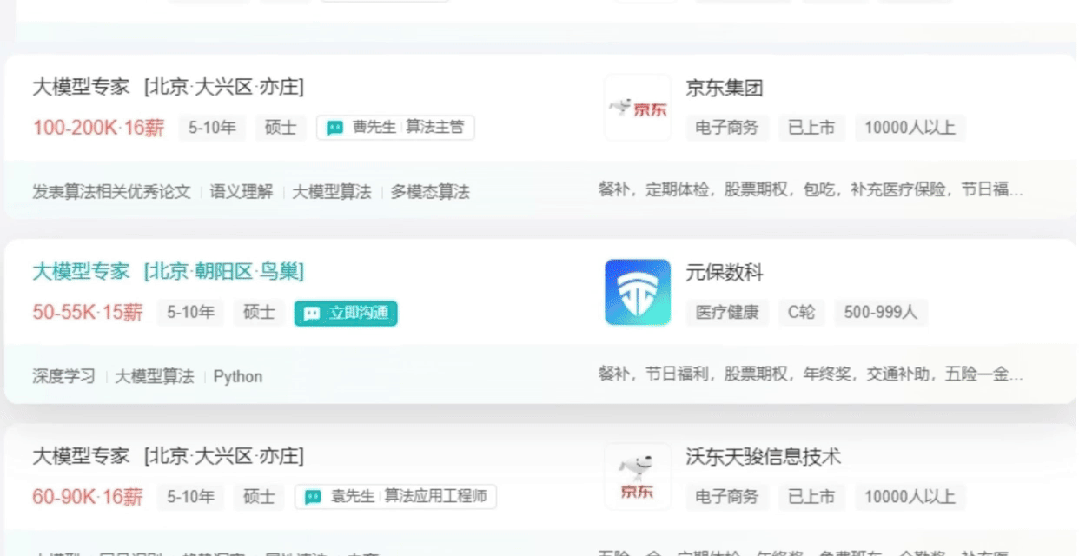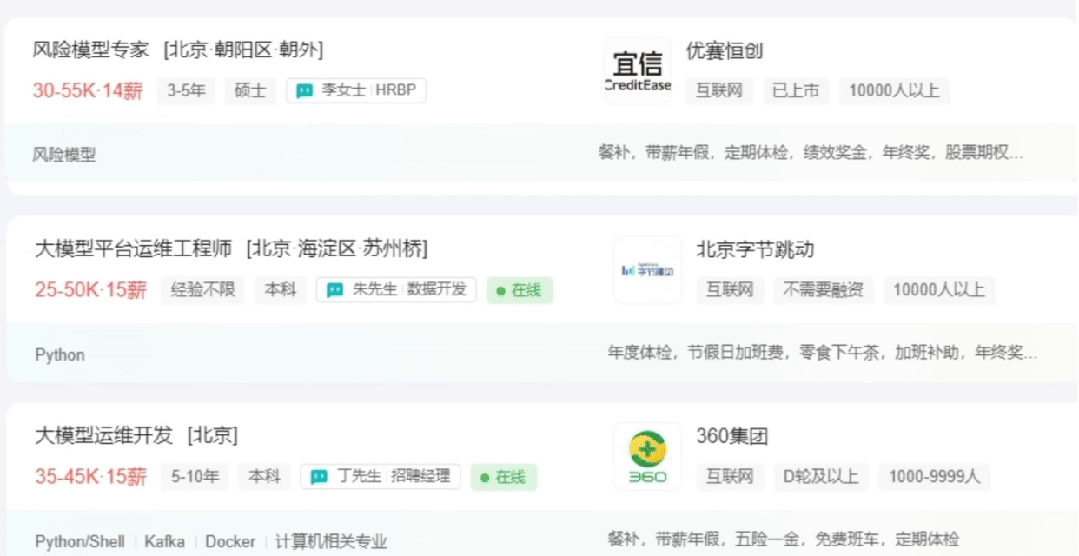
不出1年,“有AI项目经验”将成为投递简历的门槛。
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
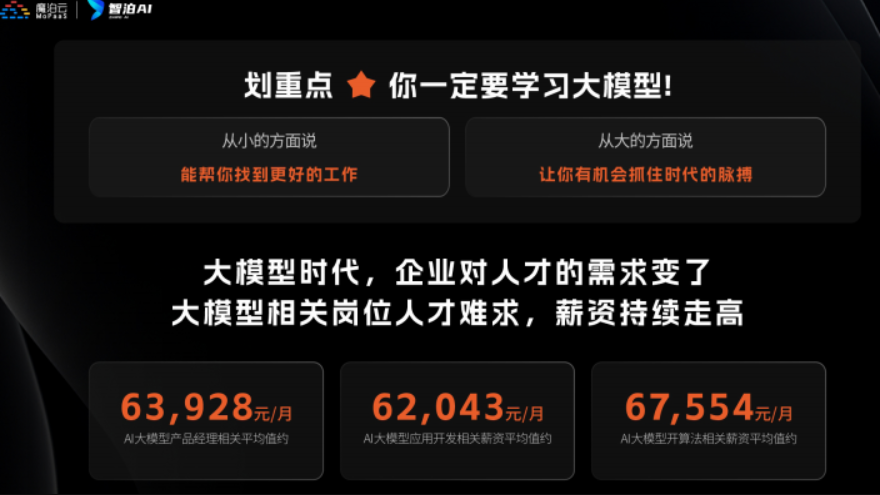
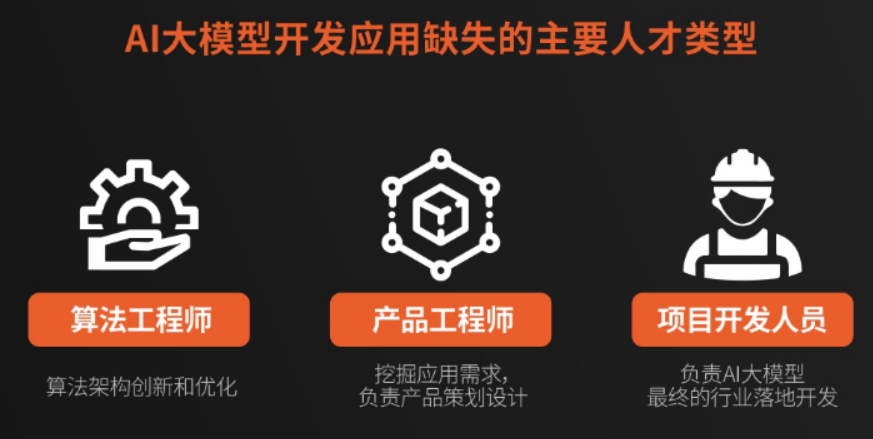
这些资料真的有用吗?
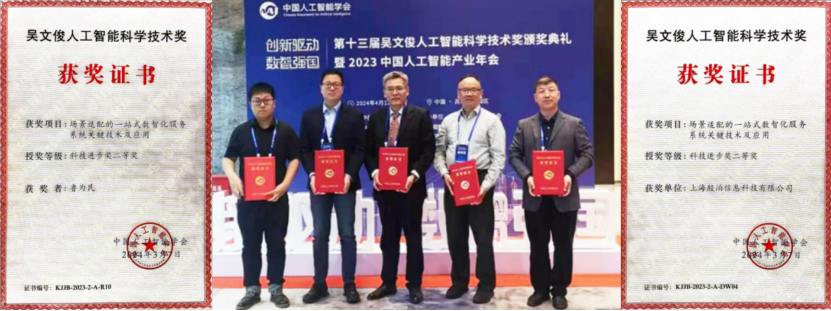
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
以上全套大模型资料如何领取?
更多推荐

 24
 0
- 0


 已为社区贡献48条内容

所有评论(0)