
Agent 术语速查卡:九个高频词,一张表放进脑子
为什么你需要一张速查卡
Agent 领域的词汇量正在以季度为单位膨胀,而且新词的诞生速度远快于消亡速度。
更麻烦的是,很多词在不同文章里指的不是同一个东西——有的作者把 Tool 叫 Skill,有的把 Runtime 叫 Harness,读三篇文章能攒出五种理解。
这篇按自底向上的顺序,把九个高频词串成一张速查卡。顺序本身就是理解框架:先有大脑,再有手,再有打法,再有骨架,最后是骨架之间的差异。
第一组:能力层——模型和工具
Model(模型):大语言模型本体。会推理、会生成,但只能说话不能做事。它是 Agent 的必要条件,不是充分条件——只有 Model 的产品叫 Chatbot。
Tool(工具):模型能调用的外部能力,一个 API、一段脚本、一个查询接口。关键在「模型自己决定调不调」:传统自动化是人写死调用顺序,Agent 是模型运行时动态决策。这一条是 Agent 与自动化的分水岭。
Skill(技能):工具的打法沉淀。同一个搜索工具,裸调用可能搜一次就下结论;封装成 Skill 后规定关键词策略、交叉验证、输出格式。工具解决能不能,技能解决好不好。
第二组:骨架层——循环和运行时
Agent Loop(代理循环):干活的基本节拍:接收任务 → 推理 → 调工具 → 看结果 → 再推理 → 直到完成。两个命门:反馈必须真实(假反馈会让推理越走越偏),终止必须明确(没有上限就是无限忙但无产出)。
Runtime(运行时):承载循环的执行环境。管进程、管超时、管重试、管资源配额。它不出现在产品介绍里,但生产环境的稳定性一半靠它。
Harness(脚手架):包裹模型的软件骨架——收集上下文、执行工具调用、管理循环、控制权限。同一个模型配不同的 Harness,产出差一个档次,这是各家 Agent 产品差异的真正来源。
Runtime 和 Harness 的分界:Runtime 管运行环境的基础设施,Harness 管围绕模型的编排逻辑。日常讨论里两者常被混着说,知道分界就不会被绕晕。
第三组:记忆层——状态与记忆
State(状态):单次任务执行中的数据,当前目标、进度、工具结果。任务结束就结束。
Memory(记忆):跨会话的长期信息,分两类:检索式(向量化存库,按相关性召回,RAG 是标准实现)和摘要式(定期压缩沉淀成画像档案)。记的是用户偏好、项目背景这类越攒越值钱的东西。
State 和 Memory 的时间尺度是本质区别:State 服务于这一趟任务,Memory 服务于这个用户的全部历史。
第四组:顶层概念——Agent 本身
Agent(智能体):以大模型为核心、能调用工具、接收反馈并持续完成任务的系统。注意落点是「持续完成」——不是生成一段文本,而是推进一段过程。
一个容易答错的对照题:Agent 和 Copilot 差在哪? 控制权。Copilot 是人机交替,每步人来确认;Agent 是模型接管,人只在边界处介入。自主程度不是越高越好,而是要与权限设计匹配。
速查卡本体
| 术语 | 一句话 | 一层 |
|---|---|---|
| Model | 只能说话的大脑 | 能力 |
| Tool | 模型自己决定调用的手 | 能力 |
| Skill | 工具的打法沉淀 | 能力 |
| Agent Loop | 想-做-看的基本节拍 | 骨架 |
| Runtime | 承载循环的执行环境 | 骨架 |
| Harness | 包模型的编排骨架 | 骨架 |
| State | 单次任务的账本 | 记忆 |
| Memory | 跨会话的档案柜 | 记忆 |
| Agent | 以上全部组装成的系统 | 顶层 |
怎么用这张卡
三个用法:
读文章时:遇到新词先定位它属于哪一层。大部分新词都是四层里某层的具体实现换个名字,定位到层,理解成本立降。
选型时:按层排查。健忘查记忆层,不稳定查骨架层,回答质量差查能力层。分层排查比笼统升级模型便宜得多。
面试或汇报时:用「组装」逻辑讲 Agent——大脑、手、打法、骨架、账本、档案柜,一件件装上去。这个讲法比背定义高级,因为它展示的是结构理解。
一个彩蛋式总结
如果只能记一句话,记这个版本:
Model 是大脑,Tool 是手,Skill 是肌肉记忆,Loop 是心跳,Runtime 是身体,Harness 是神经骨架,State 是账本,Memory 是档案柜——Agent 是这个完整的人。
缺哪个器官,对应哪种病,对照表都能查出来。这张卡放进脑子,Agent 领域的新词就再也不会让你卡壳了。
这波 AI 大模型的机会,你接得住吗?
又到了一年中最受期待的 “金九银十”招聘季。每年这两个月,各家大厂都会集中释放大量岗位:既有补录名额,也有核心业务扩招,对应届生来说是冲刺上岸的最后窗口,对在职的朋友而言,同样是全年最值得把握的跳槽时机。
我最近梳理了一遍大厂的招聘需求,发现今年的市场格局和往年明显不同
机会确实在,但门槛也在抬高。
先看机会端。在大模型、生成式 AI 这条赛道上,各家公司的诚意给得很足:岗位数量大幅增加,薪资水涨船高。目前中大厂的大模型相关岗位,年薪普遍能到 50W+,顶尖人才拿到百万年薪并不稀奇,不少岗位的薪酬比去年上调了 40% 左右。更难得的是,这条赛道对年龄也宽容得多——对深陷“35 岁焦虑”的程序员来说,这几乎是目前为数不多的高薪避风港。
但高薪的另一面是残酷的现实:缺人的领域,同样缺不了找不到工作的人。
原因不复杂——想进大模型领域的人非常多,可真正具备胜任能力的极少。大多数求职者的技能储备,和一线企业核心 AI 岗位的要求之间,隔着一道不小的鸿沟。
怎么补上这道鸿沟?
为了帮大家真正达到国内一线大模型岗位的用人标准,我整理了一套 【2026 最新版】AI 大模型免费学习资源,从零基础入门到项目实战、从理论体系到大厂面试,一路进阶全覆盖。所有资料已分类归档,没有杂乱内容,无套路免费分享给每一位想入局 AI 赛道的程序员和零基础小白。

1、大模型系统化学习路线
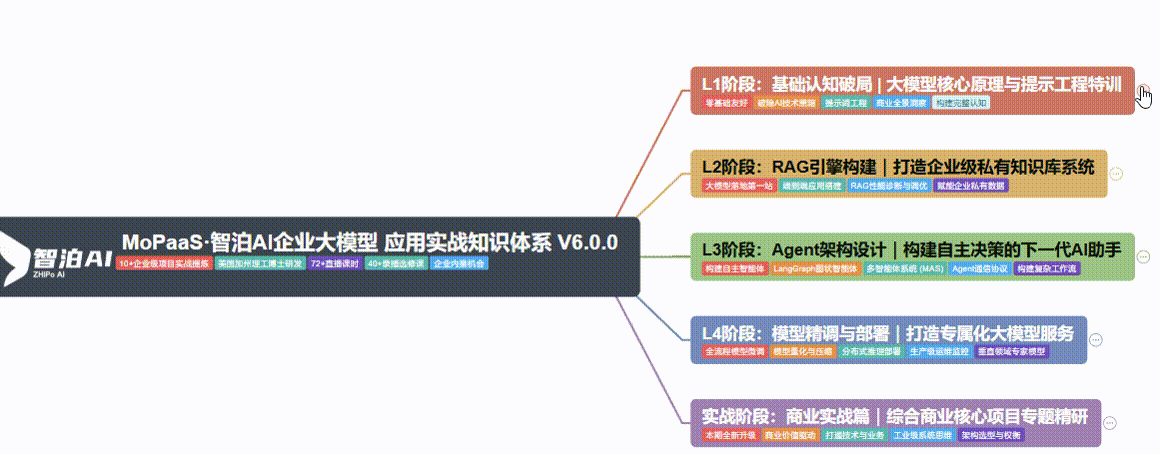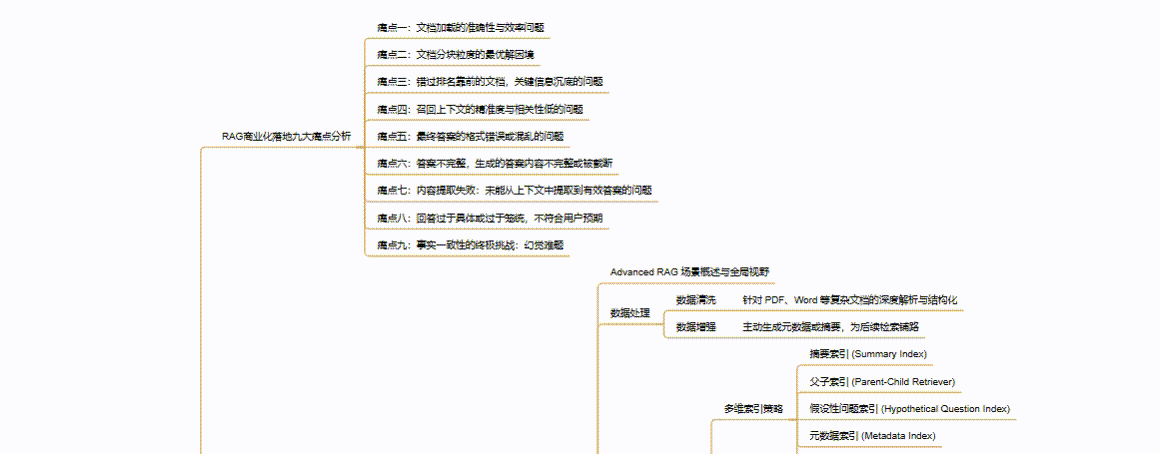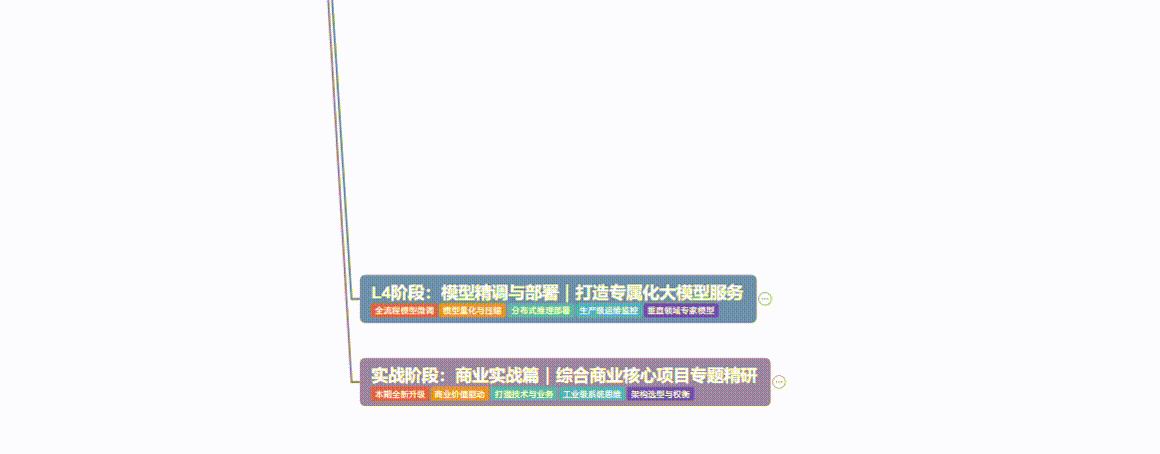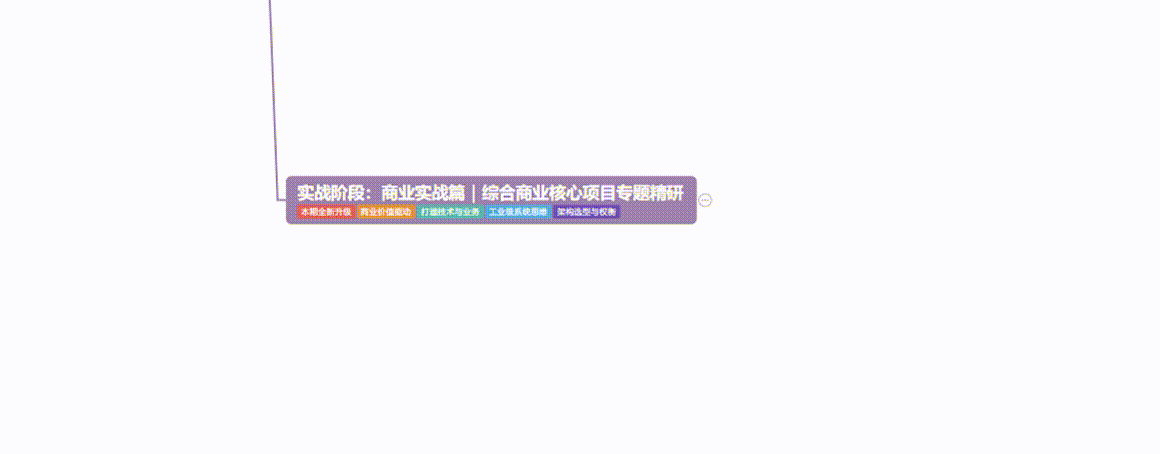
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
更多推荐

 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)