
搞懂 Agent 的执行循环,LangChain 那套架构就不难了
从一个具体问题开始
用户问:帮我查一下北京今天的天气,顺便看看适不适合出门。
普通大模型答不了。它可以编一个「北京今天晴,25 度」,但那是编的,它拿不到实时数据。
给它一个天气查询工具,情况就变了:
- 模型理解问题;
- 判断需要查天气;
- 选择天气工具;
- 拿到工具返回的结果;
- 基于结果生成回答。
这五步里,第 2 到第 4 步是一个循环。Agent 的全部复杂度,都长在这个循环上。
一、一句话定义:Agent = Model + Harness
LangChain 官方的概括就这六个字。
Harness 是围着模型搭起来的那套执行框架,负责给模型提供完成任务需要的信息、工具和执行控制。模型负责判断,Harness 负责把判断变成动作。
分清这一层,后面所有概念都有位置可放。
二、基础 Agent 只有四件套
| 组件 | 职责 | 容易搞错的地方 |
|---|---|---|
| Model | 理解、判断、选择工具、生成参数 | 它只提出调用意图,不执行 |
| Prompt | 任务说明和行为规则 | 规则靠提示词没有强制力 |
| Tools | 对外部系统的操作能力 | 工具描述写不好,模型就不会选 |
| Middleware | 控制与扩展执行过程 | 真正的硬约束应该放这里 |
关于 Prompt 有个认知要纠正:提示词只能引导,不能保证。 权限、调用次数、敏感信息这些必须严格执行的要求,靠提示词是管不住的,得靠程序中间件。
模型输出工具调用时,产物长这样:
{
  "name": "get_weather",
  "arguments": {"city": "北京"}
}
拿到这段 JSON 之后,真正去找工具、执行、把结果塞回上下文的是 Harness,不是模型。这一点想清楚,后面调 bug 会快很多。
三、Middleware:把通用逻辑从业务里剥出来
生产环境会碰到一堆和业务无关的问题:模型接口挂了怎么办、工具超时怎么办、怎么限制调用次数、怎么避免敏感信息外泄、哪些操作必须人工确认、对话太长怎么办。
这些如果都写在业务代码里,很快就会失控。所以 LangChain 提供了中间件机制,在执行过程的关键位置插入处理逻辑。
常用的几个:
| Middleware | 作用 |
|---|---|
| ModelRetryMiddleware | 模型调用失败重试 |
| ToolRetryMiddleware | 工具调用失败重试 |
| ModelCallLimitMiddleware | 限制模型调用次数 |
| ToolCallLimitMiddleware | 限制工具调用次数 |
| SummarizationMiddleware | 压缩过长的对话历史 |
| PIIMiddleware | 检测或处理敏感信息 |
| HumanInTheLoopMiddleware | 重要操作转人工审核 |
这里的价值是解耦:重试、限流、安全检查这类横切逻辑,从业务代码里彻底分离出去,配置化生效。
四、执行循环:Agent 的核心机制只有两步
不管框架多复杂,底层就是两步反复:
- Model Call:调用模型;
- Tool Execution:执行模型请求的工具。
循环直到模型认为任务完成。展开是这样:
接收问题 → 调用模型 → 判断返回结果
                          ├─ 需要工具 → 执行工具 → 结果写回 messages → 回到「调用模型」
                          └─ 不需要工具 → 生成最终回答 → 结束
四个关键点,也是四个常见故障点:
- 谁决定停:模型判断不需要工具时停。所以必须在外面加最大步数,防止它绕圈。
- 结果怎么写回:工具结果要写进 messages,模型下一轮才看得见。写错位置,模型就「失忆」。
- 上下文怎么控:轮次多了上下文会爆,需要汇总或裁剪。
- 错误怎么处理:工具失败要如实回填,不能静默吞掉,否则模型会基于「成功」的假象继续推理。
五、三个容易混的状态概念
Agent 不只要执行,还要存信息、传参数、必要时恢复现场。三个概念分工很清楚:
State:这次执行的状态。 默认是 AgentState,核心字段是 messages,里面依次是用户消息、模型的工具调用请求、工具返回结果、模型最终回答。新消息是追加而不是覆盖,靠的是框架里的 reducer 机制。
Runtime Context:本次运行的参数。 用户 ID、权限、租户、功能开关这类东西。它和 State 的区别在于:State 跨轮次持久,Context 只在一次调用内有效且不可变,传参方式是依赖注入。
Checkpointer:把状态存下来。 同一个 thread_id 的多次调用可以接着上一次的状态继续。要注意它负责的是线程级状态,不等于长期记忆;InMemorySaver 只适合本地测试,重启就没了。
一句话区分:State 是共享记忆,Context 是本次的工具包,Checkpointer 是存档点。
六、结构化输出:让结果能被程序用
自然语言的回答给人看很友好,给程序用就很难受。所以需要固定格式:
- 用 Pydantic、Dataclass 或 TypedDict 定义输出结构;
- 创建 Agent 时通过 response_format 指定;
- 调用结束后从 structured_response 里取结果。
适合的场景很明确:存数据库、返给前端、交给下一个程序处理。它是可选能力,不参与执行循环。
七、从基础 Agent 到 Deep Agents
基础四件套能覆盖大部分单点任务,但复杂任务会撑不住。比如「研究一个行业并写一份报告」,可能要拆子任务、搜大量资料、加载不同领域知识、保存中间结论、多 Agent 分工。
这时候需要更高一层的 Harness,主要多出六项能力:
| 能力 | 解决什么 |
|---|---|
| Planning | 把复杂任务拆成步骤并跟踪 |
| Skills | 按需加载专业知识和规范 |
| Memory | 跨会话保存事实性信息 |
| Subagents | 把任务委派给独立子 Agent |
| Filesystem | 用文件管理资料与中间产物 |
| Context Management | 控制上下文规模 |
其中两个最容易理解错:
Skills 不是一次性全加载。 启动时只给技能描述,任务需要时才读完整说明,这样既不炸上下文,又能扩展专业能力。
Subagents 是上下文隔离。 子 Agent 默认只拿到被委派的任务,不继承主 Agent 的全部历史。好处是专注,同时大量中间搜索结果不会堆到主上下文里。
八、LangChain、LangGraph、Deep Agents 怎么放
这三个不是替代关系,是层次关系:
| 层次 | 提供什么 | 什么时候用 |
|---|---|---|
| LangChain | 模型、提示词、工具、Agent、中间件等基础组件 | 绝大多数应用的底座 |
| 基础 Agent | create_agent 快速搭出能循环调工具的 Agent | 单点任务、实时查询 |
| LangGraph | 图执行:State、Node、Edge、条件边、存档 | 需要精细控制流程 |
| Deep Agents | 在 LangChain 与 LangGraph 之上封装的完整 Harness | 规划、技能、记忆、多 Agent 协作 |
判断标准很实用:步骤固定的,别用 Agent,用普通程序或工作流;步骤要动态决定的,用基础 Agent;还要规划、长期运行、多 Agent 协作的,再上 Deep Agents。
收尾
学 LangChain Agent,真正要抓住的只有一句:
调用模型 → 判断是否调工具 → 执行工具 → 结果写回 → 继续判断 → 结束。
四件套是这句话的配置项,状态管理是这句话的记忆,中间件是这句话的护栏,Deep Agents 是这句话在复杂任务上的加强版。
循环想通了,剩下的都是填参数。
这波 AI 大模型的机会,你接得住吗?
又到了一年中最受期待的 “金九银十”招聘季。每年这两个月,各家大厂都会集中释放大量岗位:既有补录名额,也有核心业务扩招,对应届生来说是冲刺上岸的最后窗口,对在职的朋友而言,同样是全年最值得把握的跳槽时机。
我最近梳理了一遍大厂的招聘需求,发现今年的市场格局和往年明显不同
机会确实在,但门槛也在抬高。
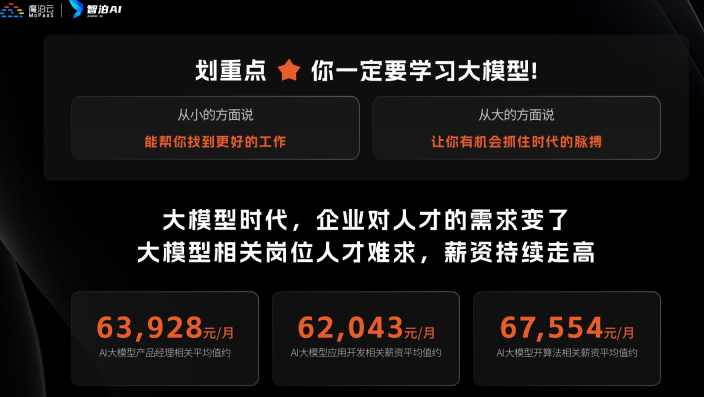
先看机会端。在大模型、生成式 AI 这条赛道上,各家公司的诚意给得很足:岗位数量大幅增加,薪资水涨船高。目前中大厂的大模型相关岗位,年薪普遍能到 50W+,顶尖人才拿到百万年薪并不稀奇,不少岗位的薪酬比去年上调了 40% 左右。更难得的是,这条赛道对年龄也宽容得多——对深陷“35 岁焦虑”的程序员来说,这几乎是目前为数不多的高薪避风港。
但高薪的另一面是残酷的现实:缺人的领域,同样缺不了找不到工作的人。
原因不复杂——想进大模型领域的人非常多,可真正具备胜任能力的极少。大多数求职者的技能储备,和一线企业核心 AI 岗位的要求之间,隔着一道不小的鸿沟。
怎么补上这道鸿沟?
为了帮大家真正达到国内一线大模型岗位的用人标准,我整理了一套 【2026 最新版】AI 大模型免费学习资源,从零基础入门到项目实战、从理论体系到大厂面试,一路进阶全覆盖。所有资料已分类归档,没有杂乱内容,无套路免费分享给每一位想入局 AI 赛道的程序员和零基础小白。
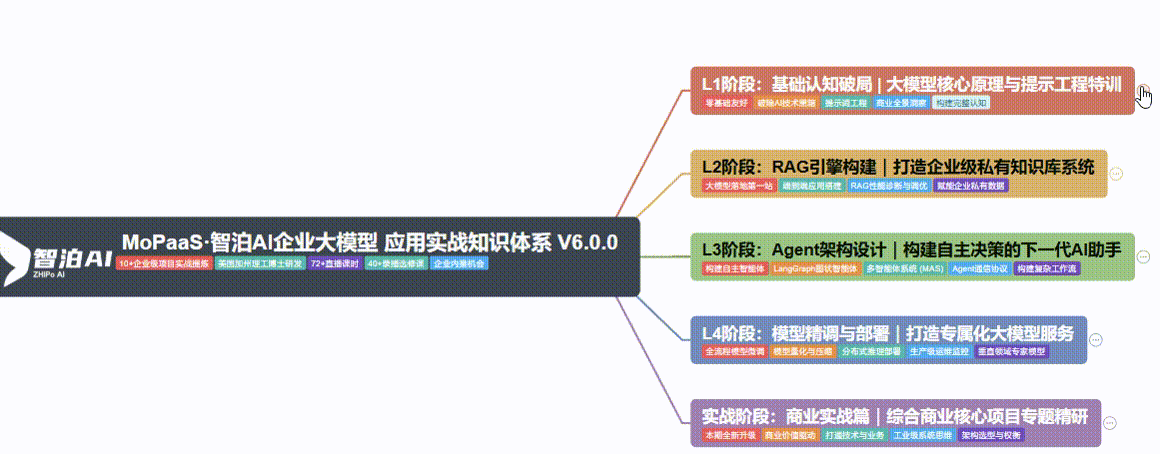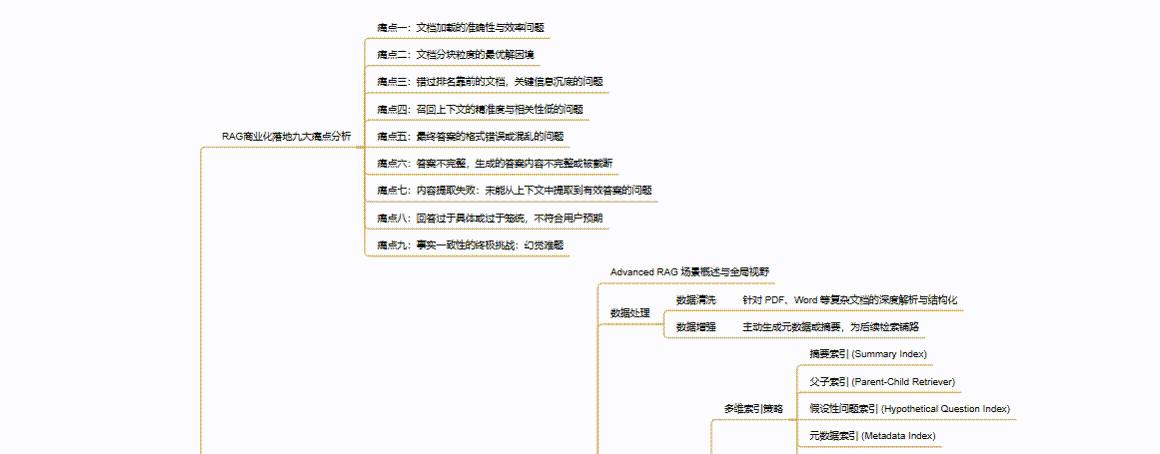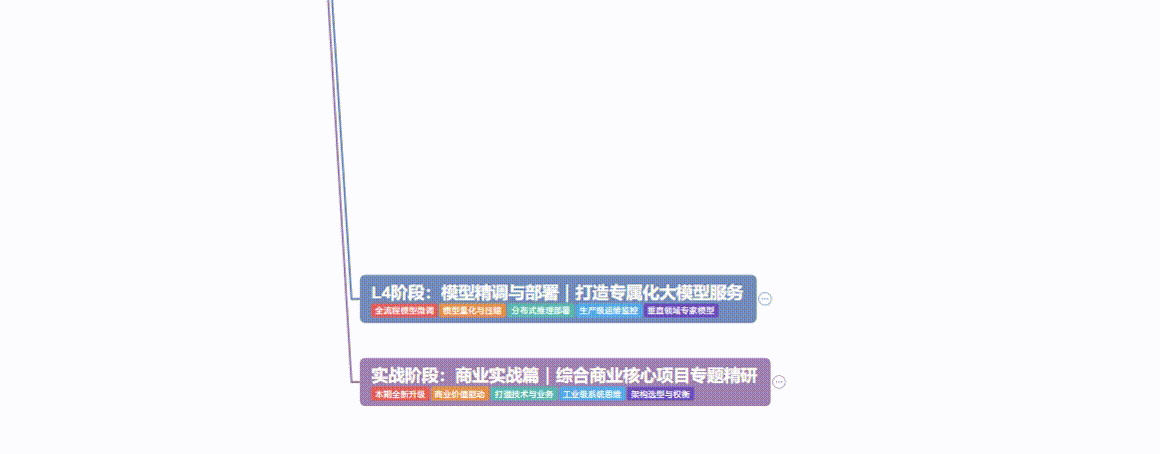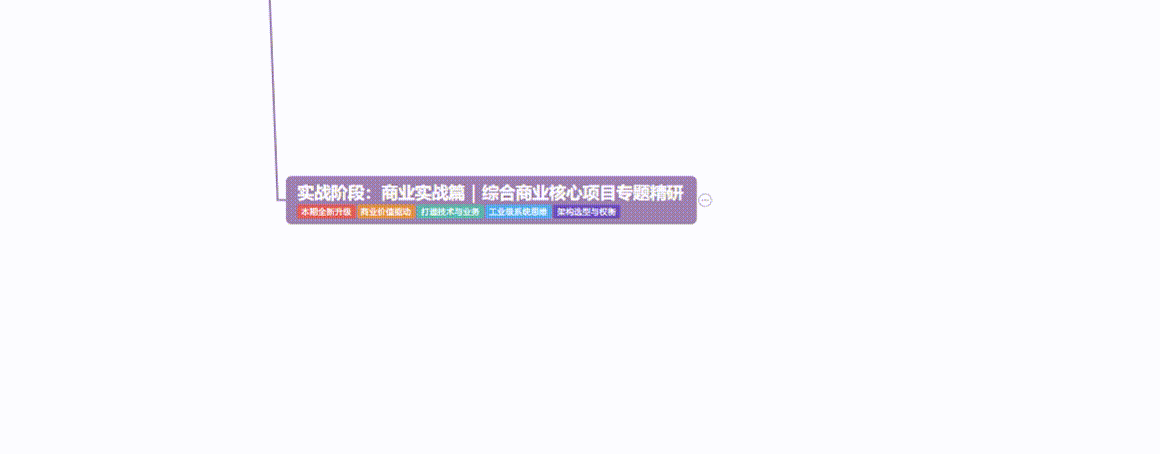
1、大模型系统化学习路线
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
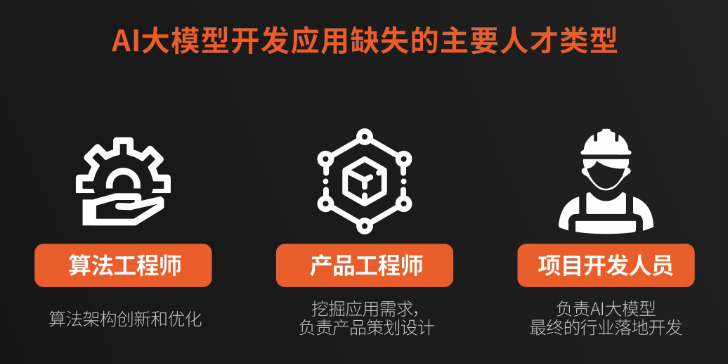
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、这些资料真的有用吗?
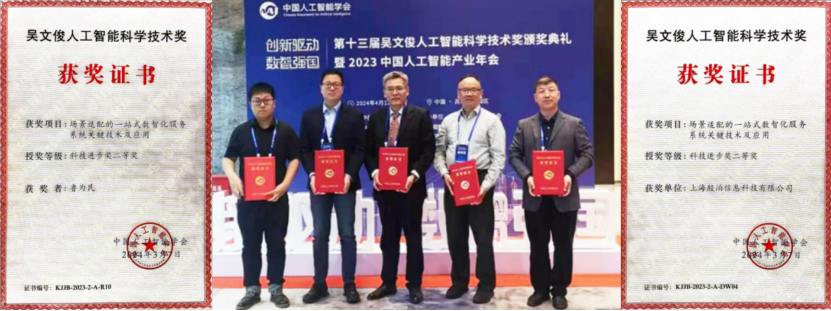
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
更多推荐


 1
 0
- 0


 已为社区贡献5条内容

所有评论(0)