
小白程序员必看:收藏这份Transformer学习指南,轻松入门大模型
本文以图文并茂的方式详细解析了Transformer模型的内部结构和工作原理,从整体架构到具体细节,包括编码器和解码器的组件、自注意力机制、多头注意力、位置编码等关键概念。通过实例和可视化解释,帮助读者理解Transformer如何并行处理序列数据,以及如何通过注意力机制捕捉词间依赖关系。此外,还介绍了模型的训练过程、损失函数和常见的解码策略,为想要学习大模型的读者提供了入门级的指导。
Transformer 来自论文 Attention is All You Need,官方 TensorFlow 实现见 Tensor2Tensor;Harvard NLP 组提供了 PyTorch 注释版。下面我们逐步拆开它的内部结构。
- 从高处俯瞰整个模型
先把 Transformer 当成一个黑盒:以机器翻译为例,喂它一句法语,它吐出一句英语。

把外壳掀开,里面其实分成两部分:一组编码器(Encoders)和一组解码器(Decoders),两者通过中间通道相连。

编码端是若干层编码器堆叠而成,原论文堆了 6 层(数字 6 没有特别含义,可以换);解码端同样堆相同数量的解码器。

每个编码器的结构都一样(但权重不共享),内部由两个子层组成:

- 自注意力层(Self-Attention):
编码某个词时,让模型同时去看输入句中其他词,从中捕捉依赖关系。
- 前馈神经网络(Feed-Forward):
对每个位置独立施加同一份前馈网络。
解码器除了拥有这两层,在它们中间还多了一层编码器-解码器注意力(Encoder-Decoder Attention),作用类似 seq2seq 模型里的 attention,让解码器去关注输入序列中相关的位置。

- 把张量画进流程图
下面我们看数据本身是怎样在这些组件之间流动的。和大多数 NLP 任务一样,第一步是把每个词通过词嵌入变成向量。

每个词被嵌入为长度 512 的向量,图中用方框表示。
词嵌入只在最底层编码器输入端做一次。所有编码器对外的契约其实是一致的:接收一组长度为 512 的向量列表。最底层接收的是词向量,而上面每一层接收的,是它正下方那一层的输出。这个列表的长度是个超参数,通常取训练集中最长句子的长度。
嵌入完成后,每个词向量都会先后经过编码器的两个子层:

关键性质:每个位置的词在编码器内部走自己独立的一条路径。自注意力子层里这些路径之间存在依赖(每个位置都要看别的位置);但到了前馈子层,各位置之间彼此独立,因此可以完全并行计算。这是 Transformer 训练比 RNN 快得多的根本原因之一。
- 编码器里的数据流
下面用更短的句子做例子,看看一个编码器内部到底发生了什么。

每个位置的词向量都先穿过自注意力,再穿过前馈网络(每个位置独立通过同一份前馈网络)。
- 自注意力(高层直觉)
"自注意力"这个词第一次听可能很玄乎,作者本人也是读了 Attention is All You Need 论文才第一次接触。下面用一个例子建立直觉。
假设我们要翻译这句话:
“The animal didn’t cross the street because it was too tired”
句中的 it 指代什么?是 street 还是 animal?人一眼就看出来是 animal,但让算法自己判断并不容易。
当模型处理 it 这个词时,自注意力机制能帮它把 it 和 animal 在表示上关联起来。模型每处理一个位置,自注意力都会让它"环顾"输入序列中的其他位置,从中找出对当前位置有帮助的信息。
如果你熟悉 RNN,可以这样类比:RNN 用隐状态把"已经处理过的词"的信息传给当前词;而 Transformer 通过自注意力把"序列中所有相关词"的理解一次性"烤"进当前词的表示里。

当第 5 层(最顶层)编码器处理 “it” 时,注意力机制把一部分焦点放在 “The Animal” 上,并将其表示融入到 “it” 的编码中。
感兴趣可以去 Tensor2Tensor 提供的 Notebook 加载 Transformer 模型并交互式查看注意力可视化。
- 自注意力(向量级细节)
先用向量讲清楚自注意力怎么算,再扩展到矩阵实现。
第一步:构造 Query / Key / Value 三个向量
对每个输入向量(词嵌入),分别乘上三个训练得到的权重矩阵 W^Q、W^K、W^V,得到对应的 Query 向量 q、Key 向量 k、Value 向量 v。
注意:这三个新向量的维度比词嵌入要小——论文中嵌入是 512 维,q/k/v 是 64 维。这并不是必须的,而是为了让多头注意力的总计算量大致保持不变。

把 x1 乘上 W^Q 矩阵就得到对应的 q1(Query 向量)。每个词都得到一组 query/key/value 投影。
怎么直观理解 query / key / value?它们是三种"角色"。可以想象在做信息检索:query 是当前词发出的"查询",每个 key 像是其他词挂在外面的"标签",把 query 和各个 key 做点积就得到匹配分数;分数越高,意味着对应那个词的 value(实际内容)应该被更多地拿回来。继续往下看具体计算就更清楚了。
第二步:计算分数
假设我们正在为第一个词 Thinking 计算自注意力。我们要给输入句中每个词打一个"分数",决定编码 Thinking 时该有多关注其他位置。
分数 = 当前词的 query 向量与被打分词的 key 向量的点积。处理位置 1 时:
score₁ = q1 · k1,score₂ = q1 · k2,依此类推。

第
三、四步:缩放 + Softmax
把每个分数除以 √d_k = √64 = 8(key 向量维度的平方根),目的是让梯度更稳定。然后再过一层 Softmax,把所有分数归一化成正数且加起来等于 1。

这个 softmax 分数就是"在当前位置上,每个词应该被表达多少"。当前位置自己的分数通常最高,但有时把注意力分给一些相关的其他词更有用。
第
五、六步:加权求和得到输出
- 第五步:
把每个 value 向量乘上对应的 softmax 分数。直觉是——保留我们想关注词的内容(乘以接近 1 的数),淡化无关词(乘以例如 0.001 这样很小的数)。
- 第六步:
把这些加权后的 value 向量求和,得到当前位置(这里是第一个词)的自注意力输出向量 z1。

这就完成了一个位置上的自注意力计算。这个输出向量接下来会被送进前馈网络。但实际工程实现里,我们不会逐位置算,而是一口气用矩阵把所有位置一起算了,下面就是矩阵版本。
- 自注意力的矩阵实现
第一步:算出 Q、K、V 三个矩阵
把所有词的嵌入按行拼成矩阵 X,然后分别乘上训练好的 W^Q、W^K、W^V,得到 Q、K、V 三个矩阵。

X 矩阵每行是一个词。注意嵌入维度(512,图中 4 格)和 q/k/v 维度(64,图中 3 格)的差别。
最后一步:一个公式搞定
因为我们直接用矩阵,第二到第六步可以浓缩成一个公式:

矩阵形式的自注意力计算公式:Z = softmax( Q·Kᵀ / √d_k ) · V
- 多头注意力(Multi-Head Attention)
论文进一步对自注意力做了改进,引入了"多头"机制。它带来两个好处:
- 扩展模型关注不同位置的能力。
前面的例子中,z1 虽然包含了一点其他词的信息,但很可能被自己这个词主导。多头让模型有更多"机会"去关注不同的位置,比如句子 “The animal didn’t cross the street because it was too tired” 中,知道 it 指代谁就很关键。
- 提供多个"表示子空间"。
一组 Q/K/V 权重矩阵是一个"头",论文里用了 8 个头,所以每个编码器/解码器都有 8 套 Q/K/V 权重。每套都随机初始化,训练完后会把输入投影到 8 个不同的表示子空间里。

多头注意力为每个头维护一组独立的 Q/K/V 权重矩阵,把 X 分别投影出多组 Q/K/V。
把前面那一套自注意力流程跑 8 遍(每遍用不同的权重),就会得到 8 个不同的输出矩阵 Z:

但下游的前馈层只接受单个矩阵,怎么办?做法是:把 8 个 Z 在维度上拼接起来,再乘上一个额外的权重矩阵 W^O,把它压回到合适的维度。

多头自注意力大体就这些步骤,矩阵确实很多。把所有步骤画在一张图里复盘一下:

讲完了多头机制,再回到 it 的例子,看不同的注意力头各自在关注什么:

编码 “it” 时,一个头主要关注 “the animal”,而另一个头主要关注 “tired”——某种意义上,模型对 “it” 的表示同时融入了 “animal” 和 “tired” 的信息。
但如果把所有 8 个头一起画出来,可视化就会变得很难解读:

- 位置编码:让模型感知顺序
到目前为止,我们描述的模型还差一个东西:它对词的先后顺序毫无感知。RNN 天然按顺序处理,所以位置信息隐含在递归过程中;但 Transformer 是并行处理所有位置的,必须显式地告诉它"谁在前、谁在后"。
解决方法是——给每个输入嵌入向量再加上一个位置编码向量(Positional Encoding)。这些向量遵循一种特定的模式,模型在训练后就能据此推断每个词的位置或词与词之间的距离。直觉是:把这些位置信息加进嵌入后,再投影成 Q/K/V 做点积时,向量之间就能体现"有意义的距离"。

为了让模型感知词序,我们额外加上位置编码向量——它的取值遵循特定的数学模式。
假设嵌入维度只有 4,真实的位置编码可能长这样:

嵌入维度为 4 时位置编码的真实例子。
那位置编码的"模式"长什么样?下图中每一行就是一个位置上对应的位置编码向量——第 1 行加给序列中第 1 个词,第 2 行加给第 2 个词,依此类推。每行有 512 个值,每个值都在 -1 到 1 之间,颜色编码后能看出明显的图案。

20 个词(行)× 512 维(列)的真实位置编码。可以看到从中间一分两半:左半边由 sine 函数生成,右半边由 cosine 函数生成,再拼接起来构成完整的位置编码向量。
具体公式见原论文 3.5 节,参考实现可看 Tensor2Tensor 仓库里的 get_timing_signal_1d()。这并不是唯一的位置编码方法,但它有一个好处——能外推到训练时未见过的更长序列。
2020 年 7 月勘误(作者补充):上面这张图展示的是 Tensor2Tensor 实现里的位置编码方式(左右拼接 sin/cos)。论文里的写法略有不同,是把 sin 和 cos 两路信号交错排列而不是直接拼接。下图展示了论文版本的样子(生成代码在此):

- 残差连接与层归一化
编码器内部还有一个细节值得说:每个子层(自注意力 / 前馈网络)外面都包了一层残差连接(residual connection),并在残差相加后再做一次层归一化(Layer Normalization)。

如果把自注意力的向量流和层归一化操作画出来,看起来是这样:

解码器的子层也是同样套路。如果想象一个由 2 层编码器 + 2 层解码器组成的精简版 Transformer,整体结构大致是这样:

- 解码器一侧
编码端的概念都讲清楚了,解码器的组件其实和编码器几乎一样——下面看它们如何协同工作。
编码器先处理整个输入序列,最顶层编码器输出会被转换成两个矩阵 K 和 V,作为"编码端记忆"提供给每一层解码器中的 encoder-decoder attention 子层使用。借助这两个矩阵,解码器在生成时能持续关注输入序列里的相关位置:

编码阶段结束后进入解码阶段,每一步解码器会输出目标序列里的一个词(这里就是英文翻译里的下一个词)。
之后这个过程不断重复,直到生成一个特殊的"句末"标记 <end of sentence>,表示翻译结束。每一步的输出会作为下一时间步最底层解码器的输入。和编码器一侧一样,对解码器输入也要做嵌入并加上位置编码,以指示词的位置。
- 解码器在生成第 t 个位置时只能看到自己已经生成的位置 1…t-1,不能看未来。实现方式是在 Softmax 之前把"未来位置"对应的分数设成
-inf,softmax 之后这些位置的权重就趋近于 0。 - Encoder-Decoder Attention:
结构和多头自注意力完全一样,区别在于——它的 Query 来自下一层(即解码器自身的输出),而 Key、Value 来自编码器栈最顶层的输出。这就是解码器"看输入"的通道。
- 最后的 Linear 与 Softmax 层
解码器栈输出的还是一组浮点向量,怎么把它变成一个真实的词?这就是最后的 Linear 层 + Softmax 层负责做的事情。
Linear 层是一个简单的全连接网络,把解码器输出的向量投影成一个非常长的向量,称为 logits 向量。
假设我们的模型从训练集中学到了 10,000 个不同的英文单词(“输出词表”),那 logits 向量就有 10,000 个元素,每个元素对应一个词的"得分"。
Softmax 层把这些得分变成概率(全部为正且加起来等于 1),概率最大的那个位置对应的词,就是这一时间步的输出。

从下往上看:解码器栈输出向量 → 通过 Linear 投影到 logits 向量 → Softmax 转成概率 → 取最大概率对应的词。
- 训练过程回顾
前向传播(推理)讲完了,再回头看一眼训练是怎么进行的。
未训练的模型走的就是同样一套前向流程,只不过我们手上有带标注的训练数据,可以拿模型的输出和"正确答案"做对比,再用反向传播把权重朝正确方向调整。
为了画图简单,假设我们的输出词表只有 6 个词:a、am、i、thanks、student、<eos>(句末符)。

词表是在训练之前的预处理阶段就确定好的。
定义好词表后,可以用一个长度等于词表大小的向量来表示每个词,也就是 one-hot 编码。例如表示词 am:

玩具词表的 one-hot 编码示例。
- 损失函数
假设这是训练的第一步,我们用一个最简单的样本:把法语 merci 翻译成英语 thanks。
我们希望模型输出的概率分布在 thanks 这一格上概率最高。但因为模型权重都是随机初始化的,目前它给出的分布几乎是任意的:

初始权重随机,未训练模型给出的分布是任意的;我们把它和期望的分布做差异度量,再用反向传播去调整所有权重,让输出逐步贴近期望。
怎么衡量两个概率分布的差异?最直接的就是相减;更严谨的指标是交叉熵(cross-entropy)和 KL 散度。
真实场景里我们当然不会只翻译一个词。比如输入 "je suis étudiant",期望输出 "i am a student"。这意味着我们希望模型连续输出 5 个概率分布,满足:
- 每个分布是长度为词表大小的向量(玩具例子里是 6,真实场景往往是 30,000 或 50,000);
- 第 1 个分布在
i上概率最高; - 第 2 个分布在
am上概率最高; - ……依此类推;
- 第 5 个分布在
<eos>(句末符)上概率最高。

训练样本对应的目标概率分布——我们就是让模型去逼近这组分布。
充分训练之后,我们希望模型能输出像下图那样的分布:

训练完成后,模型应当能输出我们期望的翻译。注意每个位置上其它词也会分到一点点概率——这是 softmax 的一个有用性质,对训练过程很有帮助。当然,如果这句话本来就在训练集里,泛化能力还要靠交叉验证来真正考察。
解码策略:贪婪 vs Beam Search
由于模型一次输出一个词,最简单的做法是:每一步直接选概率最大的那个词,丢掉其他。这就是贪婪解码(greedy decoding)。
更聪明一点的做法是 Beam Search——每一步保留概率最高的若干个候选(比如 2 个,记 beam_size = 2):在第 1 步保留 I 和 a 两个候选;第 2 步则分别假设第 1 个词是 I 跑一次模型,再假设是 a 跑一次,比较哪条路径整体误差更小,就把好的那条留下;不断重复。beam_size(每一步保留的候选数)和最终返回的翻译数量都是可调超参数。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
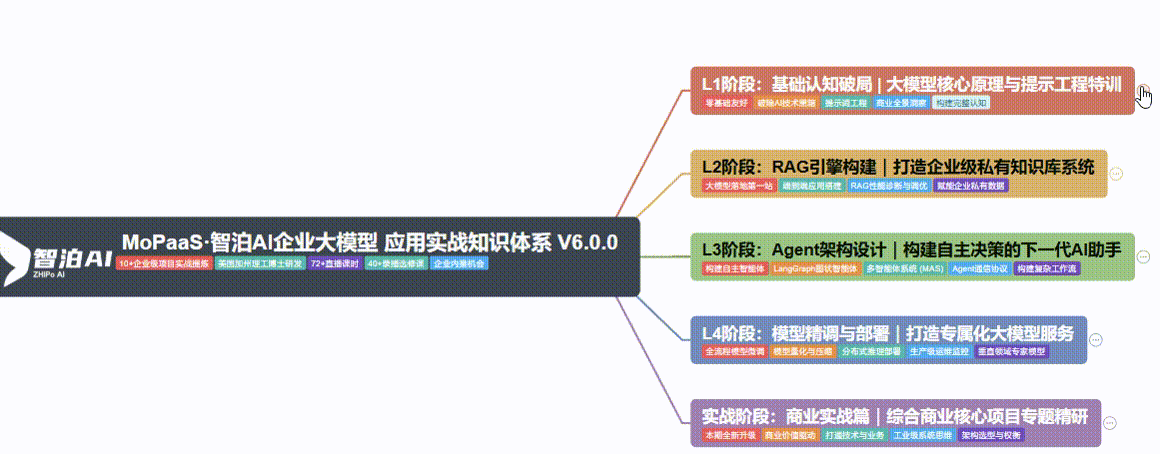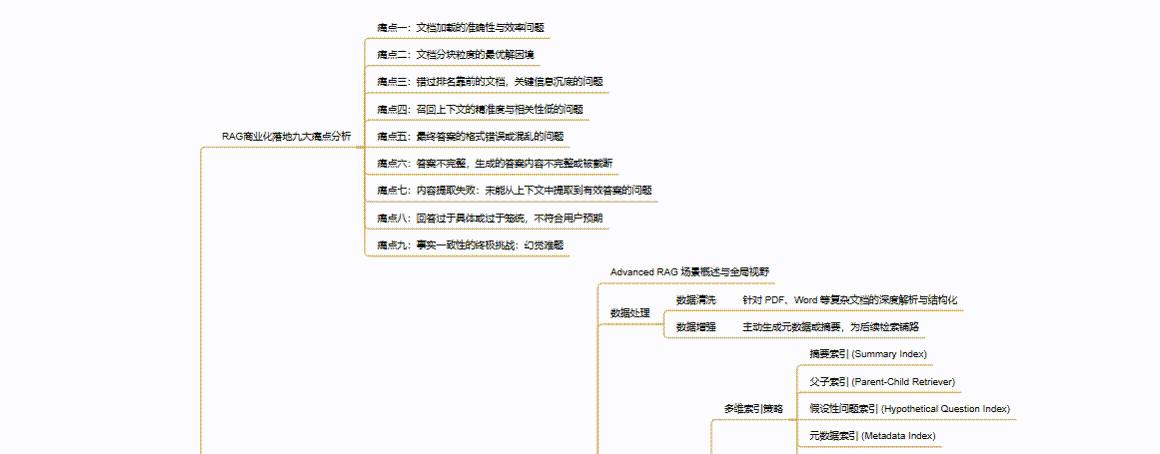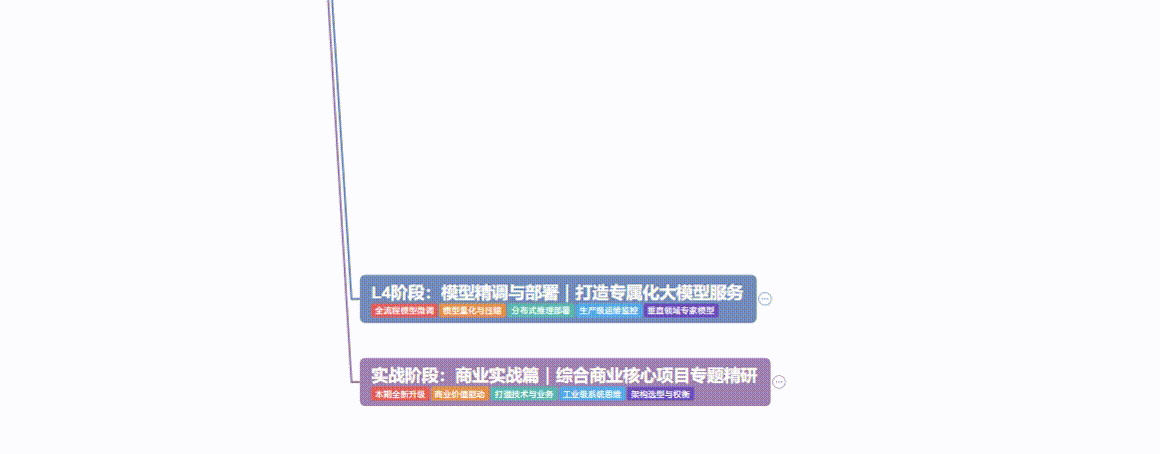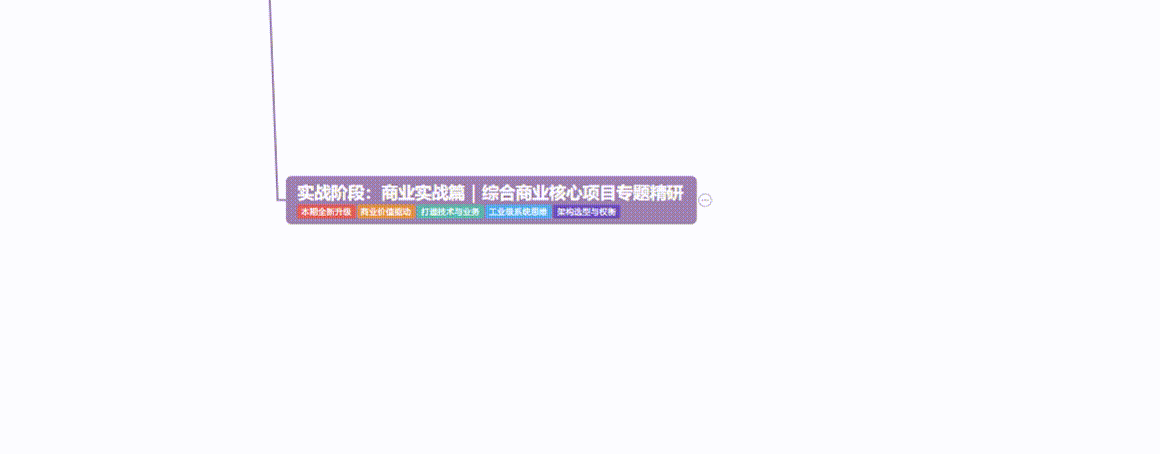
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
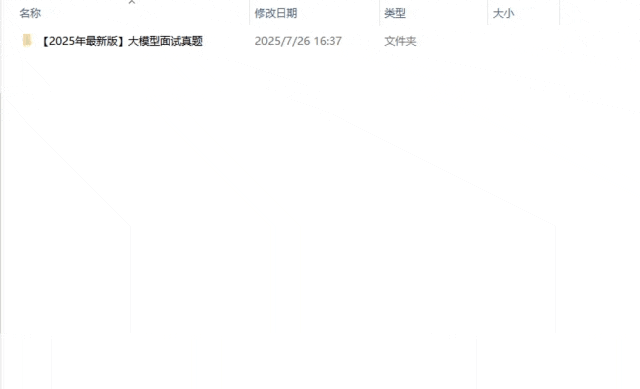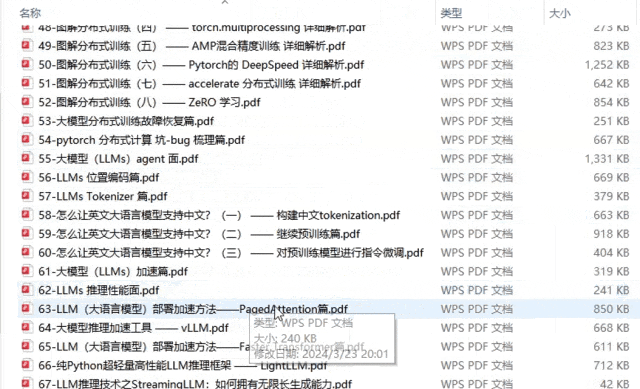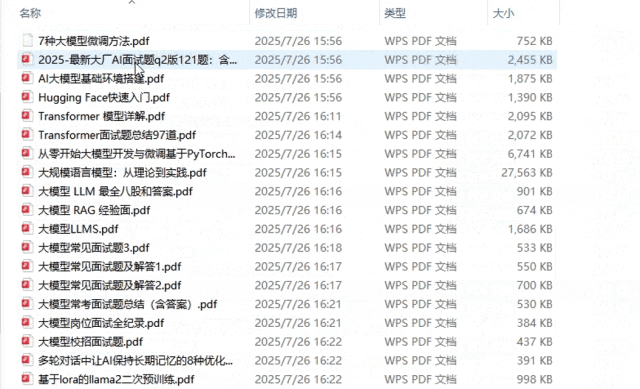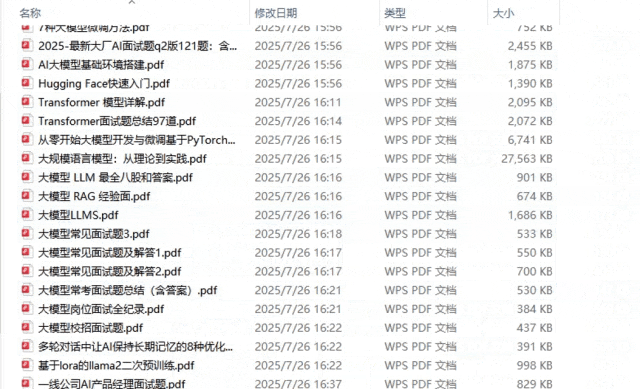
6、2026大模型大厂面试真题
7、为什么要学习大模型?
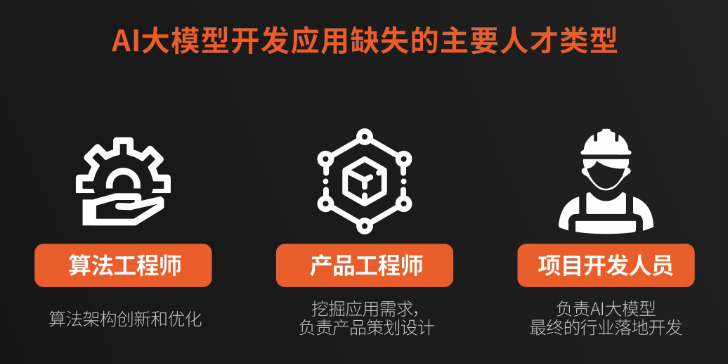
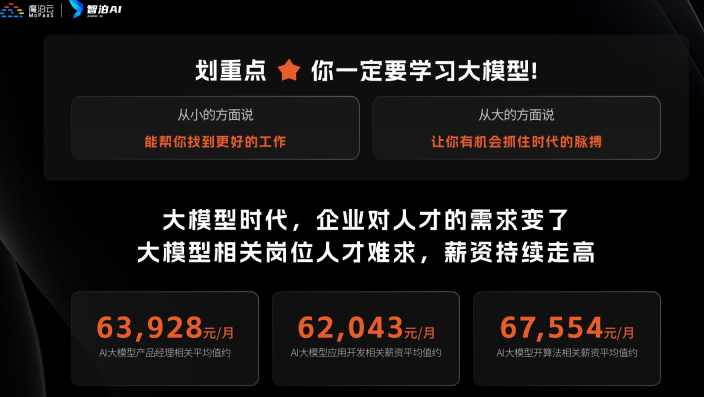
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
更多推荐


 2
 0
- 0


 已为社区贡献47条内容

所有评论(0)