
大模型总在编答案?RAG 这套「开卷考试」打法该懂了
先说一个很多人都碰见过的翻车现场
你有没有遇到过这种对话:
你问大模型一个它其实并不知道的问题,它没有说"我不清楚",而是张口就来——年份、数字、人名、参考文献,样样齐全,格式还很规范。你去核实一下,发现全部是编的。
更让人哭笑不得的是,你指出它错了,它还能继续顺着编下去,逻辑自洽、态度诚恳。
这个现象有个专门的学术名词:幻觉(Hallucination)。而RAG,就是目前工程界对付它最通用、成本最低的一套办法。
幻觉的根源,得从大模型怎么工作说起
很多人下意识把大模型当成"搜索引擎 + 总结器"——以为它内部存了一份资料库,提问时去查一查再回答。
其实不是。大模型干的活儿,本质只有一件:根据上文,预测下一个最可能出现的词。一个字一个字往外蹦,蹦完一整段,看起来就像在思考。
也就是说,它不是在"查",是在"猜"。猜对了叫博学,猜错了就叫幻觉。
导致猜错的常见原因有这么几类:
| 原因 | 表现 |
|---|---|
| 训练语料本身没有这块知识 | 冷门领域、内部资料、时效性很强的内容 |
| 训练数据里存在错误信息 | 把错的学成对的,还很自信 |
| 过拟合与知识遗忘 | 微调之后原本会的东西反而丢了 |
| 训练语料有时间截止点 | 问它最近发生的事,只能靠推测 |
明白了这一点,解决方案的思路就清楚了:既然它缺资料,那就现场给它补资料。
RAG 的核心思想:让它开卷答题
RAG 的全称是 Retrieval-Augmented Generation,中文叫检索增强生成。名字听着唬人,拆开看只有两个动作:
- Retrieval(检索):拿用户的问题,去一个专属知识库里找最相关的内容
- Generation(生成):把找到的内容当成"参考资料",连同问题一起交给大模型,让它据此作答
打个比方就很直观:
- 闭卷考试:只准用脑子里记的东西,忘了就只能瞎写 —— 这就是纯大模型
- 开卷考试:允许翻书,翻到相关章节再动笔 —— 这就是 RAG
同一道题,开卷的正确率天然高一截。而且更关键的是:开卷考生能告诉你答案出自第几页,也就是可溯源。这在企业场景里价值极大,因为"答错了能查证"比"答对了但不知道为啥"更让人放心。
检索那一环,靠什么撑起来
问题来了:这个"书"放在哪?怎么快速翻到相关的那一页?
答案是向量数据库。
传统数据库为什么不行
假设你想在 MySQL 里搜"腾讯的社交产品创新",做法是 LIKE '%腾讯%'。这就有个死穴:如果某篇文档写的是"微信事业群(WXG)近年的研发投入",语义上高度相关,但一个字都不含"腾讯",照样搜不出来。
关键词匹配只认字面,不懂意思,这是传统检索方式的根本局限。
向量数据库换了个思路
它不问"字面上像不像",而是问"意思上近不近"。做法是把文字变成数字:
- 用 Embedding 模型把每段文本压成一串浮点数(比如 768 维或 1536 维)
- 这串数字可以理解为文本在高维空间里的"坐标"
- 意思越接近的文本,坐标距离越近
- 计算两个向量的距离(常用余弦相似度),就量化了语义相似程度
这套机制天然能处理同义词、多义词、不同表述方式。更妙的是它不限于文字——图片、音频、视频同样可以 Embedding,所以现在很火的"以图搜图""音频检索"底层是同一套东西。
一次完整的 RAG 请求,链路是这样跑的
把环节串起来,用户问一句"美国是哪一年成立的",后台实际发生了什么:
- 用户的问题进入系统
- Embedding 模型把问题编码成向量
- 向量数据库执行相似度检索,先粗召回一批候选,比如 Top 100
- 重排序模型(Reranker) 对这批候选做精细打分,筛出最相关的 Top 10
- 把筛出的资料片段和原始问题拼成一个完整 Prompt
- 大模型基于这份上下文生成答案,附上引用来源
注意顺序:先查后答。资料在生成之前就已经摆在模型面前了,它自然没有多少空间去瞎编。
知识库不是天上掉下来的
向量库里存的东西需要自己构建,标准三步走:
原始文档 → ① 分片 Chunking → ② 向量化 Embedding → ③ 写入向量库
其中分片这一步最容易被忽视,但影响最大。
为什么非得切?因为一份几十页的文档,前后讲的东西可能完全不同。整篇压成一个向量,等于把好几种语义搅成一团,检索时自然对不准。
切分之后:
- 每块内部主题集中,向量表达更"纯"
- 块与块之间有区分度,匹配才有针对性
但切多大有讲究:
| 分片粒度 | 后果 |
|---|---|
| 切得太碎 | 上下文被割断,答案需要的完整信息丢了 |
| 切得太粗 | 一块里混了多个主题,检索精度下降 |
实践中通常还要做重叠(overlap),让相邻块共享一小段内容,避免关键句正好被切在边界上。
想自己搭一套,需要哪些工具
理论清楚了,动手其实不难,常用的工具箱长这样:
- 向量数据库:FAISS(轻量、本地跑,适合验证)、Milvus(分布式、生产级)、PGVector(已有 PostgreSQL 就直接用)、Chroma(上手最快)
- 编排框架:LangChain、LlamaIndex——把检索、拼接、调用这一串流程封装好,省掉大量胶水代码
- Embedding 模型:OpenAI 的 text-embedding 系列,中文场景更推荐 BGE 系列(智源开源,效果好且免费可私有化)
写在最后
回到那个最初的问题:大模型为什么爱编答案?因为它一直在闭卷猜题。
RAG 的解法谈不上多精妙,甚至有点朴素——缺什么资料,就提前把资料找出来喂给它。但就是这个朴素思路,把大模型从"看起来什么都会"变成了"确实能用在业务里"。
当然它不是银弹。检索质量、分片策略、重排模型的选择,每一个环节掉链子都会影响最终效果。但在可控成本下,RAG 依然是目前让大模型真正"靠谱"起来的最优工程路径。
这波 AI 大模型的机会,你接得住吗?
又到了一年中最受期待的 “金九银十”招聘季。每年这两个月,各家大厂都会集中释放大量岗位:既有补录名额,也有核心业务扩招,对应届生来说是冲刺上岸的最后窗口,对在职的朋友而言,同样是全年最值得把握的跳槽时机。
我最近梳理了一遍大厂的招聘需求,发现今年的市场格局和往年明显不同
机会确实在,但门槛也在抬高。
先看机会端。在大模型、生成式 AI 这条赛道上,各家公司的诚意给得很足:岗位数量大幅增加,薪资水涨船高。目前中大厂的大模型相关岗位,年薪普遍能到 50W+,顶尖人才拿到百万年薪并不稀奇,不少岗位的薪酬比去年上调了 40% 左右。更难得的是,这条赛道对年龄也宽容得多——对深陷“35 岁焦虑”的程序员来说,这几乎是目前为数不多的高薪避风港。
但高薪的另一面是残酷的现实:缺人的领域,同样缺不了找不到工作的人。
原因不复杂——想进大模型领域的人非常多,可真正具备胜任能力的极少。大多数求职者的技能储备,和一线企业核心 AI 岗位的要求之间,隔着一道不小的鸿沟。
怎么补上这道鸿沟?
为了帮大家真正达到国内一线大模型岗位的用人标准,我整理了一套 【2026 最新版】AI 大模型免费学习资源,从零基础入门到项目实战、从理论体系到大厂面试,一路进阶全覆盖。所有资料已分类归档,没有杂乱内容,无套路免费分享给每一位想入局 AI 赛道的程序员和零基础小白。
1、大模型系统化学习路线
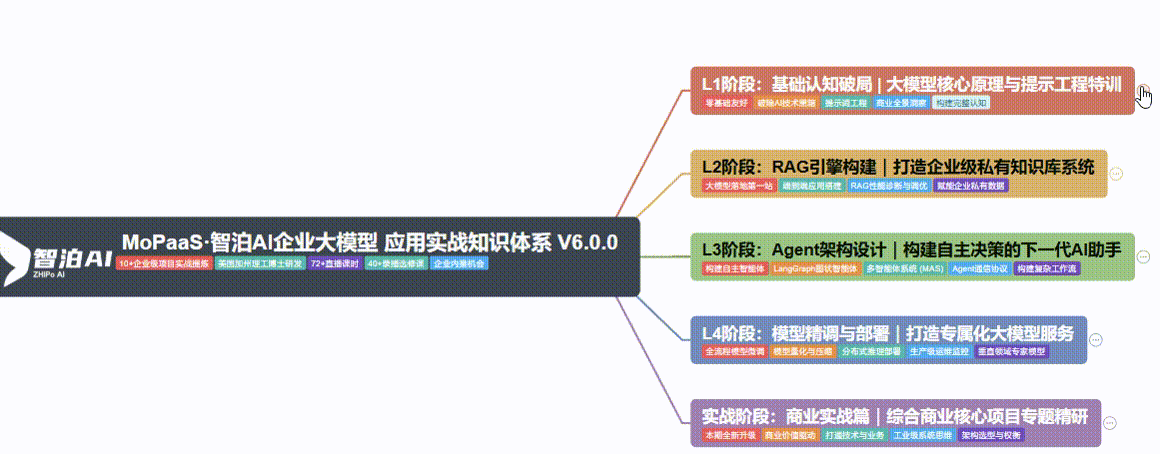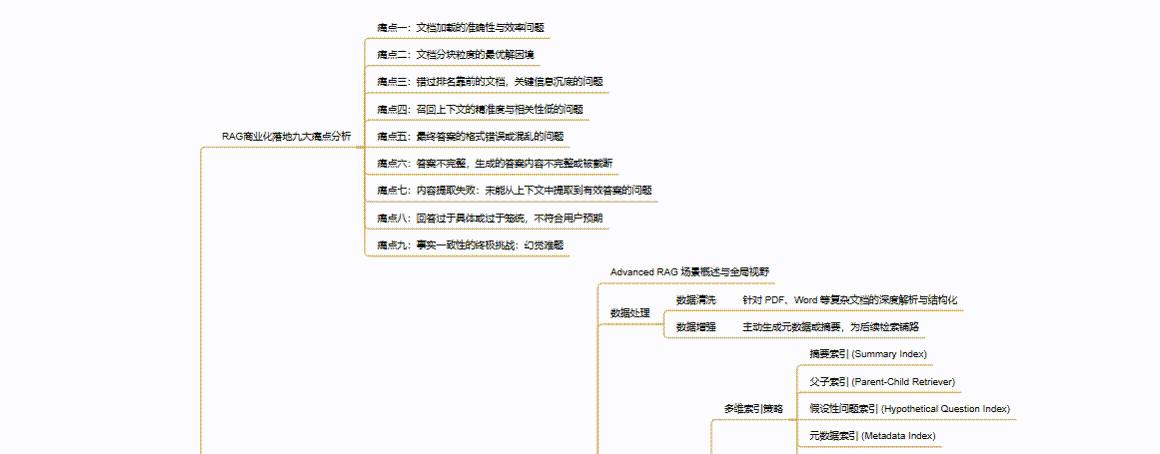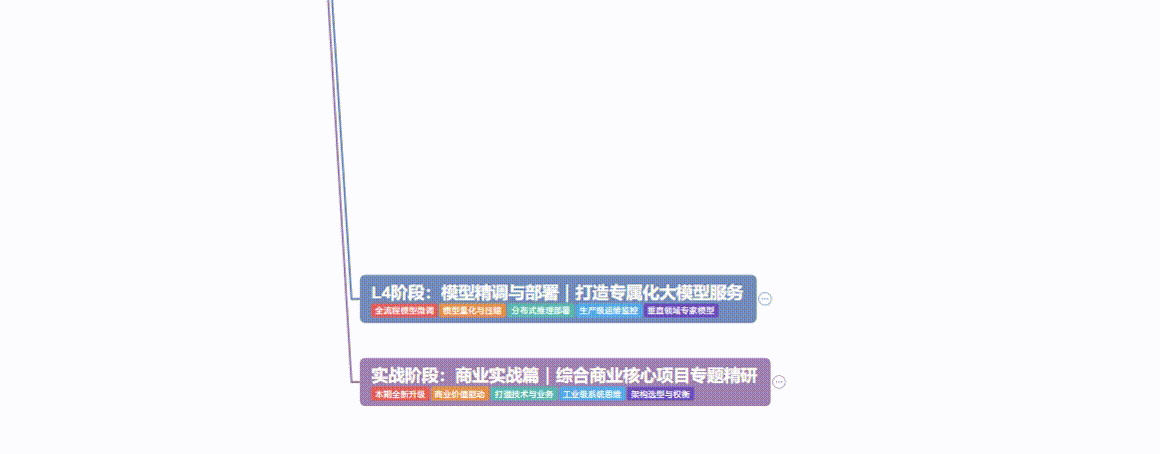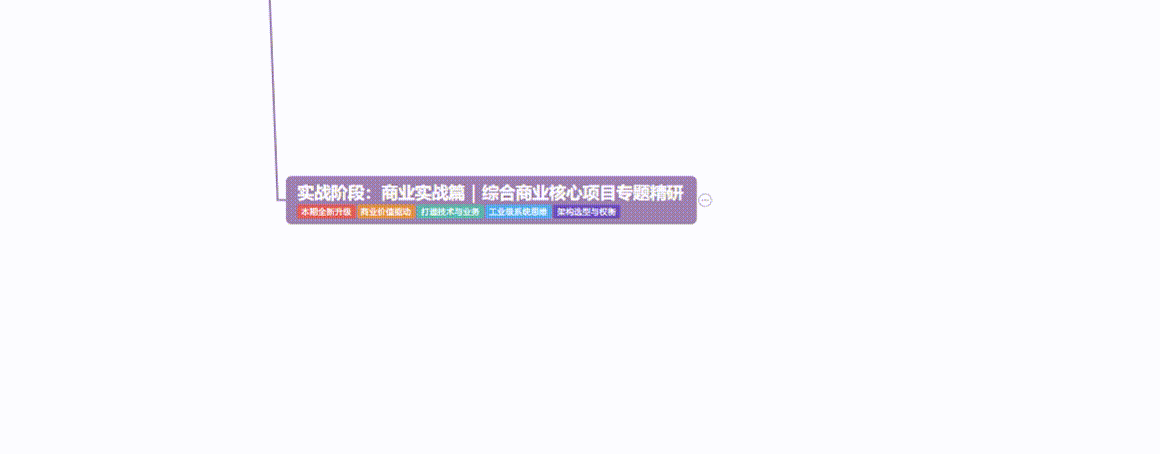
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
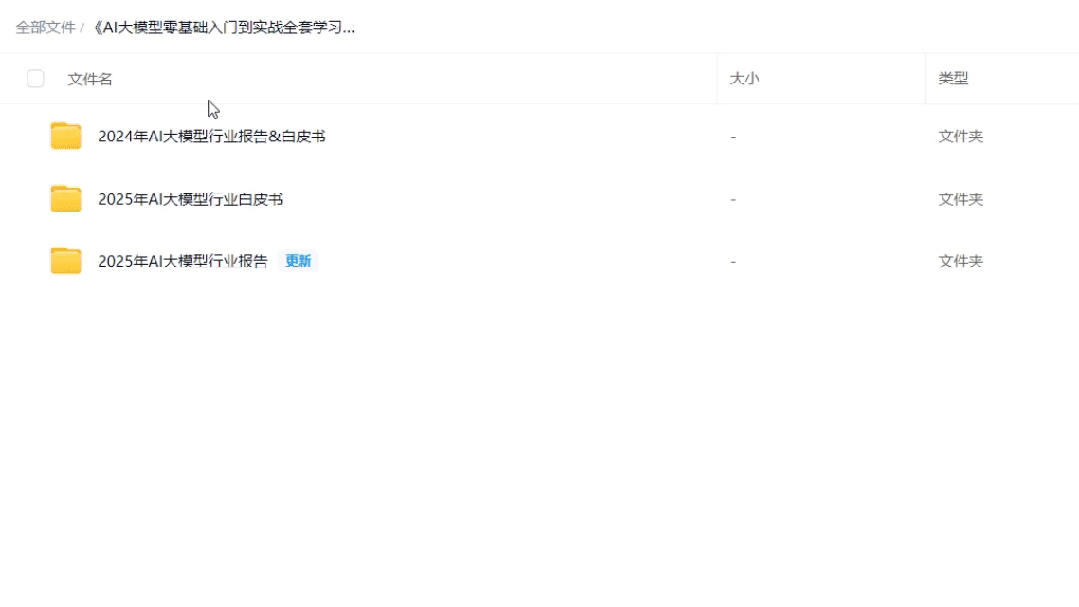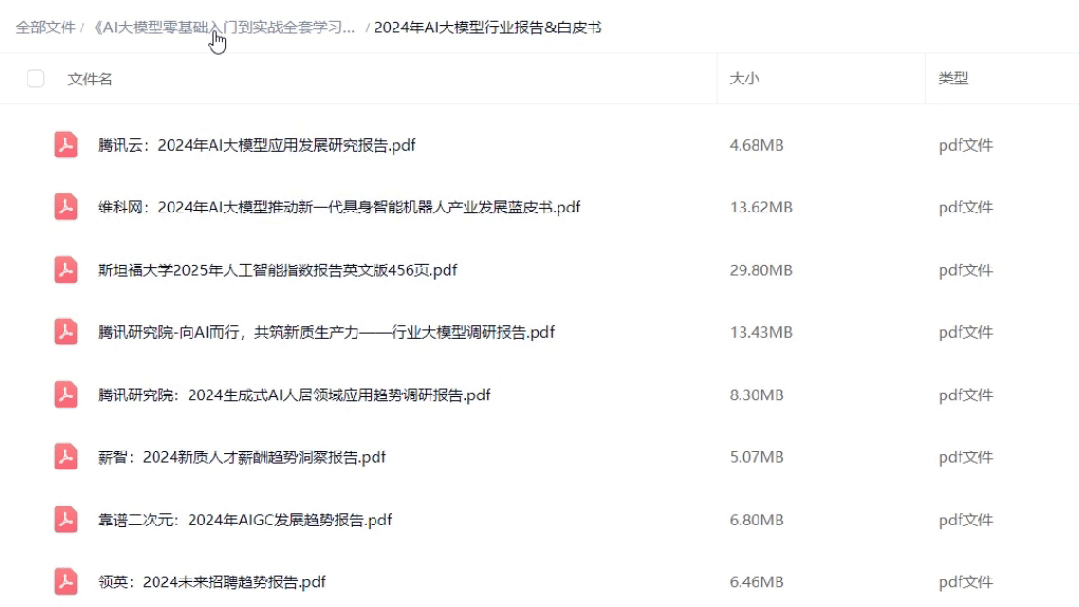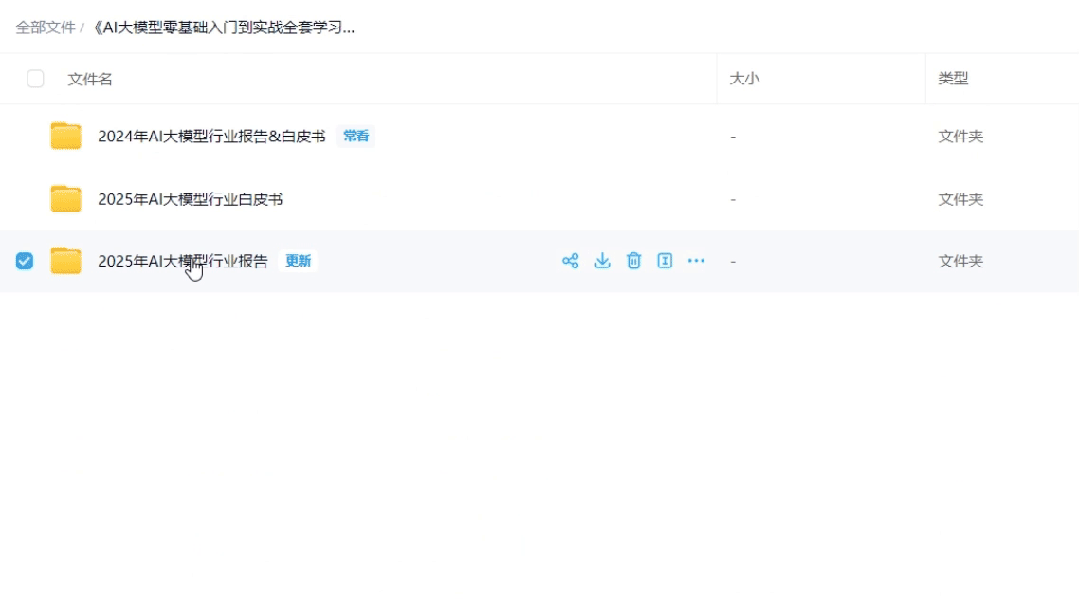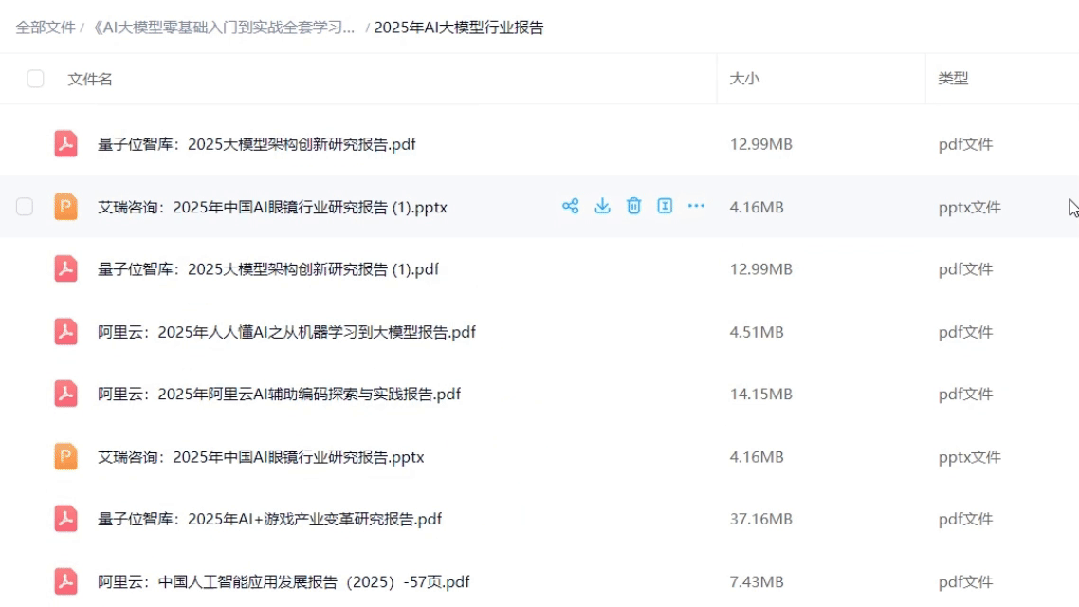
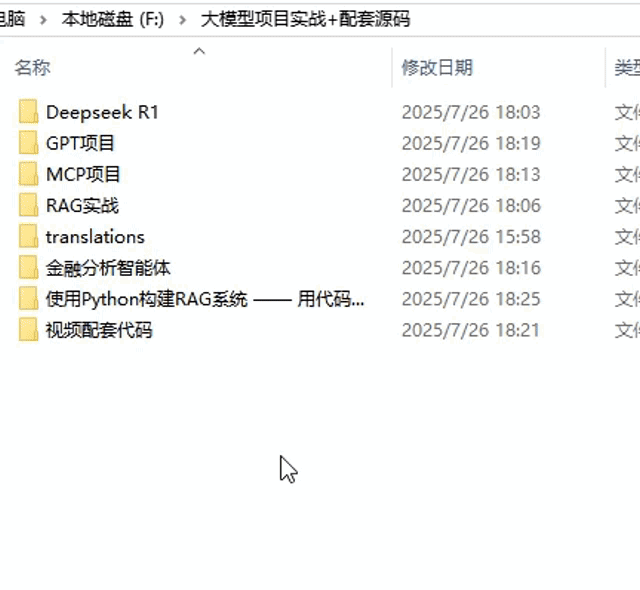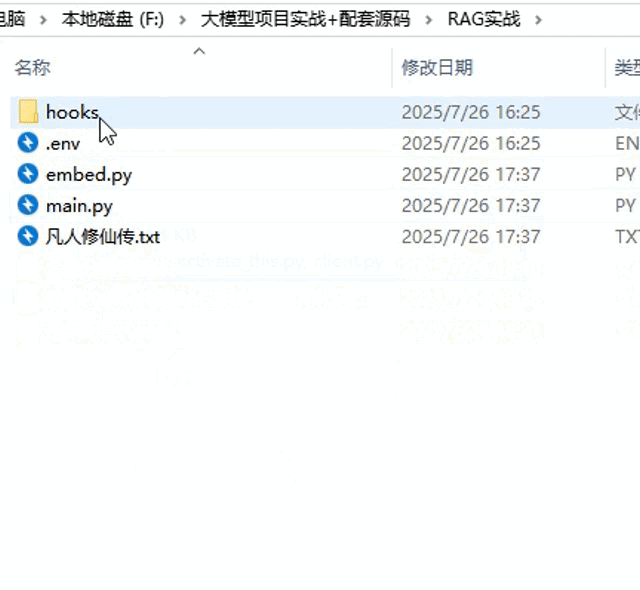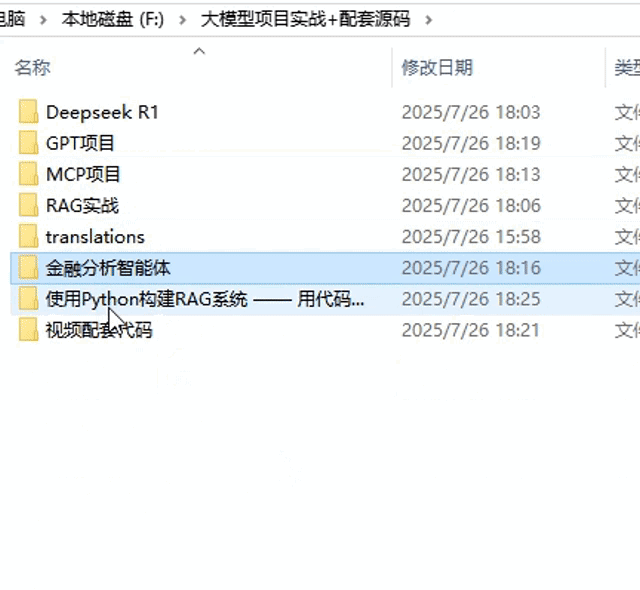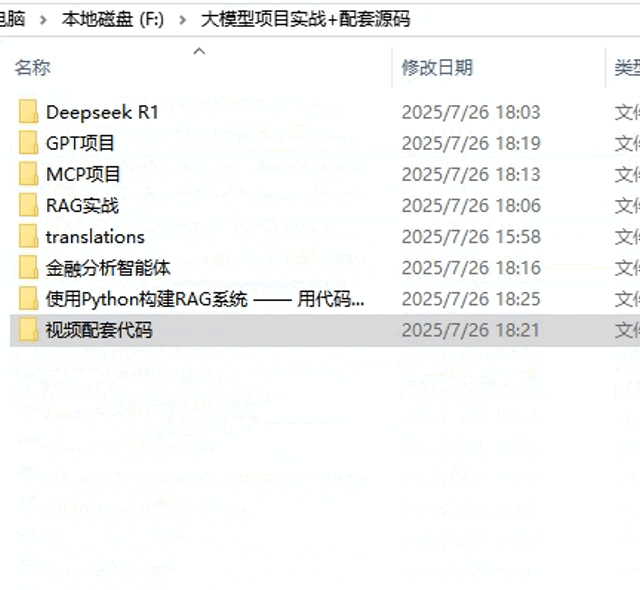
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
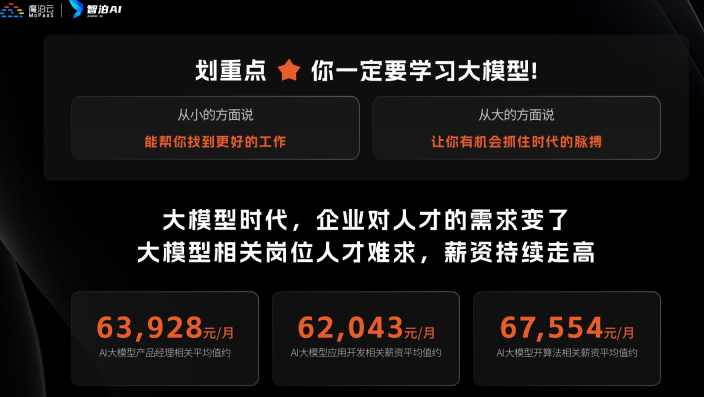
7、为什么要学习大模型?
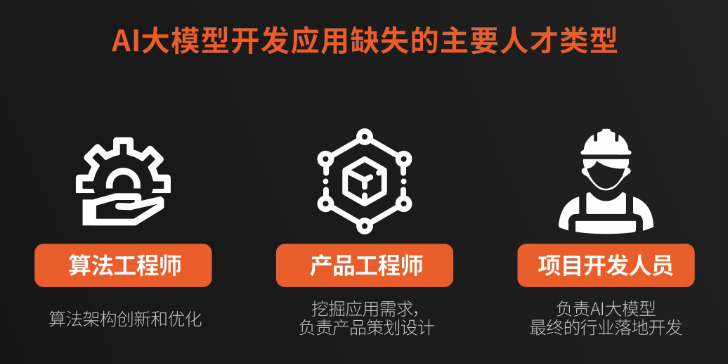
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、这些资料真的有用吗?
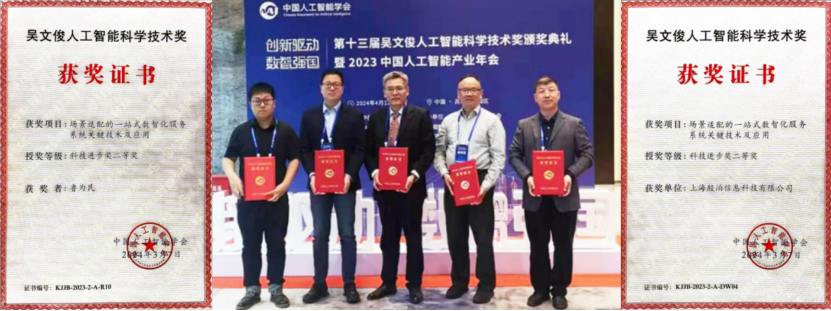
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
更多推荐

 1
 0
- 0


 已为社区贡献5条内容

所有评论(0)