
大模型学习指南:手把手教你理解 Embedding 与 RAG 系统核心,速收藏
本文深入解析了 Embedding 在 RAG 系统中的核心作用,从文本到向量的语义几何化,到 Embedding 的三种相似度度量,再到 LangChain 的 Embeddings 接口与四大部署模式,最后详细阐述了选型决策的六个维度,帮助小白和程序员快速掌握大模型的关键技术,实现高效学习和实践。
如果说 Loader 负责"读进来"、Splitter 负责"切开来",那 Embedding 就负责"变成数字"——将文本的语义压缩为高维向量,让机器能基于含义而非关键词来计算相似度。
一、Embedding 在 RAG 中的位置
先用全景图定位 Embedding 在整个 RAG 系统中的角色:

注意一个关键细节:Embedding 不是一个"一次性用完就扔"的组件。
它在 RAG 的两个阶段都会被调用:

索引阶段调用 embed_documents() 将所有 chunk 批量转为向量并入库;
查询阶段调用 embed_query() 将用户提问转为向量,再与库中的向量做相似度匹配。
这意味着:索引和查询必须使用同一个 Embedding 模型,否则两个向量空间的坐标系不同,相似度计算毫无意义。

二、Embedding 的核心原理
2.1 从文本到向量:语义的几何化
Embedding 的本质是建立一个映射函数 $$$$,将任意长度的文本映射为一个固定长度的浮点数向量:
f("机器学习是AI的核心") → [0.12, -0.34, 0.56, ..., 0.78]  # 如 768 维
f("ML is the core of AI") → [0.11, -0.32, 0.55, ..., 0.80]  # 语义相近,向量也相近
f("今天天气不错")         → [0.45, 0.23, -0.11, ..., 0.02]  # 语义不同,向量差异大

这个映射的精妙之处在于:训练过程使语义相近的文本在向量空间中距离更近。因此,比较两段文本的语义相似度,就转化为比较两个向量的数学距离——这是可以用毫秒级完成的计算。
2.2 向量化的两步流程
官方文档将 Embedding 的工作原理描述为两步:

2.3 三种相似度度量
向量之间的"距离"有多种算法,各有适用场景:


实际工程中,余弦相似度是绝对主流,因为它只关心语义方向,不关心文本长度带来的向量模长差异。
很多模型(如 BGE 系列)建议在输出时做 normalize_embeddings=True,归一化后点积就等于余弦相似度,计算更快。
相似度计算代码示例:

三、LangChain 的 Embeddings 接口
3.1 统一接口设计
和 Loader 的 BaseLoader 一样,LangChain 为所有 Embedding 模型定义了统一的 Embeddings 接口:

只有两个核心方法,但它们的区分有明确语义:
| 方法 | 输入 | 输出 | 用途 |
|---|---|---|---|
embed_documents(texts) | List[str] (多条文本) | List[List[float]] (向量列表) | 索引阶段:批量编码文档 chunk |
embed_query(text) | str (单条文本) | List[float] (单个向量) | 查询阶段:编码用户提问 |

为什么文档和查询要分两个方法?
官方文档解释:接口允许查询和文档使用不同的编码策略。虽然大多数模型在两个方法中走相同的编码路径,但一些模型(如 E5、BGE 系列)会为查询和文档添加不同的前缀——这正是分两个方法的意义所在。
四、四大部署模式
官方文档归纳了实践中最常见的四种 Embedding 部署模式[1],这对选型至关重要:

LangChain 的设计让这四种模式在代码层面完全等价——实例化一个 Embeddings 子类,交给向量库或检索器即可。
模式二和三用 HuggingFaceEmbeddings;
模式四用 OpenAIEmbeddings 指向 TEI 的 OpenAI 兼容端点,或用 OllamaEmbeddings。
五、选型决策:六个维度
5.1 选型全景
官方文档列出了选型时需要权衡的六个维度:

5.2 维度详解
质量(Quality):以 MTEB 排行榜 为参考起点。MTEB 在检索、聚类、分类、重排等多任务上评测模型,是行业事实标准。但排行榜数字不等于你的场景表现——务必在自有数据上跑一次小规模评测。
成本(Cost):
| 模式 | 计费方式 | 典型成本 | 适合 |
|---|---|---|---|
| 托管 | 按 token 计费 | ~$0.01–0.15 / 百万 token | 中低量级,不想运维 |
| 本地 CPU | 零调用成本 | 仅硬件折旧 | 低量级个人项目 |
| 本地 GPU | 零调用成本 | GPU 租赁/采购 | 中高量级生产 |
| TEI 自托管 | 零调用成本 | 服务器+GPU | 高量级,单GPU经济性可超托管 |
延迟(Latency):

维度(Dimensionality)——影响存储和查询计算量:

现代模型(OpenAI text-embedding-3-*、mxbai-embed-large-v1、Qwen3-Embedding)支持Matryoshka 截断——可以将高维向量截断到更低维度,质量优雅退化,适合在有限存储中容纳更多向量。
上下文长度(Context Length):经典模型(all-mpnet-base-v2、经典 BGE)上限 512 token。
新一代模型支持更长上下文:
| 模型 | 最大上下文 |
|---|---|
| 经典 BGE / all-mpnet-base-v2 | 512 token |
nomic-ai/modernbert-embed-base | 8192 token |
Alibaba-NLP/gte-multilingual-base | 8192 token |
BAAI/bge-m3 | 8192 token |
OpenAI text-embedding-3-* | 8191 token |
如果你的 chunk 较长(整页技术文档、法律条文),优先选长上下文模型。chunk 短则 512 token 限制很少成为瓶颈。
多语言支持(Multilingual):中文场景的推荐模型:

5.3 官方推荐起点
官方文档给出了不同场景的推荐起点:
| 场景 | 推荐模型 | 代码 |
|---|---|---|
| 快速原型·托管 | OpenAI 3-small | OpenAIEmbeddings(model="text-embedding-3-small") |
| 快速原型·本地无key | all-mpnet-base-v2 | HuggingFaceEmbeddings(model_name="sentence-transformers/all-mpnet-base-v2", encode_kwargs={"normalize_embeddings": True}) |
| 生产·托管·质量优先 | Voyage-3 或 OpenAI 3-large | VoyageAIEmbeddings(model="voyage-3") 或 OpenAIEmbeddings(model="text-embedding-3-large") |
| 生产·开源·质量优先 | BGE-M3 via TEI | HuggingFaceEmbeddings(model_name="BAAI/bge-m3", encode_kwargs={"normalize_embeddings": True}) |
| 多语言·开源 | multilingual-e5-large | HuggingFaceEmbeddings(model_name="intfloat/multilingual-e5-large") + 前缀配置 |

六、Query/Document 前缀:一个容易踩的坑
部分开源模型(E5、BGE、Qwen3-Embedding、GTE)在训练时,对查询和文档使用了不同的文本前缀[1][2]。在查询时用错前缀,是常见的质量退化原因。

LangChain 的 HuggingFaceEmbeddings 允许显式配置前缀:
from langchain_huggingface import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(
    model_name="intfloat/e5-large-v2",
    encode_kwargs={"prompt": "passage: "},        # 文档编码前缀
    query_encode_kwargs={"prompt": "query: "},   # 查询编码前缀
)
每个模型卡片上会注明推荐的前缀字符串,务必查看。
七、代码案例 OpenAI Embeddings(托管模式)
import os
from dotenv import load_dotenv
from langchain_openai import OpenAIEmbeddings

load_dotenv(override = True)

SILICONFLOW_API_KEY = os.getenv("SILICONFLOW_API_KEY")
SILICONFLOW_BASE_URL = os.getenv("SILICONFLOW_BASE_URL")

# 初始化 — text-embedding-3-large 支持 dimensions 参数截断
embeddings = OpenAIEmbeddings(
    model = "BAAI/bge-large-zh-v1.5",
    api_key = SILICONFLOW_API_KEY,
    base_url = SILICONFLOW_BASE_URL,
    check_embedding_ctx_length=False
)

# --- embed_query: 编码单条查询 ---
query_vector = embeddings.embed_query("什么是检索增强生成?")
print(f"查询向量维度: {len(query_vector)}")
print(f"前5个值: {query_vector[:5]}")

# --- embed_documents: 批量编码文档 ---
doc_vectors = embeddings.embed_documents([
    "RAG通过从外部知识库检索相关文档来增强LLM的回答质量。",
    "Embedding模型将文本转换为固定长度的稠密向量。",
    "今天北京的天气晴朗,适合户外活动。",
])

print(f"/n编码了 {len(doc_vectors)} 个文档")
for i, vec inenumerate(doc_vectors):
    print(f"  doc {i + 1}: 维度={len(vec)}, 前3值={[round(v, 4) for v in vec[:3]]}")

八、超越单向量:稀疏与混合检索
单一稠密向量是默认方案,但不是唯一选择。官方文档指出三种进阶方案:

关键直觉:
稠密向量擅长语义近似(“机器学习” ≈ “ML”),但对精确匹配(产品编号 SKU-12345、函数名 calc_tax)表现不佳。
混合检索用稠密向量负责语义、稀疏索引负责精确匹配,覆盖两端。
BGE-M3 的设计尤其方便——一次推理同时产出稠密、稀疏和多向量三种表示,天然支持混合检索。
九、选型决策树
将上述六个维度综合为一张决策路径图:

十、结语
Embedding 是 RAG 系统中"连接语义世界和数学世界的桥梁"。
选择 Embedding 模型本质上是在做一组权衡:质量 vs 成本、精度 vs 延迟、通用 vs 领域适配。
没有最优解,只有最适合你场景的解。
几个实践中容易忽视的要点:
第一,索引和查询必须使用同一模型。这听起来是常识,但在迭代过程中换模型却忘了重新编码已有数据是真实存在的错误。
第二,E5/BGE 等模型的 query/document 前缀不能搞错。一个前缀字符串的遗漏,可能让你的检索准确率掉几个百分点,而且很难从日志中发现——结果只是"不够好",不会报错。
第三,归一化向量。在用余弦相似度的场景下,normalize_embeddings=True 既是正确性保障,也是性能优化。
第四,MTEB 排行榜是起点不是终点。在你的领域数据上跑一次评测,往往和排行榜数字有明显偏差。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
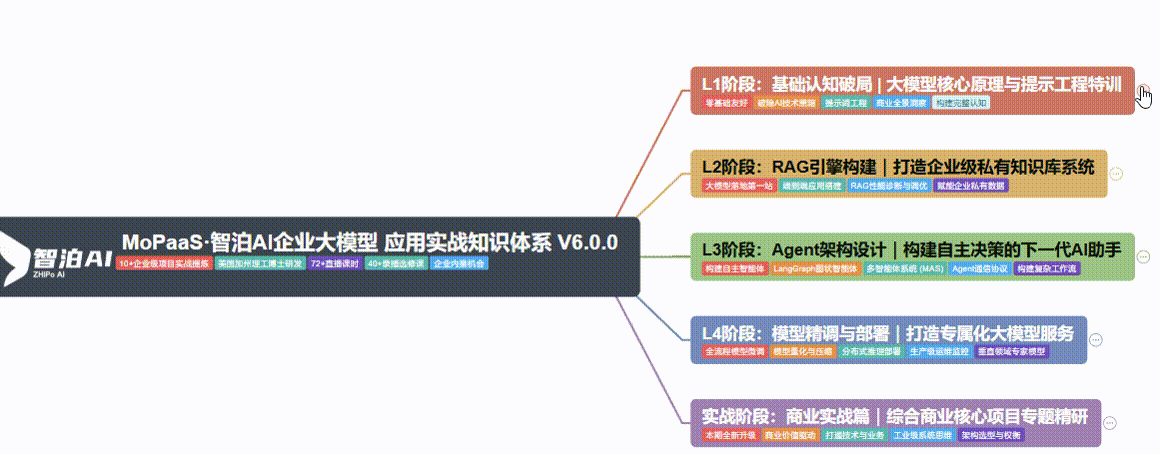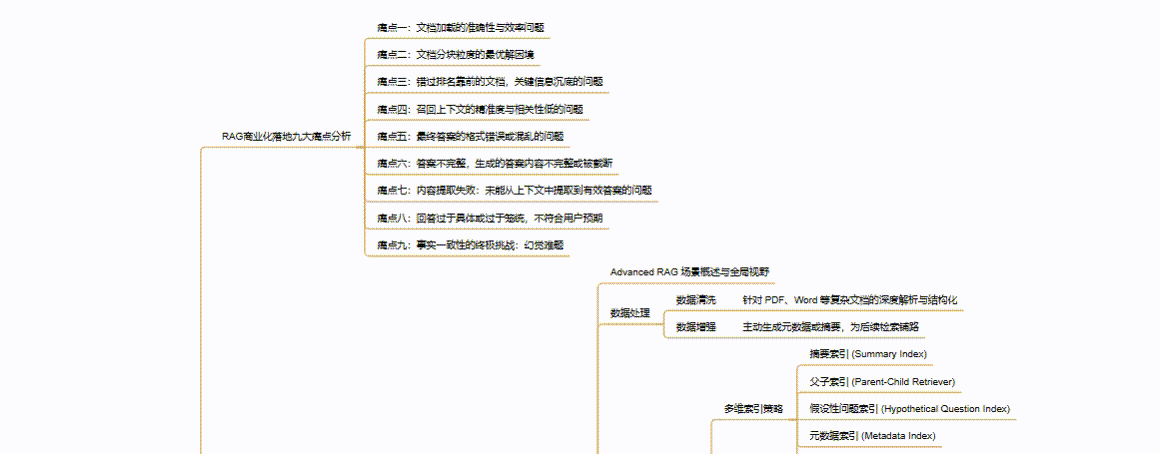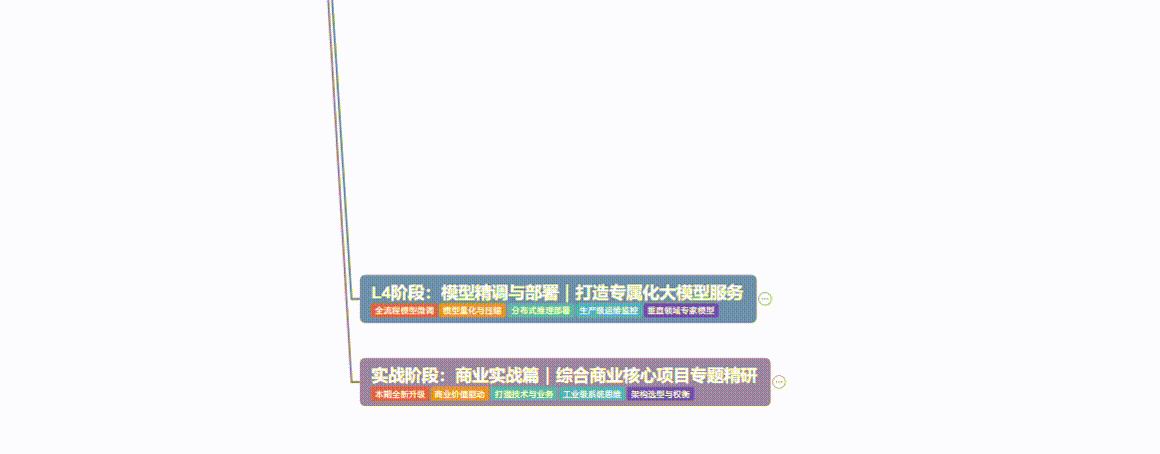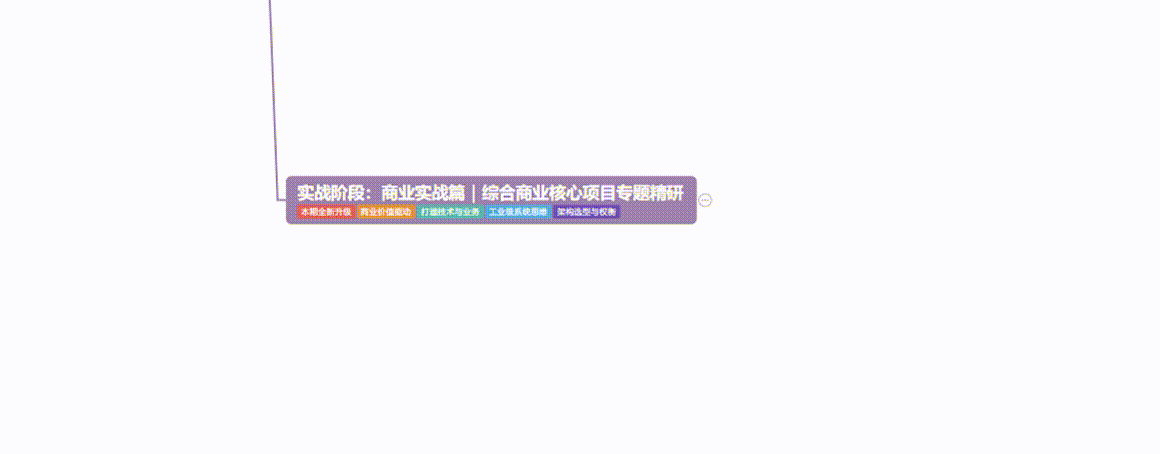
1、大模型系统化学习路线
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
更多推荐

 0
 0
- 0


 已为社区贡献48条内容

所有评论(0)