
Agent开发学习路线:小白程序员必备,收藏这份清单,少走弯路!
本文分享了Agent开发的学习路线,建议从Python基础和大模型API调用开始,逐步学习Tool Calling、RAG和Agent工作流,最后补齐工程能力,让项目真正能用。文章强调实践的重要性,建议不要贪多求全,而应按阶段逐步深入学习,并通过一个完整的项目来巩固所学知识。
去年开始学 Agent 开发的时候,我最大的感受就是:怎么感觉永远学不完?
刚看完 Python,又冒出来模型 API;刚把 RAG 跑通,又开始学 Tool Calling、LangChain、LangGraph。好不容易做出一个 Demo,发现跟真正能上线的项目还有很大差距。
我之前做了7年 Java 后端,原本以为有开发基础,转 Agent 应该不会太难。真学进去才发现,难的不是某个框架,而是知识点太多,很容易今天学这个、明天学那个,折腾几个月,还是没做出一个完整项目。
后来我才慢慢理清楚:学 Agent 不需要一开始就把所有技术弄懂,先按照项目需要,把核心能力一层层补齐就行。
📌如果你现在也在学 Agent,感觉每天都很忙,却不知道自己到底学到了什么,可以参考下面这条路线。
一、第一阶段:先把基础跑通,别急着学框架
刚开始的两三周,我建议先别急着研究多 Agent,也不用一上来就啃复杂的框架源码。
先把下面几件事弄明白:
- Python 基础
如果你之前是 Java、Go 后端,变量、函数、类这些概念不会太陌生,不用把时间全花在基础语法上。
重点补一下 Python 的常用写法,比如类型注解、Pydantic、异步编程、虚拟环境和依赖管理。尤其是 async/await,后面调用模型 API、并发处理任务时经常会用到。
- 大模型 API 调用
先学会调用模型,理解系统提示词、上下文、Token、结构化输出这些基本概念。
不要只停留在聊天窗口里问问题,试着用代码做一个小工具,比如文档总结、信息提取或者简单的问答程序。
- Tool Calling
这是从普通大模型应用走向 Agent 的重要一步。
让模型根据用户需求选择工具,再由程序执行对应操作。例如,用户问某个订单的状态,模型判断需要查询订单工具,程序调用接口拿到结果,再交给模型组织回答。
这个过程看起来简单,但要真正理解工具参数、执行结果、异常处理和多轮调用。
第一阶段的目标很明确:能够独立调用模型 API,完成一个带工具调用的小应用。
先把这件事做出来,比收藏十几套 Agent 教程更有用。
二、第二阶段:从 RAG 入手,再学习 Agent 工作流
基础跑通以后,第二个月可以重点学习 RAG 和 Agent。
为什么建议先学 RAG?
因为很多企业应用都需要模型处理自己的业务资料。如果模型只能依赖训练时学到的知识,遇到公司内部文档、产品手册、业务规则,就很难直接满足需求。
RAG 需要掌握的核心环节包括:
文档解析与切分
Embedding 和向量检索
检索结果排序与优化
上下文组装与答案生成
引用来源与效果评估
不要只满足于把文档导入向量数据库,然后问出一个答案。更重要的是理解:为什么没检索到相关内容?为什么答案会答非所问?如何判断问题出在切分、召回还是生成环节?
接下来再学习 Agent 工作流。
可以先做一个企业知识库问答助手,再逐步增加工具调用、任务分支和状态管理,让应用从“回答问题”进阶到“完成任务”。
例如,做一个业务助手:先理解用户需求,再查询知识库,必要时调用业务接口,最后整理处理结果。
如果需要进一步学习框架,可以先了解 LangChain,再根据项目需求学习 LangGraph。不要为了追新而把所有框架都学一遍,先理解原理,再选择合适的工具。
第二阶段的目标,是做出一个包含 RAG、工具调用和基本工作流的完整应用,而不是拼几个互不相关的 Demo。
三、第三阶段:补齐工程能力,让项目真正能用
到了第三个月甚至第四个月,很多人会遇到一个新问题:Demo 能跑,但稍微换个输入就出错;本地运行没问题,一部署就各种异常。
这时候就不能只盯着模型效果了。
企业真正需要的 Agent,不仅要能完成任务,还要稳定、可控、方便维护。
建议重点补齐这几项能力:
- 异常处理与兜底
工具调用失败怎么办?模型输出格式不对怎么办?检索不到答案怎么办?要设计超时、重试、降级和人工介入机制。
- 日志与效果评估
不能只凭感觉判断 Agent 做得好不好。要记录关键调用过程,分析工具选择是否准确、任务是否完成、响应时间和 Token 消耗是否合理。
- 权限与安全
涉及真实业务数据时,要考虑用户权限、敏感信息、工具调用范围等问题,不能让模型想调用什么接口就调用什么接口。
- 部署与项目交付
至少了解 FastAPI、Docker、环境配置和基本日志监控,让项目能够在目标环境中运行,而不是只能在自己的电脑上演示。
这一阶段不要求你一下子成为架构专家,但你要开始从“我做了一个功能”,转向“我能交付一个可靠的应用”。
四、学习资料怎么选?不用收藏太多
我自己更建议按学习阶段找资料,每个阶段选一两份,学完马上动手,不要同时开十几条学习线。
Python 基础:可以搜索 B 站的“黑马程序员 Python 基础教程”,也可以参考《Python编程:从入门到实践》。有开发经验的人重点补自己不熟悉的部分即可。
模型 API:优先看所使用模型的官方文档,跟着示例完成调用、结构化输出和工具调用。
RAG 与 Agent:可以参考 DeepLearning.AI 的相关短课程,以及 LangChain、LlamaIndex、LangGraph 的官方教程,选一套跟着项目实践。
工程部署:FastAPI 和 Docker 的官方文档足够作为入门参考,重点是自己动手部署一个应用。
资料只是辅助,真正决定你能不能进步的,是有没有把学到的东西用起来。
五、别一直学新技术,把一个项目做透
我后来越来越觉得,学 Agent 最容易踩的坑,就是不断追新框架、看新教程,却没有一个拿得出手的完整项目。
与其做五六个只展示基本功能的 Demo,不如认真打磨一个项目。
比如企业知识库助手,你可以从最初的文档问答开始,逐步加入检索优化、工具调用、权限管理、异常处理和效果评估。
每次增加功能,都要想清楚:解决了什么问题?为什么这么设计?有没有其他方案?效果如何验证?
这些才是面试和真实项目中更有价值的经验。
如果你本身有 Java、Go 或其他后端开发经验,也不用把过去的积累全部推倒重来。接口设计、数据库、权限、日志、部署和故障排查,依然是 Agent 应用落地需要的能力。
你需要补的是大模型应用这一层,并学会把它和已有的工程能力结合起来。
🔥最后,说点真心话
如果你现在刚开始学 Agent,觉得知识点太多、路线太乱,我的建议是:先别追求什么都会。
前期把 Python 和模型 API 跑通,中期做好 RAG 和工具调用,后期再补工程化、评估和部署。按照这个顺序持续推进,通常会比东学一点、西学一点更有效。
当然,三四个月只是一个参考节奏,具体进度还要看你的编程基础、每周投入时间和项目复杂度。学习路线能帮你少走弯路,但真正的能力还是要靠实践积累。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
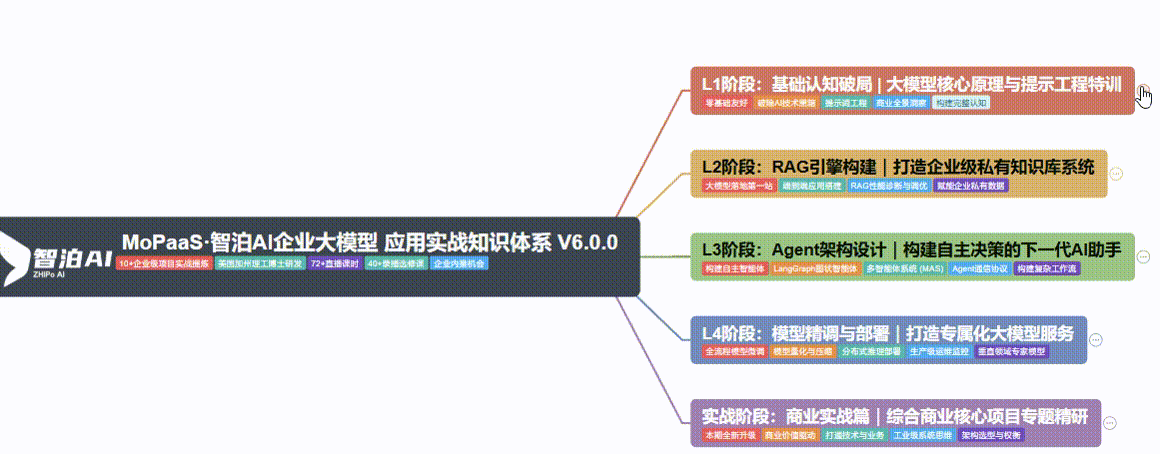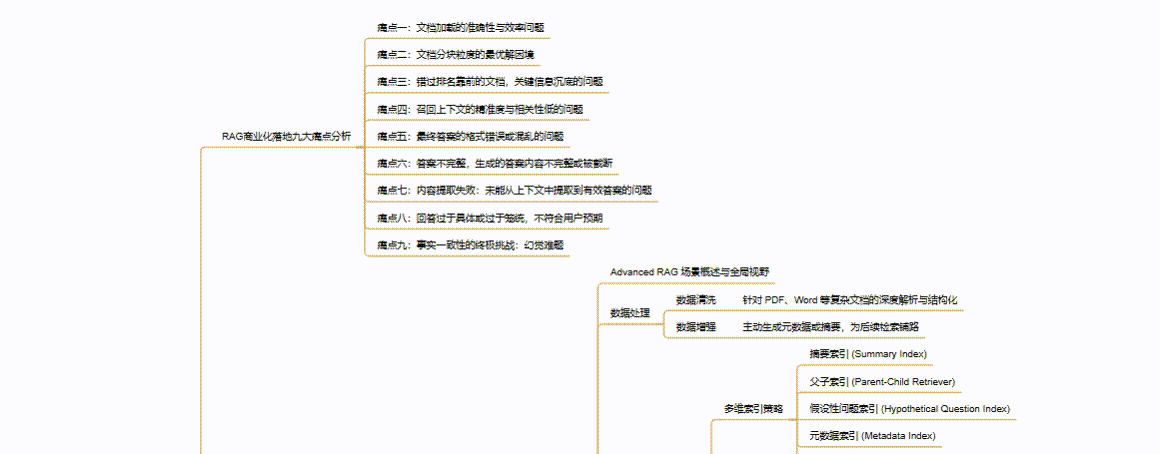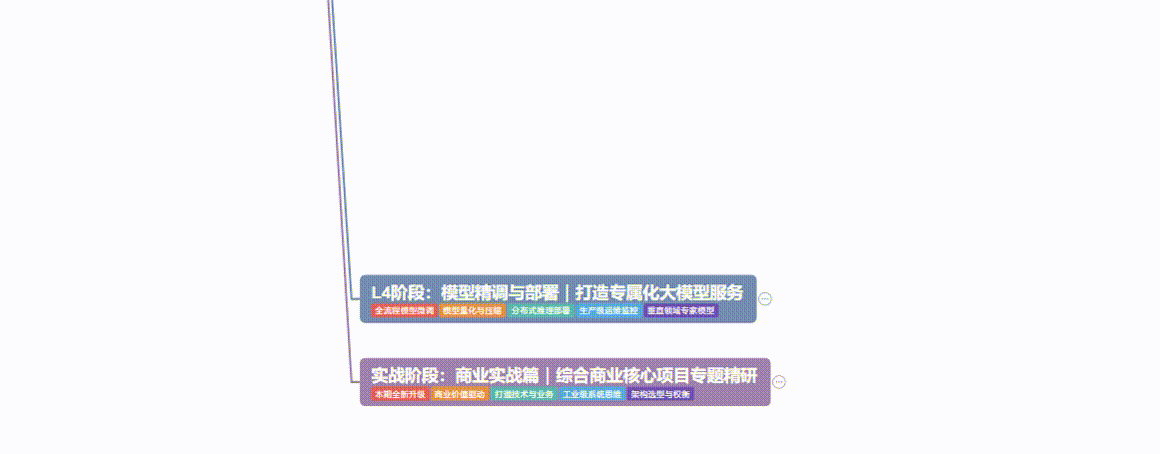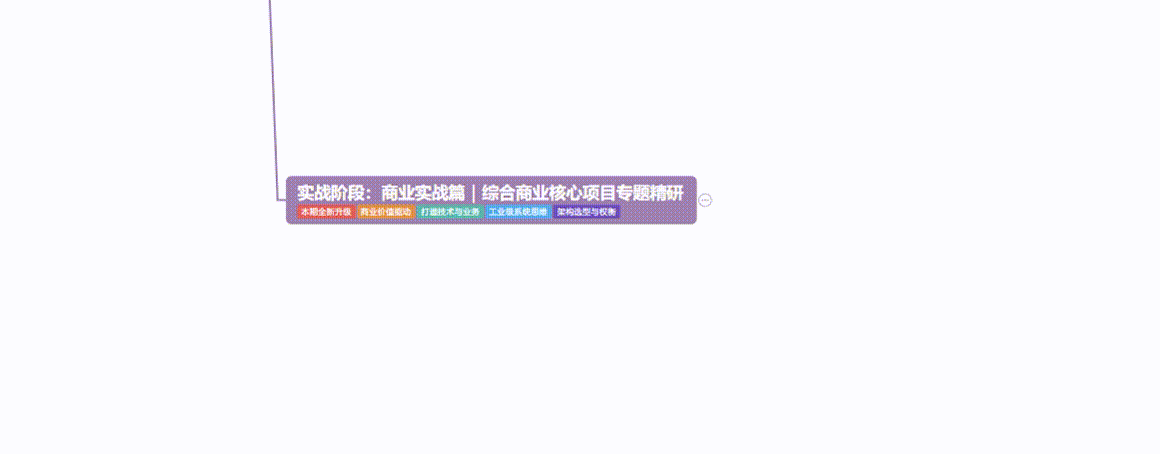
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
2、大模型学习视频教程
3、大模型学习书籍&电子文档
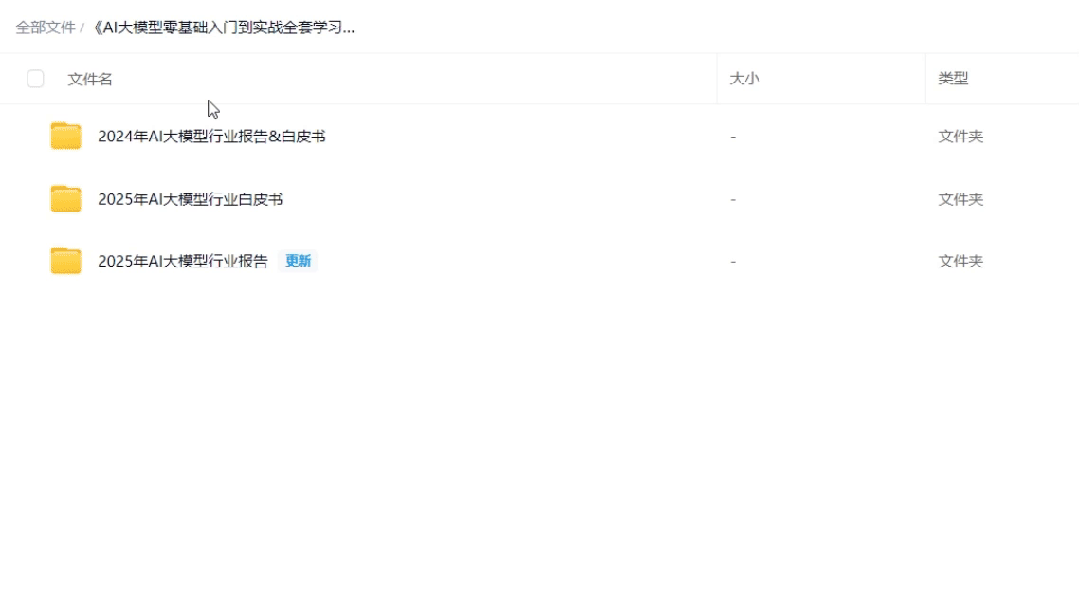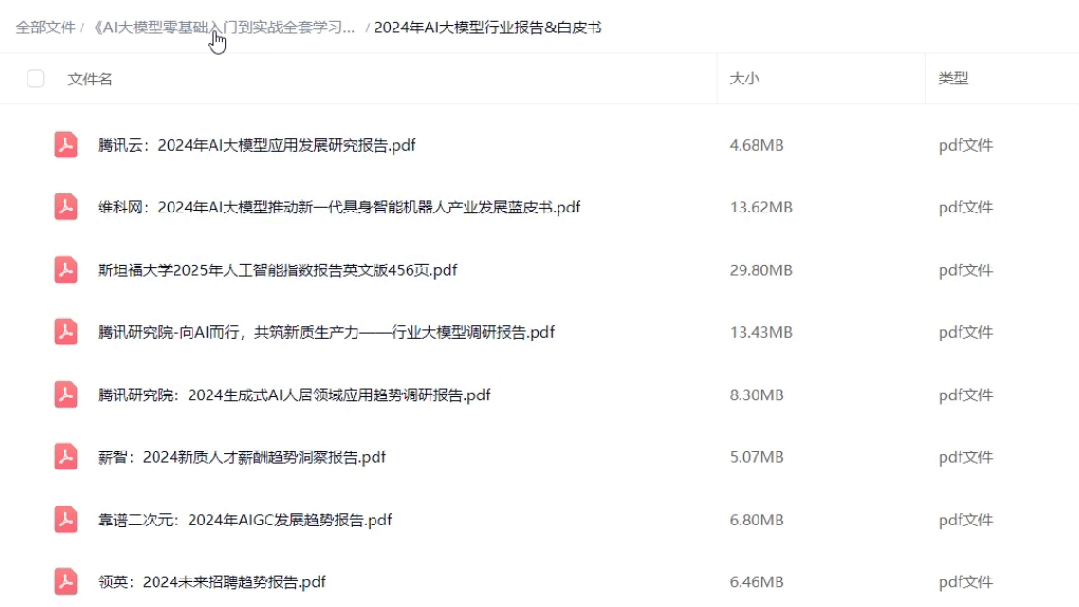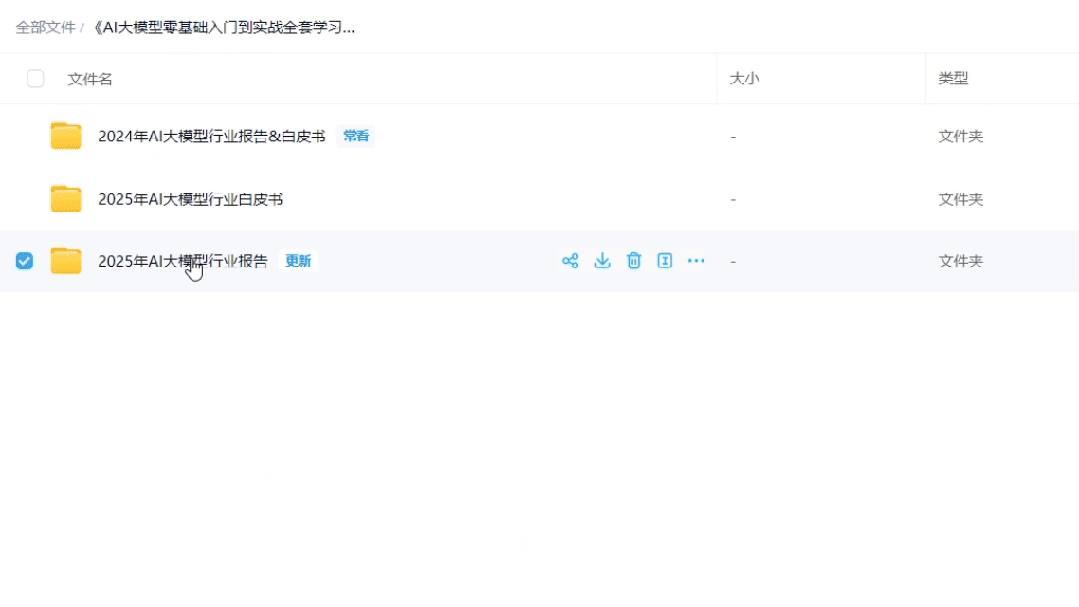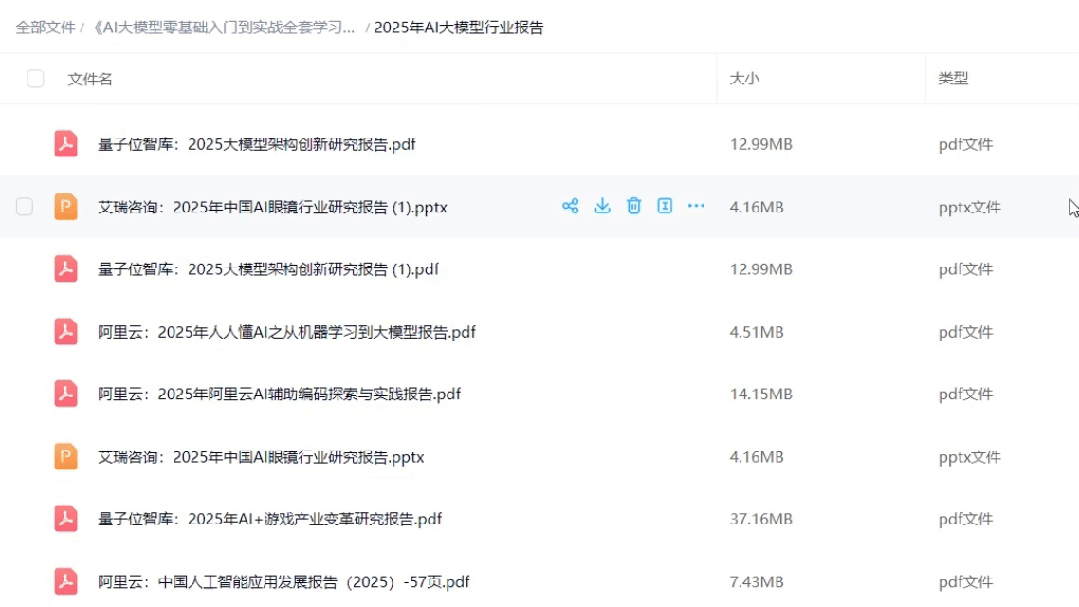
4、AI大模型最新行业报告
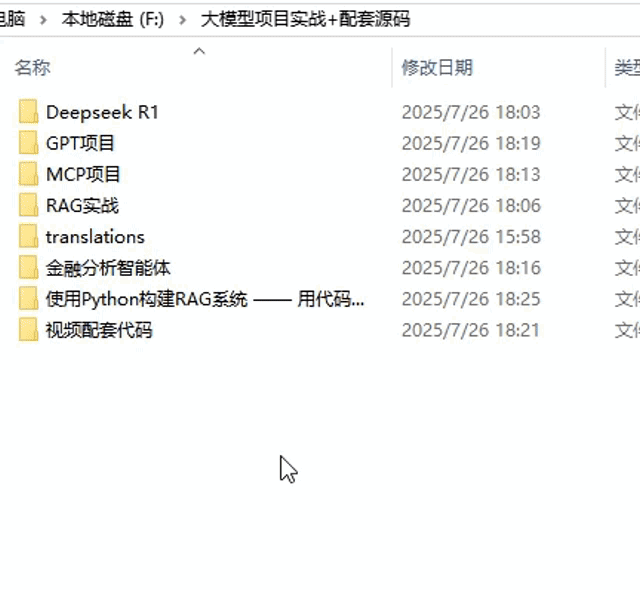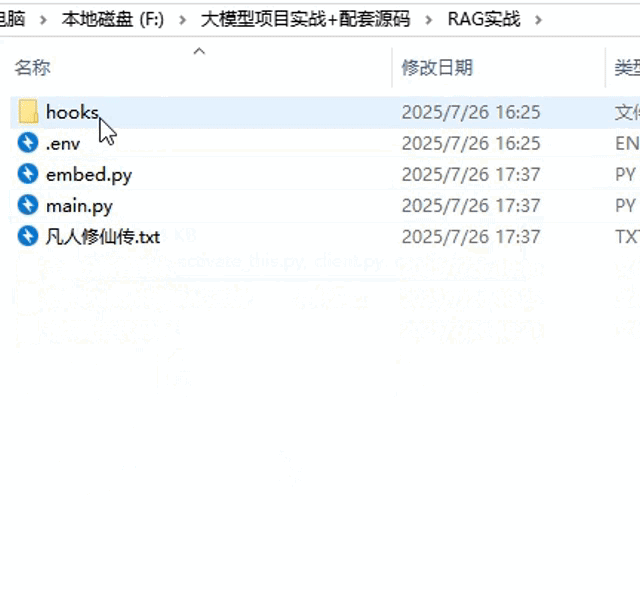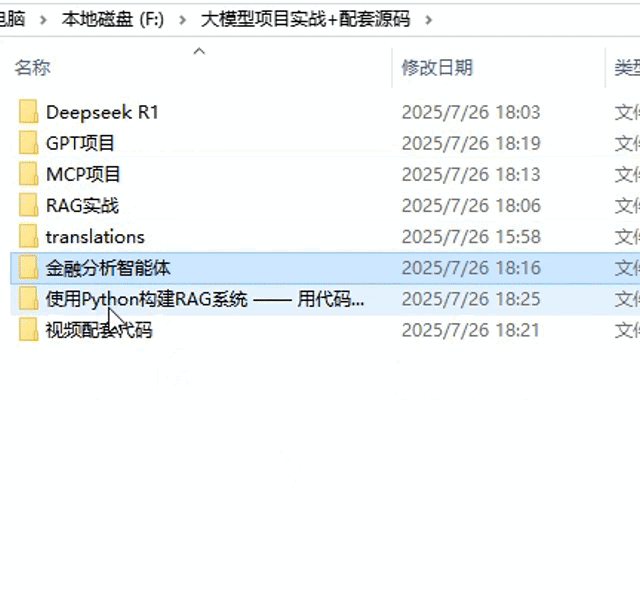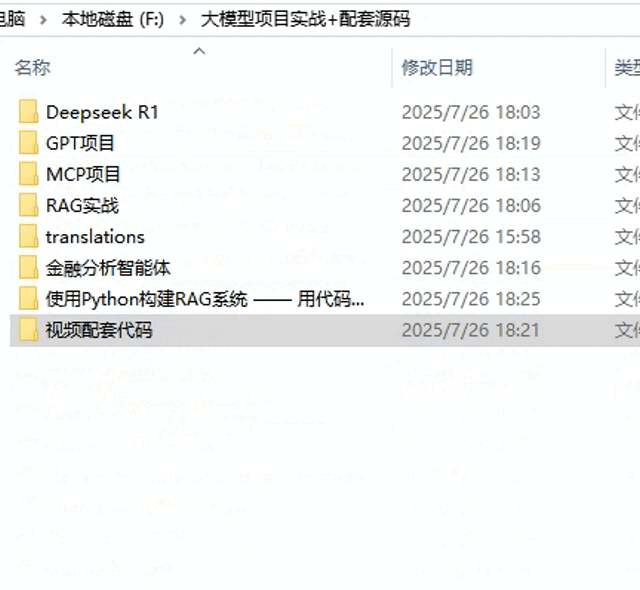
5、大模型项目实战&配套源码
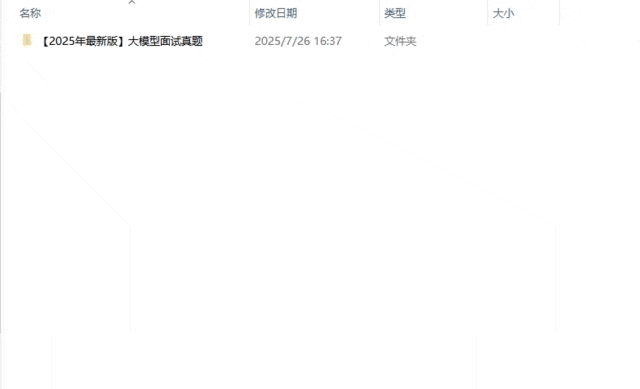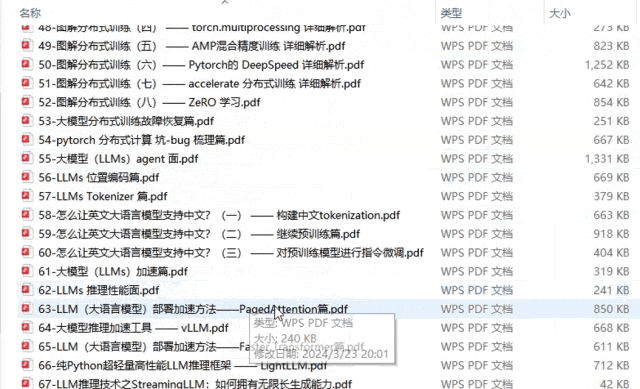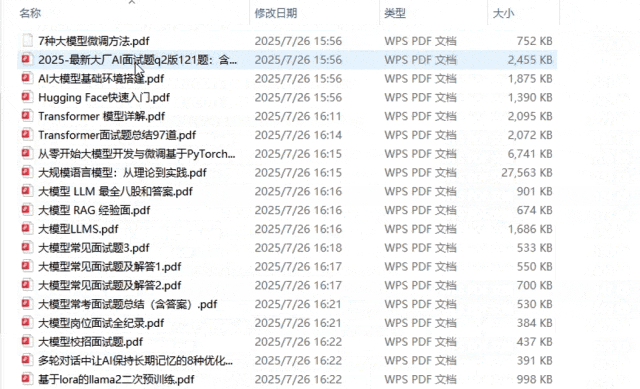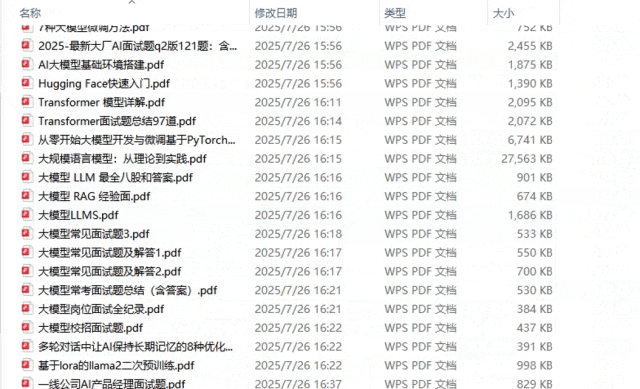
6、2026大模型大厂面试真题
7、为什么要学习大模型?
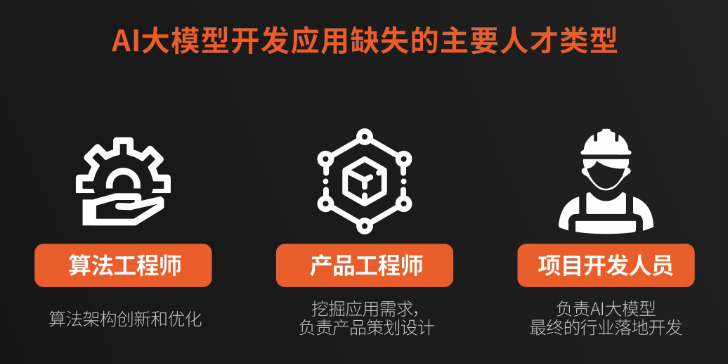
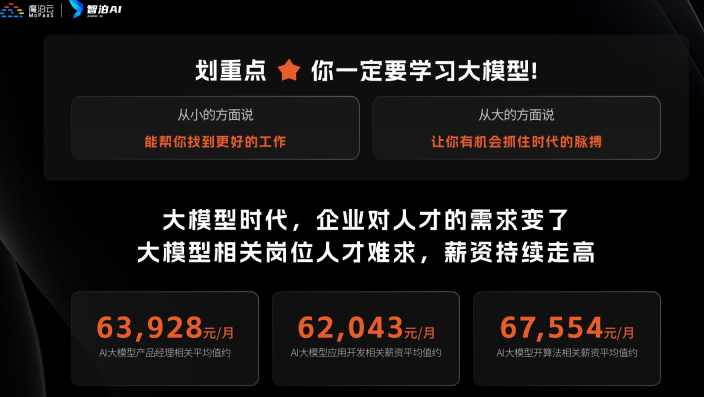
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
更多推荐

 2
 0
- 0


 已为社区贡献27条内容

所有评论(0)