
RAG 上生产:多 Agent 编排 + 监控与成本
单 Agent 为何触顶

前三篇,我们把一个 RAG 机器人从「能答本地文档」,一路养成「会记上下文、每条结论带来源、还能联网查、动手算」的 Agent。能力越叠越多,但全都塞进同一个大脑里——它迟早会触顶,而且是四种触顶同时发生:
-
上下文膨胀
:检索片段、对话历史、工具 schema、长系统提示词全挤进一个 prompt,窗口被撑爆,噪声盖过重点,成本跟着直线涨。
-
职责混杂
:一个函数既管检索又管计算又管联网又管生成,哪一步答错了,你根本分不清是「书没查到」还是「算错了」还是「网没连上」。
-
不可观测
:整条链路是个黑盒,你只知道「这次花了 3000 token、耗时 4 秒」,但说不出是检索慢、还是某个工具在空转。
-
难恢复、难降级
:任何一个零件(比如联网)挂了,整个回答直接崩;你没法让它「联网不行就老老实实答本地」。
修法不是继续给这个胖 Agent 打补丁,而是把它拆成一支队伍:一个主管调度,多个专家分工,谁挂了谁降级。这就是多 Agent 编排。

多 Agent 编排模式

用公司团队类比,四种最常见模式,各自有适用场景:
-
Supervisor / Manager(主管调度)
:一个主管统一受理需求,按需派给下属,下属干完把结果回报给主管,主管汇总成最终答复。适用「能力相对独立、需要统一入口和汇总」的场景——我们本篇就用它。
-
Worker Pool(专家池)
:一群平级专家,主管把任务广播或分发给空闲的人并行干。适用「可并行、同质」的子任务,比如同时给 10 份合同做摘要。
-
Planner-Executor(规划-执行)
:一个规划师先把大任务拆成步骤清单,再交给执行器逐步落地,每步回报进度。适用「多步、长链条」任务,例如「调研竞品 + 算成本 + 出对比报告」。
-
Critic-Reflect(批评-反思)
:先生成一版,再来一个评审员挑刺,生成者根据反馈修订,循环直到达标。适用「对正确性极敏感」的场景,如代码生成、财务结论。
选哪种不靠玄学:任务能并行就上池,任务要分步就上规划-执行,任务要质量闭环就上批评-反思,而大多数「问答型助手」用主管调度最顺手。


可复制骨架:状态与节点

我们用 LangGraph 的 StateGraph 落地主管调度。三个专家正好复用前三篇的能力:检索 Agent 对应第 1、2 篇的 retrieve_chunks,计算、联网 Agent 对应第 3 篇的 calculator、web_search。
先定义共享状态与主管节点:
# rag_kb_multi.py — 多 Agent 编排骨架(supervisor 模式)# 环境:Python 3.10+ / langgraph>=0.2 / langchain>=0.2 / redis>=5.0# 版本以官方最新为准from typing import Annotated, Literalfrom typing_extensions import TypedDictfrom langgraph.graph import StateGraph, START, ENDfrom langgraph.graph.message import add_messagesclass AgentState(TypedDict): """多 Agent 共享状态:消息流 + 当前该谁干活 + 失败重试计数。""" messages: Annotated[list, add_messages] # 所有节点共享同一份对话历史 next: str # supervisor 的派单结果 attempts: dict[str, int] # 每个 worker 的失败重试计数from langchain_openai import ChatOpenAIROUTER = ChatOpenAI(model="gpt-4o-mini", temperature=0) # 便宜模型做路由def supervisor(state: AgentState) -> dict: """主管:读对话,决定下一步派给哪个专家,或宣告结束。""" sys = ("你是调度主管。可选 worker:retrieve(本地检索)、" "calc(计算)、web(联网)。只回复一个词:retrieve/calc/web/FINISH。") decision = ROUTER.invoke([{"role": "system", "content": sys}, *state["messages"]]).content.strip() if decision notin {"retrieve", "calc", "web"}: decision = "FINISH" return {"next": decision}
TypedDict + add_messages 的好处是:每个节点只管自己那摊事,往 messages 里追加内容,LangGraph 自动把多 Agent 的产出拼成一条完整上下文,最后生成节点一眼就能看到所有专家的贡献。专家节点本身很简单——干活、把结果写回共享消息流,主管下一轮再读:
def retrieve_node(state: AgentState) -> dict: """检索专家:复用前两篇的 retrieve_chunks(本地优先)。""" from rag_kb_tools import retrieve_chunks # 复用第 1/2/3 篇能力 q = state["messages"][-1].content chunks = retrieve_chunks(q) note = f"[retrieve] 命中 {len(chunks)} 段本地资料"if chunks \ else"[retrieve] 本地无相关内容" return {"messages": [{"role": "system", "content": note}]}# calc_node / web_node 同理:分别复用 calculator / web_search,结果回写 messages

Supervisor 调度与降级

把节点连成图:主管派单 → 专家执行 → 回报主管 → 再派单,直到主管说 FINISH,交给生成节点汇总。这就是 handoff(交接)的消息传递本质:所有节点读写同一份 messages,靠 next 字段流转控制权。
def route(state: AgentState) -> Literal["retrieve", "calc", "web", "generate"]: return state["next"] if state["next"] != "FINISH"else"generate"g = StateGraph(AgentState)for n in ("supervisor", "retrieve", "calc", "web", "generate"): g.add_node(n, globals()[n])g.add_edge(START, "supervisor")g.add_conditional_edges("supervisor", route, {"retrieve": "retrieve", "calc": "calc", "web": "web", "generate": "generate"})for w in ("retrieve", "calc", "web"): g.add_edge(w, "supervisor") # 专家干完回到主管,形成调度循环g.add_edge("generate", END)app = g.compile()
「难降级」这个痛点,靠失败重试 + 优雅降级解决。比如联网专家:重试三次仍失败,就降级为「本地兜底」,绝不让整条链路崩:
from tenacity import retry, stop_after_attempt, wait_fixed@retry(stop=stop_after_attempt(3), wait=wait_fixed(0.5))def web_node(state: AgentState) -> dict: """联网专家:失败重试;彻底失败则降级为本地兜底,不阻断整条链路。""" try: from rag_kb_tools import web_search res = web_search(state["messages"][-1].content) if"失败"in res or"未安装"in res: raise RuntimeError(res) return {"messages": [{"role": "system", "content": f"[web] {res}"}]} except Exception: # 降级:联网挂了,本地仍能答 return {"messages": [{"role": "system", "content": "[web] 降级:联网不可用,已回退本地资料"}]}

上线监控怎么做

上线不是 streamlit run 完事。至少盯六类指标:
-
Trace / Span
:用 LangSmith 或 OpenTelemetry 包裹每个节点,能看清「这次慢是卡在检索还是卡在生成」。
-
Token 用量
:按模型、按角色(检索/生成)分别计数,定位「谁在偷吃 token」。
-
延迟 P50 / P95
:用直方图看中位数和长尾,P95 才是用户体验底线。
-
检索命中率
:沿用第 1 篇黄金集,线上再抽样回测,防止知识库漂移。
-
工具调用成功率
:按工具 + 状态打 Counter,某个工具悄悄失败能立刻发现。
-
失败告警
:阈值 + webhook(飞书/钉钉/企微),异常自动推到群里。
生成若走流式输出,可在每个 token 块回传时累加已消耗 token,前端实时显示「本次预计花费」,用户和后台都能边用边看见账单在涨。最小可运行的打点与告警长这样:
from prometheus_client import Histogram, Counter, start_http_serverimport requestsLAT = Histogram("rag_latency_seconds", "端到端延迟", buckets=(0.5, 1, 2, 5, 10))TOK = Counter("rag_token_total", "token消耗", ["model", "role"])TOOL = Counter("rag_tool_total", "工具调用", ["tool", "status"])@LAT.time()def handle(req): ... # 在每步结束后 TOK.labels(...).inc(n)、TOOL.labels(...).inc()def alert_if(p95: float, threshold: float = 5.0): """P95 延迟超阈值,打 webhook 告警。""" if p95 > threshold: requests.post(WEBHOOK_URL, json={"text": f"RAG P95={p95:.1f}s 超阈值"})# 链路追踪:app.invoke(..., config={"callbacks": [LangChainTracer()]})# 即可在 LangSmith 看到每个节点的 span 与耗时


成本控制四板斧

成本不控,月底账单教你做人。四板斧:
-
模型分层
:路由、分类用便宜模型(如
gpt-4o-mini或本地小模型),只有最终生成才上贵模型——本篇ROUTER已经这么干了。 -
缓存
:语义缓存 / 向量缓存(Redis),近义问题命中同一答案,直接省下整次调用。
-
Token 预算与熔断
:单请求设预算上限,上游错误率过高直接熔断,别让一次坏请求把配额烧光。
-
归因 + 限流
:按「用户 / 会话 / 功能」给每次请求打标,算清谁最费钱;再对单 IP 限流、设日配额。流式输出时实时累计已花 token,便于中途预估账单。打标其实就一行:在请求入口把
user_id/session_id/ 功能标签写进 metrics 的 label,月底按标签group by,立刻分清是「客服场景」还是「内部测试」在烧钱;限流用 Redis 的INCR+EXPIRE做滑动窗口,对单 IP 限每分钟 N 次即可。
前两板斧的最小实现:
import redis, hashlib, jsonr = redis.Redis(host="localhost", port=6379, db=0)def semantic_cache(q: str): """语义缓存:同义/近义问题命中同一答案,省下整次调用。""" key = "rag:" + hashlib.md5(q.encode()).hexdigest() hit = r.get(key) return json.loads(hit) if hit elseNone # 命中即返回,跳过模型def cache_set(q: str, answer: str, ttl: int = 3600): r.setex("rag:" + hashlib.md5(q.encode()).hexdigest(), ttl, json.dumps(answer))class Budget: """单请求 token 预算 + 上游错误率熔断。""" def __init__(self, limit: int = 8000): self.limit, self.used, self.open = limit, 0, False def spend(self, n: int): if self.open: raise RuntimeError("熔断器已打开") if self.used + n > self.limit: raise RuntimeError("超出 token 预算") self.used += n

依赖与最小组合

本篇在第三篇基础上新增四项依赖;不配也能跑,只是对应能力会降级:
# 基础依赖(同前三篇)langchain>=0.2langchain-openai>=0.1langchain-chroma>=0.1chromadb>=0.5streamlit>=1.36openai>=1.4pypdf>=4.0tavily-python>=0.3 # 联网检索(可选)# 本篇新增langgraph>=0.2 # 多 Agent 编排(supervisor 模式)redis>=5.0 # 语义缓存prometheus-client>=0.20 # 监控指标tenacity>=8.0 # 失败重试opentelemetry-api>=1.20 # 链路追踪(可选,也可用 LangSmith)
最小可用组合:LangGraph(编排)+ Redis(缓存)+ Prometheus(监控) 三件套即可上线;LangSmith / OpenTelemetry 二选一做追踪,嫌重可先不接。版本号以官方最新为准。

评测与系统韧性

编排完更要证明它「不会整体崩」。两招:
多 Agent e2e 评测:在黄金集里加一批多步用例,例如「对比 A、B 两款产品并算出总价差」,断言最终答案出现 [来源:...] 且数值正确——验证检索、计算、生成三个专家真的协同了。
混沌测试:主动干掉某个 worker,断言整体降级而非崩溃。这正是检验「难降级」有没有落地的铁证:
def test_chaos_web_down(): """混沌测试:联网挂了,整体是否降级而非崩溃。""" import rag_kb_multi as m m.web_search = lambda q: (_ for _ in ()).throw(RuntimeError("web down")) ans, cited = m.app.invoke({"messages": [("user", "今天天气怎么样?")]}) assert ans andnot str(ans).startswith("Error"), "联网挂掉导致整体崩溃" # 断言回退到了本地兜底,而非抛出未捕获异常
把这两招接进 CI,每次改了调度逻辑或新增专家,自动跑一遍,系统的韧性就有了底线。

代码仓库与下期

到这一篇,我们的小助手从「单打独斗的胖 Agent」进化成了一支分工明确的队伍:主管调度、专家各司其职、谁挂了谁降级,上线后还有监控盯延迟、缓存压成本、混沌测试保韧性。它终于像个能扛生产流量的真同事了。
关注公众号「Python程序员」,回复关键词 RAG 获取完整代码仓库(现含本篇新增的 rag_kb_multi.py 多 Agent 编排 + 监控/成本模块,以及前三篇的 rag_kb.py / rag_kb_memory.py / rag_kb_tools.py、requirements.txt、示例文档、评测脚本与 Dockerfile)。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
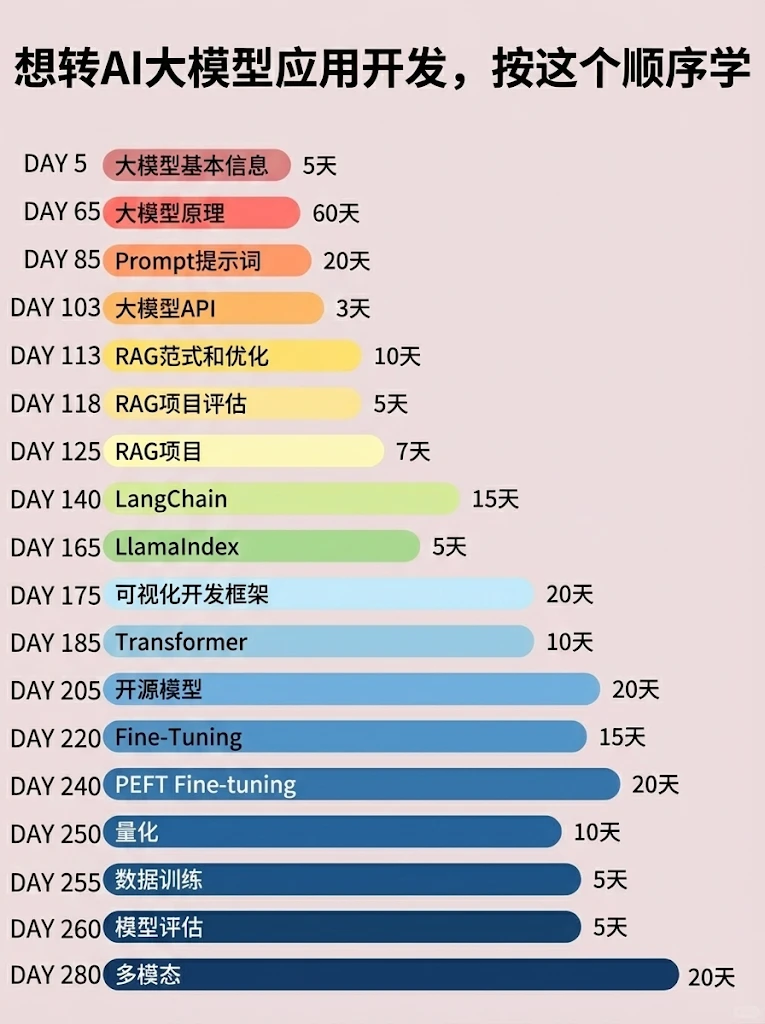
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

更多推荐
 1
 0
- 0


 已为社区贡献16条内容

所有评论(0)