
企业级智能中台:A2A 多 Agent + RAGAS + Spring Cloud + LangGraph+AI 智选导购助手
一套代码,把「AI 智选导购助手」「A2A 多 Agent 协作」「RAGAS 定时回归」装进同一个中台。这篇文章只讲三件事:两条闭环怎么咬合、每一处选型放弃了什么、踩过的坑值多少学费。所有截图来自项目真实运行界面。
写在前面:企业级 AI 中台的分水岭,不在模型,在"能不能被验证"
很多人做完一个 Agent Demo,觉得自己已经做完了。
真实差距在哪?不是模型选得多新、不是向量库用得多快,而是四个问题:答得出吗、答得对吗、验得过吗、出了事查得到吗。
演示时答得很好,业务方拿去试三个问题就卡住——问报销标准说不清依据,问库存编了个数字,问知识库外的事一本正经地胡答。
这篇文章拆的这套「企业级 AI 智能中台」,就是冲着这四个问题去的:Java 管钱、Python 管脑、LangGraph 管流程、A2A 管分工、RAGAS 管验收。六个进程 + 六类中间件全部跑通,前端三套、后端两栈、中间件六类。
先看它最见功力的一屏——一句复合问句进来,系统给出的不是一段话,是一张能逐行核对的卡:

任务 ec7c78c5「待你确认」:U2 ¥1,599.00 库存 15 件、预计 11-08 前送达上海、安装最近可约 11-06 周五 14:00–16:00 共 18 个时段。三行各自亮着"已核实",右栏余额 ¥79,816.00。
01 全景架构:6 个进程,边界比功能重要
一句话主线:网关收口,Java 管钱,Python 管脑,状态全落库。
浏览器(三套 Vue:5173 内部问答 / 5174 管理后台 / 5175 智选商城)
│  HTTP + SSE
▼
Spring Cloud Gateway :8888        ← 验签 / 限流 / 路由改写 / 身份透传
│                    │
▼                    ▼
ai-business-service     ai-intel-platform :8001
:8081 (Java)            (Python / FastAPI)
账号·权限·元数据          检索·编排·生成·评测
商品·订单·余额
│                    │
└──────┬─────────────┘
▼
MySQL 3306 · Redis 6379 · Nacos 8848
RocketMQ 9876/8082 · Milvus 19530 · ES 9200
三端各管一段:前端只管交互,网关只认三个前缀,业务中台管「人、钱、单」,智能中台管「脑、知识、编排」。所以这套系统里有两件事是物理隔离的——AI 没有任何一个工具能改余额,也没有任何一个端点能直接落订单。
| 层 | 只做这些 | 坚决不做 |
|---|---|---|
| 网关 :8888 | 验签、限流、路由改写、身份透传 | 业务判断、聚合、检索 |
| 业务中台 :8081 | 账号权限、元数据、账务、写操作事务 | 向量检索、提示词、模型调用 |
| 智能中台 :8001 | 检索、编排、生成、评测 | 直接扣款、直接改余额 |
两条核心链路贯穿全系统:
链路 A · 异步文档摄入
上传 → 网关 → 业务落盘 + INSERT(PENDING) + 发 MQ → 立刻返回 docId
→ Python 消费 → 解析 → 分块 → 向量化 → 双写 Milvus + ES → 回写 DONE
大文档上传永远不会把请求拖到超时。跑到第几步,用户刷新都能看到。
链路 B · 流式问答
提问 → 网关 /api/agent/qa/stream → LangGraph:
load_memory → retrieve(向量 + BM25 → RRF → rerank)→ grade(充分则答 / 不足则拒)
→ save_memory → SSE 逐字回传 → 前端渲染 + 引用卡片
六个进程与中间件的端口,照着能把环境拉起来:
| 进程 | 端口 | 中间件 | 端口 |
|---|---|---|---|
| ai-frontend(内部问答) | 5173 | MySQL | 3306 |
| ai-admin(管理后台) | 5174 | Redis | 6379 |
| ai-shop-frontend(智选商城) | 5175 | Nacos | 8848(控制台 8080) |
| ai-gateway | 8888 | RocketMQ | 9876 / proxy 8082 |
| ai-business-service | 8081 | Milvus | 19530 |
| ai-intel-platform | 8001 | Elasticsearch | 9200 |
RocketMQ 的 proxy 挪到 8082,是因为本机 8081 被业务服务占了。这类端口冲突是本地跑全链路最常见的第一个坑。
02 技术栈与选型:每个"为什么"都得付代价
先给结论表,再讲三个关键决策。
| 层 | 选型 | 为什么是它 |
|---|---|---|
| 前端 | Vue 3.5 / Vite 5.4 / TS 5.6 / Element Plus 2.8 | 三套前端共用组件库,管理后台表格与表单开发成本最低 |
| 后端 | Spring Boot 4.0.8 + Spring Cloud 2025.1.3 + JDK 21 | 交易类要事务与强一致;Boot 4 换来虚拟线程与新一代可观测 |
| 网关 | Spring Cloud Gateway(WebFlux) | SSE 必须用它:响应式网关对 text/event-stream 天然透传不缓冲 |
| 编排 | LangGraph 1.x(FastAPI 0.141 / Python 3.14) | 工作流是一等公民:状态、条件边、分支、人工确认都有标准表达 |
| 向量库 | Milvus 3.0.1(pymilvus) | 生产级向量检索,支持租户过滤与一致性级别 |
| 全文库 | Elasticsearch 8 | 中文 BM25 补语义召回的短板,型号词、专有名词靠它 |
| 融合 | RRF + gte-rerank-v2 | 只比排名规避量纲不可比,精排再压一遍候选 |
| 缓存 | Redis | 会话窗口、语义缓存、令牌桶限流、confirmToken 快照 |
| 元数据 | MySQL 8 | 用户/租户/知识库/订单/审计/计量,金额一律"分"整数 |
| 消息 | RocketMQ 5.x | 跨语言同 broker:Java remoting ↔ Python gRPC |
| 调度 | XXL-JOB 2.4.1 | 跑批、CRON、执行器分组、失败重试都有现成能力 |
| 模型 | qwen-plus / text-embedding-v3 / gte-rerank-v2 | 一套 DashScope 打通 chat / embedding / rerank |
决策一:Java 管钱、Python 管脑——双栈不是炫技,是各管各的命。
交易、鉴权、计量、审计要「事务 + 强一致 + 留痕」,交给 Spring Boot;编排、检索、流式生成要「生态迭代快」,交给 Python。两边靠Nacos 注册发现 + RocketMQ + 网关统一入口解耦,字段名逐字对齐(Python 侧 Pydantic 刻意用驼峰 kbId/docId),少一层命名策略转换,就少一个静默拿到 null 的机会。
代价是两套技术栈、两套发布流程、两套排查手法。一个人同时维护两侧,认知负担是真实的。
决策二:双索引不是叠 buff,是多养一套一致性。
只用 Milvus,语义召回强但型号词弱——"U2"向量化之后和"U3"的距离可能比和"显示器"更近。只用 ES,精确匹配强但口语化描述召回不出来。
两套都上的代价是:每次写文档要双写,而且两边可见性规则不同——Milvus 是 bounded consistency(约 5 秒),ES 的 bulk 默认 refresh=False。验收脚本必须按"可被查到"写,不能按"写入成功"写。
决策三:A2A 自研薄封装,不接现成协作平台。
成熟平台有 Agent 市场、协议兼容、可观测面板。放弃它们换来的是可控:AgentCard 字段、任务状态机、SSE 事件顺序、双主体鉴权,全按自己的业务约束定。
代价是没有生态——新接一个外部 Agent 得自己写适配。对内部中台这笔账划算,对要开放给第三方的平台就不划算。
03 A2A 闭环:一句话怎么变成一张能确认的卡
这一节拆五段:拆维度 → 派发 → 执行 → 聚合 → 确认。每段都回答一个问题:断了会怎样。
3.1 拆维度:不是分句,是判断"这问题归谁管"
系统认四个维度:delivery(送达)、booking(安装预约)、knowledge(商品知识)、service(售后口径)。四个维度对三个 Worker:履约管送达和安装,售后管服务口径,知识管商品知识。
「U2 送到上海要几天,安装能约什么时段,平时怎么保养」被判成 [‘delivery’,‘booking’,‘knowledge’],三个 Worker 同时开工。
如果只按逗号分句会怎样?"平时怎么保养"可能被当成售后工单派给 service Worker——用户问的是知识,被派去查保修政策,答得再流畅也是答非所问。
3.2 派发:先发现,再鉴权,最后才是重试
Worker 不是写死的地址,是注册上来的。启动时各自往 /agents/register 报到,带 AgentCard:会什么、要什么参数、超时多久。编排器用 /agents/search 按能力找人。加一个 Worker,不需要改编排器代码,也不需要往配置里加一行。
鉴权是双主体的:编排器持 service-account 的 JWT,scope 写死 a2a:worker;Worker 只认这个 scope,不认用户 token。用户身份走任务上下文,不走调用凭证。
失败处理分两类,这条规则是踩过坑才定的:
- 400 / 403 / 404 不重试:参数错、没权限、找不到,重试一百次还是错,只把延迟叠三倍
- 5xx / 429 / 超时不重试不行:这是"对方现在忙",重试才真能救回来
3.3 执行:Worker 之间不互相说话
三个 Worker 并行跑,彼此不知道对方存在。这是刻意的——一旦允许 Worker 互调,编排就退化成一张随时打结的网,超时和死锁都从那里长出来。
协作层挂了会怎样?事件被吞掉,产出一条 a2a_unavailable,导购正文照常返回。协作是增强,不是主链路——它挂了不能把一句已经答好的推荐变成错误页。
另外,纯交易查询根本不触发协作。“我的订单到哪了”"余额还有多少"这类问题答案在业务库里,派给 Worker只是多花 30 秒延迟。
3.4 聚合:方案卡是"四行 + 三个状态"
聚合不是把三段文字拼起来,是把三份结构化结果对齐成一张卡:商品行、送达行、安装行、服务说明行。
每行三个状态:已核实 / 本次没涉及 / 未能核实。
中间那格最容易被忽略。「U2 送到上海一般要几天」只问送达,安装那行不该留空、也不该写"暂无",而应明确写"本次没涉及"——用户一看就知道不是查不到,是这次没问。

任务 8f0ce974:商品与送达两行亮绿标,安装与服务时段灰显"本次没涉及"。右栏可见工具"商城类 8 个",管理类对会员隐藏。
3.5 确认:什么时候该打断用户,是有门槛的
判断只有一行:need_confirm = any(d in dims for d in (“delivery”, “booking”))。
送达和安装都是"说了要兑现"的承诺,所以弹卡。商品咨询不是——用户只是问价,不该被要求确认一份方案。
这里有个陷阱:不能按"有金额就弹卡"来判。导购只要查到商品就会带出价格,那会导致每次问价都被打断。
纯知识问题同样不弹。「机械键盘怎么保养」只命中 knowledge,给四条保养建议就收工:

任务 b0f5b516,状态「已完成」而不是「待你确认」。商品行写"本次没有选定商品",条件条只填 1/4——没有确认按钮,因为这次没有任何要兑现的承诺。
只问安装也一样能派:

只问安装时段时的方案卡。安装和送达分属两个 Worker,只问其中一个时另一行显式标"本次没涉及",而不是留空。
3.6 回写:确认之后发生什么
用户点「确认这份方案」,走的不是"AI 帮你下单",而是"AI 把这份计划定下来"。
确认窗口 300 秒。超时任务转 canceled,原因 confirm_expired——这条记录在审计日志里能查到。
卡内那句固定说明值得抄:"确认只是把这份计划定下来。付款和下单仍需你在商品页自行完成,AI 不会代扣、也不会代你下单。"这不是免责声明,是产品边界。
04 RAGAS 闭环:每晚 2:30,它给自己判一次卷
A2A 保证"答得出",这一节保证"验得过"。
4.1 触发:一条 CRON,一个不带业务的执行器
调度在 XXL-JOB,任务 ID 5,CRON 0 30 2 * * ?——每天凌晨 2:30。执行器独立部署,分组 id=3,里面没有任何业务代码,只负责把评测跑起来、把结果写回库。

任务 ID 5、运行模式
BEAN: ragasRegressionJobHandler、状态 RUNNING,页脚 XXL-JOB 2.4.1。
4.2 跑批:先冒烟,再全量
20 条样本 × 3 项指标,一轮 870–905 秒。这个成本决定了必须分两段。
先冒烟:几条必答问题,确认模型和检索都活着。一旦 401 或上游异常就在这一步中止——不拿后面 20 条样本白花钱。冒烟过了才跑全量。
四轮里分别有 3 / 4 / 3 / 2 个 nan 分数,来源是 LLM 裁判超时或解析失败,报告里能看到具体是哪条样本。
4.3 评分:三项分数,各回答一个问题
-
faithfulness:答案里的话,有多少能在检索到的上下文里找到出处。低于 0.80 就是"说得像真的,但没依据"
-
answer_relevancy:答的是不是问的那件事。低于 0.75 通常是答非所问或绕圈子
-
context_precision:召回来的片段里,有多少真相关。低于 0.90 说明检索在浪费上下文预算

四轮 faithfulness 85.6 / 90.8 / 81.7 / 83.1,context_precision 98.8 / 98.8 / 97.5 / 98.8,每轮 870–905 秒,状态全
warn。底部两条告警:warn记"本轮 3 个 nan",critical记"冒烟 401 全量中止"。
四轮全 warn,不是失败。它表示"分数在阈值之上,但没到满分"——把 83.1 和 98.8 涂成同一个绿色,才是真的骗自己。
4.4 门禁:只标记,不阻断
三条线:faithfulness ≥ 0.80、answer_relevancy ≥ 0.75、context_precision ≥ 0.90。跌破记 warn,但不拦发布。
理由很具体:一次模型抖动就能让分数掉几个点。如果门禁自动阻断,你会在某个没改任何东西的早晨被告知"质量不达标,禁止发布"。让机器替你做这个决定,代价比收益大。
正确用法是给人看:连续三轮往下走,才值得停下手上所有事去查。
4.5 兜底:漏跑和跑挂是两件事
漏跑检测按 36 小时阈值扫 run_time 缺口——每天 2:30 该有一条记录,36 小时还没出现,说明调度没触发或执行器掉了。
跑挂有告警,漏跑没有日志可查,只能靠扫。这两个失败面不分开处理,就一定会有一天"评测很安静,但安静是因为它根本没跑"。
05 全景业务:四层视角,一套系统
5.1 会员侧:导购把一句话变成可核对的卡

一切从"你是谁"开始。会员与员工两套账号体系,商城侧走
app=SHOP,进不来后台任何一页。

商城商品列表页,会员进入购物的第一屏。

第一个问题进来时,顶部已在收集条件,右侧「当前会话」标着身份与"可见工具 商城类 8 个",红字说明管理类工具已对会员隐藏。

场景说清楚(家用)之后,候选在场景维度内收敛。

加购是 C 端自己的动作,AI 只负责把商品选对、把价格和库存核实清楚。

多件组合场景,同一单里合并算账。

改口数量之后重新出预览:上一轮签发的 token 直接作废,不会出现"价格是旧的、数量是新的"。

订单 SO2026110600000001,¥597.00(199 × 3),余额 ¥79,816.00,状态「进行中」。三个快捷按钮:改数量再预览 / 看余额 / 换一款。
5.2 员工侧:知识问答的三条边界

答案分三段带 [1][2][3]:住宿 400 元/晚、补贴 100 元/天、业务招待人均 ≤200 元。顶部显示会话 5e41629e、知识库「企业内部知识库」、记忆状态「窗口 2 轮 / 尚未触发压缩」。

问自己的用量。这类问题走工具调用拿实时值,不走知识检索——同一条链路,答案来源不同。

域外提问的表现是给边界而不是给答案。拒答能力是 RAG 能不能上线的分水岭。
5.3 租户管理员:治理面全貌

左侧 12 项治理菜单加末尾的「RAGAS 回归」;"今日限流(429)"与"今日鉴权拒绝"是两个独立计数器,说明限流和鉴权分开埋点。

环形图最大的一块是「重排」,之后才是 qa_intent_route、充分性判定、shop_kb、文档向量化、查询向量化、memory_index。日常问答的 Token 大头不是 embedding,是精排。
这张图解释了一个代码取舍:召回 40 条全送精排,质量或许能再好一点,成本会翻几倍。先看到钱花在哪,才谈得上该不该省。

三个知识库,选中"企业内部知识库";副标题写明向量模型 text-embedding-v3、维度 1024、分块 500/80、PUBLIC;表内 id13 已索引 26 分块 13.4 KB、id10 已索引 38 分块 21.0 KB。

三个角色 + Casbin 粗粒度策略表 +
sys_permission权限目录(qa:ask、kb:write、doc:upload、kb:manage-all、user:manage、role:manage、system:config、tenant:manage、usage:read-all、audit:read、shop:manage)。前端按码显隐,后端再拦一次。

顶部四行说明本身就是设计文档:deny 优先、有 ALLOW 即白名单(无命中即拒)、无策略默认放行、影子策略只记 WARN 不真拦。当前"暂无策略"。

表里能看到 A2A 完整生命周期:CREATED → DISPATCH → COMPLETED 各一条,另有两条 A2A_CANCEL 详情写
confirm_expired;多数 detail 带dryRun: true,说明当时跑在影子模式。

员工账号管理页。员工与商城会员分属两套表,这一页管员工。

商品主数据维护入口,上下架与价格库存都从这里改。

后台订单视角,与会员侧"我的订单"同源、权限不同。

会员管理。
shop_user自增起点设成 10 亿,与员工sys_user的 ID 空间物理隔开。
5.4 平台超管:只有这一层能看到的四个页面

多租户管理,只对平台超管开放。租户是所有隔离的第一层:知识库、记忆、用量、限流都按
tenant_id切。

会员余额调整,平台超管专属。这一页在权限矩阵里专门验证过:租户管理员手输 URL 也会被后端拦——前端隐藏不算数。

会员侧"我的订单",C 端查看履约进度的入口。

后台用量统计,与看板同一份计量,按租户与时间切片。

会员自己的用量视图——同一套计量,收敛到本人可见。
06 项目亮点代码:四段最值得抄的
亮点 1 · 混合检索用 RRF 融合,绕开分数归一化
ai-intel-platform/app/rag/retriever.py
_RRF_K = 60
def _rrf_fuse(vec_hits, bm_hits):
”””RRF 只看排名不看原始分数:score(d) = Σ 1/(k + rank)。
天然规避「余弦相似度 0~1、BM25 无上界、两路不可比」的归一化难题。”””
fused = {}
for origin, hits in ((”vector”, vec_hits), (”bm25”, bm_hits)):
for rank, hit in enumerate(hits, start=1):
slot = fused.setdefault(hit[”id”], {”rrf”: 0.0, ”doc”: hit})
slot[”rrf”] += 1.0 / (_RRF_K + rank)
return sorted(fused.values(), key=lambda d: d[”rrf”], reverse=True)
# 两路并行召回,都带 tenant_id,召回严格限定在本租户内
vec_hits, bm_hits = await asyncio.gather(
milvus_store.search(vec, kb_id=kb_id, tenant_id=tenant_id, limit=candidate_k),
es_store.search(query, kb_id=kb_id, tenant_id=tenant_id, limit=candidate_k),
)
rerank_pool = _rrf_fuse(vec_hits, bm_hits)[:max(top_k * 2, 10)]
设计思考:向量分数和 BM25 分数量纲完全不同,直接加权求和是常见坑。RRF 只比排名,天然归一化。融合后只把 top_k*2(至少 10 条)送精排——不是舍不得,是看板那张 Token 分布图告诉我的:重排是成本第一大块,全量送精排会让单次问答成本翻几倍。
亮点 2 · 确认卡的两行判断,背后是一条产品约束
ai-intel-platform/app/a2a/service.py
# 只有「要用户点头的承诺」才弹确认卡:排送达 / 约时段需要用户确认才算定下来。
# 纯知识咨询(例:这屏怎么保养)不该弹「合计 ¥1,599 确认这份方案」——
# 用户没要下单,弹金额卡等于变相推销。
# 注意 amount_fen 不能单独触发:导购查到商品就会带价格,那会让每次问价都弹卡。
need_confirm = any(d in dims for d in (”delivery”, ”booking”))
if need_confirm:
await store.update_task(task_id, tid, {”state”: models.STATE_INPUT_REQUIRED})
设计思考:any(…) 里刻意不含 knowledge 和 amount。确认卡是资金安全链条上最后一道人闸,一道被无视的闸等于没有——所以宁可少弹,也不能让它变成每次问价的固定流程。
亮点 3 · 两段式下单:confirm 只收 token,一个业务参数都不收
ai-business-service/…/shop/service/OrderService.java
public ActionResult confirmCreate(ShopPrincipal p, String confirmToken) {
String token = trimToken(confirmToken);
ConfirmSnapshot snap = tokenStore.consume(token);   // GETDEL:事务外先消费
if (snap == null) {
ActionResult replay = tokenStore.readResult(token);  // 重复提交回放首次结果
if (replay != null) return replay;
throw new ShopBizException(ShopErrorCodes.TOKEN_INVALID, ”确认令牌无效或已过期”);
}
assertAction(snap, ConfirmSnapshot.ACTION_CREATE);
assertSameIdentity(snap, p);
ActionResult result = self.doCreateOrderTx(p, snap, token);
tokenStore.storeResult(token, result);
return result;
}
设计思考:方法签名只有身份和 token,没有商品、价格、数量。令牌在事务外先消费——即使事务回滚,令牌也已作废,不可能被重放二次扣款。snap == null 时先查结果缓存,网络抖动导致的重复提交既不报错也不重复扣钱。一旦 confirm 收参数,这一切都不成立。
亮点 4 · 协作层是增强,不是主链路
ai-intel-platform/app/shop/agent.py
def _a2a_should_collab(intent: str, question: str) -> bool:
”””是否该发起多 Agent 协作。
两道条件:意图属于「商品相关」或「客服口径」,且问句里出现了协作维度关键词
(送达/安装/保养)。订单、余额、取消这类纯交易查询不触发——答案在业务库里,
派发给 Worker 只会多花 30s 延迟。
”””
if not settings.A2A_ENABLED:
return False
if intent not in (”recommend”, ”detail”, ”stock”, ”compare”, ”purchase”,
”clarify”, ”knowledge”):
return False
return a2a_service.needs_collab(question)
设计思考:三行判断是三层防线——开关(影子模式可整体关)、意图(交易类根本进不来)、关键词(没有协作维度就别派)。只留关键词,"余额还有多少"里的"多少"就可能误派;只留意图,"推荐个送得快的"会白触发三个 Worker。
07 项目经验:九个坑,换一个环境照样会踩
- Spring Boot 4 默认是 Jackson 3,不是 Jackson 2。 自动装配的是
tools.jackson.databind.ObjectMapper,按老包名注入直接失败。JWT 库选 nimbus-jose-jwt,它不绑 Jackson 版本,正好避开 2/3 并存。 - MyBatis-Plus 必须用 boot4 专用 starter。 普通 starter 跑不了 Boot 4,得换
mybatis-plus-spring-boot4-starter(3.5.17)。 - 网关 starter 改名,配置命名空间也变了。 是
spring-cloud-starter-gateway-server-webflux,yml 走spring.cloud.gateway.server.webflux.routes,不是老坐标。 - RocketMQ 跨语言是"两条协议、一个 broker"。 Java remoting 连 namesrv 9876;Python 5.x gRPC 连 proxy。两个端口、两套重连逻辑,配错一边一条消息都收不到。另外
receive()/ack()会阻塞,必须独立线程 +asyncio.run_coroutine_threadsafe把结果丢回事件循环。 - Milvus 写后有 bounded-consistency 窗口。 upsert 后立刻 query 可能读到旧值,实测约 5 秒;导入自检要么等,要么传
consistency_level="Strong"。ES 侧bulk默认refresh=False,管线里要显式refresh_index()。 - Nacos 空 namespace
''和字面量'public'是两个租户。 Java 侧留空会自动归一化,Python 侧 2.0.11 必须显式写"public"——两侧刻意不对称。排查别信 SDK 缓存,直接查 admin API。 - 前端 SSE 用
fetch + ReadableStream,不用 EventSource。 后者只支持 GET 且不能带 Authorization 头,问答是 POST + JWT,只能手工读流按\n\n切帧。 - XXL-JOB 执行器没有 web 依赖,进程起来就退出。 非 Web 应用主线程跑完就结束——不是崩溃,是没事干。加
spring-boot-starter-web保活,只为占住主线程。 - 金额全链路用"分"整数(BIGINT),禁用浮点。 前端"元"转"分"再传,M3 单价存的就是 19900。拿小数当金额是必踩的坑。
08 边界与下一步:不做什么,和做了一样重要
这套系统有意识地不做这些:
- 不做代客下单、不做自动扣款——AI 只有 preview,confirm 端点不对 Agent 暴露,能力边界写死在协议里
- 不做生产级高可用——单机单副本,面向开发与演示;真要分布式,得换共享对象存储、加 Sentinel 熔断、上 Nacos 配置中心
- 不做 A2A 全量强制——
A2A_ENFORCE=false影子模式先跑,事件照记、不真拦,看两周日志再收口 - 不做门禁自动阻断——回归跌破阈值只记
warn,人来看趋势,机器不替你做发布决定
灰度开关留了五组:Casbin、配额、条件访问、下单限额、A2A 派发,默认全"只记录不拦"。先观察、后收口,这是企业级发布的标准动作。
写在最后
回头看,这套中台最值钱的不是哪段代码,而是三句判断:
- AI 进业务系统,先解决"能不能碰钱、碰了谁负责",再谈模型效果;
- 答得出靠 A2A 把一句话拆给三个 Agent 再收回来,验得过靠 RAGAS 每晚替它判一次卷——少一个闭环,它就只是能演示;
- 灰度永远先于强制:影子模式跑一阵,再打开闸门。
少任何一个闭环,这套系统就还是一套只能演示的东西。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
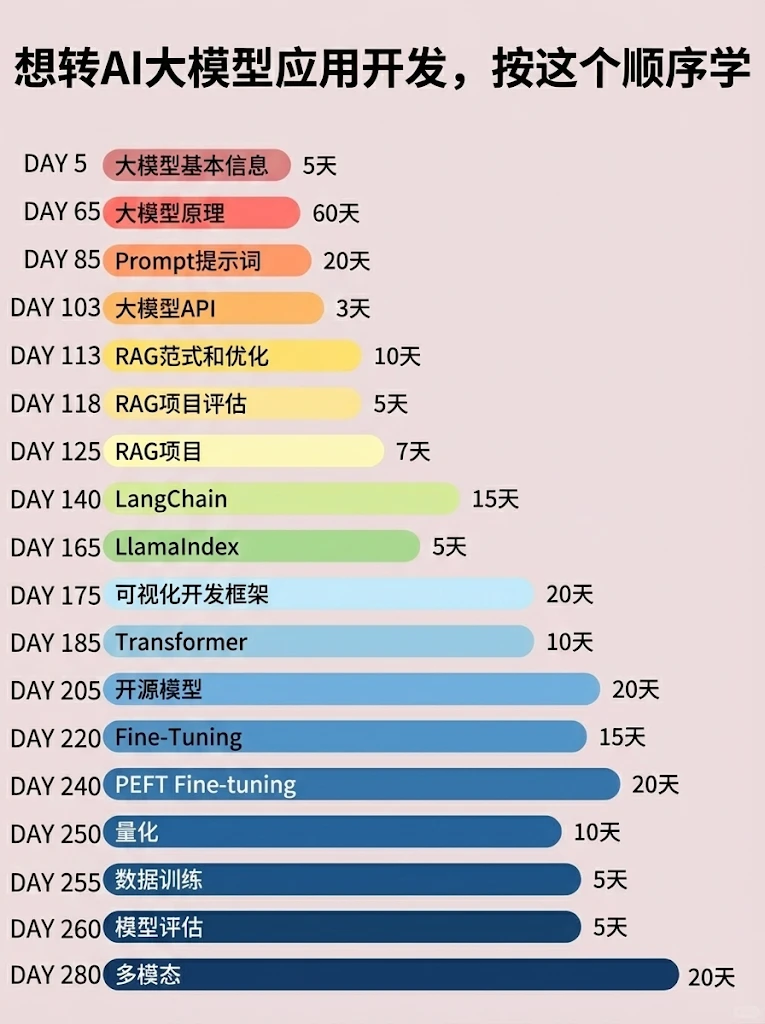
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

更多推荐

 1
 0
- 0


 已为社区贡献20条内容

所有评论(0)