
大模型人才盘点:AI Infra 真是黄金赛道,小白也能入局!
文章指出,在大模型领域,AI基础设施(AI Infra)工程人才比算法人才更为稀缺。全球范围内,AI Infra 工程师需求高达10万人以上,而合格供给仅为2.5万至3.4万人,供需比仅为1:8.6。在中国,AI Infra核心工程人才的活跃供给不到1000人,而企业需求超过8200人。文章还分析了全球和中国主要大模型公司的团队规模和代表模型,以及猎头和候选人在大模型人才招聘中的判断依据。对于想要进入大模型领域的小白或程序员,AI Infra是一个值得关注的黄金赛道。
大模型人才盘点:AI Infra 才是真缺口
先说一句实在话:"大模型算法 / AI Infra 总人数"目前没有单一权威口径,下文分"硬数据"与"合理估算"标注,来自猎头数据,供招聘判断&求职判断
这几年招聘大模型岗位,发现一个反直觉的事实——卡住项目的往往不是算法,是 GPU 集群跑不起来、推理成本高到吐血。
先抛一组数字:中国 AI Infra 核心工程人才,近 6 个月有看机会意愿的活跃供给不到 1000 人,企业需求 8200+,供需比 1:8.6;算法研究员是 1:4.5。
比算法研究员更缺的,是能让模型真正跑起来的 AI Infra 工程人才。
下面这份盘点,从全球到国内,把"人到底在哪、缺在哪、多少钱、往哪挖"讲清楚。

一、全球:能训前沿模型的人,不到 1 万
先界定两层:
真正前沿的研究员层
(能推进基础模型能力边界):全球< 10,000 人。业内甚至有观点称,真正"从 0 到 1 训过模型"的只有几百人。
五大前沿实验室
(OpenAI / Anthropic / Google DeepMind / Meta FAIR / xAI)合计研究员 + 工程师≈ 7,000+:OpenAI ~1,500|Anthropic ~800|DeepMind ~2,000|Meta FAIR ~1,500|xAI ~800。
放到广义"大模型算法"(含训练 / 对齐 / 后训练 / 多模态算法):
训练 / 对齐方向:需求 45,000 / 供给 8,000,缺口率82%。
更宽的口径(含所有 AI 岗):全球 AI 相关岗位总需求 ~320 万,合格供给 ~65 万。
结论(全球):狭义能训前沿模型的核心算法人才< 1 万;广义大模型算法工程师是4.5 万需求 vs 8 千供给的池子——这是各家 recruiter 抢破头的地方。
二、AI Infra:2026 缺口显著的工程方向
AI Infra 是什么?一句话:让 GPU 集群跑得动、训得快、推得省的那层工程。具体是 GPU 集群管理、分布式训练框架(Megatron / DeepSpeed / FSDP)、高性能网络(InfiniBand / RoCE)、推理优化(量化 / 投机解码 / KV-cache)。
| 口径 | 需求 | 合格供给 |
|---|---|---|
| AI Infra / 系统工程 | 120,000 | 25,000 |
| AI Infrastructure Engineer(在招) | 78,000 | 34,000 |
| 全球 ML 工程师总量(含广义) | — | 200,000–300,000 |
结论(全球):
严格定义下(生产级、能管千卡 / 万卡集群的 AI Infra 工程人才),全球供给仅约 2.5 万–3.4 万。
需求 ~10 万+,缺口率 75–80%。JustSaid 直言:缺口明显的岗不是研究员,是 ML Infra 工程师。
广义 ML Infra / MLOps 全球约 20–30 万,但其中能碰大模型规模的"低几千人"。
三、中国盘面:核心模型人才约 1–1.5 万,Infra 活跃供给不到 1000
先看大盘:
中国 AI 研究员约 3.9 万(另有蓝皮书口径 5.2 万 / 2024)。
脉脉薪酬:AI 科学家 / 负责人月薪132,796 元;算法研究员74,441 元;AI Infra 工程师 73,702 元。
智联 / 猎聘(2026 H1):AI 工程师需供比2.62,算法工程师 TSI 紧缺指数2.64;汽车研发 AI 工程师需供比高达8.2。
大模型算法各岗供需:
| 岗位 | 企业需求(人) | 活跃人才(人) | 供需比 |
|---|---|---|---|
| 大模型算法研究员 | 12,500 | 2,800 | 1:4.5 |
| AI Infra 架构师 | 8,200 | 950 | 1:8.6 |
| 大模型应用开发 | 18,600 | 9,200 | 1:2.0 |
| Prompt / 对齐工程师 | 6,400 | 2,100 | 1:3.0 |
| 大模型产品经理 | 9,300 | 4,600 | 1:2.0 |
结论(中国):
真正训过模型的核心人才约 1 万–1.5 万
,高度集中在字节 Seed、阿里通义、腾讯混元、智谱、DeepSeek。
AI Infra 核心工程人才(GPU 集群 / 分布式训练 / 推理优化)活跃供给 < 1,000,总需求 8,200+,是缺口显著的方向(供需比 1:8.6)
。
招聘增长(2026 H1):AI Infra 工程岗+82%、基础模型研发+45%、应用开发+113%。
四、谁在养人:公司图谱
全球头部实验室(团队规模多为 2025–2026 推算,取区间):
| 公司 | 代表模型 | 总人数(估) | 核心人物 |
|---|---|---|---|
| OpenAI | GPT-5.6 / 5.5 | ~3,500–4,500 | Sam Altman、Greg Brockman、Jakub Pachocki |
| Google DeepMind | Gemini | ~6,000+ | Demis Hassabis、Koray Kavukcuoglu |
| Meta AI / FAIR | Llama | ~3,000+ | Yann LeCun |
| xAI | Grok | ~1,000+ | Elon Musk、Igor Babuschkin |
| Anthropic | Claude Fable 5 | ~1,200–5,000 | Dario Amodei |
中国自研基座(按综合实力):
| 公司 | 代表模型 | 团队规模(估) | 核心人物 |
|---|---|---|---|
| 字节 Seed / 豆包 | 豆包 5.0 / Seed 2.0 Pro | ~2,000+(国内头号基座团队) | 吴永辉(前 Google Fellow)、周畅、郭达雅 |
| 阿里 通义 | Qwen3.6-Plus | ~1,000+ | 周靖人、张迪、周浩(前 DeepMind) |
| 腾讯 混元 | 混元 3.0 | ~1,500+ | 姚顺雨(前 OpenAI 研究员) |
| 智谱 AI | GLM-5.1 | ~700–800 | 唐杰、张鹏 |
| DeepSeek | V4-Pro(MoE 1.6T,开源) | ~200–300 | 梁文锋 |
| 月之暗面 | Kimi K2.5 / K3 | ~250–800 | 杨植麟 |
| 阶跃星辰 | Step 系列 | ~240–300 | 姜大昕、张祥雨(ResNet 作者) |
| MiniMax | M2.5 / ABAB 6.5 | 385 | 闫俊杰、赵鹏宇 |
中国 8 家大模型独角兽合计 ML 研究员约 1,600–2,400。字节 Seed 是当之无愧的"中国 AI 黄埔军校",近一年字节离职员工创立了 30+ 家 AI 公司,大量人才流向腾讯 / 阿里 / 创业公司。
五、给猎头和候选人的 5 个判断
挖 AI Infra 比挖算法性价比更高、竞争更小。
全球供给 2.5–3.4 万 vs 需求 10 万+;中国活跃供给 <1,000、供需比 1:8.6。同样是稀缺,Infra 的"被抢烈度"反而低一档。
核心人才高度集中,盯住那几家。
字节 Seed(2000+)、阿里通义、腾讯混元、智谱、DeepSeek。挖人不是广撒网,是定点突破。
热点方向看招聘指数:
大模型后训练(171) > 预训练(151) > 推理优化(121) > 高性能计算 / 算子(113) > 强化学习(109) > AI Infra(90)。后训练 / 推理优化是当前最缺的细分。
核心人才流动性极高,这是挖角窗口。
吴永辉(Google→字节)、姚顺雨(OpenAI→腾讯)、周浩(DeepMind→阿里)、乔思远(字节→Meta)、蒋路(字节→Apple)——中美 + 大厂之间来回跳。
价格参考(年薪):
中国头部研究员 200–500 万 RMB;资深工程师 100–250 万;名校 AI 博士应届 60–120 万。硅谷同级别总包 2–5M USD(含股权)。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
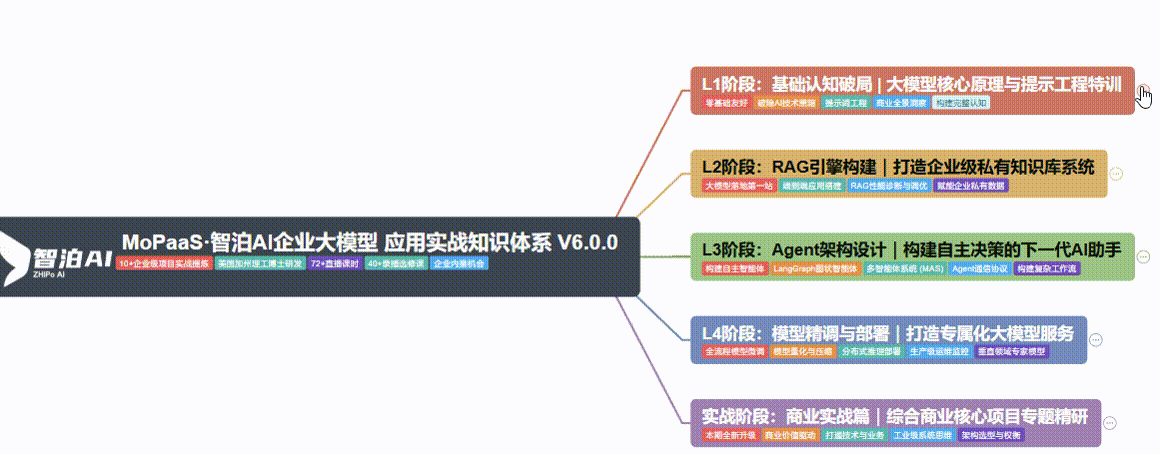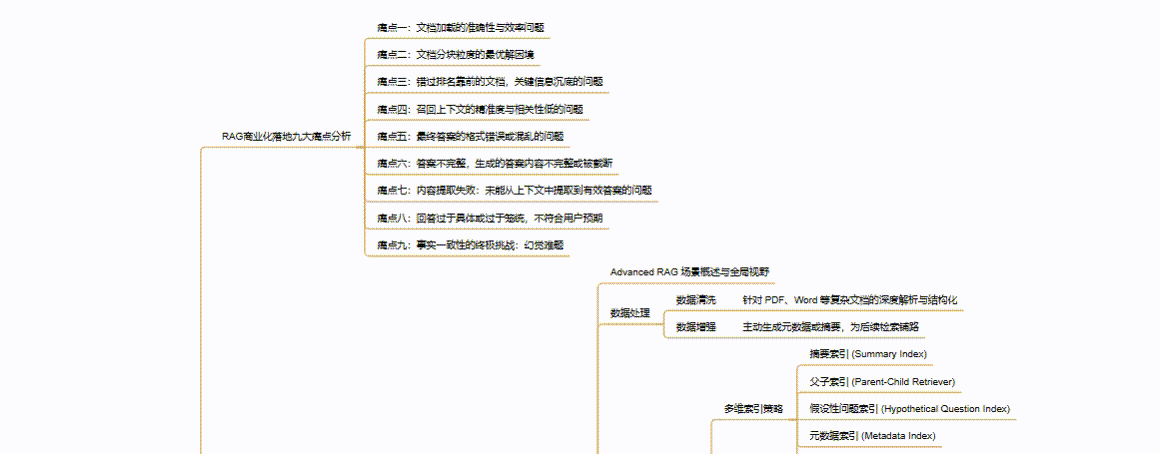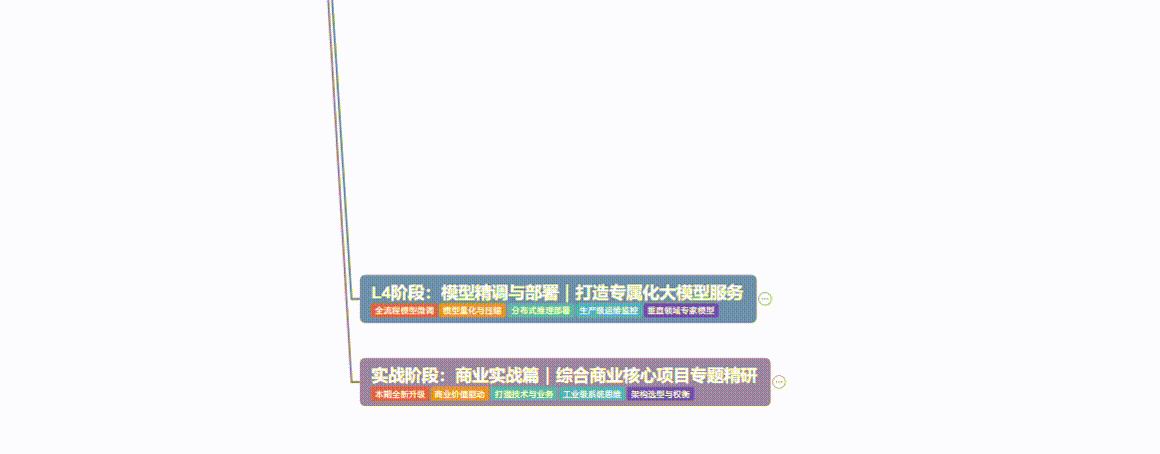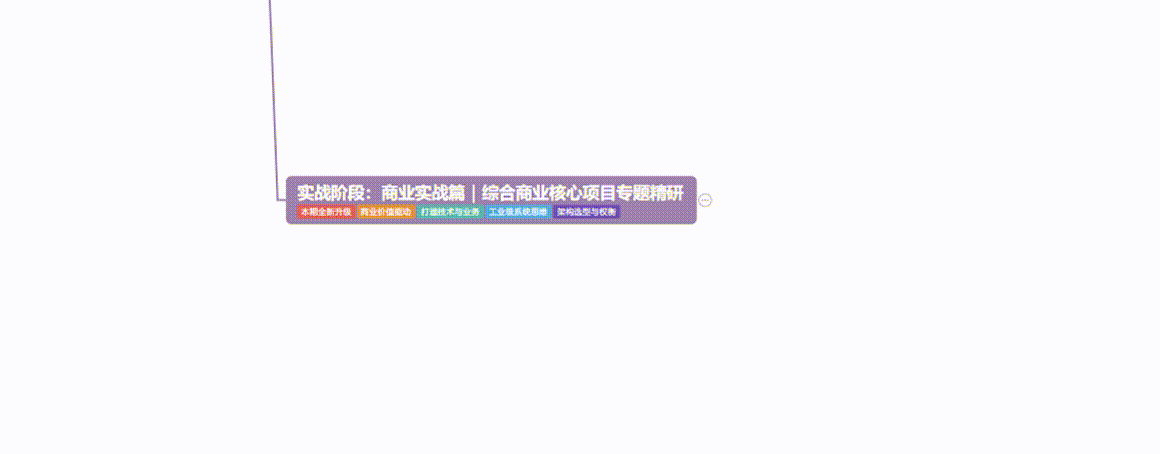
1、大模型系统化学习路线
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
更多推荐


 4
 0
- 0


 已为社区贡献48条内容

所有评论(0)