
新手必看:用50行代码快速入门ReAct大模型Agent(收藏版)
本文深入浅出地介绍了ReAct大模型Agent的核心原理,通过50行代码实例展示了最小Agent的实现过程,并详细讲解了Prompt设计技巧。此外,还探讨了工程化时需要注意的状态持久化、错误恢复、人工介入及成本控制等问题,帮助读者快速掌握大模型Agent开发的关键要点,适合小白和程序员学习参考。

一、ReAct 到底是什么
ReAct = Reasoning + Acting
它让模型在推理和行动之间交替:先判断下一步该做什么,再调用工具,再根据观察结果继续。
说实话,ReAct 是理解 Agent loop 的入门框架。但工程里不要迷信"让模型一直想"——你真正要设计的是工具、状态、停止条件、错误恢复和 trace。
二、基本模式
经典的 ReAct 格式是这样的:
 Question: ...
Thought: I need to search for evidence.
Action: search(query="...")
Observation: ...
Thought: The evidence is enough.
Final Answer: ...
但真实系统建议不要存完整的 Thought,而是存可审计的摘要。不然模型想太多,不仅费 token,还容易跑偏。
2.1 可审计的 Trace 格式
 {
  "step": 2,
  "action": "search",
  "args": {"query": "agentic rag evaluation"},
  "reason_summary": "Need external evidence before comparing methods.",
  "observation_summary": "Found 5 papers from 2024-2025."
}
这样既保留了可追溯性,又不会让模型的思考过程膨胀到失控。
三、50 行代码实现一个最小 Agent
话不多说,直接上代码。这段代码能让你看清 Agent loop 的完整过程。

3.1 最小实现
 def react(task, model, tools, max_steps=6):
    trace = []
    observations = []

    for step in range(max_steps):
        prompt = build_prompt(task, tools, observations)
        decision = model.generate_json(prompt)

        if decision["type"] == "final":
            return {
                "answer": decision["answer"],
                "trace": trace,
                "status": "completed",
            }

        tool_name = decision["tool"]
        if tool_name not in tools:
            obs = {"ok": False, "error": "unknown_tool"}
        else:
            args = decision.get("args", {})
            tool = tools[tool_name]
            obs = tool(args)

        observations.append(obs)
        trace.append({
            "step": step + 1,
            "tool": tool_name,
            "args": decision.get("args", {}),
            "observation": summarize(obs),
        })

    return {
        "answer": None,
        "trace": trace,
        "status": "max_steps_exceeded",
    }
3.2 代码深度解读
这段代码虽然短,但包含了 Agent 的核心逻辑:
初始化阶段:
trace = []:记录每一步的决策,用于调试和审计observations = []:保存工具返回的结果,用于上下文构建
循环阶段:
for step in range(max_steps):最多执行 max_steps 步,防止无限循环build_prompt(task, tools, observations):构建 prompt,包含任务、工具、历史观察model.generate_json(prompt):模型根据当前状态生成下一步决策
决策分支:
if decision["type"] == "final":模型决定结束,返回答案和 traceelse:模型决定调用工具,执行工具调用
工具调用:
if tool_name not in tools:工具不存在,返回错误else:工具存在,执行工具调用,获取观察结果
记录阶段:
observations.append(obs):保存观察结果,用于后续上下文trace.append({...}):记录这一步的决策和结果
异常处理:
- 超过最大步数,返回
max_steps_exceeded状态 - 工具不存在,返回错误信息
3.3 数据流分析
 Task (用户任务)
  ↓
Prompt Builder (构建 prompt)
  ├─ Task
  ├─ Tools (工具列表)
  └─ Observations (历史观察)
  ↓
Model (模型决策)
  ├─ Type: tool_call | final
  ├─ Tool: 工具名称
  ├─ Args: 工具参数
  └─ Answer: 最终答案
  ↓
Tool Executor (执行工具)
  ├─ Tool Name
  ├─ Args
  └─ Observation (观察结果)
  ↓
Trace Recorder (记录 trace)
  ├─ Step
  ├─ Tool
  ├─ Args
  └─ Observation Summary
  ↓
Return (返回结果)
  ├─ Answer
  ├─ Trace
  └─ Status
3.4 关键设计决策
为什么用 JSON 格式?
- 结构化输出,容易解析
- 类型明确,减少错误
- 易于扩展,可以添加新字段
为什么限制最大步数?
- 防止无限循环
- 控制成本
- 强制模型在有限步数内完成任务
为什么记录 trace?
- 调试:出问题时可以查看每一步的决策
- 审计:可以追踪 Agent 的行为
- 优化:可以分析哪些步骤可以优化
为什么 summarize observation?
- 控制上下文长度
- 提取关键信息
- 减少干扰
四、Prompt 设计技巧
Prompt 是 Agent 的灵魂。好的 Prompt 能让模型更聪明,坏的 Prompt 能让模型发疯。

4.1 推荐的 Prompt 结构
 You are an agent that solves the task by calling tools.

Rules:
- Use only the listed tools.
- Stop when enough evidence is collected.
- If evidence is missing, say what is missing.
- Never fabricate tool results.

Task:
{task}

Tools:
{tool_cards}

Previous observations:
{observations}

Return JSON:
{
  "type": "tool_call | final",
  "tool": "tool name or null",
  "args": {},
  "answer": "final answer or null",
  "reason_summary": "short auditable reason"
}
4.2 Prompt 各部分深度解析
System Role(系统角色)
You are an agent that solves the task by calling tools.
- 明确 Agent 的角色:一个通过调用工具解决问题的智能体
- 设定 Agent 的行为模式:调用工具、观察结果、推进任务
Rules(规则)
 - Use only the listed tools.
- Stop when enough evidence is collected.
- If evidence is missing, say what is missing.
- Never fabricate tool results.
- 限制工具使用:只能使用列出的工具,不能编造工具
- 明确停止条件:收集到足够证据就停止
- 处理缺失信息:如果证据缺失,明确说明缺失什么
- 禁止编造:不能编造工具结果,必须基于真实观察
Task(任务)
{task}
- 清晰描述任务目标
- 包含任务约束(如预算、时间)
- 明确成功标准
Tools(工具列表)
{tool_cards}
每个工具卡片包含:
- 工具名称:清晰、具体、无歧义
- 工具描述:能做什么,不能做什么
- 参数定义:参数类型、范围、默认值
- 返回值:返回什么,格式是什么
- 示例:如何调用,返回什么
Previous Observations(历史观察)
{observations}
- 记录之前的工具调用和结果
- 用于上下文构建
- 帮助模型理解当前状态
Return JSON(返回格式)
 {
  "type": "tool_call | final",
  "tool": "tool name or null",
  "args": {},
  "answer": "final answer or null",
  "reason_summary": "short auditable reason"
}
type:决策类型,工具调用或结束tool:工具名称,如果 type 是 final 则为 nullargs:工具参数,如果 type 是 final 则为空answer:最终答案,如果 type 是 tool_call 则为 nullreason_summary:简短的可审计理由
4.3 关键设计原则
- 规则要明确
别写"尽量不要…“这种模糊的话,直接写"禁止…”、“必须…”。
反例:
 - Try to use the listed tools.
- Stop when you think you have enough evidence.
正例:
 - Use only the listed tools.
- Stop when enough evidence is collected.
- 工具描述要具体
别写"查数据",要写清楚:
- 工具能做什么
- 参数是什么,类型是什么
- 返回什么
- 举个例子
反例:
search: 查数据
正例:
 search: 搜索互联网上的信息
参数:
  query: 搜索关键词(字符串,必需)
  num_results: 返回结果数量(整数,可选,默认 5)
返回:
  results: 搜索结果列表,每个结果包含 title、url、snippet
示例:
  输入: {"query": "AI Agent", "num_results": 3}
  输出: {"results": [{"title": "...", "url": "...", "snippet": "..."}]}
- 格式要严格
让模型返回 JSON,并且明确每个字段的含义。最好给个示例,模型更容易理解。
反例:
Return your decision.
正例:
 Return JSON:
{
  "type": "tool_call | final",
  "tool": "tool name or null",
  "args": {},
  "answer": "final answer or null",
  "reason_summary": "short auditable reason"
}

Example:
{
  "type": "tool_call",
  "tool": "search",
  "args": {"query": "AI Agent"},
  "answer": null,
  "reason_summary": "Need to search for information about AI Agent."
}
- 限制思考长度
不要让模型写长篇大论的思考,只让它写 reason_summary——一句话说明为什么选这个工具。
反例:
thought: I need to search for information about AI Agent. Let me think about what keywords to use. Maybe "AI Agent" or "autonomous agent". I'll start with "AI Agent" and see what I get.
正例:
reason_summary: Need to search for information about AI Agent.
4.4 Prompt 优化技巧
技巧 1:使用 Few-Shot Examples
给模型几个示例,让它理解如何调用工具。
 Example 1:
Task: What is the weather in Beijing tomorrow?
Decision:
{
  "type": "tool_call",
  "tool": "search_weather",
  "args": {"city": "Beijing", "date": "tomorrow"},
  "answer": null,
  "reason_summary": "Need to check weather forecast for Beijing tomorrow."
}

Example 2:
Task: Summarize the latest news about AI.
Decision:
{
  "type": "tool_call",
  "tool": "search_news",
  "args": {"query": "AI", "num_results": 5},
  "answer": null,
  "reason_summary": "Need to search for latest AI news to summarize."
}
技巧 2:使用 Chain-of-Thought
让模型先思考,再行动。
 Think step by step:
1. **What do I need to do?**

2. **Which tool can help?**

3. **What parameters does the tool need?**

4. **What do I expect the tool to return?**

Then make your decision.
技巧 3:使用 Reflection
让模型反思之前的决策。
 After each tool call, reflect:
- Did the tool return what I expected?
- Do I have enough information to answer the question?
- What should I do next?

If the tool failed or returned unexpected results, try a different approach.
技巧 4:使用 Self-Correction
让模型自我纠正错误。
 If you make a mistake:
1. **Acknowledge the mistake.**

2. **Explain why it was a mistake.**

3. **Propose a correction.**

4. **Execute the correction.**

Example:
Mistake: I called the wrong tool.
Correction: I should have called search_weather instead of search_news.
Action: Call search_weather with the correct parameters.
五、工程化注意事项
上面的代码只是一个最小实现。真实项目中,你还需要考虑这些问题:
5.1 状态持久化
长任务需要持久化状态,不然 Agent 重启后就忘了之前做了什么。
我之前做过一个代码修复 Agent,改到第三步就忘了第一步改了什么——因为状态只存在内存里,重启后全丢了。后来用 LangGraph 的持久执行,问题就解决了。
5.2 错误恢复
工具调用可能失败,网络可能超时,模型可能返回格式错误。你需要:
- 重试机制
- 超时控制
- 格式校验
- 降级方案
5.3 人工介入
有些高风险操作需要人工确认,比如发邮件、删文件、付款。你需要:
- 权限分级
- human-in-the-loop 机制
- 审核日志
5.4 成本控制
模型调用和工具调用都要花钱。你需要:
- Token 预算控制
- 缓存机制
- 成本监控
六、常见坑
坑一:让模型想太多
模型的思考过程会消耗大量 token,而且不一定有用。建议只记录 reason_summary,而不是完整的 chain-of-thought。
坑二:工具返回值太长
工具返回 10MB 的原始数据,模型根本处理不过来。建议:
- 返回摘要
- 分页返回
- 只返回关键信息
坑三:没有停止条件
Agent 可能无限循环搜索信息。建议:
- 设置最大步数
- 设置时间限制
- 让模型自己判断是否停止
坑四:没有 trace
出问题时不知道模型做了什么,根本无法调试。一定要记录完整的 trace。
七、从 50 行代码到生产级系统
上面的代码只是一个起点。要做成生产级系统,你需要:
-
1. 状态管理:用 LangGraph 或类似框架管理复杂状态流
-
2. 持久化:把状态和 trace 存到数据库
-
3. 安全:权限分级、审计日志、数据脱敏
-
4. 评测:构造 eval case,持续评估 Agent 效果
-
5. 监控:监控延迟、成本、成功率
-
6. 运维:部署、扩容、故障恢复
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。我们整理出这套 AI 大模型突围资料包:
- ✅ 从零到一的 AI 学习路径图
- ✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
- ✅ 百度/阿里专家闭门录播课
- ✅ 大模型当下最新行业报告
- ✅ 真实大厂面试真题
- ✅ 2026 最新岗位需求图谱
所有资料 ⚡️ ,朋友们如果有需要 《AI大模型入门+进阶学习资源包》,下方扫码获取~
① 全套AI大模型应用开发视频教程
(包含提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
② 大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
③ 大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
④ AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
⑤ 大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
⑥ 大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
以上资料如何领取?
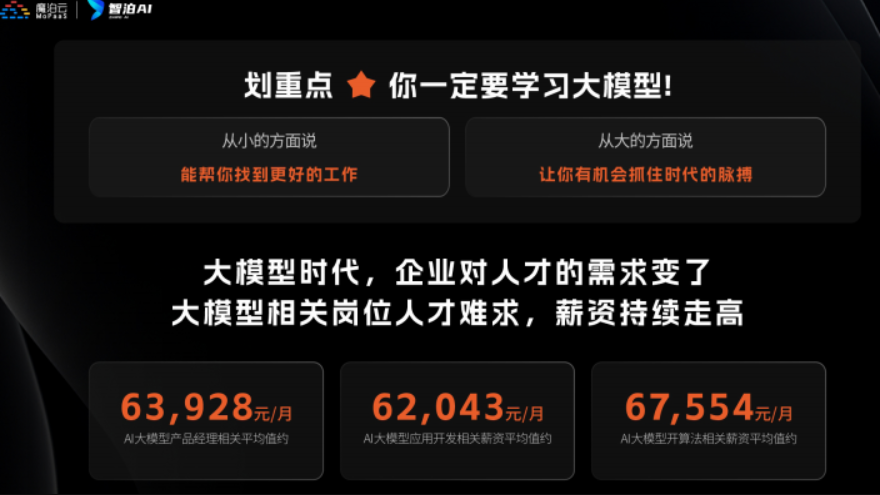
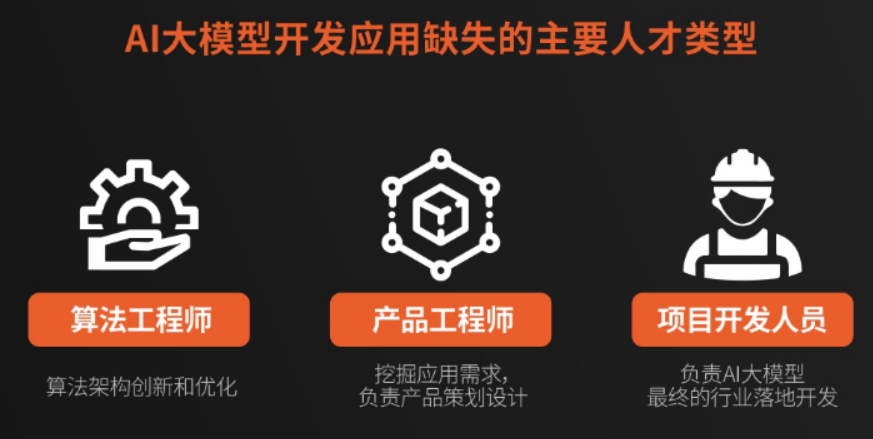
为什么大家都在学大模型?
最近科技巨头英特尔宣布裁员2万人,传统岗位不断缩减,但AI相关技术岗疯狂扩招,有3-5年经验,大厂薪资就能给到50K*20薪!
不出1年,“有AI项目经验”将成为投递简历的门槛。
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
这些资料真的有用吗?
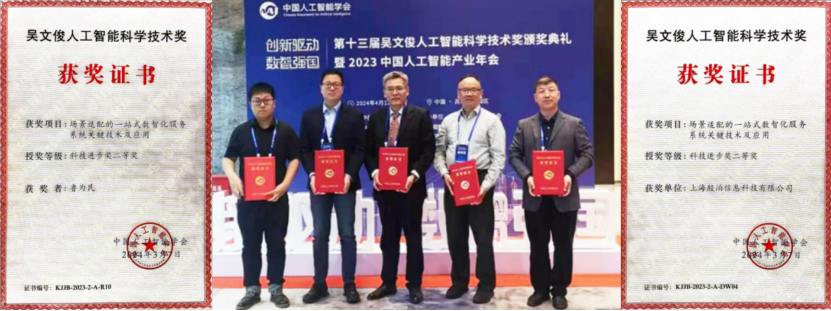
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
以上全套大模型资料如何领取?
更多推荐

 0
 0
- 0


 已为社区贡献18条内容

所有评论(0)