DeepSeekHarness源码到底有多强?从入门到进阶:Cordis设计哲学 + 自我进化 Skills + Context 工程,一次性讲透!
DeepSeekHarness源码到底有多强?从入门到进阶:Cordis设计哲学 + 自我进化 Skills + Context 工程,一次性讲透!1. 引言:为什么 DeepSeekHarness 值得深入源码
在 AI 工程化浪潮中,DeepSeekHarness 凭借其独特的架构设计和工程实践,成为众多开发者研究的热门项目。它不仅仅是一个工具库,更是一套完整的 AI 应用开发范式。本文将从源码层面剖析其核心设计,带你从入门到进阶,一次性讲透 Cordis 设计哲学、自我进化 Skills 机制以及 Context 工程实践。
无论你是刚接触 AI 工程的新手,还是希望借鉴优秀架构的资深开发者,这篇文章都能为你提供有价值的参考。
2. 项目概览与核心架构
DeepSeekHarness 的源码结构清晰,模块划分合理。整体架构遵循「核心引擎 + 可插拔能力」的设计思路,主要包含以下几个核心模块:
- Core Engine:负责任务调度、上下文管理和执行流程控制。
- Skills 系统:支持技能的定义、注册、调用和动态进化。
- Context 工程:管理对话上下文、记忆和知识库的注入。
- Tool 集成层:提供与外部工具和服务的标准化接口。
这种分层设计使得各个模块可以独立演进,同时通过清晰的接口协议保持协作,是典型的「高内聚、低耦合」架构实践。
3. Cordis 设计哲学:事件驱动的核心
Cordis 是 DeepSeekHarness 的底层事件驱动框架,其设计哲学深刻影响了整个项目的架构风格。理解 Cordis,是读懂 DeepSeekHarness 源码的关键。
3.1 事件驱动模型
Cordis 采用事件驱动架构,将系统内的所有交互抽象为事件的发布与订阅。这种设计带来了几个显著优势:
- 解耦:组件之间不直接依赖,通过事件总线通信。
- 可扩展:新增功能只需注册新的事件处理器,无需修改现有代码。
- 可观测:所有事件流可以被监控和追踪,便于调试和优化。
在源码中,事件总线的实现非常轻量,核心代码不过数百行,却支撑起了整个系统的灵活调度。
3.2 生命周期管理
Cordis 对组件的生命周期进行了精细化管理,包括初始化、启动、运行、停止和销毁等阶段。每个阶段都有对应的事件钩子,开发者可以在合适的时机注入自定义逻辑。
// Cordis 生命周期钩子示例
export class MyPlugin extends Plugin {
    async start() {
        // 插件启动逻辑
        this.ctx.on('message', this.handleMessage);
    }
async stop() {
    // 插件停止逻辑
    this.ctx.off('message', this.handleMessage);
}
}
这种生命周期管理确保了资源的正确释放,避免了内存泄漏和状态残留问题。
3.3 依赖注入与上下文
Cordis 通过上下文(Context)对象实现依赖注入。每个插件都能访问共享的上下文,从而获取配置、服务和其他插件的引用。这种模式让插件之间的协作变得透明而可控。
4. 自我进化 Skills:让系统越用越聪明
DeepSeekHarness 最引人注目的特性之一,就是其自我进化的 Skills 系统。这套机制让 AI 应用能够根据使用情况不断优化自身能力。
4.1 Skills 的定义与注册
Skill 是 DeepSeekHarness 中可复用的能力单元,可以是一个函数、一个工具调用,甚至是一段提示词模板。每个 Skill 都包含元数据描述,用于说明其用途、参数和适用场景。
// Skill 定义示例
const skill = {
    name: 'code_review',
    description: '对代码进行审查,发现潜在问题并给出改进建议',
    parameters: {
        code: { type: 'string', description: '待审查的代码' },
        language: { type: 'string', description: '代码语言' }
    },
    execute: async (params) => {
        // 执行逻辑
        return reviewResult;
    }
};
4.2 进化机制:从反馈中学习
自我进化的核心在于反馈循环。系统会记录每个 Skill 的使用频率、成功率和用户反馈,并基于这些数据动态调整 Skill 的优先级和调用策略。
- 使用频率统计:高频使用的 Skill 会被优先推荐。
- 成功率评估:失败率高的 Skill 会被降级或标记为待优化。
- 用户反馈收集:显式反馈和隐式反馈都会被纳入进化决策。
这种机制让系统能够自适应不同用户的使用习惯,实现「越用越顺手」的效果。
4.3 动态组合与编排
Skills 不是孤立的,DeepSeekHarness 支持将多个 Skill 组合成复杂的工作流。通过编排引擎,系统可以根据任务需求动态选择合适的 Skill 序列。
// Skill 编排示例
const workflow = {
    steps: [
        { skill: 'parse_request', params: { input: '{{user_input}}' } },
        { skill: 'search_knowledge', params: { query: '{{parse_request.result}}' } },
        { skill: 'generate_response', params: { context: '{{search_knowledge.result}}' } }
    ]
};
5. Context 工程:让 AI 更懂你的需求
Context 工程是 DeepSeekHarness 的另一大亮点。它解决了 AI 应用中最棘手的问题之一:如何让模型充分理解用户意图和背景信息。
5.1 多层级上下文管理
DeepSeekHarness 将上下文划分为多个层级,每个层级服务于不同的目的:
- 会话级上下文:记录当前对话的完整历史。
- 用户级上下文:存储用户的偏好、历史行为和长期记忆。
- 任务级上下文:包含当前任务的目标、约束和中间结果。
- 知识库上下文:从外部知识库检索的相关信息。
这种分层设计让系统能够在不同粒度上管理信息,既保证了上下文的完整性,又控制了 Token 消耗。
5.2 上下文压缩与摘要
长对话会导致上下文膨胀,影响模型性能和响应质量。DeepSeekHarness 实现了智能的上下文压缩机制:
// 上下文压缩示例
async function compressContext(history) {
    if (history.length > MAX_HISTORY) {
        const summary = await summarize(history.slice(0, -MAX_HISTORY));
        return [summary, ...history.slice(-MAX_HISTORY)];
    }
    return history;
}
通过定期生成摘要并保留最近的关键对话,系统能够在信息完整性和 Token 效率之间取得平衡。
5.3 知识注入与检索增强
DeepSeekHarness 集成了检索增强生成(RAG)能力,能够从外部知识库中检索相关信息并注入到上下文中。这种机制让模型能够回答超出训练数据范围的问题。
- 向量化存储:知识文档被转换为向量并存储。
- 语义检索:根据用户问题检索最相关的知识片段。
- 动态注入:检索结果被动态拼接到提示词中。
6. 实战:从零构建一个 DeepSeekHarness 应用
理解了核心设计之后,让我们通过一个实际案例,看看如何基于 DeepSeekHarness 构建一个智能问答应用。
6.1 环境准备
首先,确保你的开发环境满足以下要求:
- Node.js 18 及以上版本
- npm 或 yarn 包管理器
- DeepSeek API Key(用于模型调用)
6.2 项目初始化
# 创建项目目录
mkdir my-harness-app
cd my-harness-app
初始化 npm 项目
npm init -y
安装 DeepSeekHarness
npm install deepseek-harness
6.3 编写核心逻辑
import { Harness, SkillRegistry, ContextManager } from 'deepseek-harness';
// 创建 Harness 实例
const harness = new Harness({
apiKey: process.env.DEEPSEEK_API_KEY,
model: 'deepseek-chat'
});
// 注册自定义 Skill
harness.registerSkill({
name: 'weather_query',
description: '查询指定城市的天气信息',
parameters: {
city: { type: 'string', description: '城市名称' }
},
execute: async ({ city }) => {
// 调用天气 API
return await fetchWeather(city);
}
});
// 配置上下文管理器
const contextManager = new ContextManager({
maxHistory: 20,
enableCompression: true,
knowledgeBase: './knowledge'
});
// 处理用户消息
async function handleMessage(userInput) {
const context = await contextManager.buildContext(userInput);
const response = await harness.chat(userInput, context);
await contextManager.updateContext(userInput, response);
return response;
}
6.4 运行与测试
完成上述代码后,运行应用并测试几个典型场景,观察系统如何利用 Skills 和 Context 提供更精准的回答。
7. 性能优化与最佳实践
在实际生产环境中,有几个关键的性能优化点值得关注:
7.1 缓存策略
对于频繁使用的 Skill 和检索结果,合理的缓存可以显著降低延迟和成本。
// 缓存示例
const cache = new LRUCache({ max: 1000, ttl: 3600 });
async function getCachedResult(key, fetchFn) {
if (cache.has(key)) {
return cache.get(key);
}
const result = await fetchFn();
cache.set(key, result);
return result;
}
7.2 并发控制
当多个请求同时到达时,需要合理的并发控制机制,避免资源耗尽。
7.3 监控与日志
完善的监控体系是保障系统稳定运行的基础。DeepSeekHarness 提供了内置的日志和指标收集能力,建议在生产环境中启用。
8. 常见问题与解决方案
在实践过程中,开发者可能会遇到一些典型问题,这里给出常见问题的解决方案:
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
| 上下文过长导致 Token 超限 | 历史对话积累过多 | 启用上下文压缩,调整 maxHistory 参数 |
| Skill 调用失败 | 参数校验不通过或外部服务异常 | 检查 Skill 定义,增加错误重试机制 |
| 响应质量不稳定 | 上下文信息不足或提示词设计不佳 | 优化 Context 构建逻辑,改进提示词模板 |
| 系统响应延迟高 | 检索或模型调用耗时过长 | 引入缓存,优化检索索引,使用流式输出 |
9. 总结与展望
DeepSeekHarness 的源码为我们展示了现代 AI 应用工程化的优秀实践。通过 Cordis 事件驱动架构,系统实现了高度的模块化和可扩展性;通过自我进化的 Skills 机制,系统能够持续优化自身能力;通过精细的 Context 工程,系统能够更准确地理解用户需求。
这套设计理念不仅适用于 DeepSeekHarness 本身,也为其他 AI 项目的架构设计提供了宝贵参考。随着 AI 技术的快速发展,我们有理由相信,类似 DeepSeekHarness 这样的工程化框架将在未来扮演越来越重要的角色。
希望本文能帮助你更好地理解 DeepSeekHarness 的源码设计,并在实际项目中灵活运用这些优秀的工程实践。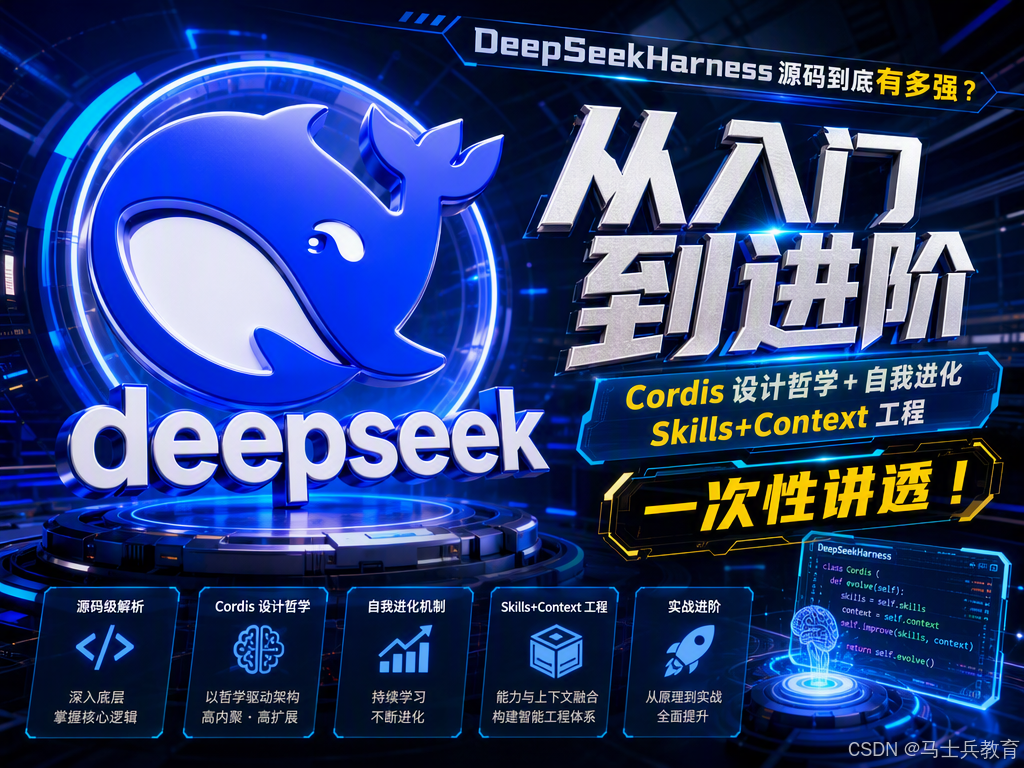
小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐
 5
 0
- 0


 已为社区贡献14条内容

所有评论(0)