
读完Agent Loop工程手册,我有8个还没想明白的问题
01
先安利一下:Agent Loop 真的挺香
最近 Agent Loop 这个词在国外讨论量破 220 万,硅谷一线工程师圈基本人手一份手册。我连读完之后第一反应是"早该这样了"。它的核心主张就一句话:
别再死磕 Prompt 怎么写了,去设计一个能让 AI 自己转起来的“循环(Loop)”。
打个比方——
- 过去用 AI 像手动挡:每个路口都得自己换挡踩离合,一句句喂 Prompt;
- Agent Loop 让你升级到自动驾驶:你只管输入目的地(目标)和限速(护栏),车自己开。
它把这套"自动驾驶系统"拆成了几个零件,我用大白话翻译一下:
| 手册术语 | 大白话 | 解决什么 |
|---|---|---|
| Automations | 定时闹钟,自动开跑 | 不用人每次手动点"开始" |
| Worktrees | 给每个 Agent 一个隔离工位 | 多 Agent 并行不打架(不互相覆盖文件) |
| Skills | 攒下来的"操作手册" | 不用每次从零教 AI |
| Plugins/Connectors | 外接工具(GitHub/Slack/MCP) | 让 Agent 真的能动手,而不是只会聊天 |
| Sub-agents | 一个干活、一个验收 | 防止 AI 自己给自己打高分 |
| Memory | 外挂笔记本 | 突破"聊几句就忘" |
| Guardrails | 限速 + 油量表 | 防止失控烧钱 / 原地打转 |
读完之后让我反复琢磨的有 4 个设计法,每一条都很值得拎出来单聊:
① 写循环之前,先想清楚"什么算干完了"(Stopping Condition)
别说"把代码改好"——太模糊,AI 会把"我感觉改好了"当成"真改好了";
要说"写一个能复现 bug 的测试,然后让它通过"——可验证,AI 才知道什么时候该停。
这一条是整本手册我觉得最值钱的。模糊的目标会让 AI 自欺欺人,可验证的目标才是真护栏。
② Context 是"组装出来的",不是"写出来的"
传统 Prompt 是一段固定文字。
Loop 里 Context 是根据当前状态动态拼出来的——上一轮失败日志、当前文件树、最近 N 条调用记录,全自动拼进下一轮 Prompt。
这意味着你不再是"写 Prompt 的人",而是"设计 Context 怎么自动生长"的人。
③ 失败是输入,不是终点
跑挂了?把错误堆栈、报错截图、上次 Diff 全自动喂回去当下一轮的输入。
Loop 把"失败"重新定义成"用来下一步推理的数据"——这跟传统编程"出错就停"是反过来的思路。
④ 多 Agent 协作有 6 种"拓扑"
手册罗列的 6 种多 Agent 编排模式(顺序流水线 协调者-工作者 扇出合并 生成-验证 共享状态 / 辩论对抗),每种都对应一类典型场景。
这相当于给"多 Agent 怎么搭"建了一个模式词典——你不用每次重新发明轮子,看着场景挑一个就行。
光是这 4 条心法,就值得每个用 AI 干活的人反复琢磨。真心推荐没读过的同学去搜一下原手册。
02
读完之后改了我什么?(包括我用 Loop 重新理解了我手上的 SELF)
读完不是看个热闹。我边读边把我自己每天怎么用 AI 干活重新审视了一遍,发现有 4 处直接被它改掉了。
其中第 4 处特别想单独展开聊——因为我手上正好在搞一个相关的小东西(SELF Protocol),读完 Loop 之后我才看清它在 Loop 体系里的位置。
改变 1:从"写 Prompt"心态切到"写循环 + 写 Stopping Condition"心态
以前接一个任务,我第一反应是"这次 Prompt 怎么写"。
现在第一反应是"这件事怎么定义’干完了’"——这一步先想清楚,后面 Prompt 反而短了一半。
改变 2:失败信息从"丢了"到"接住"
以前 AI 跑出错,我下意识就清屏重来。
现在我开始强制自己把错误堆栈贴回下一轮——光这一条就让我同一类问题二次失败的概率明显降下来(纯个人体感,没量化)。
改变 3:开始用"拓扑"这个词去观察自己的工作
以前我和 AI 的协作是糊在一起的"我说一句它做一步"。
现在我会自问"这件事我现在用的是哪种拓扑?该不该换一种?“——比如给文章纠错,从"我自己 review"换成"扇出合并(找两个 Agent 各自挑刺,再合并)”,挑出来的问题数明显多一些。
改变 4:用 Loop 的视角,重新看清了我手上的 SELF Protocol 在哪一层
老实说,过去 30 多天我搞 SELF(Self-Evolving Lightweight Fabric · 一套薄壳协议),自己心里也只是"一些 Markdown 规矩 + 少量脚本",定位有点糊。
直到读完 Agent Loop,我才反应过来:SELF 本质上就是 Agent Loop 体系里的"治理 / 审查层"——它不抢 Loop 框架的位置、不替代 Sub-agents、不替代 Memory。
它只负责回答 Loop 没着重展开的那一面:转起来之后,怎么不胡说、不失忆、不重复踩坑。
我画了一张对照表,把 Loop 7 件套里和"治理"最相关的 5 件,逐条对位 SELF 在每件套上做了什么补强 / 没做什么——也算我读完之后给自己一次复盘:
| Loop 5 件套(治理相关) | Loop 怎么做 | SELF 怎么做(我的薄壳尝试) | 我的诚实评估 |
|---|---|---|---|
| Memory(外挂记忆) | 用 Markdown / DB 突破上下文窗口 | 同样用 Markdown,但强制三层分级(一句话 l0 几条结论 l1 全文 l2)+ 答关键问题前强制先翻笔记 | 30 天有效但仍有失焦案例(题 4 的真痛点) |
| Sub-agents(一个干活一个验收) | Maker-Checker 多 Agent 分工 | 单 Agent 内置一个**"小查"角色卡**(pre-publish review 清单:链接真假 数据出处 未核实声明) | 比"无验收"强,但同模型盲区共存(题 2 我也没解) |
| Guardrails(护栏) | 资源类(迭代/预算/无进展检测) | 加一层认知类(不胡说 不失忆 不污染记忆)· 发布出口拦截 | 实测拦下过编造数据 1 次,但红线触发率仍未稳(题 3 的痛) |
| Skills(操作手册) | 攒下来可复用的指令 | 加一条**“失败转技能”**(每个失败案例自动沉淀成一条可复用规矩) | 30 天攒了 9 条,但同类失败仍在反复犯(题 1 的痛) |
| Stopping Condition | 可验证的硬目标 | 软目标场景下加一道**“诚实分级 disclaimer”**(论文级 工件级 计划级三档)—— 不能验证就显式标 | 治不了软目标本身,但至少不会假装"完成了" |
一句话定位:Agent Loop 教我“怎么让 AI 自己转起来”,SELF 是我回答“转起来怎么不跑偏”的那一层薄壳——前者是骨架,后者是润滑层;前者解决能不能转,后者解决转得稳不稳。
⚠️ 诚实声明
这张对照表是我读完 Loop 之后的事后整理,不是说 SELF 一开始就照着 Loop 设计的——它是先在 30 天踩坑里长出来的(268 次 LLM 调用、20 个失败案例、314 条学习记录),读完 Loop 后我才用它的语言把自己手上的东西"翻译"了一遍。
所有"有效"都是我个人体感、单 Agent 单样本、无对照组,普适性等更多人验证。
03
读完之后,我有 8 个还没想明白的问题
手册里的方法用上之后确实顺了很多,也撞出来一堆我自己想不通的问题。
下面这 8 条,每一条都是我真实卡住的地方,特别想听评论区怎么解:
- 停止条件这条铁律,遇到"软目标"怎么办?
"写测试-通过测试"这种硬目标很容易写停止条件。但很多场景目标本身是软的——“把这篇文章写得让人愿意读完”、“判断这个方案值不值得做”、“输出一份让老板满意的周报”。
我自己试过用 LLM 当 judge 给软目标打分(>0.7 就停),但两个 LLM 互打分有时会漂——上午 0.85,下午同样的输出 0.6。
SELF 我目前的土办法:加一道“诚实分级 disclaimer”——治不了软目标本身,但至少强制 Agent 显式标“这是计划级 / 我没法验证”。
你们的实践里有没有又稳又不死板的写法?
- 子代理"互相验收",会不会同病相怜一起跑偏?
Maker-Checker(一个干活一个验收)听起来很美。但两个 Agent 都是同一个底模,它们的盲区高度重合——干活的看不出来的错,验收的也看不出来。
我亲身试过:让 Agent A 写代码、Agent B 验收,结果 B 把 A 的"看上去对其实有 off-by-one"的代码全都标了"PASS"。
你们生产里真用过吗?怎么避免"两个 LLM 一起自我感觉良好"? 是该用不同模型当 Checker?还是用规则引擎/单元测试当硬验收?
- 护栏到底应该写在哪一层?
"预算上限 无进展检测 迭代次数封顶"这些护栏,应该焊死在 Loop 框架里,还是做成可插拔的独立层?
前者紧凑,但写死之后改起来麻烦;后者灵活,但灵活也意味着可能被"忘了启用"——我就忘开过一次,结果一晚上烧了几十块测试 token。
SELF 我目前的分法:把“认知类护栏”做成可插拔的独立薄壳(理由:认知红线常需迭代),而把“资源类护栏”留给底层 Loop 框架(理由:资源红线该写死)。
但你们的项目里这两类是怎么分的?这个分法对不对?
- 记忆要给多大?
手册说用外挂记忆突破上下文窗口。但记忆给太大 Agent 会失焦(什么都翻一遍、容易被无关历史带偏),给太小又等于没解决问题。
SELF 我目前的土办法:分三层(一句话摘要 l0 几条结论 l1 全文 l2),按需展开——但 30 天里仍有失焦案例。
你们的经验法则是什么?是按 token budget 截断、按相关性打分、还是按时间衰减?
- Loop 跑顺了之后,人对系统的理解会不会变浅?
手册自己也警告"过度依赖会导致理解力腐蚀"——AI 越自动,人越不知道里面发生了什么;等到出 bug 时反而修不动,因为代码不是你自己写的、Loop 也不是你手动跑过的。
我自己最近就有这个体感——有几个我自己搭的循环,跑了两周后我突然发现我已经不太记得它每一步在做什么了,要重新读自己的代码。
你们重度用 AI 自动化之后,怎么对冲这种腐蚀?
- 拓扑选型有没有"踩坑指南"?
手册给了 6 种多 Agent 拓扑,理论上每种都有适用场景。但真用起来怎么判断’我现在该选哪种’?
我试过用"辩论对抗"(正反方 Agent 互相挑战)做风险评估,结果两个 Agent 互相说服反而比单 Agent 更糊涂——它们一起越聊越自信,最后一致同意一个错的结论。
有没有同学交过学费、能分享一下哪些拓扑是看着美用着崩的?
- AI 一本正经地胡说,怎么在 Loop 里防?
这是我栽得最惨的——Loop 跑得越自动,AI 错得也越自信。有一次它笃定地告诉我某个事实(甚至给出了"出处"),我没核就用了,事后一查那个出处根本不存在,是它自己编的。
SELF 我目前的土办法:发布前自检清单——对外的链接 数据 结论必须过一道“链接是真的吗 数据有出处吗 有没有未核实结论”。实测拦下过 1 次编造,但触发率还是不稳。
你们这一层是怎么加的? 接外部检索强制核查?接独立的 fact-checker Agent?还是干脆白名单只让它输出特定结构?
- 成本怎么压?尤其在多 Agent + 长循环场景下
手册主要在讲"怎么让 Loop 跑起来",但怎么让 Loop 跑得便宜这一面我读得不解渴。多 Agent 一并行 + 循环一拉长,token 烧得真的快。
我目前的土办法:① 协调者用便宜模型只做路由 ② 中间产物存脚本变量不进 Prompt ③ 限制单循环最大轮数。
你们有没有更系统的成本压缩套路? 模型分级?Prompt 压缩?还是缓存中间结果?这一块我特别想抄作业。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
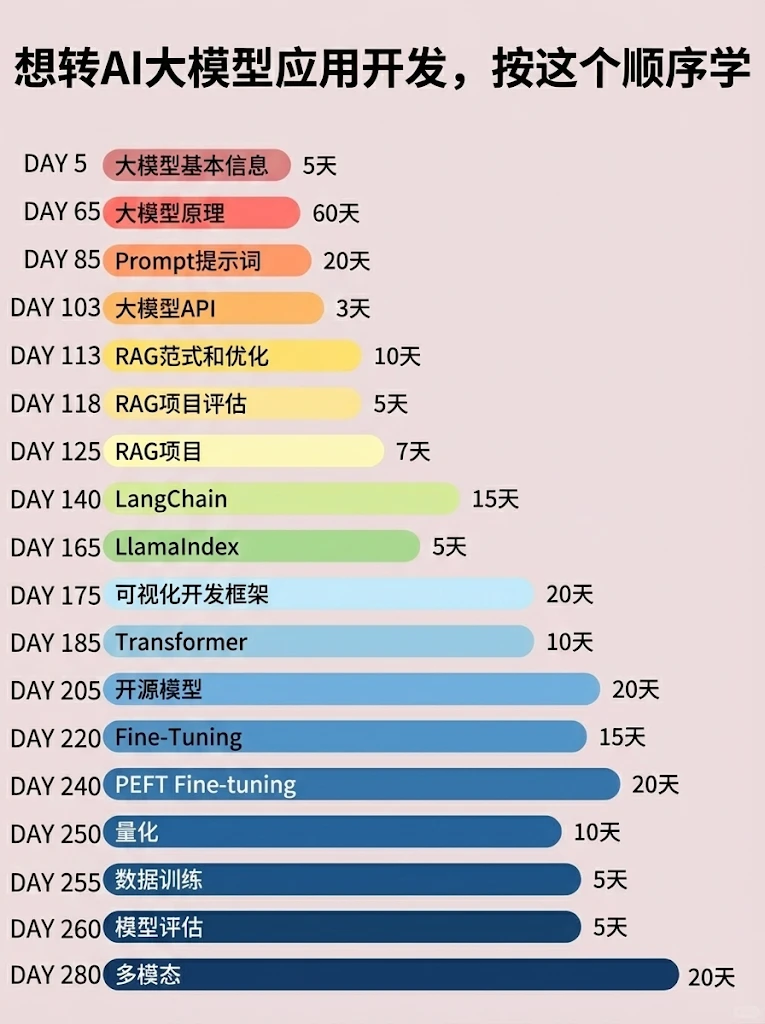
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐


 4
 0
- 0


 已为社区贡献63条内容

所有评论(0)