Skill Graph:skills时代如何搭建技能图谱
全文为解析该开源项目:
arscontexta
一、TL;DR
随着 AI Agent 越来越普及,写单一 Prompt 的时代正在过去,未来必然是写 Skills(技能)的时代。当个人的 Skills 数量激增,且互相调用、嵌套时,必然会引发“技能通胀”和逻辑冲突。关键判断:
- 技能分级:Skills 必须遵循“原子 (Atoms) -> 分子 (Molecules) -> 化合物 (Compounds)”的三级抽象,保持极简的单点边界。
- 架构借鉴:
arscontexta本是一个为 Agent 提供持久化外脑的插件,但其“三度空间”与“6 Rs 流水线”架构,为我们管理庞大的 Skill Graph(技能图谱) 提供了绝佳的范本。 - 上下文隔离:通过派生子代理(Subagent)执行原子 Skill,能有效解决深层调用时的逻辑“打架”和幻觉问题。
“未来的核心竞争力不在于你写了多长多牛的 Prompt,而在于你能否编织一张边界清晰、能被 Agent 自动调度的 Skill Graph。”
二、背景与痛点:技能通胀时代的混乱
最近看了一篇微信公众号文章以及推特上的探讨,里面提到的一个思路非常戳中我:每个人日后都会生产出各种各样的 Skills,Skills 之间可能会互相调用,甚至一个高阶的 Skill 就是基于其他几个底层 Skills 拼装而成的。
在我的实战中,这种现象已经开始显现。当你只有 3 个 Skill 的时候,你靠大脑记忆就能轻松调度;但当你有 30 个、50 个 Skill,并且一个“做一份周报”的 Skill 需要同时调用“查阅日历”、“抓取 GitHub”、“排版 Markdown”等底层 Skill 时,灾难就来了。
如果 Agent 的依赖链深度很深,使用 Skills 很多,就会出现 Skills 之间的逻辑打架。Agent 会在超长的上下文里迷失,不知道到底该听哪个指令的。
个人感觉,这时候我们就需要给这些海量的 Skills 做归纳整理。这里,**Skill Graph(技能图谱)**就是一种极具前瞻性的解法。
三、核心理念:Skill 的三级抽象
参考 Claude Code 的源码解析以及软件工程的单一职责原则,一个独立优秀的 Skill,必须是功能最小粒度,只要干好一件事即可。只有当每一个 Skill 都有足够清晰的边界,日后互相调用才不会出现冲突。
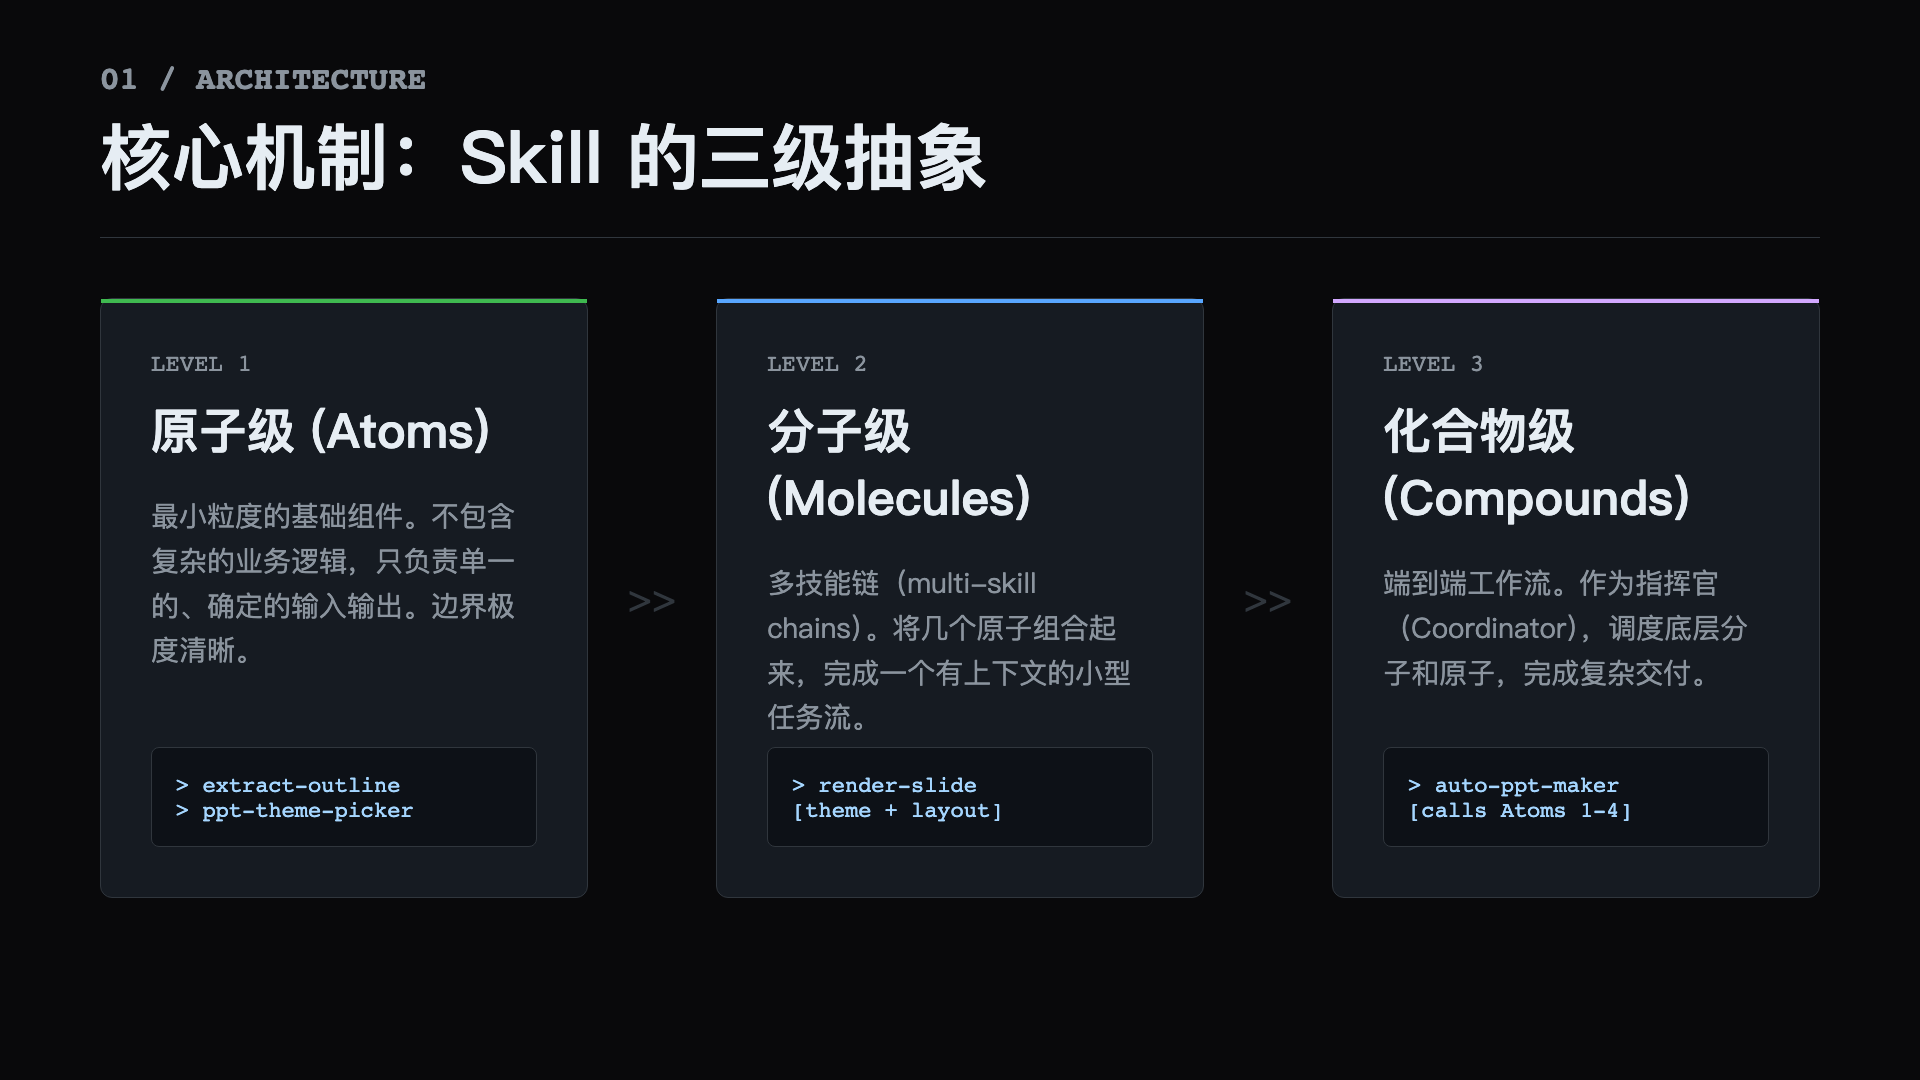
我们可以将 Skills 的层级分为三类:
1. 原子级(Atoms)
这是最小粒度的基础组件。它不包含复杂的业务逻辑,只负责单一的、确定的输入输出。
比如:获取当前日期、将本地图片转为 OSS 链接、读取指定 URL 的纯文本。
2. 分子级(Molecules / Multi-skill chains)
将几个原子 Skill 组合起来,完成一个有上下文的小型任务流。
比如:抓取 GitHub 仓库信息 = 下载源码 (Atom) + 扫描目录结构 (Atom)。
3. 化合物级(Compounds / End-to-end workflows)
这通常是用户直接触发的入口,代表一个完整的端到端工作流。它不需要自己去干脏活累活,而是作为一个“指挥官(Coordinator)”,去调度底层的分子和原子。
举个完善的例子:生成一份高质量 PPT
如果你把所有要求(大纲、字体、排版、颜色)都塞进一个 generate-ppt 的巨无霸 Skill 里,Agent 一定会发疯,排版和配色指令极易互相覆盖。
合理的 Skill Graph 应该是这样的:
- Atom 1 (
extract-outline):专门负责从长文章中提取 5 页 PPT 的骨架。 - Atom 2 (
ppt-theme-picker):专门负责根据主题决定字体组合与色板(只管颜色和字体)。 - Atom 3 (
ppt-layout-renderer):专门负责将文案注入到 HTML 骨架中(只管排版)。 - Atom 4 (
ppt-qa-auditor):专门负责审核,比如检查大标题是否超过 10 个字,图片比例是否正确。 - Compound (
auto-ppt-maker):它只做一件事——按照顺序,依次调用上面 4 个 Atom,将上一个的输出作为下一个的输入。
“边界越清晰,组合越强大。把巨无霸拆成原子,是构建图谱的第一步。”
四、从 arscontexta 借鉴的 Skill Graph 架构
有了这么多的原子和分子,怎么管理它们?我们可以从 arscontexta 这个开源项目里偷师。
arscontexta 的本质是给 Claude Code 生成一套量身定制的知识系统(Vault)。但仔细看它的架构,你会发现它完美契合了 Skill Graph 的管理需求。
1. 三度空间映射
它采用了严格的 self/、notes/、ops/ 目录隔离:
self/(身份与索引):我们可以把它当作 Agent 的“技能调度中枢”。里面存放着 Agent 当前可用的所有 Compound 级别的工作流入口。notes/(原子节点):映射到技能图谱中,这里就是存放数以百计的 Atom 和 Molecule 级别 Skill 的地方。每个 Skill 都是图谱上的一个节点。ops/(执行队列):用于存放临时状态和任务队列。当 Compound 开始调度时,当前的执行进度(比如已经跑完了字体选择,等待排版)就记录在这里。
2. 通过 MOC(Map of Content)进行路由
arscontexta 极度依赖 MOC(内容映射图)来让 Agent 不至于迷路。
在 Skill Graph 中,我们可以为同一领域的 Skills 建立 MOC。比如 前端开发 MOC 下关联了 创建 React 组件、编写 CSS 样式 等原子技能。Agent 在接到大任务时,先查 MOC,再顺藤摸瓜找到具体要调用的原子 Skill,这就避免了全局盲目搜索带来的幻觉。
五、源码级剖析:如何避免上下文污染

在多 Skill 嵌套调用的场景中,最致命的坑就是上下文污染。Agent 的 Context Window 填满了前几个 Skill 的执行日志后,注意力机制会严重退化。
arscontexta 的做法堪称教科书级别。
源码位置:README.md
/ralph 5
  |-- Read queue, find next unblocked task
  |-- Spawn subagent (fresh context)
  |   +-- Runs skill, updates task file, returns handoff
  |-- Parse handoff, capture learnings
这段逻辑深度解读:
它实现了一个名为 /ralph 的队列管理器。当系统需要连续执行 6 Rs(Record, Reduce, Reflect, Reweave, Verify, Rethink)等多个流水线任务时,它并没有在一个对话上下文里硬扛。
相反,每执行一个 Phase(也就是调用一个 Skill),它都会Spawn subagent (fresh context)——派生一个全新的子代理。
子代理拿着纯净的、仅包含当前单一原子 Skill 所需上下文的 Prompt 去执行。执行完毕后,仅返回高度浓缩的 handoff(交接结果)给主 Agent。
“主 Agent 负责统筹全局图谱,子 Agent 拿着单程票去执行原子技能,这是解决逻辑打架的唯一正解。”
六、实战排障与避坑指南
如果你准备开始构建自己的 Skill Graph,请务必注意以下几点:
| 故障现象 | 根因剖析 | 防御性解决方案 |
|---|---|---|
| Agent 在执行复杂任务时突然“忘记”了早期的约束 | 巨无霸 Skill 导致 Token 过载,Attention 机制失效 | 强制拆分。将任务拆解为 Atom 级,使用 Subagent 隔离执行。 |
| Agent 找不到该用哪个 Skill,或者用错了 Skill | 原子 Skill 的命名或描述不够正交(Orthogonal),存在歧义 | 强化接口描述。每个 Skill 必须像 API 文档一样,在 description 中写清楚输入什么、输出什么、绝对不做什么。 |
| 多个同类 Skill 互相打架(如两个格式化代码的 Skill) | 缺乏统一的路由中心 | 引入 MOC(内容映射图),按领域对 Skill 进行分类,让 Agent 遵循图谱路径寻路。 |
七、总结
研究完 arscontexta 和微信上的那几篇探讨,个人感觉,AI 时代的知识管理和工作流管理正在发生底层范式的转移。
以前,我们把精力花在如何写出几万字的 Prompt 上;而现在,真正的壁垒在于如何像搭乐高一样,把最小粒度的积木(Atoms)拼接成复杂的机器(Compounds)。
你的 Skill Graph 有多大、边界有多清晰、调度有多智能,你在 AI 时代的杠杆率就有多高。
参考文献
小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐
 10
 0
- 0


 已为社区贡献16条内容

所有评论(0)