


- @zlfprogram


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Hadoop 均衡器Hadoop在运行过程中,其datanode的块会越来越不平衡,不平衡的集群会导致部分datanode相对更繁忙。Hadoop的均衡器是一个守护进程。它会重新分配块,将块从忙碌的datanode移到相对空闲的datanode。同时坚持复本策略,将复本分散到不同机架,以降低数据损坏率。集群均衡标准:每个datanode的使用率和集群的使用率非常接近,差距不超过给定的阀值。data
设计模式分为三种类型,共23种。1.创建型模式:单例模式、抽象工厂模式、建造者模式、工厂模式、原型模式。2.结构型模式:适配器模式、桥接模式、装饰模式、组合模式、外观模式、享元模式、代理模式。3.行为型模式:模版方法模式、命令模式、迭代器模式、观察者模式、中介者模式、备忘录模式、解释器模式、状态模式、策略模式、职责链模式、访问者模式。按字典序排列简介如下:1.Abstract Factory(抽象
数据结构线性数据结构Java数据结构-链表栈和队列数字九宫格狼追兔子猴子选大王蜗牛爬墙八皇后问题
【常规】Ctrl+Shift + Enter,语句完成“!”,否定完成,输入表达式时按 “!”键Ctrl+E,最近的文件Ctrl+Shift+E,最近更改的文件Shift+Click,可以关闭文件Ctrl+[ OR ],可以跑到大括号的开头与结尾Ctrl+F12,可以显示当前文件的结构Ctrl+F7,可以查询当前元素在当前文件中的引用,然后按 F3 可以选择Ctrl+N,可以快速打开类Ct
hadoop实现HA后,需要部署三个Journal 节点,来同步namenode数据;由于线上机器需要,要更好一台部署了Journal 节点的机器,于是停进程更换机器;Journal 节点建议是三个点,另找了台机器部署,启动进程,修改namenode节点的配置信息;问题:1.第一次报Journal 的目录没有,于是创建目录;2.接着又报Journal 的目录没有格式化;这如何
1)KahaDb和AMQ Message Store两种持久方式如何选择?官方:From 5.3 onwards - we recommend you use KahaDB - which offers improved scalability and recoverability over the AMQ Message Store.The AMQ Message Store which alt
源自 IBM developerWorkshttp://www.ibm.com/developerworks/cn/opensource/os-cn-zookeeper/index.html安装和配置详解本文介绍的 Zookeeper 是以 3.2.2 这个稳定版本为基础,最新的版本可以通过官网 http://hadoop.apache.org/zookeeper/来获取,Zookeeper 的安
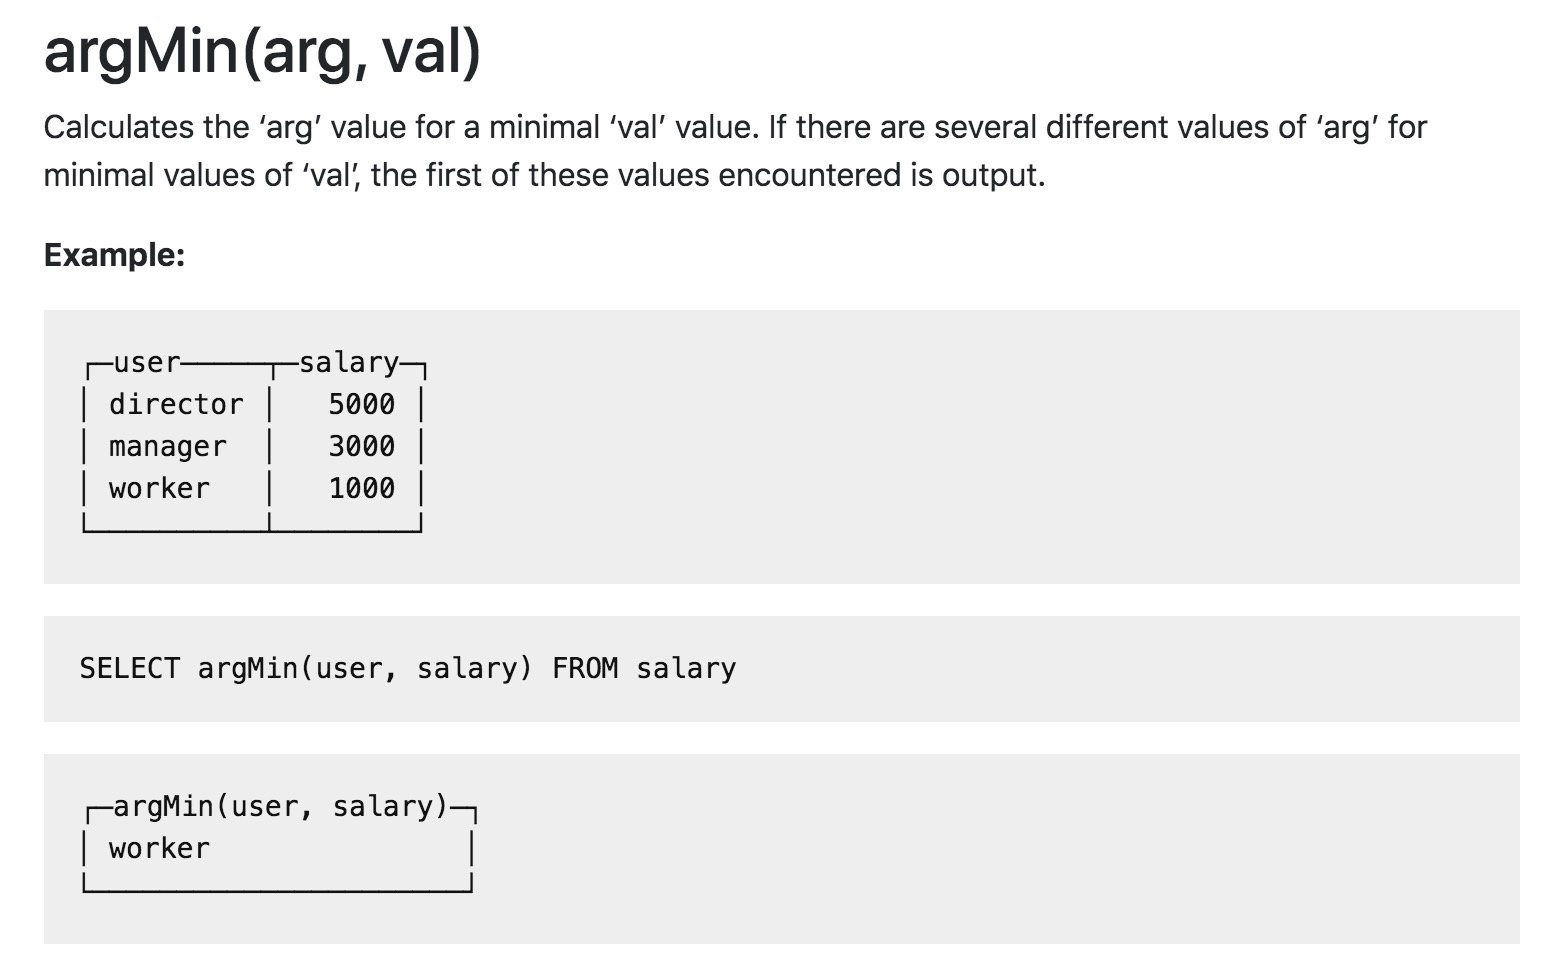
argMax():计算 ‘arg’ 最大值 ‘val’ 价值。如果有几个不同的值 ‘arg’ 对于最大值 ‘val’,遇到的第一个值是输出。argMin() 与argMax() 的功能正好是相反的,👇是Clickhouse官方文档对这个函数的解释,看官应该看知道这个函数是用途了吧。当然上图是argMin() 函数的简单案例,这里我想到的几个业务场景的使用案例,仅供参考。
在过去一年左右的时间里,在相当平静,企业的软件架构变得相当令人振奋的一次。 我们终于看到新出现的一些课题已经融入主流,并潜在地改变了游戏规则,一些创新,本来徘徊在边缘的技术也开始进行颠覆式革命。一些大的变化是:传统的霸权的第3和第4层应用模型 ,重量级的运行平台(集中式数据库计算模型),以及古典面向服务SOA的架构已经主宰了近十年,现在几乎被四分五裂了一系列新办法的设计和架构应用。这些听起来似乎很
本文将由浅入深详细介绍Java内存分配的原理,以帮助新手更轻松的学习Java。这类文章网上有很多,但大多比较零碎。本文从认知过程角度出发,将带给读者一个系统的介绍。进入正题前首先要知道的是Java程序运行在JVM(Java Virtual Machine,Java虚拟机)上,可以把JVM理解成Java程序和操作系统之间的桥梁,JVM实现了Java的平台无关性,由此可见JVM的重要性。所以在学习J