- @iymei4986533030


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在多核对称多处理(SMP)与非统一内存访问(NUMA)架构下,编写能够线性扩展的高性能并发程序,本质上是一场。回顾九月在“并发原语”专栏中的探索,我们从操作系统互斥锁(Mutex)的底层上下文切换开销,到硬件原子指令(CAS / FAA)的总线一致性风暴,再到基于 64 字节缓存行对齐的无锁队列(Lock-Free RingBuffer)、带 PAUSE 退避的自适应自旋锁,以及读端绝对零开销的
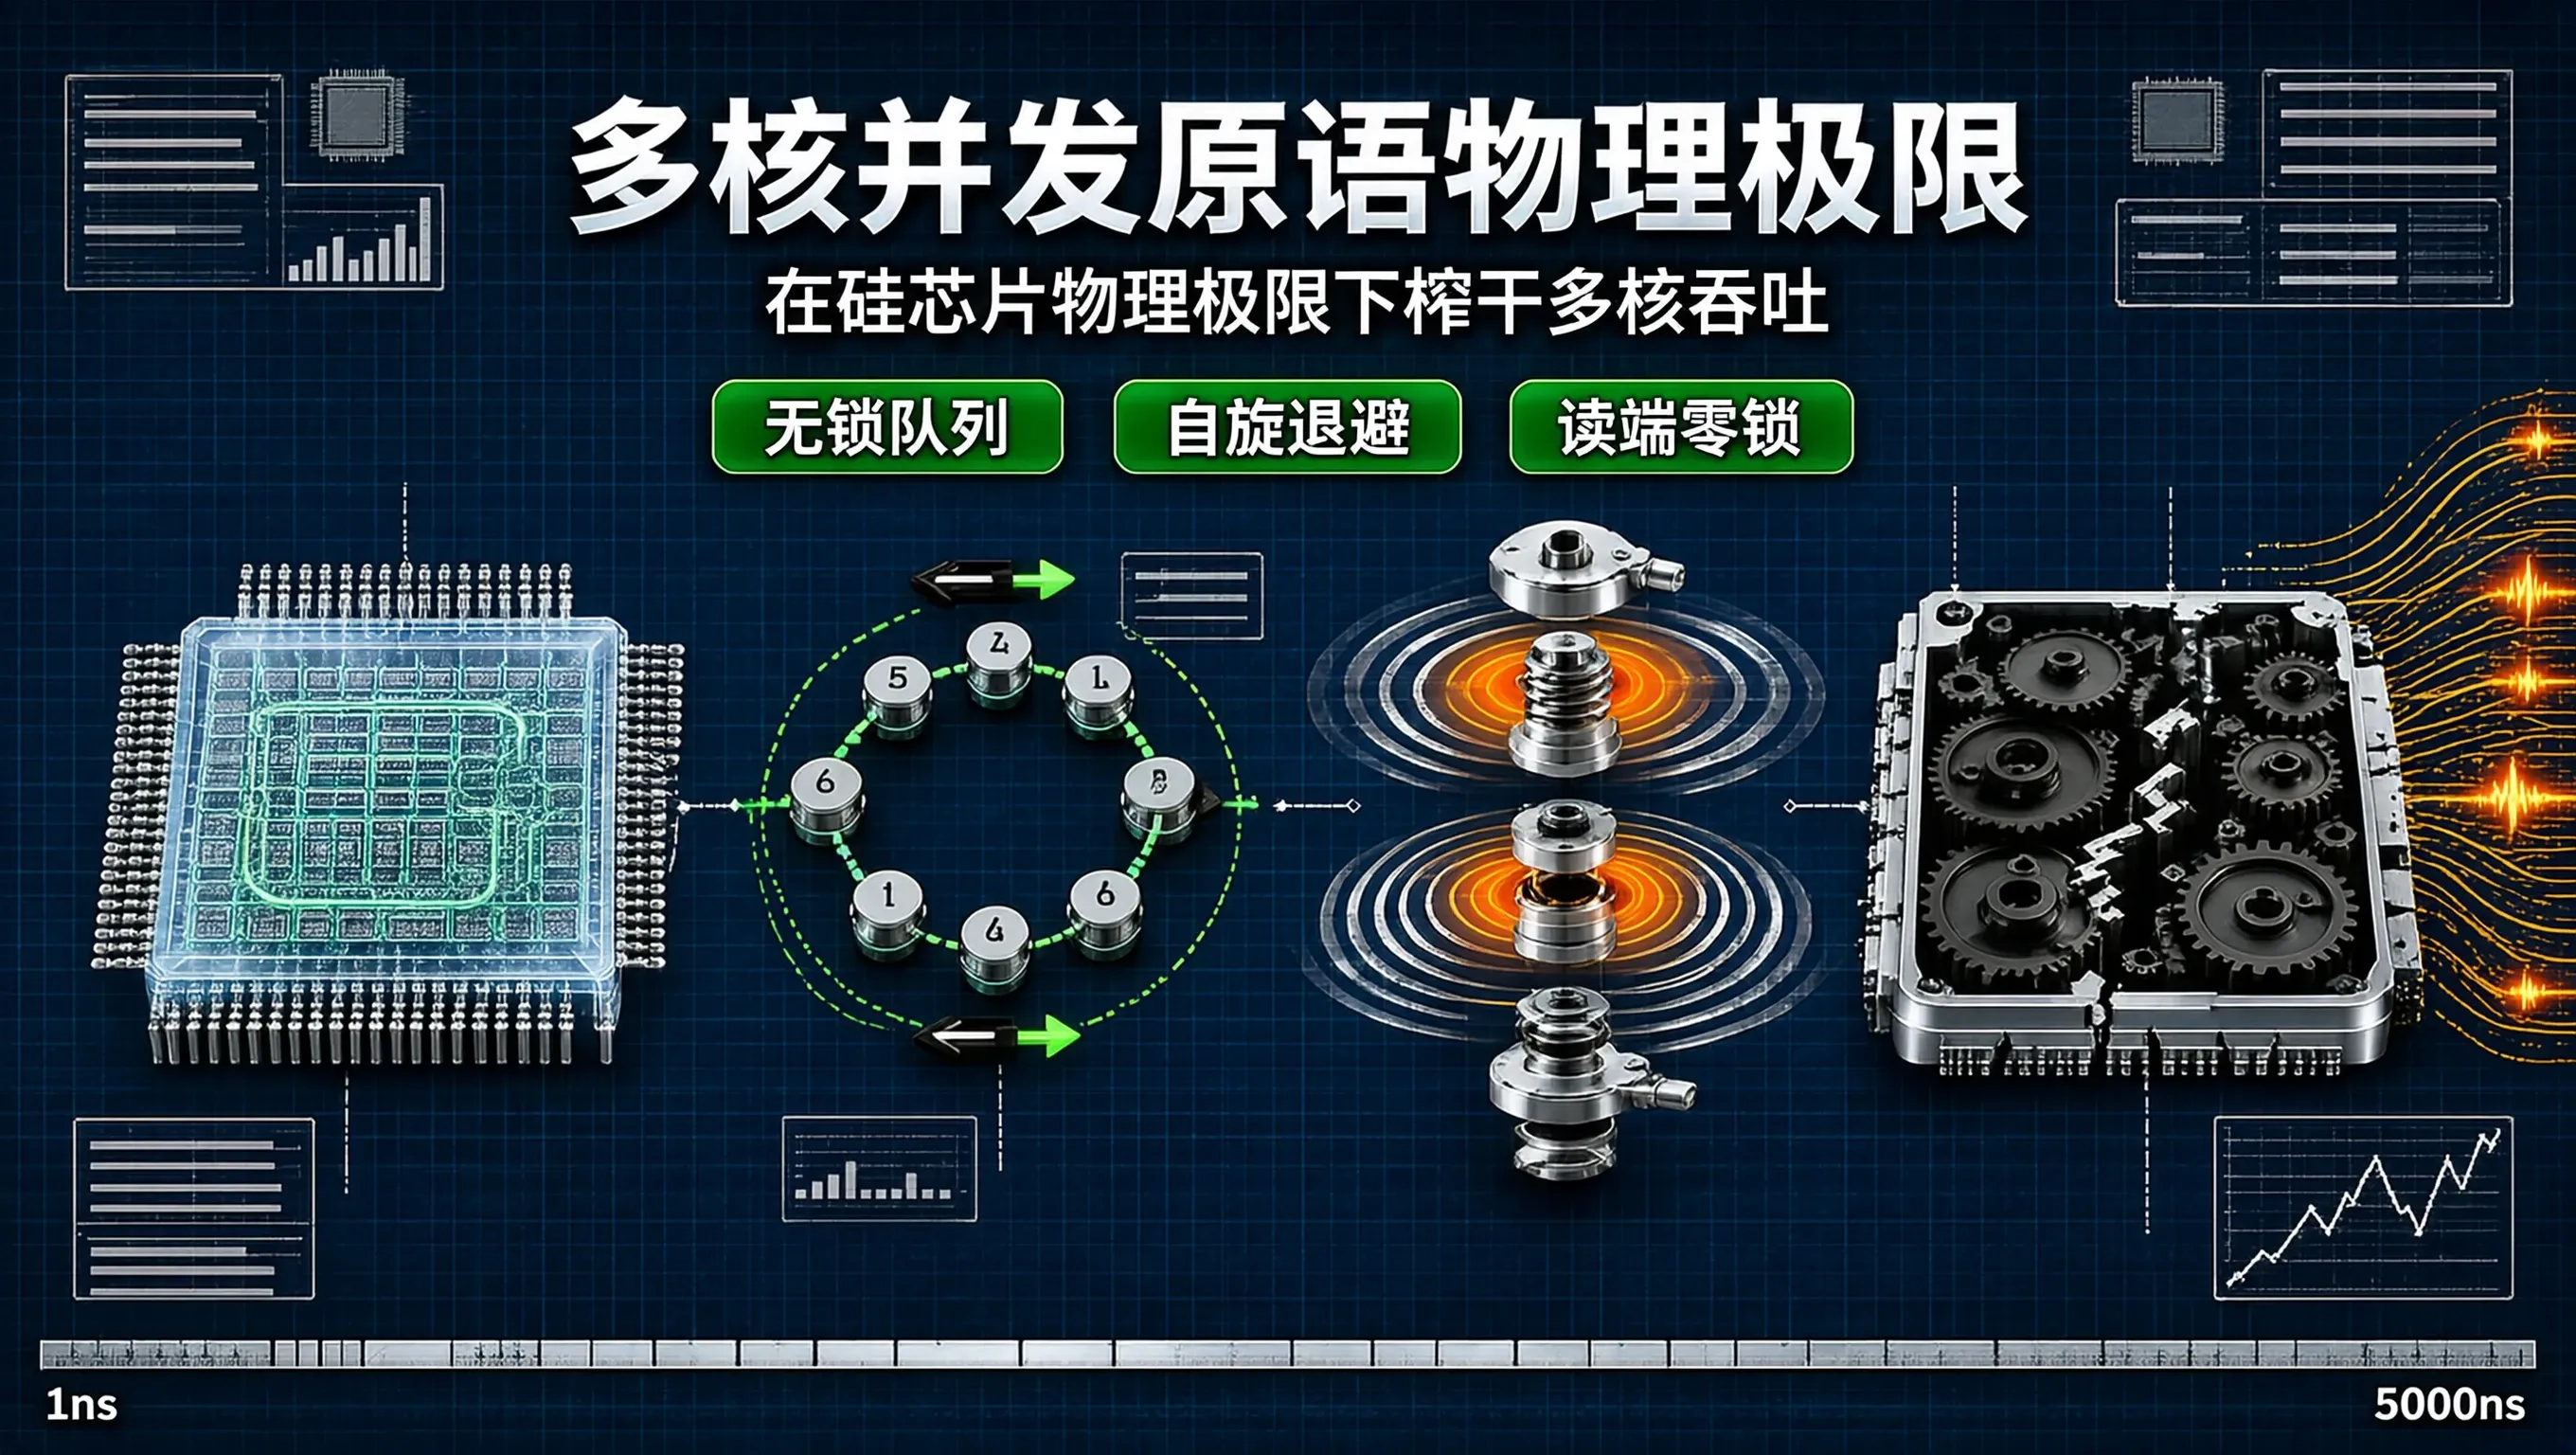
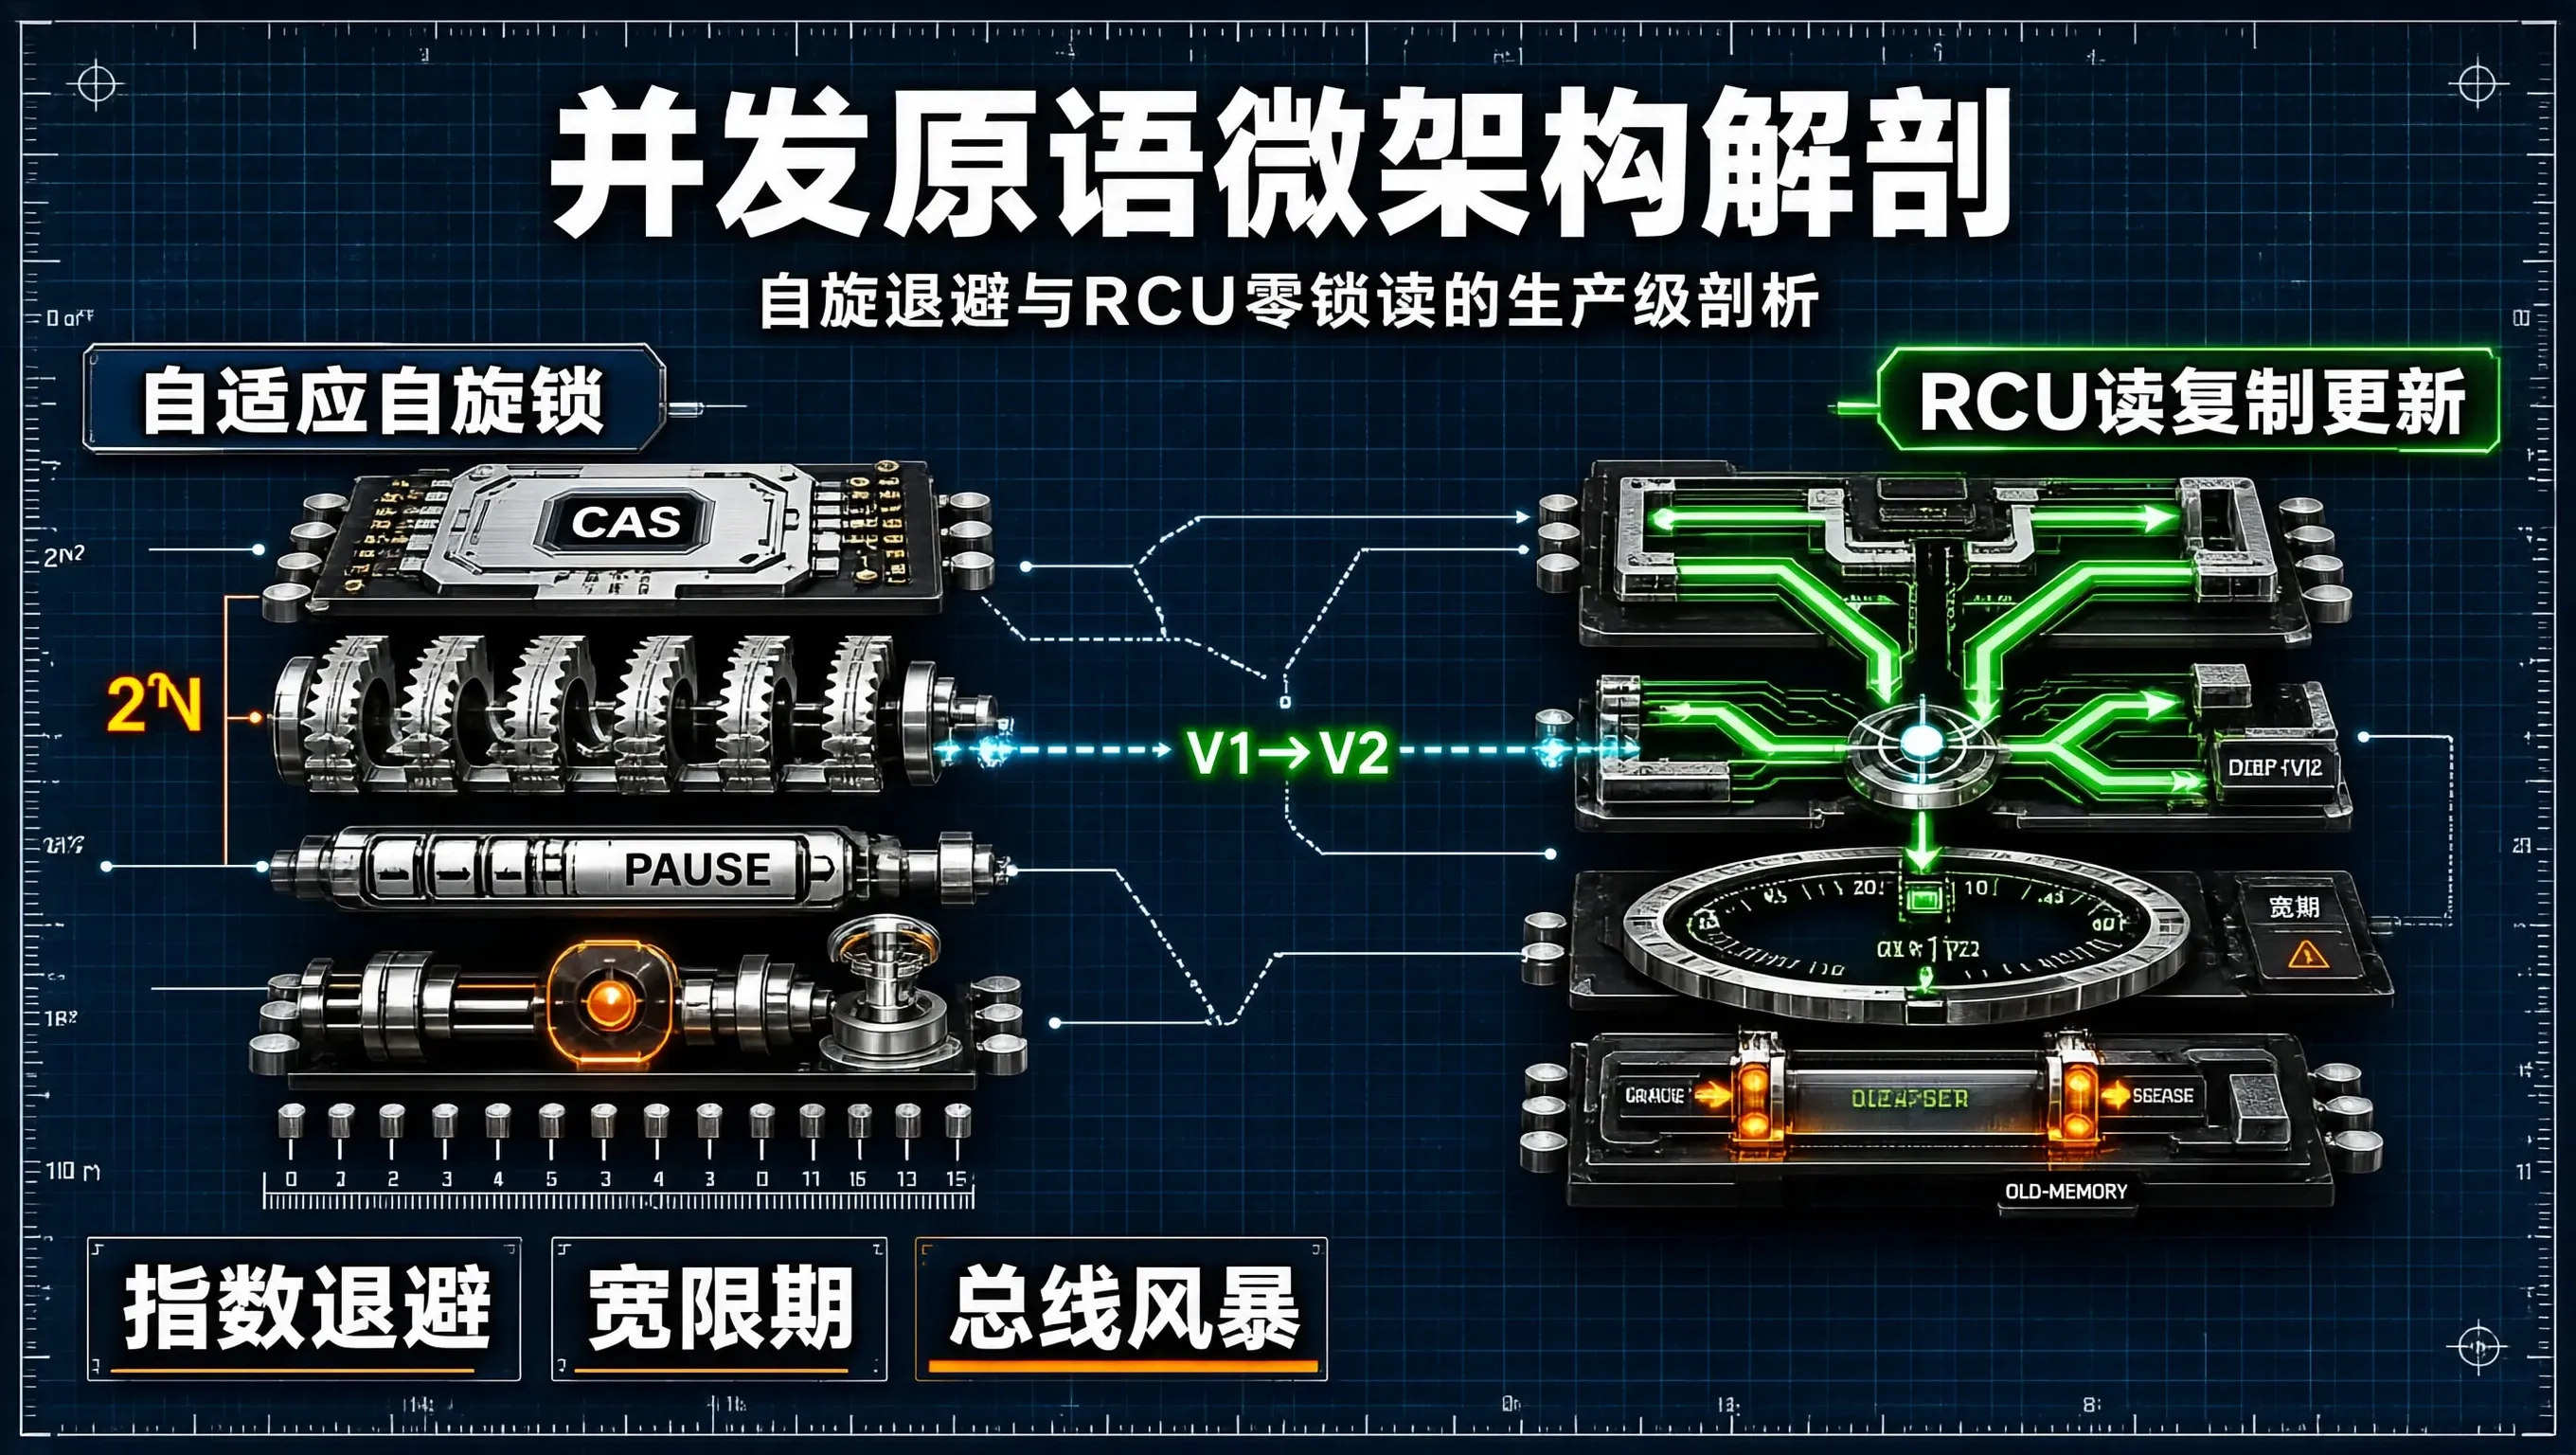
在多核高性能并发编程中,当临界区(Critical Section)极其短小(仅耗时数纳秒到数十纳秒)时,直接使用操作系统的互斥锁(Mutex)会因为陷入内核态 futex 休眠与线程唤醒调度,导致长达数微秒的系统延迟。此时,成为了极客们的首选武器。然而,朴素的自旋锁在多核争用剧烈时,会导致所有争用核心疯狂执行原子指令,引发总线风暴(Bus Storm)并使 CPU 功耗暴增、流水线指令重排崩溃。
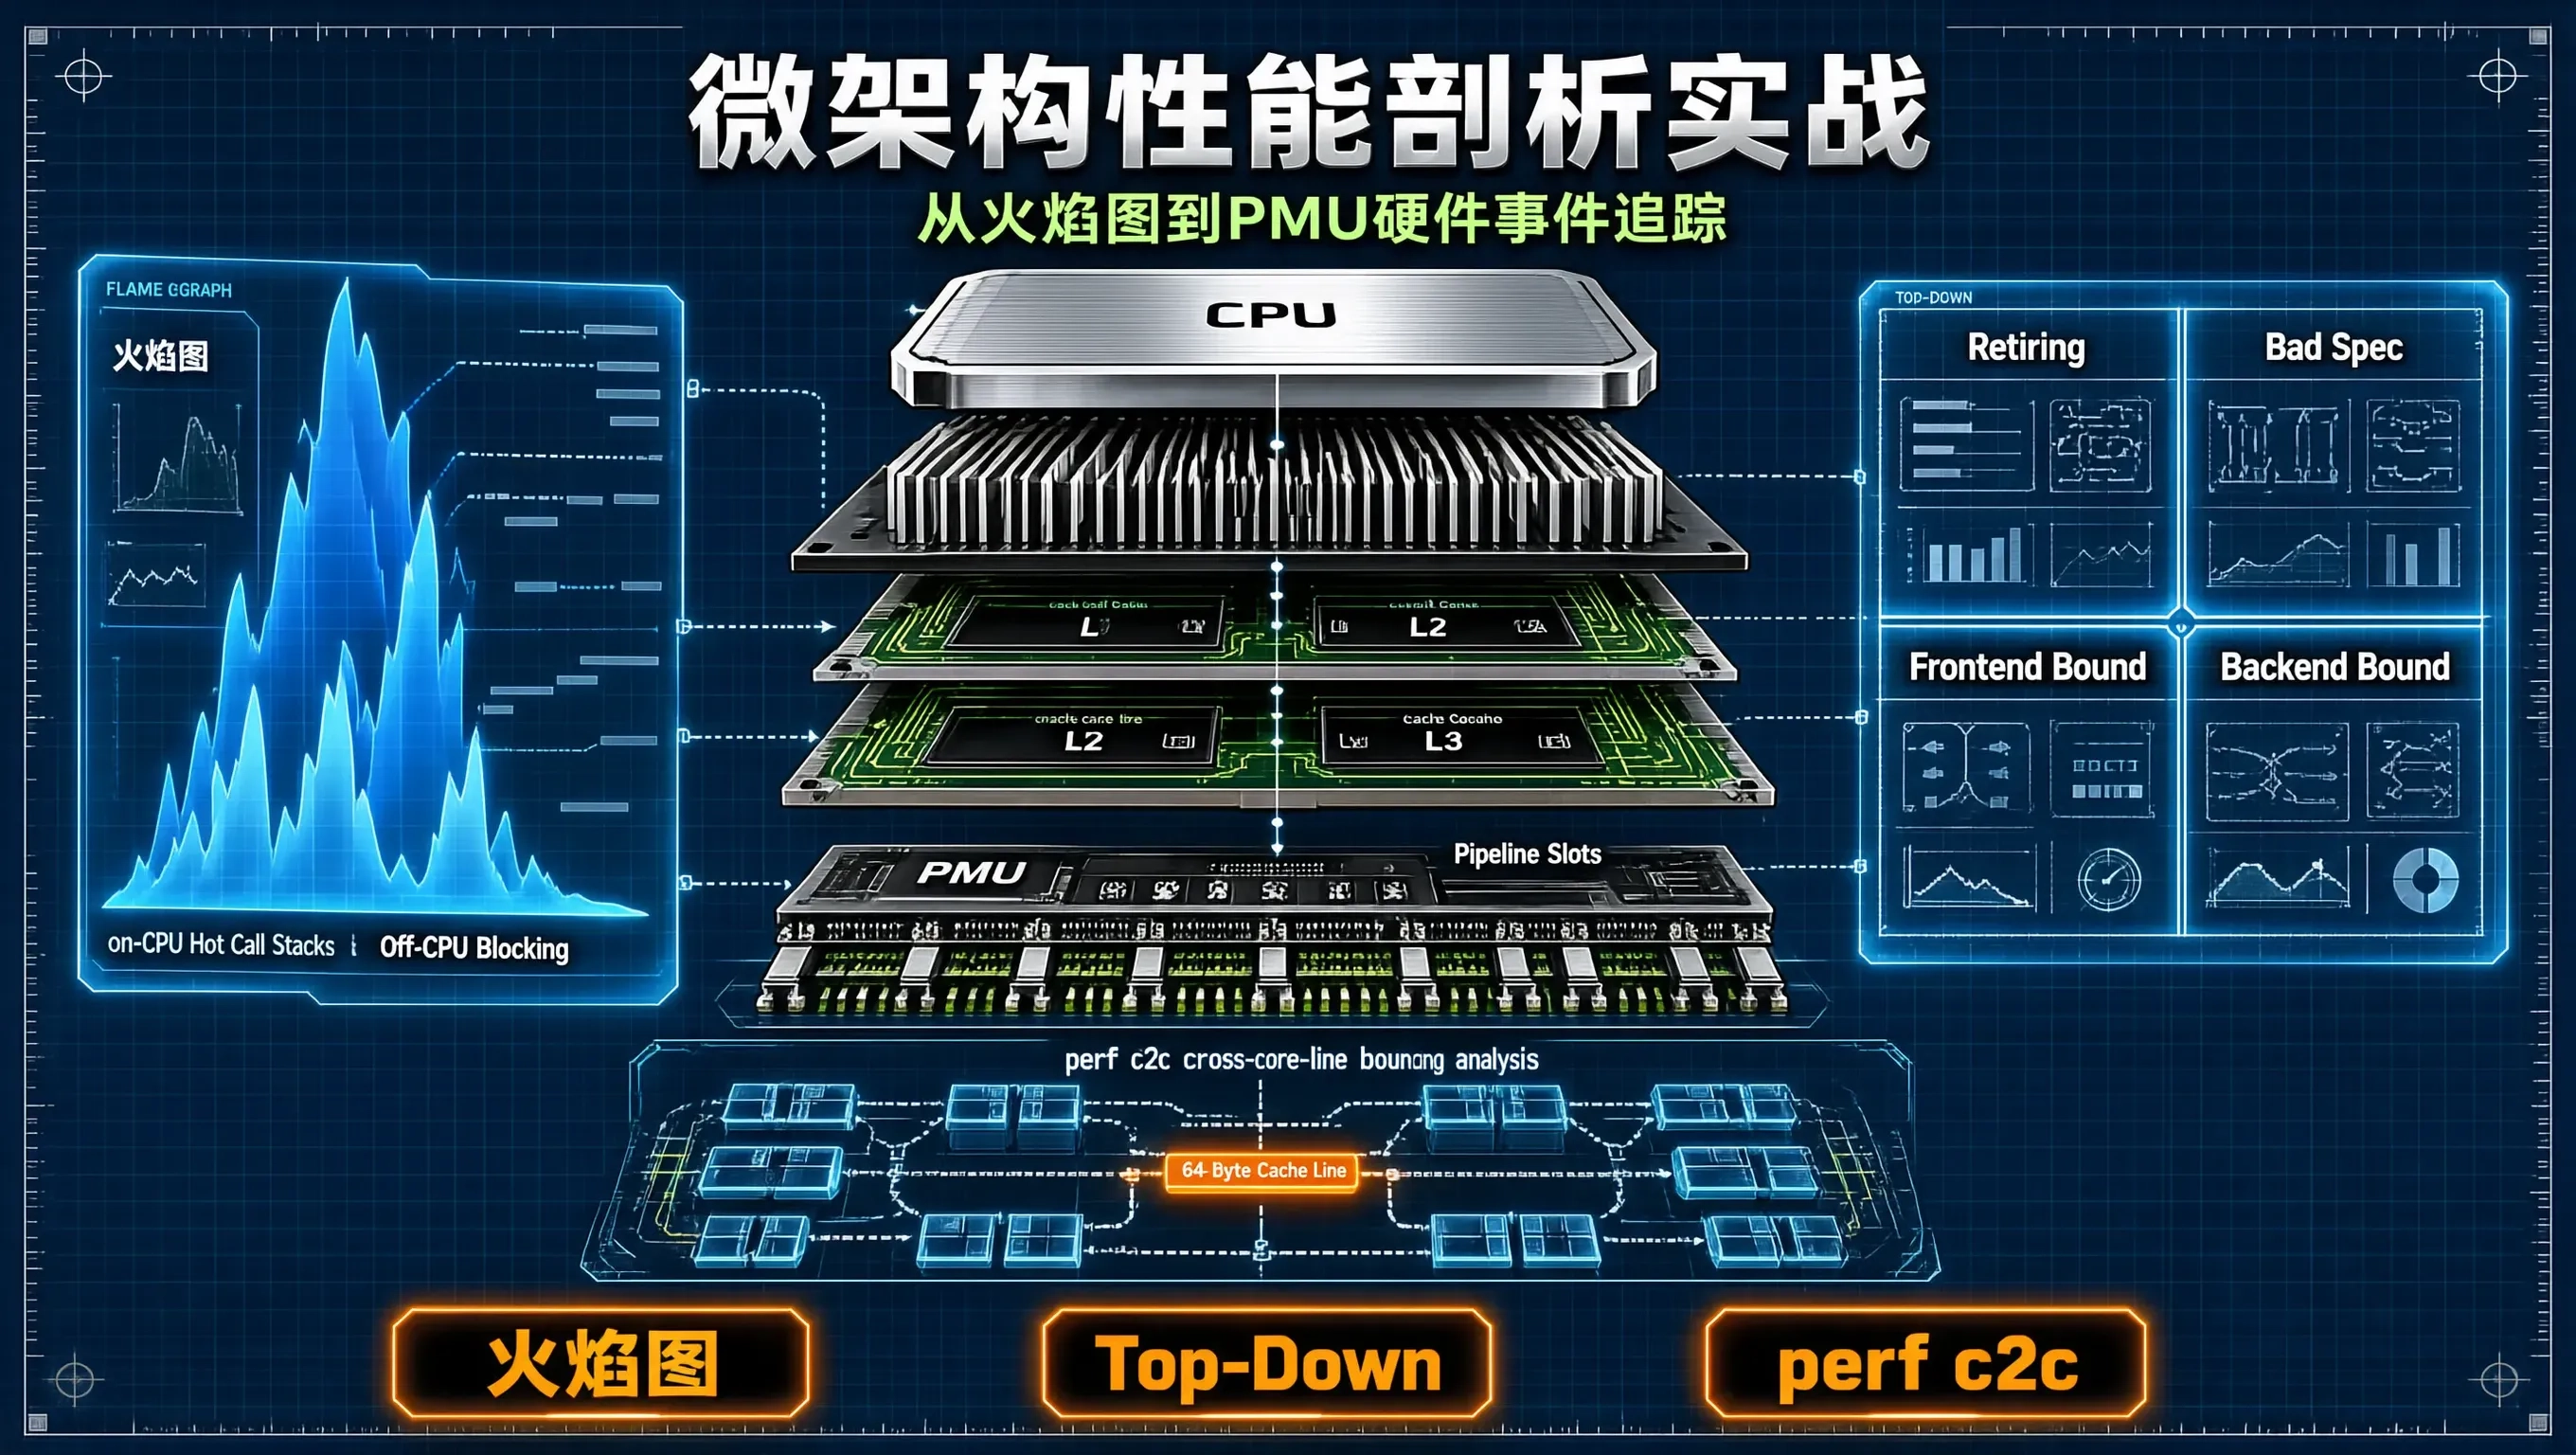
在大型服务端程序与高性能系统的调优实战中,许多工程师往往停留在看应用日志、打印打点耗时或使用通用的 CPU 使用率监控(如 top/htop)。然而,当 CPU 达到瓶颈或系统在低 CPU 利用率下吞吐依然无法提升时,传统的粗粒度监控手段便彻底失效。性能分析(Profiling)的本质是一门建立在硬件微架构(Microarchitecture)与操作系统内核调度基础上的严密诊断科学。从识别算力瓶颈
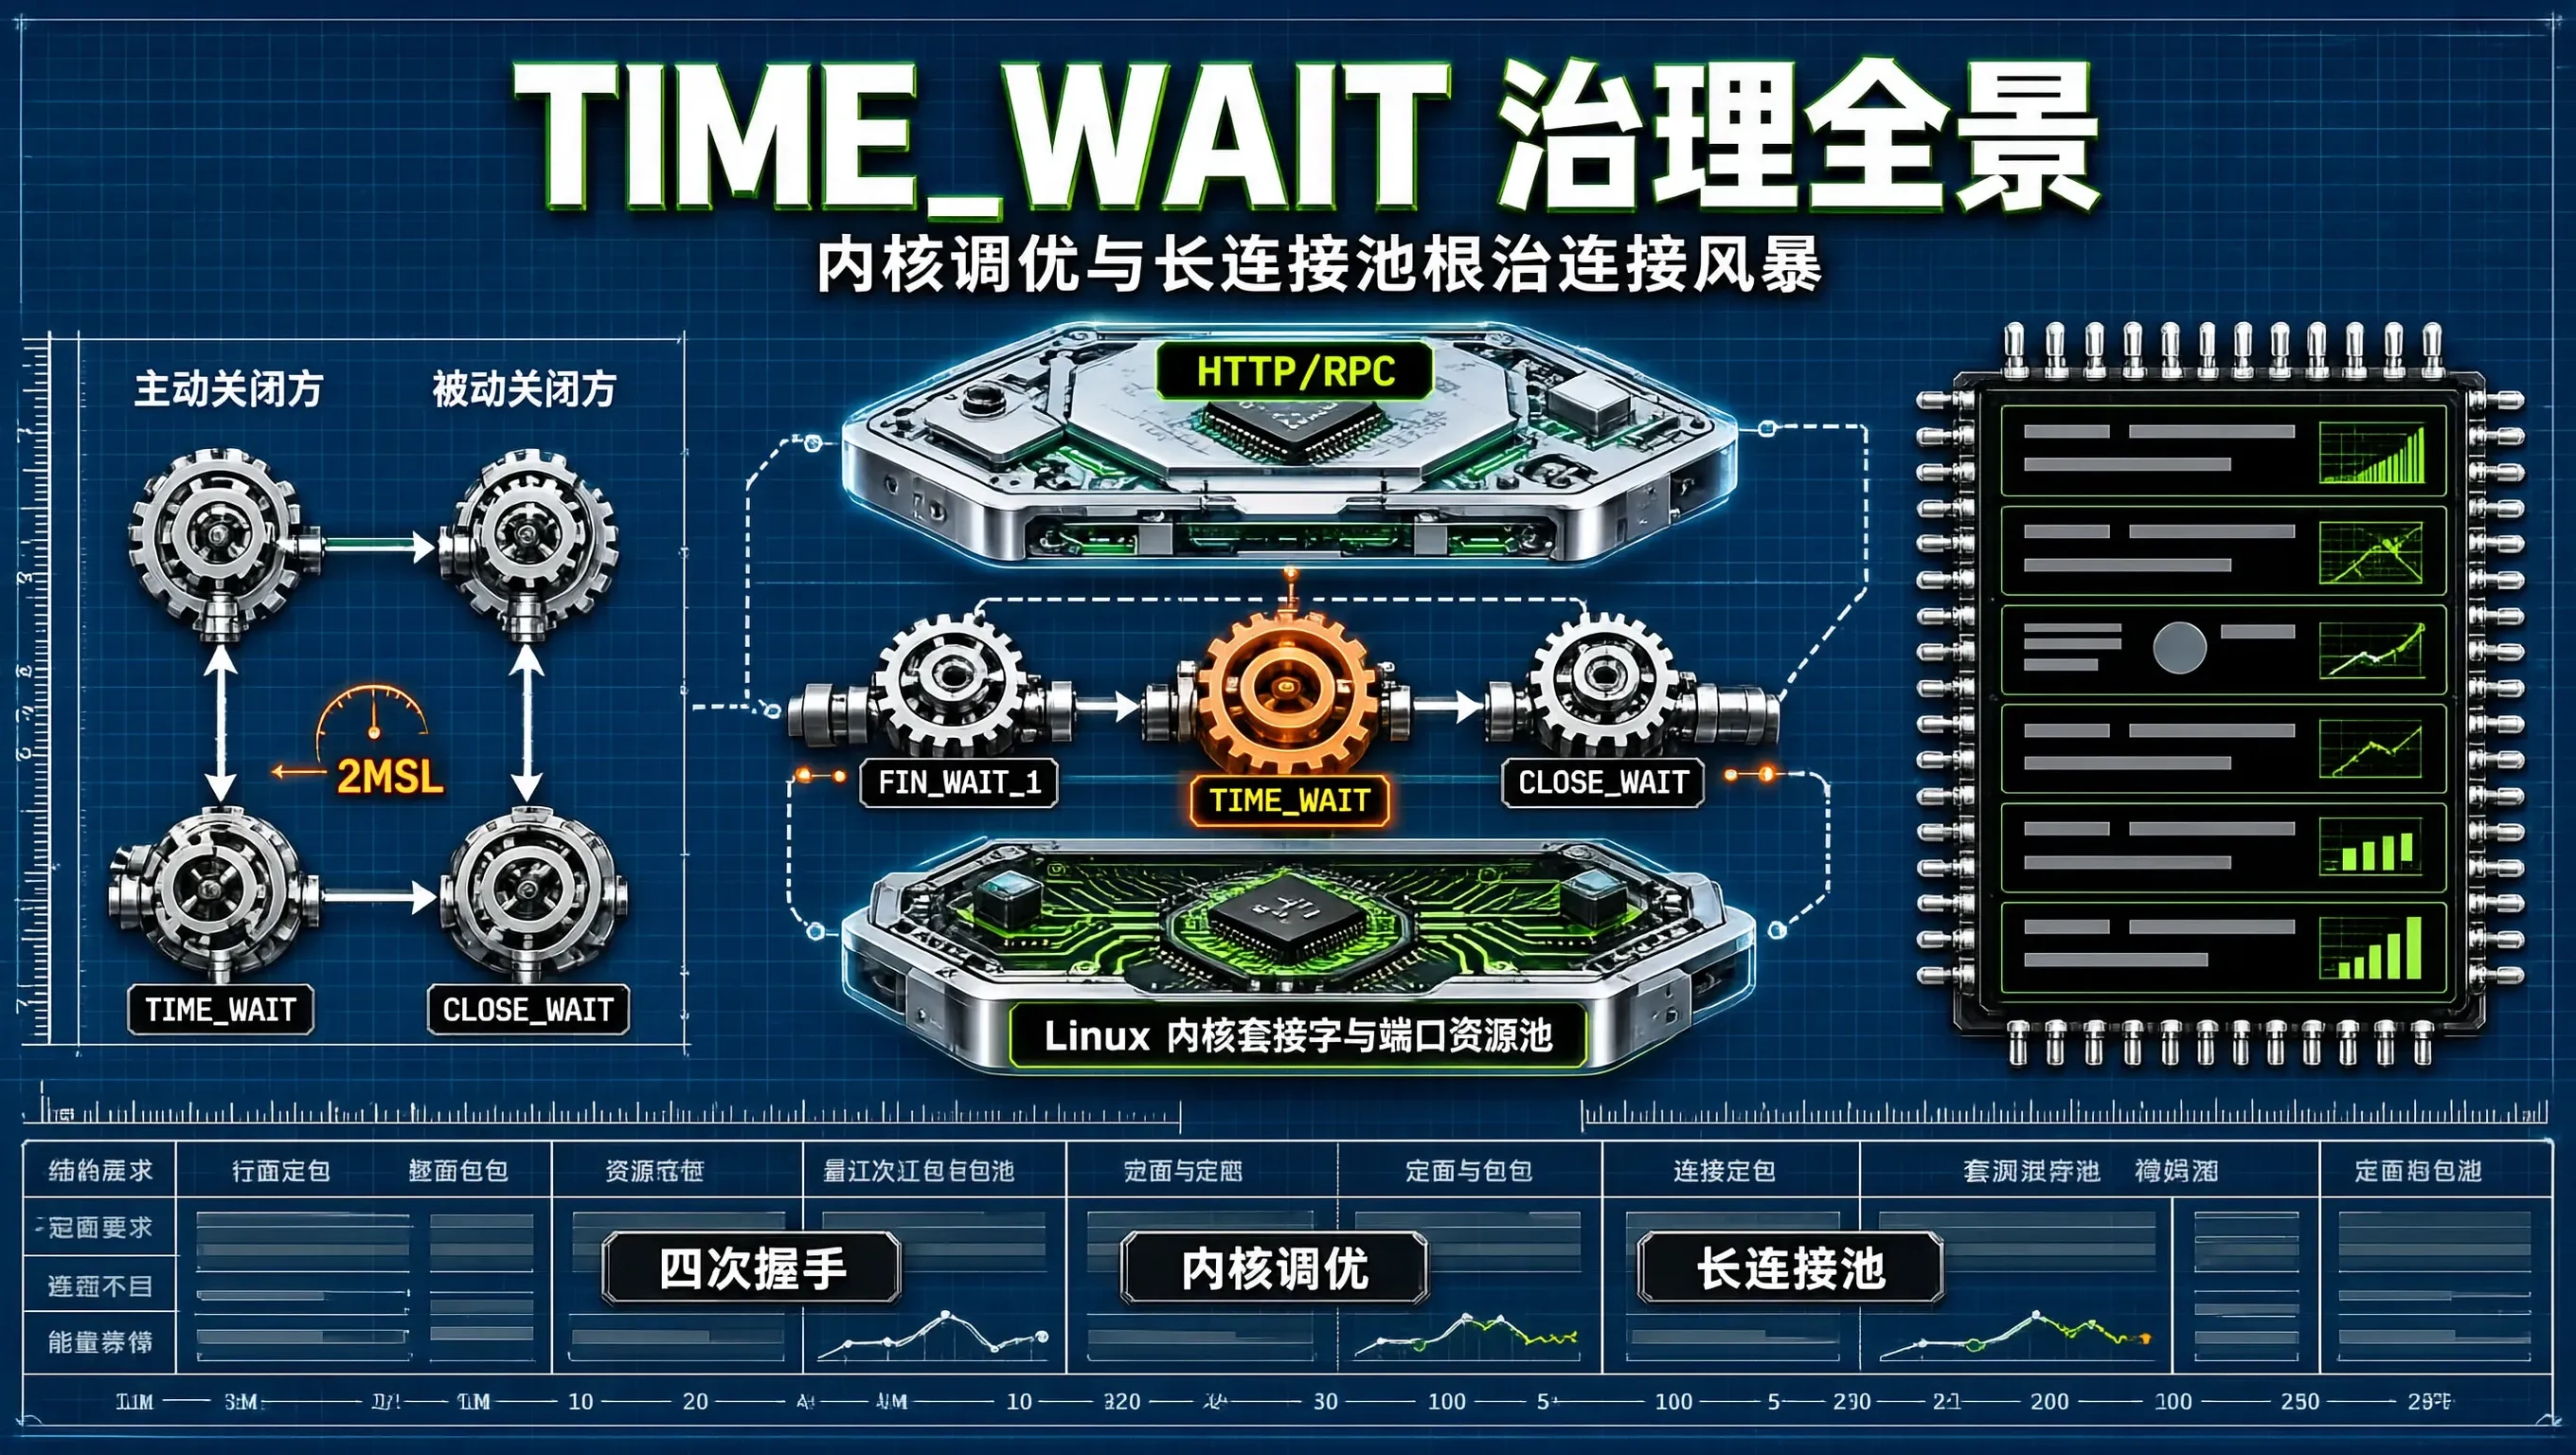
在大促微服务 RPC 相互调用、反向代理与大模型 API 网关集群中,系统工程师经常遭遇一种诡异的“网络瘫痪”:服务器 CPU 占用率不到 20%,内存剩余充足,网络带宽利用率不足 15%,但新发起的 HTTP/RPC 请求却大面积报错(无法分配请求地址)或。通过netstat或ss命令排查,会发现系统中堆积了TIME_WAITCLOSE_WAIT。这些套接字不仅占用了宝贵的内核内存,更耗尽了操作
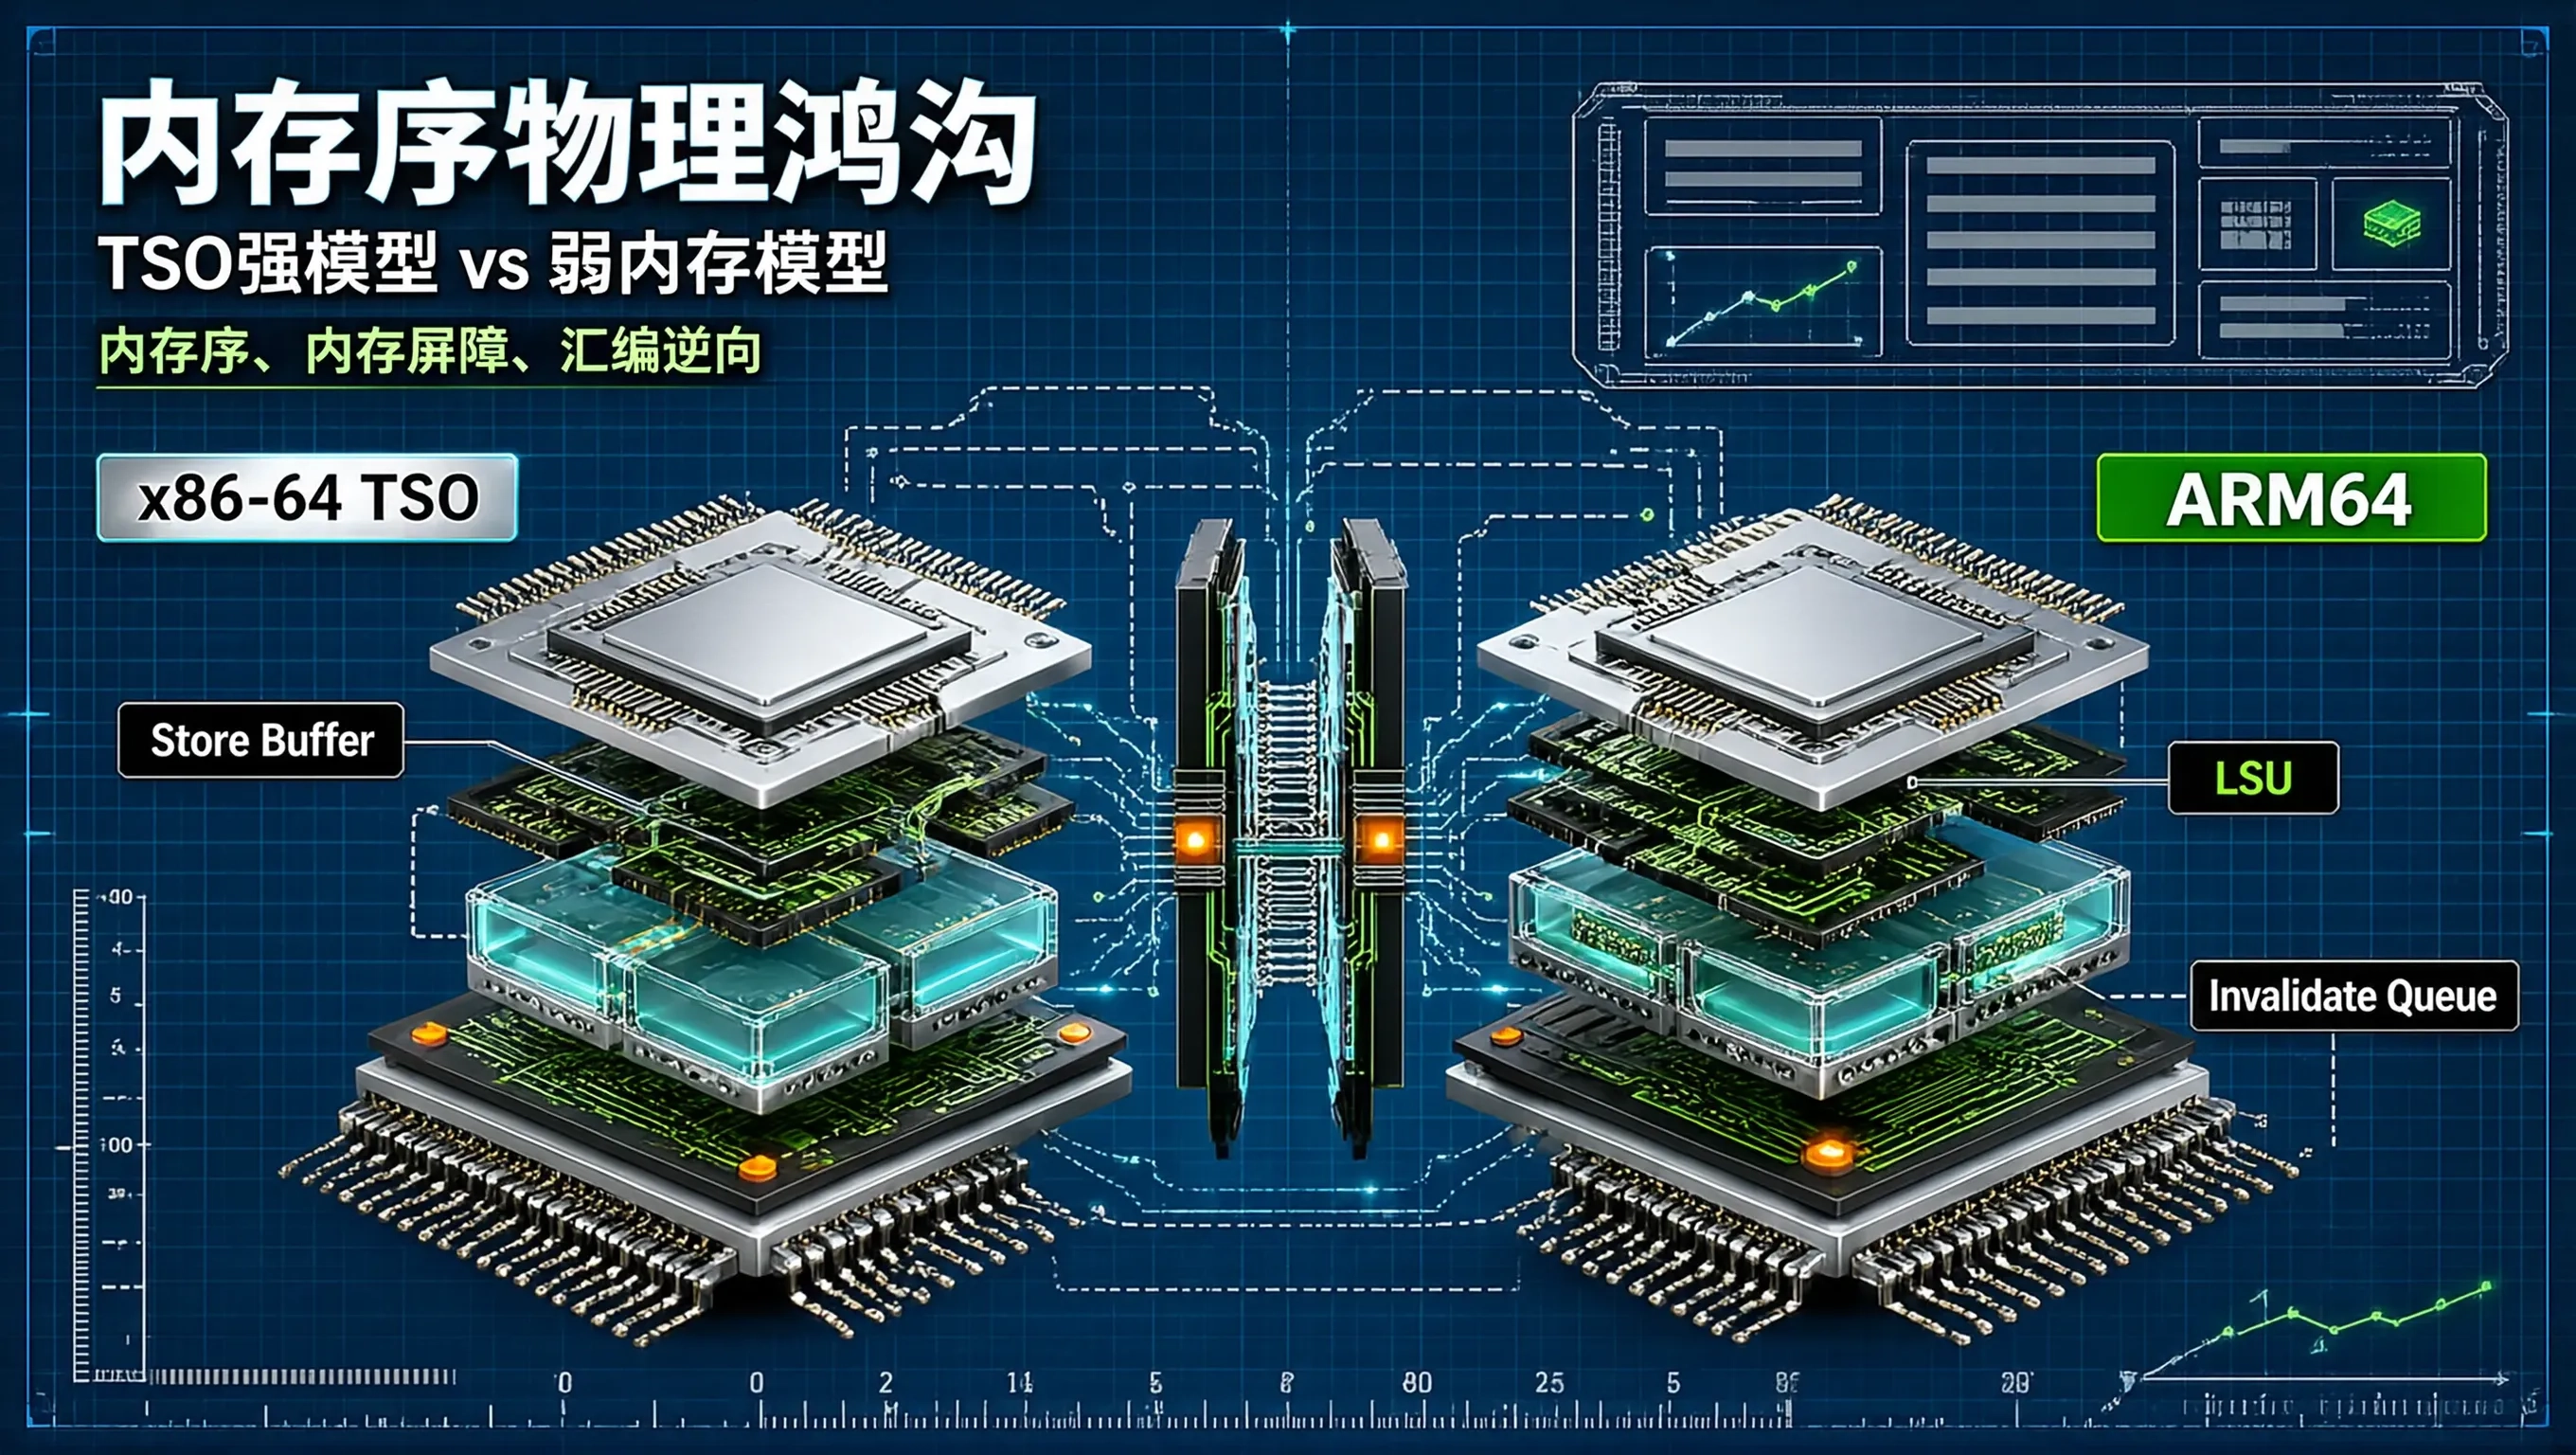
在现代高性能系统级编程(C++、Rust、Go)中,内存序(Memory Ordering)与原子操作是无锁并发数据结构(如无锁队列、原子引用计数、无锁跳表)中最深奥、也最容易引发诡异并发 Bug 的微架构深水区。然而,高级语言层面上完全相同的 Acquire-Release 代码,在 x86-64 架构芯片(Intel / AMD)与 ARM64 架构芯片(Apple Silicon、AWS G
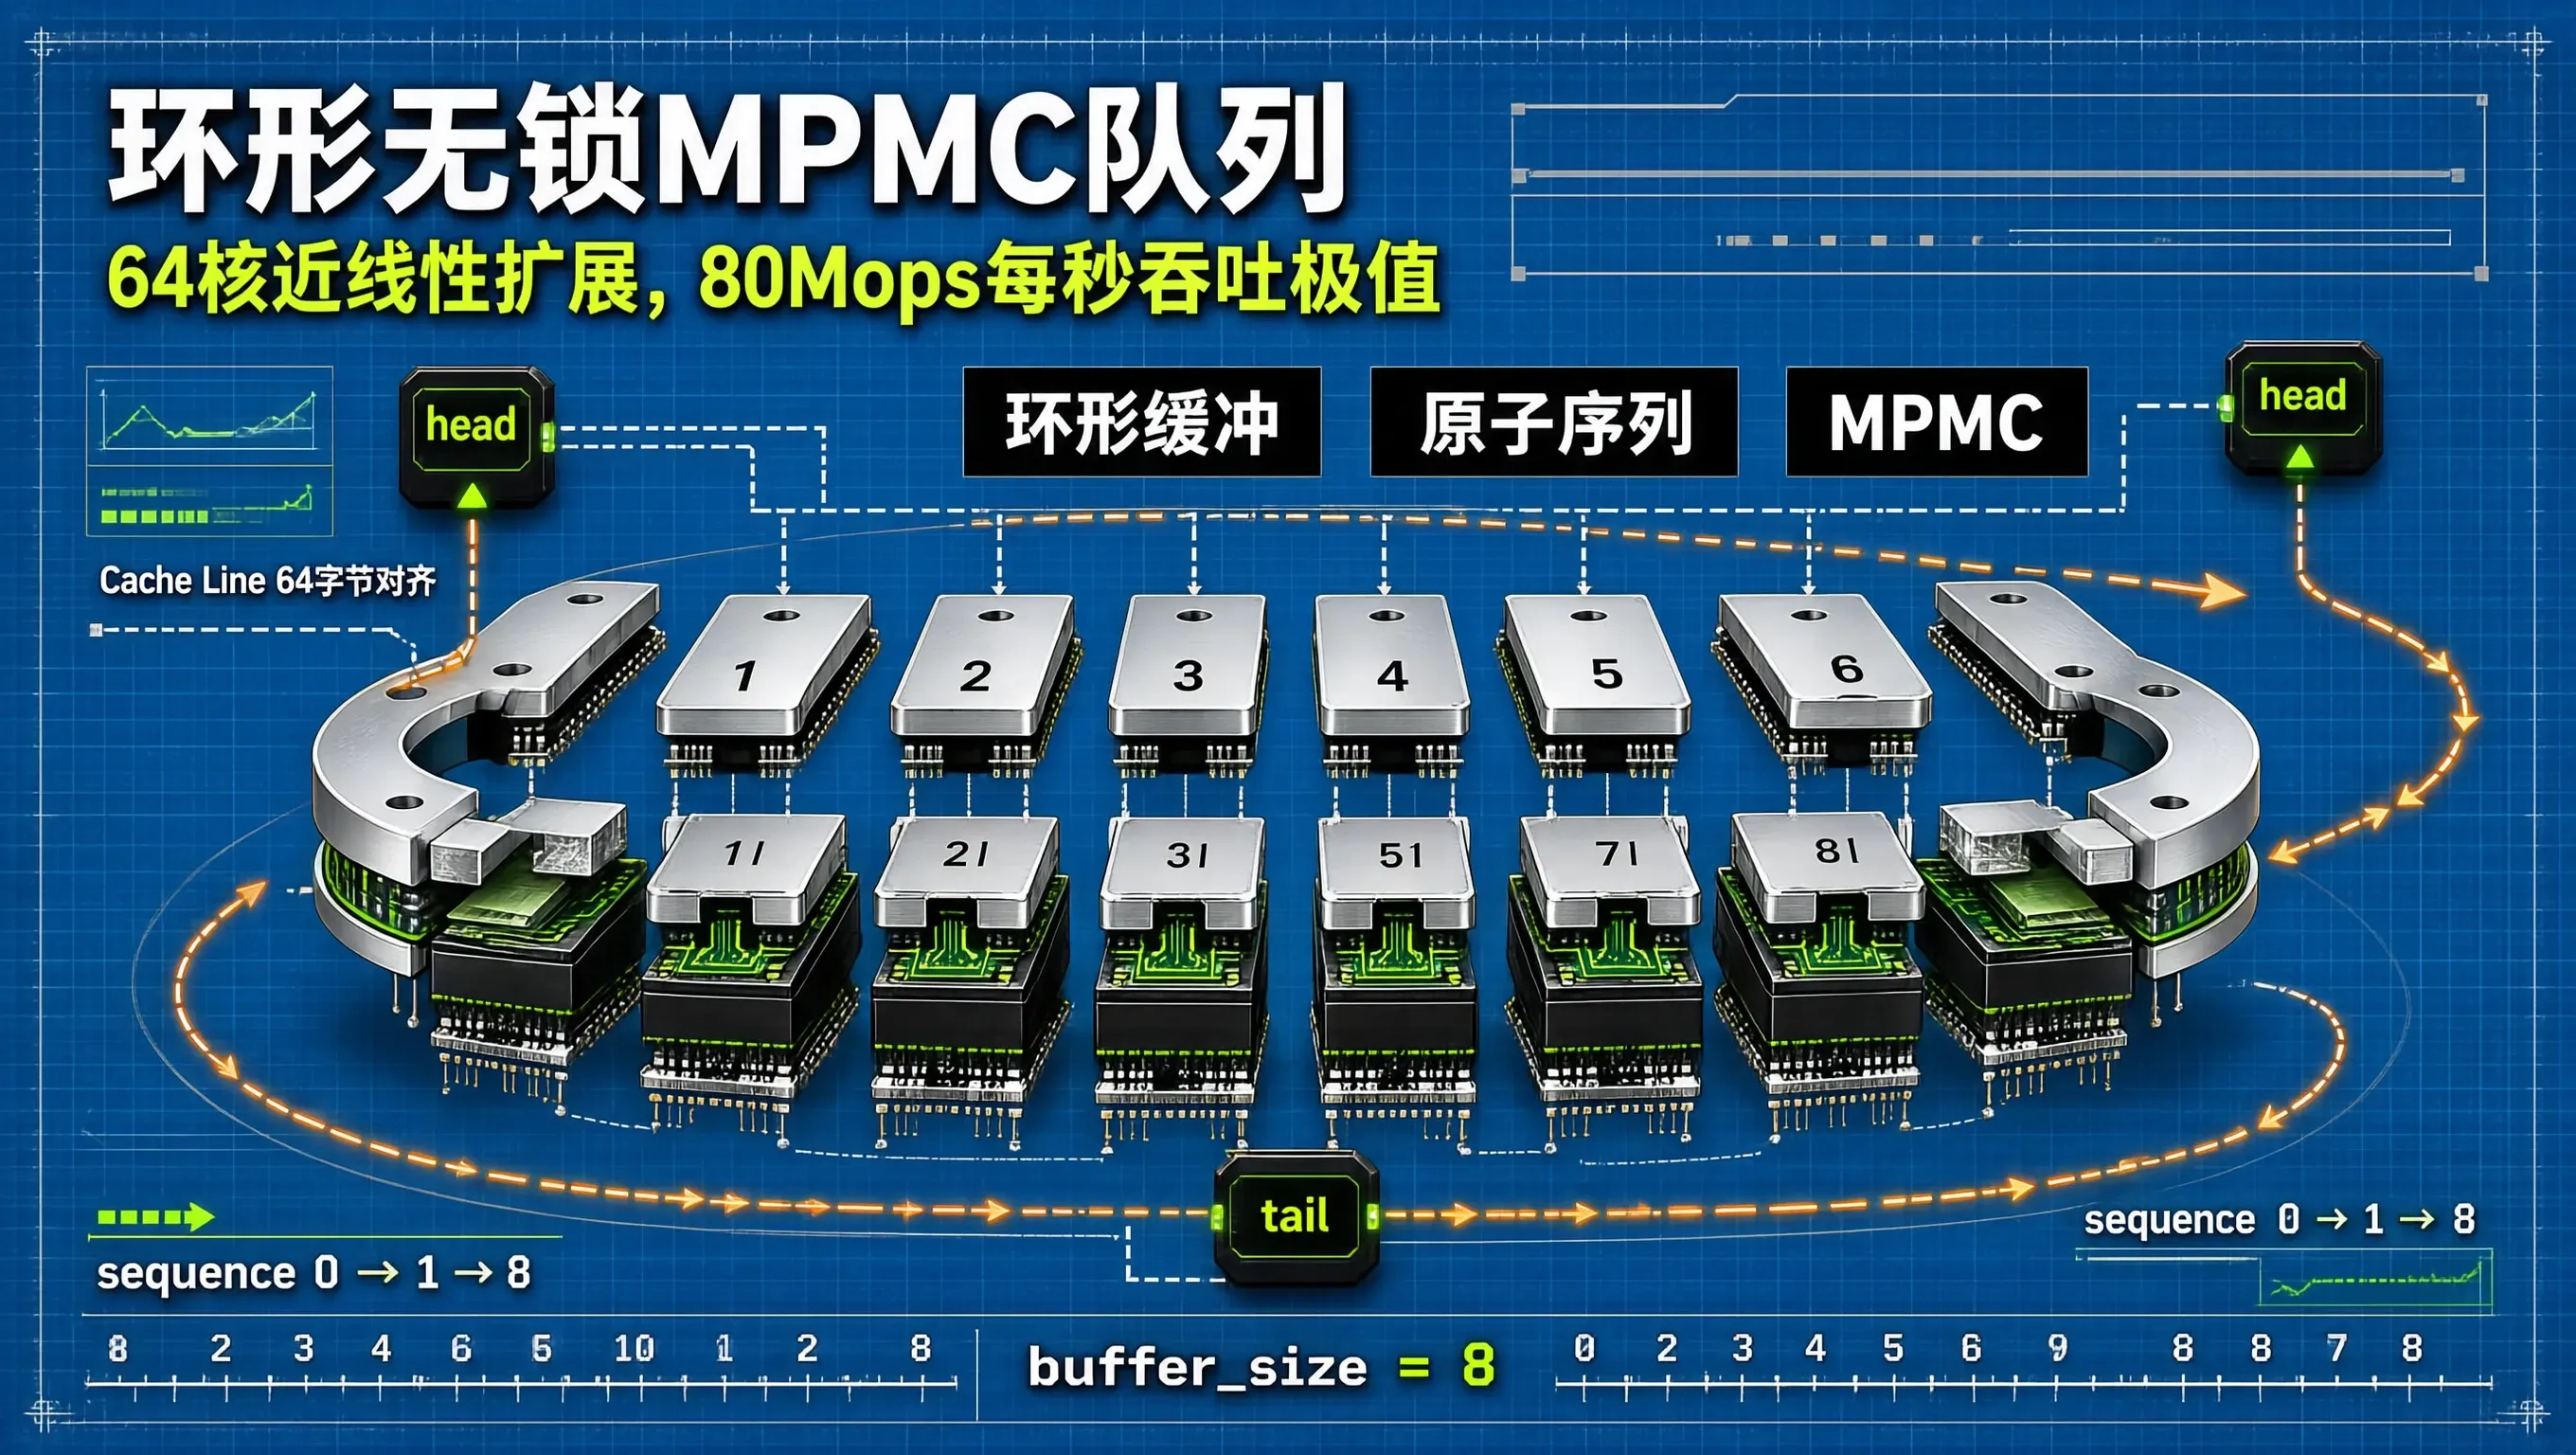
在现代多核高并发系统(如异步 Actor 框架、高性能日志收集器、分布式 RPC 线程池与撮合引擎)的底层架构中,多生产者多消费者(MPMC, Multi-Producer Multi-Consumer)无锁队列是被广泛依赖的高性能并发原语。传统的基于std::mutex互斥锁的 MPMC 队列在 32 核或 64 核高并发负载下,会引发剧烈的锁争用与频繁的操作系统上下文切换,导致吞吐量断崖式下滑
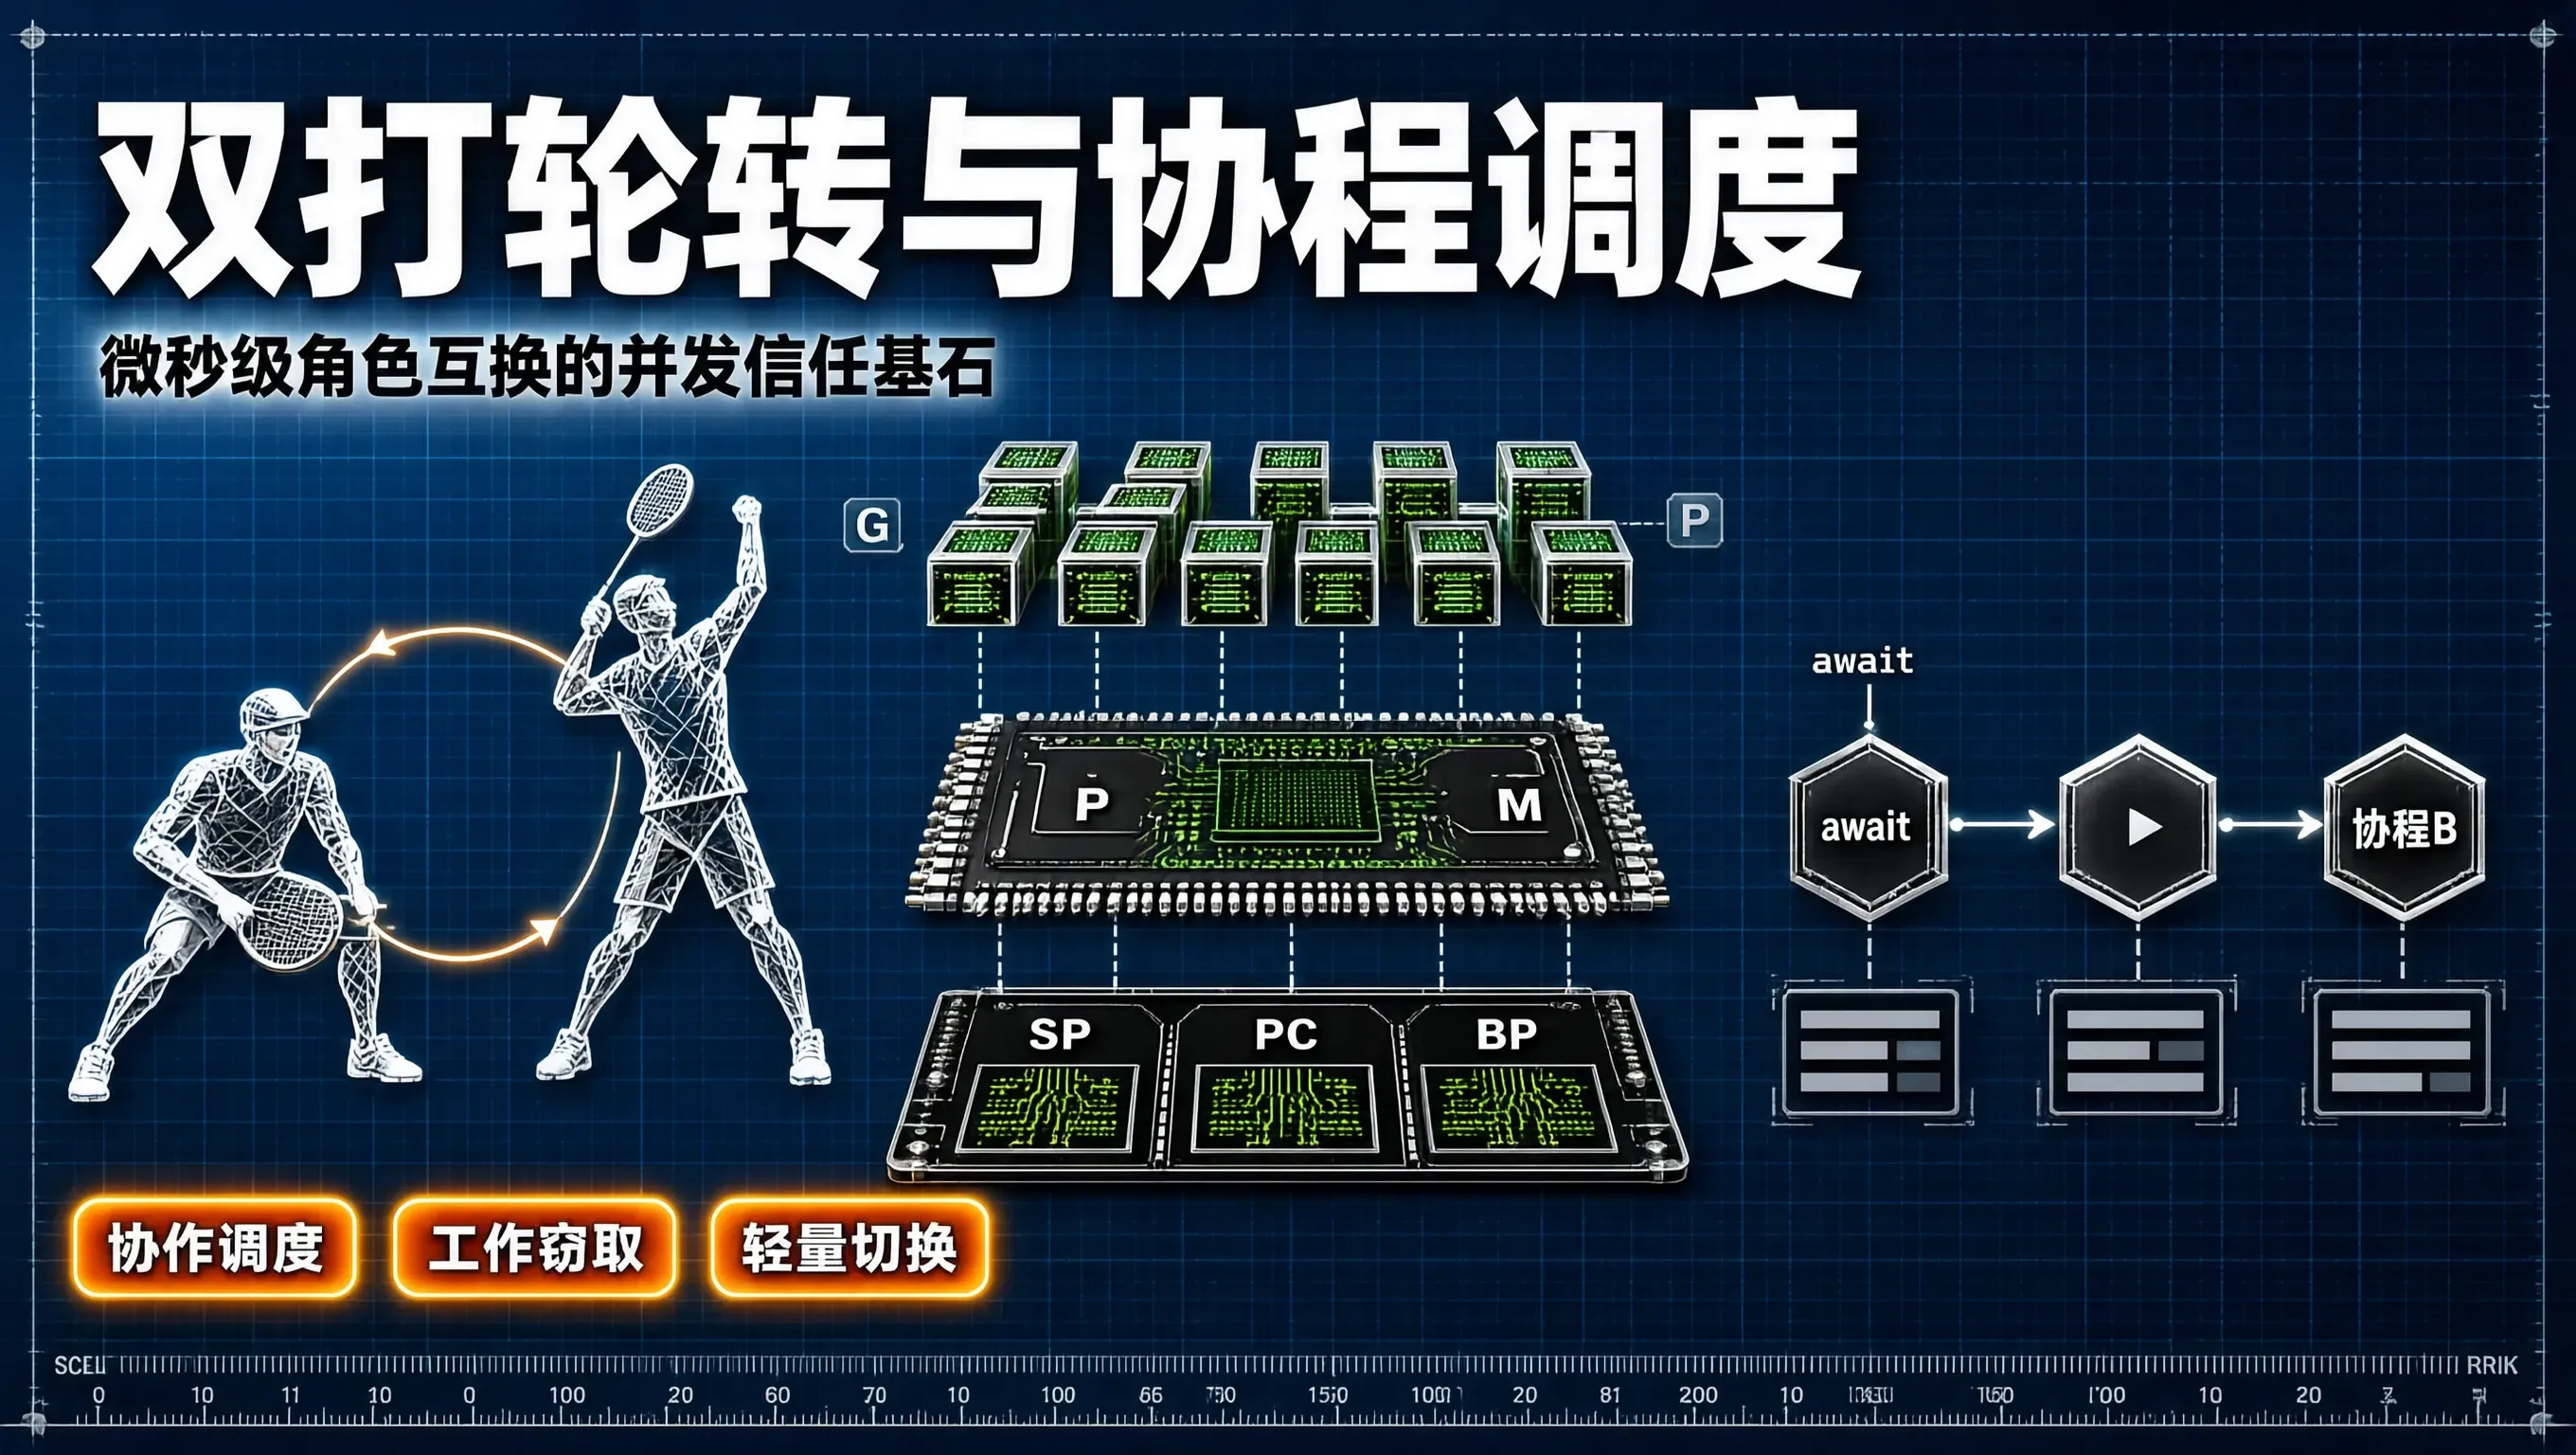
在羽毛球竞技体系中,高水平双打对抗的节奏极快、攻防转换极其剧烈。在整个轮转过程中,前场队员绝对不会回头去看搭档。他之所以敢毫无顾忌地全力向前封网,是因为对搭档拥有绝对的信任——他确信只要自己前插,身后的整片后场空档就一定会被搭档在几十毫秒内精准补位。将这种依托协作契约实现微秒级角色互换的竞技智慧投射到操作系统与并发架构中,现代编程语言中的协程调度(如 Go 的 G-P-M、Rust 的 Async
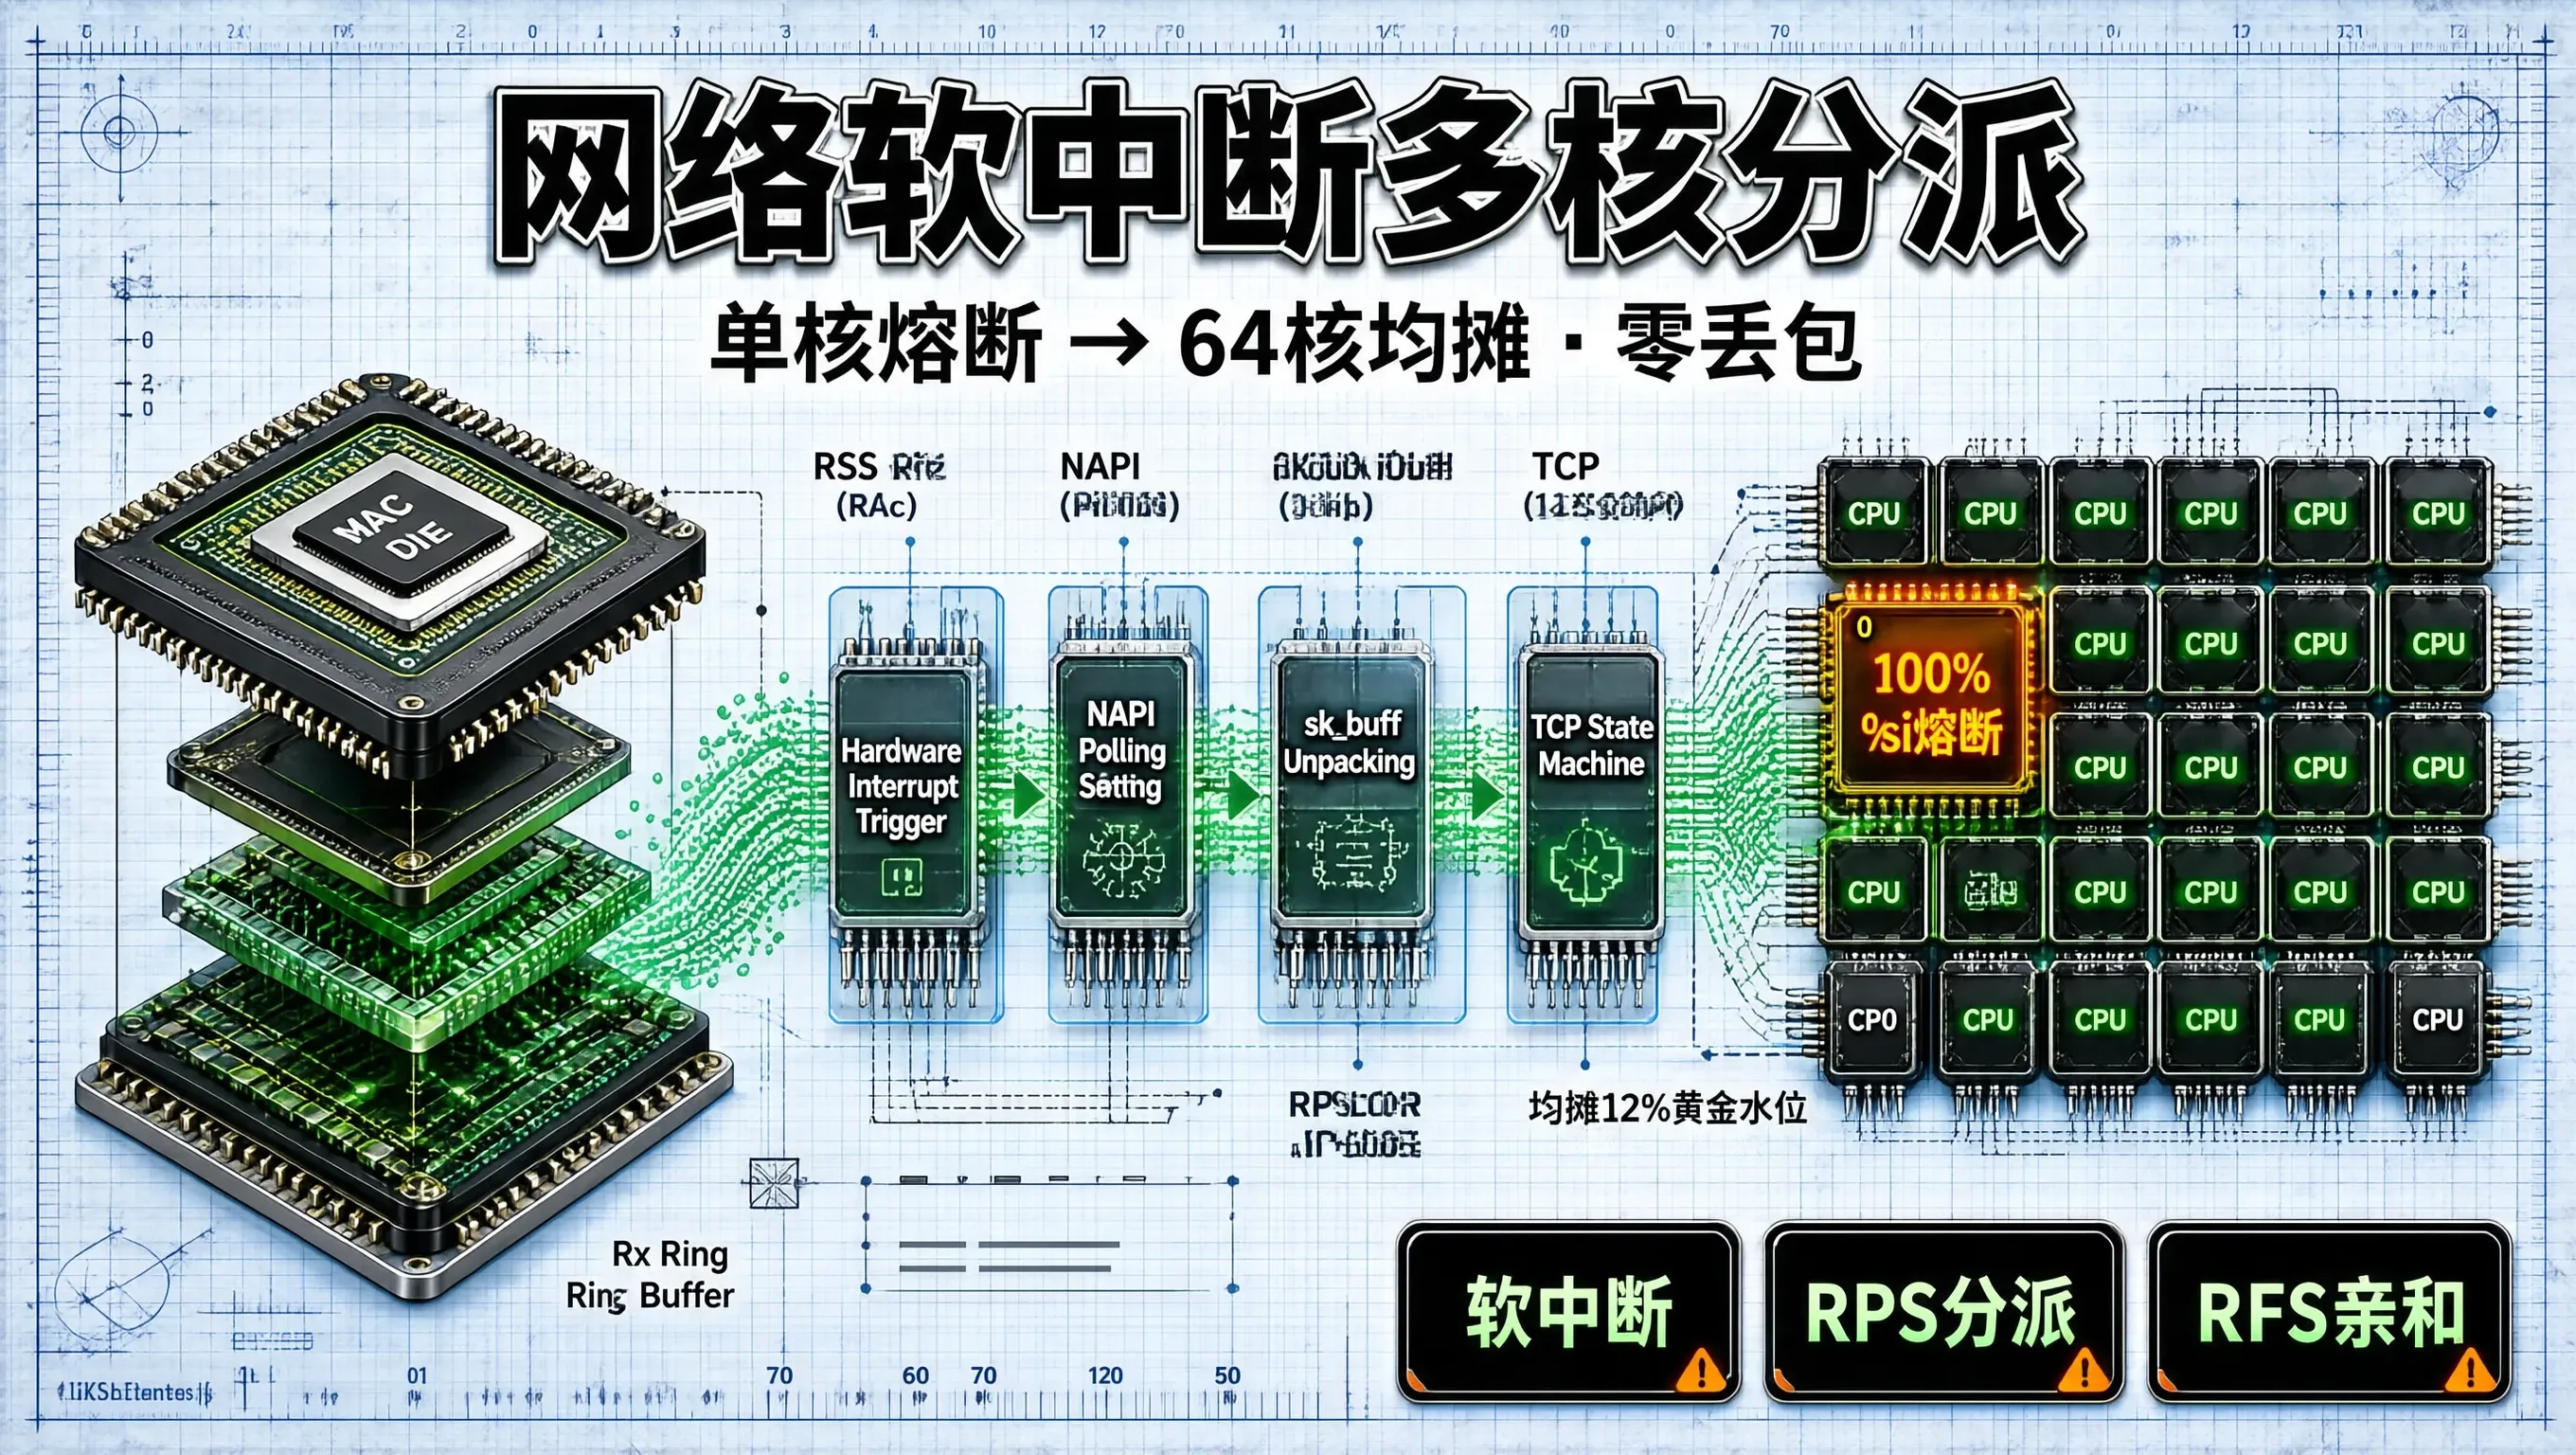
现代高并发系统的性能极限,往往受制于操作系统协议栈最底层的时钟与中断分配。搞懂硬中断与NET_RX软中断的微观流转,合理利用 RPS/RFS 机制将单核重压化解于多核阵列之中,才能让服务器的每一颗 CPU 核心协同共振,在海量网络洪峰的冲击下保持绝对的从容与流畅。
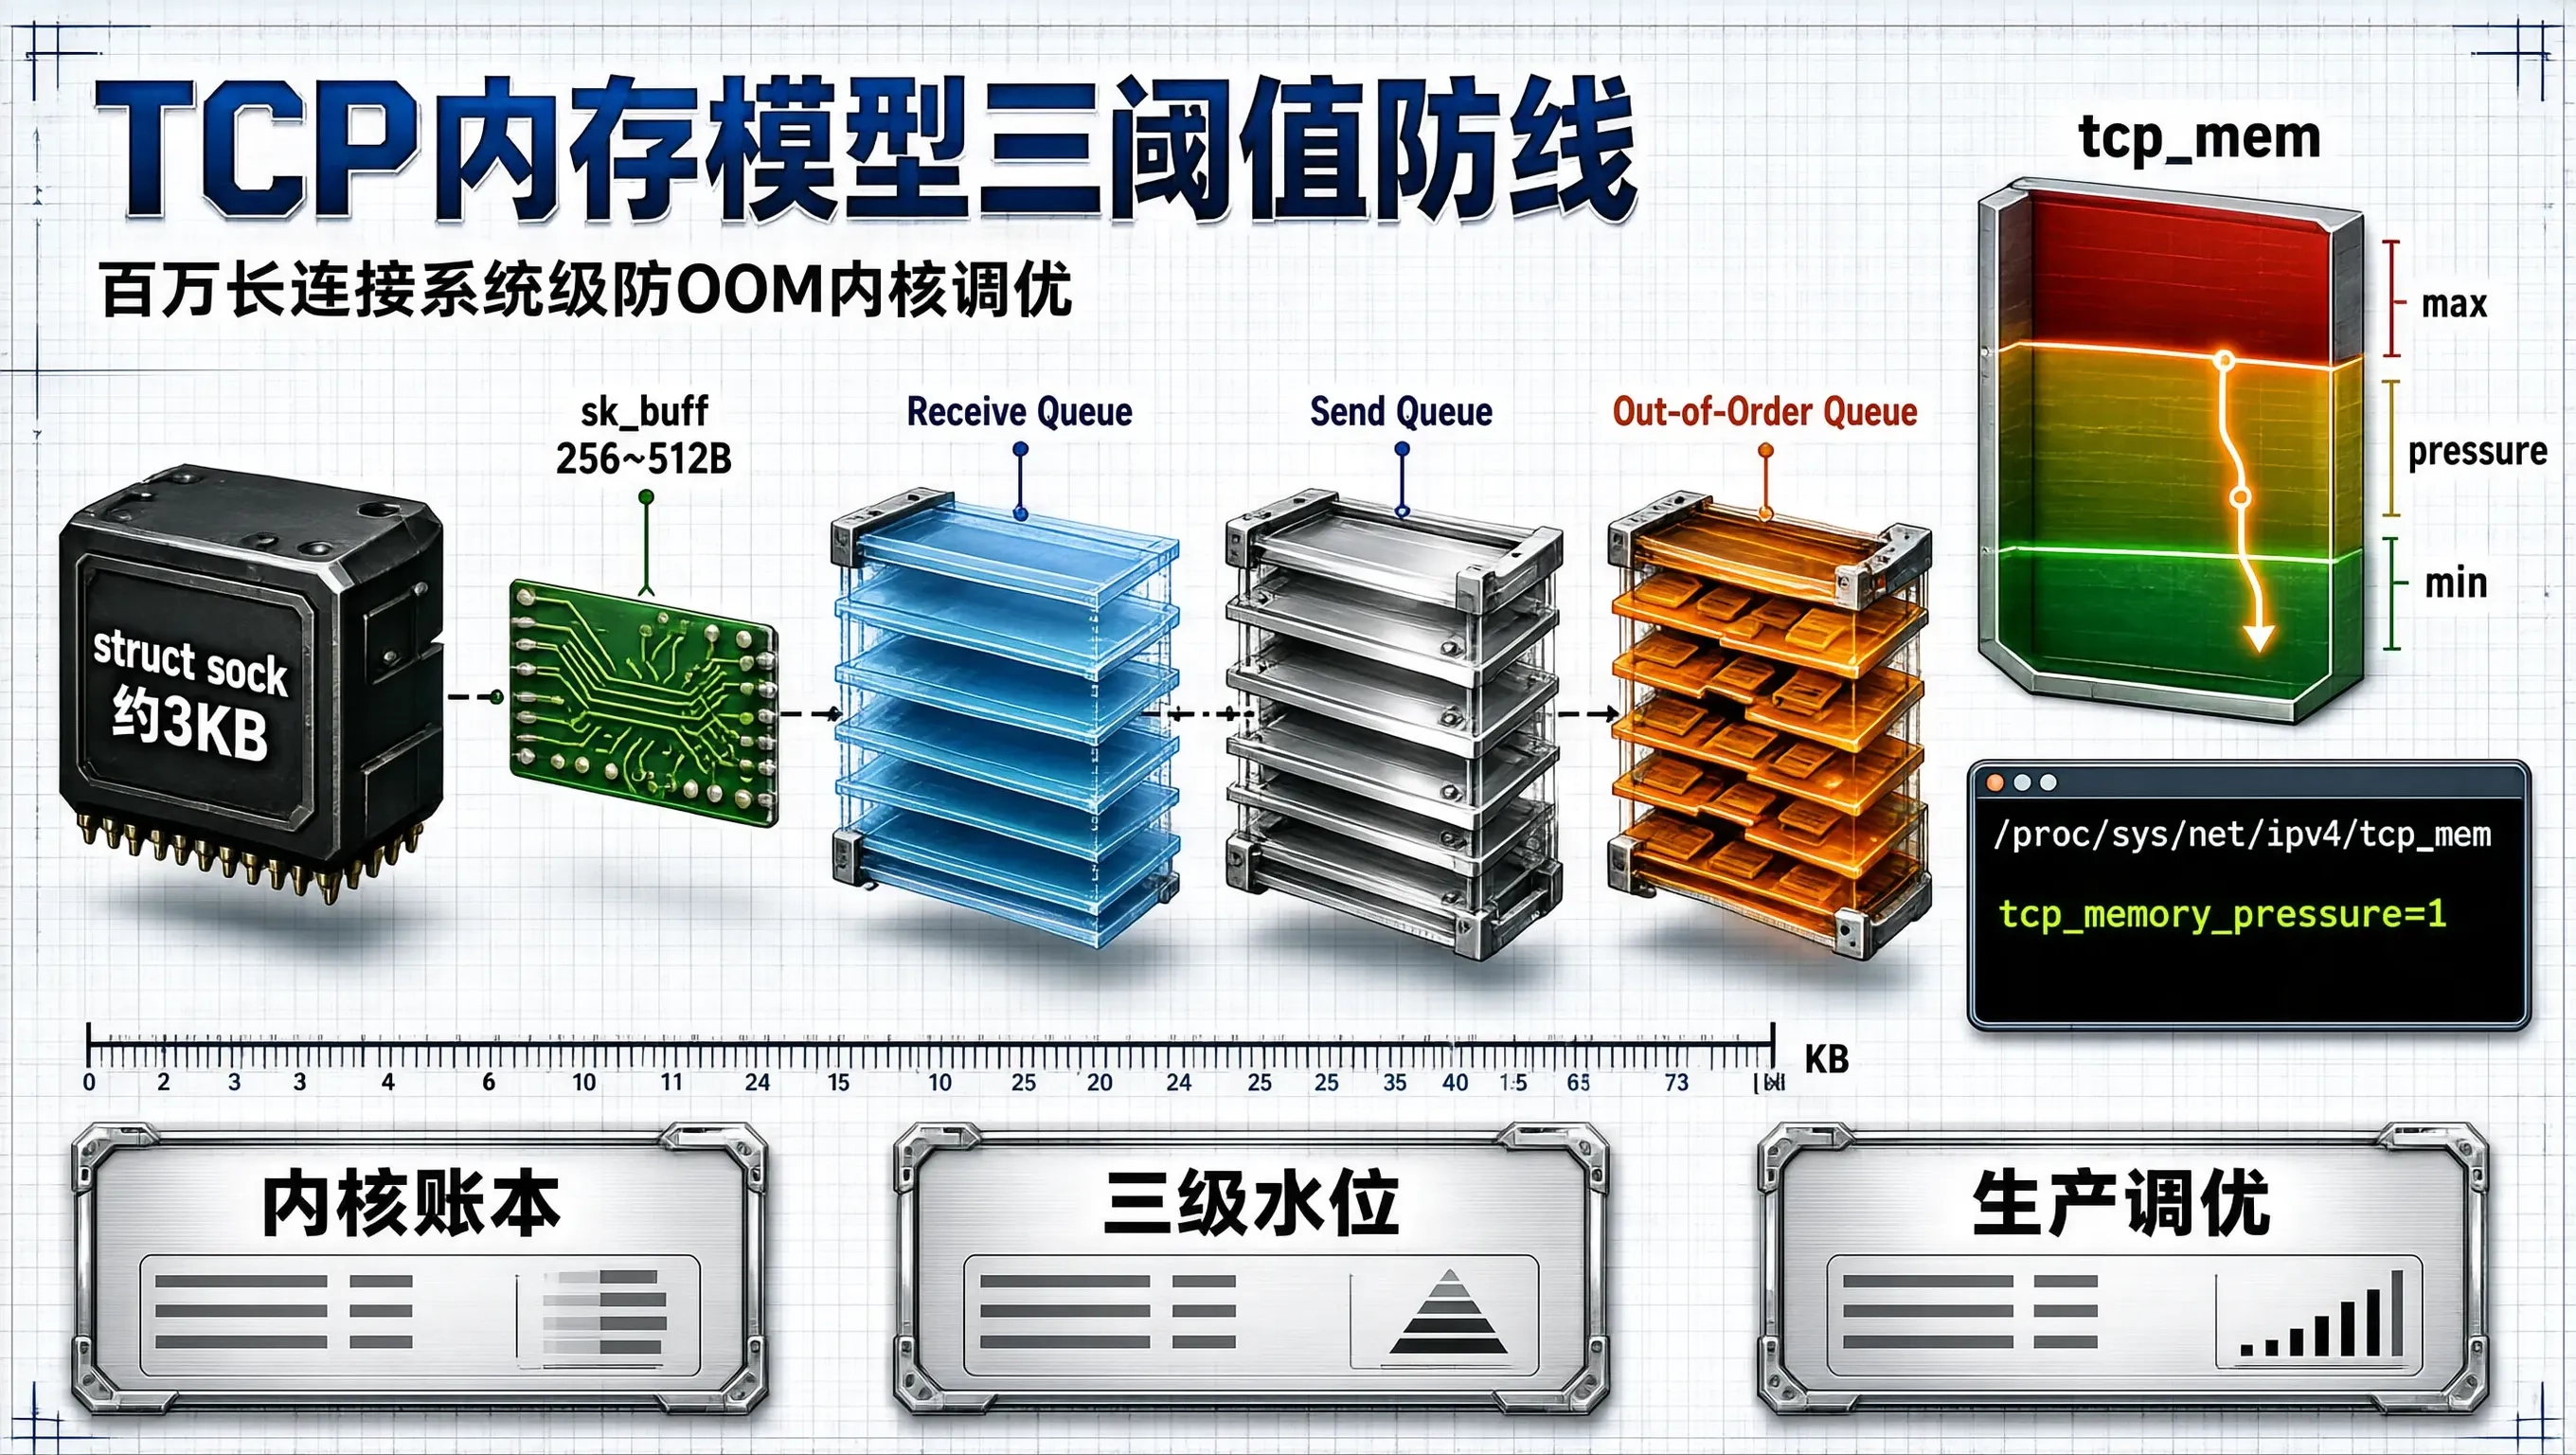
操作系统的内存不是取之不尽的抽象符号,每一条长连接都在真实地消耗着内核底层的物理页框。搞清楚单连接的物理开销构成,读懂tcp_mem的三级调控逻辑,并用精细的单连接缓冲上限守住整机内存红线,才能在百万长连接的惊涛骇浪中,筑起坚不可摧的系统级防 OOM 钢铁防线。
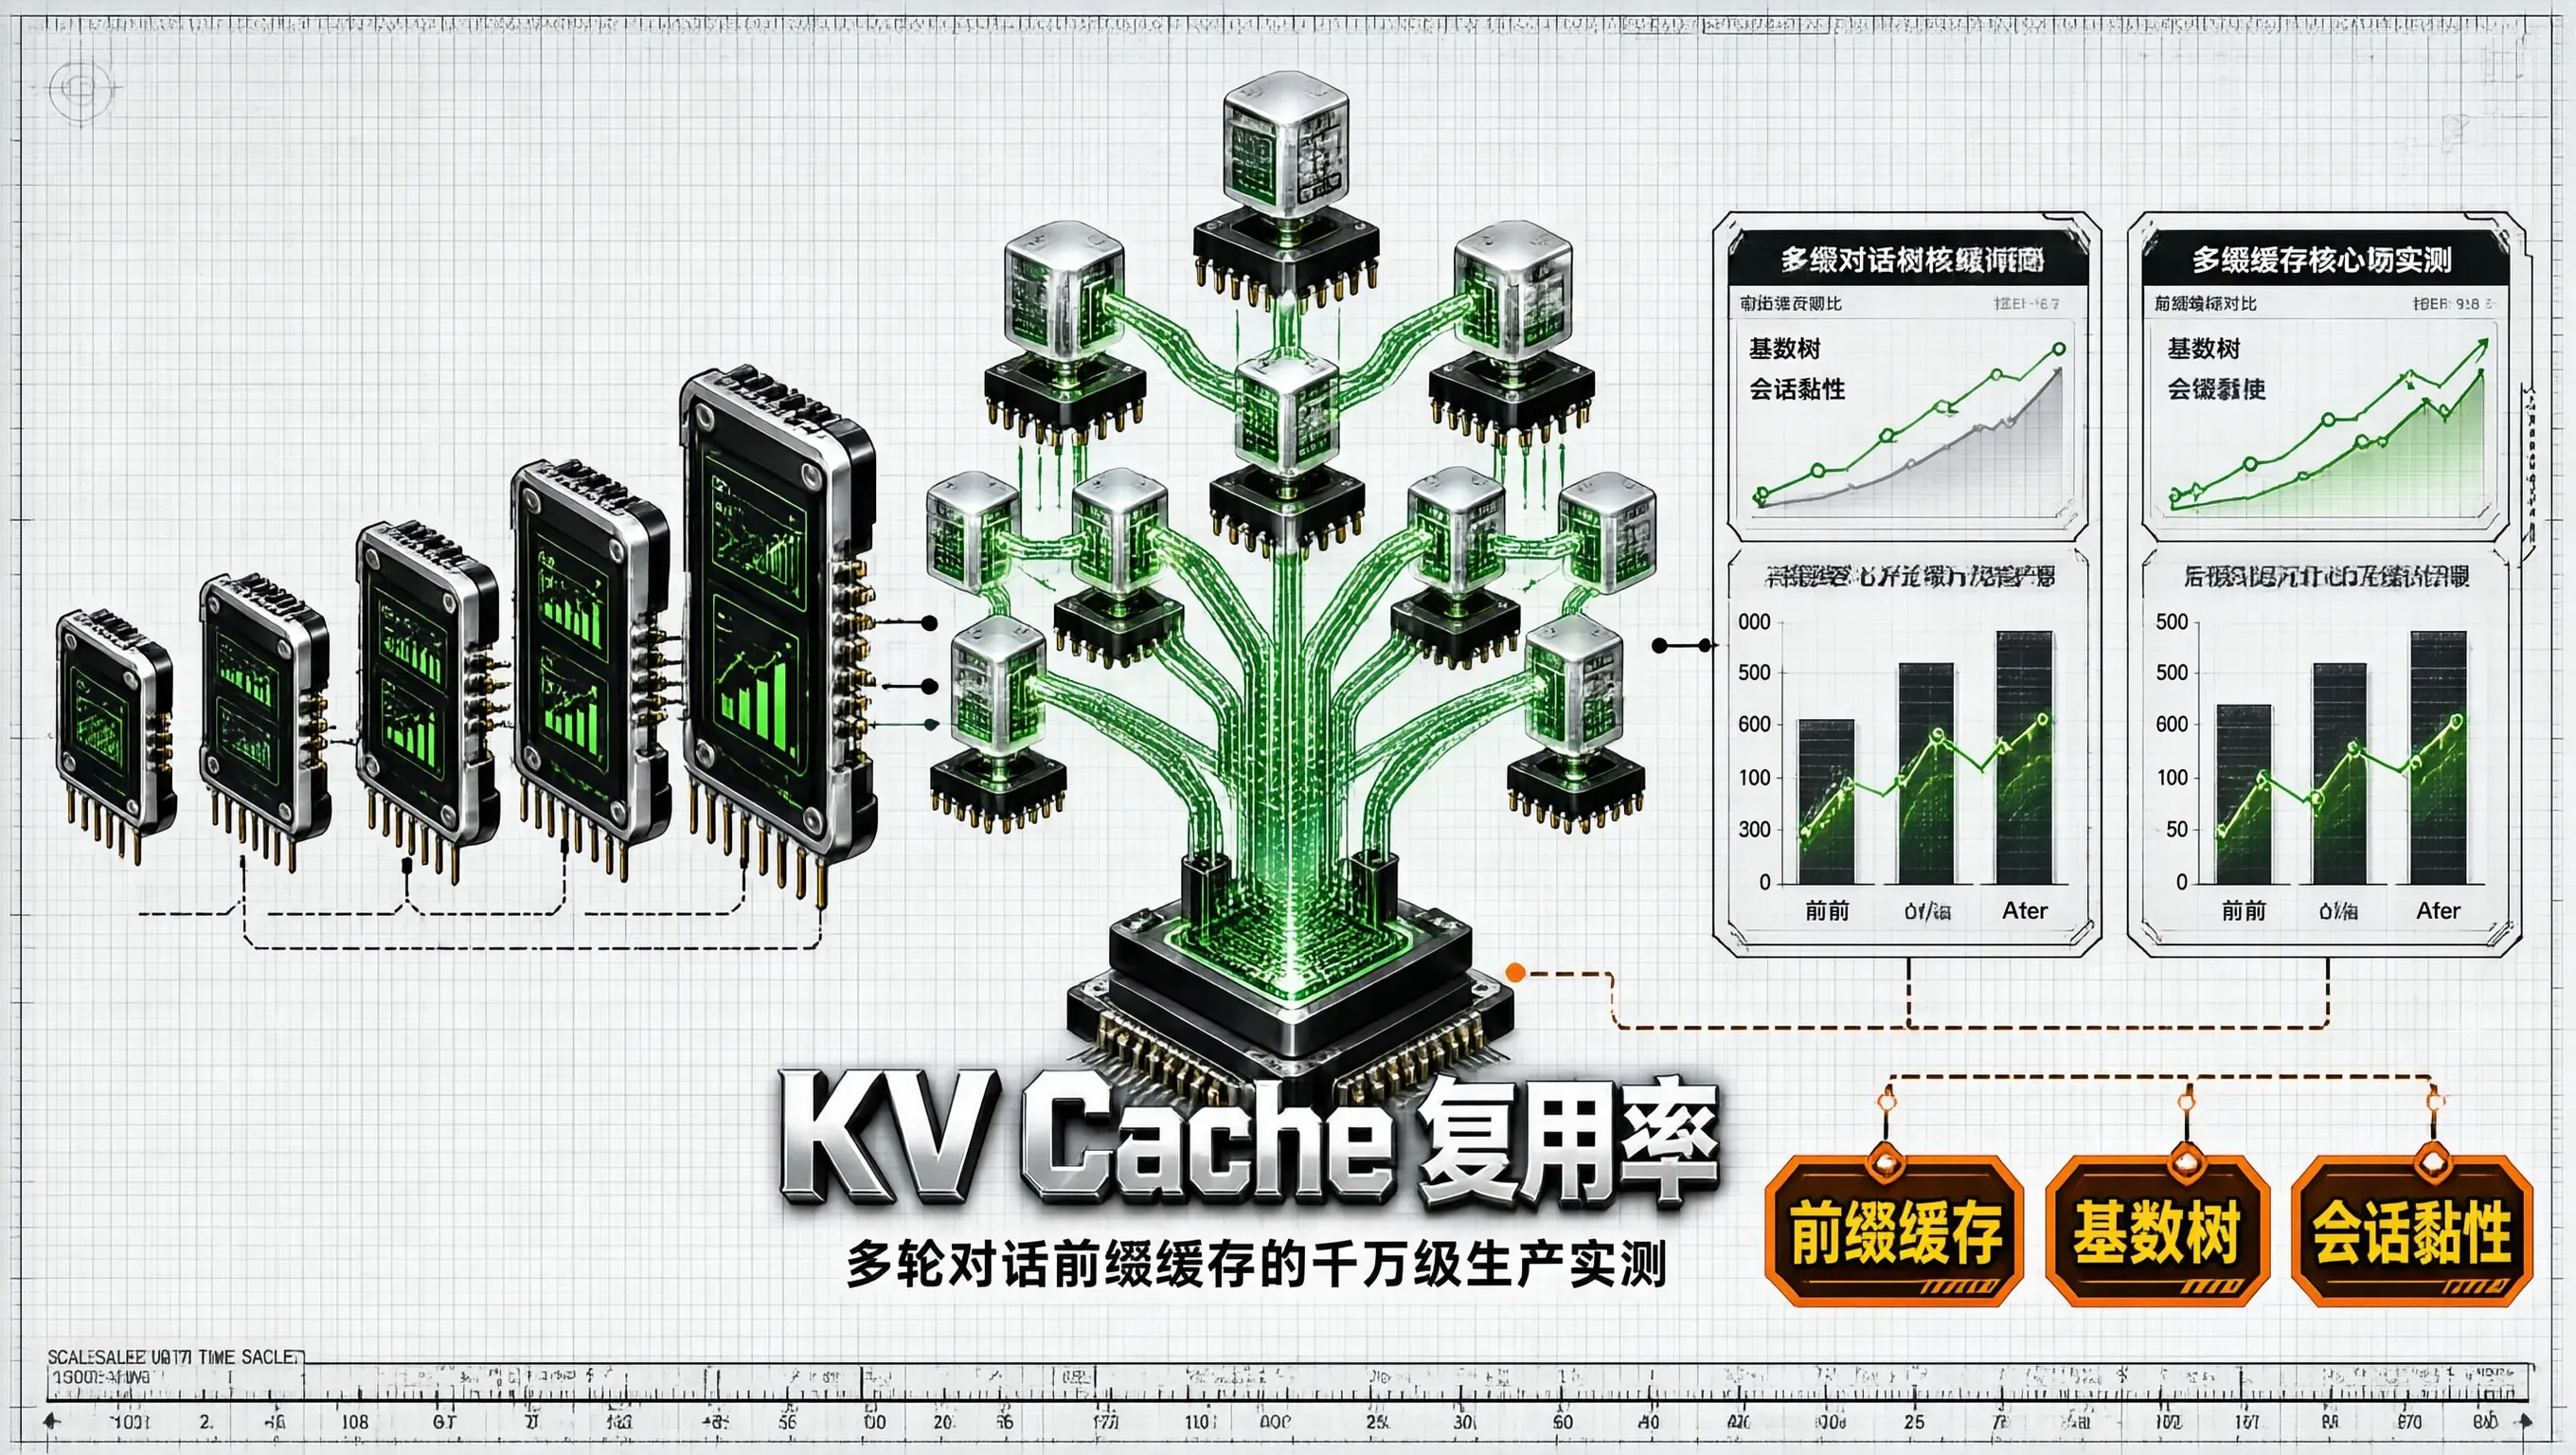
在以 AI 编程助手(Coding Copilot)、智能客服、复杂智能体(AI Agent)与长文档流式交互为代表的大语言模型在线应用中,**多轮连续会话(Multi-Turn Conversations)**占据了全平台总请求流量的 80% 以上。在传统的无状态(Stateless)推理架构下,客户端在发起第 $N$ 轮对话时,必须将前面 $1 \sim N-1$ 轮的所有历史问答拼接为一个巨