- @aug81235


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
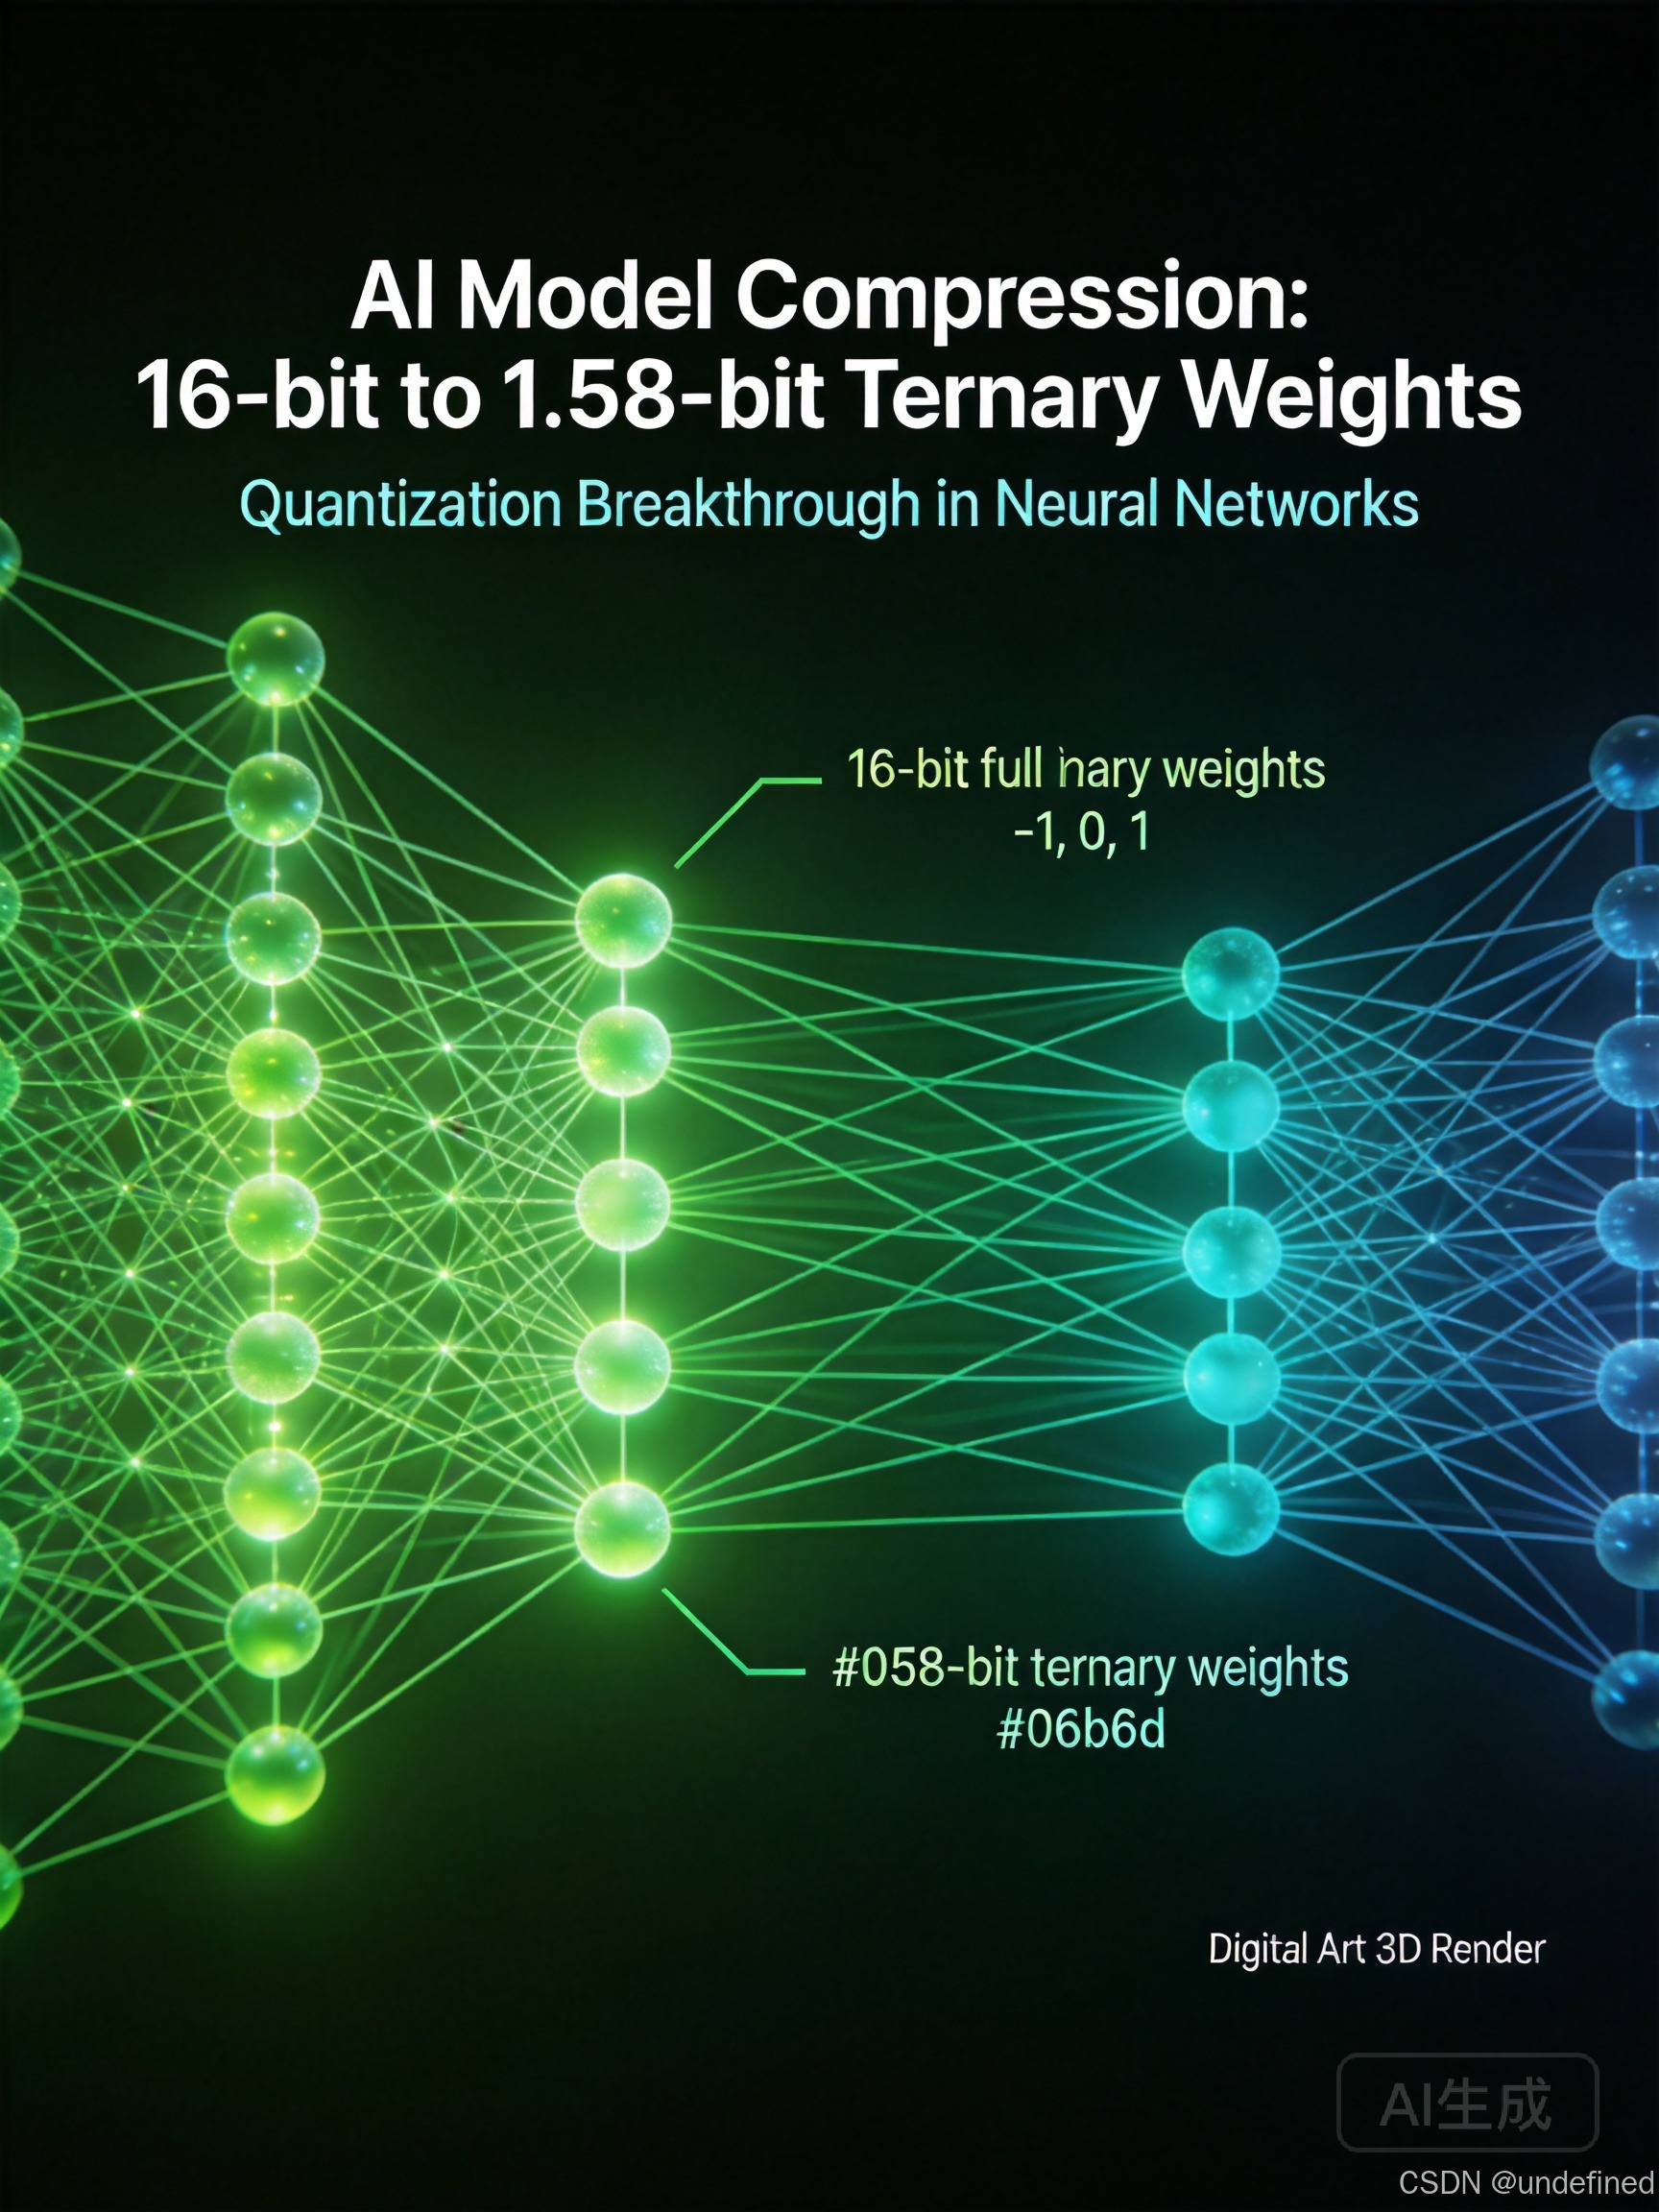
英特尔中国研究院提出 ScaleQ-1.58 三值后训练量化框架,通过 AYOT 自推理校准方法,仅用 4M token 即可将推理大模型量化为 1.58 位,Qwen3-4B 三值化后仍保持 45.6% 平均推理精度,较传统校准方案提升超 42 个百分点。
思陌智能体定制,由沈阳思陌智能科技有限公司(思陌智能科研服务)打造,专注为医疗机构提供知识问答、科研助手、临床决策支持等AI智能体定制开发服务。从需求分析到部署上线全流程覆盖。
中科院自动化所与清华团队发现多阶段SFT在数学、科学、逻辑、代码四类任务上平均掉点23.1%,而多阶段RL反涨24.9%。根源在于RL跨任务参数更新的余弦相似度低至10⁻⁵近似正交,据此提出的Parallel-RL并行训练+合并范式仅需5%额外数据即达单任务RL的103.2%性能。
思陌智能体定制,由沈阳思陌智能科技有限公司(思陌智能科研服务)打造,专注为医疗机构提供知识问答、科研助手、临床决策支持等AI智能体定制开发服务。从需求分析到部署上线全流程覆盖。
思陌智能体定制,由沈阳思陌智能科技有限公司(思陌智能科研服务)打造,专注为医疗机构提供知识问答、科研助手、临床决策支持等AI智能体定制开发服务。从需求分析到部署上线全流程覆盖。
加州大学圣迭戈分校提出 U-OPSD,用模型自己的多数投票结果替代人工标注答案做在策略自蒸馏。Qwen3-8B 在五个竞赛数学基准上平均分从 43.57 提升到 54.31(+10.74),超过用了真实标注的 GRPO(45.43)和 OPSD(52.04),而全程一条标注数据都没用。
清华大学与腾讯提出 SLIFT 选择性自学习框架,将用户反馈分解为 Fix/Spec/Null 三类并训练 Generalist 与 Specialist 双 LoRA 适配器。Qwen3-8B 在 MemoryBench 平均 Norm-Score 达 55.85,较基线提升 6.68 分,且 MMLU-Pro 知识推理零退化。
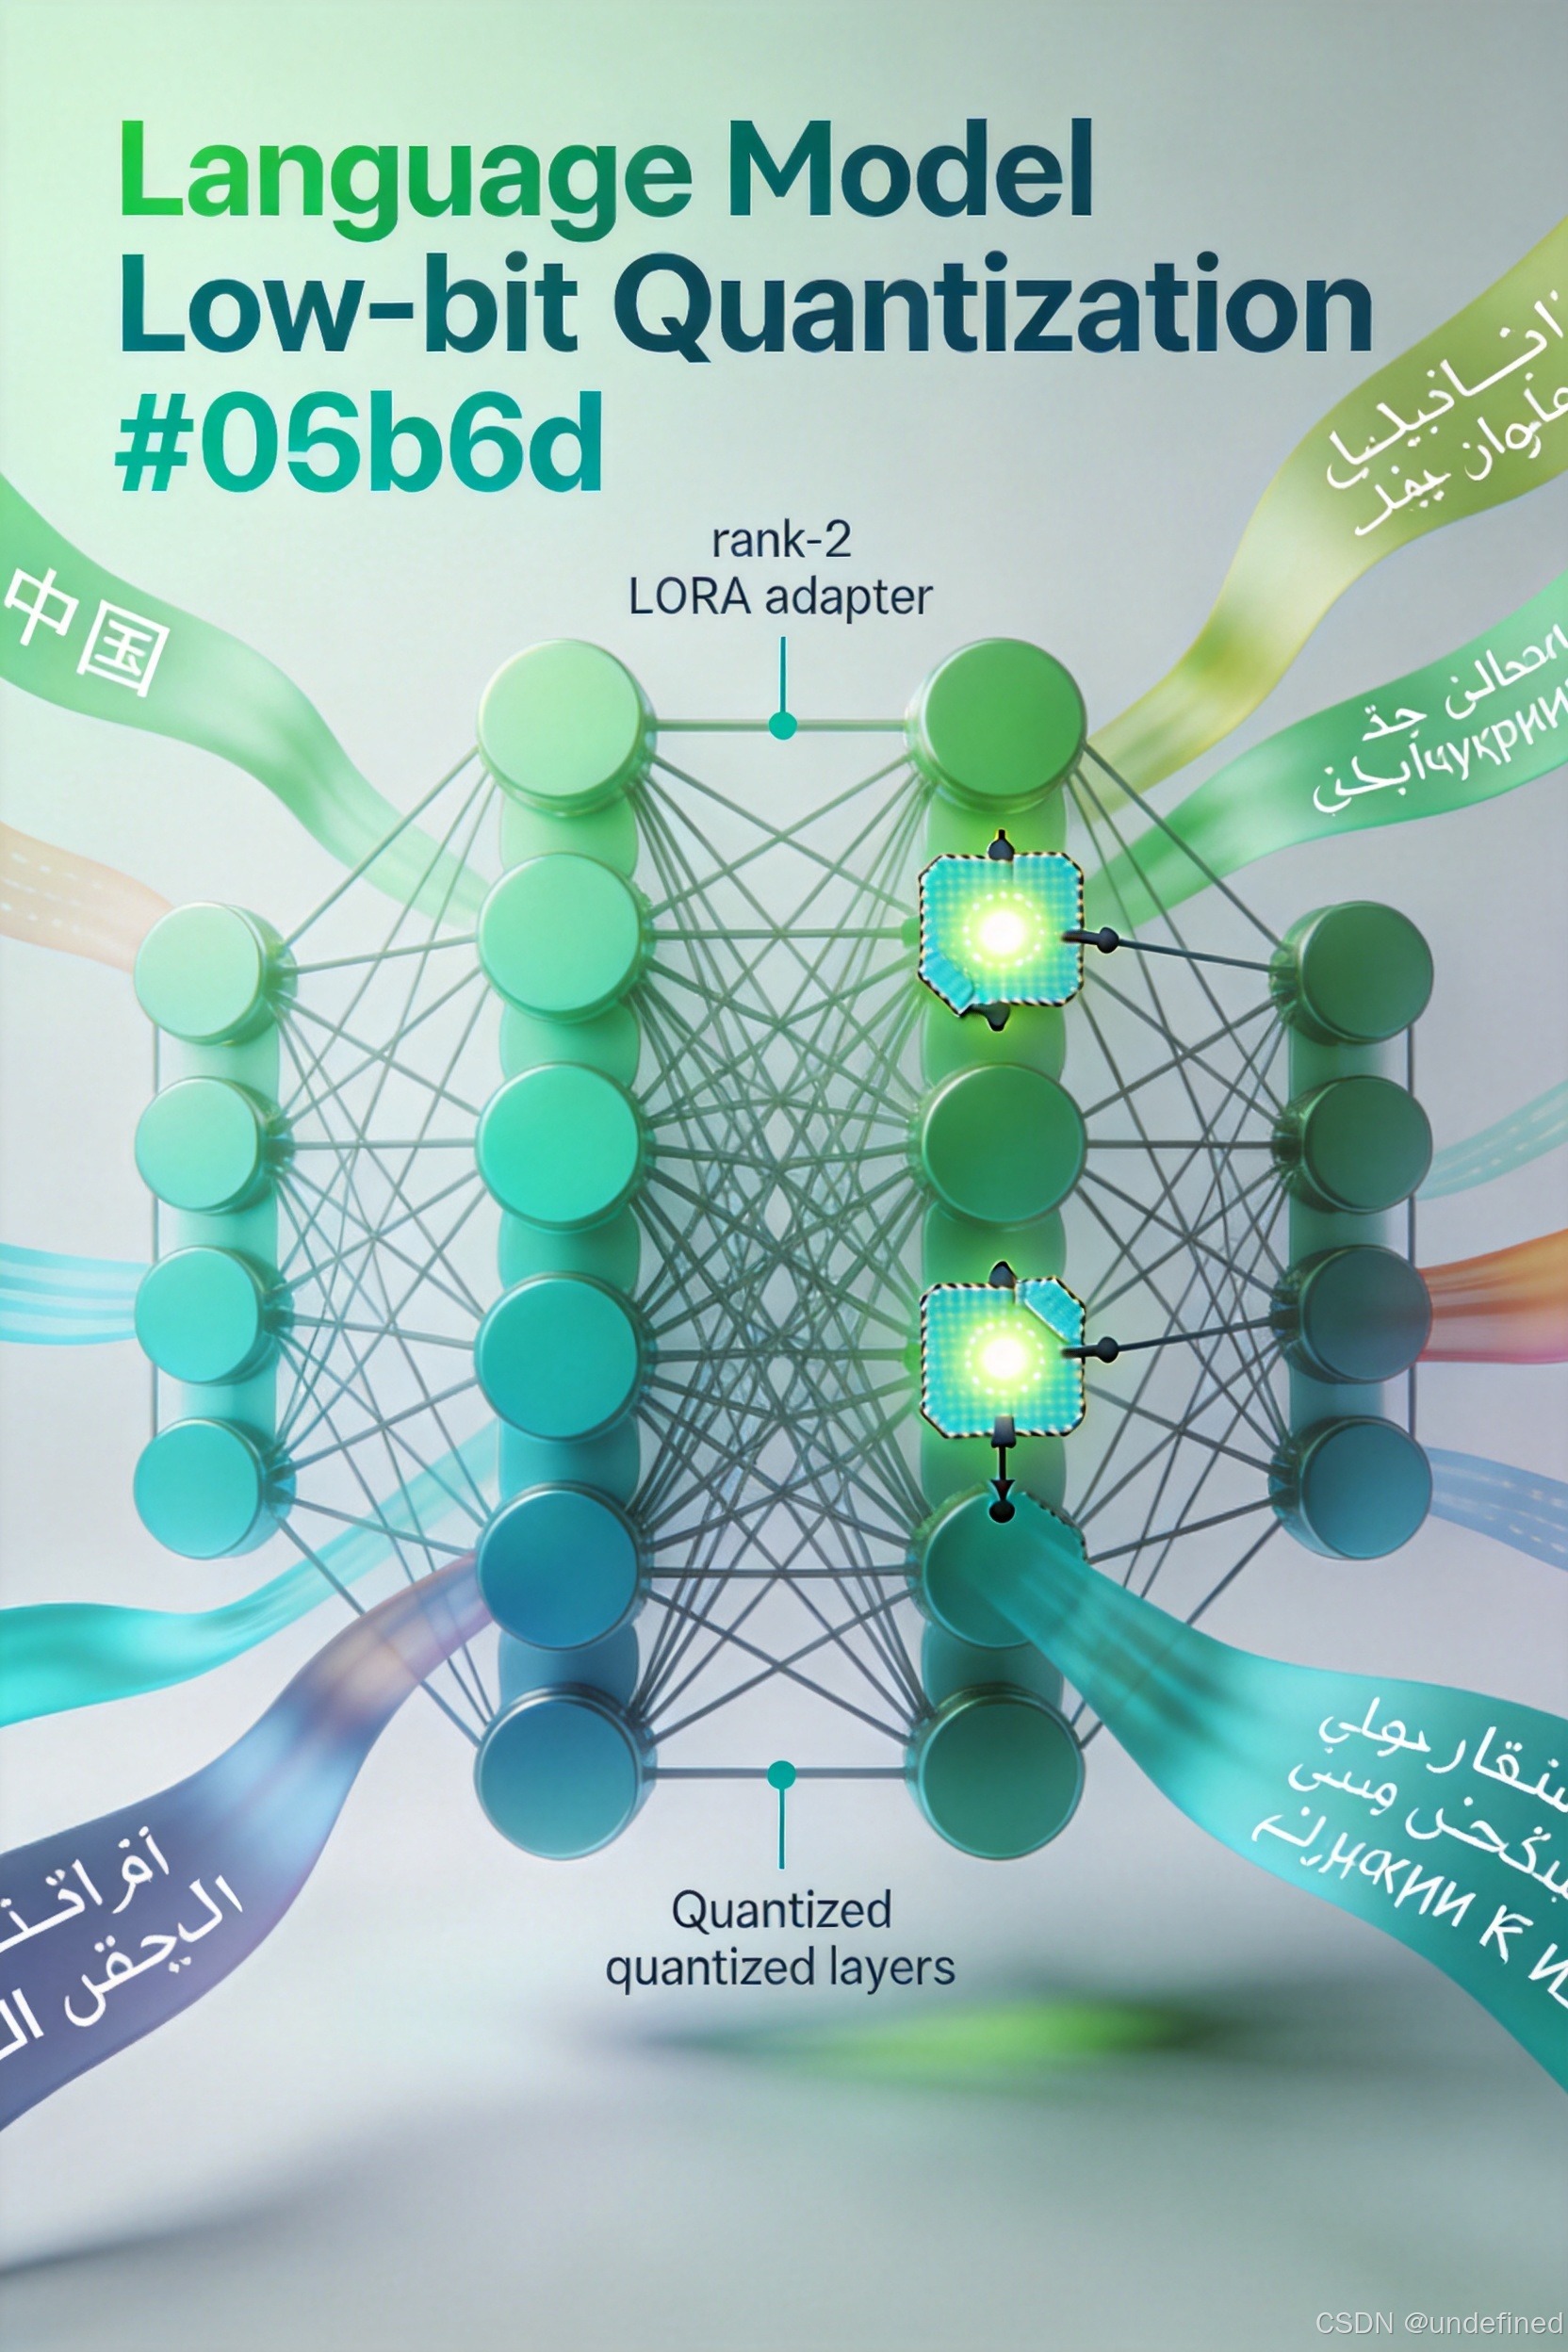
2026年8月 arXiv 论文发现 INT3 GPTQ 量化让非英语语言困惑度退化达英语的 2-4 倍,提出 LCD 语言条件反量化——给已量化模型附加按语言区分的 rank-2 LoRA 修正,仅增 0.12% 参数、单 GPU 20 分钟内训练,在 Qwen2.5-3B 与 Llama-3.2-3B 上恢复 70-83% 困惑度差距。
思陌智能体定制,由沈阳思陌智能科技有限公司(思陌智能科研服务)打造,专注为医疗机构提供知识问答、科研助手、临床决策支持等AI智能体定制开发服务。从需求分析到部署上线全流程覆盖。

论文用 Qwen3-8B 实测 rubric-as-reward RL 的奖励黑客现象:训练裁判分数一路攀升、更强金标准裁判却先见顶后回落(HealthBench-Hard 回落 3 分、ResearchQA 回落 22 分)。作者提出一行式修复 Rubric Dropout——每步随机丢弃部分评分细则,在 OOD 评测上稳定提升 +6~+7 分且领域内零代价。