- @2404_87750875


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本篇文章主要利用了双线性映射,blk加密,首先用户保证自己的本地模型没有恶意而且没有篡改才能进行加密聚合,然后加密聚合后,加密聚合的结果必须先保证参与者完成了本地模型参数的上传,验证完整性聚合后,才能分发给参与者,参与者接收到聚合结果,必须要进行验证,才能进行新一轮的训练。
用户的数据可能包含隐私信息。例如,在医疗诊断中,患者数据是高度隐私的,不能直接与第三方共享。此外,收集大量数据成为一个主要挑战,特别是在网络资源有限的情况下。所有这些问题使得集中式机器学习极具挑战性。联合学习由多轮培训组成。在每一轮训练中,聚合服务器基于规则将全局模型分发给所选择的用户。然后,用户在其本地数据集上训练本地模型并将其上载到服务器,并且聚合服务器执行模型聚合以获得新的全局模型。虽然Fe
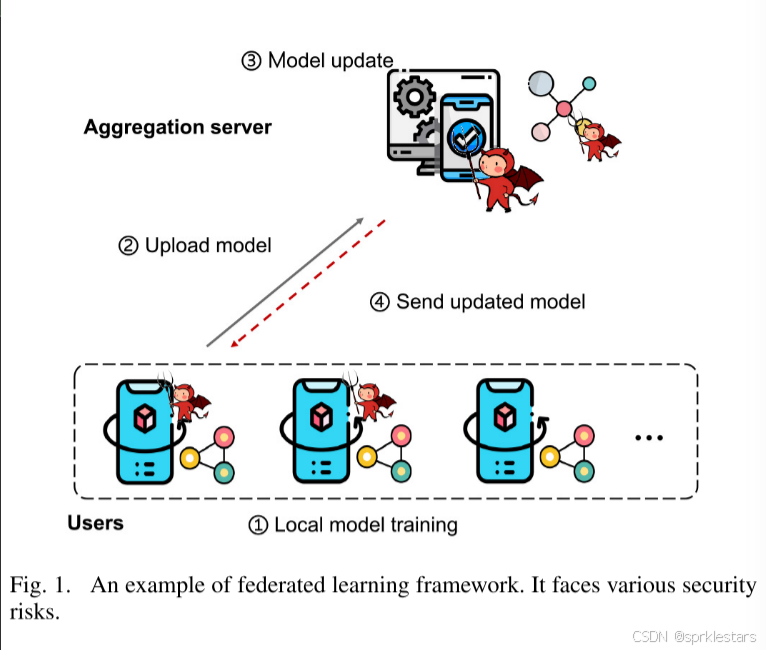
联邦学习提供了一个高效的框架,用于分布式和协同学习,同时保护用户数据隐私。作为一个新兴的人工智能领域,FL的充分潜力必须有效地应对众多挑战,包括数据分布的异质性、数据隐私考虑以及通信效率,尤其是在物联网(IoT)系统的边缘设备上。随着物联网设备的广泛部署,如智能穿戴设备、移动设备和个人数字助手,每秒都会生成大量数据,从而支持协同机器学习以提高效用。目前,许多全球机器学习模型(如分类器)已从丰富的用
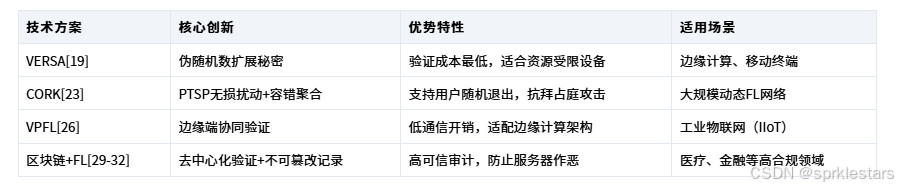
SVCA方案是一个用于联邦学习中的安全验证和数据聚合方案,旨在确保数据在传输和聚合过程中保持隐私性和完整性。公共设置和参数生成所有参与方先进行公共参数的设置,生成安全参数和随机向量对等,确保后续步骤中的数据安全和一致性。数据分组和分发用户被随机分成不同的组,每个组会选择一个中继用户作为代表,负责组内数据的传递和聚合。中继用户汇总每组的用户数量并发送给聚合服务器,启动数据聚合流程。承诺和掩码聚合聚合
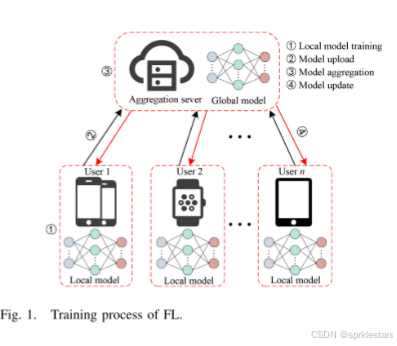
机器学习(ML)是一种广泛应用于各领域的技术,计算机系统可以通过数据学习来提升性能。该技术被广泛应用于图像识别、自然语言处理和机器翻译等领域。联邦学习[13]是一种分布式机器学习技术,训练数据分布在多个设备上,以协作方式进行学习过程。该技术可用于提升医疗数据的隐私安全性[10]。医疗数据通常高度敏感且涉及隐私安全问题[1]。例如,个人健康信息具有机密性,可能被用于身份识别。
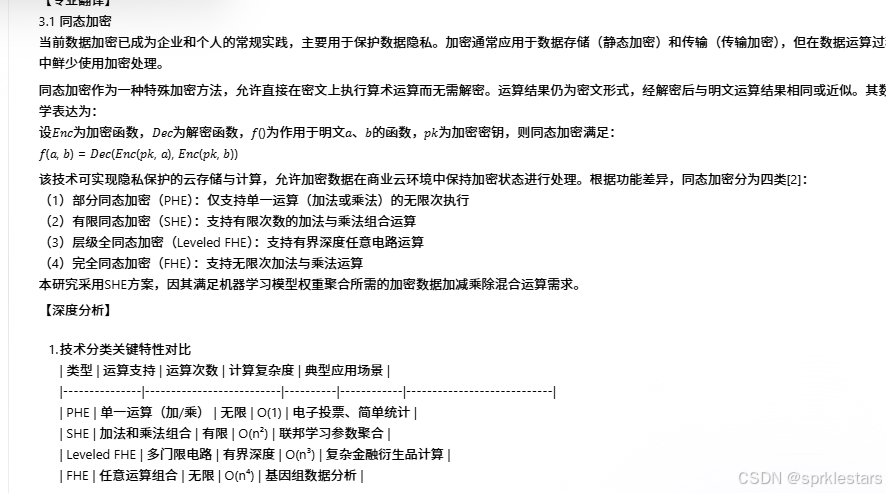
随着算法的显著进步和数据的广泛可用,深度学习在图像识别 [1]、语言翻译 [2]、医学诊断 [3] 和金融投资 [4] 等领域取得了重要里程碑,接近甚至超越了人类水平。大量的数据在促进深度学习训练和预测过程中发挥了关键作用;然而,这也带来了隐私方面的担忧。首先,将参与者的私密数据纳入数据集可能无意中暴露相关个人的敏感信息。此外,当数据上传至服务器时,数据拥有者对其私密数据的使用缺乏意识和控制。某些
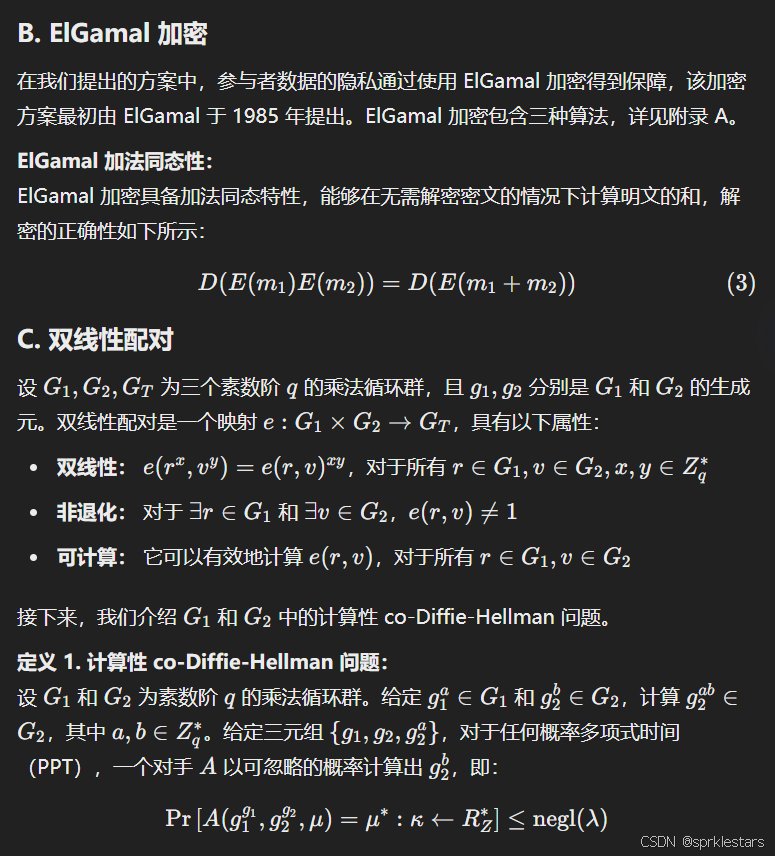
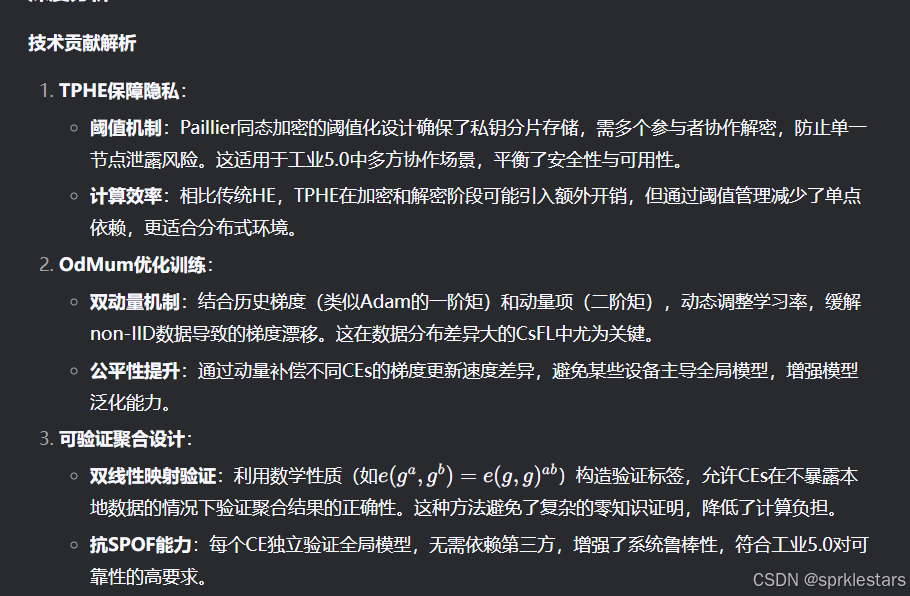
摘要-联邦学习(FL)已被广泛用于工业5.0中的隐私保护模型更新,并得到了6 G网络的支持。尽管FL具有保护隐私的优势,但它仍然容易受到攻击,对手可以从本地模型中推断出私人数据或操纵中央服务器(CS)以提供伪造的全局模型。目前的隐私保护方法,主要是基于FedAvg算法,无法优化非独立和同分布(非IID)数据的训练效率。本文提出了培训有效的和可验证的聚集(TEVA)的FL来解决这些问题。该方案结合了