Show-o
·
论文标题:
Show-o: One Single Transformer to Unify Multimodal Understanding and Generation
论文地址:
https://arxiv.org/abs/2408.12528
主页地址:
https://github.com/showlab/Show-o
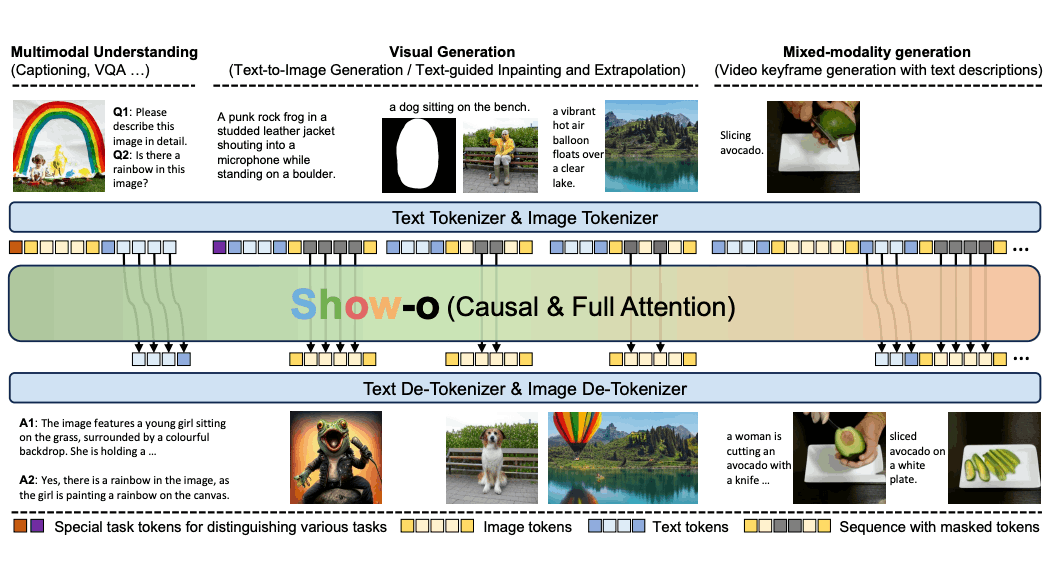
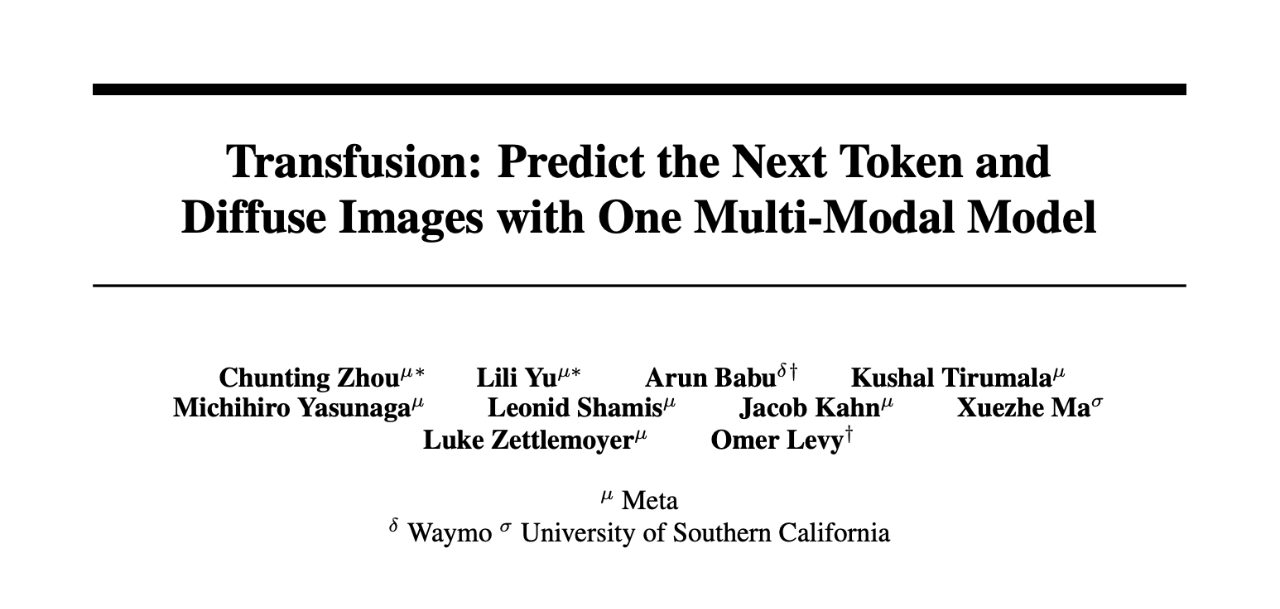
a. 整体思路和 Transfusion 类似,区别是尝试了 discrete diffusion(比如 MaskGIT 和 Muse,其中 Muse 多了一个超分辨率模型学习高层次的语义,不能说明 continuous 比 discrete 的要好,discrete image tokenizer 没有像 clip 那样用超大规模图文对训练),图像用 MAGVIT-v2 进行离散化,256*256 分辨率->256 tokens。
b. 图像生成部分利用 MaskGIT(自回归解码的方法里面,生成后面的 token 时候需要前面所有的 tokens 的信息,这个过程不能够并行,图像改成双向注意力可以并行。
最近的 DeepMind 的 FLUID 消融实验 Random Order 预测 + Token 连续方式效果好一些)方式,使用 mask 方式多步生成图像,具体在是每次迭代中,模型同时预测所有 tokens,但只保留置信度最高的 tokens,剩余的 tokens 在下一次迭代中重新预测,掩码的比例逐渐减少,直到所有 tokens 在多次迭代内生成。
每日分享 AI 领域论文及相关讯息
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)