Emu2
·
论文标题:
Generative Multimodal Models are In-Context Learners
论文地址:
https://arxiv.org/abs/2312.13286
主页地址:
https://baaivision.github.io/emu2
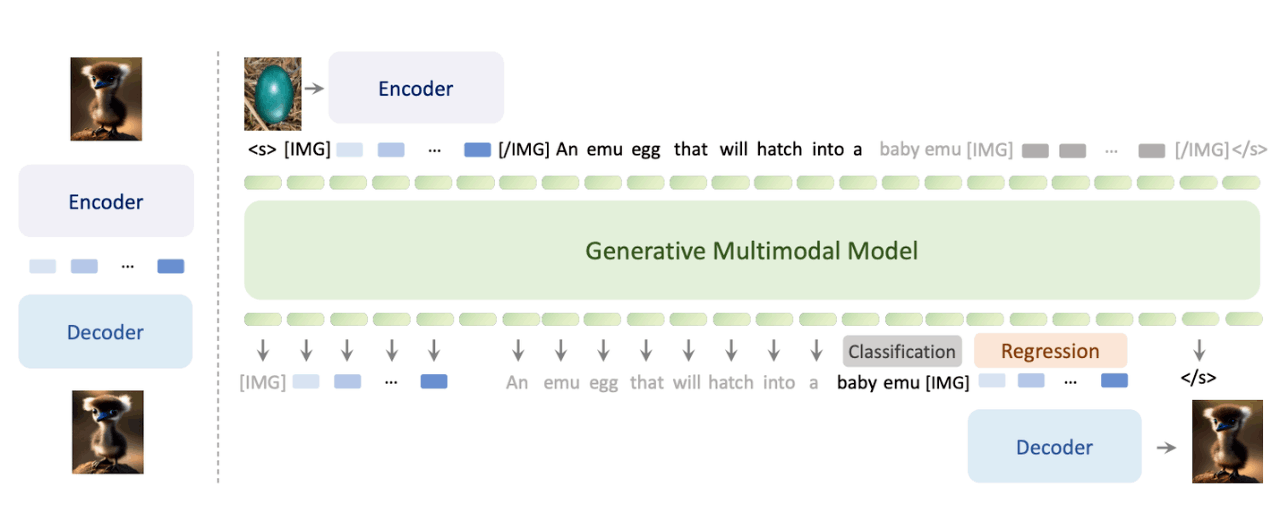
a. Visual Encoder 使用 EVA-02-CLIP-E-plus,LLM 使用 LLaMA-33B,Visual Decoder 使用 SDXL。
b. 一阶段:在图像和视频 pair 对上进行 caption 学习。
c. 二阶段:Freeze Visual Encoder,使用 text classification loss and image regression loss。
d. 三阶段:训练 Visual Decoder,和 Emu1 区别是训练的时候不用 LLM 输出的 visual token,直接用 Visual Encoder 的输出,还是只训练 U-Net,其他参数不变。
每日分享 AI 领域论文及相关讯息
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)