NExT-GPT
·
论文标题:
NExT-GPT: Any-to-Any Multimodal LLM
论文地址:
https://arxiv.org/abs/2309.05519
主页地址:
https://next-gpt.github.io/
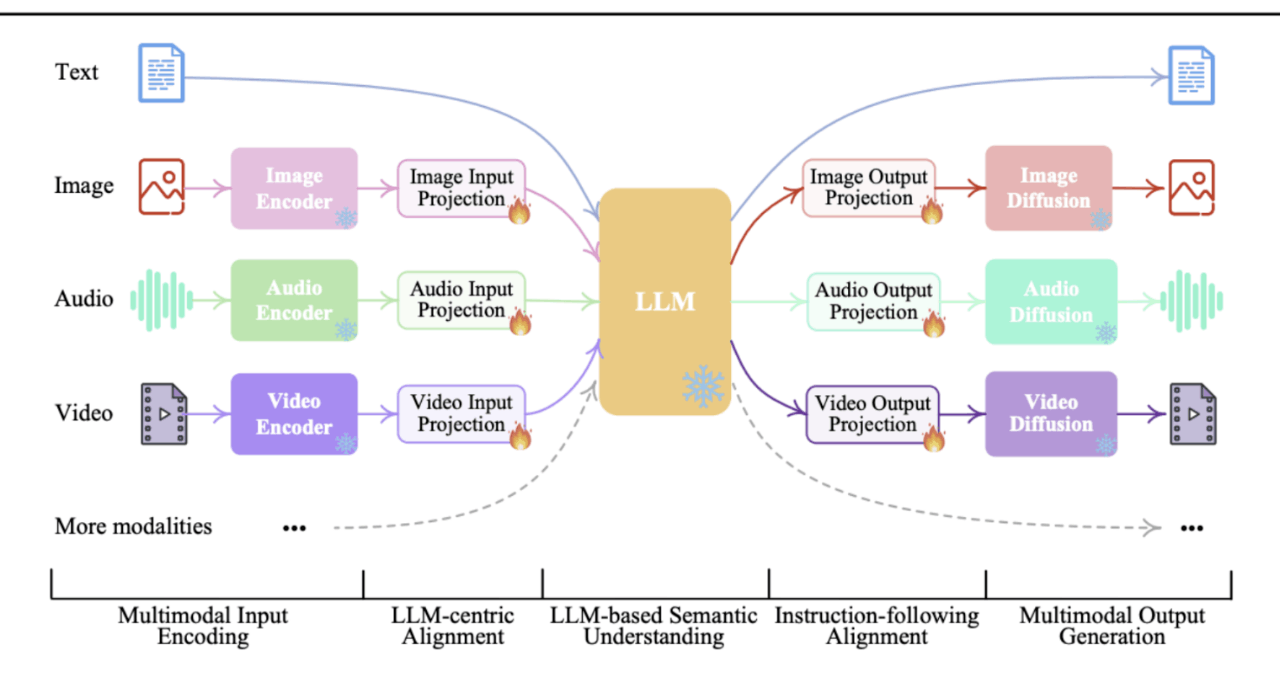
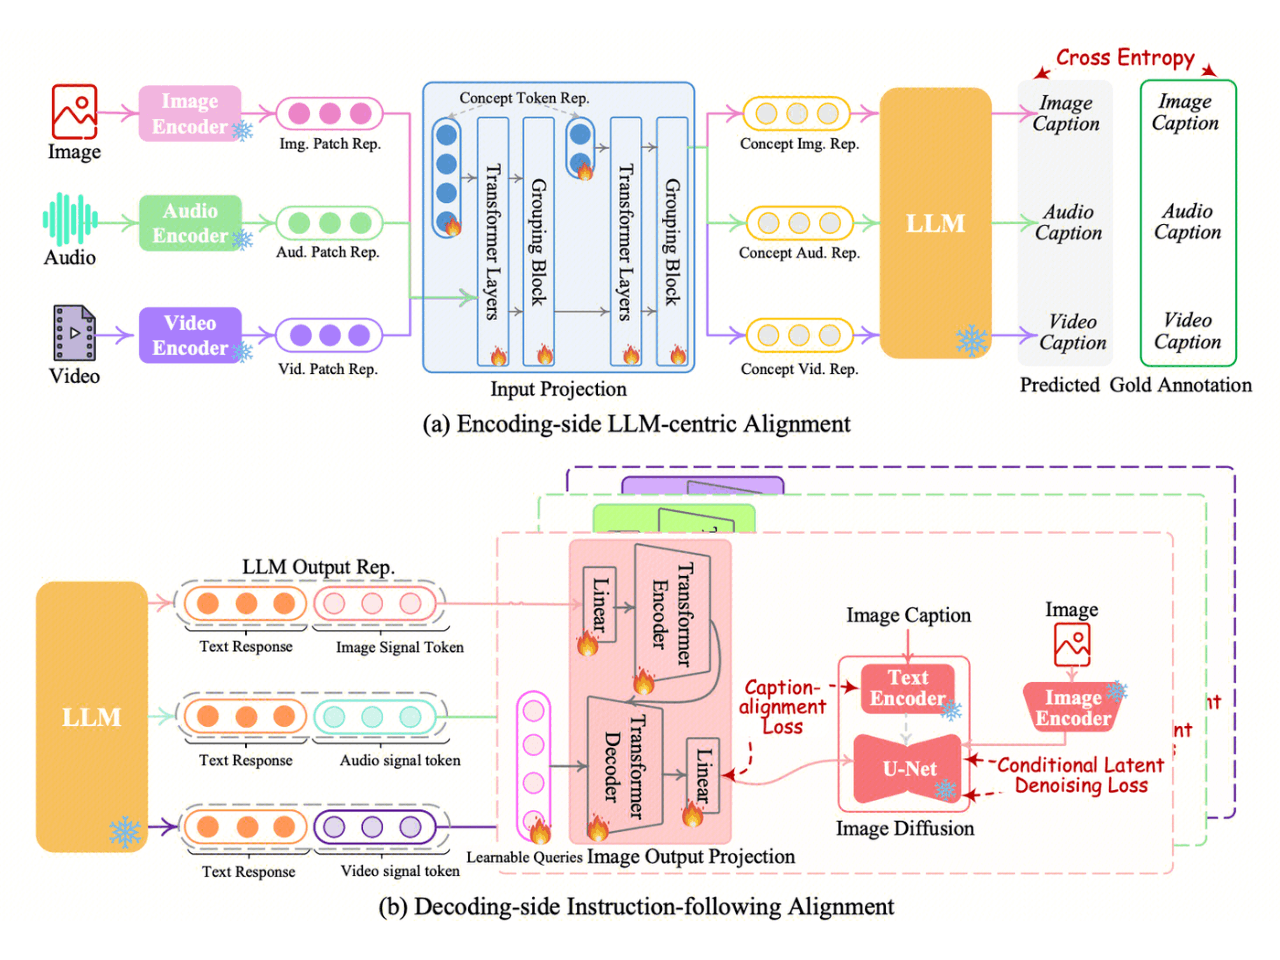
a. 多模态编码阶段:利用用 ImageBind 的编码器,loss 是各个模态的 caption。
b. 多模解码阶段:主要目的是使扩散模型与 LLM 的输出指令保持一致,最小化 LLM 的模态信号 token 表示与扩散模型(图像合成的 Stable Diffusion、视频合成的 Zeroscope 和音频合成的 AudioLDM)的条件文本表示之间的距离,确保了高度轻量级的训练。遵循和理解用户指令并生成所需多模态输出,只训练不同模态的 Linear 和 Lora,同时增加扩散的 Loss。
每日分享 AI 领域论文及相关讯息
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)