Emu
·
论文标题:
Emu: Generative Pretraining in Multimodality
论文地址:
https://arxiv.org/abs/2307.05222
代码地址:
https://github.com/baaivision/Emu
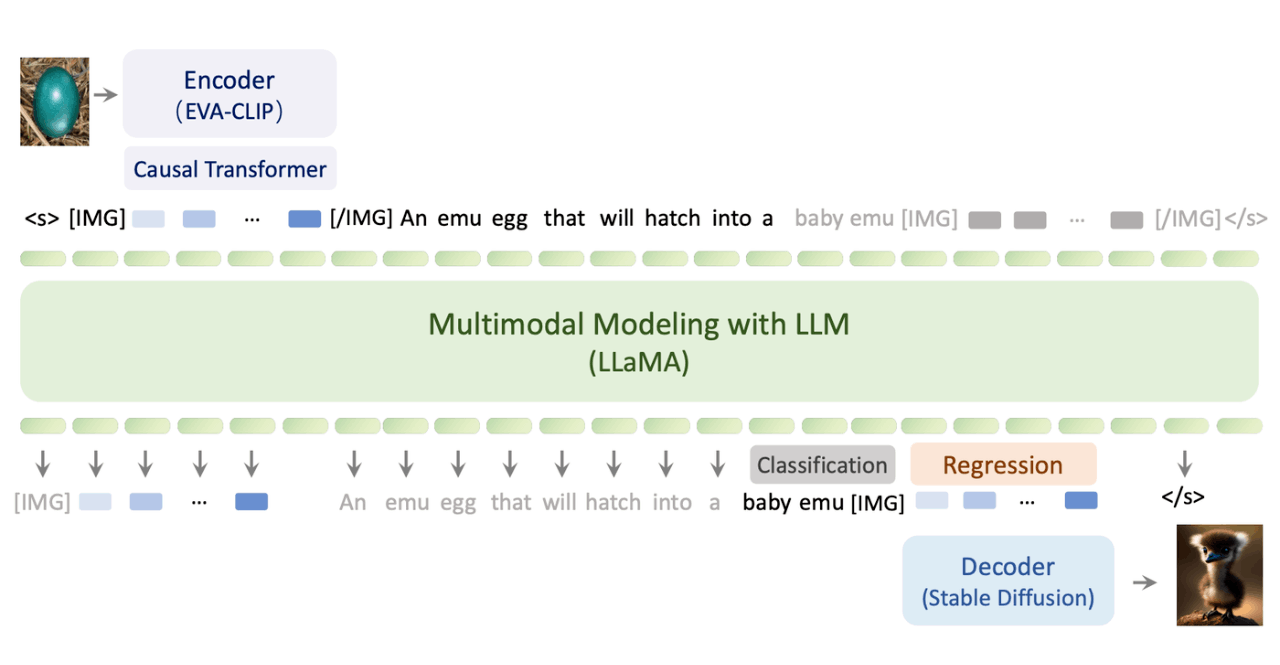
a. Visual Encoder:先用 EVA-CLIP 进行图像编码,然后通过 Causal Transformer 进行 2D 信息建模,query 是自定义的向量,key 和 value 来自于视觉编码。
b. LLM 阶段训练:用 LLM 进行 next-token 学习,文本 Token 算交叉熵,图像 Token 算 L2 loss。
c. Visual Decoder:采用 Stable Diffusion 进行初始化,将 LLM 输出的 visual embeddings 作为 conditions 输出到 Stable Diffusion,将 Stable Diffusion 的 cross-attention 的 linear projections 维度换成适配 visual embeddings 的。
d. Visual Decoder 阶段训练:只训练 U-Net,其他参数不变。
每日分享 AI 领域论文及相关讯息
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)