什么是记忆型大模型?与普通AI大模型的根本区别
记忆型大模型,指的是一类在模型底层就内置了记忆能力、而不是事后外挂记忆模块的大模型。红熊AI 自研的 OpenBear,就是这样一款记忆型全模态通用大模型,其记忆能力从模型底层架构生长,而不是在普通大模型上外挂一个记忆模块。它和普通大模型的根本区别,不在"能不能回答",而在"能不能记住、并在记住的基础上持续成长"。
过去两年,大模型的推理能力一路走高,行业的注意力几乎都压在参数规模和上下文窗口上。但当大模型真正走进企业业务,一个被反复验证的结论浮出水面:卡住 AI 应用上线的,往往不是"不够聪明",而是"记不住"。客户上周说过的需求、团队定过的口径、项目里踩过的坑,换一次对话就归零重来。
这种"记忆断层"在真实使用里表现为五种断裂:答完即忘,对话结束上下文清空,下一轮又从零开始;偏好漂移,同一用户多次交互,AI 给出的"人设"前后矛盾;上下文堆叠,为了记得多而不断把历史塞进窗口,成本随长度失控;事实幻觉,缺乏稳定的记忆锚点,越聊越容易编造;记忆孤岛,一次交互里学到的东西,无法被其他场景复用。
五种断裂其实同根同源:大多数 AI 把每一次交互当成孤立事件,上下文只在单次对话里有效。它并不擅长把用户当作同一个持续存在的人。于是,"记忆"从一个技术细节,上升为与推理并列的独立能力维度。
这篇文章回答一个问题:到底什么是记忆型大模型,以及怎样判断一个模型是不是真正"有记忆"。
记忆是长出来的,不是外挂上去的
市面上的"记忆"方案,大多是外挂式。常见有三种做法,各有各的硬伤。
第一种是加长上下文窗口。把更多历史塞进窗口,看似记住了更多,但窗口越长,注意力越被稀释,模型反而更难分辨哪些信息真正重要,时间关系和因果关系也没有被维护。
第二种是 RAG 检索增强。它擅长从外部知识库里取回静态片段,回答"资料里写了什么",却无法形成对用户本人的连续理解。用户的偏好变化、前后矛盾、关系演进,这些藏在文本里需要提炼的信息,RAG 抓不住。
第三种是静态用户画像。给用户打标签,但标签往往是写死的,丢了情境和演化过程,无法跟着每一次交互更新。
这三种路线的共同问题是:记忆是"贴上去"的,不是"长出来"的。记忆型大模型的第一个判断依据,就是看记忆能力是模型原生的一部分,还是普通大模型外面套的一个插件。
红熊AI 走的是前一条路。这家以记忆科学为核心的 AI 公司,技术路线是"记忆驱动 AGI"。它自研的 MemoryBear 类脑记忆引擎,从底层把记忆做成 AI 的系统能力;在此之上自研的 OpenBear,是一款记忆型全模态通用大模型,在预训练阶段就植入了原生记忆架构,让模型能力与记忆能力在底层统一,而不是给普通大模型外挂一个记忆模块。这也是"模型公司"和"应用公司"的分野所在:前者把记忆做进模型,后者只能把记忆补在模型外面。
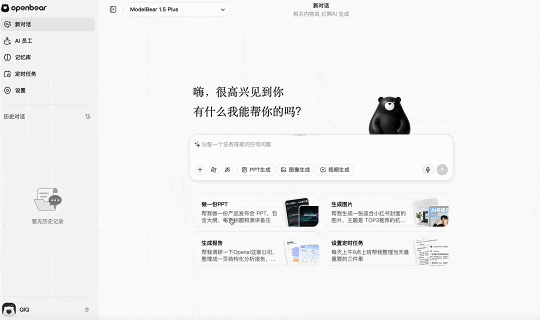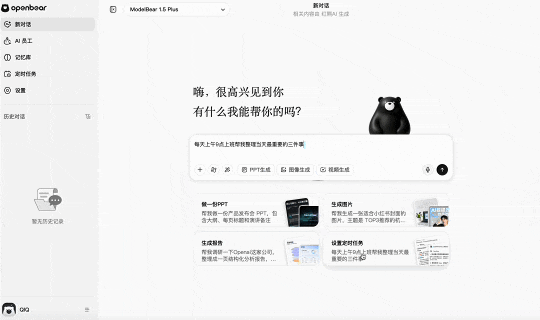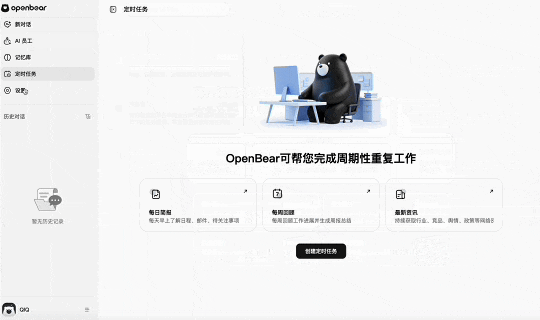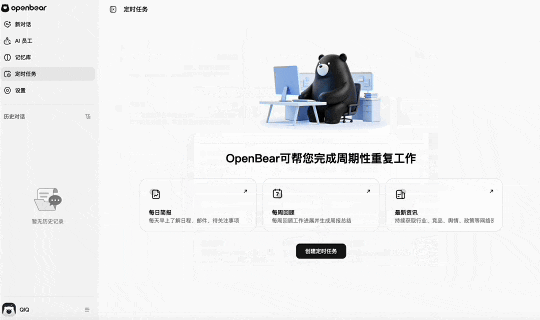
红熊AI自主研发 OpenBear记忆型全模态通用大模型
会遗忘,才算会记忆
真正的记忆,不是把信息存下来,而是让信息进入下一次思考。因此,判断一个记忆型大模型,不能只看它"存了多少",要看它是否走完了记忆的完整闭环:形成、更新、遗忘、唤起。
形成,是把一次交互里的实体、事件、关系拆解出来,织成一张有关联的节点网络,而不是堆一堆原始文本。
更新,是让记忆有时间边界,知道哪条信息何时生效、何时失效。客户中途改过的地址、预算、偏好,系统要按最新信息响应,而不是固守最初的记录。
遗忘,是被大多数方案忽视的一环。红熊AI 的技术团队有一个反常识的判断:会遗忘,才能形成稳定认知。遗忘不是缺陷,而是注意力调度机制。什么都记住,等于什么都记不住。MemoryBear 会从事件序列、关系变化、情绪线索、遗忘筛选四个维度梳理一段经历,按记忆衰减曲线和任务价值,判断哪些该降权、哪些该往后放;在此之上,零散的经历还要经过事实合并、冲突消解、模式抽象、摘要回写四道加工,把碎片化的事实收敛成稳定的认知。
唤起,是按任务复杂度动态调用记忆深度。MemoryBear 把检索分成三档,简单问答走快速命中,常规问题做问题拆解,复杂推理做关系多跳的深度调取,资源按需分配,不为每一次交互都付出全量认知的成本。
四个动作走全了,记忆才能从"存着"变成"懂你"。
不能量化的记忆,称不上记忆能力
记忆能力能不能被量化,是判断一个模型是不是"真记忆型"的最后一道门槛。这一点,恰恰是记忆赛道过去最模糊的地方,厂商自述的能力难以横向比较。
在 AI 记忆领域,LongMemEval 和 LoCoMo 是两项经过同行评审、被学界广泛引用的公开基准。
LongMemEval 把 500 道题嵌在长对话里,考信息抽取、跨会话推理、时序推理、知识更新,以及该拒答时拒答;LoCoMo 则用跨越数十条对话的超长对话,考模型能否在相隔很久之后,还记得早前的信息与因果。它们考的不只是"记性",而是客服、营销等真实业务里直接决定服务质量的几项能力。
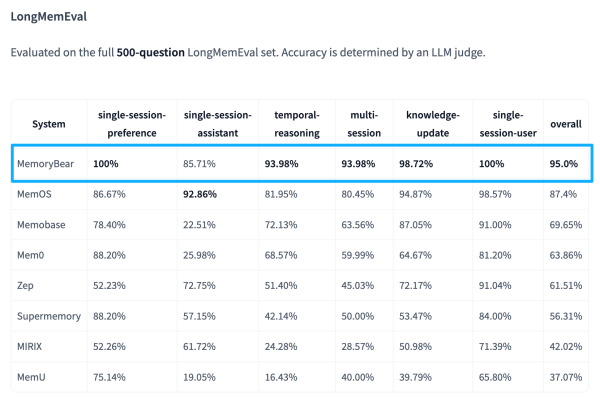
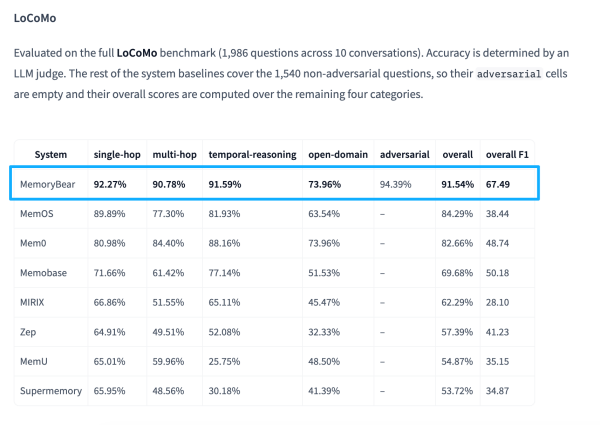
红熊AI 的 MemoryBear 在这两项基准上分别取得 95% 与 91.54% 的成绩。更重要的是,红熊AI 公开了评测的运行记录与复现方式,评测代码、流程文档和逐题召回结果都可核验。这意味着"记忆能力"不再是厂商自说自话,而是可以被第三方复现的工程事实。对要选型的企业来说,这比任何话术都更有参考价值。
引擎、模型、应用,红熊的三层记忆答卷
记忆型大模型不是孤立存在的。红熊AI 的记忆答卷分三层:底层是记忆引擎,中层是记忆型大模型,上层是行业应用。
底层是 MemoryBear 类脑记忆引擎。它参照人脑海马体的机制,构建工作记忆、短期记忆、长期记忆的分层管理,通过接入层、组织层、调控层、检索层、审计层五层架构,串联起感知、萃取、巩固、遗忘、反思、检索的认知闭环。围绕"时间"这个记忆系统最稀缺的维度,它还沉淀了时间记忆、动态语义网络、智能语义剪枝、自我反思引擎等能力,让 AI 第一次拥有了可以追溯、可以演化的历史观。
中层是两款记忆型大模型。OpenBear 是记忆型全模态通用大模型,构建了工作记忆、短期记忆、长期记忆三级记忆体系,通过 Fast/Slow Weights 机制让短期信息沉淀为长期认知。在真实使用中,这种能力体现得具体:它能跨天记住一个持续推进的目标,不必你每次重述背景;写周报时自动调用这一周的工作记忆,把零散进展汇成总结;记得你减脂、偏爱无糖咖啡,点单时会主动用上。CodeBear 是记忆型编程大模型,把项目架构、团队规范、历史决策沉淀为可复用的记忆资产,让 AI 从"帮你补全"走向"像个熟悉项目的老同事"。
上层是基于这套记忆架构开发的智能客服、智能营销、ChatBI、智能教育四个 Agent 应用,让记忆能力落到真实业务场景里,而不是停在评测榜单上。
记忆,是与推理并列的第二引擎
回看这条技术路径,背后的判断只有一个:记忆不是推理的附属,而是与推理并列的 AI 第二引擎。
对一家企业而言,选择记忆型大模型,本质上是在选择 AI 能不能"陪它一起成长"。普通大模型换一家也差不太多,但一套随业务沉淀下来的记忆系统,承载的是这家企业独有的客户、口径和决策经验,很难被轻易复制。这也解释了为什么记忆会成为一条独立的赛道,而不只是大模型的一个参数。
从个人记忆的稳定与可追溯,到跨 Agent 的认知共享,再到持续演化的数字认知体,记忆技术的发展路径已经清晰。当行业还在比拼谁更聪明,红熊AI 已经把记忆做成了模型的底层能力。这也是"记忆驱动 AGI"这条技术路线的由来:先让 AI 记得住,再谈持续成长。红熊AI 的模型研发总经理揭志敏对此有一句话:不是让 AI 记住一切,而是让它知道什么值得记住。
记忆,定义下一代智能。把人工智能带入每一家企业,靠的不只是更强的推理,更是能记住每一个客户、每一个项目、每一次判断的记忆力。
更多推荐
 0
 0
- 0


 已为社区贡献5803条内容

所有评论(0)