
物联网设备数据乱序处理:用 seq 和 watermark 接住迟到消息
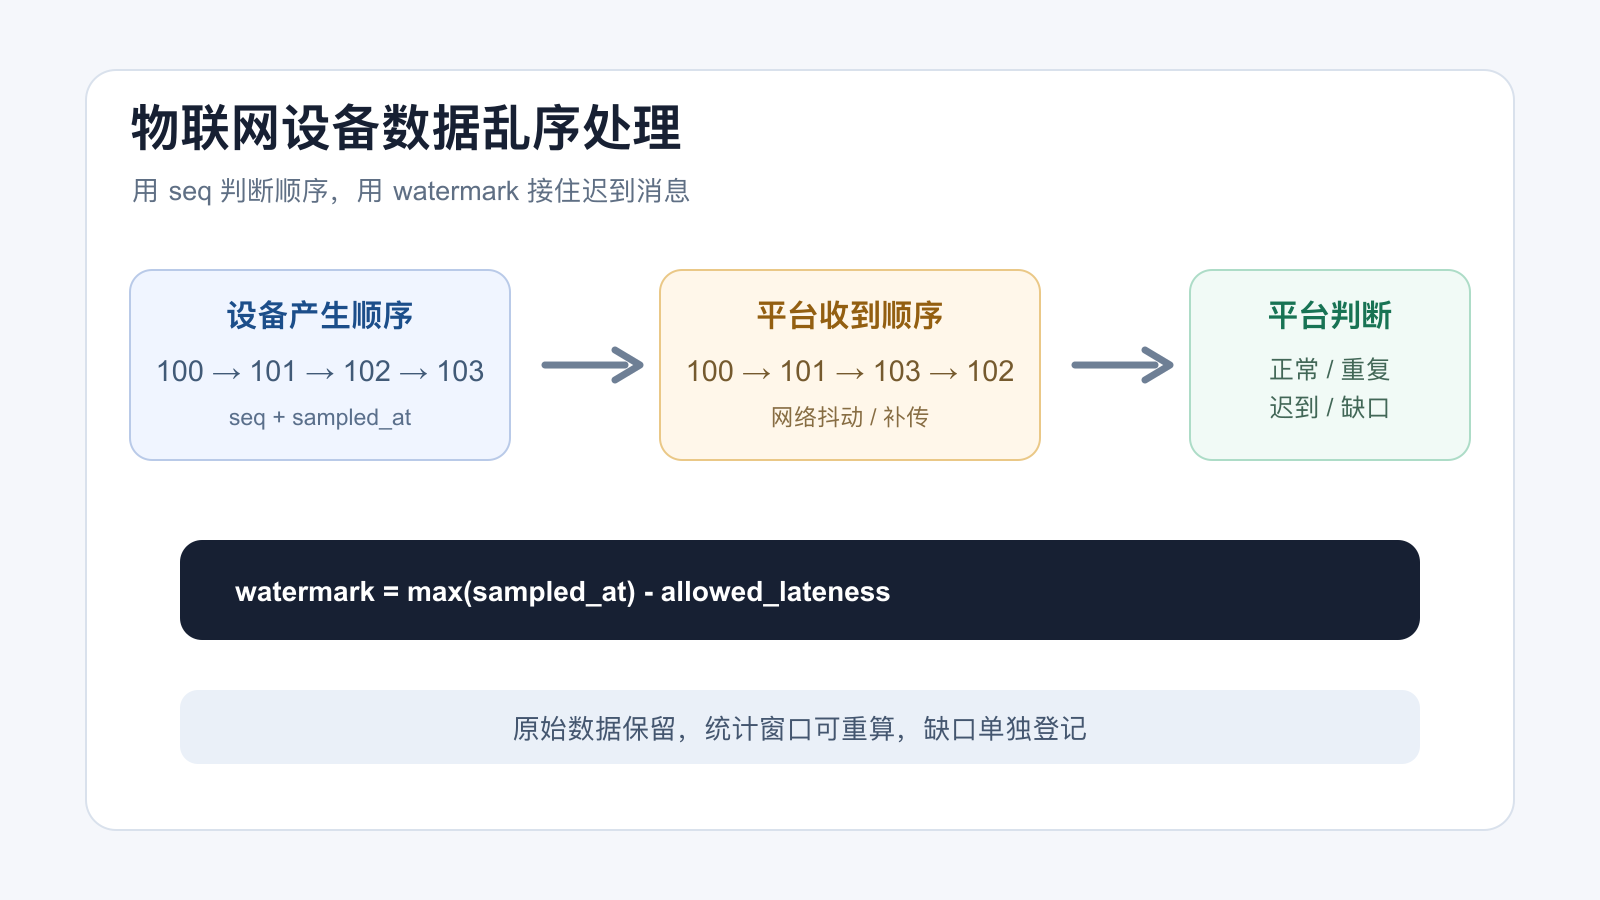
设备上报数据时,平台收到的顺序不一定等于设备产生的顺序。
例如设备依次产生了 seq=100、101、102、103 四条数据,网络抖动后,平台可能先收到 100、101、103,过了一会儿才收到 102。要是直接按接收时间入库,曲线会出现倒退,按时间计算的统计结果也可能被改写。
在星野云联这类多门店设备接入场景里,设备离线补传、边缘网关缓存和网络重试都会制造这种乱序。处理这类数据时,重点不是把消息强行排成一条队,而是判断每条消息当前该怎么处理。
1. 不要用 received_at 判断先后
一条设备数据至少要保留两类时间:
{
  "device_id": "meter_021",
  "seq": 102,
  "sampled_at": "2026-09-20T09:01:02+08:00",
  "received_at": "2026-09-20T09:01:08+08:00",
  "value": 18.6
}
sampled_at 表示设备采集数据的时间,received_at 表示平台收到数据的时间。前者用于业务分析,后者用于观察链路延迟。
如果设备支持连续递增的序列号,最好再增加 seq。时间可能因为设备时钟漂移而不可靠,序列号通常更适合判断同一台设备的数据顺序。
2. 先定义四种消息状态
收到一条新数据后,可以拿它和设备当前记录的最大序列号比较:
incoming_seq > max_seq       正常新数据
incoming_seq == max_seq      重复数据
incoming_seq < max_seq       可能是迟到数据
incoming_seq > max_seq + 1   中间存在缺口
这里的“可能”很重要。seq=102 晚于 seq=103 到达,不代表 102 一定是无效数据,它可能只是路上慢了一点。
可以把判断写成一个简单函数:
def classify(incoming_seq, max_seq):
    if incoming_seq == max_seq + 1:
        return "next"
    if incoming_seq <= max_seq:
        return "duplicate_or_late"
    return "gap"
生产代码里还需要结合设备是否允许补传、数据是否已经落库等条件,但先把消息分成几类,后续处理会清楚很多。
3. 给迟到消息留一个窗口
平台不能无限等待缺失的数据。常见做法是设置允许迟到窗口,例如 5 分钟。
假设设备的采样时间如下:
09:01:00  seq=100
09:01:01  seq=101
09:01:03  seq=103
09:01:02  seq=102
当 seq=103 到达时,平台可以先把它放入待处理区,而不是立即用它关闭当前时间窗口。等到 watermark 推进到 09:01:08,再判断 09:01:02 是否已经超过允许迟到范围。
一个简化的计算方式是:
watermark = max_sampled_at - allowed_lateness
例如:
max_sampled_at    = 09:01:08
allowed_lateness  = 00:05:00
watermark         = 08:56:08
早于 watermark 的数据可以进入补算流程,晚于 watermark 的数据继续等待。这个窗口需要根据设备网络情况来调,不能直接套一个固定值。
4. 原始数据和统计结果分开
乱序处理最怕“收到一条就覆盖上一条”。建议把原始上报和聚合结果拆开:
device_measurement_raw
  device_id
  seq
  sampled_at
  received_at
  value

device_measurement_hourly
  device_id
  window_start
  window_end
  avg_value
  version
原始表负责保留设备实际上报过什么,统计表负责保存当前计算结果。迟到消息到来后,可以重算对应的时间窗口,再增加 version。这样既能修正统计结果,也能查出结果为什么发生变化。
5. 缺口不一定等于丢包
看到 100、101、103 时,不能马上把 102 标记为丢失。至少要等到下面几种情况之一再做判断:
- 收到设备明确的补传结束标记;
- 超过允许迟到窗口;
- 设备重新上线后仍没有补回;
- 人工确认设备在这段时间没有产生数据。
如果确实需要补数,可以记录一个缺口表:
{
  "device_id": "meter_021",
  "missing_from": 102,
  "missing_to": 102,
  "detected_at": "2026-09-20T09:06:08+08:00",
  "status": "waiting_repair"
}
缺口记录独立出来以后,数据补传、告警判断和运维排查就不会互相覆盖。
6. 入库时保留唯一约束
同一条消息可能因为 MQTT 重投、HTTP 重试或网关补传而到达多次。原始表可以使用:
unique(device_id, seq)
如果设备重启后会重置序列号,就不能只依赖 device_id + seq,还需要增加设备启动批次,例如:
unique(device_id, boot_id, seq)
这一点要在设备协议设计阶段确定。否则平台上线后再补字段,历史数据很难处理。
7. 一个简单的处理流程
可以把整条链路压缩成下面几步:
接收消息
    |
校验 device_id、seq、sampled_at
    |
写入原始表,重复消息直接丢弃
    |
更新 max_seq 和 watermark
    |
处理正常数据,登记缺口,重算迟到窗口
这个流程不依赖特定消息队列。无论底层使用 MQTT、HTTP 还是其他协议,只要设备数据存在延迟、重试和补传,就需要类似的判断。
结语
物联网数据处理里,乱序是常态,不是异常。平台真正需要做的是保留事件时间、设备序列号和接收时间,再用迟到窗口控制什么时候计算、什么时候等待、什么时候补算。
先把“这条数据何时产生、何时收到、是否重复、是否缺口”记录清楚,后面的时序统计和异常判断才有稳定的基础。
参考标签:物联网、边缘计算、消息乱序、watermark、时序数据、设备数据
更多推荐

 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)