
虚拟机到底怎么 “骗” 硬件?CPU 内存 IO 虚拟化底层原理大揭秘
虚拟化技术介绍
虚拟化技术概览
虚拟化技术简介
什么是虚拟化
- 虚拟化(Virtualization)的含义很广泛。将任何一种形式的资源抽象成另一种形式的技术都是虚拟化,是资源的一种逻辑表示。解除了物理硬件和操作系统之间的紧耦合关系
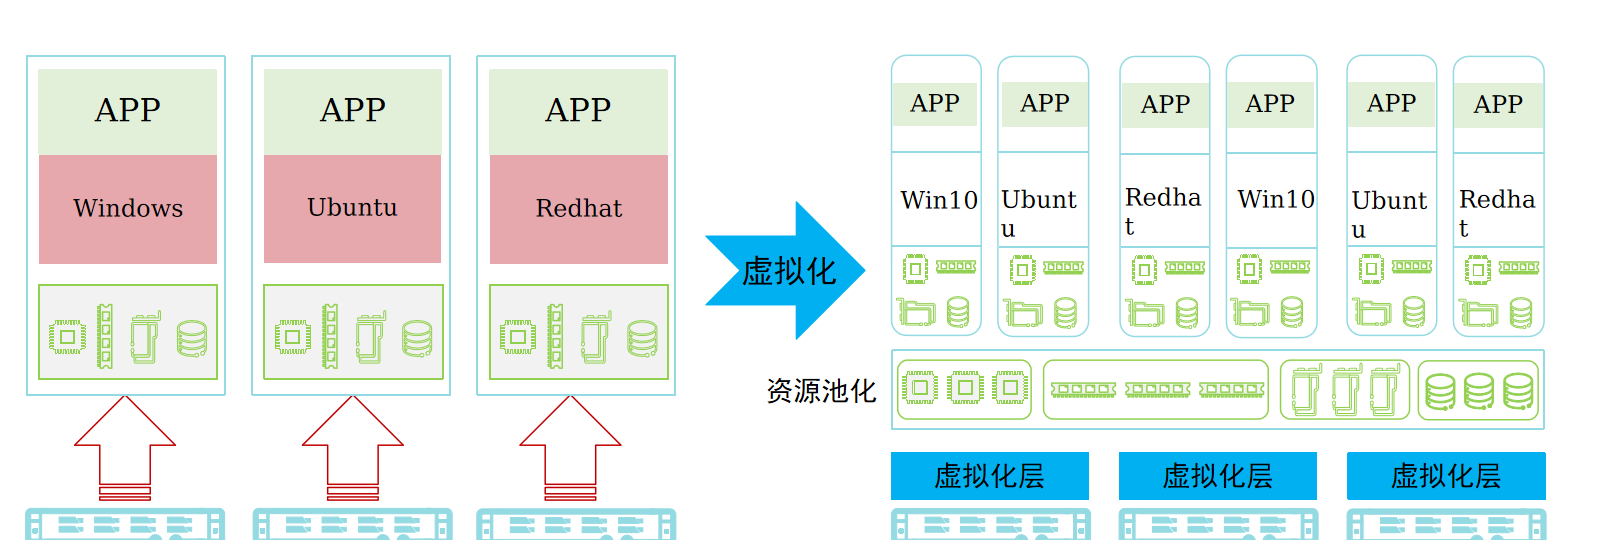
- IT资源独立
- 操作系统必须与硬件紧耦合
- 资源抽象成共享资源池
- 上层操作系统与硬件解耦,操作系统从资源池中分配资源
[!tip]
虚拟化是云计算的基础。简单地说,虚拟化使得在一台物理的服务器上可以跑多台虚拟机,虚拟机共享物理机的CPU、内存、IO硬件资源,但逻辑上虚拟机之间是相互隔离的。
在计算机方面,虚拟化一般指通过对计算机物理资源的抽象,提供一个或多个操作环境,实现资源的模拟、隔离或共享等。
本质上,虚拟化就是对硬件资源的一种抽象与模拟。通过空间上的分割、时间上的分时以及模拟,虚拟化可将一份资源抽象成多份,亦可将多份资源抽象成一份。
虚拟化中的重要概念
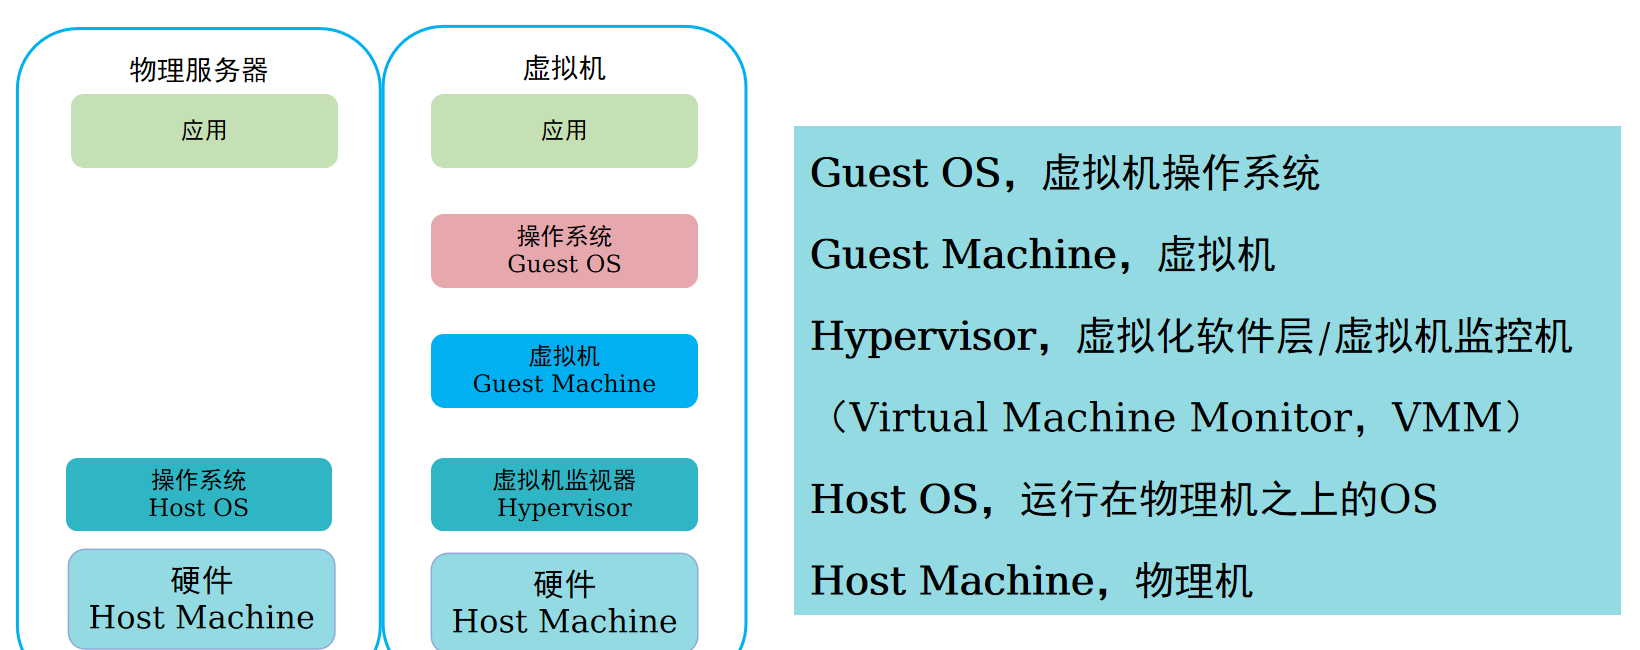
- Guest OS,虚拟机操作系统
- Guest Machine,虚拟机
- Hypervisor,虚拟化软件层/虚拟机监控机(Virtual Machine Monitor,VMM)
- Host OS,运行在物理机之上的OS
- Host Machine,物理机
虚拟化技术发展史
[!tip]
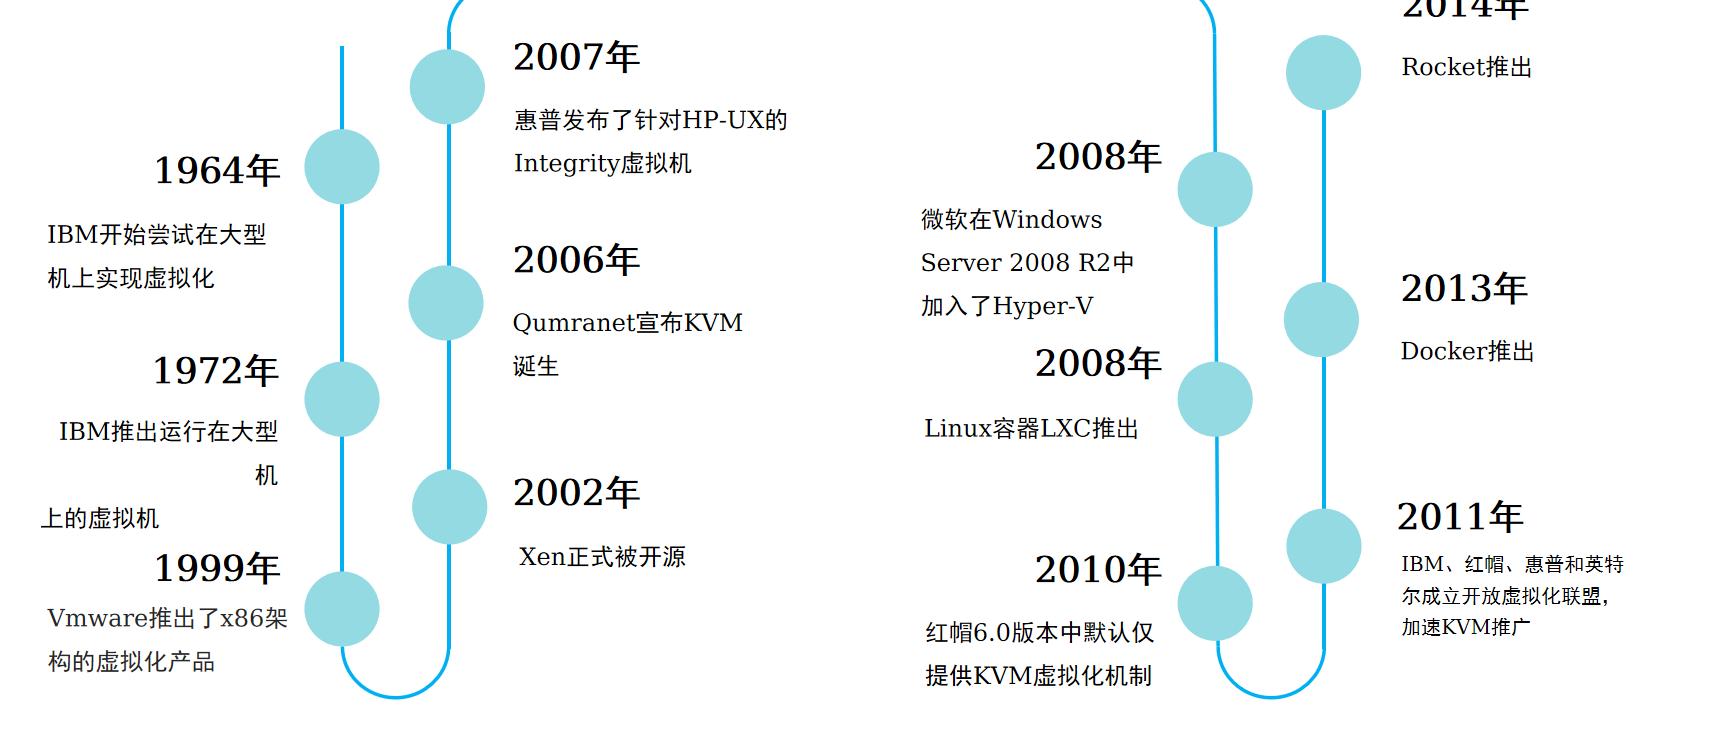
1964年,“蓝色巨人”IBM就开始尝试在大型机上实现虚拟化。
1972年,IBM正式将system370机的分时系统命名为虚拟机。
1999年,VMware推出了最早的能在x86架构上运行的虚拟化产品。
2002年Xen正式被开源,并先后推出了1.0和2.0版本。在这之后,Xen作为虚拟化解决方案,开始被诸如Redhat、Novell和Sun的Linux发行版集成。2004年,Intel的工程师开始为Xen添加硬件虚拟化的支持,从而为即将上市的新款处理器做必需的软件准备。在他们的努力下,2005年发布的Xen 3.0,开始正式支持Intel的VT技术和IA64架构,因此Xen虚拟机就可以运行完全没有修改的操作系统了。
2006年10月,在完成基本功能、动态迁移以及主要的功能和性能的优化后,Qumranet正式对外宣布KVM的诞生。同年10月,KVM模块的源代码被正式纳入Linux Kernel,成为内核源代码的一部分。
在2006年至2010年期间,各大传统IT厂商在虚拟化方面都推出了自己的产品。2007年,HP推出了Integrity虚拟机,微软在Windows Server 2008 R2中加入了Hyper-V。2010年11月,Redhat公司推出了新的企业版Linux——RHEL 6,该发行版集成了最新的KVM虚拟机,替换了在RHEL 5.x系列中集成的Xen。
2011年IBM、红帽、惠普和英特尔成立开放虚拟化联盟,加速KVM推广。
2013年,推出了Docker容器项目。Docker引入了一整套与容器管理相关的生态系统。其中包括一套高效的分层式容器镜像模型、一套全局及本地容器注册表、一个精简化REST API以及一套命令行界面等等。Docker公司还构建出一套名为Docker Swarm的容器集群管理解决方案。2014年,Rocket推出,它最初是由CoreOS开发的,专门用于解决Docker中存在的部分缺陷。CoreOS目标是在满足安全性与生产要求能力上超越Docker。Rocket基于App Container规范,并使其成为一项更为开放的标准。
虚拟化的类型
| 分类 | 说明 |
|---|---|
| 全虚拟化 | 使用VMM实现CPU、内存、设备I/O的虚拟化,而Guest OS和计算机系统硬件都不需要进行修改。该方式兼容性好,但会给处理器带来额外开销 |
| 半虚拟化 | 使用VMM实现CPU和内存虚拟化,设备I/O虚拟化由Guest OS实现。需要修改 Guest OS,使其能够与VMM协同工作。该方式兼容性差,但性能较好 |
| 硬件辅助虚拟化 | 借助硬件(主要是处理器)的支持来实现高效的全虚拟化。该方式不需要修改Guest OS,兼容性好。该技术将逐渐消除软件虚拟化技术之间的差别,成为未来的发展趋势 |
虚拟化的特点
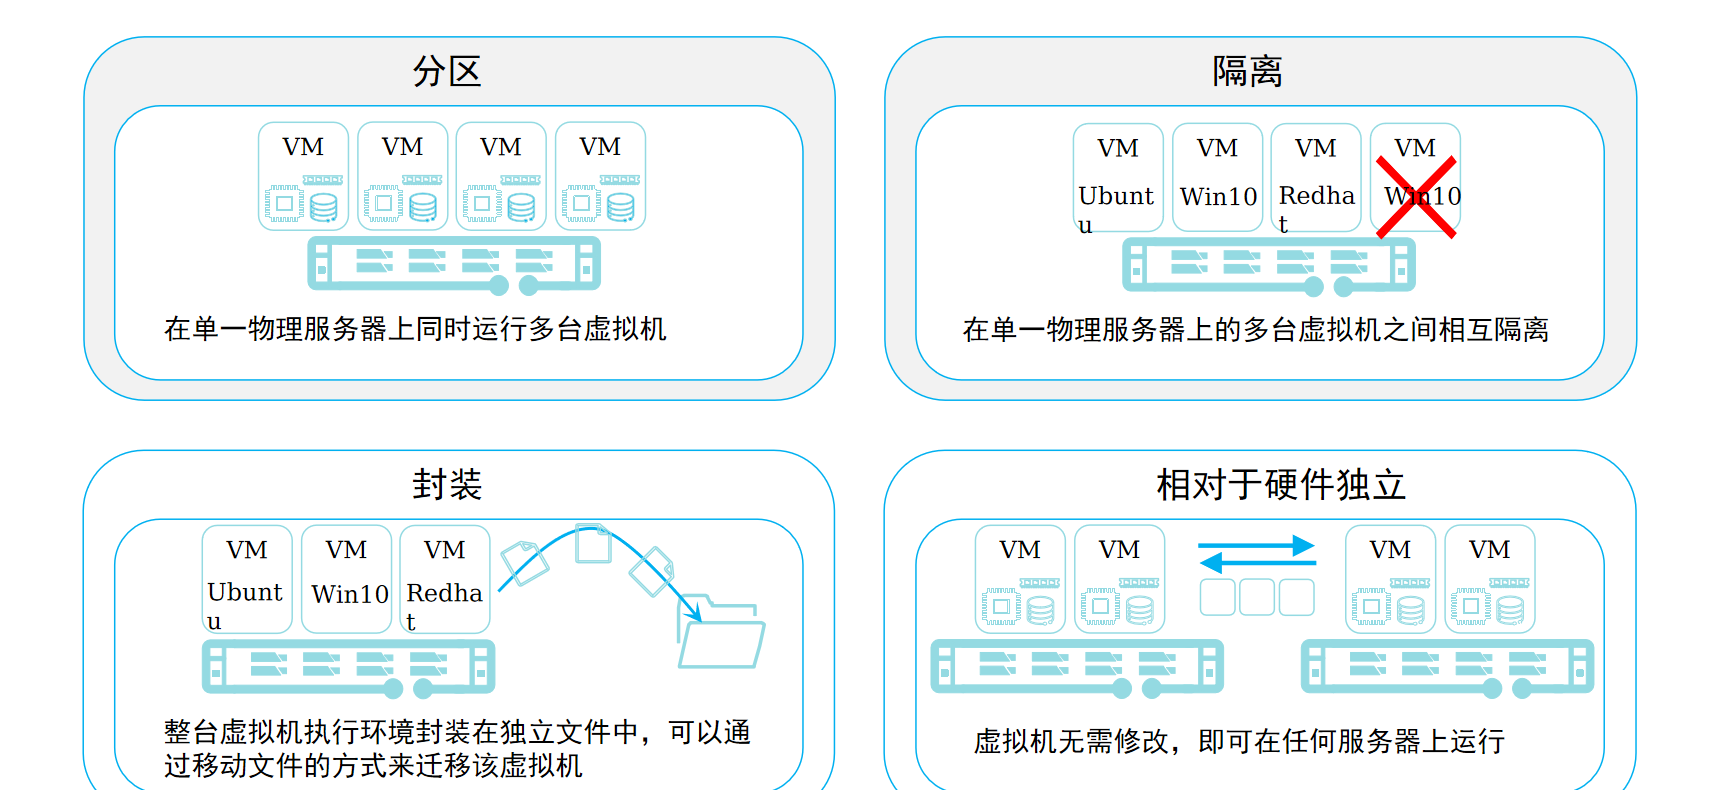
- 分区:在单一物理服务器上同时运行多台虚拟机
- 隔离:虚拟机之间相互隔离,一台虚拟机故障不影响其他虚拟机
- 封装:虚拟机封装为文件,便于迁移和备份
- 相对于硬件独立:虚拟机运行在虚拟化层之上,与底层硬件解耦
[!tip]
分区:分区意味着虚拟化层为多台虚拟机划分服务器资源的能力;每台虚拟机可以同时运行一个单独的操作系统(相同或不同的操作系统),使您能够在一台服务器上运行多个应用程序;每个操作系统只能看到虚拟化层为其提供的“虚拟硬件”(虚拟网卡、CPU、内存等),以使它认为运行在自己的专用服务器上。
隔离:虚拟机是互相隔离的
一台虚拟机的崩溃或故障(例如,操作系统故障、应用程序崩溃、驱动程序故障,等等)不会影响同一服务器上的其他虚拟机。
一台虚拟机中的病毒、蠕虫等与其它虚拟机相隔离,就像每台虚拟机都位于单独的物理机器上一样。
可以进行资源控制以提供性能隔离:您可以为每台虚拟机指定最小和最大资源使用量,以确保某台虚拟机不会占用所有的资源而使得同一系统中的其他虚拟机无资源可用。
可以在单一机器上同时运行多个负载/应用程序/操作系统,而不会出现我们刚才讨论传统x86服务器体系结构的局限性时所提到的那些问题(应用程序冲突、DLL冲突等)。
封装:封装意味着将整台虚拟机(硬件配置、BIOS配置、内存状态、磁盘状态、CPU 状态)储存在独立于物理硬件的一小组文件中。这样,您只需复制几个文件就可以随时随地根据需要复制、保存和移动虚拟机。
相对于硬件独立:因为虚拟机运行于虚拟化层之上,所以只能看到虚拟化层提供的虚拟硬件;此虚拟硬件也同样不必考虑物理服务器的情况;这样,虚拟机就可以在任何x86服务器(IBM、Dell、HP等)上运行而无需进行任何修改。这打破了操作系统和硬件以及应用程序和操作系统/硬件之间的约束。
虚拟化的优势
- 虚拟化前:
- 操作系统与物理服务器绑定
- 难以迁移,可靠性难以控制
- 难以扩展,资源利用率低
- 空间占用高,难以管理
- 虚拟化后:
- 操作系统与物理服务器分离
- 易于迁移、扩展,资源整合
- 标准化的虚拟硬件由一系列文件组成,易于保护
CPU虚拟化问题
- CPU虚拟化需要解决两个问题:
- 如何模拟CPU指令 (所有敏感指令)
敏感指令:可以读写系统关键资源的指令叫做敏感指令
特权指令:决大多数的敏感指令是特权指令,特权指令只能在处理器的最高特权级 (内核态)执行 - 如何让多台VM共享CPU
利用与Native操作系统类似的机制—通过定时器中断,在中断触发时陷入VMM,从而根据调度机制进行调度
- 如何模拟CPU指令 (所有敏感指令)
[!tip]
系统关键资源:处理器呈现给软件的接口是指令集和寄存器。而 I/O 设备呈现给软件的接口是状态和控制寄存器。这些都是系统的资源,其中影响处理器和设备状态和行为的寄存器称为关键资源。
CPU虚拟化
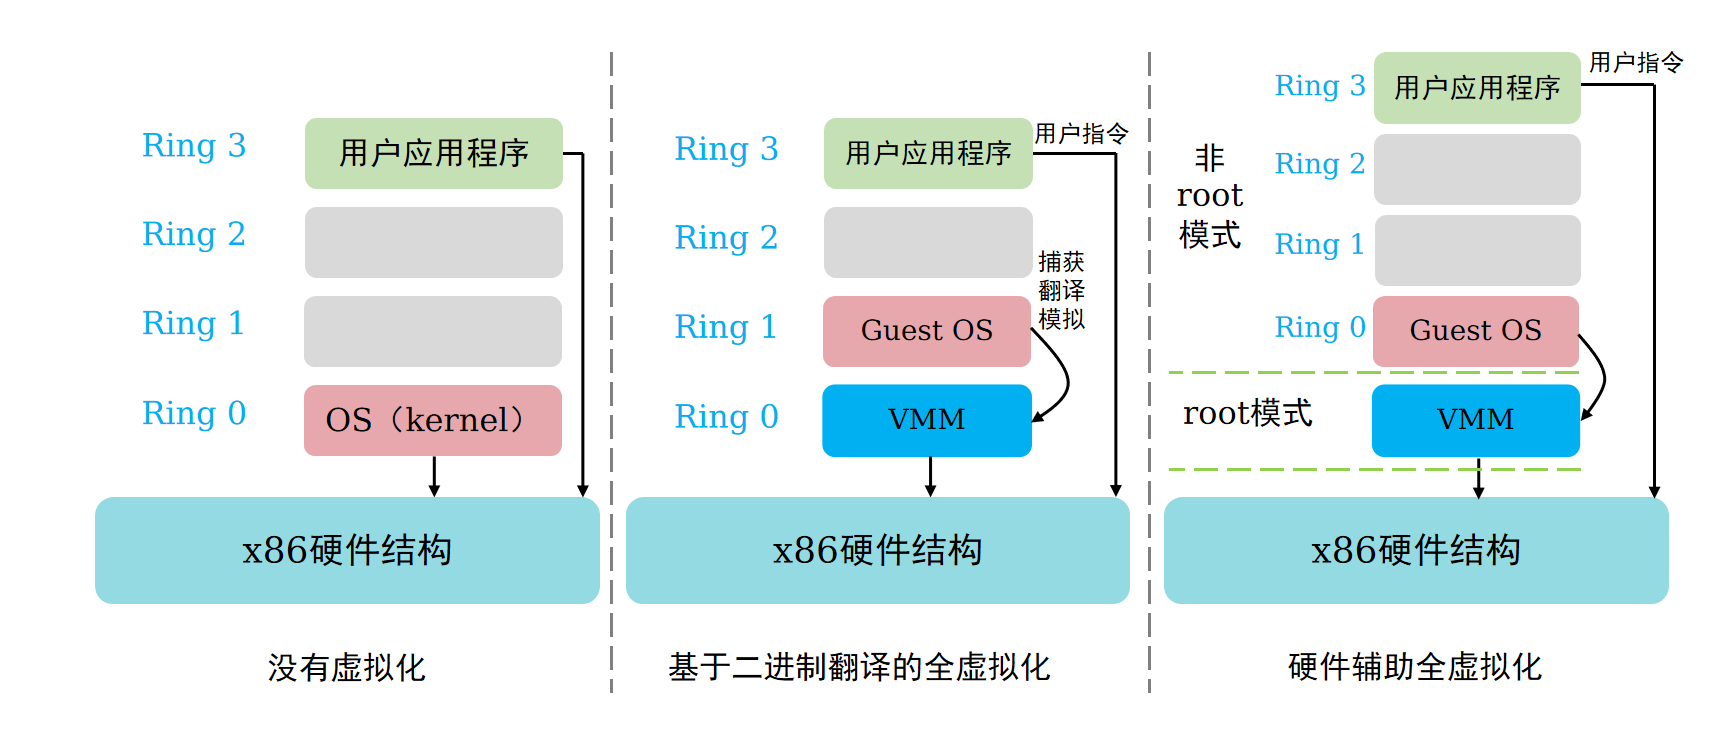
- x86架构提供4个特权级(Ring 0~Ring 3)
- 没有虚拟化时:OS内核运行在Ring 0,应用程序运行在Ring 3
- 全虚拟化:VMM运行在Ring 0,Guest OS运行在Ring 1
- 硬件辅助虚拟化(Intel VT-x / AMD-V):引入根模式(Root Mode)和非根模式(Non-root Mode)
[!tip]
后续介绍的FusionCompute采用的是硬件辅助全虚拟化
x86操作系统是设计成直接运行在裸硬件设备上的,因此它们自动认为它们完全占有计算机硬件。x86架构提供四个特权级别给操作系统和应用程序来访问硬件。Ring是指CPU的运行级别,Ring 0是最高级别,Ring 1次之,Ring 2更次之…… 就Linux+x86 来说:
操作系统(内核)需要直接访问硬件和内存,因此它的代码需要运行在最高运行级别Ring0上,这样它可以使用特权指令,控制中断、修改页表、访问设备等。
应用程序的代码运行在最低运行级别上Ring 3上,不能做受控操作。如果要做,比如要访问磁盘,写文件,那就要通过执行系统调用(函数),执行系统调用的时候,CPU的运行级别会发生从Ring 3到Ring 0的切换,并跳转到系统调用对应的内核代码位置执行,这样内核就为你完成了设备访问,完成之后再从Ring 0返回Ring 3。这个过程也称作用户态和内核态的切换。
那么,虚拟化在这里就遇到了一个难题,因为宿主操作系统是工作在Ring 0 的,客户操作系统就不能也在Ring 0 了,但是它不知道这一点,以前执行什么指令,现在还是执行什么指令,但是没有执行权限是会出错的。所以这时候虚拟机管理程序(VMM)需要避免这件事情发生。VM通过VMM实现Guest CPU对硬件的访问,根据其原理不同有三种实现技术:
全虚拟化
半虚拟化
硬件辅助的虚拟化
[!tip]
2005年后,CPU厂商Intel和AMD开始支持虚拟化了。Intel引入了Intel-VT(Virtualization Technology)技术。 这种 CPU,有VMX root operation和VMX non-root operation两种模式,两种模式都支持Ring 0 ~ Ring 3共4个运行级别。这样,VMM 可以运行在VMX root operation模式下,客户OS运行在VMX non-root operation模式下。
目前主要有Intel的VT-x和AMD的AMD-V这两种技术。其核心思想都是通过引入新的指令和运行模式,使VMM和Guest OS分别运行在不同模式(ROOT模式和非ROOT模式)下,且Guest OS运行在Ring 0下。通常情况下,Guest OS的核心指令可以直接下达到计算机系统硬件执行,而不需要经过VMM。当Guest OS执行到特殊指令的时候,系统会切换到VMM,让VMM来处理特殊指令。
以Intel VT技术为例,它增加了两种运行模式:VMX root模式和VMX nonroot模式。通常来讲,主机操作系统和VMM运行在VMX root模式中,客户机操作系统及其应用运行在VMX nonroot模式中。因为两个模式都支持所有的Ring,因此,客户机可以运行在它所需要的Ring中(OS运行在Ring 0中,应用运行在Ring 3中),VMM也运行在其需要的Ring中(对KVM来说,QEMU运行在Ring 3,KVM运行在Ring 0)。CPU 在两种模式之间的切换称为VMX切换。从root mode进入nonroot mode,称为VM-Entry;从nonroot mode进入root mode,称为VM-Exit。可见,CPU受控制地在两种模式之间切换,轮流执行VMM代码和Guest OS代码。
对KVM虚拟机来说,运行在VMX Root Mode下的VMM在需要执行Guest OS指令时执行VMLAUNCH指令将CPU转换到VMX non-root mode,开始执行客户机代码,即 VM-Entry过程;在Guest OS需要退出该mode时,CPU自动切换到VMX Root mode,即VM-Exit过程。可见,KVM用户机代码是受VMM控制直接运行在物理CPU上的。QEMU只是通过KVM控制虚拟机的代码被CPU执行,但是它们本身并不执行其代码。也就是说,CPU并没有真正地被虚拟化成虚拟CPU给客户机使用。
CPU和vCPU的对应关系
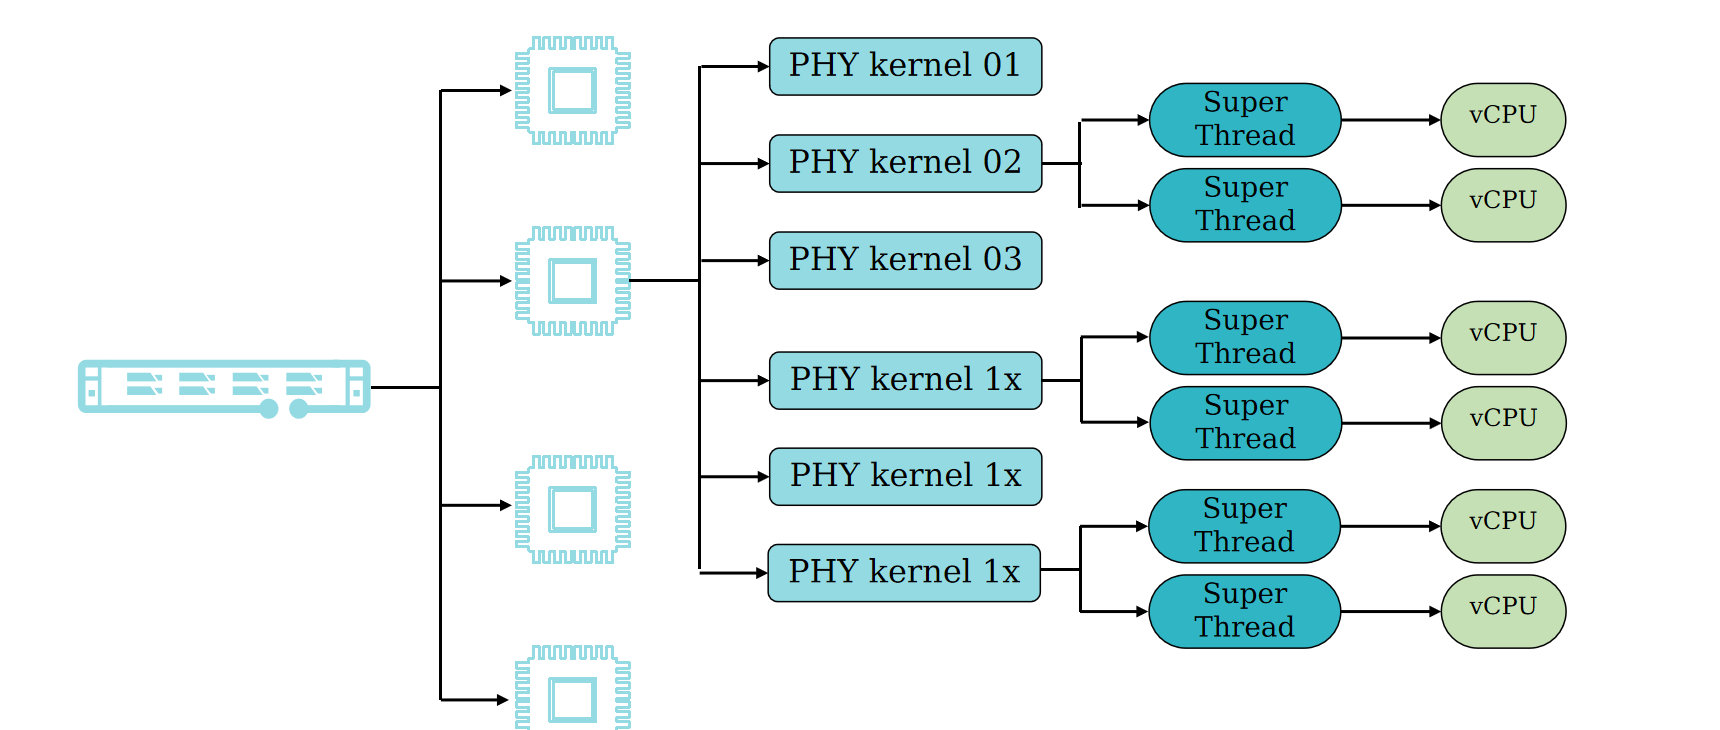
- 物理CPU(pCPU)通过超线程技术可以提供多个逻辑CPU
- 虚拟CPU(vCPU)是虚拟机看到的CPU,由VMM调度到物理CPU上运行
- vCPU与pCPU的对应关系由VMM的调度器决定,可以是1:1或N:1
[!tip]
vCPU数量和物理CPU对应关系如图所示。
以RH服务器使用2.6 GHz主频CPU为例,单台服务器有2颗物理CPU,每颗CPU有8核,又因为超线程技术可以提供每个物理内核两个处理线程,因此每颗CPU有16线程,总vCPU数量为282=32个vCPU。总资源为32*2.6 GHz=83.2 GHz。
虚拟机vCPU数量不能超过单台CNA节点可用vCPU数量。多台虚拟机间可以复用同一颗物理CPU,因此单CNA节点上运行的虚拟机vCPU数量总和可以超过实际vCPU数量。
内存虚拟化问题
- Native操作系统对内存的认识与管理达成以下两点认识:
- 内存都是从物理地址0开始的
- 内存都是连续的
- 内存虚拟化需要解决两个的问题:
- 从物理地址0开始的:物理地址0只有一个,无法同时满足所有客户机从0开始的要求
- 地址连续:虽然可以分配连续的物理地址,但是内存使用效率不高,缺乏灵活性
内存虚拟化
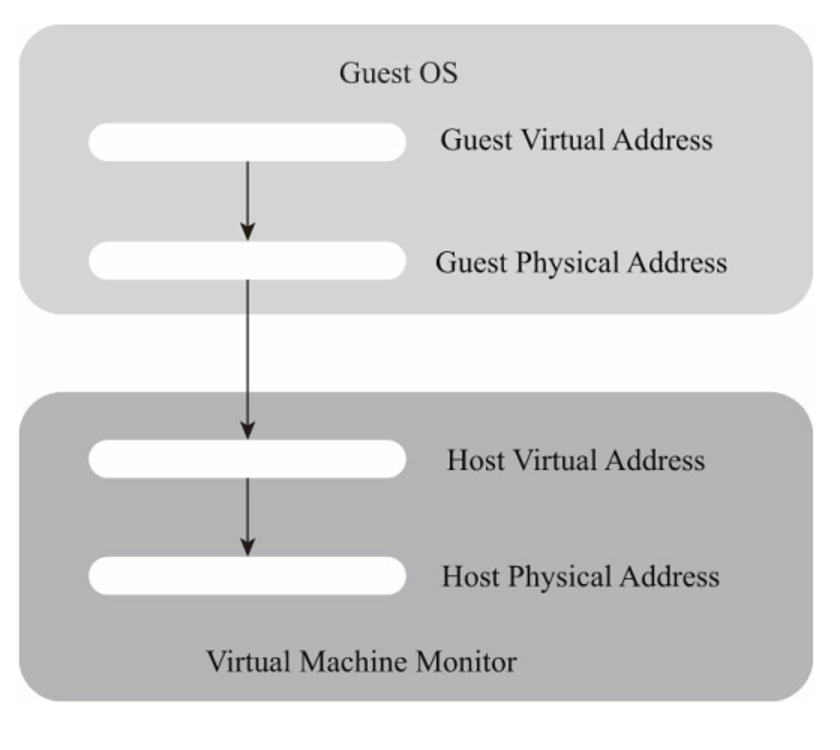
- 把物理机的真实物理内存统一管理,包装成多份虚拟的内存动态分配给若干虚拟机使用
- KVM通过内存虚拟化共享物理系统内存,动态分配给虚拟机
[!tip]
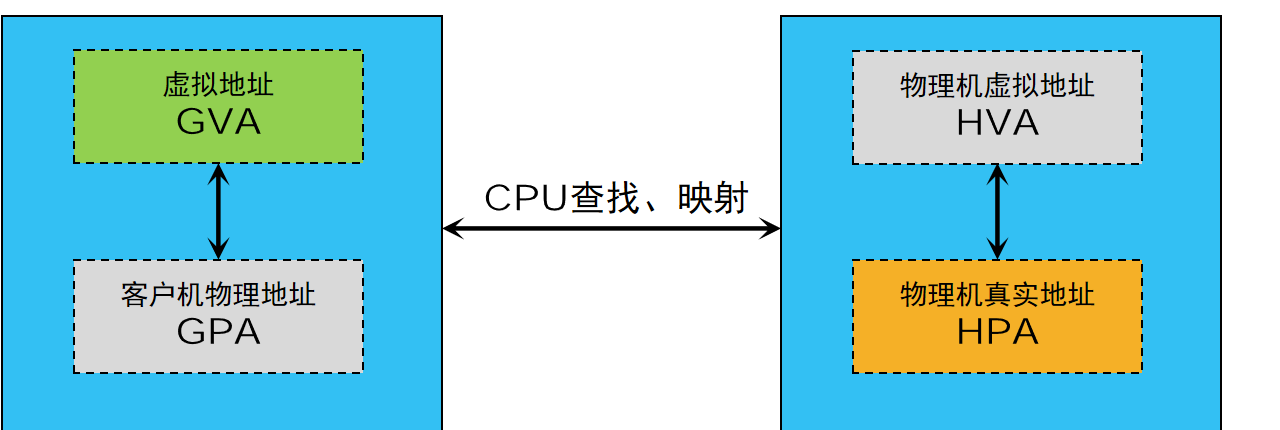
1) 客户机虚拟地址, GVA(Guest Virtual Address)
2) 客户机物理地址, GPA(Guest Physical Address)
3) 宿主机虚拟地址, HVA(Host Virtual Address)
4) 宿主机物理地址, HPA(Host Physical Address)
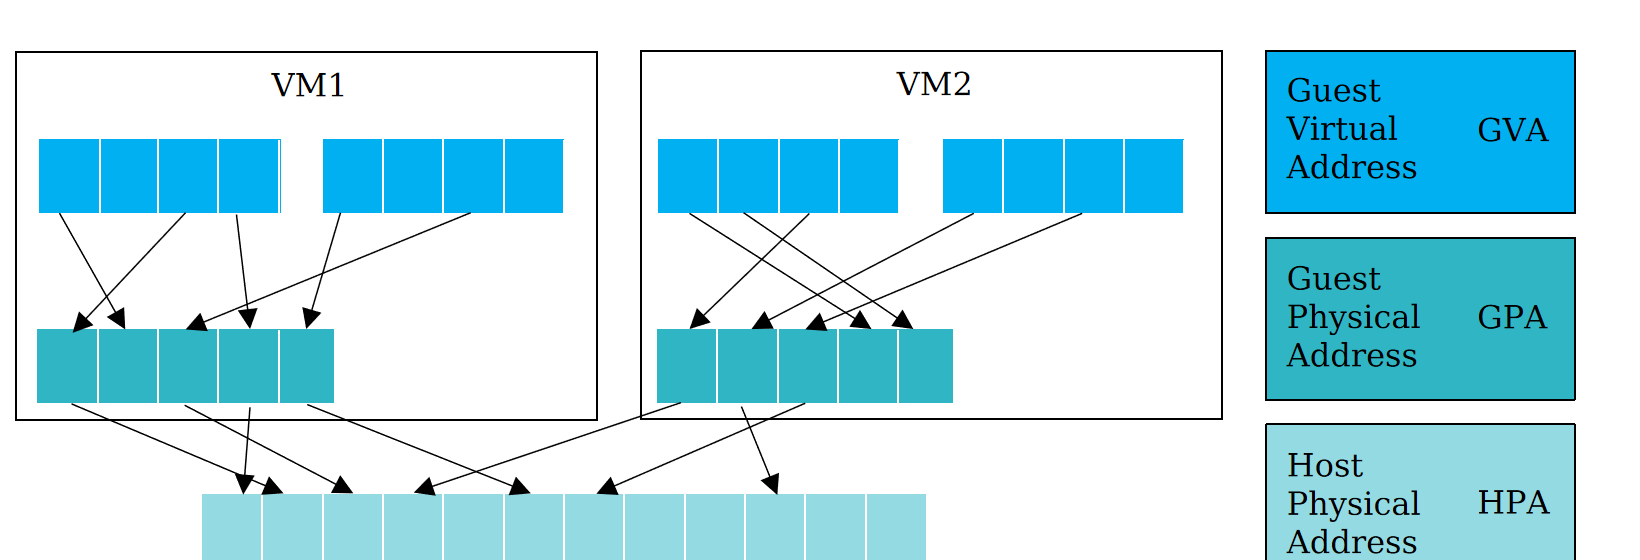
地址空间:
- GVA(Guest Virtual Address):客户机虚拟地址
- GPA(Guest Physical Address):客户机物理地址
- HVA(Host Virtual Address):宿主机虚拟地址
- HPA(Host Physical Address):宿主机物理地址
[!tip]
KVM中,虚拟机的物理内存即为qemu-kvm进程所占用的内存空间。KVM使用CPU辅助的内存虚拟化方式。
内存虚拟化 - 影子页表:
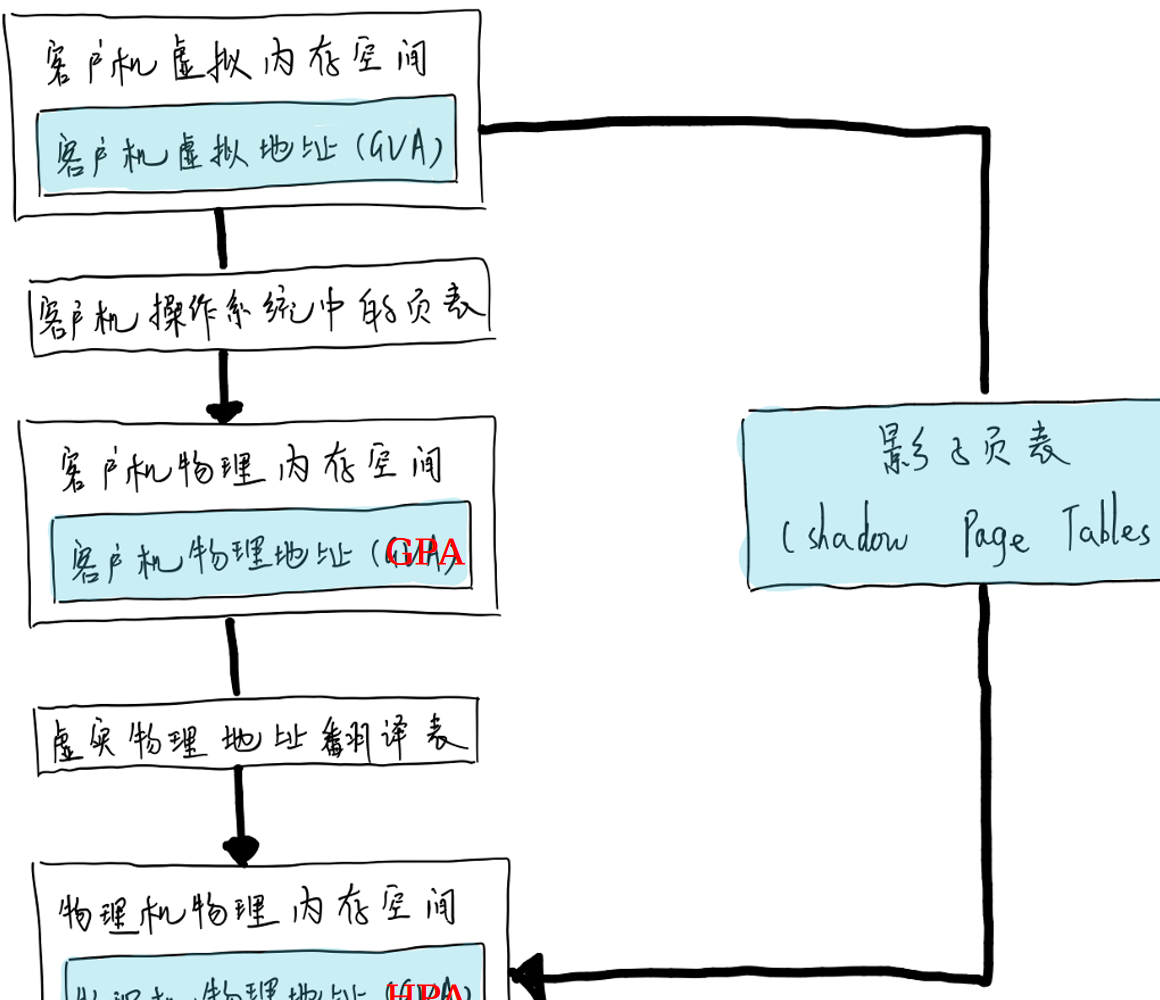
由于宿主机MMU不能直接装载客户机的页表来进行内存访问,所以当客户机访问宿主机物理内存时,需要经过多次地址转换。即首先根据客户机页表把客户机虚拟地址(GVA)转换成客户机物理地址(GPA),然后再通过客户机物理地址(GPA)到宿主机虚拟地址(HVA)之间的映射转换成宿主机虚拟地址,最后再根据宿主机页表把宿主机虚拟地址(HVA)转换成宿主机物理地址(HPA)。而通过影子页表,则可以实现客户机虚拟地址到宿主机物理地址的直接转换。
Intel的CPU提供了EPT(Extended Page Tables,扩展页表)技术,直接在硬件上支持GVA->GPA->HPA的地址转换,从而降低内存虚拟化实现的复杂度,也进一步提升内存虚拟化性能。
KVM为了在一台机器上运行多台虚拟机,需要增加一个新的内存虚拟化层(客户机物理地址空间),这个地址空间不是真正意义上的物理地址空间,它们之间还有一层转换。客户机虚拟地址(GVA)到客户机物理地址(GPA)的转换。
但是客户操作系统不能直接访问实际机器内存,因此VMM需要负责映射客户物理内存到实际机器内存(GPA ->HPA)。
MMU
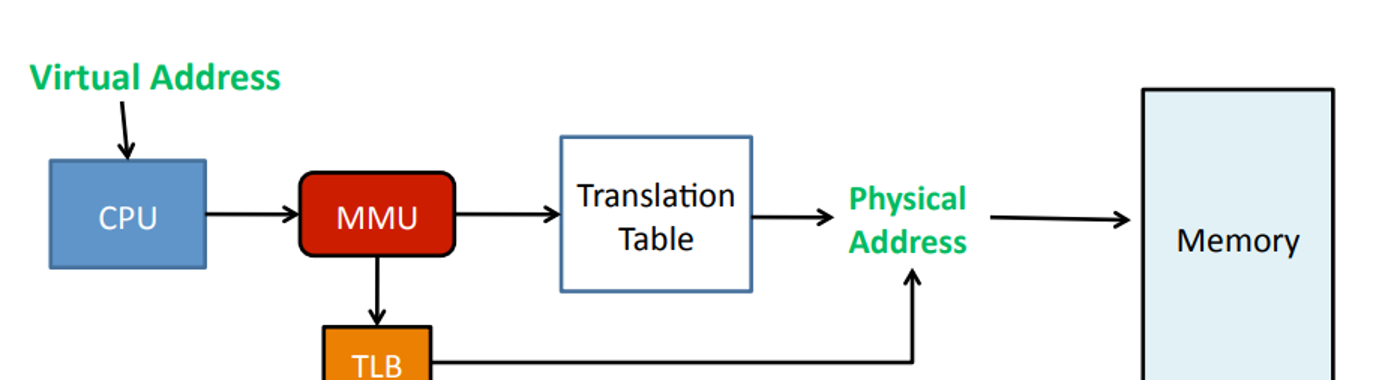
- 内存管理单元MMU(memory management unit)的主要功能是虚拟地址(virtual memory addresses)到物理地址(physical addresses)的转换。除此之外,它还可以实现内存保护(memory protection)、缓存控制(cache control)、总线仲裁(bus arbitration)以及存储体切换(bank switching)。
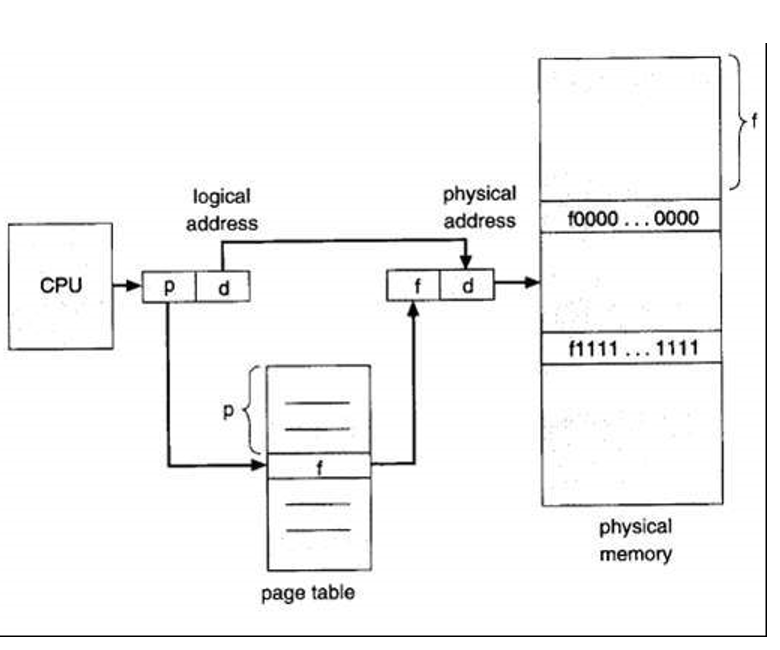
页表地址转换
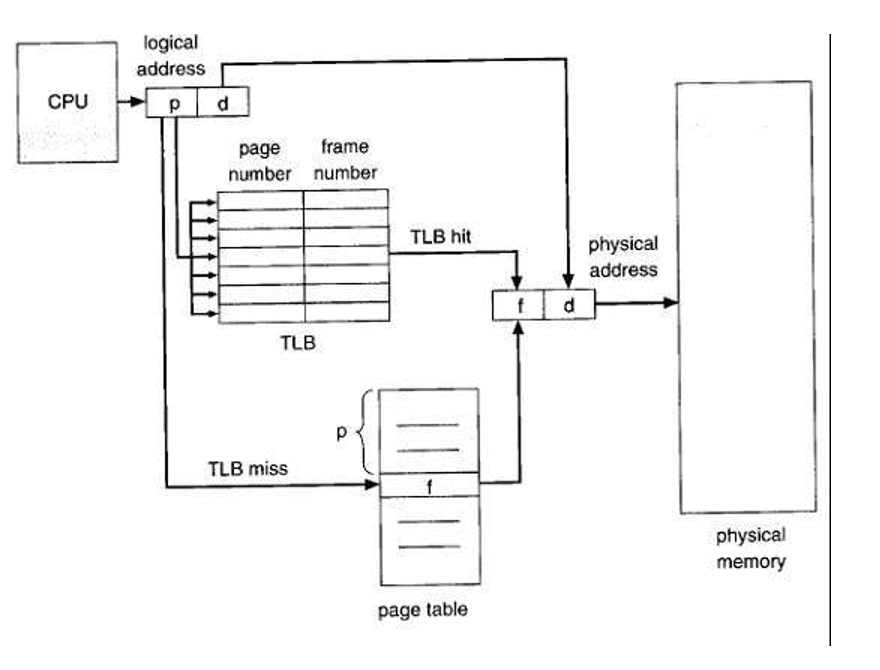
TLB
透明大页 (THP)
- 大页:
- 页大小2M
- 提高TLB命中率
- 减少访存时间
- 申请大内存区,效率更高
- 访问大内存去,减少页表项大小,提高CPU Cache效率
- 透明:
- 对使用者完全透明,不依赖任何库,大小页混合
- 兼容ksm,swap,需要共享或swap时拆分成4K大小页面
- 兼容EPT/NPT,兼容影子页表
[!tip]
x86 (包括x86-32和x86-64)架构的CPU默认使用4KB大小的内存页面,但是它们也支持较大的内存页,如x86-64系统就支持2MB大小的大页 (huge page)。Linux2.6及以上的内核都支持huge page。如果在系统中使用了huge page,则内存页的数量会减少,从而需要更少的页表 (page table),节约了页表所占用的内存数量,并且所需的地址转换也减少了,TLB缓存失效的次数就减少了,从而提高了内存访问的性能。另外,由于地址转换所需的信息一般保存在CPU的缓存中,huge page的使用让地址转换信息减少,从而减少了CPU缓存的使用,减轻了CPU缓存的压力,让CPU缓存能更多地用于应用程序的数据缓存,也能够在整体上提升系统的性能。
影子页表
- 由于宿主机MMU不能直接装载客户机的页表来进行内存访问,所以当客户机访问宿主机物理内存时,需要经过多次地址转换。也即首先根据客户机页表把客户机虚拟地址 (GVA)转换成客户机物理地址 (GPA),然后再通过客户机物理地址 (GPA)到宿主机虚拟地址 (HVA)之间的映射转换成宿主机虚拟地址,最后再根据宿主机页表把宿主机虚拟地址 (HVA)转换成宿主机物理地址 (HPA)。而通过影子页表,则可以实现客户机虚拟地址到宿主机物理地址的直接转换。
- Intel的CPU提供了EPT (Extended Page Tables,扩展页表)技术,直接在硬件上支持GVA->GPA->HPA的地址转换,从而降低内存虚拟化实现的复杂度,也进一步提升内存虚拟化性能。
[!tip]
AMD 提供的类似技术叫做NPT,即 Nested Pge Tables 。
[!tip]
内存虚拟化就是要将客户机虚拟地址(GVA) 转化为最终能够访问的宿主机上的物理地址(HPA) 。 对于客户机操作系统而言, 它不感知内存虚拟化的存在, 在程序访问客
户机中虚拟地址时, 通过CR3寄存器可以将其转化为物理地址, 但是在虚拟化环境中这个物理地址只是客户机的物理地址, 还不是真实内存硬件上的物理地址。 所以, 虚拟机监控器就需要维护从客户机虚拟地址到宿主机物理地址之间的一个映射关系, 在没有硬件提供的内存虚拟化之前, 这个维护映射关系的页表叫作影子页表(Shadow Page Table) 。 内存的访问和更新通常是非常频繁的, 要维护影子页表中对应关系会非常复杂, 开销也较大。同时需要为每一个客户机都维护一份影子页表, 当客户机数量较多时, 其影子页表占用的内存较大也会是一个问题。
内存虚拟化 (2)
- KVM中,虚机的物理内存即为qemu-kvm进程所占用的内存空间。KVM使用CPU 辅助的内存虚拟化方式。在Intel平台,其内存虚拟化的实现方式为EPT (Extended Page Tables)技术。直接在硬件上支持GVA->GPA->HPA的地址转换,从而降低内存虚拟化实现的复杂度,也进一步提升内存虚拟化性能。
[!tip]
H:Host
G:Guest
V:virtual
P:Physical
A:Address
EPT(Extended Page Tables,扩展页表)
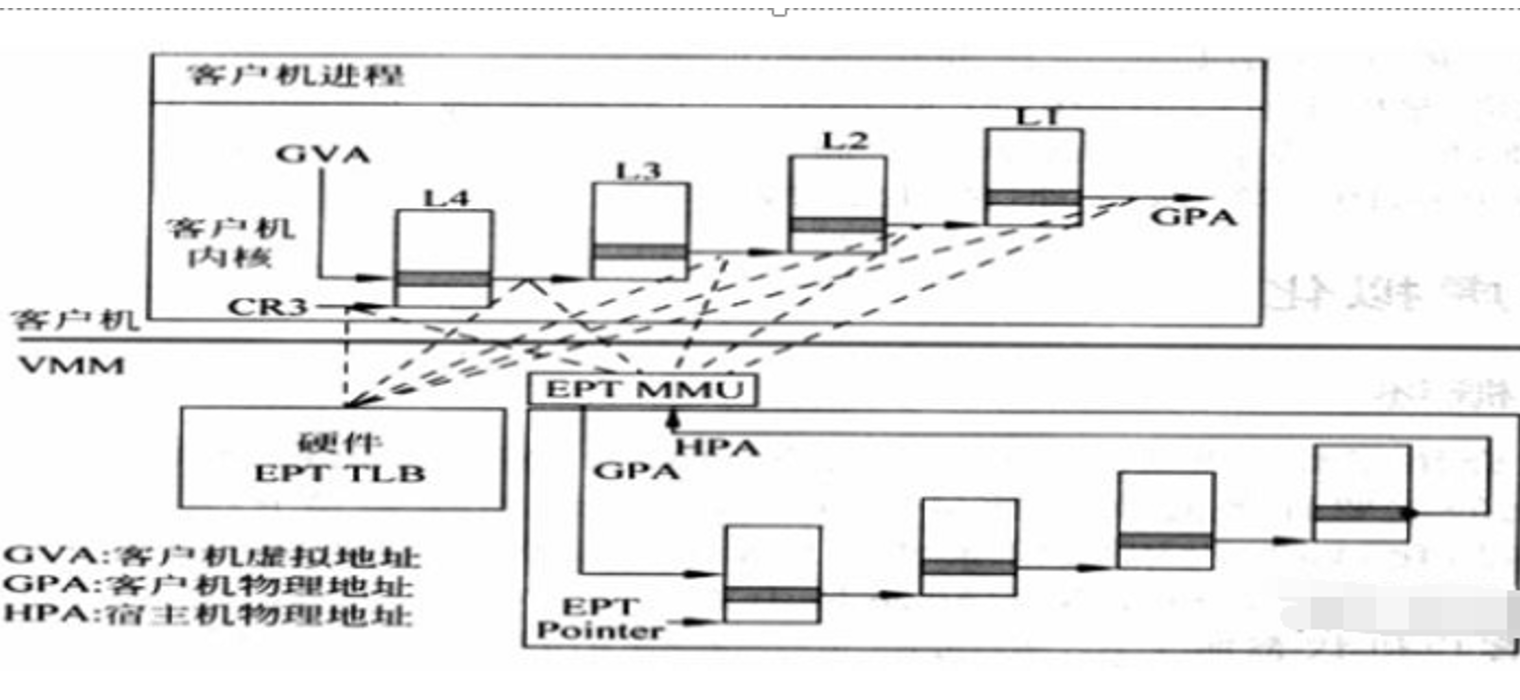
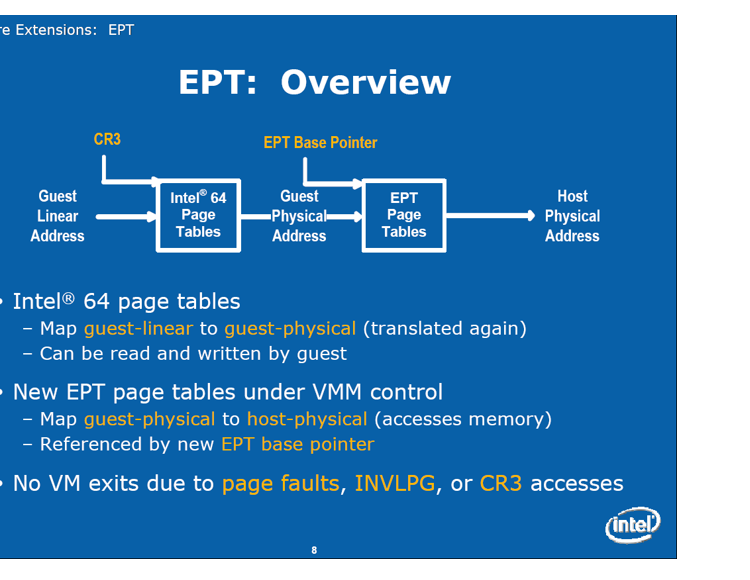
- CR3(控制寄存器3)将客户机程序所见的客户机虚拟地址(GVA)转化为客户机物理地址(GPA),然后在通过EPT将客户机物理地址(GPA)转化为宿主机物理地址(HPA)。这两次转换地址转换都是由CPU硬件来自动完成的,其转换效率非常高。
[!tip]
Intel CPU在硬件设计上就引入了EPT(Extended Page Tables, 扩展页表) , 从而将客户机虚拟地址到宿主机物理地址的转换通过硬件来实现。 当然, 这个转换是通过两个步骤来实现的, 如图所示。 首先, 通过客户机CR3寄存器将客户机虚拟地址转化为客户机物理地址, 然后通过查询EPT来实现客户机物理地址到宿主机物理地址的转化。 EPT的控制权在虚拟机监控器中, 只有当CPU工作在非根模式时才参与内存地址的转换。 使用EPT后, 客户机在读写CR3和执行INVLPG指令时不会导致VM Exit, 而且客户页表结构自身导致的页故障也不会导致VM Exit。 所以通过引入硬件上EPT的支持, 简化了内存虚拟化的实现复杂度, 同时也提高了内存地址转换的效率。
I/O虚拟化问题
- I/O虚拟化需要解决两个问题:
- 设备发现:
需要控制各虚拟机能够访问的设备 - 访问截获:
通过I/O端口或者MMIO对设备的访问
设备通过DMA与内存进行数据交换
- 设备发现:
I/O虚拟化
- I/O虚拟化可以被看作是位于服务器组件的系统和各种可用I/O处理单元之间的硬件中间件层,使得多个guest可以复用有限的外设资源
- 设备虚拟化(I/O虚拟化)的过程,就是模拟设备的这些寄存器和内存,截获Guest OS对IO端口和寄存器的访问,通过软件的方式来模拟设备行为
- 在QEMU/KVM中,客户机可以使用的设备大致可分为三类:
- 模拟设备:完全由QEMU纯软件模拟的设备
- Virtio设备:实现VIRTIO API的半虚拟化设备
- PCI设备直接分配(PCI device assignment)
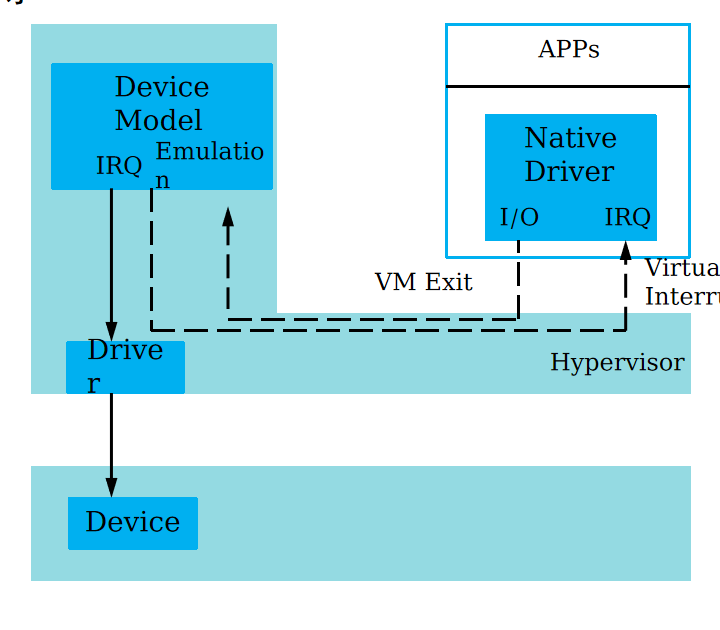
I/O虚拟化 - 全模拟
- 用软件完全模拟一个特定的设备
- 保持一样的软件接口,如:PIO、MMIO、DMA、中断等
- 可以模拟出跟系统中的物理设备不一样的虚拟设备
- 每次I/O操作需要多次上下文切换
- VM <-> Hypervisor
- QEMU <-> Hypervisor
- 软件模拟的设备不影响虚拟机中的软件栈
- 原生驱动
[!tip]
模拟I/O设备方式的优点是对硬件平台依赖性较低、可以方便模拟一些流行的和较老久的设备、不需要宿主机和客户机的额外支持,因此兼容性高;而其缺点是I/O路径较长、VM-Exit次数很多,因此性能较差。一般适用于对I/O性能要求不高的场景,或者模拟一些老旧遗留(legacy)设备(如RTL8139的网卡)。
I/O虚拟化 - Virtio
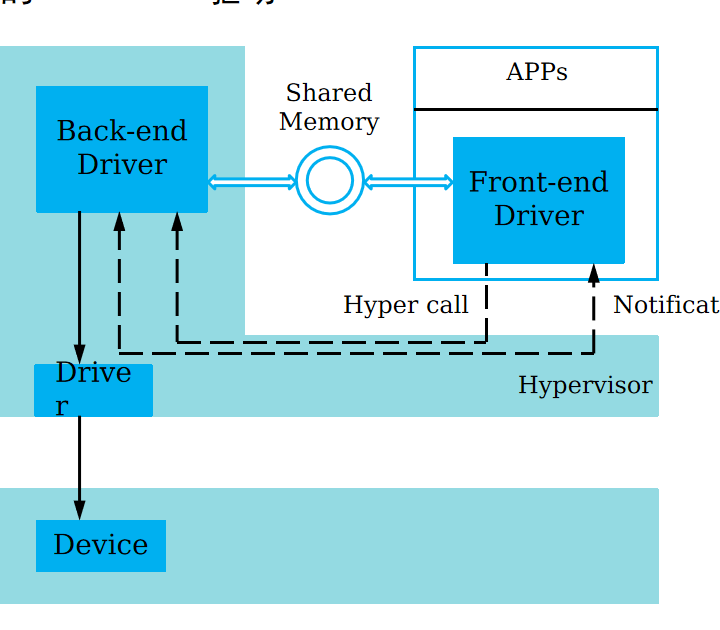
- 虚拟出特殊的设备
- 特殊的设备驱动,包括VM中的Front-end驱动和主机上的Back-end驱动
- Front-end和Back-end驱动之间的高效通信
- 减少VM和主机的数据传输开销
- 共享内存
- Batched I/O
- 异步事件通知Eventfd轻量级进程间“等待/通知”机制
[!tip]
Virtio半虚拟化设备方式的优点是实现了VIRTIO API,减少了VM-Exit次数,提高了客户机I/O执行效率,比普通模拟I/O的效率高很多;而其缺点是需要客户机中与Virtio相关驱动的支持(较老的系统默认没有自带这些驱动,Windows系统中需要额外安装Virtio驱动),因此兼容性较差,而且I/O频繁时的CPU使用率较高。
PCI设备直接分配
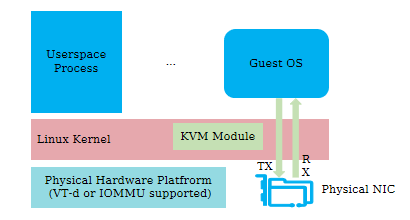
- KVM虚拟机支持将宿主机中的PCI、PCI-E设备附加到虚拟化的客户机中,从而让客户机以独占方式访问这个PCI(或PCI-E)设备。通过硬件支持的VT-d技术将设备分配给客户机后,在客户机看来,设备是物理上连接在其PCI(或PCI-E)总线上的,客户机对该设备的I/O交互操作和实际的物理设备操作完全一样,不需要(或者很少需要)Hypervisor的参与
[!tip]
设备直接分配让客户机完全占有PCI设备,这样在执行I/O操作时大量地减少甚至避免了VM-Exit陷入到Hypervisor中,极大地提高了I/O性能,可以达到几乎和Native系统中一样的性能。尽管virtio的性能也不错,但VT-d克服了其兼容性不够好和CPU使用率较高的问题。不过,VT-d也有自己的缺点,一台服务器主板上的空间比较有限,允许添加的PCI和PCI-E设备是有限的,如果一台宿主机上有较多数量的客户机,则很难向每台客户机都独立分配VT-d的设备。另外,大量使用VT-d独立分配设备给客户机,让硬件设备数量增加,这会增加硬件投资成本。
主流虚拟化技术介绍
Xen虚拟化简介
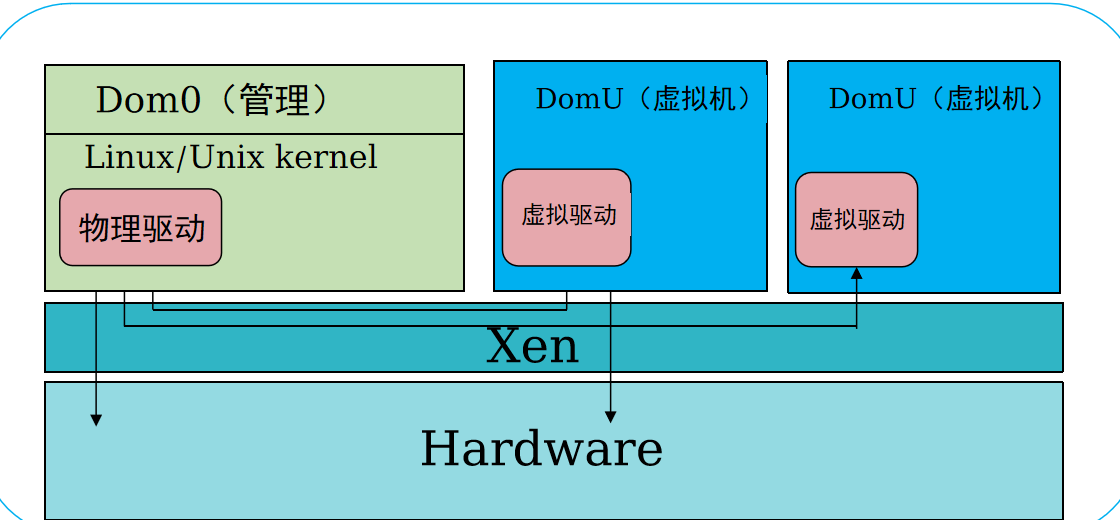
- Xen的Hypervisor是服务器经过BIOS启动之后载入的首个程序,然后启动一个具有特定权限的虚拟机,称之为Domain 0(简称Dom0)。Dom0的操作系统可以是Linux或Unix,Domain 0实现对Hypervisor控制和管理功能。在所承载的虚拟机中,Dom0是唯一可以直接访问物理硬件(如存储和网卡)的虚拟机,它通过本身加载的物理驱动,为其他虚拟机(Domain U,简称DomU)提供访问存储和网卡的桥梁
[!tip]
Xen最初是剑桥大学Xensource的一个开源研究项目,2003年9月发布了首个版本Xen 1.0,2007年Xensource被Citrix公司收购,开源Xen转由www.xen.org继续推进,该组织成员包括个人和公司(如 Citrix、Oracle等)。该组织在2011年3月发布了版本Xen 4.1。
相对于ESX和Hyper-V来说,Xen支持更广泛的CPU架构,前两者只支持CISC的x86/x86_64 CPU架构,Xen除此之外还支持RISC CPU架构,如IA64、ARM等。
Xen支持两种类型的虚拟机,一类是半虚拟化(PV,Paravirtualization),另一类是全虚拟化(Xen称其为HVM,Hardware Virtual Machine)。半虚拟化需要特定内核的操作系统,如基于Linux paravirt_ops(Linux内核的一套编译选项)框架的Linux内核,而Windows操作系统由于其封闭性则不能被Xen的半虚拟化所支持,Xen的半虚拟化有个特别之处就是不要求CPU具备硬件辅助虚拟化,这非常适用于2007年之前的旧服务器虚拟化改造。全虚拟化支持原生的操作系统,特别是针对Windows这类操作系统,Xen的全虚拟化要求CPU具备硬件辅助虚拟化,它修改的QEMU仿真所有硬件,包括:BIOS、IDE控制器、VGA显示卡、USB控制器和网卡等。为了提升I/O性能,全虚拟化特别针对磁盘和网卡采用半虚拟化设备来代替仿真设备,这些设备驱动称之为PV on HVM,为了使PV on HVM有最佳性能,CPU应具备MMU硬件辅助虚拟化。
Xen的Hypervisor层非常薄,少于15万行的代码量,不包含任何物理设备驱动,这一点与Hyper-V是非常类似的,物理设备的驱动均是驻留在Dom0中,可以重用现有的Linux设备驱动程序。因此,Xen对硬件兼容性也是非常广泛的,Linux支持的,它就支持。
KVM虚拟化简介
- KVM(Kernel-based Virtual Machine)是基于内核的虚拟机
- KVM本质是Linux内核中的虚拟化功能模块kvm.ko,利用Linux做大量的事,如任务调度、内存管理与硬件设备交互等
- KVM是开源软件,于2007年2月被集成到Linux 2.6.20内核中
- KVM中,虚拟机其实就是一个Linux进程,由CPU进行调度运行
- KVM运行在内核空间,提供CPU、内存的虚拟化,它本身不执行任何模拟。运行在用户空间的QEMU提供硬件I/O的虚拟化模拟
[!tip]
KVM的全称是Kernel-based Virtual Machine,字面意思是基于内核的虚拟机。其最初是由Qumranet公司开发的一个开源项目。2008年,Qumranet被RedHat所收购,但KVM本身仍是一个开源项目,由RedHat、IBM等厂商支持。
KVM之所以叫做基于内核的虚拟机,是因为KVM本身是一个Linux内核模块,当安装有Linux系统的物理机安装了这个模块后,就变成了Hypervisor,而且还不会影响原先在该Linux上运行的其它应用程序。
与Xen类似,KVM支持广泛的CPU架构,除了x86/x86_64 CPU架构之外,还将会支持大型机(S/390)、小型机(PowerPC、IA64)及ARM等。
KVM充分利用了CPU的硬件辅助虚拟化能力,并重用了Linux内核的诸多功能,使得KVM本身是非常瘦小的,KVM的创始者Avi Kivity声称KVM模块仅有约10000行代码,但我们不能认为KVM的Hypervisor就是这个代码量,因为从严格意义来说,KVM本身并不是Hypervisor,它仅是Linux内核中的一个可装载模块,其功能是将Linux内核转换成一个裸金属的Hypervisor。
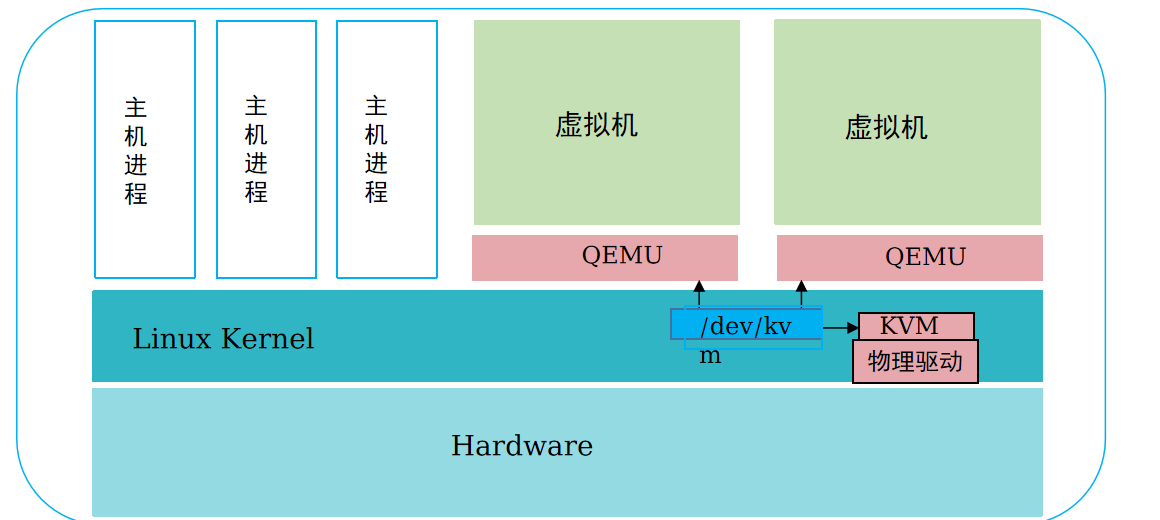
通过KVM模块的加载将Linux内核转变成Hypervisor,Linux本身运行于内核模式,主机进程运行于用户模式,虚拟机则运行于客户模式,使得转变后的Linux内核可以将主机进程和虚拟机进行统一的管理和调度,这也是KVM名称的由来。
KVM历史:
2006年10月,以色列公司Qumranet发布KVM;
2006年12月,KVM合入内核(Linux 2.6.20rc);
2007年2月,Linux 2.6.20正式版发布;
2008年9月,Redhat以1.07亿美元收购Qumranet;
2009年9月,RHEL 5.4开始支持KVM(同时支持Xen);
2010年11月,RHEL 6.0之后仅支持KVM。
Xen vs KVM
[!tip]
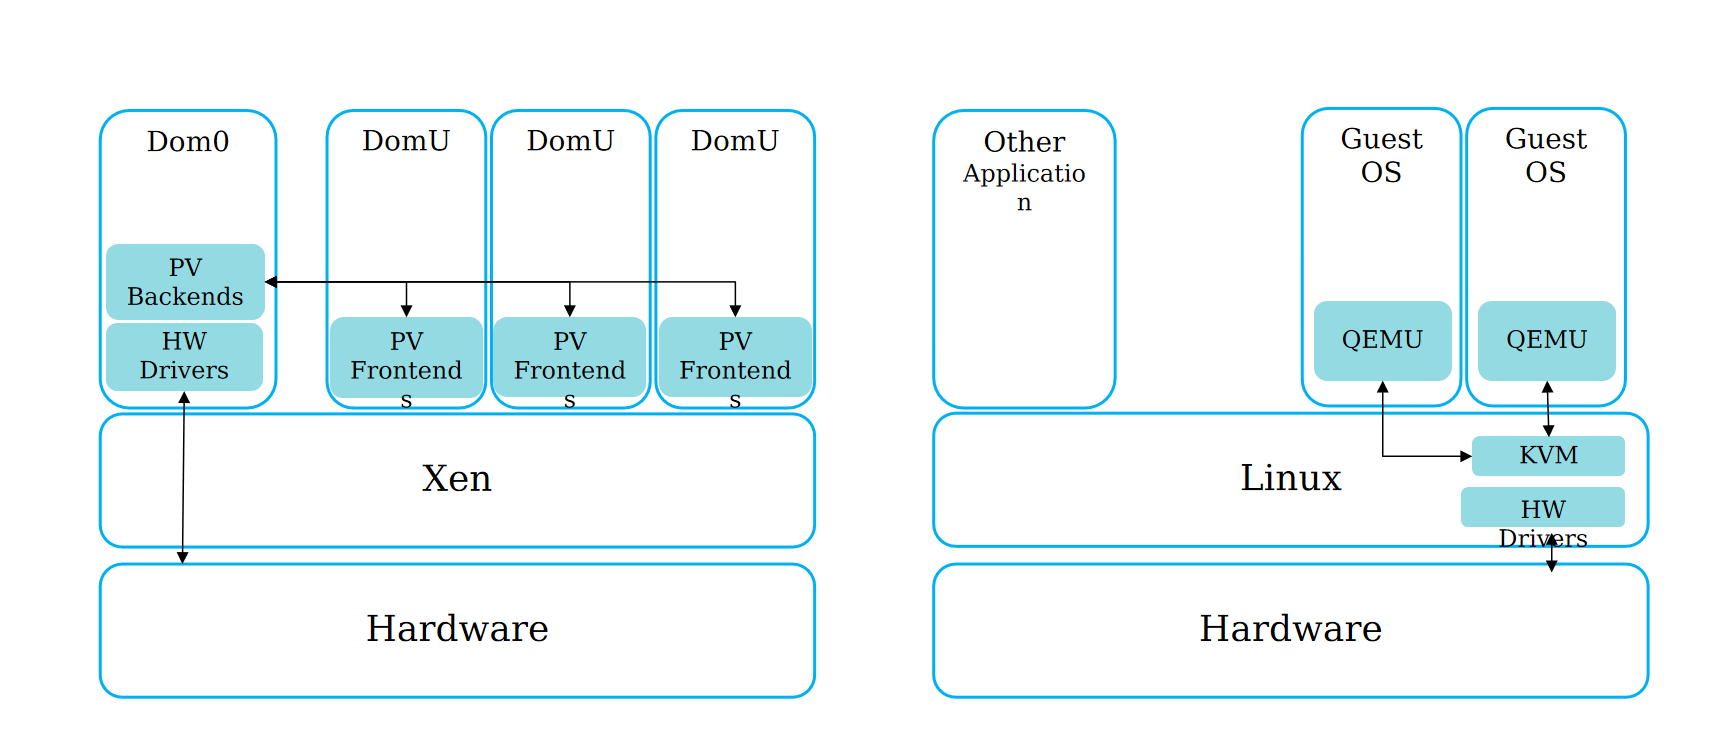
Xen平台架构侧重安全性:为保证安全性,各Domain对共享区域的访问和映射必须通过Hypervisor授权。
KVM平台架构侧重性能:VM之间以及与Host Kernel之间对共享区域的访问和映射无需Hypervisor进行授权,故整个访问路径较短。使用Linux Baremetal内核,无PVOPS性能损耗。KVM虚拟化的核心主要由以下两个模块组成:
1) KVM内核模块, 它属于标准Linux内核的一部分, 是一个专门提供虚拟化功能的模块, 主要负责CPU和内存的虚拟化, 包括: 客户机的创建、 虚拟内存的分配、 CPU执行模式的切换、 vCPU寄存器的访问、 vCPU的执行。
2) QEMU用户态工具, 它是一个普通的Linux进程, 为客户机提供设备模拟的功能,包括模拟BIOS、 PCI/PCIE总线、 磁盘、 网卡、 显卡、 声卡、 键盘、 鼠标等。 同时它通过ioctl系统调用与内核态的KVM模块进行交互。
KVM与QEMU
- 在KVM虚拟化方案中,KVM主要用于管理CPU和内存的虚拟化,IO设备的虚拟化则由QEMU来完成
- QEMU是一个纯软件实现的开源(模拟)软件,它能够模拟整套虚拟机的实现,包括CPU、内存、IO设备、USB、网卡等
[!tip]
KVM用来模拟CPU的运行,但缺少了对Network和I/O的支持。QEMU-KVM是一个完整的模拟器,它基于KVM上,提供了完整的I/O模拟支持。其中OpenStack为了跨VM性,所以不会直接控制QEMU-KVM,而是通过Libvirt的库去间接控制QEMU-KVM,后续我们会对Libvirt进行介绍。
KVM离不开QEMU。KVM实现初期,为了简化开发和代码重用,在QEMU基础上进行了修改,主要是将比较消耗CPU性能的CPU虚拟化和内存虚拟化部分移交到了内核中实现,保留IO虚拟化模块在用户空间实现。避免了用户态和内核态的频繁切换,优化使用性能。
QEMU离不开KVM。之前我们提到,QEMU是一个纯软件的实现,运行在用户空间,性能非常低下,所以从QEMU的角度可以说是QEMU使用了KVM的虚拟化功能,为自身虚拟机提供资源与加速。
/dev/kvm接口是QEMU和KVM交互的“桥梁”。/dev/kvm本身是一个设备文件,我们可以通过ioctl函数来对该文件进行控制和管理,从而完成用户空间与内核空间的数据交互。KVM与QEMU的通信过程主要就是一系列针对该设备文件的ioctl系统调用。
KVM工作原理
- KVM是Linux Kernel的一个模块, 运行在内核空间
- QEMU运行在用户空间,提供硬件I/O设备的虚拟化模拟
- Linux系统安装KVM模块后,会有如下三种运行模式:客户模式、用户模式、内核模式
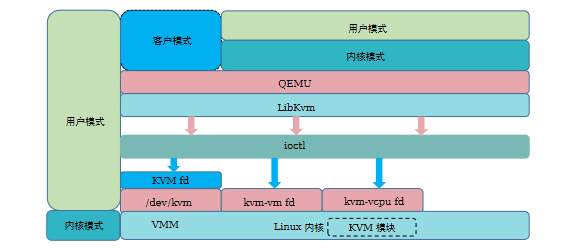
三种运行模式:
- 客户模式:执行虚拟机的非I/O代码
- 用户模式:QEMU运行,代表虚拟机执行I/O操作
- 内核模式:KVM运行,处理客户模式的退出,切换到客户模式
[!tip]
KVM基本结构如上图。KVM已经是内核模块,被看作是一个标准Linux字符集设备(/dev/kvm)。QEMU通过Libkvm应用程序接口,用fd(文件描述符)通过ioctl向设备驱动来发送创建、运行虚拟机命令。设备驱动KVM会解析命令。
KVM模块让Linux主机成为了一个虚拟机监视器(VMM),在原有执行模式基础上,增加了客户模式。在虚拟机运行时,三种模式的工作为:
客户模式:执行非I/O的客户代码,虚拟机运行在这个模式下。
用户模式:代表用户执行I/O指令,QEMU运行在这个模式下,它用来为虚拟机模拟执行I/O类的操作请求。
内核模式:实现客户模式切换,处理因I/O或者其他指令引起的从客户模式退出动作(VM-Exit)。KVM模块工作在这个模式下。此模式下可以真正操作硬件,当Guest OS执行I/O类操作或特权指令操作时,需要向用户模式提交请求,然后由用户模式再次发起硬件操作请求给内核模式,从而真正操作硬件。
KVM工作原理(扩展)
[!tip]
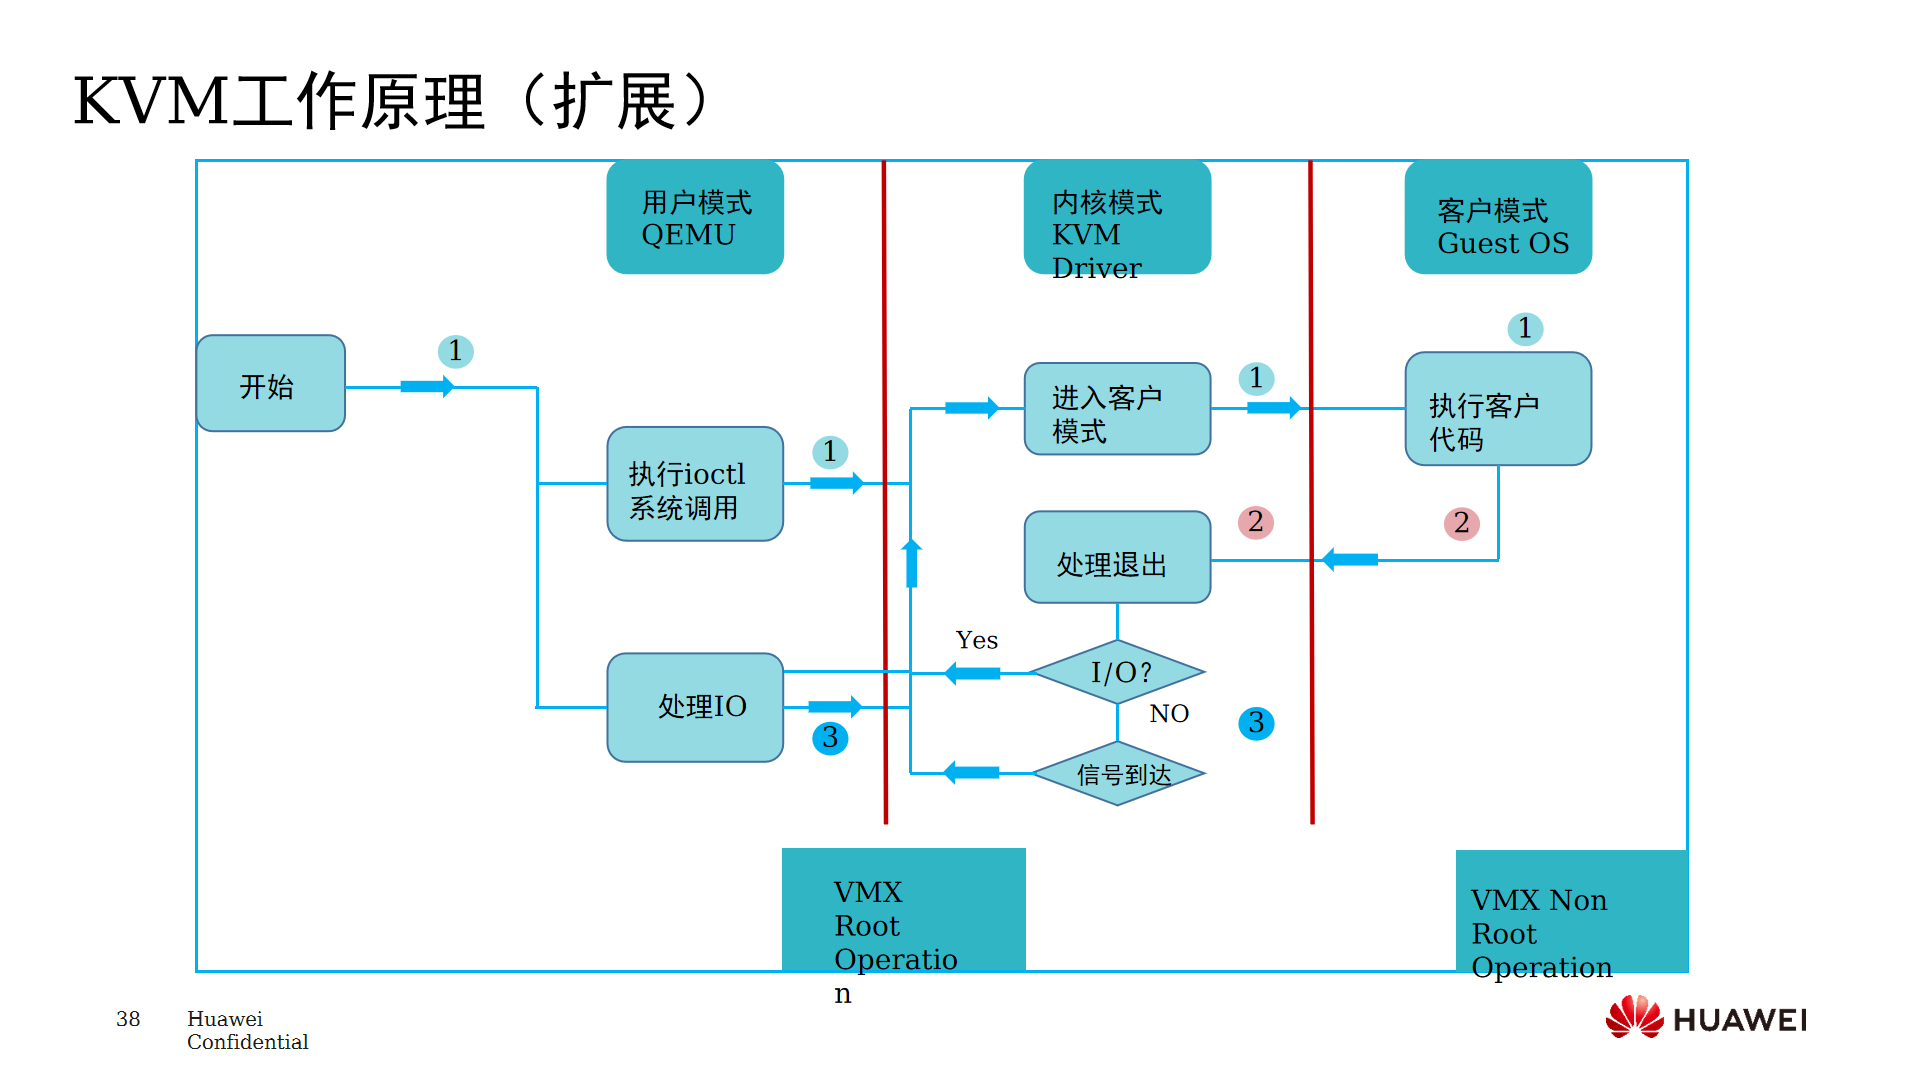
用户模式的QEMU利用Libkvm通过ioctl进入内核模式,KVM模块为虚拟机创建虚拟内存、虚拟CPU后,执行VMLAUCH指令进入客户模式,加载Guest OS并执行。
如果Guest OS发生外部中断或影子页表缺失等情况,会暂停Guest OS(客户模式)的执行,退出客户模式到内核模式执行异常处理,之后重新进入客户模式,执行客户代码。
如果发生I/O事件或者信号队列中有信号到达,就会进入用户模式(QEMU)进行处理,执行模拟。在普通的Linux系统中, 进程一般有两种执行模式: 内核模式和用户模式。 而在KVM环境中, 增加了第3种模式: 客户模式。 vCPU在3种执行模式下的不同分工如下。
(1) 用户模式(User Mode)
主要处理I/O的模拟和管理, 由QEMU的代码实现。
(2) 内核模式(Kernel Mode)
主要处理特别需要高性能和安全相关的指令, 如处理客户模式到内核模式的转换, 处理客户模式下的I/O指令或其他特权指令引起的退出(VM-Exit) , 处理影子内存管理(shadow MMU) 。
(3) 客户模式(Guest Mode)
主要执行Guest中的大部分指令, I/O和一些特权指令除外(它们会引起VM-Exit, 被Hypervisor截获并模拟) 。
虚拟化平台管理工具 - Libvirt
- Libvirt是一套由C语言开发的API,主要目标是提供一种通用并且稳定的软件层,来管理物理主机上多种不同的虚拟化方式和虚拟主机,并支持远程管理
- Libvirt是Linux上的虚拟化库,Libvirt也是一个开源项目,它是一个非常强大的虚拟化平台管理工具,被管理的虚拟化平台可以是KVM,也可以是Xen、VMware以及Hyper-V等
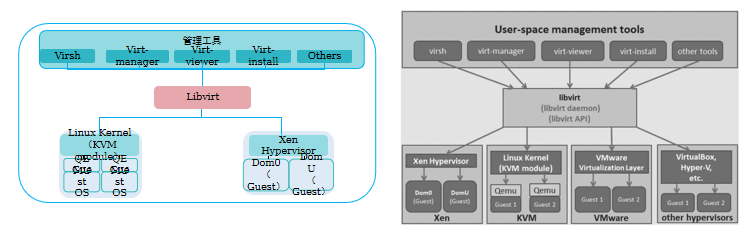
virsh:命令行管理工具virt-manager:图形化管理工具virt-viewer:虚拟机查看器virt-install:虚拟机安装工具
[!tip]
虚拟化领域针对不同的场景提出了很多虚拟化解决方案(KVM、Xen等),为了支持更多厂商以及更多领域,很多IaaS解决方案需要融合多种虚拟化技术,在这个需求背景下,Libvirt就为用户提供了一个平台类的管理工具 ,同时支持多种虚拟化方案。
Libvirt是为了更方便地管理平台虚拟化技术而设计的开放源代码的应用程序接口、守护进程和管理工具,它不仅提供了对虚拟化客户机的管理,也提供了对虚拟化网络和存储的管理。
Libvirt对多种不同的Hypervisor的支持是通过一种基于驱动程序的架构来实现的。Libvirt对不同的Hypervisor提供了不同的驱动:对Xen有Xen的驱动,对QEMU/KVM有QEMU驱动。
Libvirt作为中间适配层,让底层Hypervisor对上层用户空间的管理工具做到完全透明,因为Libvirt屏蔽了底层各种Hypervisor的细节,为上层管理工具提供了一个统一的、较稳定的接口(API)。1.libvirt
libvirt是使用最广泛的对KVM虚拟化进行管理的工具和应用程序接口, 已经是事实上的虚拟化接口标准, 本节后部分介绍的其他工具都是基于libvirt的API来实现的。 作为通用的虚拟化API, libvirt不但能管理KVM, 还能管理VMware、 Hyper-V、 Xen、 VirtualBox等其他虚拟化方案。
2.virsh
virsh是一个常用的管理KVM虚拟化的命令行工具, 对于系统管理员在单个宿主机上进行运维操作, virsh命令行可能是最佳选择。 virsh是用C语言编写的一个使用libvirt API的虚拟化管理工具, 其源代码也是在libvirt这个开源项目中的。
3.virt-manager
virt-manager是专门针对虚拟机的图形化管理软件, 底层与虚拟化交互的部分仍然是调用libvirt API来操作的。 virt-manager除了提供虚拟机生命周期(包括: 创建、 启动、 停止、 打快照、 动态迁移等) 管理的基本功能, 还提供性能和资源使用率的监控, 同时内置了VNC和SPICE客户端, 方便图形化连接到虚拟客户机中。 virt-manager在RHEL、CentOS、 Fedora等操作系统上是非常流行的虚拟化管理软件, 在管理的机器数量规模较小时, virt-manager是很好的选择。 因其图形化操作的易用性, 成为新手入门学习虚拟化操作的首选管理软件。
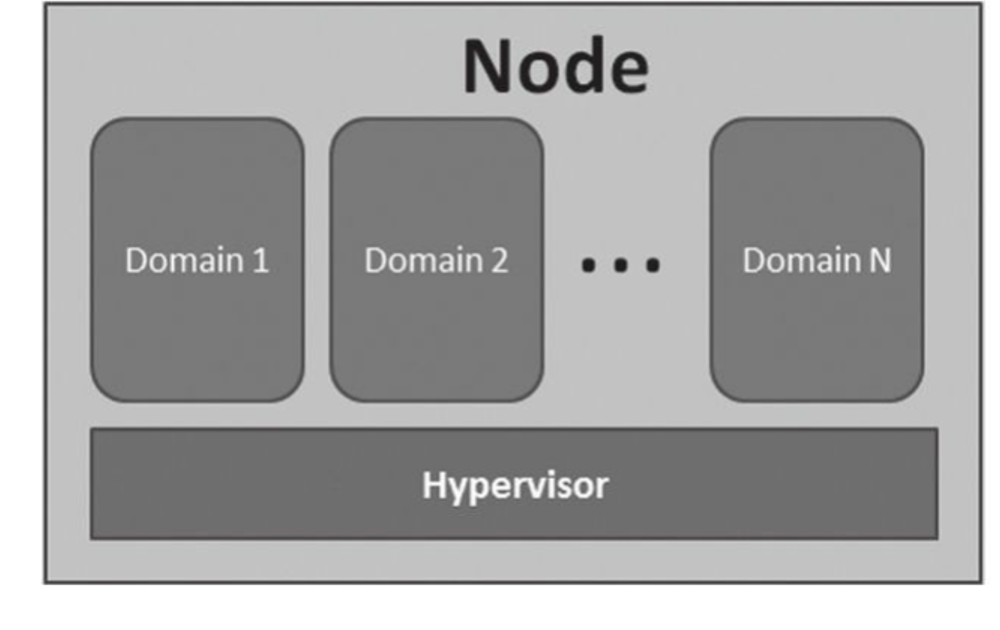
节点、Hypervisor和域之间的关系
[!tip]
在libvirt中涉及几个重要的概念, 解释如下:
·节点(Node) 是一个物理机器, 上面可能运行着多个虚拟客户机。 Hypervisor和Domain都运行在节点上。
·Hypervisor也称虚拟机监控器(VMM) , 如KVM、 Xen、 VMware、 Hyper-V等, 是虚拟化中的一个底层软件层, 它可以虚拟化一个节点让其运行多个虚拟客户机(不同客户机可能有不同的配置和操作系统) 。
·域(Domain) 是在Hypervisor上运行的一个客户机操作系统实例。 域也被称为实例(instance, 如在亚马逊的AWS云计算服务中客户机就被称为实例) 、 客户机操作系统(guest OS) 、 虚拟机(virtual machine) , 它们都是指同一个概念。
为新手入门学习虚拟化操作的首选管理软件。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)