
【人工智能每日精选】会发光的 AI 芯片:我看到的多任务学习新路线
AI 想要更快、更省电,不能只盯着模型结构,硬件本身也要变得更像大脑。
现在很多 AI 系统已经能同时做多件事,比如识别人脸、估计年龄、重建图像。但这些任务通常会被拆成多个模型、多个训练流程,或者在 GPU 上反复搬运数据。真正耗电的地方,往往不只是乘加计算,而是数据在存储器和计算单元之间来回移动。
我看到的关键转变是:如果一个硬件单元本身就能同时输出两种可训练信号,多任务学习就不必完全依赖软件调度。器件可以直接参与学习。
一,一个输入,两种输出
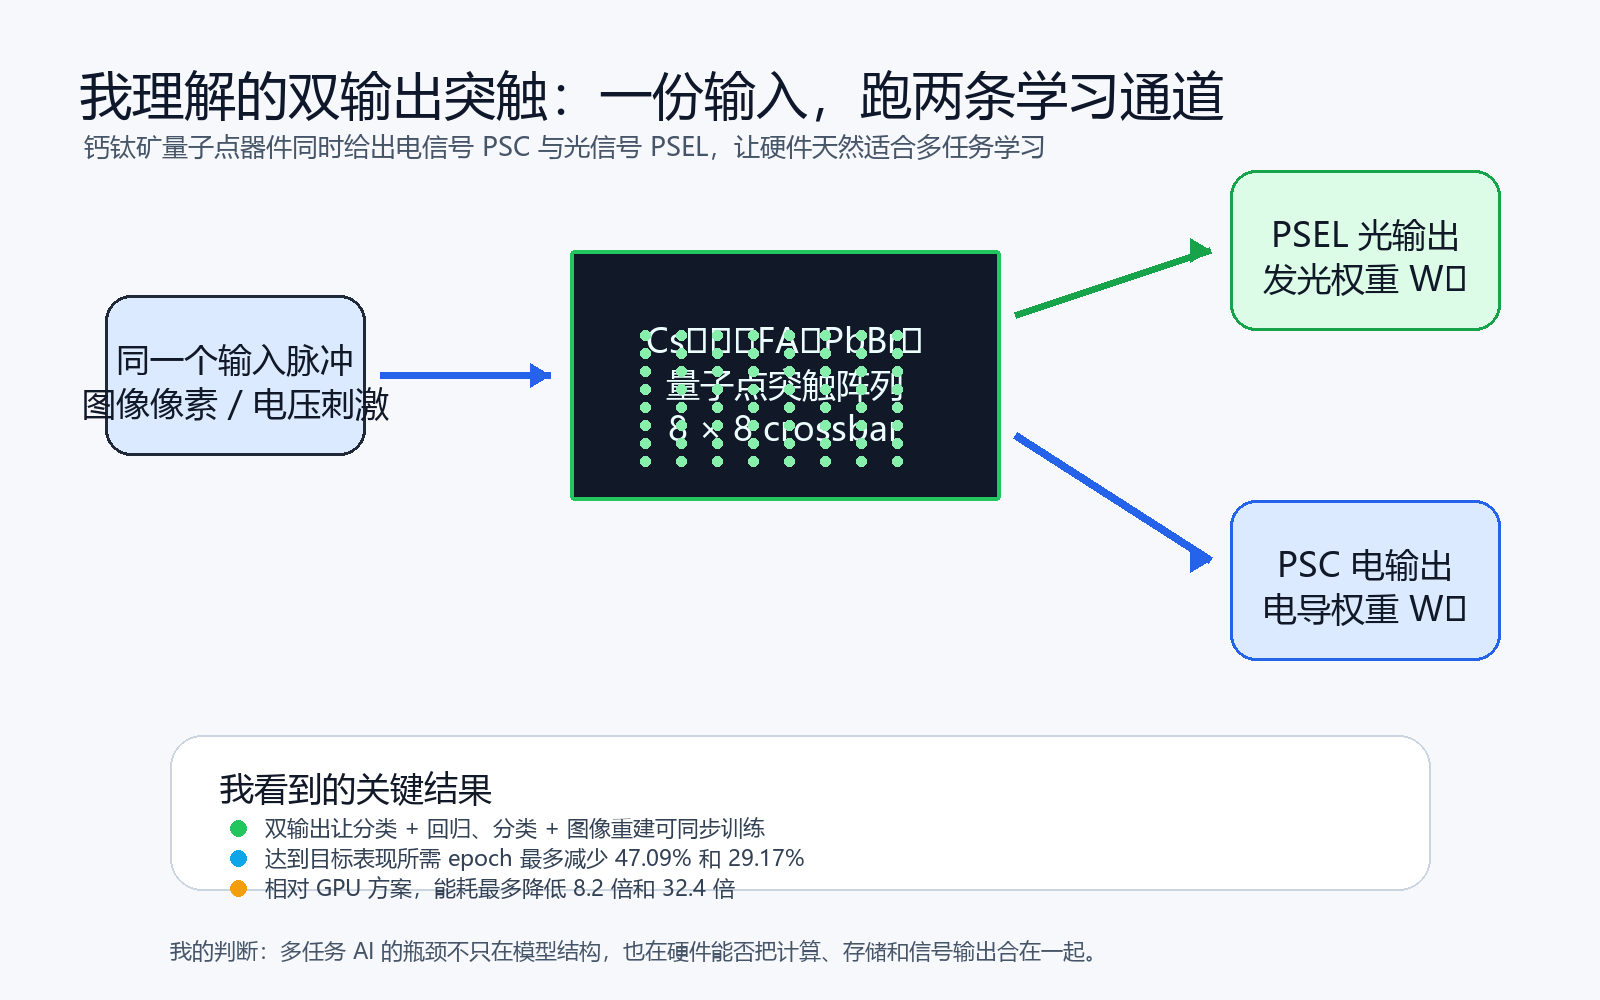
核心器件是基于 Cs₁₋ₓFAₓPbBr₃ 钙钛矿量子点的 8 × 8 交叉阵列。它最有意思的地方不是“能存储权重”这么简单,而是同一个输入脉冲进去后,可以同时产生两类突触响应:
- PSC:postsynaptic current,电流型突触输出;
- PSEL:postsynaptic electroluminescence,电致发光型突触输出。
我把它理解成一个“会发光的人工突触”。传统突触器件多半只给出电信号,而这里多了一条光信号通道。电流可以作为一组权重,发光也可以作为另一组权重。于是,一个物理节点不再只是单通道存储单元,而更像一个双通道学习单元。
这对多任务学习很重要。因为多任务学习的本质不是简单把两个任务堆在一起,而是让它们共享一部分表征,同时保留各自的输出目标。双输出器件恰好给了硬件层面的共享与分流能力。
二,为什么钙钛矿量子点适合做这件事?
我关注到一个细节:FA 掺杂浓度 x 可以在 0.00 到 0.15 之间调节。随着 FA 成分变化,材料的能带、离子迁移和电致发光行为都会改变。也就是说,器件的“可塑性”不是纯粹靠外部电路硬凑出来的,而是材料自身就提供了可调空间。
实验里,这个阵列表现出几类类脑特征:
- 成对脉冲易化 PPF;
- 长时程增强 LTP;
- 长时程抑制 LTD;
- 约 1000 个独立可调状态;
- 电信号 PSC 与光信号 PSEL 的同步更新趋势。
这让我觉得它不像普通存储器那样只是“记住一个数”,而是在材料层面模拟了“学习 - 记忆 - 遗忘”的动态过程。
三,多任务学习怎么跑起来?
任务设计来自人脸图像数据。输入是一张脸,系统需要完成不同目标:
1. 年龄回归;
2. 种族分类;
3. 图像重建。
其中两组多任务组合最关键:
- 分类 + 回归;
- 分类 + 图像重建。
我喜欢这个设计,因为它不是只验证一个单点指标,而是在考察多任务之间是否真的能互相借力。分类任务偏向提取高层语义特征,重建任务偏向保留低层像素细节,回归任务则要求模型对连续变化更敏感。三类目标放在一起,能比较好地检验硬件是否只是“能跑”,还是“能协同学习”。
四,速度提升来自哪里?
最直观的数据是训练轮次减少。
在分类 + 回归任务中,多任务 CNN 在 100 个 epoch 左右就能同时达到年龄预测 R² 约 0.749、分类准确率约 85%。如果按组合式单任务流程,需要 189 个 epoch 才能达到类似水平。
在分类 + 图像重建任务中,多任务 ResNet-15 在 119 个 epoch 达到分类准确率约 84.9%、SSIM 约 0.9;组合式单任务流程需要 168 个 epoch。
换算下来,达到目标表现所需训练轮次最多减少:
- 分类 + 回归:47.09%;
- 分类 + 图像重建:29.17%。
我会把这里的“加速”理解成两层:一是任务共享表示后,学习路径更短;二是双输出硬件让两个任务不必完全串行地使用同一种信号通道。
五,省电才是更大的看点
如果只看速度,这还不够震撼。真正让我觉得有价值的是能耗。
和 GPU 硬件加速器相比,这种双输出器件方案在向量矩阵乘法相关能耗上有明显优势:
- 分类 + 回归任务:最多降低 8.2 倍;
- 分类 + 图像重建任务:最多降低 32.4 倍。
另外,在权重更新能耗上,多任务学习也比组合式单任务更低:分类 + 回归约降低 2 倍,分类 + 图像重建约降低 1.4 倍。
这背后的逻辑很朴素:传统计算架构里,数据移动非常贵;而类脑硬件把存储和计算放得更近,甚至让器件状态本身承载权重更新。少搬数据,就少耗电。
六,我的极简理解框架
```python
input_pulse = face_image_to_voltage(image)
psc_weight = synapse.electrical_output(input_pulse) # 电流通道
psel_weight = synapse.optical_output(input_pulse) # 发光通道
loss = 0.7 * task_loss_a(psc_weight) + 0.3 * task_loss_b(psel_weight)
synapse.update(loss)
```
这段伪代码不是器件级实现,只是帮助理解:同一份输入被映射到电流和光两条路径,两条路径共同参与多任务损失优化。
七,我看到的边界
我也不会把它理解成“GPU 很快会被替代”。这里的结果更多是在说明一种可能路线:让神经网络硬件从单输出、单任务、强数据搬运,走向双输出、多任务、低能耗协同。
真正落地还要面对很多问题,比如大规模阵列一致性、外围电路能耗、器件寿命、制造稳定性,以及复杂任务上能否保持精度。尤其是这里的能耗比较主要聚焦特定计算和更新环节,工程系统的整体能耗还需要进一步验证。
但即便如此,我仍然觉得方向很清晰:未来 AI 的效率竞争,不只是“谁的模型参数更少”,也不是“谁的 GPU 更强”,而是软硬件能不能一起设计。
八,我的结论
我最喜欢这个方向的一点,是它把“多任务学习”从算法概念推进到了器件层面。
一个会同时输出电信号和光信号的突触阵列,让我看到了一种更接近大脑的计算方式:同一个输入,不必只服务一个任务;同一个器件,也不必只承担一种权重。
如果说过去 AI 硬件追求的是更快地算,那么这类发光突触器件给我的启发是:下一代 AI 硬件也许要学会更聪明地“同时算”。
参考资料:Park and Wang, Sci. Adv. 12, eady8518 (2026)
更多推荐



 7
 0
- 0


 已为社区贡献6条内容

所有评论(0)