
05-【2027毕设】YOLO11动物检测识别系统 - Python完整源码+PyQt5界面+训练模型+数据集
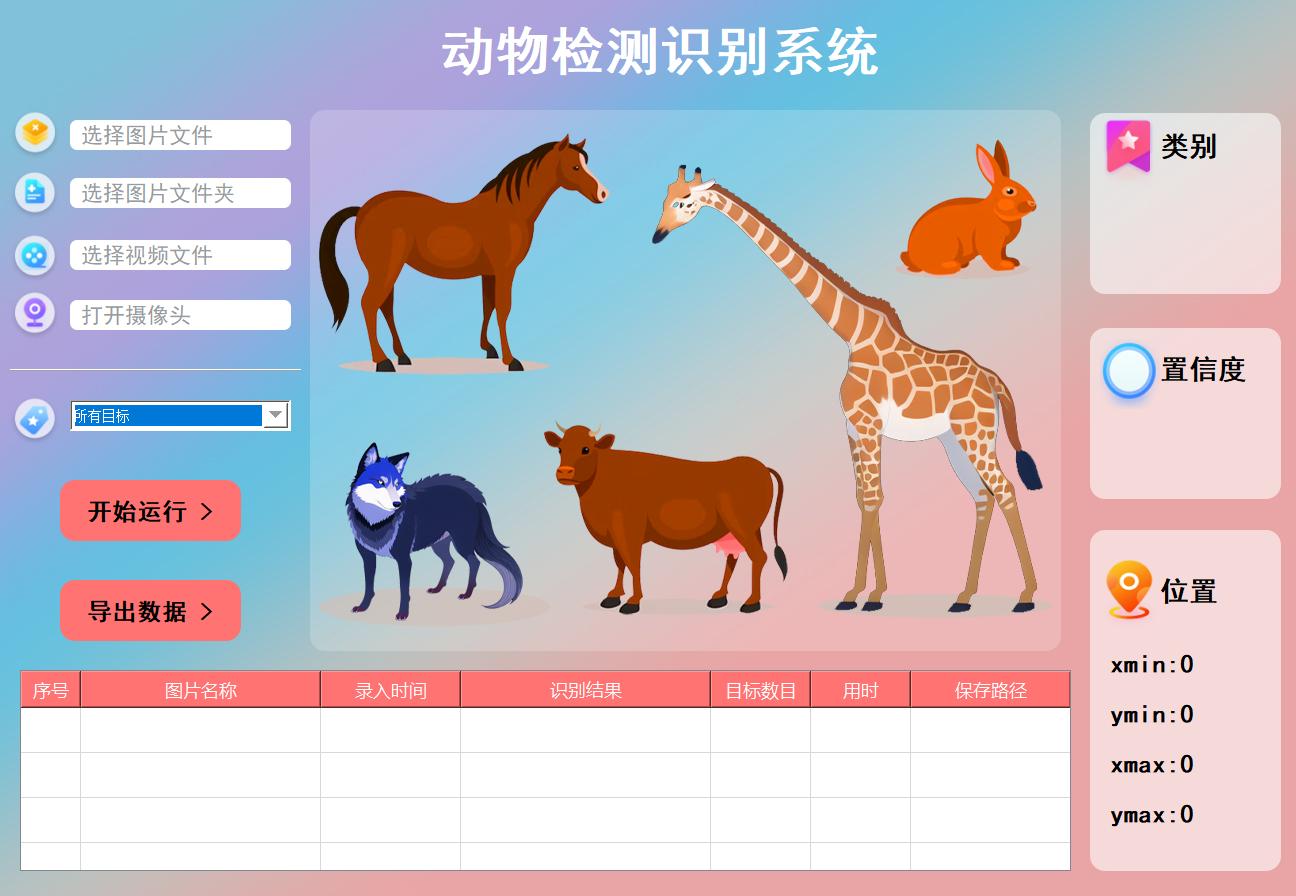

📌 项目概览
本项目基于深度学习框架,实现了一套完整的检测识别系统。系统集成了多种主流YOLO算法版本,配合PyQt5构建的可视化交互界面,提供了从数据标注、模型训练到在线推理的全流程解决方案。以下是项目的核心技术栈和资源构成:
| 项目组成 | 说明 |
|---|---|
| 算法引擎 | yolo26 / yolo11 / yolo12 / yolov8 / yolov5(含各版本 + SE注意力机制改进版) |
| 预训练模型 | 每种算法均提供两个已训练好的权重文件,无需GPU即可直接使用 |
| 数据集 | 已整理为YOLO标准格式(train/val/test),标注文件可直接加载 |
| GUI框架 | PyQt5,跨平台桌面应用,操作直观易上手 |
💡 创新点提示:各算法版本均支持添加 SE注意力机制,可在模型结构中嵌入该模块以提升特征提取的聚焦能力,适合作为毕业设计的创新亮点。
本文目录
🎯 一、系统功能演示
本系统围绕实用场景设计,涵盖以下核心功能模块:
- 🔍 单张图片检测 — 上传任意图片即刻返回检测结果
- 📁 文件夹批量检测 — 支持遍历整个文件夹进行自动化识别
- 🎬 视频流检测 — 对本地视频文件逐帧分析并标注
- 📹 摄像头实时检测 — 接入USB摄像头实现实时推理展示
- 📊 结果导出 — 支持将检测数据导出为xls表格格式
- 🔄 目标筛选查看 — 可切换查看已检测到的各类目标
完整的功能演示和环境配置讲解,请参考下方视频资源。视频内容覆盖了安装部署、模型训练、结果评估及常见问题解答。
05-基于YOLO12的动物检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络
05-基于深度学习的动物检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)
05-基于深度学习的动物检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)
05-基于深度学习的动物检测系统(yolov5)(附赠任务书、开题报告模板课程)
📊 二、数据集说明
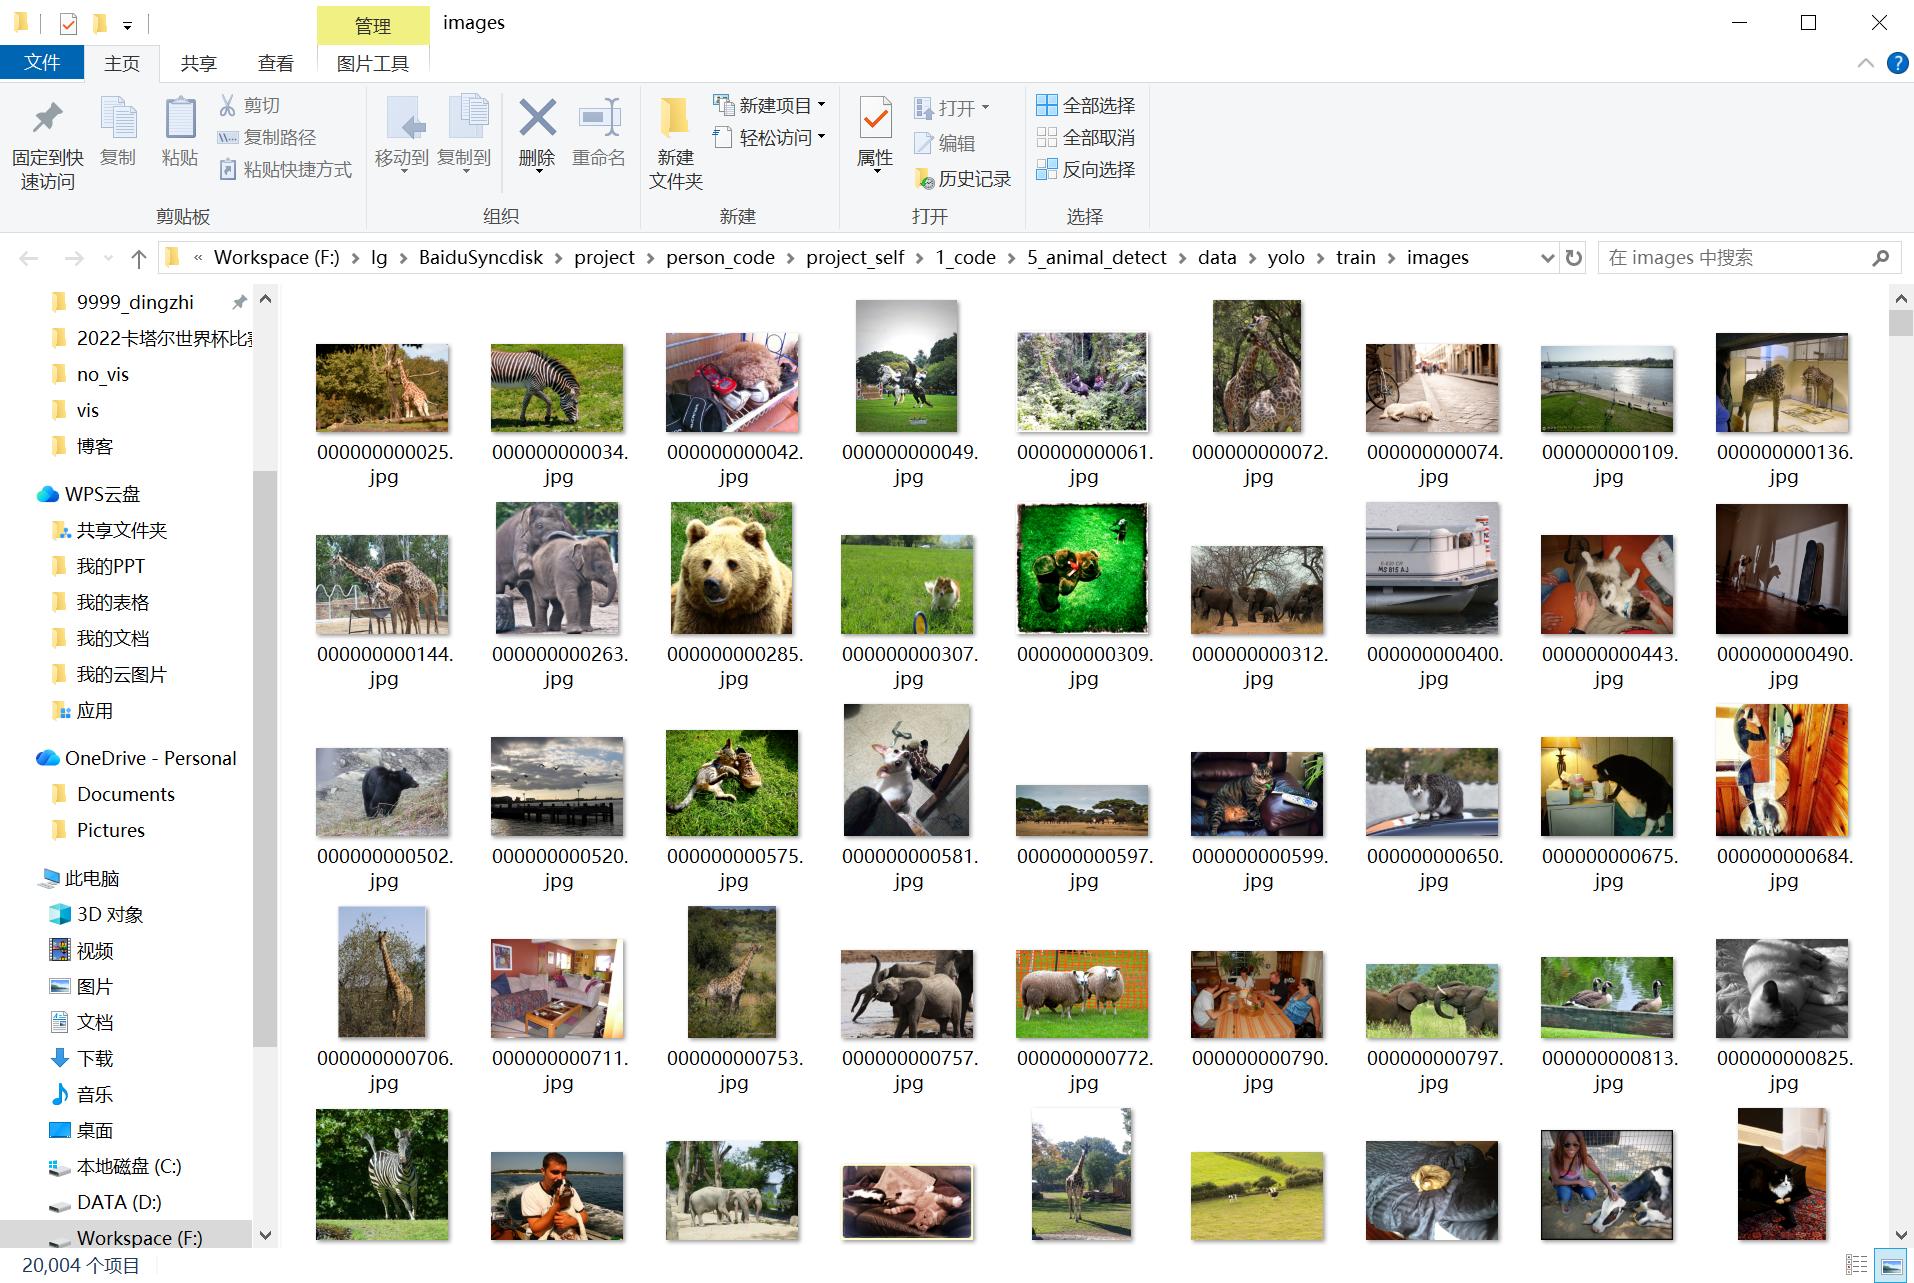
本项目使用的数据集已按照YOLO规范完成整理,包含 train、val、test 三个子目录,标注格式为YOLO标准txt格式,可直接用于训练和评估,无需额外转换。
🔬 三、核心算法详解
本项目提供多版本算法实现,涵盖从经典到前沿的多种检测方案,用户可根据需求灵活选择。各版本算法均经过完整测试验证,保证了检测精度与推理效率的平衡。
算法版本概览:
- 各算法版本经充分测试优化,在不同场景下均具备稳定的检测性能
- 界面版本支持简约风格与专业风格切换,适配不同使用场景
- 系统架构支持实时扩展,可方便地集成新算法模块或界面风格
以下逐一介绍各算法的核心原理与架构特色。
1. YOLOv8 算法原理
YOLOv8作为当前目标检测领域的SOTA级算法框架,在继承前代技术积累的基础上进行了结构性革新。其设计核心体现在三个层面:
架构创新: 采用全新设计的骨干网络与Anchor-Free无锚框检测头,摒弃了传统锚框依赖机制,通过解耦检测头直接回归目标位置与尺寸,显著提升了模型对不同尺度目标的适应能力。
训练优化: 引入重构的损失函数体系,结合TaskAlignedAssigner策略,使训练收敛过程更加平滑高效。同时支持CPU与GPU双平台推理,在资源受限环境下仍能保持高效推理速度。
框架定位: ultralytics团队将该项目定位为通用视觉算法平台,而非单一YOLO版本迭代。其设计目标覆盖目标检测、实例分割、图像分类、姿态估计等多类任务,可扩展性远超传统框架。未来规划不仅支持YOLO系列演进,还将引入非YOLO类模型,构建更广泛的算法生态。

YOLOv8网络结构图:

2. YOLOv5 算法原理
YOLOv5提供n/s/m/l/x五个尺寸梯度版本,通过depth_multiple与width_multiple参数控制网络深度与宽度。各版本结构框架一致,仅在规模上递进——如同衣物尺码排序,YOLOv5n最为轻量,YOLOv5x最为庞大。实际应用中YOLOv5s是最常用的平衡版本。

核心设计思路: YOLOv5将目标检测问题转化为端到端的回归任务。图像经骨干网络提取特征后,检测头直接输出边界框坐标(x, y, w, h)、置信度与类别概率,每个框编码为维度(C+5)的向量。
特征提取网络: 采用CSPNet结构,将特征图分两路并行处理——一路经卷积层深化提取,一路直接下采样——最终融合两路特征。这种设计增强了非线性表达能力,有利于应对复杂背景与多类别目标。

损失函数设计: 训练阶段采用复合损失函数,整合定位损失、置信度损失和分类损失三部分。辅以Focal Loss缓解正负样本不平衡,IoU Loss优化边界框回归精度,有效提升了小目标与重叠目标的检测表现。
网络四大组件:
| 模块 | 功能 |
|---|---|
| Input | 数据输入,采用Mosaic增强拼接四张图提升泛化 |
| Backbone | 特征提取核心,引入Focus结构将WH信息转入通道空间 |
| Neck | 多尺度特征融合,FPN+PAN双路径聚合 |
| Prediction | 解耦检测头,输出框坐标+置信度+类别概率 |
3. YOLO11 算法原理
YOLO11是Ultralytics团队推出的新一代目标检测框架,在骨干网络和颈部架构上进行了关键改进,特征提取精度和复杂任务表现均有显著提升。
核心改进要点:
- 架构精简高效:YOLO11m在COCO数据集上达到更高mAP,参数量却比YOLOv8m减少22%,实现了精度与效率的最佳平衡
- C3K2模块:将C2F模块中的Bottleneck替换为C3结构,当c3k参数为True时开启深度特征提取,为False时退化为C2F,兼顾灵活性与性能
- C2PSA注意力:在C2f模块中嵌入PSA点注意力机制,强化模型对关键特征区域的聚焦能力
- 检测头优化:引入YOLOv10的深度可分离思想,减少冗余计算,推理更高效

YOLO11网络结构变更图:

C3K2模块结构:

C2PSA模块结构:

🚀 部署灵活性:YOLO11支持边缘设备、云平台及NVIDIA GPU环境,覆盖检测/分割/分类/姿态估计/OBB定向检测等多样任务,是当前最全能的视觉推理框架之一。
4. PyQt5 界面框架
PyQt5是基于Qt C++库的Python GUI开发框架,提供完整的跨平台桌面应用构建能力。
| 特性 | 说明 |
|---|---|
| 跨平台 | 支持Windows/macOS/Linux多操作系统部署 |
| 组件丰富 | 窗口、按钮、表格、文本框等全覆盖,拖拽与代码布局双模式 |
| 交互机制 | 事件驱动 + 信号与槽,响应灵活可扩展 |
| 开发友好 | Python语法简洁 + Qt功能强大,入门与深度开发兼顾 |
⚙️ 四、模型训练指南
项目提供了完整的模型训练流程,可在本地环境独立训练模型。
Step 1 — 用PyCharm打开项目代码,定位 train.py 文件:
Step 2 — 修改 model_yaml 参数:
- 训练YOLOv8s → 设为
model_yaml = yaml_yolov8s - 训练SE注意力改进版 → 设为
model_yaml = yaml_yolov8_SE
Step 3 — 修改 data_path 数据集路径。默认指定 traindata.yaml,使用项目自带数据集则无需修改。
Step 4 — 调整 model.train() 训练参数:
model.train(data=data_path,             # 数据集配置
            imgsz=640,                  # 输入图片尺寸
            epochs=200,                 # 训练轮次
            batch=2,                    # 批次大小
            workers=0,                  # 数据加载线程
            device='0',                 # GPU编号
            optimizer='SGD',            # 优化器
            project='runs/train',       # 输出目录
            name=name,                  # 实验命名
            )
Step 5 — 修改 traindata.yaml 数据集配置文件:
只需修改 path 值指向数据集根目录(yolo 文件夹层级),其余参数保持不变,然后执行 train.py。
Step 6 — 运行 train.py,右键执行启动训练:
Step 7 — 训练启动后终端输出如下:
Step 8 — 训练完成后模型权重保存在 runs/train/ 目录:
📈 五、模型评估指南
Step 1 — 打开 val.py 评估脚本:
Step 2 — 修改 model_pt 为待评估模型路径。
Step 3 — 修改 data_path 数据集路径(参照训练步骤修改方法)。
Step 4 — 调整 model.val() 评估参数:
model.val(data=data_path,           # 数据集配置
          imgsz=300,                # 图片尺寸(需与训练一致)
          batch=4,                  # 推理批次
          workers=0,                # 加载线程数
          conf=0.001,               # 置信度阈值
          iou=0.6,                  # NMS IoU阈值
          device='0',               # GPU编号
          project='runs/val',       # 输出目录
          name='exp',               # 实验命名
          )
Step 5 — 执行后出现评估进度界面(以下为示例,具体以实际项目为准):
Step 6 — 评估结果保存在 runs/val/exp... 目录下:
📊 六、训练结果分析
每次训练结束后,runs/train 目录下会生成完整的评估指标文件集:
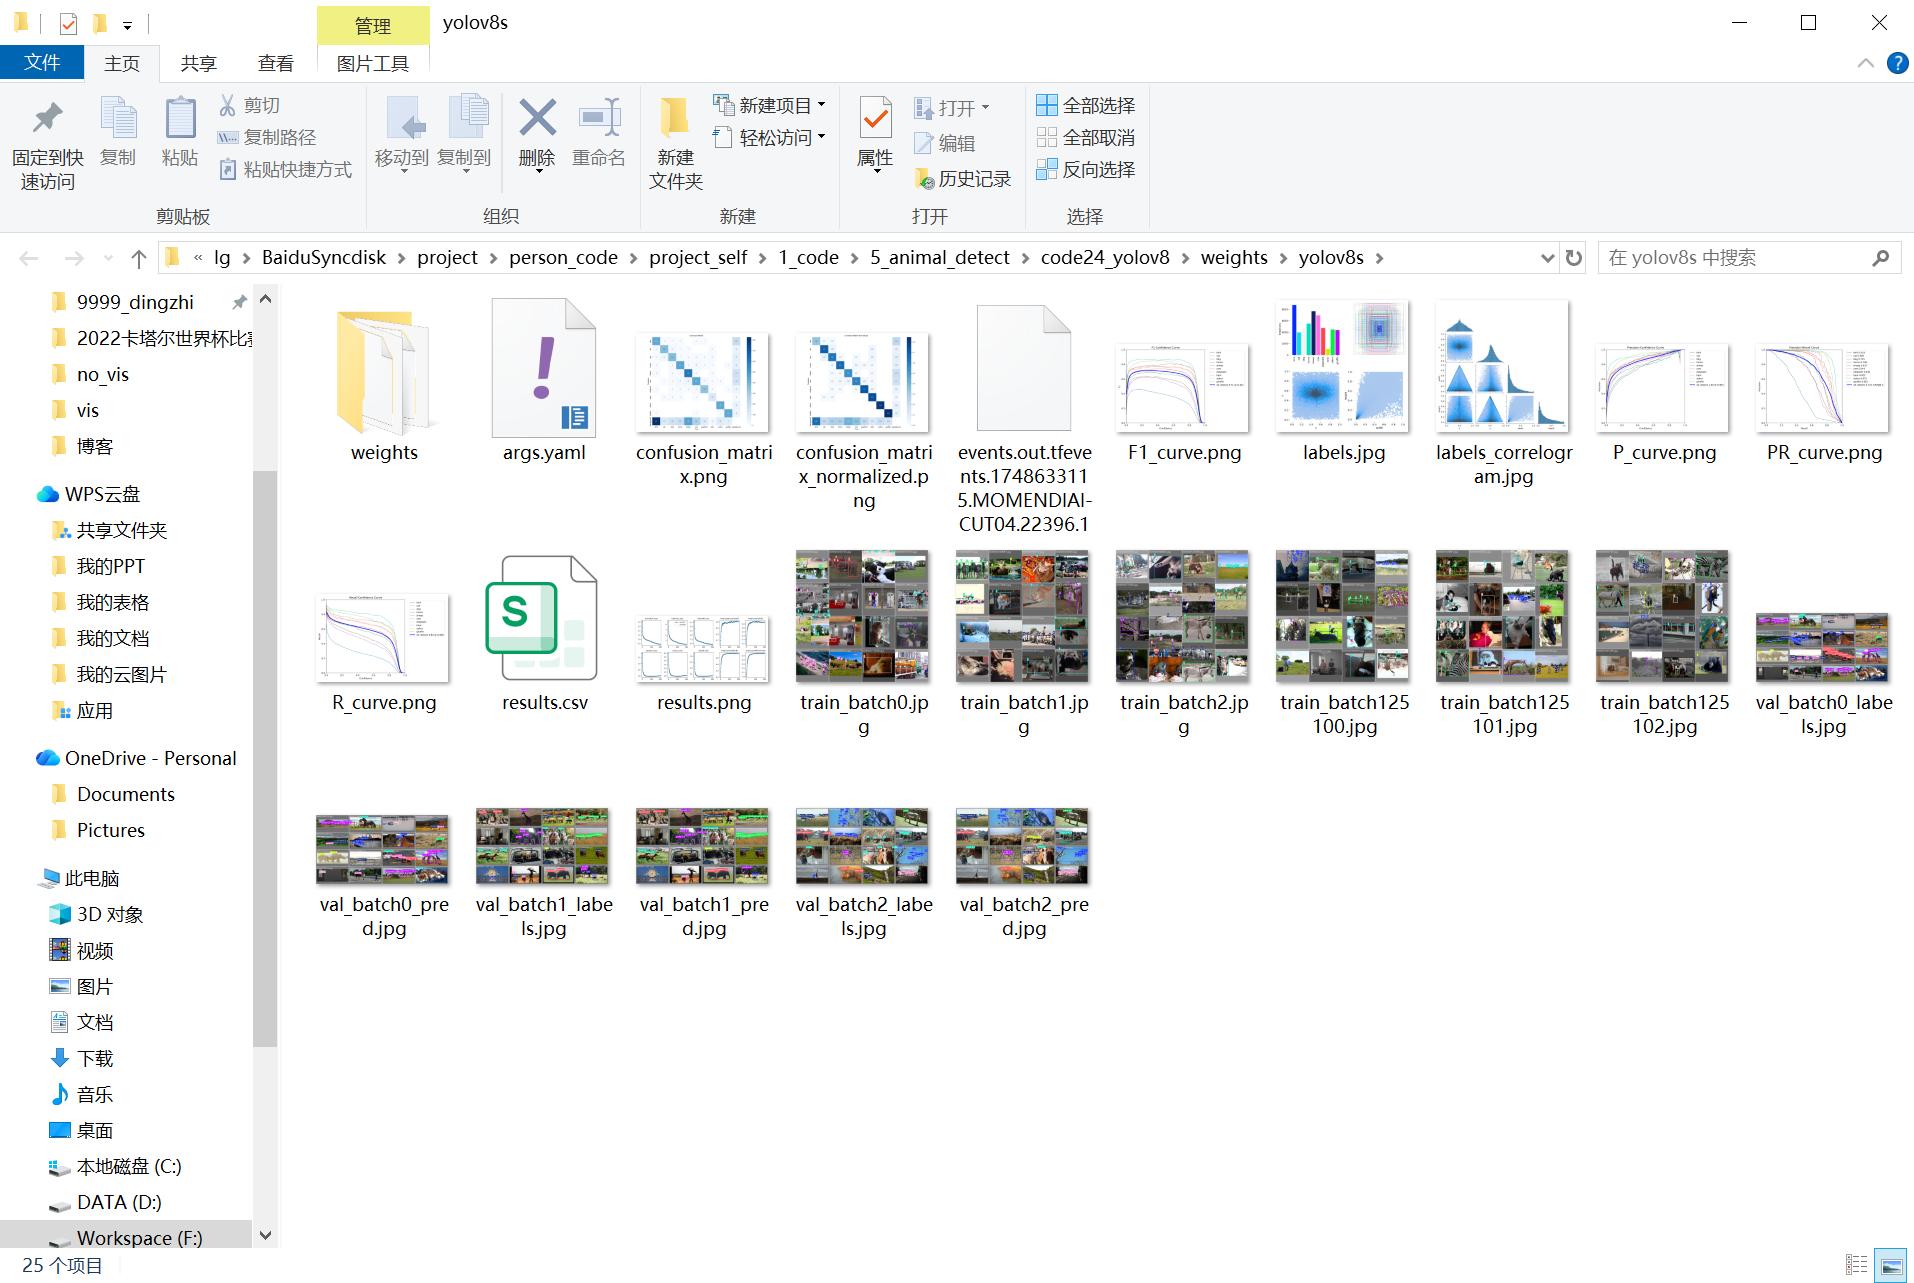
对上述文件中的 confusion_matrix.png、results.png 等指标含义如有疑问,可参考项目附带的详细指标解读文档,文档截图如下:

💻 七、源码获取
下方截图展示了项目各文件夹的功能说明:

使用YOLO系列算法构建检测系统并不复杂,但文字说明难免有所遗漏。建议结合视频教程同步学习,涵盖环境配置、训练预测、界面修改等关键环节,理解会更加深入。
演示与介绍视频: 05-基于YOLO12的动物检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络
演示与介绍视频: 05-基于深度学习的动物检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)
演示与介绍视频: 05-基于深度学习的动物检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)
演示与介绍视频: 05-基于深度学习的动物检测系统(yolov5)(附赠任务书、开题报告模板课程)
⚠️ 免责声明:本文所述方法基于实验验证,但可能存在不足之处。如有问题反馈或优化建议,欢迎交流指正,这将有助于持续完善内容质量,使更多读者受益。同时也期待您分享更优的实现思路,共同推动技术进步。感谢支持!
更多推荐



 0
 0
- 0


 已为社区贡献69条内容

所有评论(0)