
【深度学习】RNN与LSTM_序列建模的前Transformer时代
文章目录
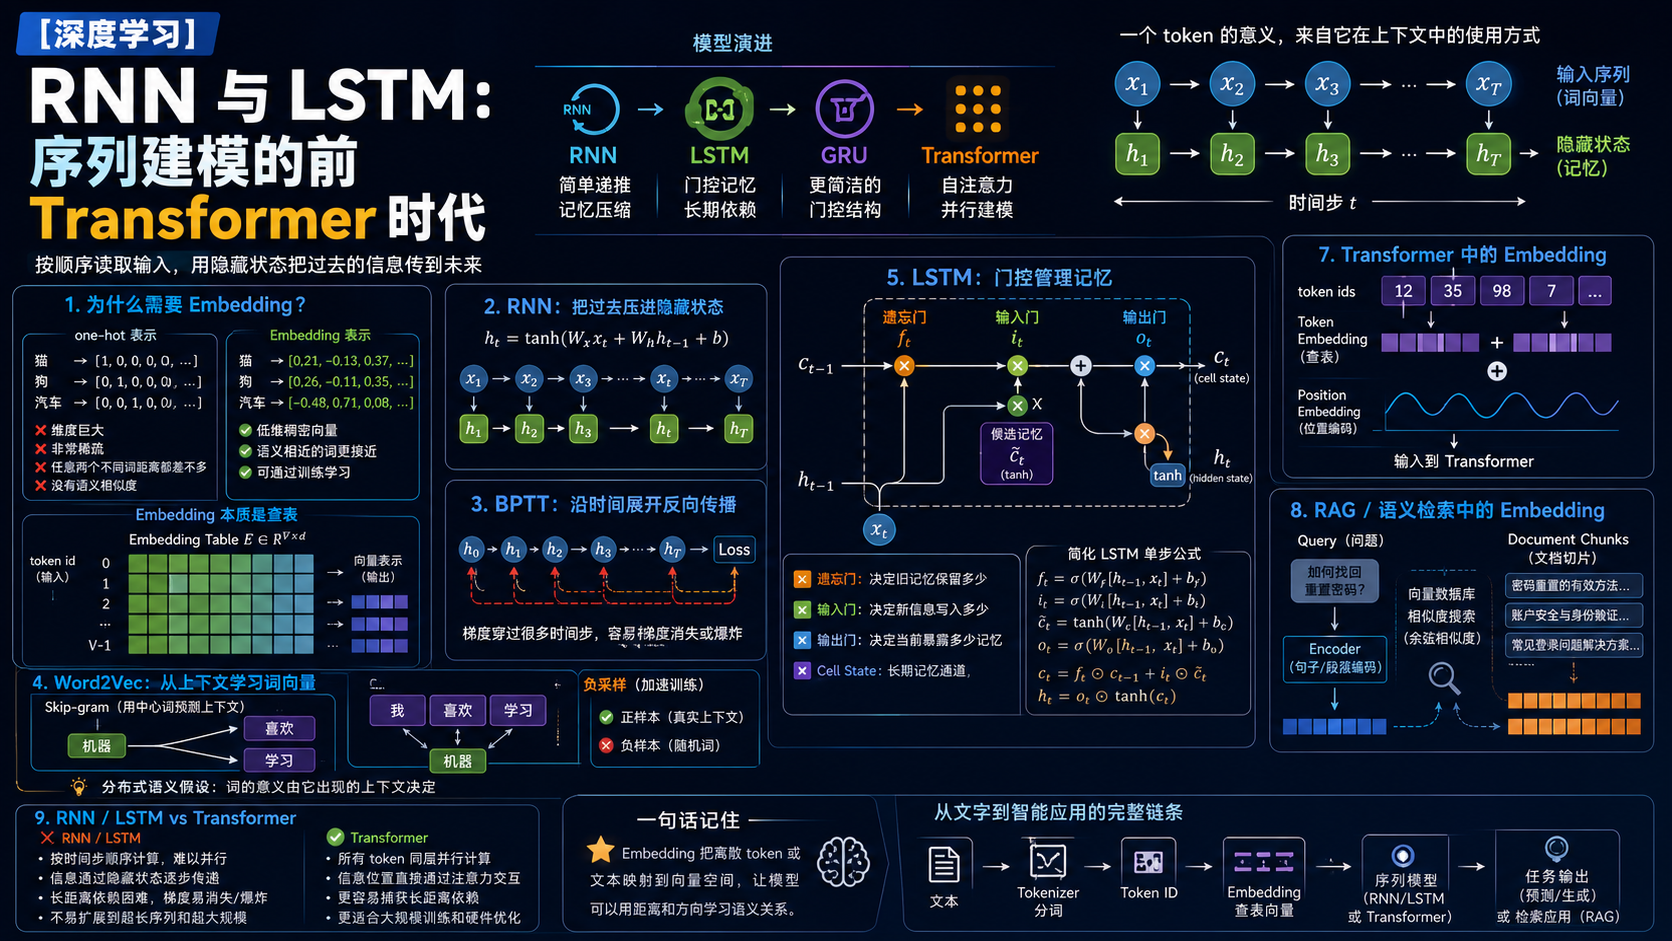
摘要:在 Transformer 成为主流之前,RNN、LSTM、GRU 是处理文本、语音、时间序列的核心模型。它们的基本思想是按顺序读取输入,用隐藏状态把过去的信息传到未来。RNN 简洁但难以学习长距离依赖,容易梯度消失或爆炸;LSTM 通过遗忘门、输入门、输出门和 cell state 管理记忆,让长期信息更容易保留;GRU 则用更简洁的门控结构做类似事情。本文从序列建模问题讲起,解释 RNN 公式、BPTT、长距离依赖、LSTM 门控和 NumPy 单步实现,最后说明为什么 Transformer 取代了 RNN/LSTM 成为大模型基础。
前置知识:链式法则,反向传播,词嵌入
阅读时间:约 65 分钟
代码环境:Python 3.10+,numpy >= 1.24,torch >= 2.0
入门导读:先抓住主线
语言是有顺序的。模型看到一句话时,不能只知道有哪些词,还要知道它们按什么顺序出现。
RNN 的做法很直接:
读第 1 个 token -> 更新隐藏状态
读第 2 个 token -> 基于上一个隐藏状态继续更新
读第 3 个 token -> 继续更新
隐藏状态 h_t 像一份不断更新的记忆,里面压缩了到当前位置为止的历史信息。
LSTM 的改进是:不要让所有信息都挤在一个普通隐藏状态里,而是用门控机制决定:
哪些旧信息要忘掉
哪些新信息要写入
当前要输出多少记忆
读完先达到这个程度就够了:
- 能解释序列建模为什么需要记忆;
- 能看懂 RNN 的递推公式;
- 能理解 BPTT 为什么会导致长距离梯度问题;
- 能说清 LSTM 遗忘门、输入门、输出门分别做什么;
- 能读懂一个简化 LSTM 单步代码;
- 能理解 Transformer 为什么在大模型时代取代 RNN/LSTM。
带着这 3 个问题读:
- RNN 的隐藏状态为什么既是优势也是瓶颈?
- LSTM 的 cell state 为什么有助于长期记忆?
- Transformer 取代 RNN/LSTM 的关键原因是效果,还是并行和规模化?
一、什么是序列建模
序列建模处理的是有顺序的数据。
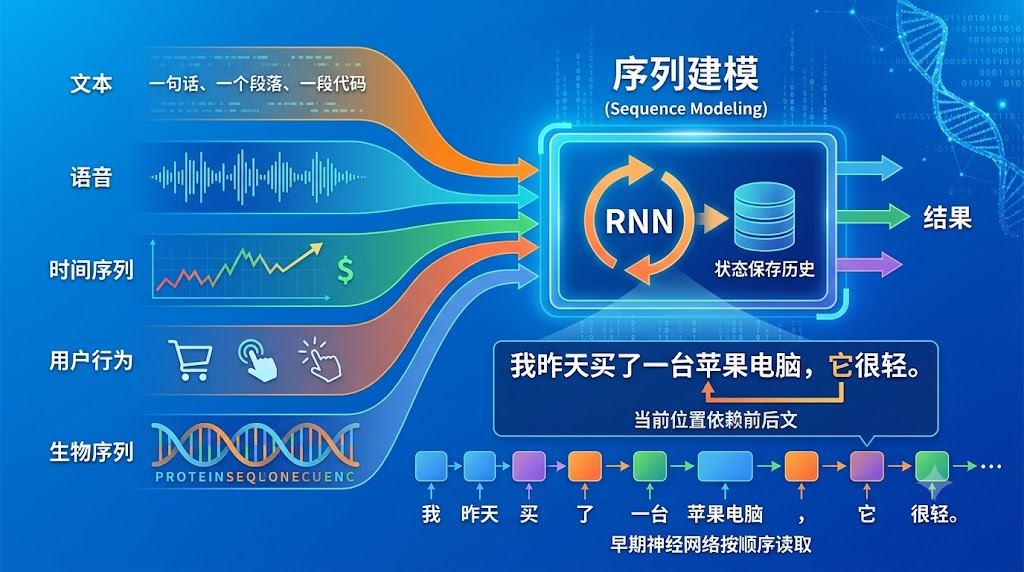
常见序列包括:
- 文本:一句话、一个段落、一段代码;
- 语音:按时间排列的声学特征;
- 时间序列:股票价格、传感器数据;
- 用户行为:点击、购买、浏览记录;
- 生物序列:DNA、蛋白质序列。
序列的特点是:当前位置的含义依赖前后文。
例如:
我昨天买了一台苹果电脑,它很轻。
“它”指什么,需要记住前面出现过“苹果电脑”。
早期神经网络处理序列,一个自然想法是:按顺序读,用一个状态保存历史。这就是 RNN 的基本思想。
二、RNN:把过去压进隐藏状态
RNN 全称 Recurrent Neural Network,循环神经网络。
在时间步 t,输入是当前 token 向量 x_t,上一步隐藏状态是 h_{t-1},输出当前隐藏状态 h_t。
公式:
h t = t a n h ( W x x t + W h h t − 1 + b ) h_t = tanh(W_x x_t + W_h h_{t-1} + b) ht=tanh(Wxxt+Whht−1+b)
其中:
x_t是当前输入;h_{t-1}是过去信息;h_t是更新后的记忆;W_x、W_h、b是可训练参数。
用代码写一个 RNN 单步:
import numpy as np

input_dim = 4
hidden_dim = 6

x_t = np.random.randn(input_dim)
h_prev = np.zeros(hidden_dim)

W_x = np.random.randn(input_dim, hidden_dim) * 0.1
W_h = np.random.randn(hidden_dim, hidden_dim) * 0.1
b = np.zeros(hidden_dim)

h_t = np.tanh(x_t @ W_x + h_prev @ W_h + b)
print(h_t.shape)
处理完整序列时,就是循环调用这个单步:
seq_len = 5
xs = np.random.randn(seq_len, input_dim)
h = np.zeros(hidden_dim)

states = []
for t in range(seq_len):
    h = np.tanh(xs[t] @ W_x + h @ W_h + b)
    states.append(h)

print(len(states), states[-1].shape)
最后一个隐藏状态可以用于分类,每个时间步隐藏状态可以用于序列标注或语言建模。
三、RNN 如何做语言模型
如果用 RNN 做语言模型,可以在每个时间步根据 h_t 预测下一个 token。
输入:我 -> 预测 喜欢
输入:喜欢 -> 预测 机器
输入:机器 -> 预测 学习
公式:
o t = h t W o + b o o_t = h_t W_o + b_o ot=htWo+bo
p t = s o f t m a x ( o t ) p_t = softmax(o_t) pt=softmax(ot)
训练目标是让真实下一个 token 的概率更高。
这和后来的 GPT 目标有相似之处:都是从左到右预测下一个 token。区别在于,RNN 用隐藏状态压缩历史,Transformer 用 self-attention 直接访问上下文。
四、BPTT:沿时间展开反向传播
RNN 参数在每个时间步共享。训练时需要把整个序列展开,然后反向传播。
这叫 Backpropagation Through Time,简称 BPTT。
展开后可以想象成:
h0 -> h1 -> h2 -> h3 -> h4 -> loss
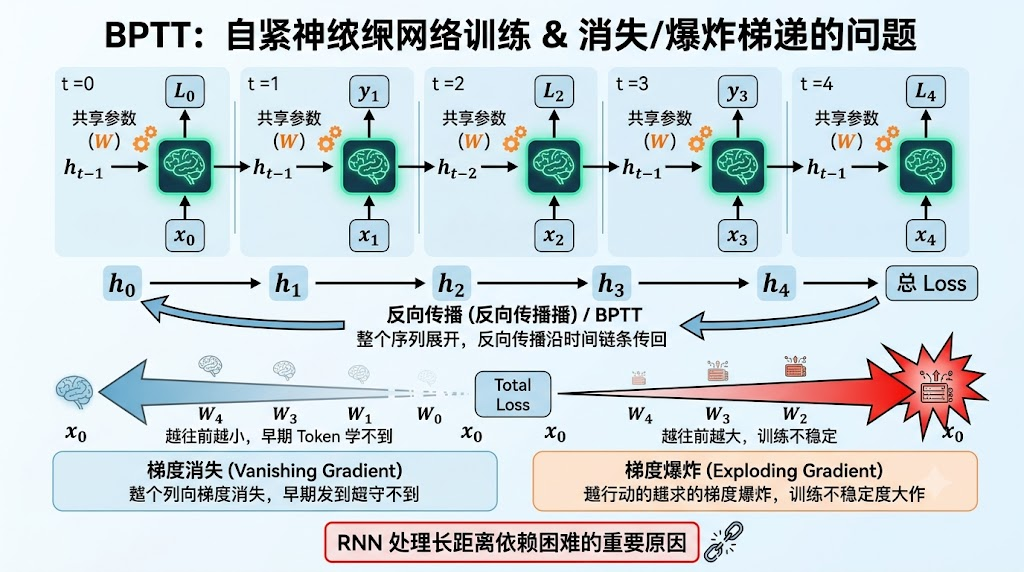
虽然每一步用的是同一组参数,但反向传播要沿时间链条传回去。
问题来了:如果序列很长,梯度要穿过很多时间步。
梯度连续相乘后,可能出现:
- 梯度消失:越往前越小,早期 token 学不到;
- 梯度爆炸:越往前越大,训练不稳定。
这就是 RNN 处理长距离依赖困难的重要原因。
五、RNN 的长距离依赖问题
看一个句子:
我在巴黎住了很多年,虽然后来搬去了伦敦,但我仍然能说流利的法语。
要预测“法语”,模型需要记住很早之前的“巴黎”。
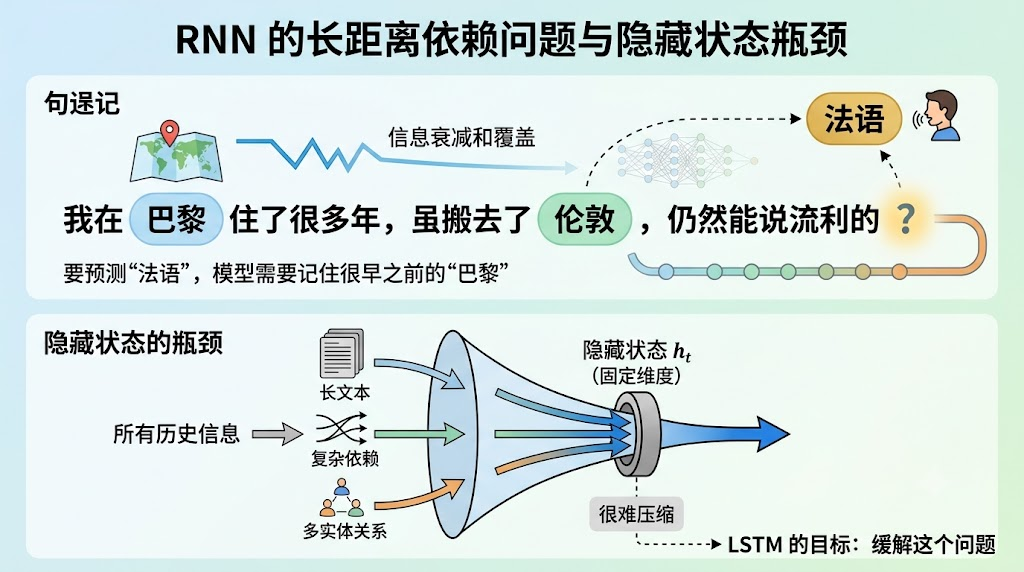
RNN 必须把“巴黎”信息压进隐藏状态,然后一步步传到后面。中间经过很多 token,信息可能被覆盖或衰减。
这就是隐藏状态的瓶颈:
所有历史信息 -> 一个固定维度 h_t
无论前文多长,RNN 都要压进同一个向量。长文本、复杂依赖、多实体关系都会让这个压缩变得困难。
LSTM 的目标就是缓解这个问题。
六、LSTM:用门控管理记忆
LSTM 全称 Long Short-Term Memory。
它在普通隐藏状态 h_t 之外,引入了 cell state c_t。你可以把 c_t 理解成一条更稳定的长期记忆通道。
LSTM 有三个主要门:
- 遗忘门:决定旧记忆保留多少;
- 输入门:决定新信息写入多少;
- 输出门:决定当前暴露多少记忆给隐藏状态。
整体直觉:
c_{t-1} -> 遗忘一部分 -> 加入新候选记忆 -> c_t
c_t -> 输出门控制 -> h_t
相比普通 RNN,LSTM 不需要每一步都完全重写记忆,而是可以让重要信息沿 cell state 传得更远。
七、遗忘门:哪些旧信息该丢掉
遗忘门公式:
f t = σ ( W f [ h t − 1 , x t ] + b f ) f_t = \sigma(W_f [h_{t-1}, x_t] + b_f) ft=σ(Wf[ht−1,xt]+bf)
f_t 的每个元素在 0 到 1 之间。
- 接近 1:对应记忆保留;
- 接近 0:对应记忆忘掉。
旧 cell state 会乘以遗忘门:
f t ⊙ c t − 1 f_t \odot c_{t-1} ft⊙ct−1
这里 ⊙ \odot ⊙ 表示逐元素相乘。
遗忘门让模型可以选择性丢掉不再重要的信息。例如对话换了主题,某些旧上下文就可以降低权重。
八、输入门:哪些新信息该写入
输入门控制新信息写入多少。
输入门:
i t = σ ( W i [ h t − 1 , x t ] + b i ) i_t = \sigma(W_i [h_{t-1}, x_t] + b_i) it=σ(Wi[ht−1,xt]+bi)
候选记忆:
c ~ t = t a n h ( W c [ h t − 1 , x t ] + b c ) \tilde{c}_t = tanh(W_c [h_{t-1}, x_t] + b_c) c~t=tanh(Wc[ht−1,xt]+bc)
写入部分:
i t ⊙ c ~ t i_t \odot \tilde{c}_t it⊙c~t
然后更新 cell state:
c t = f t ⊙ c t − 1 + i t ⊙ c ~ t c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t ct=ft⊙ct−1+it⊙c~t
这条公式是 LSTM 的核心。旧记忆不是被完全覆盖,而是和新记忆按门控比例组合。
九、输出门:当前暴露多少记忆
输出门决定 cell state 里有多少信息输出成 hidden state。
公式:
o t = σ ( W o [ h t − 1 , x t ] + b o ) o_t = \sigma(W_o [h_{t-1}, x_t] + b_o) ot=σ(Wo[ht−1,xt]+bo)
h t = o t ⊙ t a n h ( c t ) h_t = o_t \odot tanh(c_t) ht=ot⊙tanh(ct)
c_t 是内部长期记忆,h_t 是当前时间步对外提供的表示。
这让 LSTM 可以保留某些长期信息,但不一定每一步都全部暴露出来。
十、用 NumPy 写一个简化 LSTM 单步
下面实现一个 LSTM 单步,帮助你把公式和代码对上。
import numpy as np


def sigmoid(x):
    return 1 / (1 + np.exp(-x))

input_dim = 4
hidden_dim = 6

x_t = np.random.randn(input_dim)
h_prev = np.zeros(hidden_dim)
c_prev = np.zeros(hidden_dim)

concat_dim = input_dim + hidden_dim
# 注意:下面所有 W_* 权重矩阵都是 (concat_dim, hidden_dim) 的形状。
# 因为 combined = [h_prev, x_t](先 h 后 x),所以权重矩阵在维度上的排布约定是
#   前 hidden_dim 行对应 h_prev 的权重,后 input_dim 行对应 x_t 的权重。
# 如果你把 combined 改成 [x_t, h_prev],那 W_* 的分块顺序也要跟着换,
# 否则前向计算逻辑上是错的。PyTorch/TF 里对应约定各不相同,读别人代码时留意这一点。
W_f = np.random.randn(concat_dim, hidden_dim) * 0.1
W_i = np.random.randn(concat_dim, hidden_dim) * 0.1
W_c = np.random.randn(concat_dim, hidden_dim) * 0.1
W_o = np.random.randn(concat_dim, hidden_dim) * 0.1

b_f = np.zeros(hidden_dim)
b_i = np.zeros(hidden_dim)
b_c = np.zeros(hidden_dim)
b_o = np.zeros(hidden_dim)

# 拼接顺序:先 h_prev 后 x_t,与上面权重矩阵的约定一致
combined = np.concatenate([h_prev, x_t])

f_t = sigmoid(combined @ W_f + b_f)
i_t = sigmoid(combined @ W_i + b_i)
c_candidate = np.tanh(combined @ W_c + b_c)
o_t = sigmoid(combined @ W_o + b_o)

c_t = f_t * c_prev + i_t * c_candidate
h_t = o_t * np.tanh(c_t)

print("c_t:", c_t.shape)
print("h_t:", h_t.shape)
真实 LSTM 会把四个门的矩阵合并成一个大矩阵,提高计算效率。但逻辑仍然是这几个门。
十一、GRU:更简洁的门控 RNN
GRU 全称 Gated Recurrent Unit,是比 LSTM 更简洁的门控 RNN。
它常用两个门:
- 更新门 update gate;
- 重置门 reset gate。
GRU 没有单独的 cell state,而是直接在 hidden state 上做门控。
相比 LSTM:
| 模型 | 结构 | 优点 | 局限 |
|---|---|---|---|
| RNN | 一个隐藏状态 | 简单 | 长距离依赖差 |
| LSTM | cell state + 三个门 | 长期记忆更强 | 参数更多,计算复杂 |
| GRU | 两个门 | 比 LSTM 简洁 | 表达和任务表现视情况而定 |
GRU 在一些中小规模序列任务里效果很好,训练也比 LSTM 简单一些。
十二、为什么 Transformer 取代 RNN/LSTM
Transformer 取代 RNN/LSTM,不只是因为模型效果更好,还因为它更适合规模化。
1. 并行性
RNN 必须按时间顺序计算:
h1 -> h2 -> h3 -> h4
后一步依赖前一步,很难在序列维度并行。
Transformer 的 self-attention 可以在同一层同时处理所有 token,更适合 GPU/TPU。
2. 长距离依赖
RNN 要把远处信息一步步传过来。
Transformer 里,任意两个 token 可以通过 attention 直接交互。
3. 训练稳定和规模化
Transformer 结构规整,矩阵乘法占主导,容易堆大模型、做分布式训练和硬件优化。
4. 表示能力
Self-attention 可以动态选择关注哪些 token,不必把所有历史压进一个固定隐藏状态。
当然,Transformer 的代价是 attention 复杂度随序列长度平方增长。这也是后面长上下文技术要解决的问题。
十三、RNN/LSTM 还值得学吗
值得。
原因有三点。
第一,它们是理解序列建模历史的关键。你会更清楚 Transformer 解决了什么问题。
第二,RNN/LSTM 在某些场景仍然有用。比如低延迟流式处理、小型时间序列、边缘设备、数据量较小的序列任务。
第三,LSTM 的门控思想仍然影响现代模型。你在 GLU、SwiGLU、门控残差、MoE router 等结构里,都能看到“选择性通过信息”的影子。
所以学习 RNN/LSTM 不是为了回到旧时代,而是为了理解序列模型的核心矛盾:记忆、依赖、并行和计算成本。
十四、用 PyTorch 快速对比 RNN/LSTM
PyTorch 提供了现成模块。
import torch
import torch.nn as nn

batch, seq_len, input_dim, hidden_dim = 2, 5, 8, 16
x = torch.randn(batch, seq_len, input_dim)

rnn = nn.RNN(input_dim, hidden_dim, batch_first=True)
lstm = nn.LSTM(input_dim, hidden_dim, batch_first=True)

y_rnn, h_rnn = rnn(x)
y_lstm, (h_lstm, c_lstm) = lstm(x)

print("RNN output:", y_rnn.shape)
print("RNN h:", h_rnn.shape)
print("LSTM output:", y_lstm.shape)
print("LSTM h:", h_lstm.shape)
print("LSTM c:", c_lstm.shape)
输出:
output: [batch, seq_len, hidden_dim]
h: [num_layers, batch, hidden_dim]
c: [num_layers, batch, hidden_dim]
LSTM 多了 c,这就是 cell state。
十五、常见误区
误区 1:RNN 已经过时,所以没必要理解。
RNN/LSTM 是理解序列模型、长距离依赖和 Transformer 优势的重要基础。
误区 2:LSTM 完全解决了长距离依赖。
LSTM 缓解了问题,但长序列、大规模并行和复杂全局依赖仍然困难。
误区 3:隐藏状态能完美记住所有历史。
隐藏状态维度固定,历史越长,压缩压力越大。
误区 4:Transformer 只是更大的 RNN。
不是。Transformer 用 self-attention 让 token 直接交互,信息流方式完全不同。
误区 5:LSTM 的门控公式必须死记硬背。
第一遍更重要的是理解门控的作用:忘掉旧信息、写入新信息、控制输出。
误区 6:RNN 不能做语言模型。
RNN 当然可以做语言模型,只是大规模训练和长距离建模上不如 Transformer 路线。
十六、你应该记住的最小心智模型
RNN:
h_t = f(x_t, h_{t-1})
把过去压进隐藏状态
LSTM:
遗忘门:旧记忆保留多少
输入门:新记忆写入多少
输出门:当前暴露多少
cell state:长期记忆通道
Transformer 相比 RNN/LSTM:
不再一步步传递隐藏状态
而是让 token 通过 attention 直接读取上下文
更适合并行和规模化训练
总结
RNN 用隐藏状态按顺序传递历史信息,是早期序列建模的核心方法。它结构简单,但长距离依赖难学,反向传播穿过很多时间步时容易梯度消失或爆炸。LSTM 通过 cell state 和遗忘门、输入门、输出门管理记忆,让重要信息更容易跨时间保存。GRU 用更简洁的门控结构实现类似目标。
Transformer 后来取代 RNN/LSTM 成为大模型主流,是因为 self-attention 支持更直接的长距离交互,更适合并行计算和大规模训练。但 RNN/LSTM 仍然值得学习,因为它们清楚展示了序列建模的核心问题:如何记住过去,如何更新记忆,如何让梯度穿过时间。
第一遍记住一句话:RNN/LSTM 用隐藏状态传递记忆,Transformer 用 attention 直接读取上下文。
大模型视角
理解 RNN/LSTM 后,你会更容易看懂 Transformer 的革命性:它不是简单换了一个模块,而是改变了序列信息流。现代大模型能在海量数据上并行训练,很大程度上来自 Transformer 摆脱了 RNN 的逐时间步依赖。
下一篇
残差连接:解决深层网络梯度消失问题 —— RNN/LSTM 让我们看到梯度穿过长链条的困难。下一篇回到深层网络结构,看残差连接如何让信息和梯度更顺畅地穿过很多层。
更多推荐



 46
 0
- 0


 已为社区贡献38条内容

所有评论(0)