
2026年大模型学习路线:从零基础到精通实战,小白也能轻松掌握!
在当前人工智能领域,大模型无疑是核心支柱,其超强的泛化能力和落地潜力,正加速各行业的数字化变革与创新突破。无论你是刚接触AI、对大模型充满好奇的编程小白,还是想深耕AI领域、拓宽职业边界的程序员,系统掌握大模型的相关知识与实操技能,都是当下最具价值的学习选择。今天就为大家整理了一份超详细的2026年大模型学习路线,从零基础铺垫到精通实战,一步步带你吃透大模型,建议收藏慢慢学!
一、基础准备阶段(筑牢根基,避免后期踩坑)
小白入门大模型,最忌讳跳过基础直接啃核心技术,此阶段重点夯实数学、编程、深度学习三大基础,为后续学习铺路,程序员可根据自身基础选择性查漏补缺。
(一)数学基础(大模型的底层逻辑支撑)
数学是大模型的“内功”,不用追求极致深入,但核心知识点必须掌握,否则会难以理解模型训练、参数优化的底层原理。
- 线性代数:重点掌握矩阵运算(乘法、加法、求逆、转置),理解向量空间、特征值与特征向量的核心含义及计算方法。这是大模型处理数据的基础——比如图像数据以矩阵形式存储,文本数据通过向量编码转换,线性代数运算直接决定了数据特征的提取效率。建议结合实际案例理解,比如用矩阵运算模拟简单的图像缩放,更易上手。
- 概率统计:吃透随机变量、常见概率分布(正态分布、泊松分布、二项分布),重点掌握贝叶斯定理。大模型处理自然语言、图像识别等任务时,本质是通过概率估计实现预测,比如文本生成中,模型会通过概率计算选择最贴合上下文的词汇,贝叶斯定理则广泛用于模型的不确定性推理。
- 微积分:核心掌握梯度、偏导数的概念与计算方法,这是大模型训练中优化算法的核心。模型训练的本质的是“不断调整参数以降低误差”,而梯度下降算法正是通过计算梯度,找到参数优化的方向,比如神经网络中,通过偏导数计算每个神经元的参数调整幅度。
学习资源推荐(小白友好):Khan Academy线性代数+微积分免费课程(通俗易懂,适合零基础);Coursera《Probability and Statistics for Business and Data Science》(结合数据场景,贴合大模型应用);B站“3Blue1Brown”线性代数可视化讲解(生动直观,告别枯燥公式)。
(二)编程基础(大模型开发的必备工具)
大模型开发以Python为主,搭配NumPy等工具包,重点掌握“数据处理+基础编程”能力,无需追求复杂语法,够用即可。
- Python:作为大模型开发的首选语言,重点掌握基础数据结构(列表、字典、元组、集合)、控制流语句(if-else、for/while循环)、函数定义与调用(参数传递、返回值),了解简单的面向对象编程思想。小白建议从“实用场景”入手,比如用Python编写简单的文本读取、数据打印代码,逐步培养编程手感。
- NumPy:精通数组的创建、索引、切片、修改,熟练运用NumPy内置的数学函数(如矩阵乘法、向量求和)。大模型处理的数据多为高维数组,NumPy能大幅提升数据运算效率,比如用NumPy实现简单的向量编码,比原生Python代码更高效。
学习资源推荐:Udacity《Intro to Programming》(Python入门)、《Intro to NumPy》(针对性练习);B站“黑马程序员”Python基础教程(小白适配,配套实战案例);菜鸟教程Python板块(随时查阅语法,便捷高效)。
(三)深度学习基础(衔接大模型的核心桥梁)
大模型本质是深度学习的延伸,掌握深度学习基础,能快速理解大模型的架构与训练逻辑,避免“知其然不知其所以然”。
- 神经网络基础:理解前馈神经网络的结构(输入层、隐藏层、输出层)与工作原理,掌握卷积神经网络(CNN)在图像识别中的应用(比如特征提取),了解循环神经网络(RNN)及其变种(LSTM、GRU)在序列数据(文本、语音)处理中的优势。重点理解“神经元连接权重”的作用——模型通过调整权重,学习数据的特征规律。
- 训练技巧:掌握反向传播算法(计算模型误差、更新参数的核心),熟悉梯度下降及其变种(SGD、Adagrad、Adadelta)的区别与应用场景,了解学习率、批次大小等超参数的调整方法。小白可先记住“核心逻辑”:反向传播算误差,梯度下降调参数,后续通过实战逐步理解细节。
二、核心技术学习阶段(吃透大模型核心,建立技术壁垒)
基础扎实后,进入核心阶段,重点学习Transformer模型、预训练技术、NLP基础(大模型最核心的应用场景),这部分是小白与程序员拉开差距的关键,建议结合论文+实操同步学习。
(一)Transformer模型(大模型的核心架构)
几乎所有主流大模型(GPT、BERT、T5)都基于Transformer架构,吃透其原理,就能轻松理解各类大模型的差异与应用场景。
- 原理深入剖析:核心掌握“自注意力机制”——通俗来说,就是让模型“关注输入序列中不同位置的关联关系”,比如处理句子“我喜欢吃苹果”时,模型能识别出“苹果”与“吃”的关联。同时理解多头注意力机制(通过多个注意力头并行计算,捕捉更丰富的特征)、位置编码(给输入序列添加位置信息,让模型感知语序,解决Transformer无法捕捉序列顺序的问题)。
- 结构与变种:掌握Transformer的整体架构(编码器+解码器),重点研究三大主流变种: 1. BERT:双向编码器预训练模型,擅长文本分类、问答系统等任务,比如智能客服的问题匹配; 2. GPT:自回归生成式模型,主打文本生成,比如写文章、对话、代码生成; 3. T5:文本到文本统一框架,可将所有NLP任务(翻译、摘要、分类)统一为“输入文本→输出文本”的形式,通用性极强。
论文推荐(小白可先看解读,再啃原文):《Attention Is All You Need》(Transformer原论文,必看)、《BERT: Pre-training of Deep Bidirectional Transformers》(BERT核心论文);学习资源:B站“李沐老师”Transformer讲解(通俗易懂,配套代码演示)。
(二)预训练技术(大模型的“预加载”核心)
大模型的强大,源于“预训练+微调”的模式,预训练阶段让模型学习通用特征,微调阶段适配具体任务,这部分重点掌握预训练的原理与实用技巧。
- 预训练原理:理解“大规模无监督预训练”的核心——用海量未标注数据(比如全网文本、图像)训练模型,让模型学习通用的特征表示。比如NLP领域的掩码语言模型(MLM),随机掩盖文本中的部分单词,让模型预测被掩盖的单词,从而学习语言的语法与语义;下一句预测(NSP),让模型判断两句话是否为连贯段落,学习句子间的逻辑关系。
- 方法与技巧:掌握数据增强技术(文本领域:同义词替换、随机删除单词、句子重排;图像领域:旋转、裁剪),用于扩充训练数据,提升模型泛化能力;了解多任务预训练(同时在多个相关任务上训练,比如同时训练文本分类和问答,让模型更具通用性);学会选择合适的预训练模型作为基础(比如小白可优先选择轻量化预训练模型,降低微调难度)。
(三)自然语言处理基础(大模型最核心的应用场景)
大模型的主要应用集中在NLP领域(文本生成、问答、翻译等),掌握NLP基础,能更好地理解大模型的应用逻辑,也能快速上手实战项目。
- 文本预处理技术:这是NLP任务的第一步,也是小白最容易忽略的环节,重点掌握3点: 1. 文本清洗:去除特殊字符、HTML标签、无用空格,比如清洗网页爬取的文本数据; 2. 分词:将连续文本分割为单词/子词(中文:jieba分词;英文:nltk分词),是后续特征提取的基础; 3. 词性标注:为每个单词标注词性(名词、动词、形容词),辅助语义理解。
- 词嵌入:理解“词嵌入”的核心——将单词转换为低维向量,让语义相近的单词在向量空间中距离更近。重点掌握两类词嵌入:传统词嵌入(Word2Vec、GloVe,适合简单任务)、基于预训练模型的词嵌入(BERT嵌入,能捕捉单词的上下文语义,更适配复杂任务)。
- 语言模型:了解语言模型的核心——预测下一个单词出现的概率,从而生成连贯文本。对比传统语言模型(N-gram,局限性大,无法捕捉长距离依赖)与神经网络语言模型(RNN语言模型、Transformer语言模型,能处理长文本,生成效果更好)。
学习资源推荐:书籍《Speech and Language Processing》(Jurafsky,NLP经典教材);斯坦福CS224N课程(NLP与深度学习结合,配套实战);B站“同济子豪兄”NLP基础讲解(小白友好)。
三、实战项目阶段(从理论到落地,提升实操能力)
大模型学习的核心是“实战”,小白和程序员都需要通过项目练手,将理论知识转化为实操能力,此阶段分为基础实战和领域特定实战,循序渐进提升。
(一)基础实战项目(小白入门首选,建立信心)
重点是“复现经典项目+开发简单应用”,不用追求复杂,核心是熟悉模型的调用、微调流程,掌握基础工具的使用。
- 经典大模型项目复现:优先复现轻量化模型(降低难度),比如用PyTorch/TensorFlow搭建BERT模型,加载预训练权重,在文本分类任务(比如情感分析)上进行微调。小白可借助Hugging Face工具包,快速调用API,简化开发流程,示例代码(可直接复制使用):
from transformers import pipeline ``# 加载文本生成模型(GPT-2) ``generator = pipeline("text-generation", model="gpt2") ``# 生成文本,max_length控制生成长度 ``result = generator("Hello, I’m learning LLM because", max_length=50, num_return_sequences=1) ``print(result[0]["generated_text"])提示:复现过程中,重点关注“模型加载→数据预处理→微调训练→结果评估”的完整流程,理解每一步的作用。 - 简单应用开发:基于所学知识,开发2-3个简单应用,巩固实操能力: 1. 文本摘要生成器:输入一篇长文,调用大模型API,自动生成简洁摘要; 2. 情感分析工具:输入用户评论,判断评论的情感倾向(积极/消极/中性); 3. 简单对话机器人:调用ChatGPT API或国内大模型API,实现基础的问答交互。
小技巧:小白可先使用API开发(无需搭建复杂模型),熟悉流程后,再尝试搭建模型进行微调,降低入门难度。
(二)领域特定实战项目(程序员进阶,打造个人亮点)
结合自身兴趣或职业需求,选择特定领域开发项目,既能提升实操能力,也能为简历加分,小白可选择性尝试。
- 选择合适的领域: - 医疗领域:构建医学命名实体识别系统,从医学文献中识别疾病、药物、症状等实体; - 金融领域:开发金融风险预测模型,结合金融文本(新闻、财报)和数据,预测市场风险; - 办公领域:开发文档智能处理工具,自动提取文档关键信息、生成会议纪要。
- 项目实施与优化:核心流程为“数据收集→预处理→模型选择→微调→评估→优化”。比如开发医疗命名实体识别系统,可选择BioBERT(医学领域预训练模型)进行微调,用标注工具(如LabelStudio)标注医疗文本数据,通过调整学习率、增加领域数据,提升模型准确率;同时学习使用准确率、召回率、F1分数等指标评估项目效果,不断优化。
提升技巧:参与Kaggle竞赛(NLP类竞赛,如文本生成、摘要生成),与全球开发者交流经验,学习优秀的项目思路;GitHub上搜索开源项目,仿写并优化,积累实战经验。
四、高级技能学习阶段(进阶精通,提升核心竞争力)
基础实战扎实后,进入高级阶段,重点学习API应用开发、大模型架构实践、模型微调与私有化部署,适合想深耕大模型领域的程序员,小白可选择性学习。
(一)大模型API应用开发
当前多数企业采用“调用API”的方式开发大模型应用,掌握主流API的使用,能快速落地商业应用,提升职场竞争力。
- 主流大模型API使用:重点学习OpenAI API(ChatGPT、GPT-4)、百度文心一言API、阿里通义千问API的使用,掌握账号注册、API密钥获取、接口调用流程。比如用OpenAI API开发智能客服机器人,实现“用户提问→API请求→响应解析→回复用户”的完整流程。
- Python接口接入与开发技巧:掌握用Python编写API调用代码,处理请求与响应数据(格式转换、错误处理),比如将用户输入的文本转换为API要求的JSON格式,解析API返回的结果并展示;学习API调用优化技巧,如合理设置请求参数、缓存常用结果,降低调用成本;处理API调用异常(如超时、限流),提升应用稳定性。
(二)大模型应用架构实践
掌握框架使用,能快速构建复杂的大模型应用,提升开发效率,重点学习LangChain及多Agent框架。
- LangChain框架学习:LangChain是大模型应用开发的核心框架,重点掌握提示词管理(优化提示词,提升模型响应效果)、文档加载与处理(加载PDF、Word等文档,提取关键信息)、链(Chain)与代理(Agent)的使用。比如用LangChain构建智能文档问答系统,实现“上传文档→提问→模型结合文档内容回答”的功能。
- 多Agent框架应用:学习AutoGPT、MetaGPT等框架,理解Agent的核心(自主决策、执行任务的智能体),掌握多Agent协作开发,比如用AutoGPT实现“自主制定旅行计划”的功能,拆分多个子任务(查询景点、预订酒店、规划路线),由不同Agent分工完成。同时学习Coze、Dify等可视化工具,辅助应用开发与调试,降低开发难度。
(三)模型微调与私有化部署
这是大模型进阶的核心技能,适合需要定制化模型、注重数据安全的场景,程序员掌握后,竞争力大幅提升。
- 大模型微调技术:掌握3类核心微调方法,根据任务需求选择: 1. 全量微调:调整模型所有参数,效果好但计算量、内存需求大,适合数据量充足的场景; 2. 部分微调:只调整模型顶层或特定层参数,计算量较小,适合数据量有限的场景; 3. Adapter微调(如LoRA低秩适应技术):在模型中添加低秩矩阵,仅调整少量参数,计算量最小,是当前最常用的微调方式,比如用LoRA微调GPT-3.5,适配特定领域任务。 重点学习微调参数设置(学习率、训练轮数、批次大小),掌握微调数据的准备与预处理技巧。
- 私有化部署:掌握私有化部署的完整流程,包括硬件选择(GPU服务器,如NVIDIA A10、A100)、推理框架使用(Ollama、vLLM,实现模型快速推理)、模型优化技术(量化、蒸馏)。比如用Ollama部署Llama 2模型,实现本地离线使用;通过模型量化(将FP32转换为FP16、INT8),减少内存占用,提升推理速度;关注部署过程中的数据安全与隐私保护,避免数据泄露。
五、持续学习与探索(长期深耕,保持竞争力)
大模型技术更新迭代极快,无论是小白还是程序员,都需要保持持续学习的习惯,才能跟上技术潮流,长期立足。
(一)关注前沿技术
- 学术研究跟踪:定期关注顶级学术会议(NeurIPS、ICLR、ACL、EMNLP)和期刊的论文,重点关注多模态模型(文本+图像+音频融合)、参数高效微调、模型压缩等前沿方向;常用工具:ArXiv(免费论文库,可订阅大模型相关领域)、Papers With Code(论文+代码同步,方便实操学习)。
- 行业动态关注:关注OpenAI、Google AI、Meta AI等顶尖机构的博客与技术报告,了解最新模型研发动态;跟踪开源项目(Llama 2、Falcon、Mistral),学习其代码实现与创新点;关注大模型的行业落地案例(如金融、医疗、教育),分析市场需求,明确学习方向。
(二)加入社区与交流
- 国际社区参与:加入GitHub、Reddit等社区,在GitHub上参与大模型开源项目(如Hugging Face相关项目),通过贡献代码、提交Issue,学习优秀的编程实践;在Reddit的r/MachineLearning板块,参与热门话题讨论,与全球开发者交流学习心得,拓宽视野。
- 中文社区互动:参与知乎、掘金、CSDN等平台的大模型话题讨论,关注优质专栏(如CSDN“大模型技术专栏”);关注AI相关公众号(李rumor、机器之心、AI前线),获取最新行业资讯与学习资源;加入大模型学习交流群,与志同道合的人互相督促、分享经验,解决学习中的难题。
(三)实践与创新
- 实际项目参与:工作中主动参与大模型相关项目,将所学知识应用到真实场景中,比如参与企业智能客服升级、文档智能处理等项目,积累工程化经验;小白可尝试接简单的兼职项目(如文本标注、简单应用开发),提升实操能力。
- 创新尝试:结合自身专业,开展小型创新项目,比如程序员可开发基于大模型的代码生成工具,小白可开发个性化学习助手;参与人工智能竞赛(Kaggle、天池),激发创新思维,学习他人的优秀思路,提升自身竞争力。
最后想说,大模型学习是一个“循序渐进、持续深耕”的过程,没有捷径可走。小白不用害怕基础薄弱,从基础准备开始,一步步夯实;程序员可结合自身优势,重点突破高级技能。只要保持好奇心和执行力,按照这份学习路线稳步推进,2025年一定能实现从零基础到精通的跨越,在大模型领域占据一席之地。
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
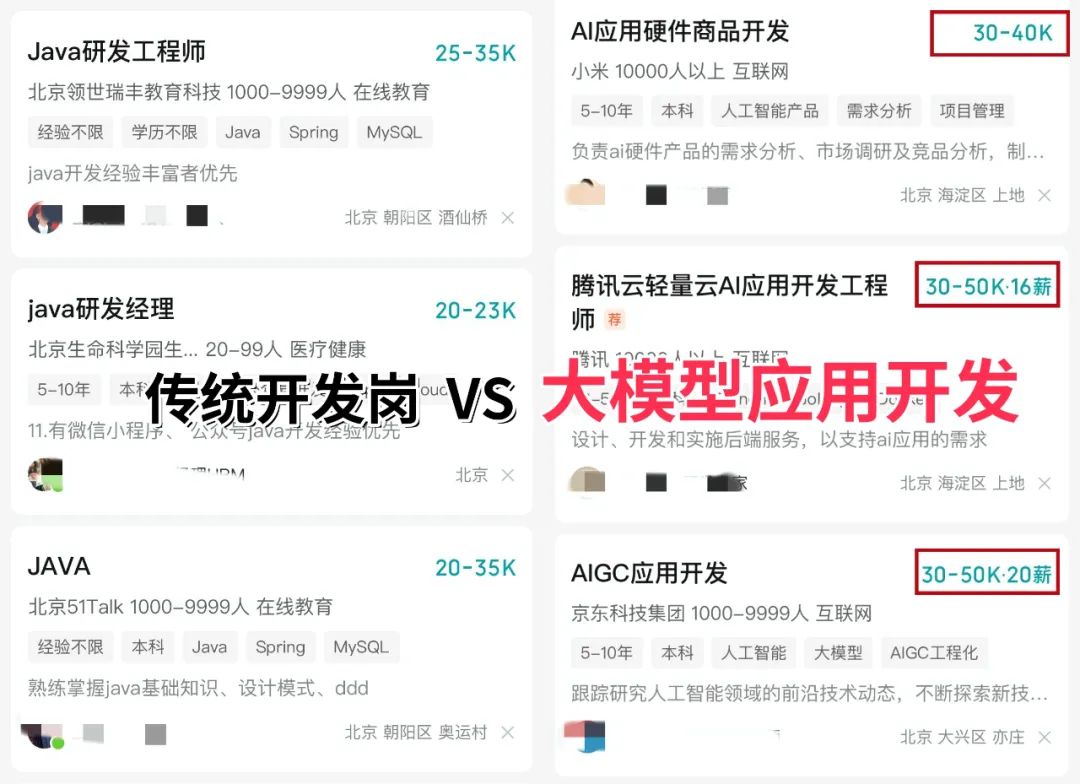
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
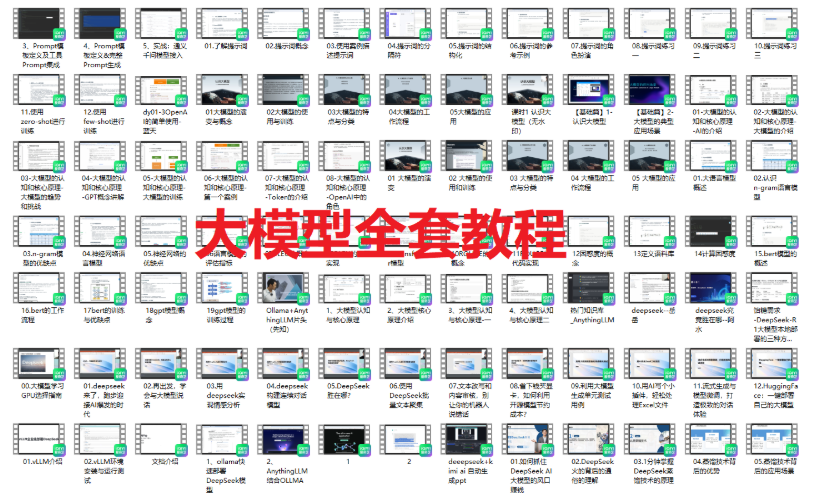
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
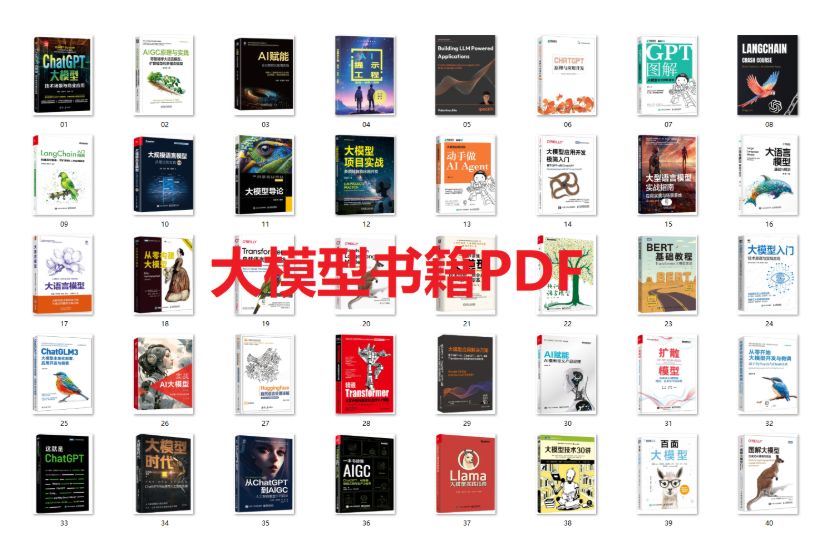
4、 AI大模型最新行业报告
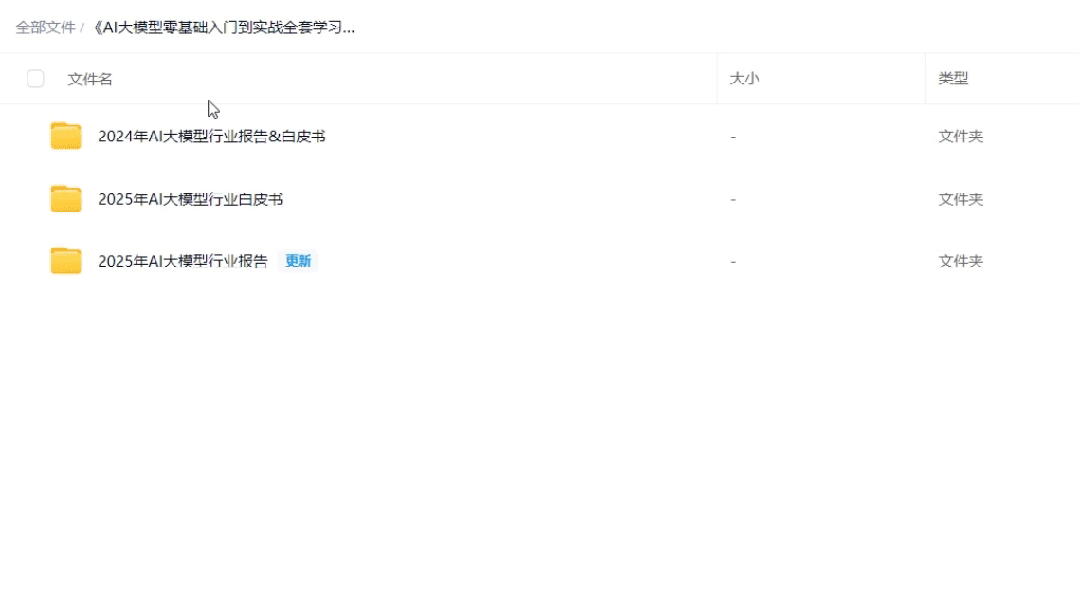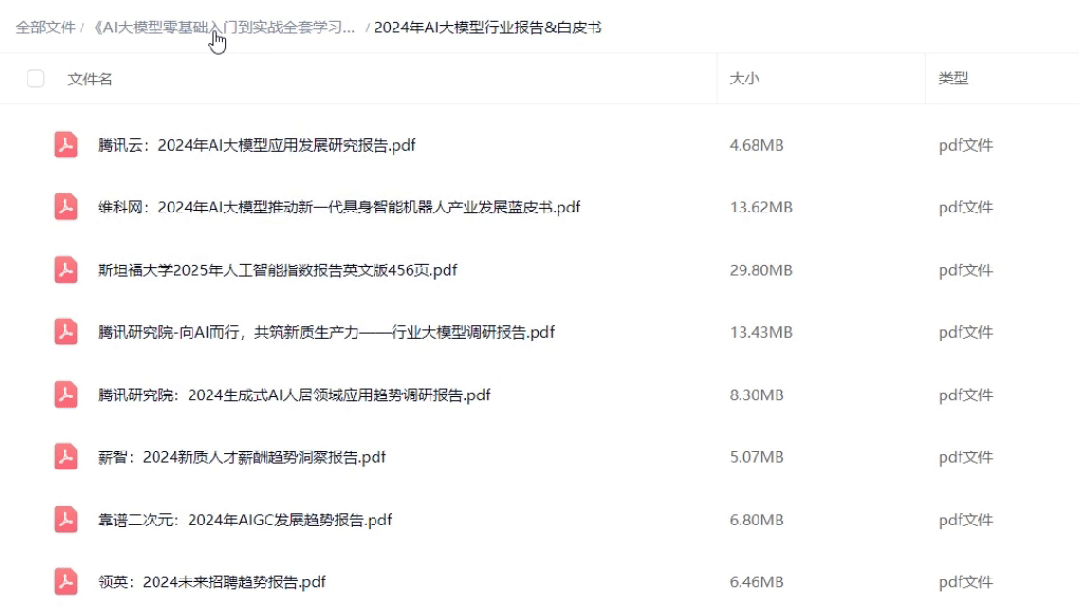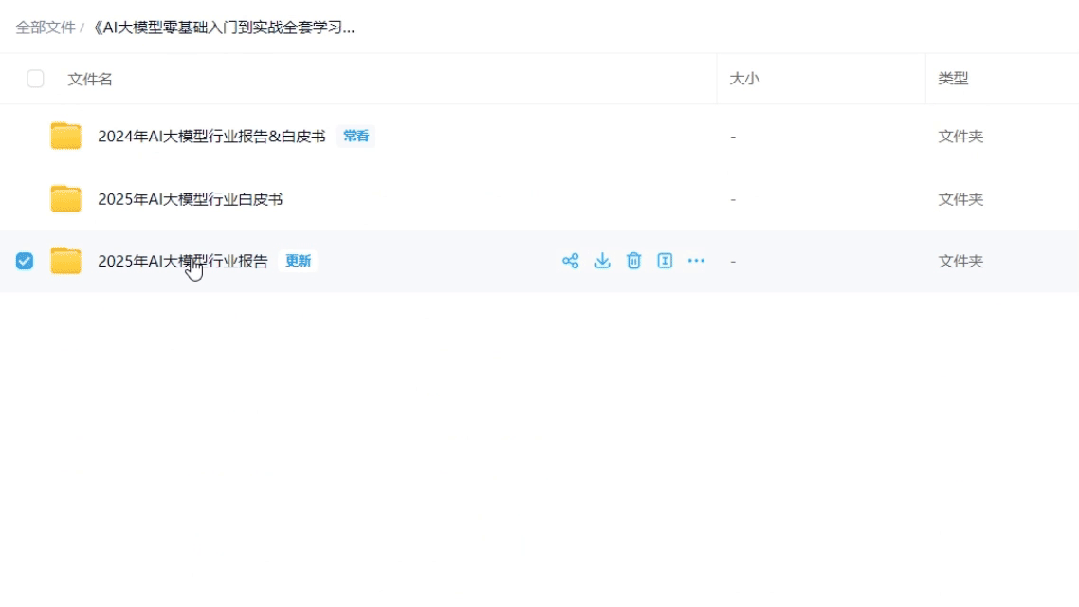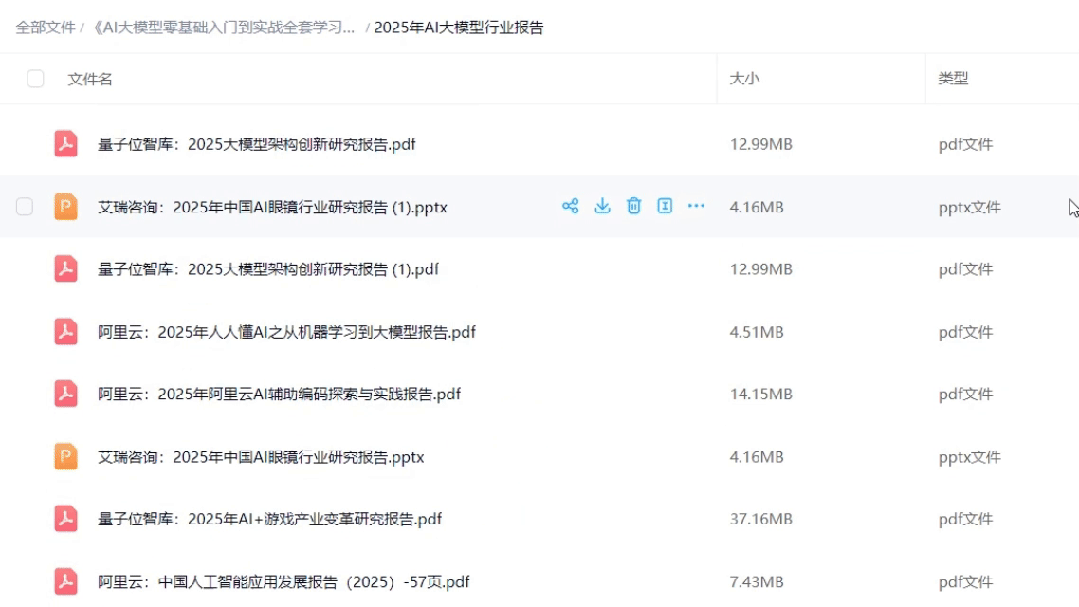
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
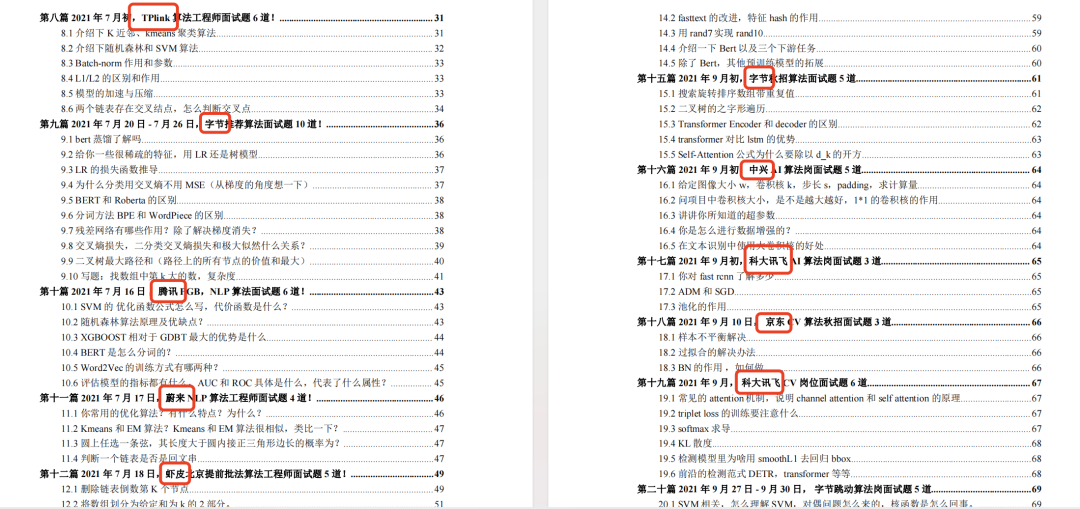
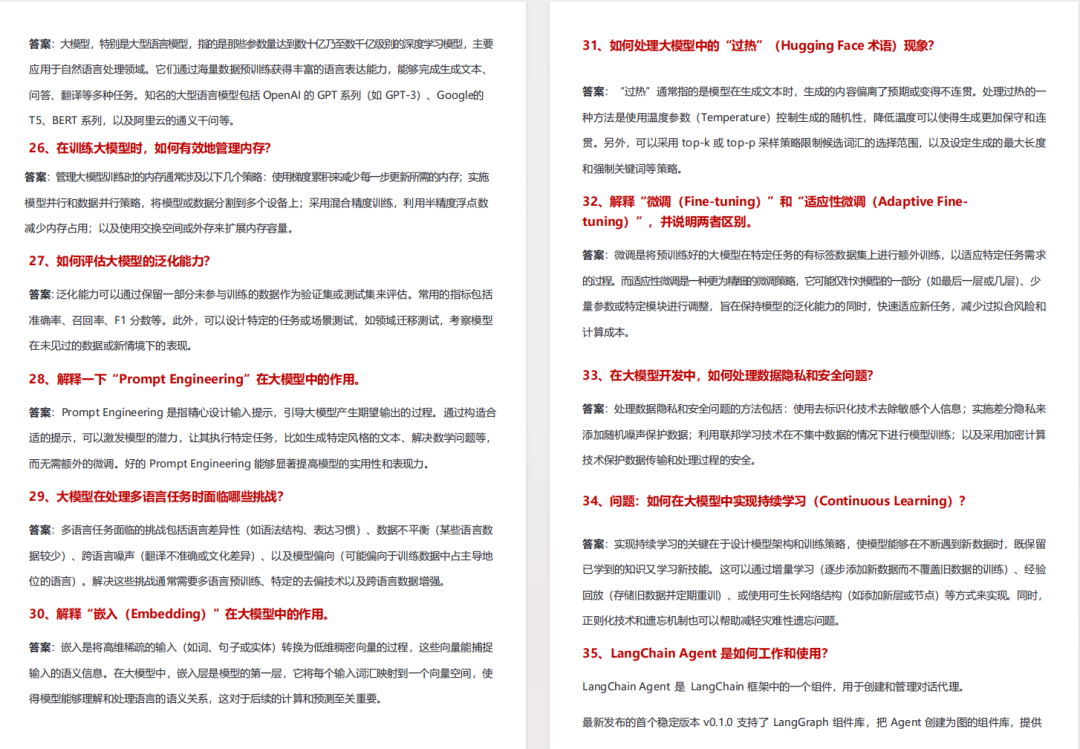
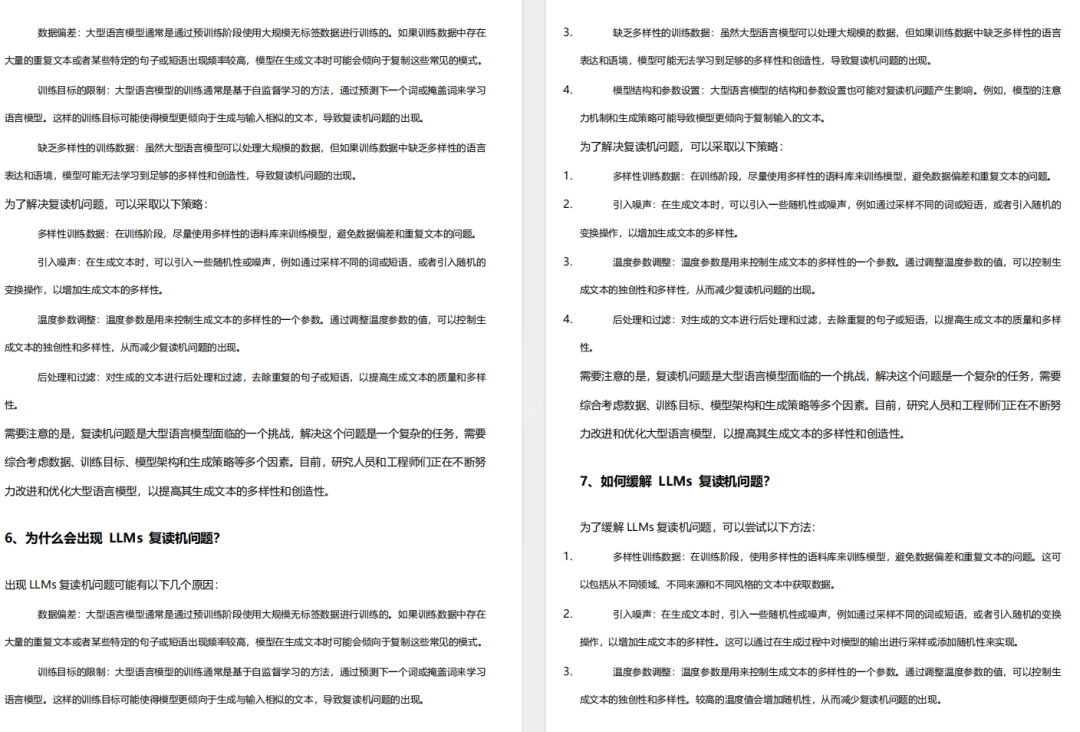
5、面试试题/经验
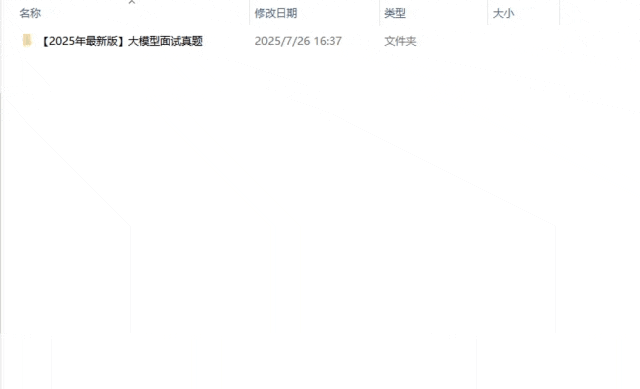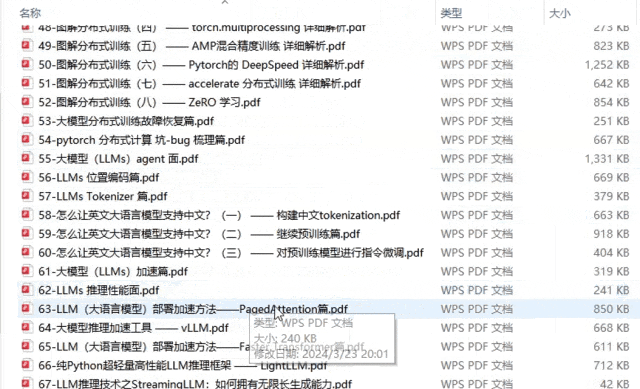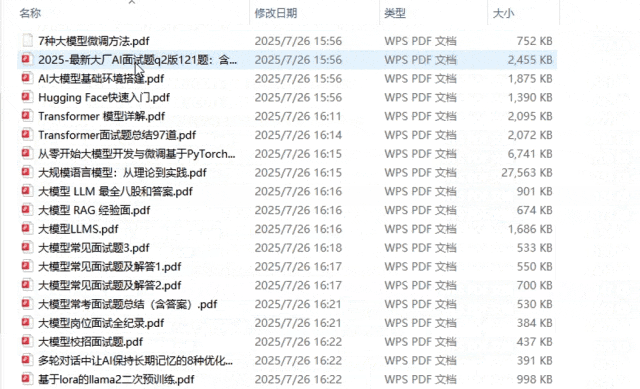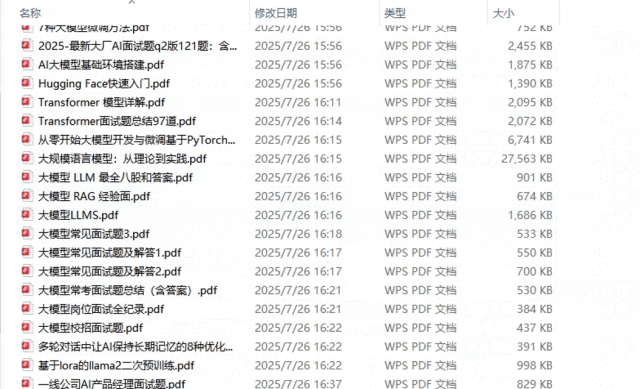
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
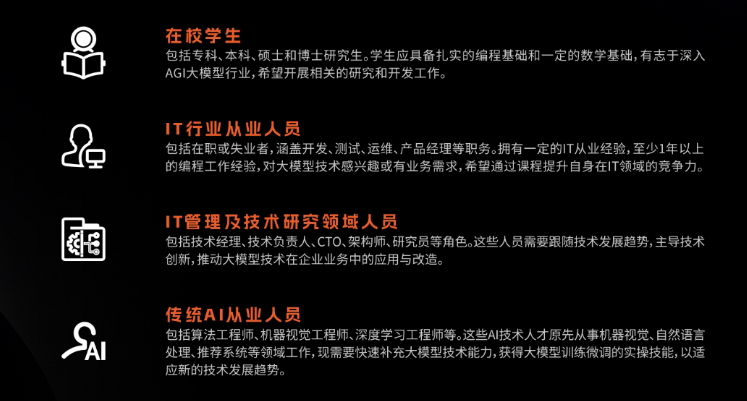
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
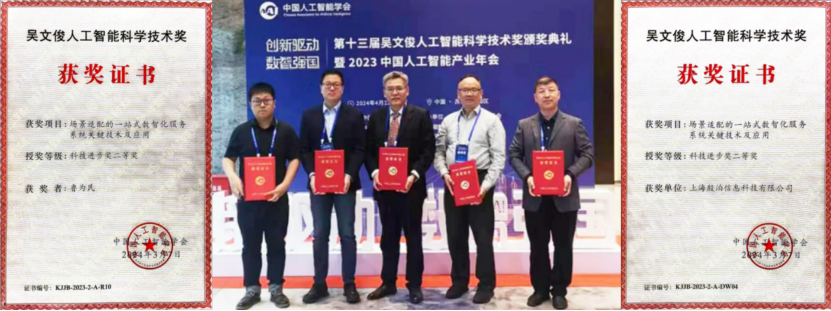
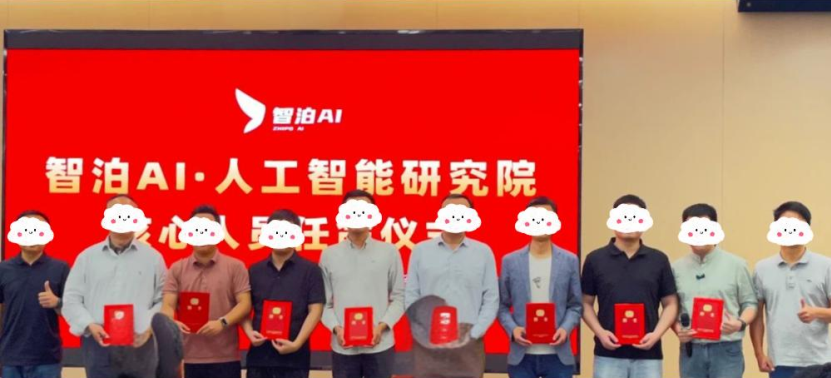
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

更多推荐



 5
 0
- 0


 已为社区贡献484条内容

所有评论(0)