
dlib库人脸检测
一.dlib人脸检测
一.基于dlib人脸检测的两种方法
dlib 的人脸检测功能在计算机视觉领域应用广泛,它提供了基于传统机器学习(HOG)和深度学习(CNN)的两种成熟方案,让开发者可以根据项目需求在速度和精度之间灵活选择。
二.核心原理
HOG + 线性SVM模型(传统方法):这是 dlib 默认且最常用的检测器,其核心流程如下:
- HOG 特征提取:先将图像划分为小的细胞单元(如8x8像素),计算每个单元内像素的梯度方向直方图,以此来捕捉人脸的边缘和轮廓特征(如眼睛、鼻子、嘴巴的形状)。
- 滑动窗口检测:使用一个固定大小的窗口(如64x64像素)在图像上滑动,并对每个窗口内的 HOG 特征进行分类。
- SVM 分类器:dlib 使用预训练的线性支持向量机(SVM)来判断窗口内的特征是否构成人脸。SVM 通过寻找一个最优超平面来区分人脸和非人脸区域。
- 多尺度与后处理:为了检测不同大小的人脸,dlib 会构建图像金字塔,在多个缩放尺度上运行检测器。最后,使用非极大值抑制(NMS)来合并重叠的检测框,保留置信度最高的结果。
CNN模型(深度学习方法):这是 dlib 提供的基于深度学习的高精度检测器,其底层架构为 MMOD(Max-Margin Object Detection)。它使用卷积神经网络自动学习人脸的高层语义特征,能够直接预测人脸边界框的坐标和置信度,因此在复杂场景下表现更好。
三.使用方法
1.导入dlib库,创建人脸检测器(使用H0G算法、线性分类器、金字塔图像结构和滑动窗口检测等技术),读入图片img。
import dlib
detector = dlib.get_frontal_face_detector()
img = cv2.imread('reba2.webp')
2.使用人脸检测器检测图像中的人脸,返回检测到的人脸框。(detector)
- image:待检测的可能含有人脸的图像。
- n:表示采用上采样的次数。上采样会让图像变大,能够检测到更多人脸对象,提高小人脸的检测效果。通常建议将此参数设置为 0 或 1。较大的值会增加检测的准确性,但会降低处理速度。
- faces:返回检测图像中的所有人脸框。
faces = detector(img, 0)
3.遍历人脸框,获取每个人脸框的坐标,分别绘制出每张人脸。
for face in faces:
    # 获取人脸框的坐标
    x1 = face.left()
    y1 = face.top()
    x2 = face.right()
    y2 = face.bottom()
    # 绘制人脸
    cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
4.显示捕获到的人脸框
cv2.imshow('img', img)
cv2.waitKey(0)
cv2.destroyAllWindows()
5.运行结果,效果不错
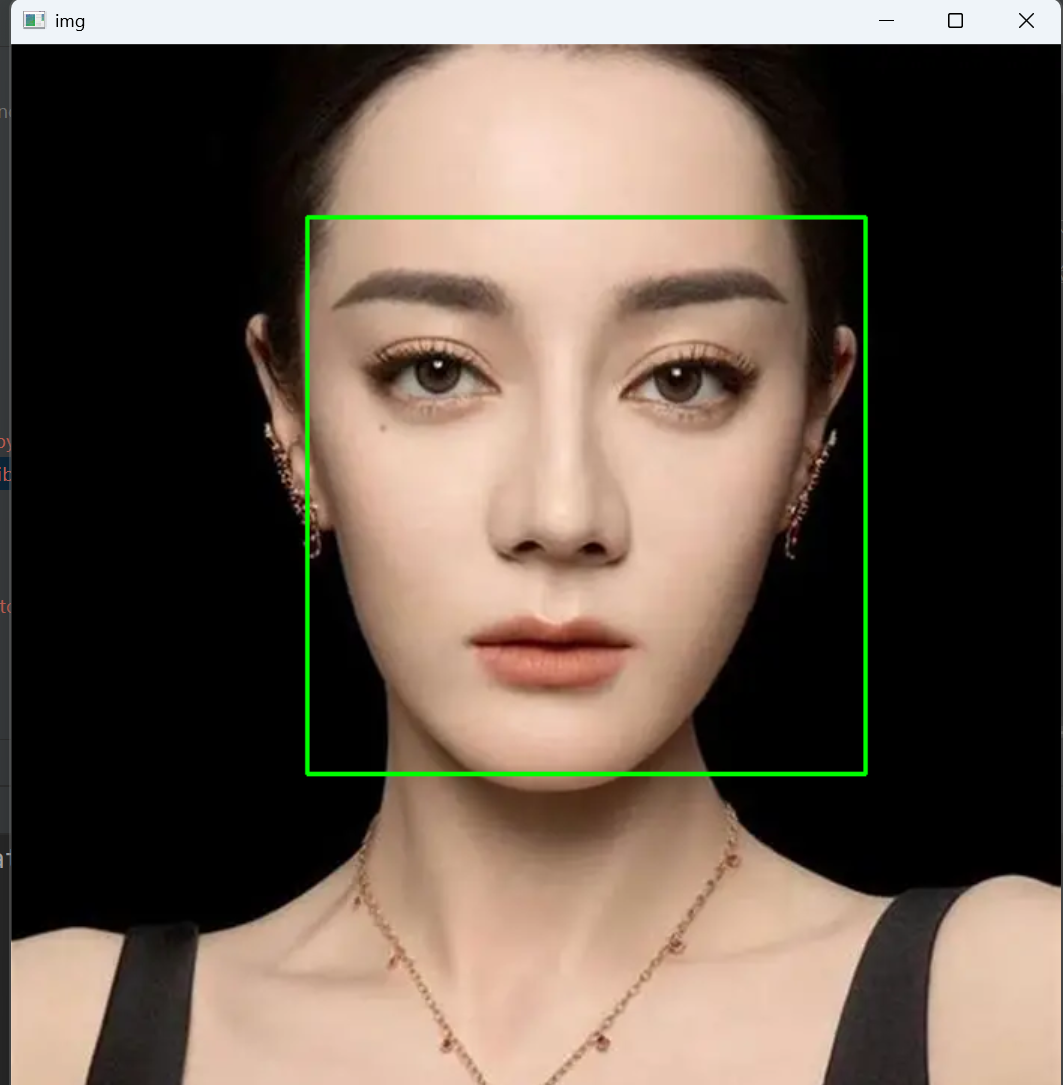
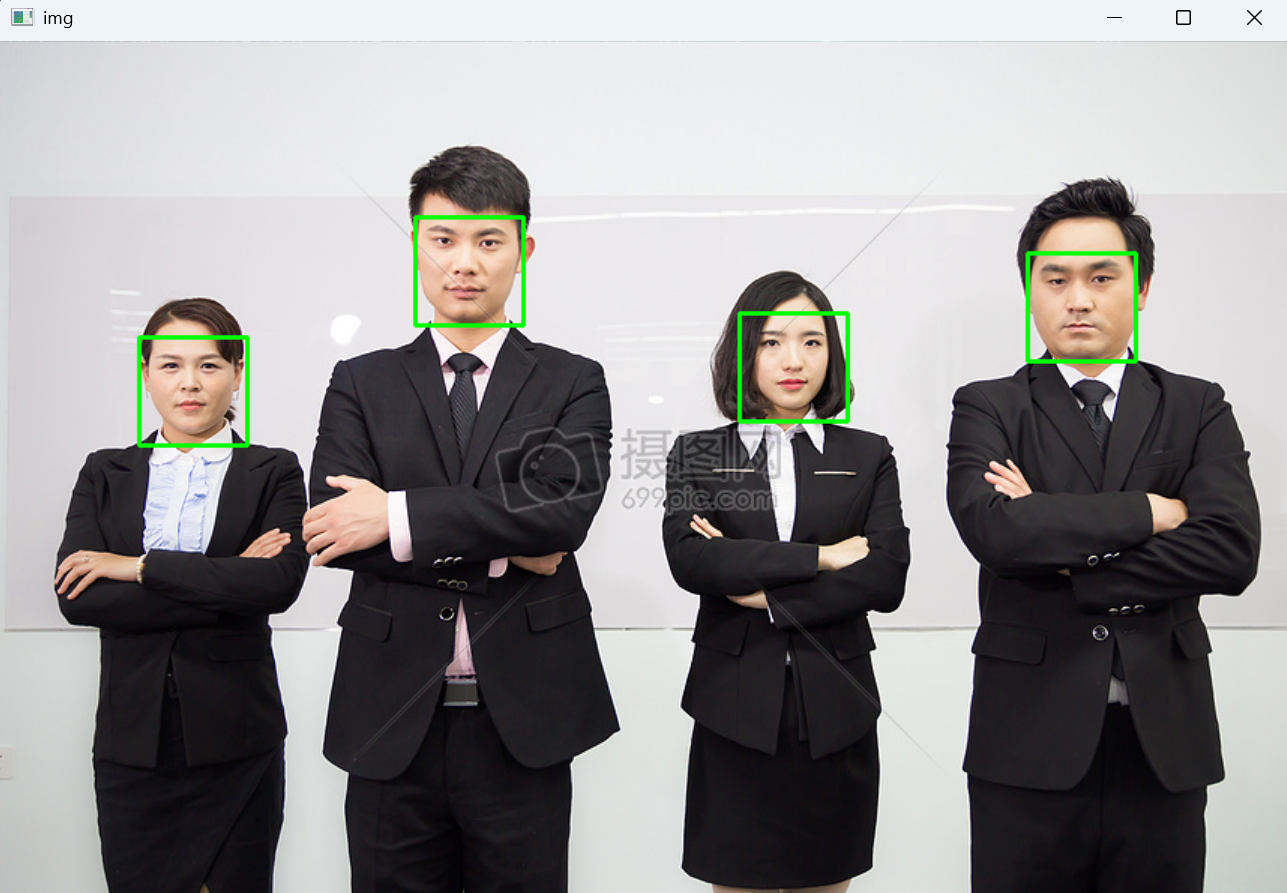
二.dlib与opencv人脸检测的对比
下表从算法原理、性能表现和适用场景等维度,对 OpenCV 与 dlib 的常见人脸检测方案进行对比:
| 方案 | 算法原理 | 特点 |
|---|---|---|
| OpenCV Haar 级联 | 基于图像灰度值的矩形特征差异,使用 AdaBoost 级联分类器 | 经典快速,但对光照、姿态和遮挡非常敏感,误检率相对较高 |
| OpenCV DNN 模块 | 一个推理引擎,可加载预训练的深度学习模型(如 SSD、Caffe) | 精度高、鲁棒性强,通常作为现代应用的首选 |
| dlib HOG + SVM | 提取图像的梯度方向直方图特征,使用线性 SVM 分类 | CPU 上的速度标杆,在正面和轻微非正面人脸上表现稳健 |
| dlib CNN (MMOD) | 基于最大边距目标检测的深度学习模型 | 精度极高,对遮挡、姿态变化鲁棒,但在无 GPU 加速时速度很慢 |
检测人脸时的区别,opencv检测到的人脸范围较大,dlib检测到的人脸范围较小,可以看到左边把额头大部分都框进去了,右边却没有。
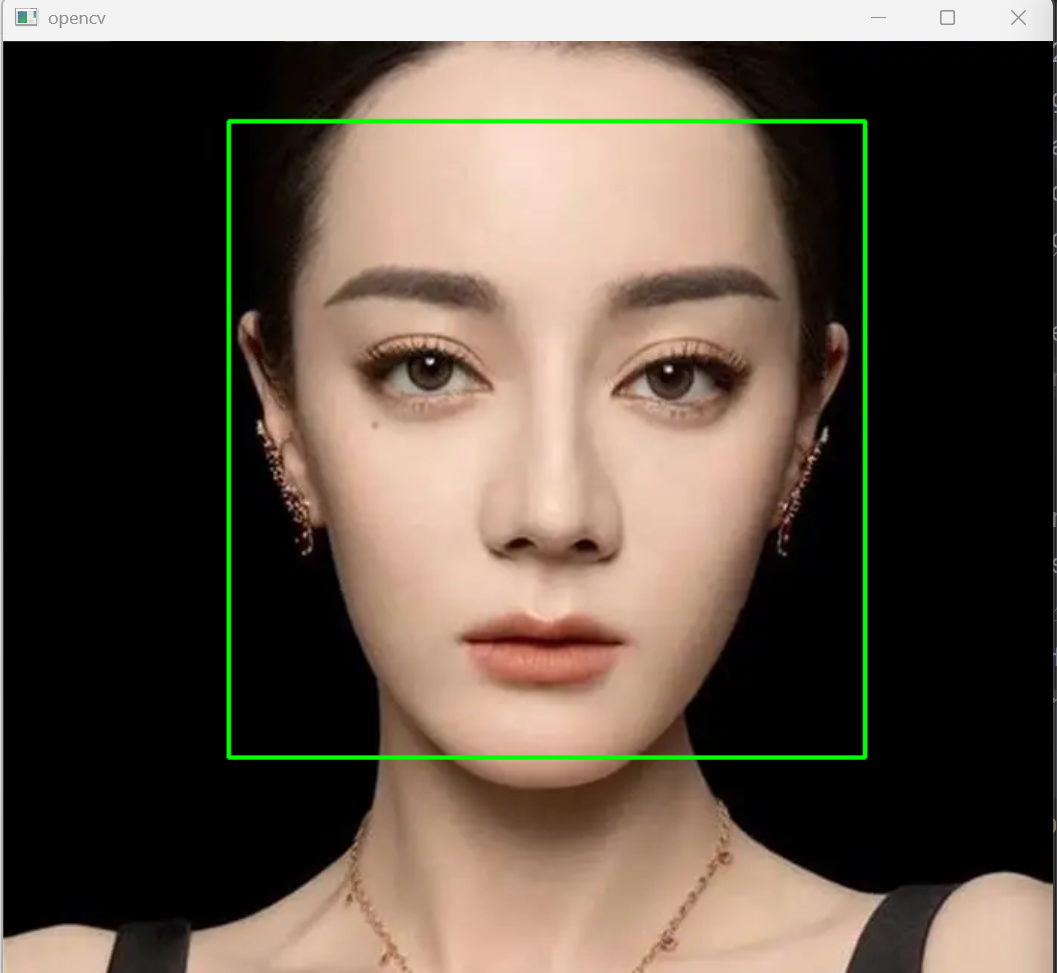
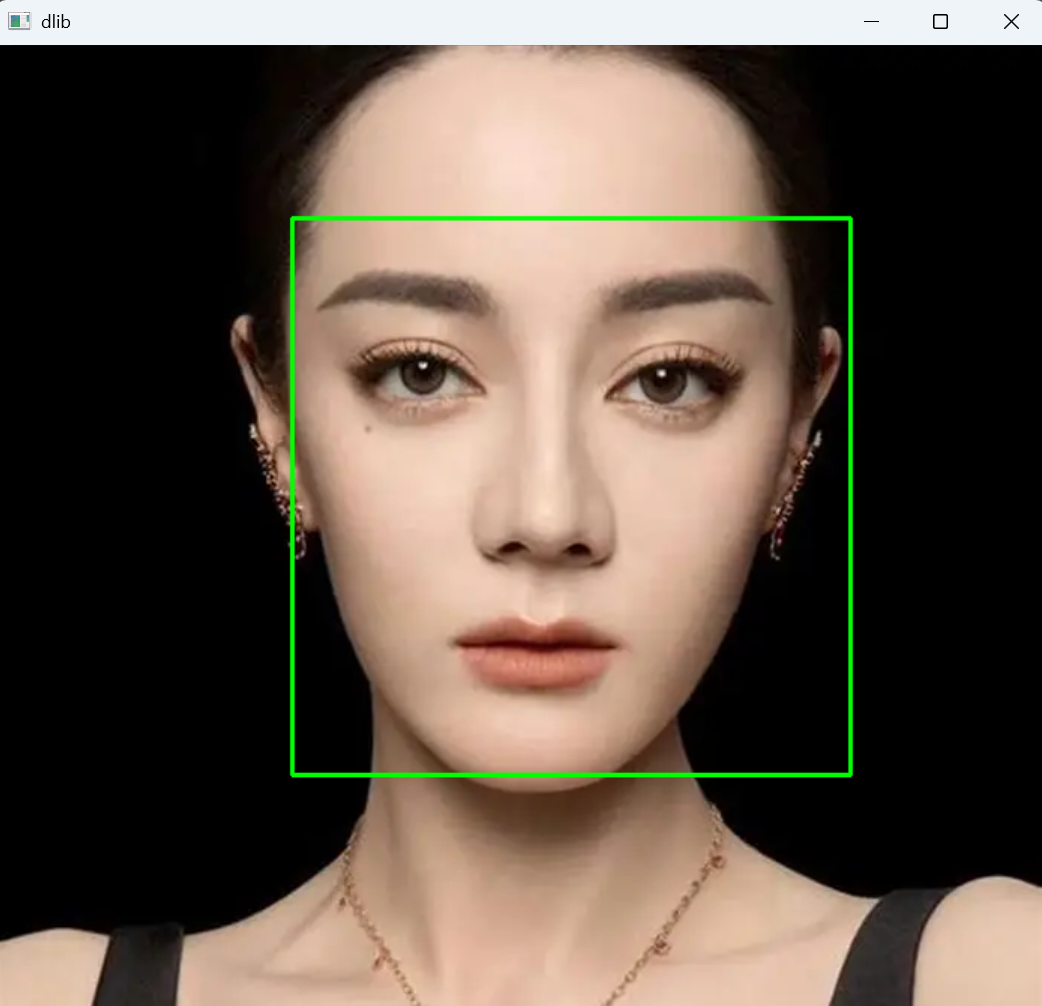
三.dlib实现关键点定位
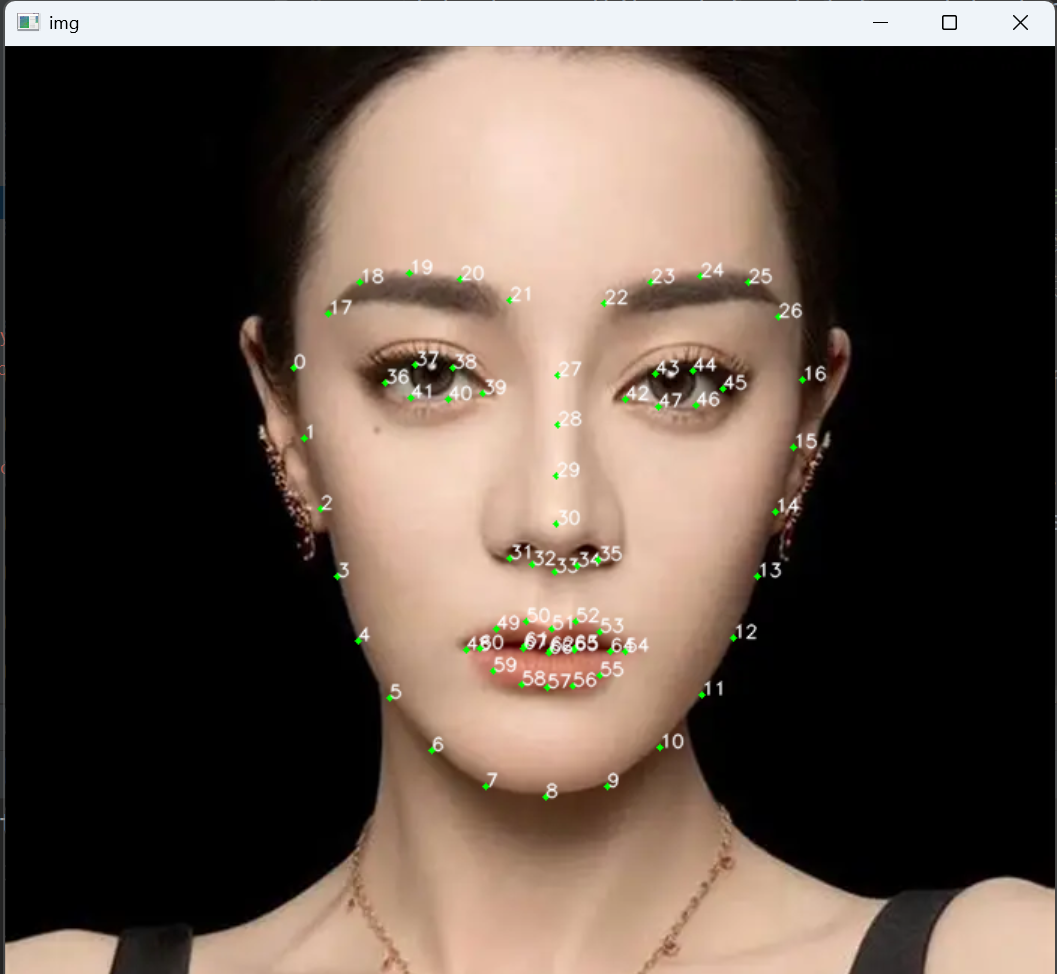
这里需要加载 dlib 官方预训练的 68 点人脸关键点检测器。它的核心作用不是判断“图里有没有人脸”,而是在已经知道人脸位置(矩形框)的前提下,进一步定位人脸上的 68 个特征点坐标。 包括眼睛、鼻子、眉毛、轮廓等
(shape_predictor_68_face_landmarks.dat)
使用方法
1.导入opencv,dlib,numpy库
import cv2
import dlib
import numpy as np
2.加载图片,生成人脸检测器,对图片进行人脸检测,返回检测图像中的所有人脸,载入模型(加载预测器,人脸68关键点检测器)
img = cv2.imread("./reba2.webp")
detector = dlib.get_frontal_face_detector()
faces = detector(img, 0)
predictor = dlib.shape_predictor("./shape_predictor_68_face_landmarks.dat")
3.遍历每一张人脸,获取他们的关键点,将关键点转换为坐标(xy)的形式
for face in faces:  # 获取每一张脸的关键点(实现检测)
    shape = predictor(img, face)  # 获取关键点
    # 将关键点转换为坐标(xy)的形式
    # landmarks = np.matrix([[p.x, p.y] for p in shape.parts()])
    landmarks = np.array([[p.x, p.y] for p in shape.parts()])
4.绘制每一张脸的关键点(绘制shape中的每个点),
    for idx, point in enumerate(landmarks):
        # 当前关键点的坐标
        pos = [point[0], point[1]]
        # 针对当前关键点,绘制一个实心圆
        cv2.circle(img, pos, 2, (0, 255, 0), thickness=-1)
                                        # 普通大小的等宽字体
        cv2.putText(img, str(idx), pos, cv2.FONT_HERSHEY_SIMPLEX, 0.4,
                    (255, 255, 255), 1, cv2.LINE_AA)  # 线条类型:抗齿线条
cv2.putText 用于在图像上绘制文本,各参数含义如下:
- img:要绘制文本的目标图像。
- str(idx):要绘制的文本内容,这里将当前关键点的索引 idx 转为字符串,用于标注每个关键点的编号。
- pos:文本左下角的起始坐标,即当前关键点的位置 (x, y)。
- cv2.FONT_HERSHEY_SIMPLEX:字体类型,表示使用普通大小的衬线字体。
- 0.4:字体缩放比例,数值越小文字越小,这里用于在关键点附近绘制较小的编号。
- (255, 255, 255):文本颜色,这里为白色(BGR 顺序)。
- 1:线条粗细,即文字的笔画宽度,数值越大文字越粗。
- cv2.LINE_AA:线条类型,表示使用抗锯齿线条,让文字边缘更平滑。
5.展示图片
cv2.imshow("img", img)
cv2.waitKey(0)
cv2.destroyAllWindows()
6.运行结果
四.轮廓绘制
使用方法
1.导入库
import numpy as np
import dlib
import cv2
2.读取图片,创建人脸位置检测器,检测人脸,读取人脸关键点定位模型
image = cv2.imread("reba2.webp")
detector = dlib.get_frontal_face_detector()  # 构造脸部位置检测器
faces = detector(image, 0)  # 检测人脸方位置
# 读取人脸关键点定位模型
predictor = dlib.shape_predictor("./shape_predictor_68_face_landmarks.dat")
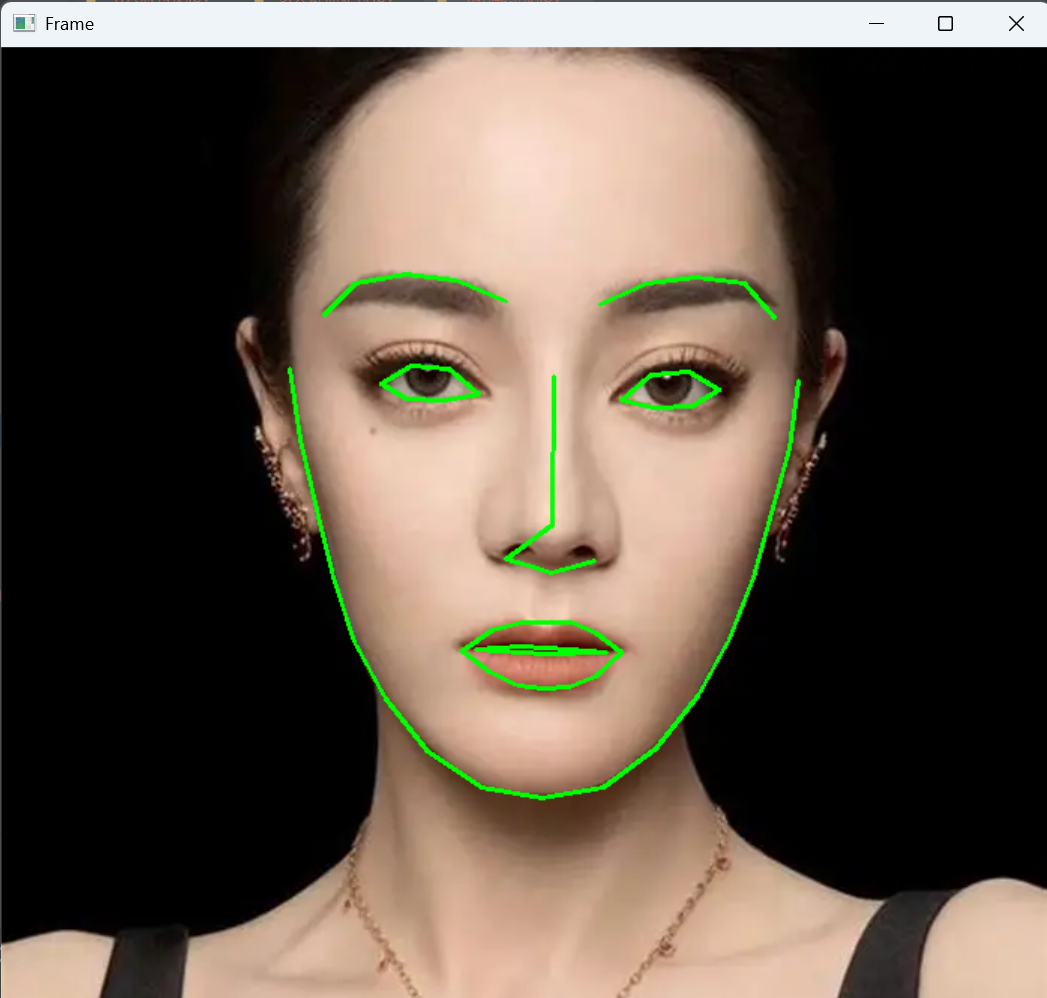
3.遍历人脸,获取关键点位置,将关键点转换为坐标(x,y)的形式,分别绘制凸包和点线。
凸包(Convex Hull):在平面几何中,凸包是指包含一组点集的最小凸多边形。直观理解,可以想象用一根橡皮筋把所有点紧紧箍住,橡皮筋最终形成的形状就是这组点的凸包。凸包上的任意两点连线都完全落在凸包内部或边界上,因此它能够简洁地勾勒出点集的外围轮廓。
在人脸关键点定位中,凸包常用于将离散的关键点连接成平滑的轮廓区域。例如,将眼睛周围的关键点(如索引 36 到 41)求凸包后,可以绘制出覆盖整个眼部的闭合区域,从而更直观地展示眼睛、嘴巴等部位的形状和范围。
for face in faces: # 对检测到的rects,逐个遍历
    shape = predictor(image, face)  # 获取关键点
    # 将关键点转换为坐标(x,y)的形式
    shape = np.array([[p.x, p.y] for p in shape.parts()])
    drawConvexHull(36, 41)      # 绘制右眼凸包
    drawConvexHull(42,47)       # 绘制左眼凸包
    drawConvexHull(48,59)       # 绘制嘴外部凸包
    drawConvexHull(60,67)       # 绘制嘴内部凸包
    drawLine(0, 17)     # 绘制脸颊点线
    drawLine(17,22)     # 绘制左眉毛点线
    drawLine(22,27)     # 绘制右眉毛点线
    drawLine(27,36)  </code></pre>
函数1:
drawConvexHull(start, end):这是一个自定义函数,用于将指定范围内的关键点构成一个凸包,并绘制成轮廓。一般眼睛、嘴巴等部位使用凸包来绘制,各参数含义如下:
- start:起始关键点的索引,表示从第几个关键点开始取点。
- end:结束关键点的索引,表示取到第几个关键点为止。
- Facial = shape[start : end+1]:从全部 68 个关键点中截取索引从 start 到 end 的这一段点集。因为切片是左闭右开,所以结束位置要写成 end+1 才能把第 end 个点包含进来。
- mouthHull = cv2.convexHull(Facial):调用 OpenCV 的凸包函数,对截取出的点集求凸包,得到包围这些点的最小凸多边形顶点集合。
- cv2.drawContours(image, [mouthHull], -1, (0, 255, 0), 2):把求得的凸包绘制到图像上。其中 image 是目标图像,[mouthHull] 表示要绘制的轮廓列表,-1 表示绘制所有轮廓,颜色为绿色 (0, 255, 0),线宽为 2 像素。
def drawConvexHull(start,end):
    # 将指定的点构成一个凸包,绘制成轮廓,一般眼睛、嘴使用凸包用来绘制
    Facial = shape[start: end+1]
    mouthHull = cv2.convexHull(Facial)  # 凸包函数
    cv2.drawContours(image, [mouthHull], -1, (0, 255, 0), 2)
函数2:
drawLine(start, end):这是一个自定义函数,用于将指定范围内的关键点按顺序用线段连接起来,绘制成点线轮廓。一般眉毛、鼻子、脸颊等部位使用点线来绘制,各参数含义如下:
- start:起始关键点的索引,表示从第几个关键点开始取点。
- end:结束关键点的索引,表示取到第几个关键点为止。
- pts = shape[start : end]:从全部 68 个关键点中截取索引从 start 到 end-1 的这一段点集。因为切片是左闭右开,所以第 end 个点不会被包含进来。
- for l in range(1, len(pts)):从第 1 个点开始遍历到最后一个点,每次取相邻的两个点来画线。
- ptA = tuple(pts[l - 1]):取当前线段的前一个点,并转换为元组形式,作为线段的起点。
- ptB = tuple(pts[l]):取当前线段的后一个点,并转换为元组形式,作为线段的终点。
- cv2.line(image, ptA, ptB, (0, 255, 0), 2):在图像上从 ptA 到 ptB 绘制一条直线。其中 image 是目标图像,颜色为绿色 (0, 255, 0),线宽为 2 像素。
def drawLine(start,end):
    pts = shape[start:end] # 获取点集
    for l in range(1, len(pts)):
        ptA = tuple(pts[l - 1])
        ptB = tuple(pts[l])
        cv2.line(image, ptA, ptB, (0, 255, 0), 2)
4.展示图片
cv2.imshow("Frame", image)
cv2.waitKey(0)
cv2.destroyAllWindows()
5.运行结果
五.笑容检测
使用方法
1.导包
import numpy as np
import dlib
import cv2
from sklearn.metrics.pairwise import euclidean_distances  # 计算欧氏距离
from PIL import Image, ImageDraw, ImageFont
2.创建人脸检测器, 检测人脸,读取人脸关键点定位模型,读入两张图片,frame1,frame2,检测人脸返回faces1,2.
detector = dlib.get_frontal_face_detector()
predictor = dlib.shape_predictor("./shape_predictor_68_face_landmarks.dat")
frame1 = cv2.imread("2.jpg")
frame2 = cv2.imread("3.jpg")
faces1 = detector(frame1, 0)
faces2 = detector(frame2, 0)
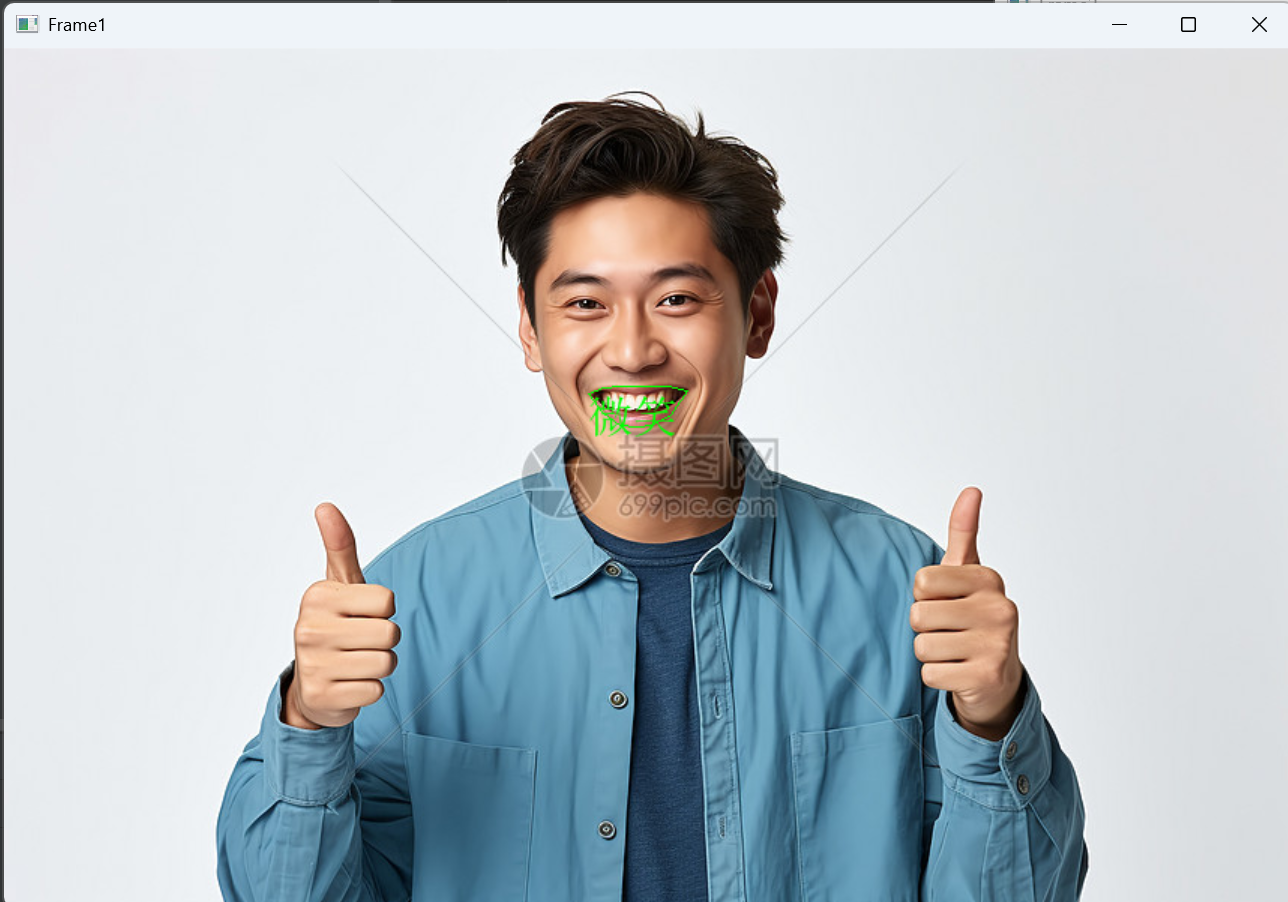
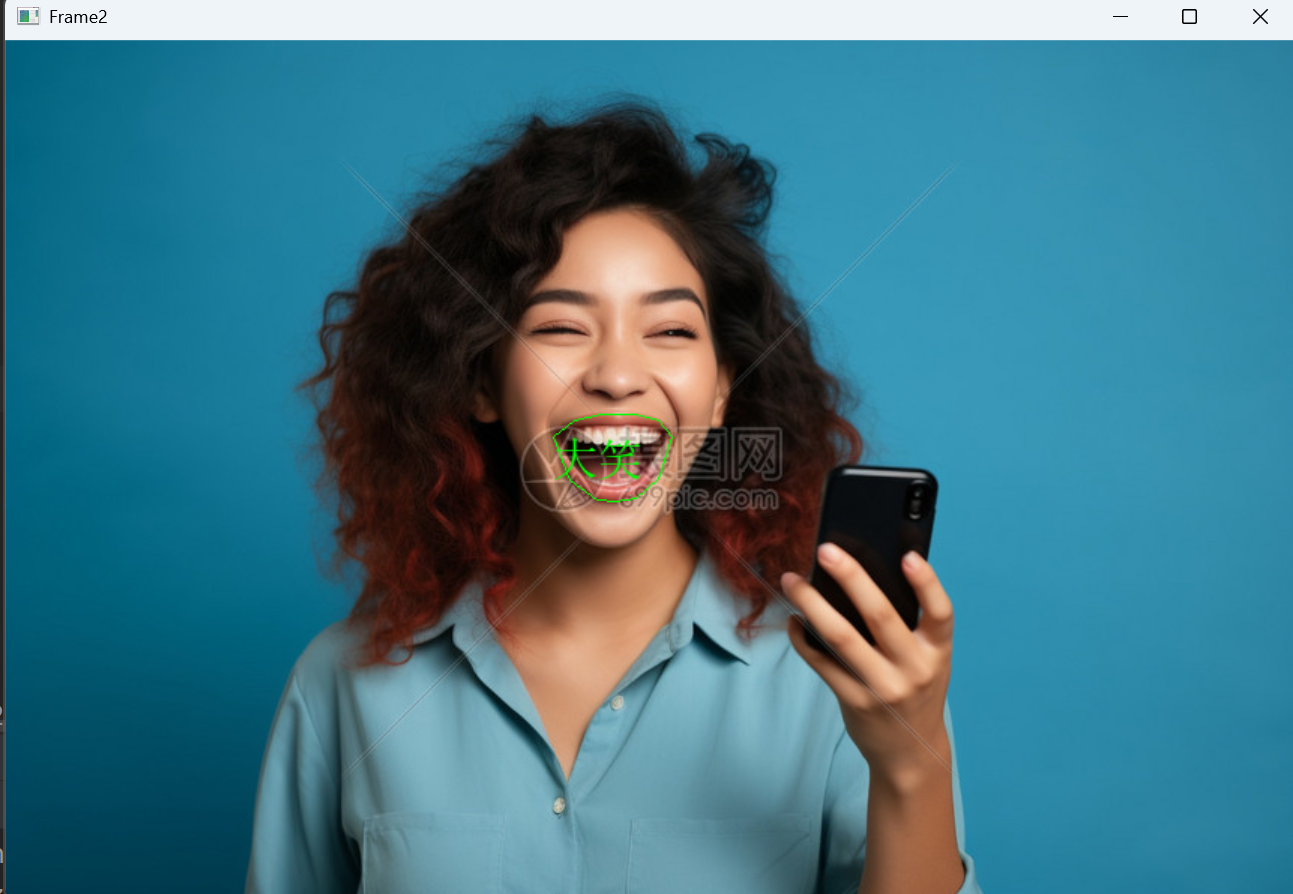
3.遍历人脸,获取关键点位置,将关键点转换为坐标(x,y)的形式,调用MAR函数,计算嘴部的高宽比,调用MJR函数,计算嘴宽/脸颊宽,默认表情为正常,当我们的嘴部的高宽比大于0.5,表情变为大笑;当我们的嘴宽/脸颊宽大于0.45,表情为微笑,将嘴部形状绘制为凸包,把我们的中文文字添加到图片上,最后画出轮廓。
for face in faces1:
    shape = predictor(frame1, face)  # 获取关键点
    # 将关键点转换为坐标(x, y)的形式
    shape = np.array([[p.x, p.y] for p in shape.parts()])
    mar = MAR(shape)    # 计算嘴部的高宽比
    mjr = MJR(shape)    # 计算“嘴宽/脸颊宽”
    result = "正常"      # 默认是正常表情
    print("mar", mar, "\tmjr", mjr)     # 测试一下实际值,可以根据该值确定
    if mar > 0.5:   # 可更具项目要求调整阈值。
        result="大笑"
    elif mjr > 0.45:  # 超过闽值为微笑
        result = "微笑"
    mouthHull = cv2.convexHull(shape[48:61])  # 构造嘴型凸包
    frame1 = cv2AddChineseText(frame1, result, mouthHull[0,0]) # 多人脸
    cv2.drawContours(frame1, [mouthHull], -1, (0, 255, 0), 1)
函数1:
MAR(shape):这是一个自定义函数,用于计算嘴部的高宽比(Mouth Aspect Ratio),通过比较嘴部关键点的纵向距离与横向距离来判断嘴巴的张开程度,从而辅助识别笑容。各参数含义如下:
- shape:包含 68 个人脸关键点坐标的数组,每个元素为 (x, y) 形式的坐标。
- A = euclidean_distances(shape[50].reshape(1, 2), shape[58].reshape(1, 2)):计算第 50 号关键点与第 58 号关键点之间的欧氏距离,即嘴部左侧上下唇之间的垂直距离。
- B = euclidean_distances(shape[51].reshape(1, 2), shape[57].reshape(1, 2)):计算第 51 号关键点与第 57 号关键点之间的欧氏距离,即嘴部中间上下唇之间的垂直距离。
- C = euclidean_distances(shape[52].reshape(1, 2), shape[56].reshape(1, 2)):计算第 52 号关键点与第 56 号关键点之间的欧氏距离,即嘴部右侧上下唇之间的垂直距离。
- D = euclidean_distances(shape[48].reshape(1, 2), shape[54].reshape(1, 2)):计算第 48 号关键点与第 54 号关键点之间的欧氏距离,即嘴部左右两侧嘴角之间的水平距离(嘴宽)。
- return ((A + B + C) / 3) / D:先对 A、B、C 三个垂直距离取平均值,得到嘴部的平均高度,再除以嘴宽 D,得到嘴部的高宽比。嘴巴张得越大,该比值越大,因此可通过设定阈值(如 0.5)来判断是否在大笑。
def MAR(shape):
    A = euclidean_distances(shape[50].reshape(1, 2), shape[58].reshape(1, 2))
    B = euclidean_distances(shape[51].reshape(1, 2), shape[57].reshape(1, 2))
    C = euclidean_distances(shape[52].reshape(1, 2), shape[56].reshape(1, 2))
    D = euclidean_distances(shape[48].reshape(1, 2), shape[54].reshape(1, 2))
    return ((A + B + C) / 3) / D
函数2:
MJR(shape):这是一个自定义函数,用于计算嘴宽与脸颊宽的比值(Mouth-to-Jaw Ratio),通过比较嘴部宽度与下颌宽度来判断嘴巴的横向张开程度,从而辅助识别微笑。各参数含义如下:
- shape:包含 68 个人脸关键点坐标的数组,每个元素为 (x, y) 形式的坐标。
- M = euclidean_distances(shape[48].reshape(1, 2), shape[54].reshape(1, 2)):计算第 48 号关键点与第 54 号关键点之间的欧氏距离,即嘴部左右两侧嘴角之间的水平距离(嘴宽)。
- J = euclidean_distances(shape[3].reshape(1, 2), shape[13].reshape(1, 2)):计算第 3 号关键点与第 13 号关键点之间的欧氏距离,即下颌左右两侧之间的宽度(脸颊宽)。
- return M / J:用嘴宽 M 除以脸颊宽 J,得到嘴宽与脸颊宽的比值。微笑时嘴角向两侧拉伸,嘴宽相对脸颊变宽,该比值会增大,因此可通过设定阈值(如 0.45)来判断是否为微笑。
def MJR(shape):
    M = euclidean_distances(shape[48].reshape(1, 2), shape[54].reshape(1, 2))  # 嘴宽度
    J = euclidean_distances(shape[3].reshape(1, 2), shape[13].reshape(1, 2))  # 下颌的宽度
    return M / J
函数3:
cv2AddChineseText(img, text, position, textColor, textSize):这是一个自定义函数,用于在 OpenCV 图像上绘制中文文本。由于 OpenCV 自带的 cv2.putText 不支持中文,因此借助 PIL(Pillow)库来实现中文的绘制。各参数含义如下:
- img:要绘制中文的目标图像,通常为 OpenCV 读取的 BGR 格式图像。
- text:要绘制的文本内容,这里传入的是表情识别结果,如“正常”“微笑”“大笑”等中文文字。
- position:文本绘制的起始坐标,即文本左上角在图像上的位置 (x, y)。
- textColor:文本颜色,默认值为 (0, 255, 0),即绿色(RGB 顺序)。
- textSize:字体大小,默认值为 30,数值越大文字越大。
- isinstance(img, np.ndarray):判断传入的图像是否为 OpenCV 的 numpy 数组类型。如果是,则说明是 OpenCV 图像,需要先转换为 PIL 图像才能绘制中文。
- cv2.cvtColor(img, cv2.COLOR_BGR2RGB):将 OpenCV 的 BGR 颜色空间转换为 PIL 使用的 RGB 颜色空间,避免颜色显示错乱。
- Image.fromarray(...):将 numpy 数组转换为 PIL 的 Image 对象。
- ImageDraw.Draw(img):在 PIL 图像上创建一个绘图对象,后续的文本绘制操作都通过它来完成。
- ImageFont.truetype('simsun.ttc', textSize, encoding="utf-8"):加载中文字体文件(宋体 simsun.ttc),并指定字体大小和 utf-8 编码,确保中文能够正常显示。
- draw.text(position, text, textColor, font=fontStyle):在指定位置绘制文本,其中 position 是坐标,text 是内容,textColor 是颜色,font 是字体样式。
- cv2.cvtColor(np.array(img), cv2.COLOR_RGB2BGR):绘制完成后,将 PIL 图像转换回 numpy 数组,并把 RGB 颜色空间转换回 OpenCV 使用的 BGR 格式,最后返回给调用方继续处理
def cv2AddChineseText(img, text, position, textColor=(0, 255, 0), textSize=30):
    """向图片中添加中文"""
    if (isinstance(img, np.ndarray)):  # 判断是否0penCV图片类型
        img = Image.fromarray(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))  # 实现array到image的转换
    draw = ImageDraw.Draw(img)  # 在img图片上创建一个绘图的对象
    # 字体的格式
    fontStyle = ImageFont.truetype('simsun.ttc', textSize, encoding="utf-8")
    draw.text(position, text, textColor, font=fontStyle)  # 绘制文本
    return cv2.cvtColor(np.array(img), cv2.COLOR_RGB2BGR)  # 转换回0penCV格式
4.展示图片
cv2.imshow("Frame1", frame1)
cv2.imshow("Frame2", frame2)
cv2.waitKey(0)
cv2.destroyAllWindows()
5.运行结果
更多推荐

 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)