
AI Agent 工具越多越聪明吗?今天的热点告诉你:真正难的是“让 Agent 一直可靠地干活
最近几天刷 CSDN,会发现一个很有意思的变化。
大家已经不太满足于讨论“这个模型有多强”了。
开始讨论:
Agent 能不能连续工作?
工具越来越多以后,会不会反而变笨?
任务跑几十分钟,中途挂了怎么办?
AI Agent 能不能自己处理代码、文件、终端和外部系统?
到底需要一个超级 Agent,还是应该让多个 Agent 分工?
这些问题,其实正在把 AI Agent 从“聊天机器人”推向真正的软件系统。
一、今天的 AI Agent 热点,正在发生一个变化
2026 年 9 月 13 日,CSDN 上最新的 AI 内容里,有几个方向非常值得关注。
一个方向是在研究:
怎么让终端 Agent 的训练环境自动变难。
近期一篇论文《Environment Evolution for Terminal Agents》提出了“环境进化”,核心思路是随着 Agent 能力提高,让训练环境持续增加难度,从而继续给 Agent 提供足够强的训练信号。论文在 Terminal-Bench 2.1 上报告了明显的性能提升。
另一个方向则恰恰相反:
工具太多,会不会让 Agent 变得更混乱?
CSDN 今天就出现了关于 Salesforce “装备膨胀”导致智能体遗忘危机的讨论:当工具、技能和协作智能体越来越多时,Agent 如何利用新增能力,同时避免上下文和决策压力成为新的问题。
再往前一步,OpenAI 在 9 月 10 日推出了 Agents API 公测版,直接把 Codex 背后的 Agent Harness、长会话、上下文管理、恢复机制以及工具和 MCP 接入能力作为基础设施提供出来。
这几个新闻放在一起看,其实特别有意思:
Agent 的竞争,正在从“模型有多聪明”,变成“Agent 系统能不能长期稳定地完成任务”。
二、AI Agent 为什么越来越像一个“软件系统”?
最开始我们理解 Agent,可能非常简单:
用户
 ↓
大模型
 ↓
调用工具
 ↓
返回结果
但真实场景根本没有这么简单。
例如用户说:
“帮我分析这个 Python 项目,然后找到 Bug 并修复,最后把测试跑通。”
Agent 真正需要做的是:
理解任务
   ↓
读取项目
   ↓
分析代码
   ↓
查找问题
   ↓
修改代码
   ↓
运行测试
   ↓
分析测试结果
   ↓
发现问题
   ↓
继续修改
   ↓
再次测试
   ↓
最终完成
这已经不是一次 API 调用了。
它更像一个:
持续运行的任务执行系统。
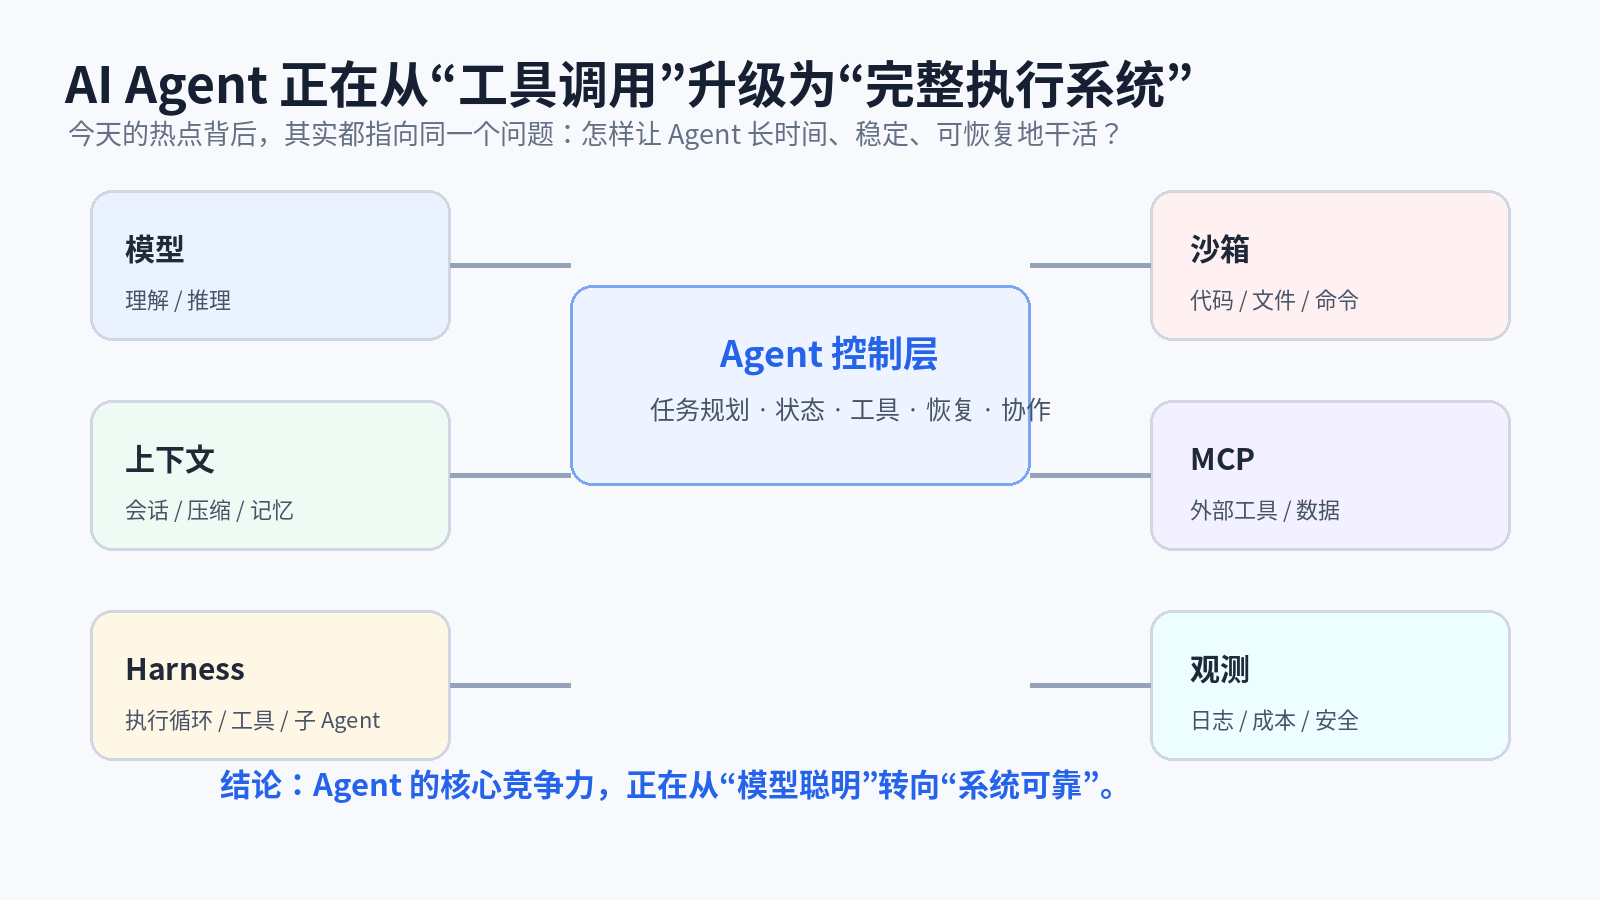
所以现在真正难的不是:
“怎么让 Agent 调一次工具?”
而是:
“怎么让 Agent 在连续几十甚至几百步操作之后,依然知道自己在干什么?”
三、为什么“工具越多”不一定越好?
这是今天我觉得最值得写的一点。
以前我们会觉得:
Agent 有 5 个工具
很好。
然后:
Agent 有 50 个工具
更强。
再然后:
Agent 有 500 个工具
是不是无敌了?
答案是:
不一定。
CSDN 今天出现的“装备膨胀”讨论,本质就是在提醒大家:工具、Skills、协作 Agent 不断增加之后,模型也需要处理更大的能力集合,工具选择和上下文管理本身就可能变成负担。
四、工具太多,为什么反而会让 Agent 变复杂?
我们假设一个 Agent 有下面这些能力:
GitHub
数据库
搜索
文件系统
浏览器
Shell
邮件
日历
代码分析
图片处理
知识库
CRM
ERP
……
用户只说了一句话:
“帮我分析一下这个项目。”
Agent 现在要做的第一件事情反而变复杂了:
到底应该用哪个工具?
甚至可能有:
工具 A:可以读取代码
工具 B:也可以读取代码
工具 C:可以搜索 GitHub
工具 D:可以直接操作 Git
工具 E:既能搜索又能读文件
这时候问题就出现了:
能力变多,不代表决策变简单。
五、这就是 Agent 的“装备膨胀”
可以把它理解成:
工具越来越多
      ↓
可用能力越来越多
      ↓
上下文越来越大
      ↓
选择空间越来越大
      ↓
决策成本越来越高
于是就出现一个很有意思的问题:
一个 Agent 到底需要多少工具才刚刚好?
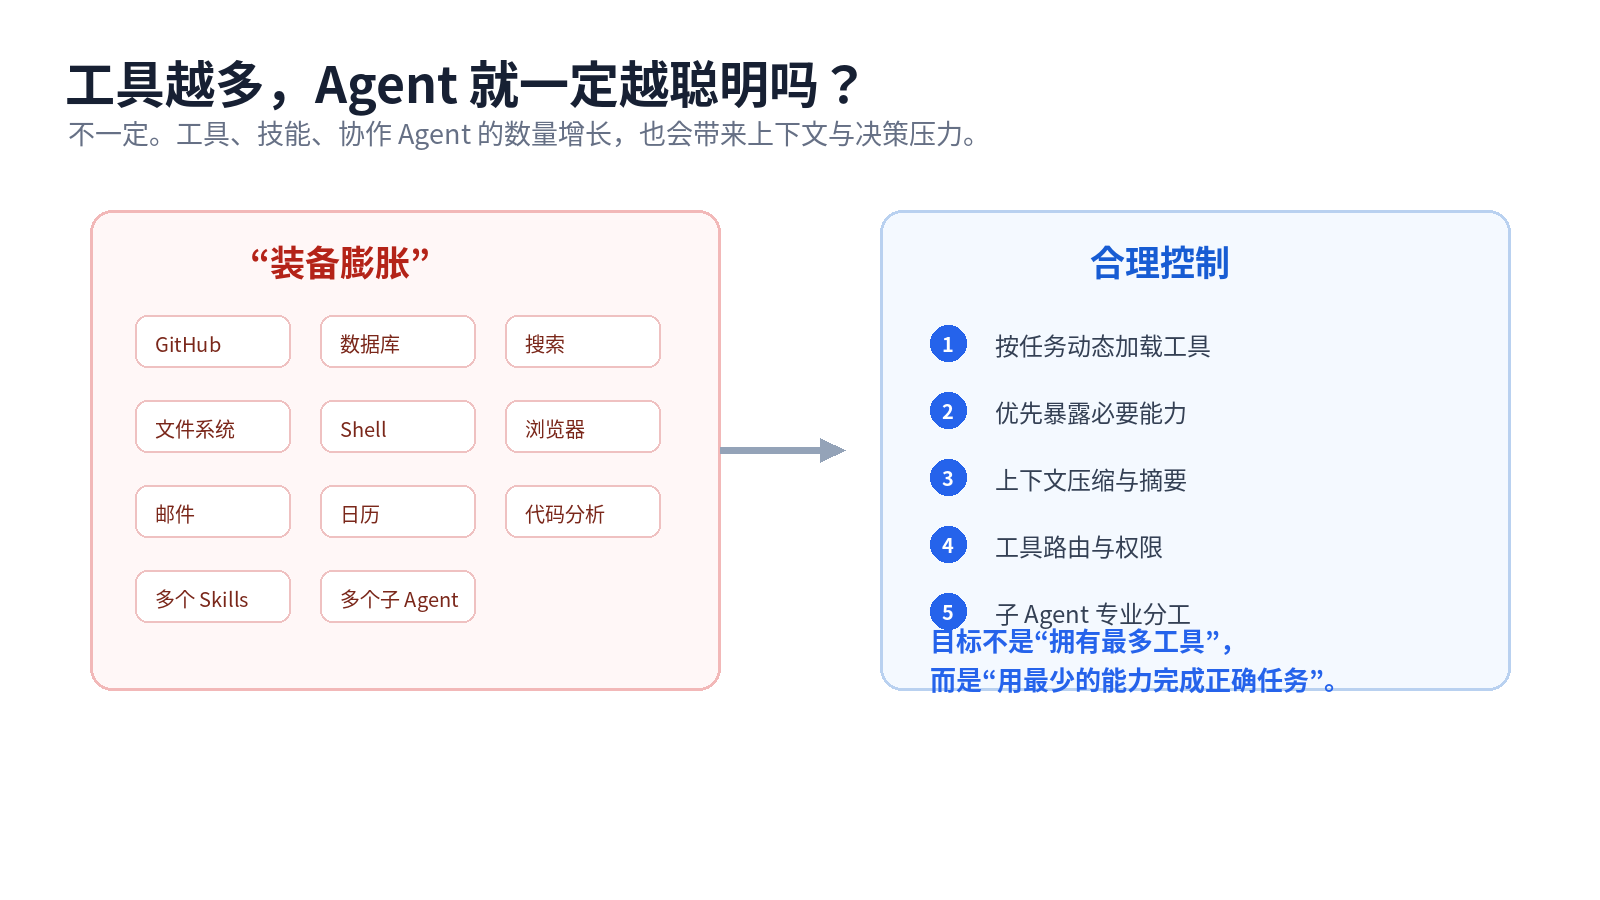
我认为正确答案不是:
越多越好。
而是:
按任务动态加载最需要的工具。
六、未来 Agent 更重要的能力,可能不是“拥有工具”,而是“选择工具”
比如一个 Python 开发任务:
“帮我找一下项目中的数据库连接问题。”
其实它真正需要的工具可能只有:
文件读取
+
代码搜索
+
数据库检查
+
测试
没必要同时暴露:
邮件
日历
天气
图片生成
CRM
ERP
GitHub 全套操作
所以更合理的做法是:
用户任务
   ↓
Agent 分析
   ↓
判断任务类型
   ↓
动态选择工具
   ↓
加载最必要能力
   ↓
执行
这样才能减少无关信息。
七、第二个真正难的问题:Agent 能不能连续工作?
这是最近另一个非常值得关注的方向。
以前的 AI:
输入
 ↓
回答
 ↓
结束
但是 Agent 不一样。
它可能:
10 分钟
20 分钟
30 分钟
甚至更长
持续执行一个任务。
比如:
“帮我分析整个代码仓库,并修复所有测试失败的问题。”
这种任务可能需要:
读取几十个文件
↓
运行测试
↓
分析日志
↓
定位错误
↓
修改代码
↓
继续运行测试
所以:
Agent 开始进入长周期运行时代。
八、长任务真正难在哪里?
不是“时间长”这么简单。
真正困难的是:
Agent 需要一直记住自己做到哪了。
例如:
第 1 步 ✅
读取项目

第 2 步 ✅
分析结构

第 3 步 ✅
找到 Bug

第 4 步 ✅
修改代码

第 5 步 ❌
测试失败
这时候 Agent 必须知道:
我不能从头再来。
而应该:
恢复到第 5 步
 ↓
分析失败原因
 ↓
继续执行
这就是:
状态管理 + Checkpoint + 恢复。
九、现在的 Agent 已经开始需要“存档”
这个概念特别好理解。
就像玩游戏:
任务进行
 ↓
存档
 ↓
继续
 ↓
出问题
 ↓
读取存档
 ↓
继续任务
Agent 也一样。
例如:
任务
 ↓
规划
 ↓
执行
 ↓
Checkpoint
 ↓
执行
 ↓
Checkpoint
 ↓
继续执行
当系统突然重启:
重新读取状态
 ↓
知道自己做到哪
 ↓
从断点继续
所以:
Checkpoint 是长任务 Agent 的基础设施之一。
十、OpenAI 最近的 Agents API 为什么值得关注?
9 月 10 日,OpenAI 正式宣布了 Agents API 公测版。
官方介绍中,它直接把 Codex 背后的 Agent Harness 提供给开发者,负责:
-
Agent 编排
-
长会话
-
上下文管理
-
恢复
-
工具调用
-
子 Agent 并行
-
沙箱执行
开发者可以通过 API 构建云端 Agent,并连接自己的工具和 MCP Server。
这个变化特别值得注意。
因为以前:
开发 Agent,需要自己搭一大套基础设施。
现在:
连“Agent 运行底座”都开始有人直接提供了。
这说明什么?
说明 Agent 正在越来越像:
一种标准软件基础设施。
十一、Agent Harness 是什么?
这个概念最近也越来越重要。
简单来说:
Harness 就是负责让 Agent 持续工作的那套“运行机制”。
可以把它理解为:
大模型
 ↓
Agent
 ↓
Harness
 ├── 工具
 ├── 状态
 ├── 上下文
 ├── 沙箱
 ├── 子 Agent
 ├── 恢复
 └── 日志
所以:
大模型不是整个 Agent。
甚至:
Agent 也不是整个系统。
真正把它变成“能持续工作的智能体”的,是后面这一整套运行框架。
十二、为什么最近大家开始研究“训练环境”?
这一点很多人会觉得奇怪:
“模型越来越强,不应该越来越容易吗?”
问题就在这里。
如果 Agent 越来越聪明,那么:
原来的训练任务
↓
越来越简单
↓
越来越难学到新东西
所以最近的研究开始想办法:
让训练环境跟着 Agent 一起升级。
《Environment Evolution for Terminal Agents》就是一个很典型的方向。
论文提出环境进化机制,让训练环境根据需要逐步增加难度,并通过多 Agent Harness 构建更加困难的终端任务;论文报告,在 Terminal-Bench 2.1 上,针对 Qwen3.6-27B 和 Qwen3.6-35B-A3B 的训练分别提升了 14.4 和 18.0 个百分点。
简单说:
不是只升级模型,也开始升级 Agent 的“训练世界”。
十三、以后训练 Agent,可能越来越像“训练一个员工”
这个比喻其实非常形象。
普通模型训练:
大量数据
 ↓
学习知识
 ↓
得到模型
Agent 训练越来越像:
给任务
 ↓
Agent 尝试
 ↓
发现问题
 ↓
环境增加难度
 ↓
Agent 再尝试
 ↓
逐渐学会解决复杂任务
就像一个员工:
刚开始只会简单工作。
然后:
任务越来越复杂。
最后:
能独立处理复杂项目。
这也是为什么“长任务”“环境进化”“Harness”开始成为 Agent 技术讨论的重要关键词。
十四、Multi-Agent 为什么又重新火起来?
还有一个今天很明显的关键词:
Multi-Agent
但我觉得需要换个角度理解。
Multi-Agent 并不是:
“Agent 越多越厉害。”
真正原因是:
一个 Agent 不应该承担所有事情。
例如:
总控 Agent
     ↓
 ┌───┼────┐
 ↓   ↓    ↓
搜索 代码  数据
Agent Agent Agent
     ↓
   审核 Agent
     ↓
   最终结果
每个 Agent 做自己擅长的事情。
这样比一个 Agent 什么都做更容易控制。
十五、但 Multi-Agent 最大的问题也是“协作”
Agent 多了以后,就出现:
Agent A
 ↓
Agent B
 ↓
Agent C
 ↓
Agent D
然后大家都要传:
上下文
任务
中间结果
工具返回值
错误信息
这时候:
通信成本就来了。
甚至可能出现:
单 Agent 成本
↓
1 元

Multi-Agent
↓
调用 30 次模型
↓
10 元
所以以后做 Multi-Agent,一定不能只问:
“能不能拆成多个 Agent?”
还要问:
“拆完之后,收益能不能覆盖协作成本?”
十六、今天还有一个非常值得关注的话题:AI 参与真实代码开发
CSDN 最近就有文章讨论:
AI 帮助修复 Linux 内核 Bug。
有意思的是,AI 确实可以帮忙找 Bug,并显著提高部分开发环节的速度,但最终代码是否正确,仍然需要有经验的工程师检查。
这其实和 Agent 的发展完全一致。
AI 开始:
找代码
↓
分析代码
↓
修改代码
↓
运行测试
但最后:
“能不能上线”
依然需要人来判断。
十七、所以 AI 编程未来真正的变化是什么?
以前:
程序员
 ↓
写代码
 ↓
测试
 ↓
部署
现在:
程序员
 ↓
提出目标
 ↓
AI Agent
 ↓
分析项目
 ↓
写代码
 ↓
运行测试
 ↓
修复问题
 ↓
程序员审核
 ↓
上线
开发者的位置发生了变化。
从:
“亲自写每一行代码”
逐渐转向:
“管理和验证 AI 写出来的代码”。
所以未来真正重要的能力可能是:
AI Agent 驾驭能力。
十八、但是 Agent 越能干,安全问题就越严重
这一点今天也非常值得关注。
CSDN 今天还有一篇引发关注的内容,讨论自主 Agent 集群对开源仓库的攻击问题。
无论具体事件最终如何认定,这件事情至少说明一个问题:
当 Agent 拥有真实执行权限后,安全问题会被放大。
假设一个 Agent 有:
Shell
+
文件系统
+
Git
+
网络
+
数据库
+
密钥
它一旦做错,就不是:
“回答错了。”
而可能变成:
“真的把系统搞坏了。”
所以生产级 Agent 必须考虑:
权限控制
+
沙箱
+
工具白名单
+
审批
+
审计日志
+
失败恢复
十九、真正成熟的 Agent,应该长什么样?
我觉得可以浓缩成下面这张图: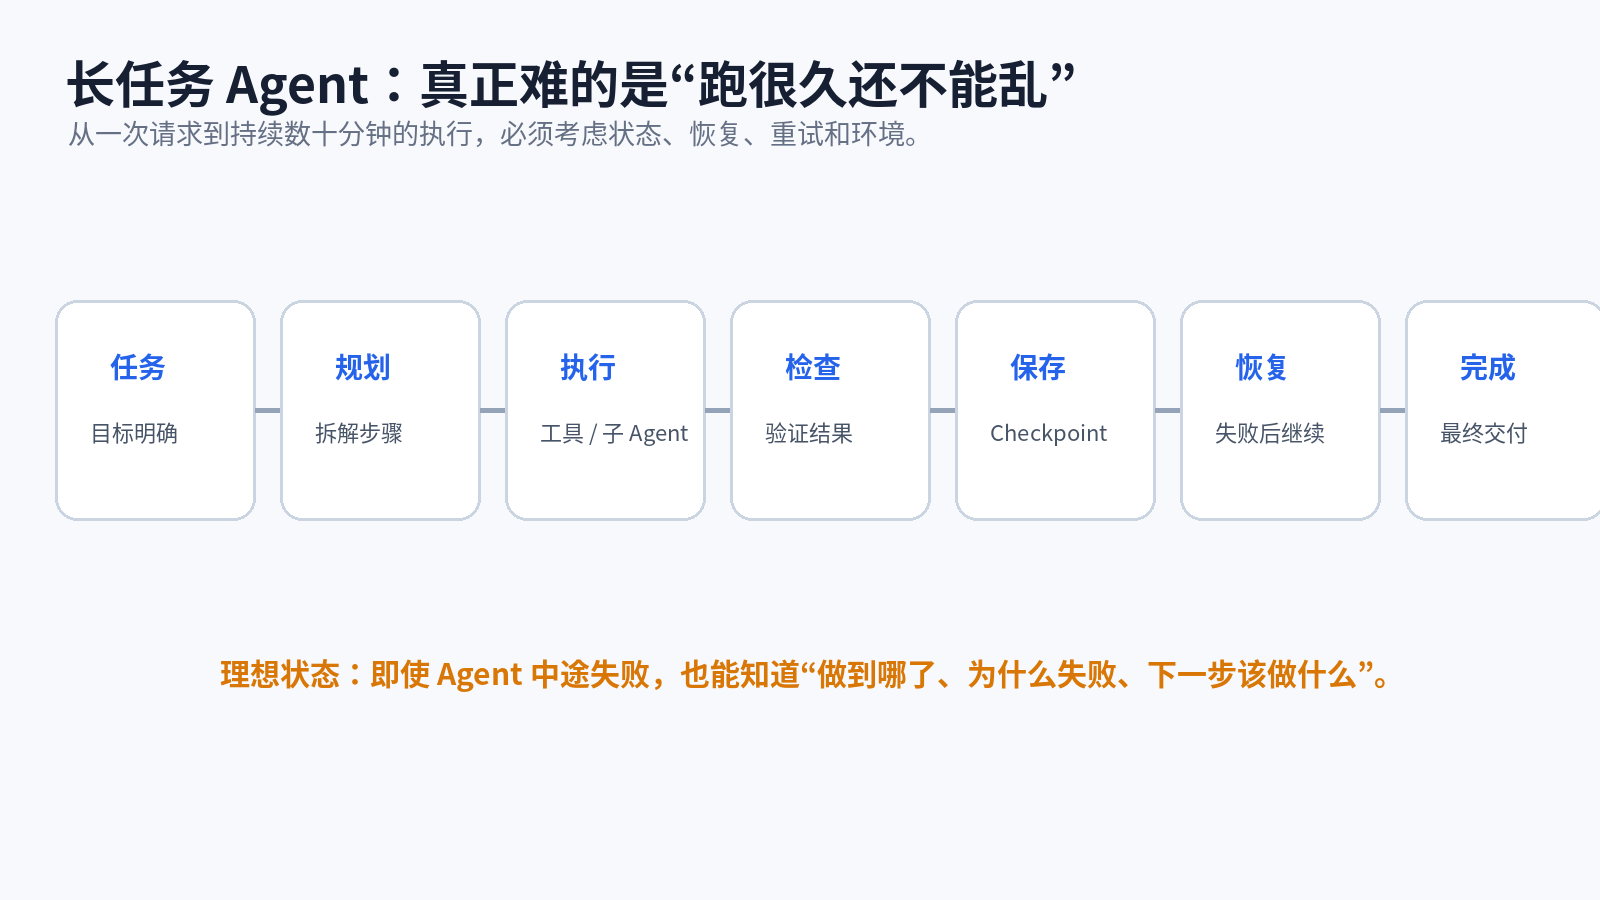
一个靠谱的 Agent 至少应该具备:
理解
 ↓
规划
 ↓
执行
 ↓
观察
 ↓
验证
 ↓
保存状态
 ↓
失败恢复
 ↓
继续执行
 ↓
最终完成
而不是:
理解
 ↓
调用工具
 ↓
结束
这已经是两个完全不同的系统。
二十、未来真正值得关注的不是“超级模型”,而是“超级 Agent 系统”
我们把今天这些热点放到一起:
今天 CSDN 的热点 1
Agent 工具越来越多。
→ 带来了装备膨胀和上下文压力。
热点 2
Agent 长时间运行。
→ 需要状态、Checkpoint、恢复。
热点 3
终端 Agent 训练环境进化。
→ 说明 Agent 正在面对越来越复杂的任务。
热点 4
OpenAI Agents API。
→ Agent 运行底座开始产品化。
热点 5
AI 真正进入代码开发。
→ Agent 开始接触真实工程。
热点 6
Agent 安全。
→ Agent 有真实执行权限之后,风险越来越大。
把这些放在一起,就得到一个特别清晰的趋势:
AI Agent 正从“一个模型”变成“一套完整的软件基础设施”。
二十一、Python 开发者应该怎么跟上?
如果你现在正在学 Python + AI,我建议不要只追热点工具。
可以按照下面这个顺序:
Python
 ↓
大模型 API
 ↓
Prompt
 ↓
Tool Calling
 ↓
RAG
 ↓
Agent
 ↓
Memory
 ↓
MCP
 ↓
Skills
 ↓
Multi-Agent
 ↓
Checkpoint
 ↓
Harness
 ↓
Agent 工程化
然后重点学习五件事情:
1. 怎么调用模型
知道:
AI 怎么被程序调用。
2. 怎么调用工具
知道:
AI 怎么操作外部世界。
3. 怎么保存状态
知道:
AI 怎么记住自己做到哪里。
4. 怎么恢复任务
知道:
AI 挂了以后怎么继续。
5. 怎么让 AI 安全工作
知道:
AI 有权限以后,哪些事情可以做,哪些事情不能做。
做到这里,你就已经开始进入真正的 Agent 开发了。
二十二、写在最后
今天的 AI Agent 热点,我觉得特别值得总结成一句话:
Agent 的上半场,是让 AI 学会调用工具。
而现在正在进入:
Agent 的下半场,是让 AI 在复杂环境里长期、稳定、安全地把事情做完。
所以未来真正优秀的 Agent,不一定是:
工具最多的。
也不一定是:
参数最大的。
而更可能是:
最懂得什么时候用什么工具、如何保存状态、如何恢复失败、如何分工协作,并且能够控制风险和成本的 Agent。
这也是为什么最近你会同时看到:
MCP、Skills、Multi-Agent、Harness、Checkpoint、沙箱、长任务、环境进化、Agent API
这些看起来完全不同的词。
其实它们都在解决同一个问题:
怎么让 AI 从“会回答”真正走向“会完成任务”。
而对于 Python 开发者来说,这可能就是接下来几年最值得持续关注的一条技术路线。
更多推荐


 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)