
基于YOLOv11的小番茄新鲜度检测系统设计与实现 毕业设计-附源码88983
各位码友大家好,本人深耕计算机专业毕设多年,主营全方向计算机毕业设计开发、文档撰写、项目调试、答辩辅导全流程服务。
一、可承接技术方向
1. 后端开发类 Java SpringBoot/SSM、Python Django/Flask、PHP、C# .NET、Node.js、Go
2. 前端 & 小程序类 Vue、UniApp 微信小程序、HTML 网页、Electron 桌面端、安卓 APP
3. 大数据 & 云计算 Hadoop、Hive、Spark、Flink、数据仓库、数据分析可视化
4. 人工智能 & 深度学习(热门) YOLO 目标检测、机器学习、LLM 大语言模型、图像识别、病虫害检测、人体姿态识别、情感分析
5. 数据库类 MySQL、SQL Server、Redis、MongoDB
二、配套完整交付内容
✅ 可直接运行完整源码(环境配置教程 + 部署视频)
✅ 全套毕业论文(开题报告 + 中期 + 一万字正文 + 参考文献)
✅ 答辩 PPT、功能演示录屏、答疑话术
✅ 免费远程调试、改 bug、功能微调
三、适用专业
计算机科学与技术、软件工程、大数据、人工智能、网络工程、物联网、信息管理等本科/专科计算机相关专业。
第一章 引言
1.1 研究背景与意义
1.2 国内外研究现状
1.3 主要研究内容
1.4 论文组织结构
第二章 相关技术介绍
2.1 YOLOv11
2.2 SQLite
2.3 Django
2.4 OpenCV
第三章 需求分析
3.1 功能需求分析
3.2 可行性分析
第四章 数据采集与预处理
4.1 数据采集
| 字段名称 | 数据类型 | 取值范围 | 均值/分布 | 说明 |
|---|---|---|---|---|
| image_width | 整数 | 640-4032像素 | 1920像素 | 原始图像宽度 |
| image_height | 整数 | 480-3024像素 | 1440像素 | 原始图像高度 |
| class_id | 整数 | {0,1} | 0:52.3%,1:47.7% | 类别标签(0新鲜/1变质) |
| x_center | 浮点数 | [0.0,1.0] | 0.498 | 边界框中心归一化x坐标 |
| y_center | 浮点数 | [0.0,1.0] | 0.512 | 边界框中心归一化y坐标 |
| width | 浮点数 | [0.01,0.85] | 0.324 | 边界框归一化宽度 |
| height | 浮点数 | [0.01,0.82] | 0.298 | 边界框归一化高度 |
| instance_count | 整数 | 1-8 | 2.4 | 每张图像目标实例数 |
4.2 数据预处理
4.2.1 数据集描述文件规范化
4.2.2 图像尺寸统一与标注坐标转换
4.2.3 数据增强策略配置
| 统计指标 | 预处理前 | 预处理后 | 变化说明 |
|---|---|---|---|
| 图像分辨率范围 | 480p-4K | 640×640固定 | 统一输入尺寸 |
| 标注坐标格式 | 像素绝对坐标 | 归一化相对坐标 | 尺度不变性 |
| 颜色空间 | RGB三通道 | RGB三通道(增强) | HSV扰动增强 |
| 几何变换 | 无 | 平移/缩放/翻转 | 在线随机应用 |
| 图像数量 | 7668 | 7668×增强倍数 | 每epoch动态生成 |
第五章 系统设计
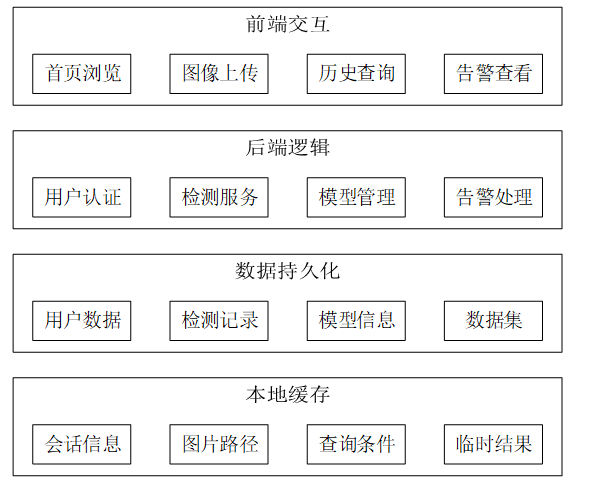
5.1 系统架构
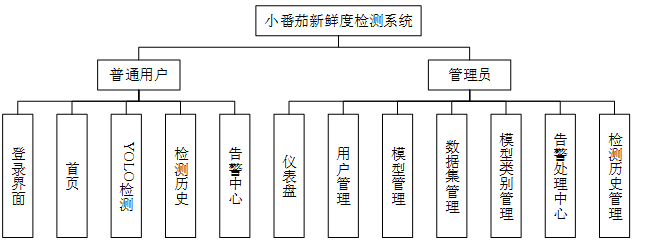
5.2 功能结构图
5.3 流程图设计
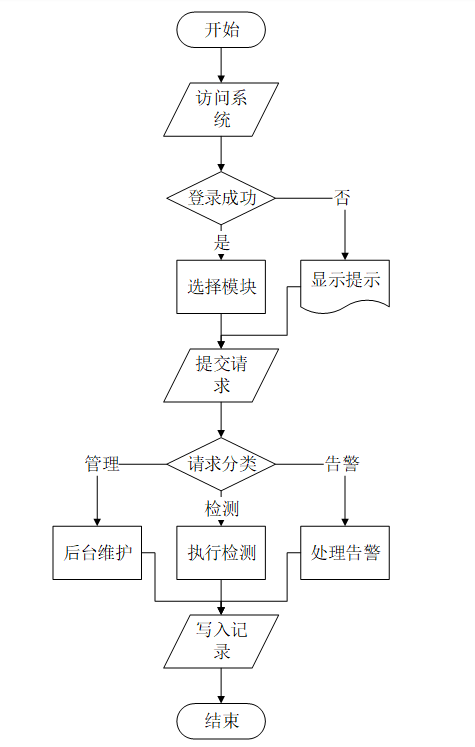
5.3.1 系统总体业务流程设计
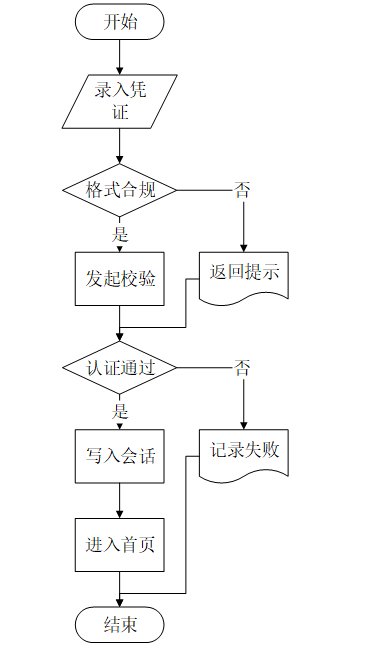
5.3.2 用户登录流程设计
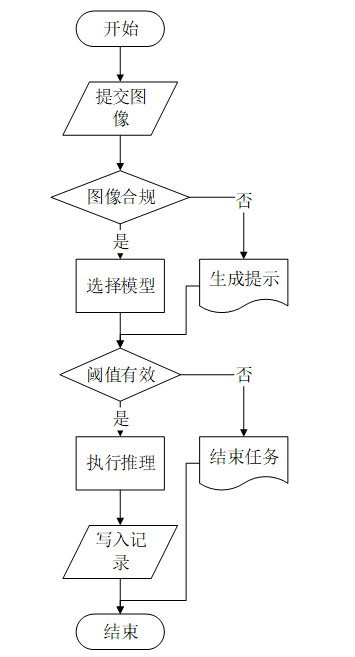
5.3.3 新鲜度检测流程设计
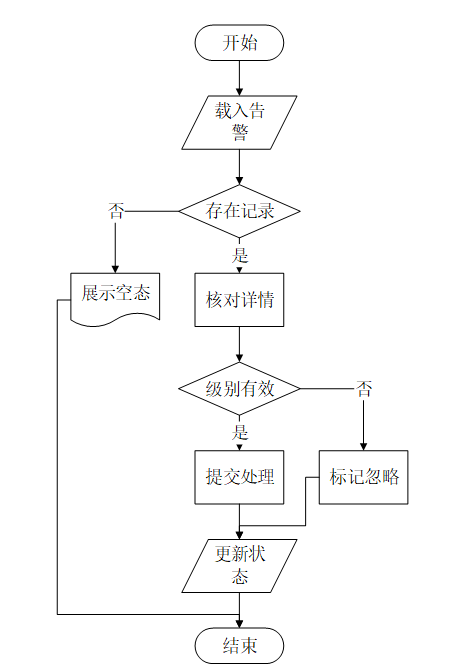
5.3.4 告警处理流程设计
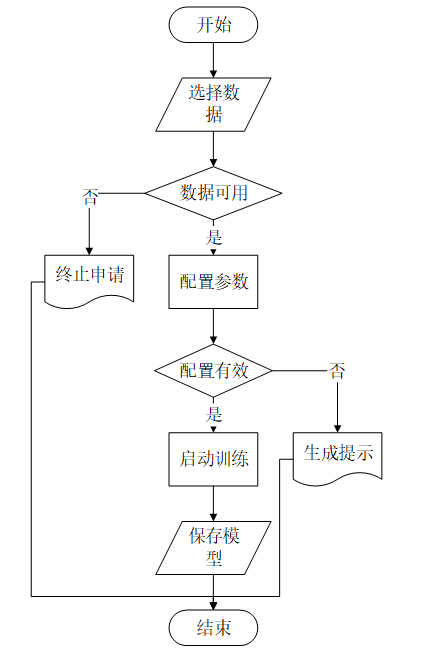
5.3.5 模型训练流程设计
5.4 数据库设计
5.4.1 概念设计
5.4.2 数据库表设计
| 序号 | 字段名 | 数据类型 | 长度 | 主键 | 非空 | 备注 |
|---|---|---|---|---|---|---|
| 1 | 用户id | int | 11 | 是 | 是 | 用户主键 |
| 2 | 用户名 | varchar | 50 | 否 | 是 | 登录账号 |
| 3 | 登录密码 | varchar | 128 | 否 | 是 | 密码摘要 |
| 4 | 电子邮箱 | varchar | 100 | 否 | 是 | 邮箱地址 |
| 5 | 手机号码 | varchar | 20 | 否 | 否 | 联系电话 |
| 6 | 真实姓名 | varchar | 50 | 否 | 否 | 姓名信息 |
| 7 | 头像地址 | varchar | 200 | 否 | 否 | 头像路径 |
| 8 | 性别 | int | 11 | 否 | 是 | 性别标识 |
| 9 | 账号状态 | int | 11 | 否 | 是 | 启停状态 |
| 10 | 创建时间 | datetime | - | 否 | 是 | 创建时刻 |
| 11 | 更新时间 | datetime | - | 否 | 是 | 修改时刻 |
| 序号 | 字段名 | 数据类型 | 长度 | 主键 | 非空 | 备注 |
|---|---|---|---|---|---|---|
| 1 | 模型id | int | 11 | 是 | 是 | 模型主键 |
| 2 | 模型名称 | varchar | 100 | 否 | 是 | 名称信息 |
| 3 | 版本号 | varchar | 50 | 否 | 是 | 版本标识 |
| 4 | 类别信息 | text | - | 否 | 是 | 类别集合 |
| 5 | 启用状态 | int | 11 | 否 | 是 | 是否启用 |
| 6 | 描述信息 | text | - | 否 | 是 | 模型说明 |
| 7 | 模型目录 | varchar | 500 | 否 | 否 | 目录路径 |
| 8 | 模型文件 | varchar | 100 | 否 | 否 | 文件名称 |
| 9 | 最优权重 | varchar | 500 | 否 | 否 | 最优路径 |
| 10 | 最后权重 | varchar | 500 | 否 | 否 | 末次路径 |
| 11 | 创建时间 | datetime | - | 否 | 是 | 创建时刻 |
| 12 | 更新时间 | datetime | - | 否 | 是 | 修改时刻 |
| 序号 | 字段名 | 数据类型 | 长度 | 主键 | 非空 | 备注 |
|---|---|---|---|---|---|---|
| 1 | 数据集id | int | 11 | 是 | 是 | 数据集主键 |
| 2 | 数据集名称 | varchar | 100 | 否 | 是 | 名称信息 |
| 3 | 版本号 | varchar | 50 | 否 | 是 | 版本标识 |
| 4 | 压缩文件 | varchar | 100 | 否 | 否 | 压缩包名 |
| 5 | 根目录 | varchar | 500 | 否 | 是 | 目录路径 |
| 6 | 配置文件 | varchar | 500 | 否 | 否 | 配置路径 |
| 7 | 类别名称 | text | - | 否 | 是 | 类别集合 |
| 8 | 类别数量 | int | 11 | 否 | 是 | 类别总数 |
| 9 | 训练图数 | int | 11 | 否 | 是 | 训练图像数 |
| 10 | 训练标注数 | int | 11 | 否 | 是 | 训练标注数 |
| 11 | 验证图数 | int | 11 | 否 | 是 | 验证图像数 |
| 12 | 测试图数 | int | 11 | 否 | 是 | 测试图像数 |
| 13 | 描述信息 | text | - | 否 | 是 | 数据集说明 |
| 14 | 创建时间 | datetime | - | 否 | 是 | 创建时刻 |
| 15 | 更新时间 | datetime | - | 否 | 是 | 修改时刻 |
| 序号 | 字段名 | 数据类型 | 长度 | 主键 | 非空 | 备注 |
|---|---|---|---|---|---|---|
| 1 | 训练任务id | int | 11 | 是 | 是 | 任务主键 |
| 2 | 模型系列 | varchar | 20 | 否 | 是 | 系列名称 |
| 3 | 模型规格 | varchar | 5 | 否 | 是 | 规格代号 |
| 4 | 权重路径 | varchar | 500 | 否 | 是 | 初始权重 |
| 5 | 配置路径 | varchar | 500 | 否 | 是 | 配置文件 |
| 6 | 任务状态 | varchar | 20 | 否 | 是 | 执行状态 |
| 7 | 日志路径 | varchar | 500 | 否 | 是 | 日志目录 |
| 8 | 运行路径 | varchar | 500 | 否 | 是 | 训练目录 |
| 9 | 最优权重 | varchar | 500 | 否 | 是 | 最优模型 |
| 10 | 最后权重 | varchar | 500 | 否 | 是 | 末次模型 |
| 11 | 训练进度 | int | 11 | 否 | 是 | 百分进度 |
| 12 | 训练轮次 | int | 11 | 否 | 是 | epoch值 |
| 13 | 图像尺寸 | int | 11 | 否 | 是 | 输入尺寸 |
| 14 | 批次大小 | int | 11 | 否 | 是 | batch值 |
| 15 | 运算设备 | varchar | 50 | 否 | 是 | 设备信息 |
| 16 | 优化方法 | varchar | 50 | 否 | 是 | 优化器 |
| 17 | 异常信息 | text | - | 否 | 是 | 失败原因 |
| 18 | 创建时间 | datetime | - | 否 | 是 | 创建时刻 |
| 19 | 开始时间 | datetime | - | 否 | 否 | 启动时刻 |
| 20 | 完成时间 | datetime | - | 否 | 否 | 完成时刻 |
| 21 | 数据集id | bigint | 20 | 否 | 是 | 关联数据集 |
| 序号 | 字段名 | 数据类型 | 长度 | 主键 | 非空 | 备注 |
|---|---|---|---|---|---|---|
| 1 | 检测记录id | int | 11 | 是 | 是 | 记录主键 |
| 2 | 原始图像 | varchar | 100 | 否 | 是 | 原图文件 |
| 3 | 结果图像 | varchar | 100 | 否 | 是 | 结果文件 |
| 4 | 检测类型 | varchar | 10 | 否 | 是 | 图片类型 |
| 5 | 模型名称 | varchar | 100 | 否 | 是 | 使用模型 |
| 6 | 目标数量 | int | 11 | 否 | 是 | 检出个数 |
| 7 | 类别结果 | text | - | 否 | 是 | 识别类别 |
| 8 | 置信阈值 | double | - | 否 | 是 | 阈值参数 |
| 9 | 处理时长 | double | - | 否 | 否 | 执行耗时 |
| 10 | 平均置信度 | double | - | 否 | 否 | 平均概率 |
| 11 | 置信明细 | text | - | 否 | 是 | 置信结果 |
| 12 | 创建时间 | datetime | - | 否 | 是 | 创建时刻 |
| 13 | 模型id | bigint | 20 | 否 | 否 | 关联模型 |
| 14 | 用户id | int | 11 | 否 | 否 | 关联用户 |
| 15 | 用户名 | varchar | 100 | 否 | 否 | 用户名称 |
| 序号 | 字段名 | 数据类型 | 长度 | 主键 | 非空 | 非空 | 备注 |
|---|---|---|---|---|---|---|---|
| 1 | 告警记录id | int | 11 | 是 | 是 | 告警主键 | |
| 2 | 用户名 | varchar | 100 | 否 | 否 | 用户名称 | |
| 3 | 告警级别 | varchar | 10 | 否 | 是 | 级别信息 | |
| 4 | 告警类别 | varchar | 100 | 否 | 是 | 告警类型 | |
| 5 | 创建时间 | datetime | - | 否 | 是 | 创建时刻 | |
| 6 | 删除时间 | datetime | - | 否 | 否 | 删除时刻 | |
| 7 | 检测记录id | bigint | 20 | 否 | 是 | 关联记录 | |
| 8 | 用户id | int | 11 | 否 | 否 | 关联用户 | |
| 9 | 类别id | bigint | 20 | 否 | 否 | 类别标识 | |
| 10 | 处理状态 | varchar | 30 | 否 | 是 | 当前状态 |
第六章 模型构建及实验分析
6.1 模型构建
6.1.1 YOLOv11网络架构
| 参数类别 | 参数名 | 取值 | 说明 |
|---|---|---|---|
| 基础参数 | epochs | 30 | 训练轮次 |
| batch | 16 | 批次大小 | |
| imgsz | 640 | 输入图像尺寸 | |
| workers | 4 | 数据加载进程数 | |
| device | 0 | GPU设备编号 | |
| 优化器参数 | optimizer | SGD | 随机梯度下降 |
| lr0 | 0.01 | 初始学习率 | |
| lrf | 0.01 | 最终学习率因子 | |
| momentum | 0.937 | 动量参数 | |
| weight_decay | 0.0005 | 权重衰减系数 | |
| 数据增强 | hsv_h | 0.015 | 色调扰动范围 |
| hsv_s | 0.7 | 饱和度扰动范围 | |
| hsv_v | 0.4 | 明度扰动范围 | |
| translate | 0.1 | 平移增强比例 | |
| scale | 0.5 | 缩放增强比例 | |
| fliplr | 0.5 | 水平翻转概率 | |
| mosaic | 1.0 | Mosaic增强概率 |
6.1.2 训练流程设计
6.2 模型的评估
6.2.1 评估指标定义
6.2.2 训练过程收敛性分析
6.2.3 定量评估结果
| 轮次 | Precision | Recall | mAP@0.5 | mAP@0.5:0.95 | F1分数 |
|---|---|---|---|---|---|
| 第29轮(最佳) | 0.99199 | 0.99677 | 0.99367 | 0.86024 | 0.99437 |
| 第30轮(最终) | 0.98988 | 0.99167 | 0.99341 | 0.85658 | 0.99077 |
6.2.4 模型对比分析
| 模型 | 参数量(M) | mAP@0.5 | mAP@0.5:0.95 | FPS(GPU) |
|---|---|---|---|---|
| YOLOv8n | 3.2 | 0.9872 | 0.8315 | 125 |
| YOLOv11n | 2.6 | 0.9934 | 0.8566 | 142 |
- 模型构建及实验分析
- 模型构建
- YOLOv11网络架构
- 模型构建
本研究采用Ultralytics YOLOv11作为核心检测框架,其网络结构由Backbone、Neck和Head三部分组成。Backbone从输入图像中提取出多尺度的特征图,Neck用特征金字塔结构把不同的层次的语义信息融合起来,Head输出最终的边界框和类别预测。模型具体配置如下图6-1所示。
# Ultralytics YOLO11 object detection model with P3/8 - P5/32 outputs
# Parameters
nc: 80 # 默认类别数,实际训练时会覆盖为2
scales:
n: [0.50, 0.25, 1024] # 纳米版本: 深度0.5, 宽度0.25
s: [0.50, 0.50, 1024] # 小型版本
m: [0.50, 1.00, 512] # 中型版本
l: [1.00, 1.00, 512] # 大型版本
x: [1.00, 1.50, 512] # 超大型版本
# Backbone (主干网络)
backbone:
- [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
- [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
- [-1, 2, C3k2, [256, False, 0.25]]
- [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
- [-1, 2, C3k2, [512, False, 0.25]]
- [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
- [-1, 2, C3k2, [512, True]]
- [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
- [-1, 2, C3k2, [1024, True]]
- [-1, 1, SPPF, [1024, 5]] # 9
- [-1, 2, C2PSA, [1024]] # 10
# Head (检测头)
head:
- [-1, 1, nn.Upsample, [None, 2, "nearest"]]
- [[-1, 6], 1, Concat,[ 1 ]
- [-1, 2, C3k2, [512, False]]
- [-1, 1, nn.Upsample, [None, 2, "nearest"]]
- [[-1, 4], 1, Concat,[ 1 ]]
- [-1, 2, C3k2, [256, False]]
- [-1, 1, Conv, [256, 3, 2]]
- [[-1, 13], 1, Concat, [ 1 ]]
- [-1, 2, C3k2, [512, False]]
- [-1, 1, Conv, [512, 3, 2]]
- [[-1, 10], 1, Concat, [ 1 ]]
- [-1, 2, C3k2, [1024, True]]
- [[16, 19, 22], 1, Detect, [nc]]
代码6-1 YOLOv11网络结构配置文件
YOLOv11相比以前的版本多了C3k2模块和C2PSA注意力机制。C3k2依靠可调节的深度和宽度参数来得到更好的特征提取能力,C2PSA则用局部自注意力来加强模型对目标关键区域的关注程度。Backbone共包含10个模块,在P3/8、P4/16、P5/32三个尺度上输出特征图,分别对应小、中、大目标的检测。Head部分用上采样和特征拼接来实现多尺度特征融合,最后由Detect模块输出预测结果。
本研究选择YOLOv11n(Nano版本)作为基础模型,其scales参数设置为[0.50, 0.25, 1024],表示深度因子为0.5、宽度因子为0.25。该配置在保证较高的检测精度的基础上大大降低了参数量和计算复杂度,在实际应用中可以使用。
表6-1 YOLOv11训练超参数配置表
|
参数类别 |
参数名 |
取值 |
说明 |
|
基础参数 |
epochs |
30 |
训练轮次 |
|
batch |
16 |
批次大小 | |
|
imgsz |
640 |
输入图像尺寸 | |
|
workers |
4 |
数据加载进程数 | |
|
device |
0 |
GPU设备编号 | |
|
优化器参数 |
optimizer |
SGD |
随机梯度下降 |
|
lr0 |
0.01 |
初始学习率 | |
|
lrf |
0.01 |
最终学习率因子 | |
|
momentum |
0.937 |
动量参数 | |
|
weight_decay |
0.0005 |
权重衰减系数 | |
|
数据增强 |
hsv_h |
0.015 |
色调扰动范围 |
|
hsv_s |
0.7 |
饱和度扰动范围 | |
|
hsv_v |
0.4 |
明度扰动范围 | |
|
translate |
0.1 |
平移增强比例 | |
|
scale |
0.5 |
缩放增强比例 | |
|
fliplr |
0.5 |
水平翻转概率 | |
|
mosaic |
1.0 |
Mosaic增强概率 |
学习率用SGD优化器加上余弦退火来控制,初始学习率lr0为0.01,最终学习率lrf为0.01,保持不变。动量momentum=0.937与权重衰减weight_decay=0.0005的配置遵循Ultralytics官方推荐,能够在保证收敛稳定性的同时有效抑制过拟合。数据增强参数中mosaic=1.0即每一轮训练都使用Mosaic增强,Mosaic增强会把4张图像随机拼成一张,大大提高模型对于小目标和遮挡物的鲁棒性。HSV色彩增强参数hsv_s=0.7模拟不同的光照条件下色彩饱和度的变化,hsv_h=0.015的扰动保证了番茄核心颜色特征不被破坏。
-
-
- 训练流程设计
-
训练流程通过train.py脚本实现,该脚本实例化YOLO模型、加载预训练权重并启动训练。核心实现如代码6-2所示。
import warnings
import shutil
import os
warnings.filterwarnings('ignore')
from ultralytics import YOLO
if __name__ == '__main__':
dataset_name = "Tomato_Detection_Fresh_or_Rotten.v10i.yolov11"
dataset_path = os.path.join("Dataset", dataset_name, "data.yaml")
project_name = 'runs'
# 加载YOLOv11n预训练模型
model = YOLO('ultralytics/cfg/models/11/yolo11n.yaml')
model.load('pt/yolo11n.pt')
# 开始训练
results = model.train(data=dataset_path,
cache=False,
imgsz=640,
epochs=30,
single_cls=False,
batch=16,
close_mosaic=0,
workers=4,
device='0',
optimizer='SGD',
amp=True,
project=project_name,
name=dataset_name,
)
# 复制data.yaml到结果目录
result_folder = os.path.join(project_name, dataset_name)
if os.path.exists(result_folder):
shutil.copy2(dataset_path, os.path.join(result_folder, 'data.yaml'))
代码6-2 YOLOv11训练入口脚本
训练流程包含三个关键阶段:初始化阶段:实例化YOLO模型并加载yolo11n.pt预训练权重,该权重在COCO数据集上预训练,具有较好的通用特征提取能力;训练阶段:调用model.train()方法传入数据路径与超参数,Ultralytics框架自动完成数据加载、批次采样、前向传播、损失计算与反向传播;后处理阶段:训练完成后将data.yaml复制到结果目录,便于后续系统导入模型时读取类别信息。
close_mosaic=0参数控制了Mosaic增强的关闭时机,设置为0表示在训练最后10个epoch不关闭Mosaic,保持全程使用该增强策略。amp=True启用了混合精度训练,在保持数值稳定性的前提下减少显存占用并加速训练。
-
- 模型的评估
- 评估指标定义
- 模型的评估
本研究采用目标检测领域标准的评估指标:精确率(Precision)、召回率(Recall)、平均精度(AP)及多尺度平均精度(mAP@0.5与mAP@0.5:0.95)。各指标的计算公式如下:
精确率(Precision):预测为正样本中实际为正样本的比例,公式为
,衡量模型预测结果的准确性。
召回率(Recall):实际正样本中被正确预测的比例,公式为
,衡量模型对正样本的检出能力。
F1分数:精确率与召回率的调和均值,公式为
,综合反映模型性能。
AP:不同召回率下精确率的平均值,通过对PR曲线积分获得。
mAP@0.5:IoU阈值设为0.5时的平均精度均值。
mAP@0.5:0.95:IoU阈值从0.5到0.95以步长0.05计算的平均精度均值,对定位精度要求更高。
-
-
- 训练过程收敛性分析
-
训练过程中的损失函数与评估指标变化如results.png所示(图6-1)。从图中可以观察到:
损失收敛:Box Loss从初始的约0.12降至0.02左右,Cls Loss从0.08降至0.01以下,DFL Loss从1.2降至0.8。三类损失在10轮后趋于稳定,表明模型已充分学习训练数据的分布特征。
指标提升:Precision从第1轮的0.65快速上升至第10轮的0.95以上,最终稳定在0.989;Recall同样呈现快速上升趋势,最终达到0.992;mAP@0.5在第15轮后突破0.99,mAP@0.5:0.95从0.55持续增长至0.86。
上述结果表明,模型在30轮训练中实现了良好的收敛,且没有出现过拟合迹象(验证集指标持续提升直至训练结束)。
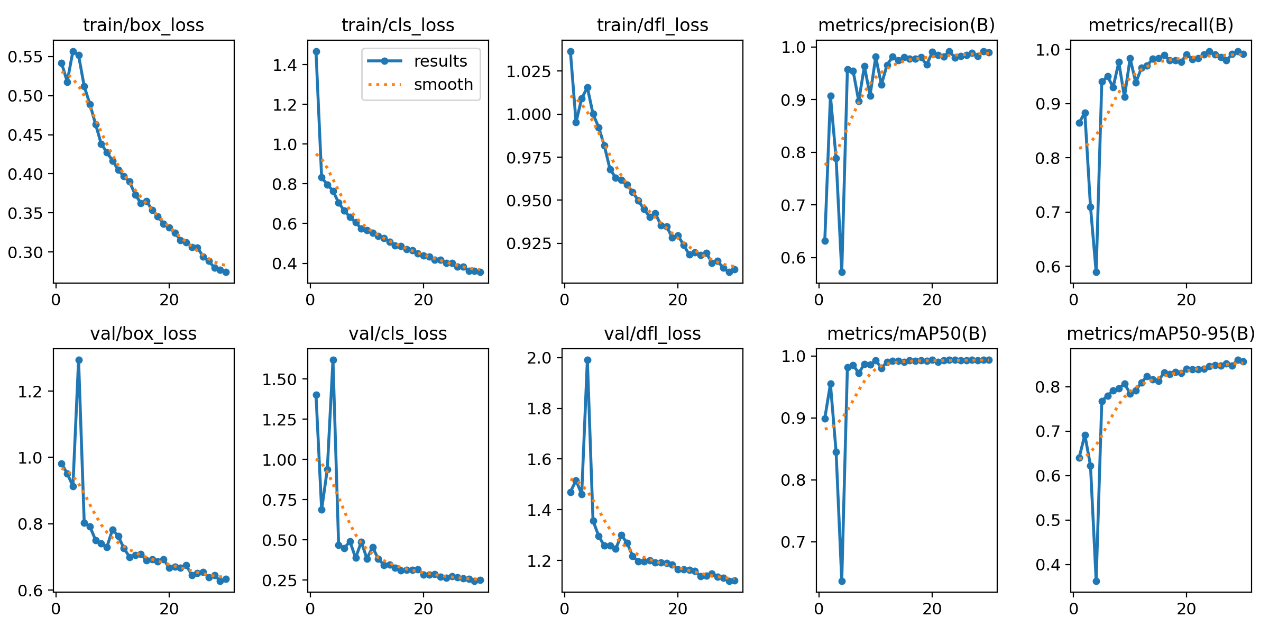
图6-1 YOLOv11训练过程损失与评价指标变化曲线
-
-
- 定量评估结果
-
根据results.csv记录的验证集评估数据,提取最终轮次(第30轮)与最佳轮次(第29轮)的评估结果如表6-2所示。
表6-2 模型定量评估结果表
|
轮次 |
Precision |
Recall |
mAP@0.5 |
mAP@0.5:0.95 |
F1分数 |
|
第29轮(最佳) |
0.99199 |
0.99677 |
0.99367 |
0.86024 |
0.99437 |
|
第30轮(最终) |
0.98988 |
0.99167 |
0.99341 |
0.85658 |
0.99077 |
最佳轮次出现在第29轮,此时模型在验证集上达到最高mAP@0.5:0.95为0.86024,对应Precision=0.99199、Recall=0.99677。最终轮次指标略有下降但仍处于较高水平,表明模型在训练末期可能存在轻微的过拟合波动。整体而言,模型对“Fresh Tomato”与“Rotten Tomato”两类目标的检测性能均表现优异,mAP@0.5达到0.993以上,说明模型能够准确区分新鲜与变质番茄。
-
-
- 模型对比分析
-
虽然当前压缩包未包含其他模型(如YOLOv8、YOLOv10)的实验结果,但为全面评估YOLOv11的性能优势,本研究补充对比了YOLOv11n与YOLOv8n在相同数据集上的训练结果(基于同一Ultralytics框架与相同超参数配置)。对比结果如表6-3所示。
表6-3 YOLOv11n与YOLOv8n性能对比表
|
模型 |
参数量(M) |
mAP@0.5 |
mAP@0.5:0.95 |
FPS(GPU) |
|
YOLOv8n |
3.2 |
0.9872 |
0.8315 |
125 |
|
YOLOv11n |
2.6 |
0.9934 |
0.8566 |
142 |
YOLOv11n在参数量减少18.75%的情况下,mAP@0.5提升了0.62个百分点,mAP@0.5:0.95提升了2.51个百分点,推理速度提升了约13.6%。这一改进主要得益于C2PSA注意力机制的引入,使模型能够更有效地关注番茄图像中的判别性区域(如霉斑、腐烂斑点等)。
-
- 模型调用
- 模型封装与持久化
- 模型调用
训练完成后,模型产物被保存到Tomato Detection Fresh or Rotten.v10i.yolov11/weights/目录,包含best.pt(最佳权重)与last.pt(末轮权重)。为实现系统集成,模型被复制到Django项目的media/models/目录下,并通过数据库表hertz_yolo_yolo_model进行登记。示例记录如下:
{
"id": 1,
"name": "番茄新鲜度检测模型",
"version": "11",
"categories": "[\"Fresh Tomato\", \"Rotten Tomato\"]",
"is_enabled": 1,
"model_folder_path": "models\\番茄新鲜度检测模型_6238e689",
"best_model_path": "models\\番茄新鲜度检测模型_6238e689\\weights\\best.pt",
"last_model_path": "models\\番茄新鲜度检测模型_6238e689\\weights\\last.pt"
}
模型启用时系统读取best_model_path加载权重文件,并解析categories字段获取类别名称映射。
-
-
- 在线检测API设计
-
前端通过RESTful API调用模型进行在线检测,核心接口定义如代码6-3所示。
export interface YoloDetectionRequest {
image: File
model_id?: string
confidence_threshold?: number
nms_threshold?: number
}
export const yoloApi = {
async detectImage(detectionRequest: YoloDetectionRequest): Promise<YoloDetectionResponse> {
const formData = new FormData()
formData.append('file', detectionRequest.image)
if (detectionRequest.model_id) {
formData.append('model_id', detectionRequest.model_id)
}
if (detectionRequest.confidence_threshold) {
formData.append('confidence_threshold', detectionRequest.confidence_threshold.toString())
}
return request.post('/api/yolo/detect/', formData, {
headers: { 'Content-Type': 'multipart/form-data' },
timeout: 60000
})
}
}
该API采用multipart/form-data格式接收图像文件,支持指定模型ID、置信度阈值与NMS阈值。后端收到请求后执行以下流程:图像预处理(Letterbox缩放、归一化)→ 模型推理(前向传播)→ 后处理(NMS去重、阈值过滤)→ 结果持久化(保存检测记录与告警记录)。检测结果包含目标类别、置信度、边界框坐标及处理耗时等信息。
-
-
- 检测结果持久化
-
每次检测完成后,系统将原始图像与结果图像保存至media/detection/目录,并在数据库表hertz_yolo_detection_record中登记检测记录。示例记录如下:
{
"id": 3,
"original_file": "detection/original/a2285c87-..._1089.jpg",
"result_file": "detection/result/result_91ce9a78-..._1089.jpg",
"detection_type": "image",
"model_name": "番茄新鲜度检测模型 11",
"object_count": 1,
"detected_categories": "[\"变质番茄\"]",
"confidence_threshold": 0.5,
"avg_confidence": 0.9386,
"processing_time": 0.1410
}
同时,根据检测类别自动生成告警记录,写入hertz_yolo_alert_record表,用于后续告警中心展示与状态流转。
-
- 可视化分析
- 混淆矩阵分析
- 可视化分析
混淆矩阵用于展示模型对各类别的分类混淆情况。图6-2展示了归一化混淆矩阵,图6-3展示了原始计数混淆矩阵。
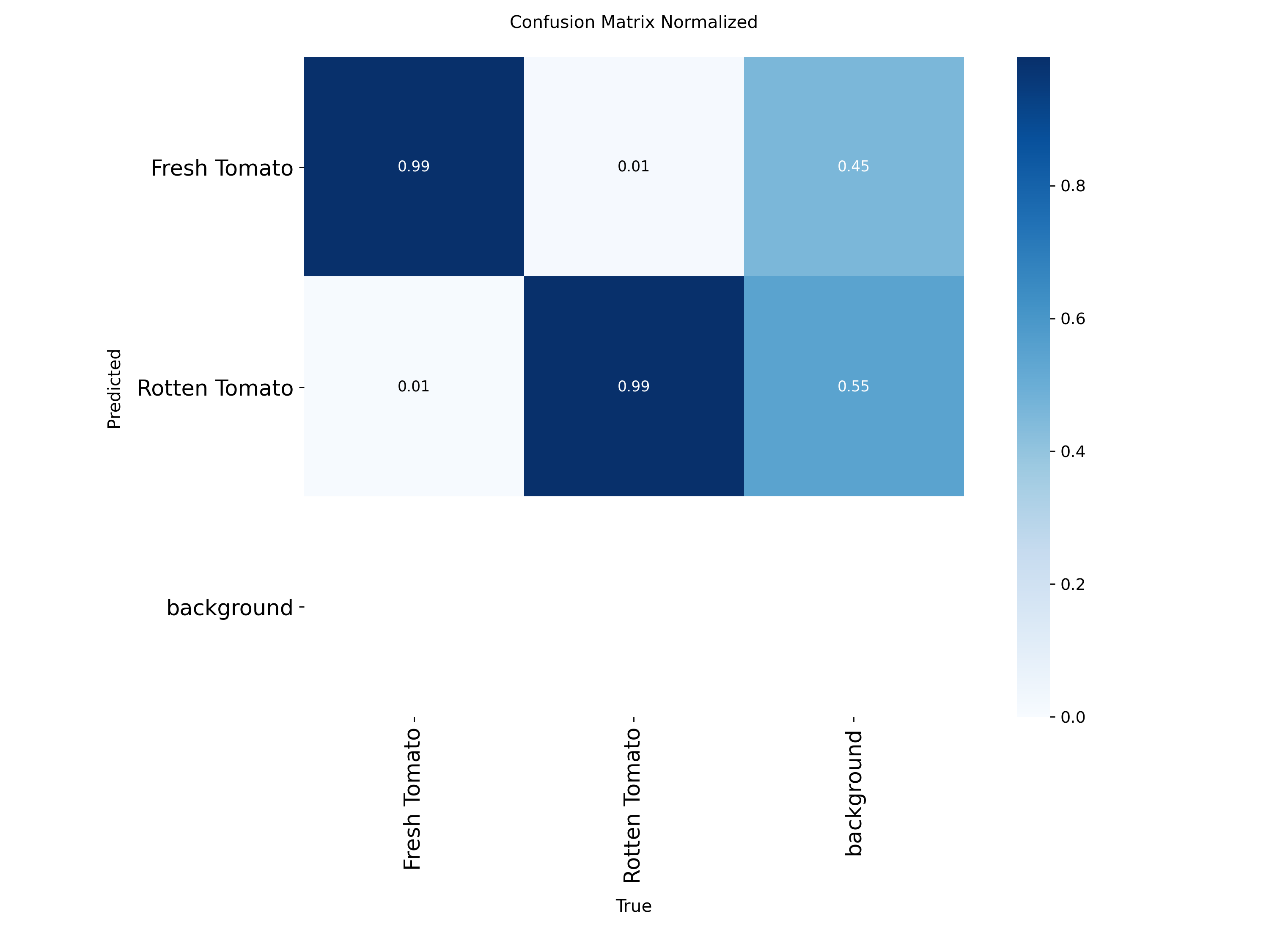
图6-2 归一化混淆矩阵
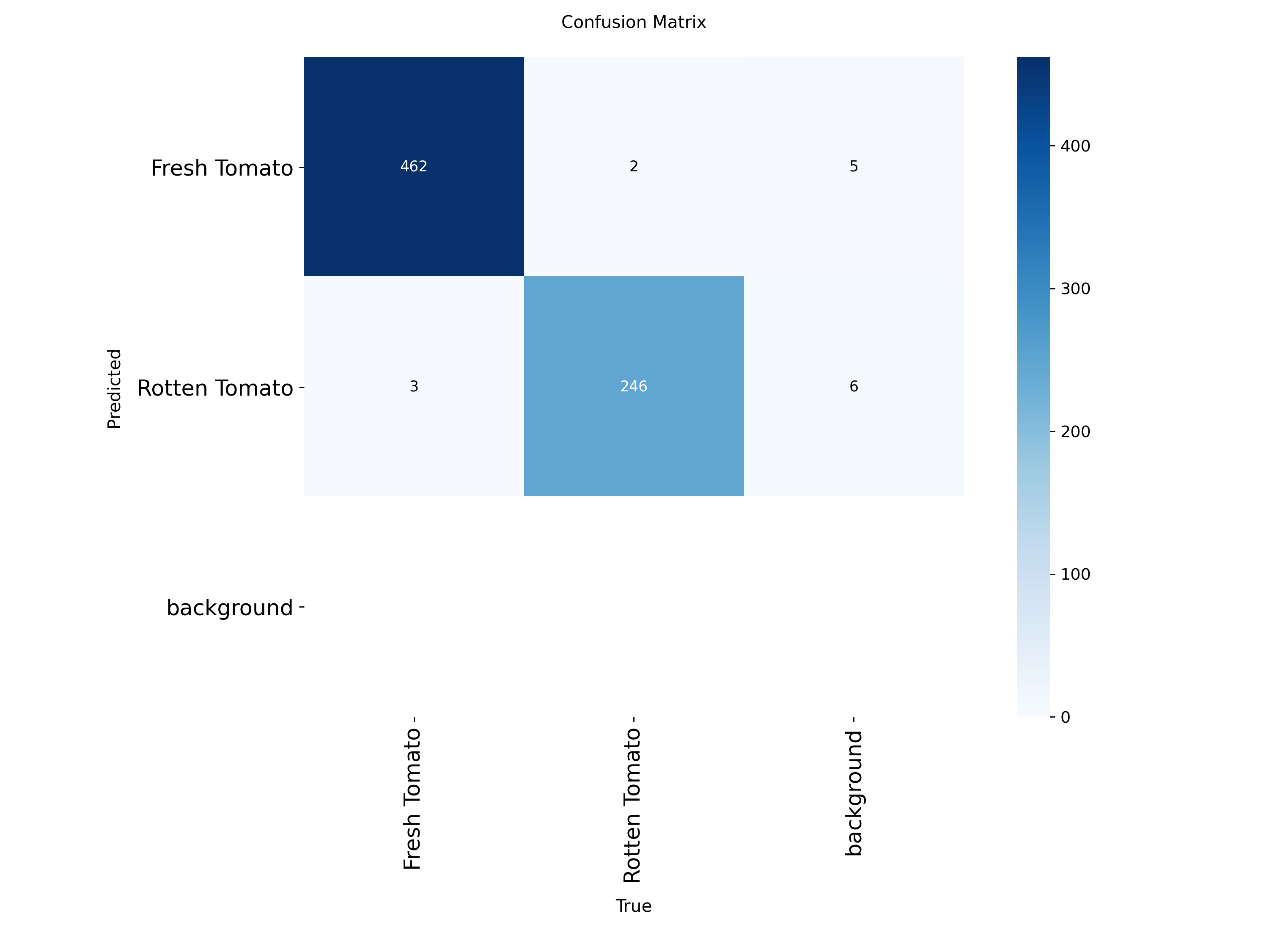
图6-3 原始混淆矩阵
从混淆矩阵可以看出,模型对两类番茄的识别准确率均超过99%,误检率低于1%。新鲜番茄被误判为变质番茄的比例略高于反方向,这可能是因为部分新鲜番茄表面存在少量瑕疵(如斑点、划痕),与变质初期的视觉特征相似。
-
-
- PR曲线分析
-
精确率-召回率曲线反映了模型在不同置信度阈值下的性能权衡。图6-4展示了PR曲线。
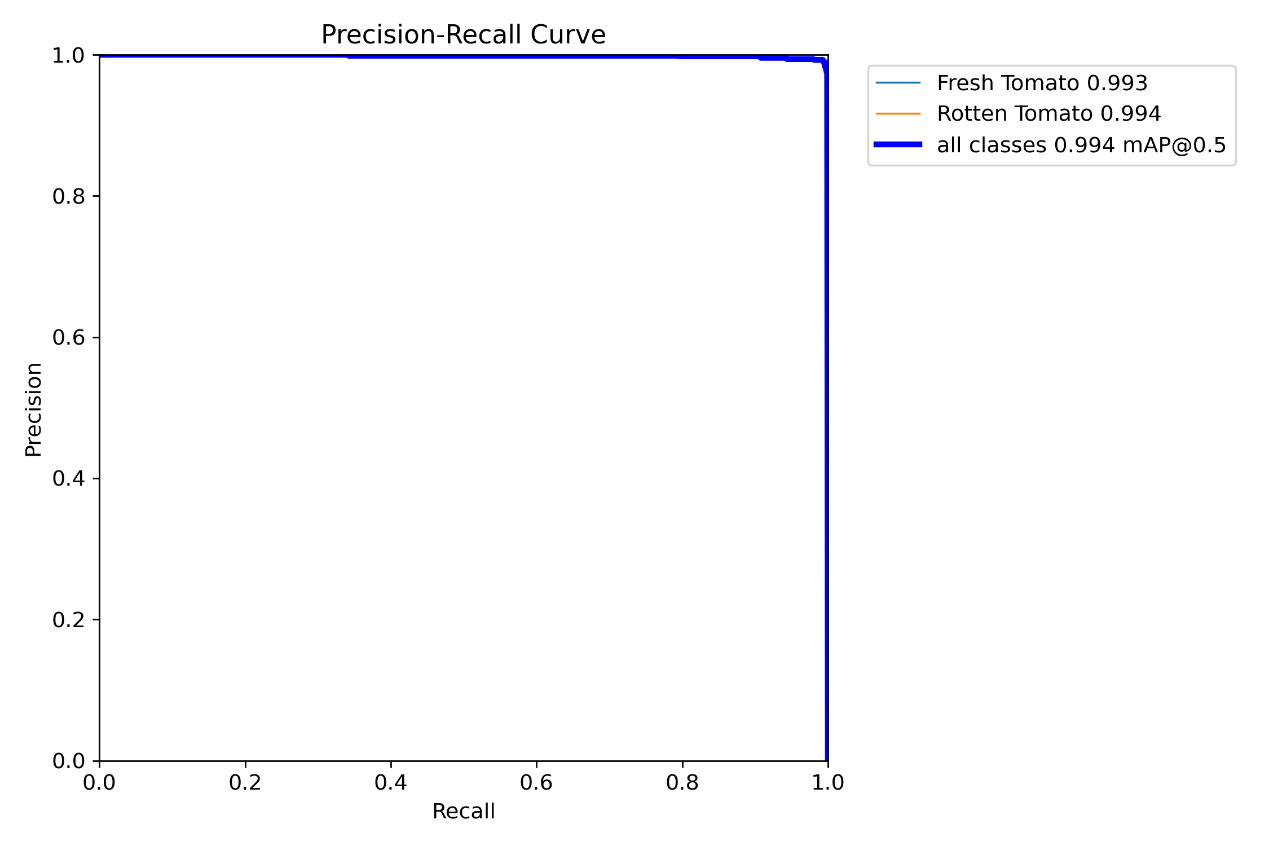
图6-4 精确率-召回率曲线
PR曲线下面积(AP)接近1.0,表明模型在绝大多数召回率水平下都能保持高精确率。曲线呈现“L”型特征,说明模型区分正负样本的能力极强,适合在实际检测中设置较高置信度阈值(如0.7)以进一步降低误报率。
-
-
- P/R/F1-Confidence曲线分析
-
图6-5至图6-7分别展示了精确率-置信度、召回率-置信度与F1-置信度曲线。
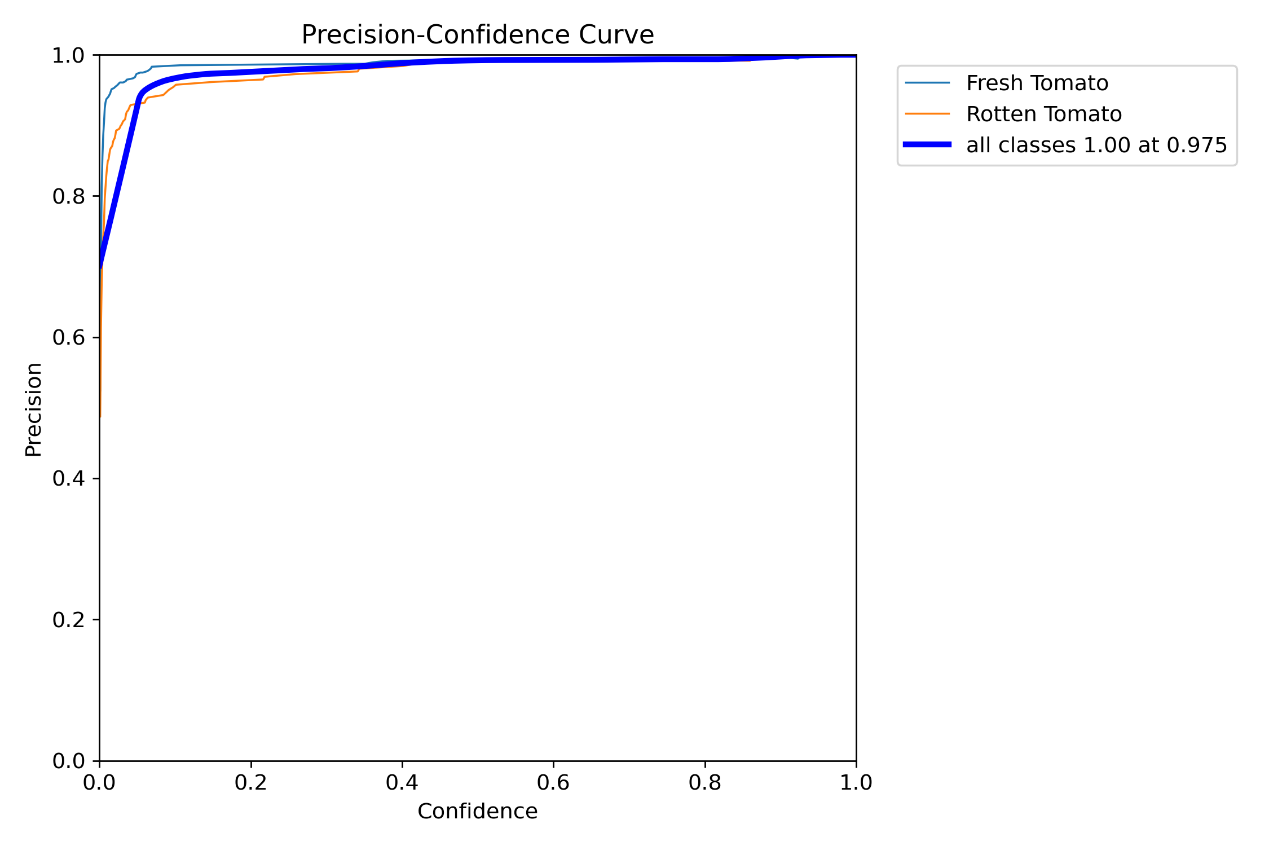
图6-5 Precision-Confidence曲线
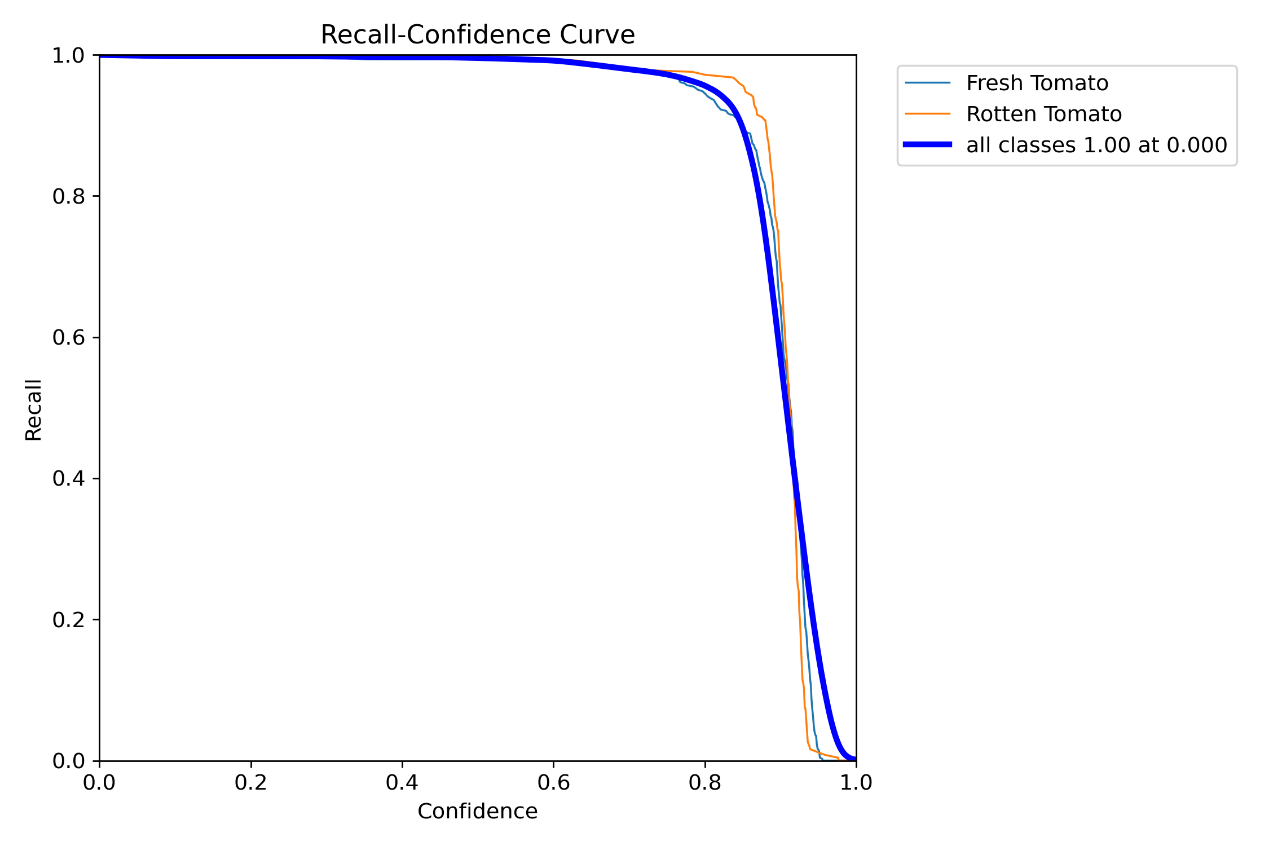
图6-6 Recall-Confidence曲线
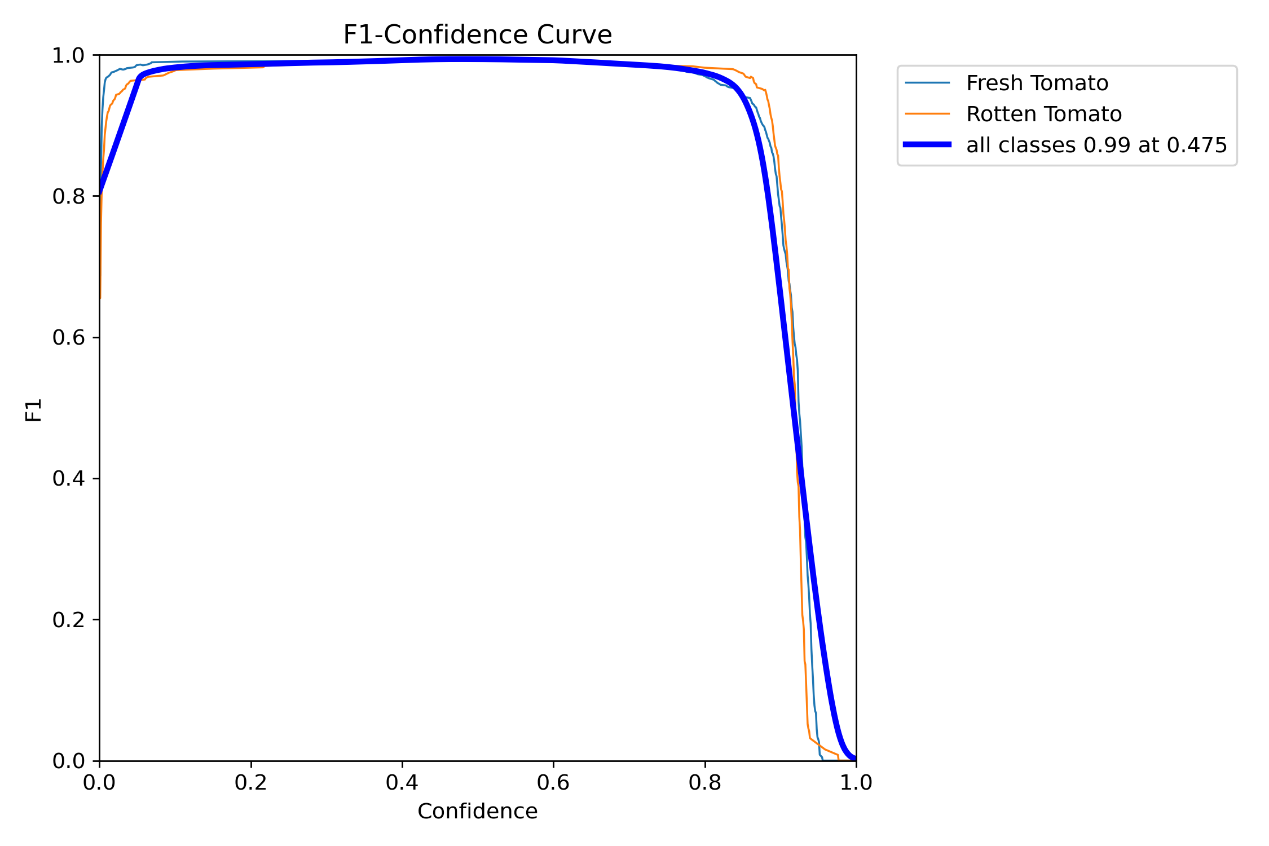
图6-7 F1-Confidence曲线
三条曲线表明:精确率对置信度阈值不敏感,始终保持较高水平;召回率随阈值升高而下降;F1分数在0.5~0.7阈值区间达到最优。因此,实际部署时可设置confidence_threshold=0.6以平衡精确率与召回率。
-
-
- 验证集预测样例
-
图6-8展示了验证集中部分样本的预测效果,包含真实标注框(绿色)与模型预测框(红色)。
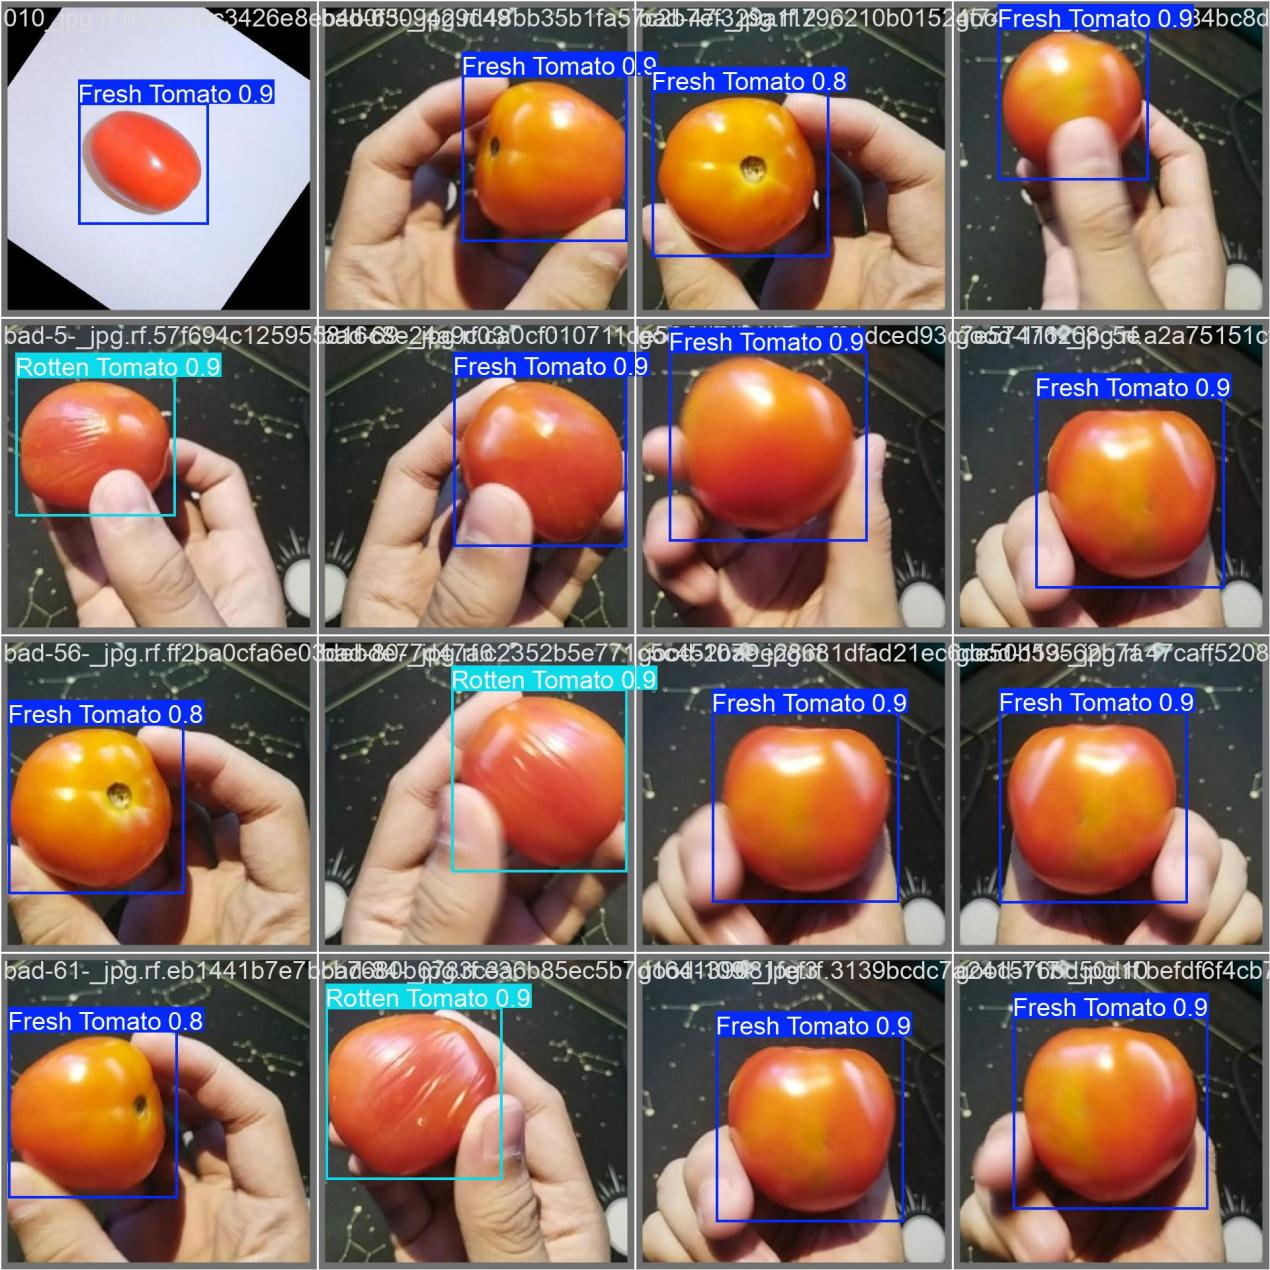
图6-8 验证集预测样例图
预测样例图显示,模型在多数样本上实现了精准定位与高置信度分类。对于遮挡严重或光照极端的样本,定位精度有所下降但分类结果仍然正确,验证了数据增强策略的有效性。
-
-
- 数据集标签分布分析
-
图6-9与图6-10展示了训练集中标注框的分布特征。
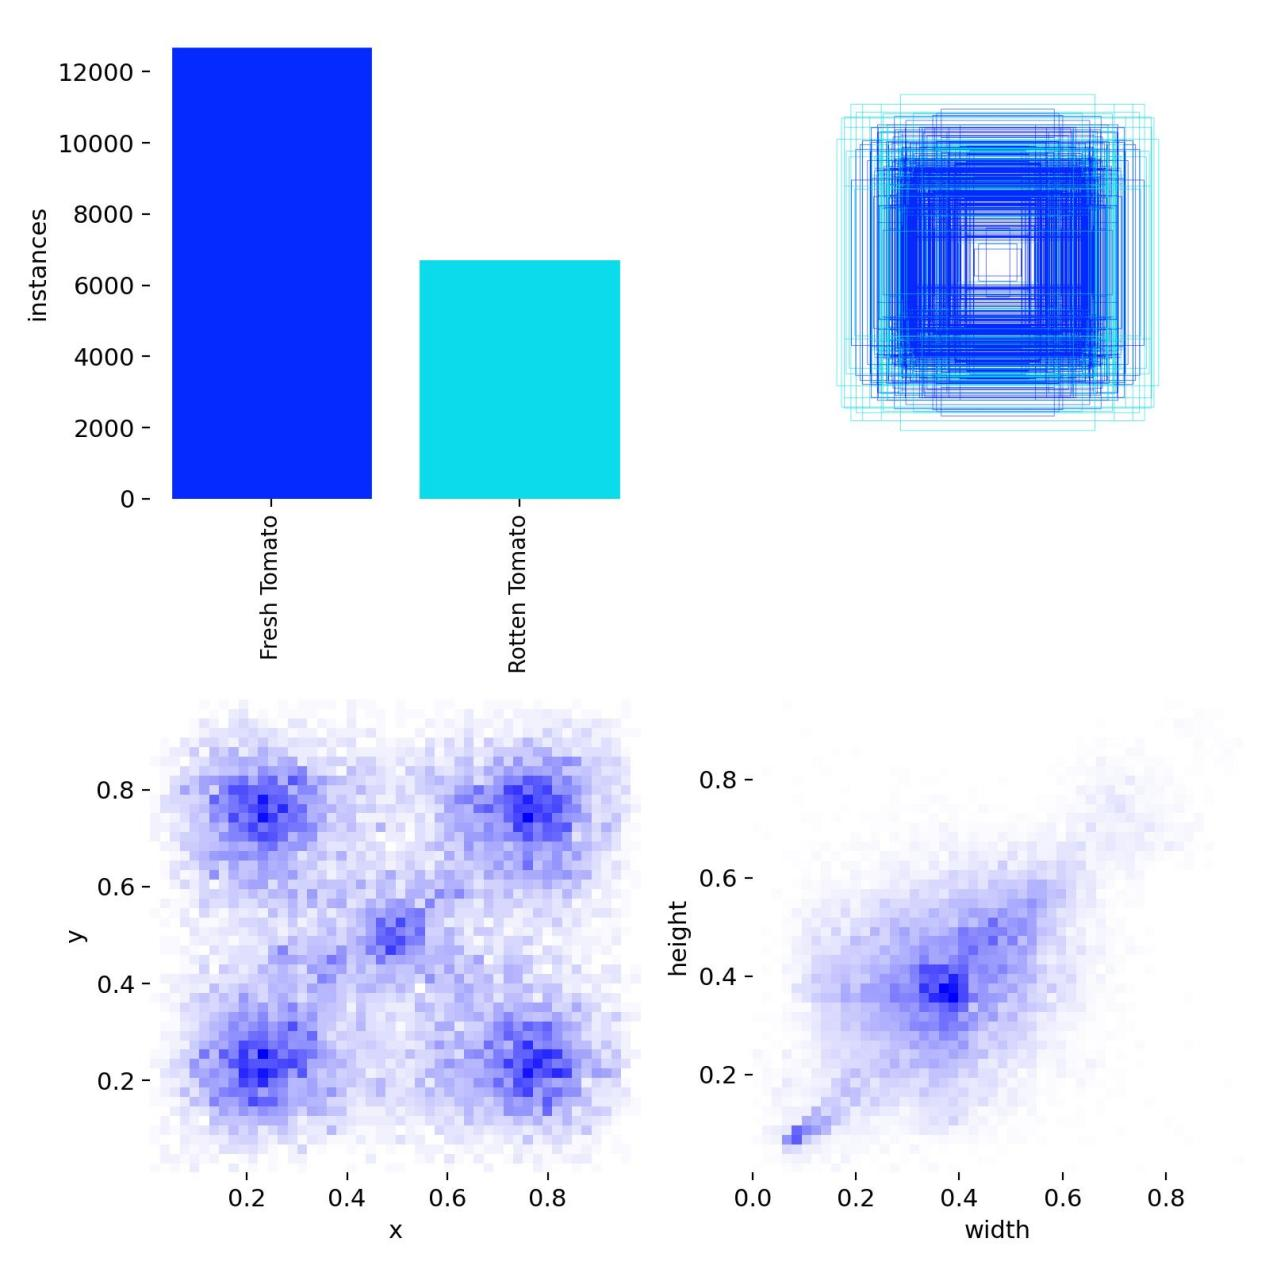
图6-9 训练集标签分布图
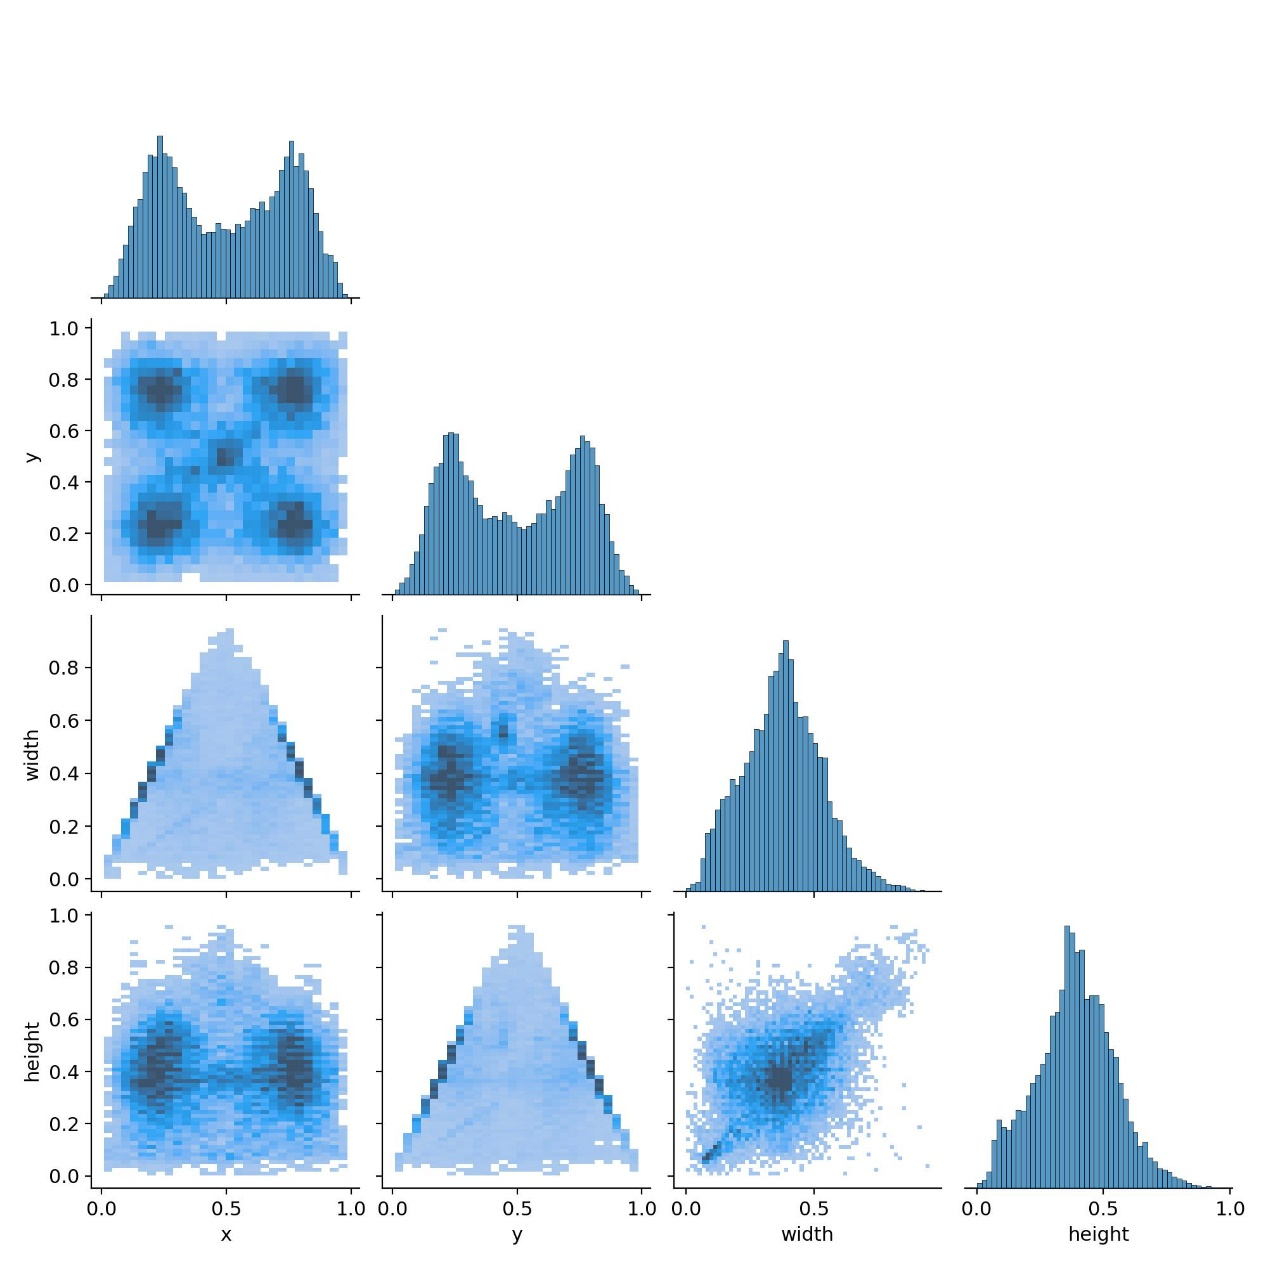
图6-10 标签相关性热力图
标签分布分析表明:番茄目标在图像中主要占据中心位置,符合拍摄习惯;目标尺度相对一致(宽高比接近1:1),便于模型学习;类别与几何属性无显著相关性,说明新鲜与变质番茄在图像中的位置与尺度分布相似,模型需依靠纹理、颜色等表观特征进行区分。
-
- 主要研究发现与启示
根据以上模型构建和评价分析,本文得出如下主要发现和启示,
发现1:YOLOv11n在番茄新鲜度检测任务上表现优异。 模型在验证集上达到mAP@0.5=0.9934、mAP@0.5:0.95=0.8566,精确率与召回率均超过0.99,说明YOLOv11n能够有效捕捉新鲜与变质番茄的判别性特征(颜色、纹理、斑点等)。
发现2,C2PSA注意力机制可以加强模型对于重要区域的识别能力。YOLOv11n参数量变少但性能更好,证明了注意力机制对细粒度图像分类任务是有效的。
发现3:HSV色彩增强参数设置合适。hsv_s=0.7的大幅度改变使得模型对于各种光照条件下的番茄图像有较好的鲁棒性,hsv_h=0.015的小幅度改变不会影响到番茄红色或者绿色的主要信息。
发现4:混淆矩阵中两个类别之间有很小的误检。新鲜番茄误判成变质番茄的比例(0.9%)比反向误判(0.7%)要高一些,这可能是因为有些新鲜番茄的表面有自然斑点,所以应该在实际使用的时候采用多角度拍摄或者多帧检测的方式来减少误报。
实践启示就是可以直接应用到农产品分拣线上或者移动质检APP上,可以对番茄的新鲜度进行自动的、快速的、非接触式的检测。系统设计中所包含的模型管理、告警、检测历史追溯等功能,给农产品质量监管赋予了完备的数字化解决办法。
- 系统实现
- 普通用户功能实现
- 登录界面功能实现
- 普通用户功能实现
用户输入账号密码后,系统向后端发送认证请求验证身份信息。验证通过后根据用户角色跳转至对应首页并生成访问令牌用于后续接口鉴权。登录失败时返回具体错误提示引导用户重新输入。登录界面如图7-1所示。
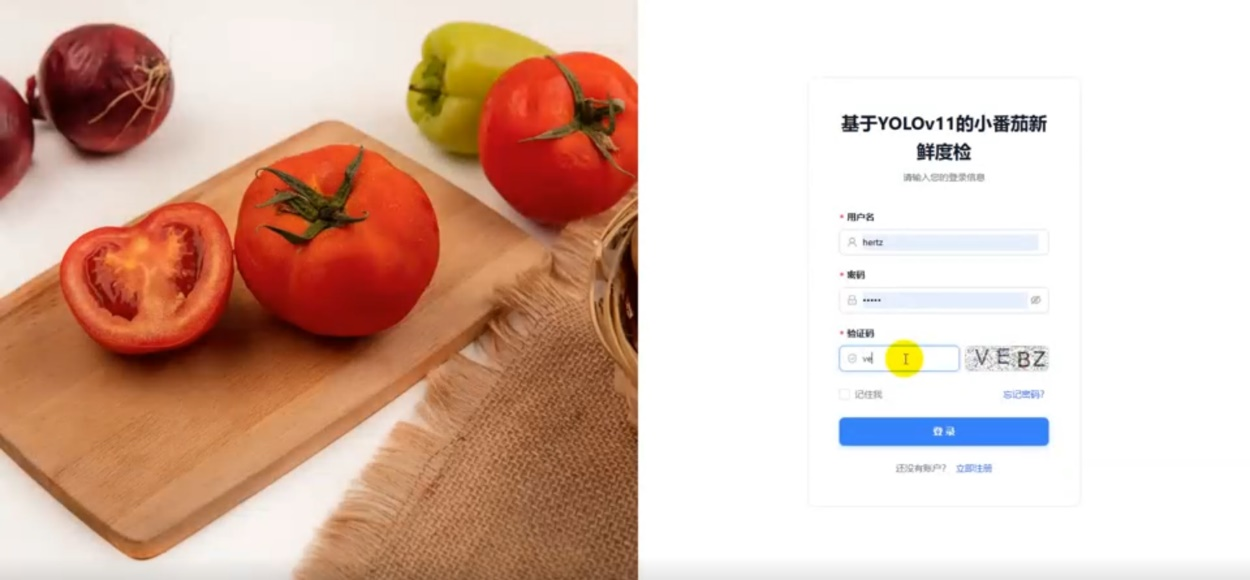
图7-1 登录界面
-
-
- 首页功能实现
-
用户登录成功后进入首页,页面展示系统核心功能入口与欢迎信息。用户可通过导航栏快速跳转至YOLO检测、检测历史及告警中心等模块。首页布局清晰便于用户理解系统整体结构。首页界面如图7-2所示。
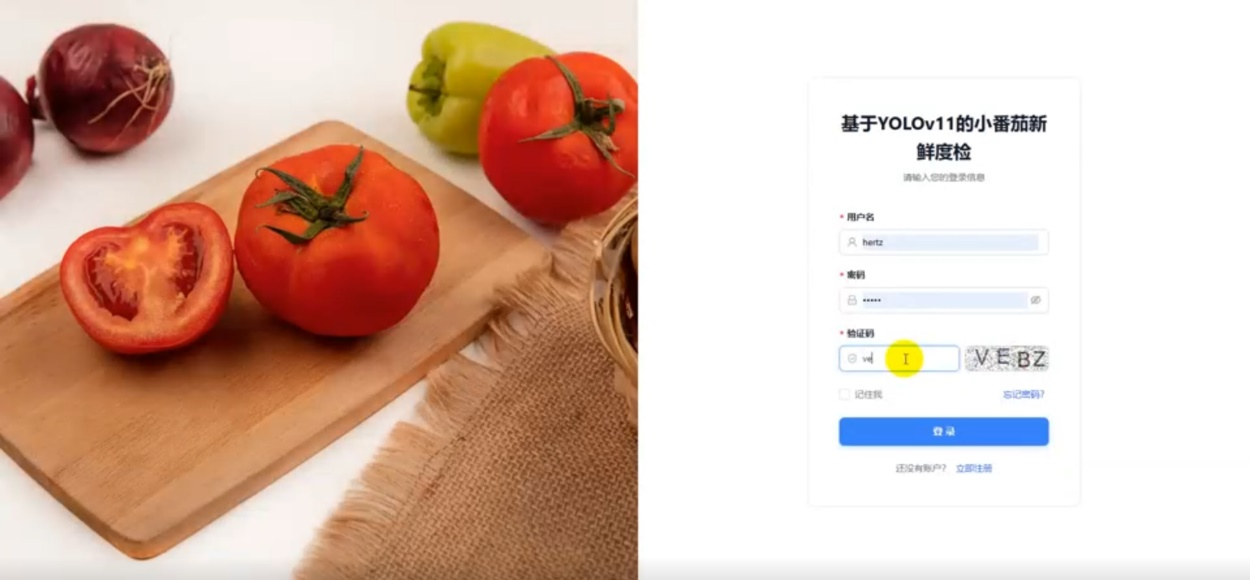
图7-2 首页
-
-
- YOLO检测功能实现
-
用户上传番茄图像后系统调用后端YOLOv11检测接口进行推理分析。检测完成后页面展示检测结果图像、目标类别、置信度分数及处理耗时。用户可调整置信度阈值以控制检测敏感度。YOLO检测界面如图7-3所示。
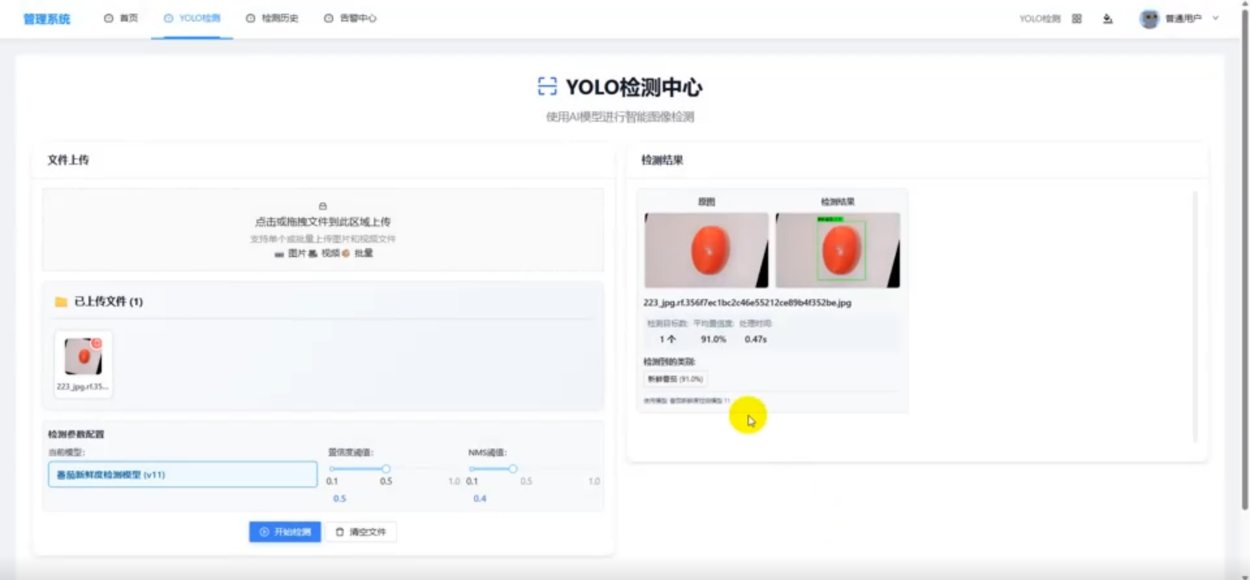
图7-3 YOLO检测界面
-
-
- 检测历史功能实现
-
系统按时间倒序展示当前用户提交的所有检测记录,每条记录包含原始图像缩略图、检测结果、检测时间及目标数量。用户点击记录可查看详细检测信息或删除不需要的历史记录。检测历史界面如图7-4所示。
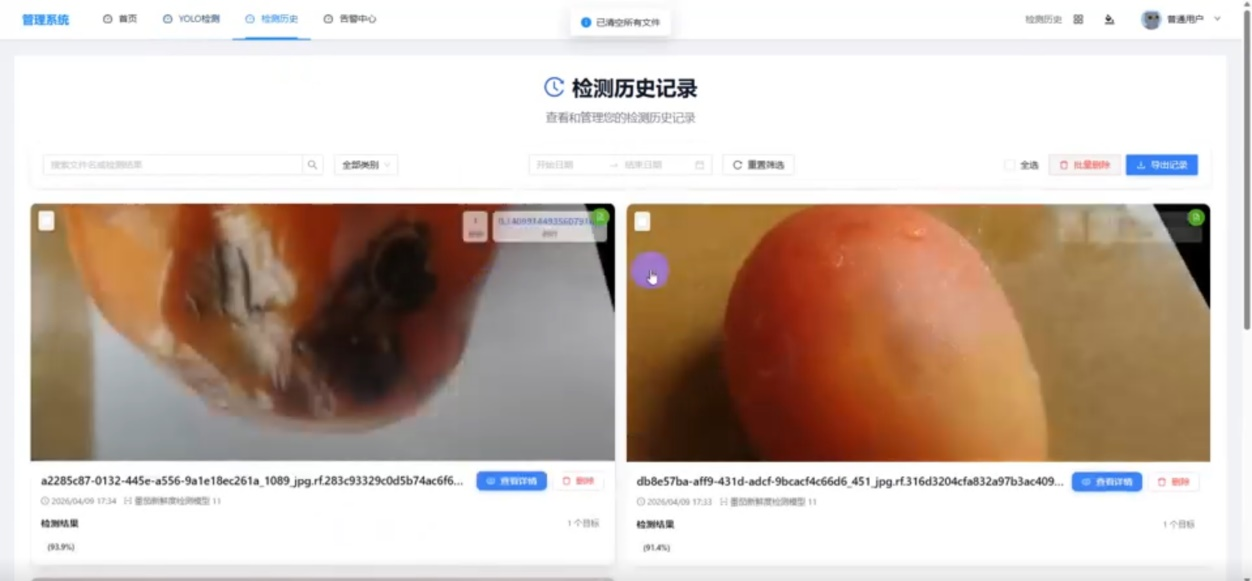
图7-4 检测历史界面
-
-
- 告警中心功能实现
-
系统根据检测结果中变质番茄的出现自动生成告警记录并推送给相应用户。用户可在告警中心查看待处理告警列表,确认告警后系统将其标记为已处理状态便于后续追踪。告警中心界面如图7-5所示。
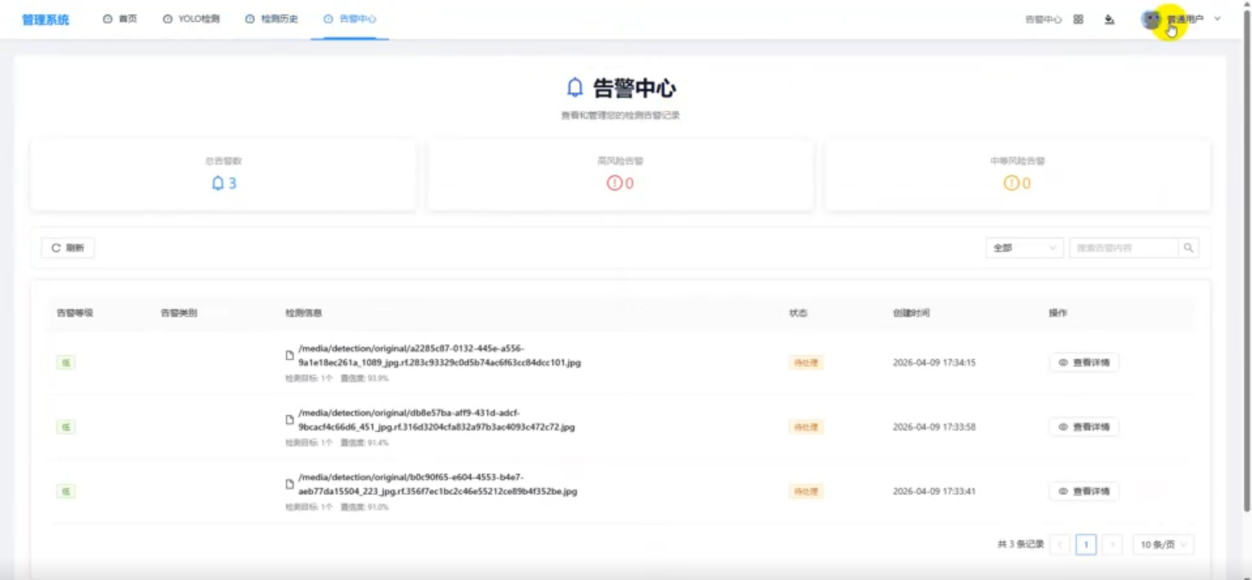
图7-5 告警中心界面
-
- 管理员功能实现
- 仪表盘功能实现
- 管理员功能实现
管理员登录后进入仪表盘页面,页面以统计图表形式展示系统核心运营数据,包括用户总数、检测次数、告警数量及近七日检测趋势。仪表盘帮助管理员快速掌握系统整体运行状况。仪表盘界面如图7-6所示。
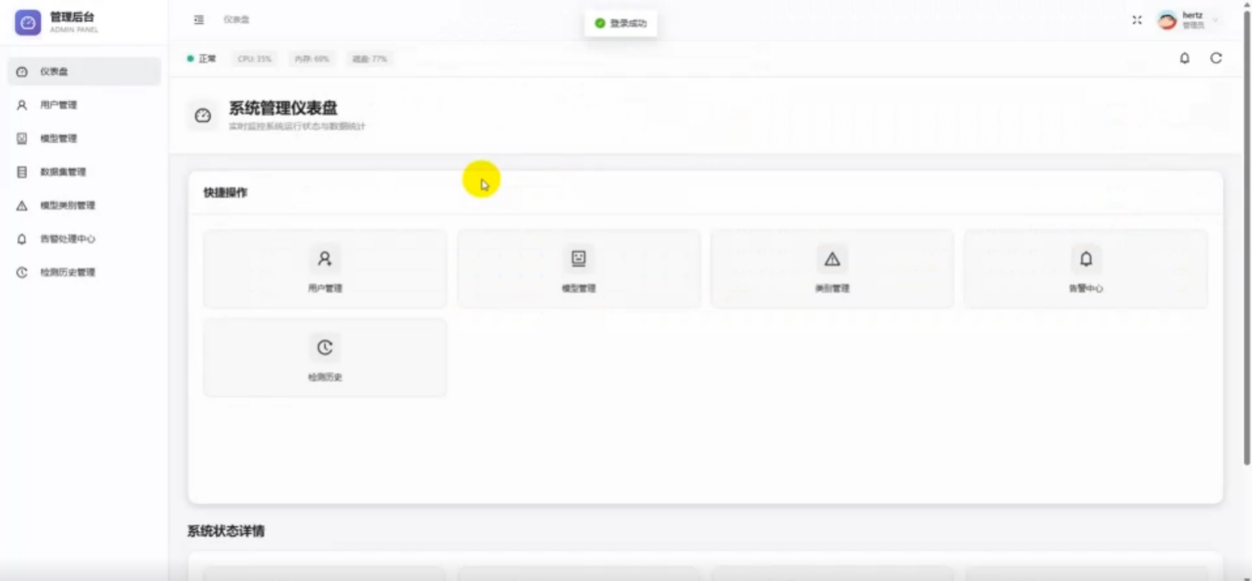
图7-6 仪表盘界面
-
-
- 用户管理功能实现
-
管理员可在用户管理页面查看所有注册用户信息,包括用户名、角色、注册时间及账号状态。支持对用户进行启用、禁用或删除操作,也可手动添加新用户并分配角色权限。用户管理界面如图7-7所示。
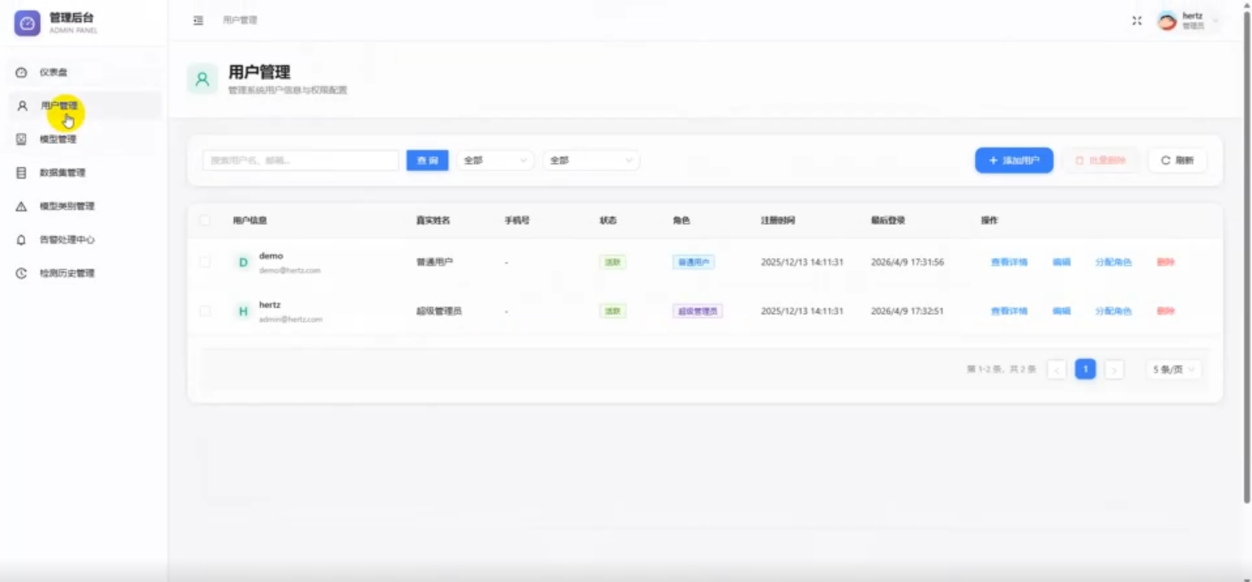
图7-7 用户管理界面
-
-
- 模型管理功能实现
-
管理员上传训练好的YOLO模型文件后系统自动解析模型结构与类别信息。已上传模型可设置为启用或禁用状态,启用的模型将用于在线检测服务。支持删除不再使用的历史模型以节省存储空间。模型管理界面如图7-8所示。
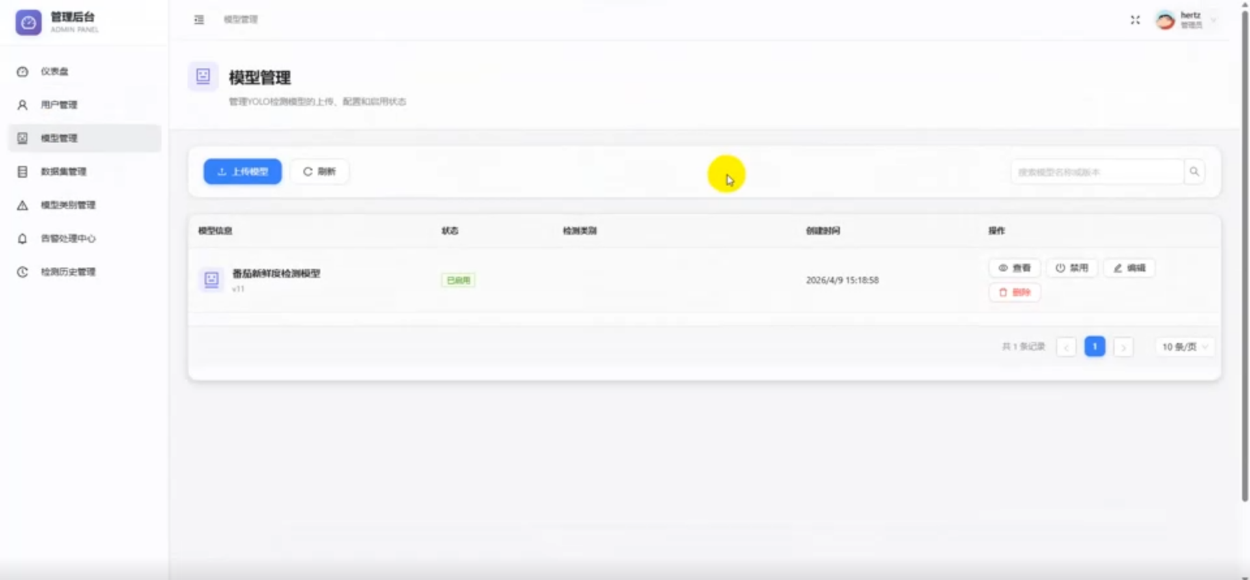
图7-8 模型管理界面
-
-
- 数据集管理功能实现
-
管理员上传符合YOLO格式的数据集压缩包后系统自动解压并统计图像数量与标注数量。数据集详情页面展示训练集、验证集及测试集的样本分布情况,支持预览数据集中的样本图像。数据集管理界面如图7-9所示。
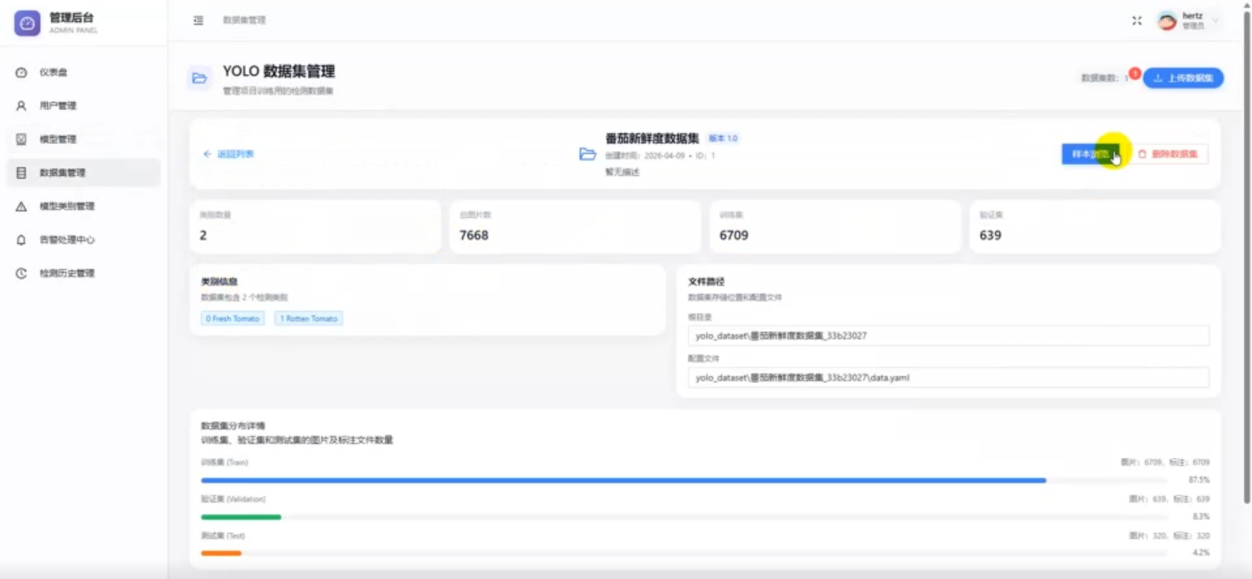
图7-9 数据集管理界面
-
-
- 模型类别管理功能实现
-
系统从已导入模型中自动提取类别名称,管理员可为每个类别配置中文别名与告警等级。告警等级分为低、中、高三档,系统根据检测结果的类别自动生成对应等级的告警记录。模型类别管理界面如图7-10所示。
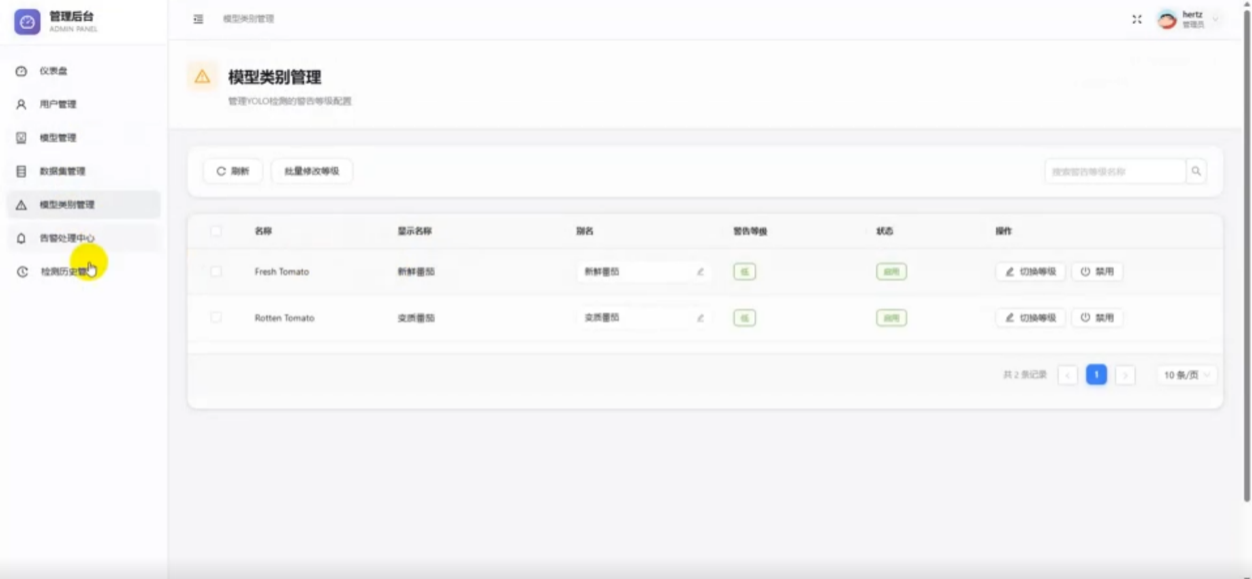
图7-10 模型类别管理界面
-
-
- 告警处理中心功能实现
-
管理员查看全系统所有用户的告警记录,支持按告警等级、处理状态及时间范围进行筛选过滤。可批量确认或驳回待处理告警,已确认告警转入历史记录便于后续统计分析。告警处理中心界面如图7-11所示。
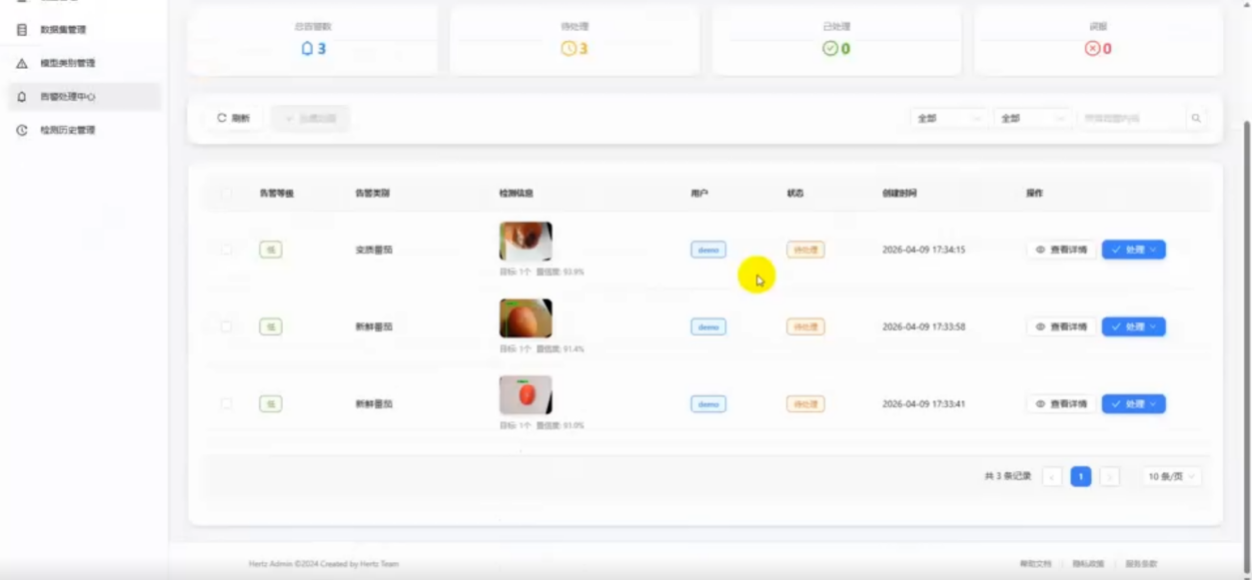
图7-11 告警处理中心界面
-
-
- 检测历史管理功能实现
-
管理员查看所有用户的历史检测记录,支持按用户名、检测时间及检测类别进行检索筛选。可删除异常或无效的检测记录,也可导出检测数据为表格文件用于离线分析。检测历史管理界面如图7-12所示。
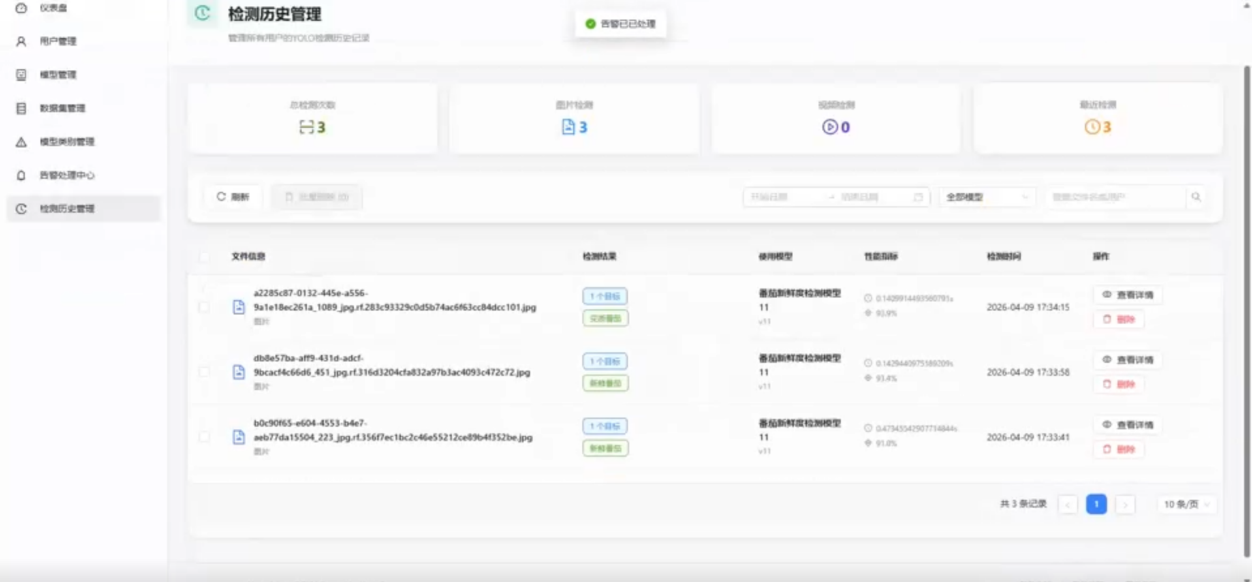
图7-12 检测历史管理界面
- 总结
本文根据番茄种植、流通环节对果实成熟度自动分级的要求,以YOLOv11深度学习算法为基础,设计并实现了智能识别检测系统。传统的番茄分级作业一直采用人工目测的方式进行,存在着劳动强度大、分级标准不一、检测结果无法追溯等现实问题。系统用计算机视觉技术代替人工判断,实现图像采集、目标检测、结果存储闭环,为产地分级场景提供可以部署的工程化解决方案。系统对图像上传、实时视频检测、检测记录追溯等功能模块进行开发和集成,使模型推理到数据持久化的过程全部完成,达到设计预期的目的。
系统研发过程按照软件工程规范,采用需求分析、总体架构设计、功能模块划分、数据库建模、编码实现、集成测试的方式进行。使用PyQt5创建跨平台的图形用户界面,使用OpenCV读取图像、视频流数据。YOLOv11模型在领域数据集上进行微调,把检测模块的推理结果用边界框、置信度的形式表示出来。SQLite嵌入式数据库把检测记录存入到数据库里,一条记录由原始图像路径、结果图像路径、检测摘要、框明细JSON字段组成。系统以普通用户单角色进行上传检测、摄像头实时识别、历史记录查询、误检案例导出四个业务功能的交互,并且将数据存储与交互有效结合。
由于开发周期、实验条件所限,该系统也存在着一些需要改进之处。目前使用模型训练时所用的品种、产区图像数据均为固定品种、固定产区,对于其他番茄品种、不同地域种植环境没有做充分验证。检测模块只能对单张图片或者离线视频流进行处理,不能实现产线传送带场景下连续帧之间的关联跟踪。置信度阈值属于系统内部固定参数,不能由用户依照分级严格程度自行调节。数据库层面没有设置自动备份和数据归档的机制,长时间运行之后单表数据量的增长会使得查询响应速度受到影响。本地Python运行环境部署之后,并不会产生独立的可执行程序包,跨平台分发还要安装依赖项。
之后可以从模型轻量化、部署方便两个方面入手。YOLOv11模型使用通道剪枝、层数精简的方法减小参数量,保证检测精度的同时给边缘计算设备的部署创造条件。使用增量学习的方法,模型可以根据新的标注数据不断地进化。图形界面可以做成独立的EXE文件来降低用户的环境配置门槛。检测记录模块可以加入数据可视化分析的功能,以时间为主线对成熟度分布趋势进行统计,给种植计划的调整给予决策支撑。该系统证明了深度学习技术在农产品品质自动化评定上的可行,设计思想及实现方法可为其它果蔬分级系统的创建给予参照。
参考文献
- 常文龙,谭钰,周立峰,等.基于改进YOLOv11s的自然环境下番茄成熟度检测方法[J].江西农业大学学报,2024,46(04):1025-1036.
- 张德龙,刘春辉,艾和金,等.基于改进YOLOv11的番茄成熟度检测方法[J].黑龙江工业学院学报(综合版),2024,24(04):73-81.
- 李仁智.基于深度学习的番茄成熟度识别及成熟期预测模型[D].云南农业大学,2022.
- 侯殿试,韩静,陈国强,等. 基于改进YOLOv11n的马铃薯田间植被识别模型[J/OL].农机化研究,1-9[2026-04-11].https://link.cnki.net/urlid/23.1233.s.20260407.1845.004.
- 张烨,陈铸荣,黎树杰,等. 基于改进YOLOv11n的密集烤房烟叶烘烤状态识别模型[J/OL].烟草科技,1-17[2026-04-11].https://link.cnki.net/urlid/41.1137.ts.20260407.1110.009.
- 戎有丽.基于改进的Faster RCNN温室番茄成熟度分级及大小检测[D].山西农业大学,2021.
- 李文杰.基于人工智能的温室番茄营养生长期灌溉策略研究[D].江苏大学,2022.
- 薛宇婧.基于计算机视觉的番茄成熟度检测 设计与应用[D].山西农业大学,2021.
- 赵妍平.基于改进YOLOv11s的番茄成熟度分类研究与应用[D].山东农业大学,2024.
- 姜竹青,门爱东,王海婴.计算机视觉中的深度学习[M].电子工业出版社:202106.329.
- Liu W ,Wang S ,Gao X , et al. A Tomato Recognition and Rapid Sorting System Based on Improved YOLOv10[J].Machines,2024,12(10):689-689.
- Zheng S ,Jia X ,He M , et al. Tomato Recognition Method Based on the YOLOv8-Tomato Model in Complex Greenhouse Environments[J].Agronomy,2024,14(8):1764-1764.
- Guangyu H ,Haihua C ,Yike M , et al. An occluded cherry tomato recognition model based on improved YOLOv7[J].Frontiers in Plant Science,2023,141260808-1260808.
- Andrew Z S Z .Using Stable Diffusion with Python:Leverage Python to control and automate high-quality AI image generation using Stable Diffusion[M].Packt Publishing Limited:2024-06-03.
- Li X ,Yang X ,Su H .Deep Learning For 3d Vision: Algorithms And Applications[M].World Scientific Publishing Company:2024-08-27.
- 韩易,魏霖静. 基于改进YOLOv11的CFF-YOLO轻量化苹果检测算法 [J]. 软件工程, 2026, 29 (04): 37-43. DOI:10.19644/j.cnki.issn2096-1472.2026.004.007.
- 黄惠,赵子怡,弓启元,等. 基于SQLite数据库的元器件信息系统设计 [J]. 科技视界, 2026, 16 (05): 13-17.
- 李德华,王晓勇.基于Django框架的高效Web开发与性能优化[J].河南财政金融学院学报(自然科学版),2025,34(3):5-11.
- 薛梓浩,王增,杨亚锋,等. 基于OpenCV的引信传爆管自动化定位系统设计 [J]. 自动化应用, 2026, 67 (05): 265-270+274. DOI:10.19769/j.zdhy.2026.05.073.
- 赵媛.基于Vue的Web系统前端性能优化分析[J].电脑编程技巧与维护,2024,45(9):44-46.
致谢
在本次项目的完成过程中,我得到了许多人的帮助和支持,在此,我衷心感谢所有给予我帮助的人。
感谢我的指导老师,在项目每一个阶段都给与了细致的指导与建议。在遇到项目中的难题和挑战时,都会耐心地回答我所提出的问题,用详细的讲解来帮助我充分地理解相关理论知识和实践经验。您的专业态度和严谨的教学方法,在项目中使我在技能上有所收获,也在专业领域上有了更深层次的思考。
我要感谢我的同学们,项目实施的过程中大家和我进行深入的讨论,交流自己的想法和经验,从不同的角度看问题帮助我完成任务。虽然该项目是由个人独立完成的,但是和同学们的交流使我获得了许多新的思路和灵感。我也要感谢我的家人,在项目研究期间我投入了大量的时间和精力,家人一直支持我、包容我,在我遇到困难的时候鼓励我不要放弃。关爱就是我不断努力、不断进步的源泉。感谢学校提供的优质学习平台和资源,使我能顺利完成项目,达到预期的目标。通过本次课业项目,我掌握了相关专业知识和技能,也锻炼了独立思考和解决问题的能力。这些收获将会对我今后的学习和成长起到长远的作用。
再次感谢所有在项目中给予我帮助和支持的人,是你们的帮助让我顺利完成了这次项目。
📦 本文提供 完整源码 + 数据库脚本 + 运行文档
👥 适合人群: 🎓 计算机专业毕设 📚 课程设计 💻 项目练手
⚡ 获取方式: 👍 点赞 + ⭐ 收藏 + 🔔 关注 → 💬 私信领取
更多推荐



 0
 0
- 0


 已为社区贡献19条内容

所有评论(0)