
从“会聊天”到“真干活”:2026 年 AI Agent 到底火在哪里?一文讲透大模型、工具调用、记忆与工作流
最近 CSDN 上 AI Agent 为什么这么火?
它和普通的大模型聊天到底有什么区别?
OpenClaw、MCP、Skills、工具调用又是什么关系?
本文不讲复杂概念,用大白话把整个 AI Agent 技术链路讲清楚。
一、最近为什么大家都在聊 AI Agent?
如果你这几天关注人工智能技术,会发现一个非常明显的变化:
以前大家讨论最多的是:
GPT 有多强?
DeepSeek 怎么样?
大模型参数有多少?
上下文有多长?
而现在大家越来越关心另外一个问题:
AI 除了回答问题,还能不能替我把事情做完?
这个变化特别明显。
最近 CSDN 上连续出现了 AI Agent 工程化、Agent 记忆、多 Agent、OpenClaw、MCP、AI 编程等主题。
这说明开发者关注的重点,正在从:
“大模型能说什么”
逐渐转向:
“大模型到底能做什么”。
这就是 AI Agent 今年越来越火的核心原因。
二、普通 AI 和 AI Agent 到底有什么区别?
这个问题是理解 Agent 的第一步。
普通聊天机器人通常是:
用户提问 → 大模型 → 返回答案
例如:
你:
帮我分析一下 Python 为什么报错

↓

大模型:

你的代码可能存在类型错误……
它主要负责:
理解 + 生成
但是 AI Agent 不一样。
它更像这样:
用户提出任务
      ↓
AI理解任务
      ↓
判断需要做什么
      ↓
制定执行步骤
      ↓
调用工具
      ↓
拿到结果
      ↓
继续判断
      ↓
继续调用工具
      ↓
任务完成
      ↓
返回最终结果
这也是最近很多 CSDN 文章强调的“从 ChatBot 到自主智能体”的核心变化。
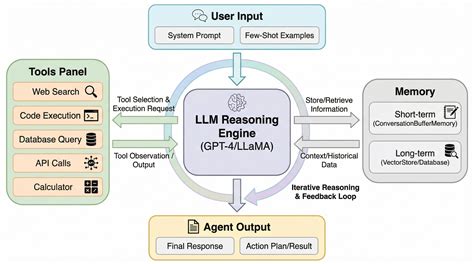
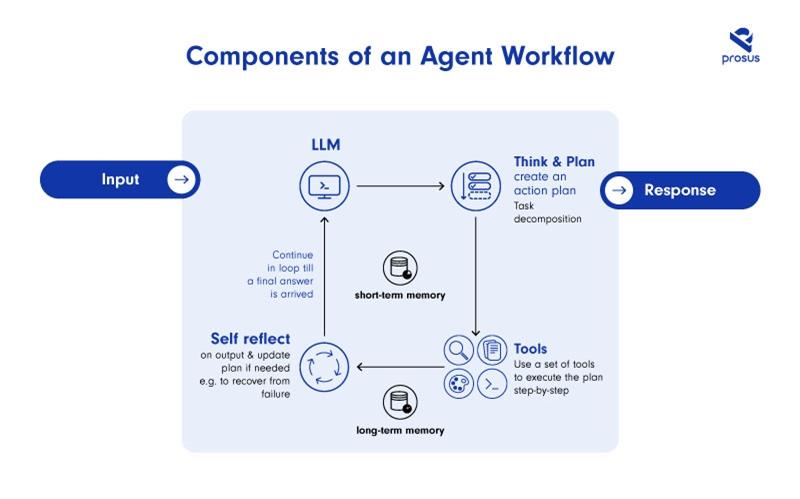
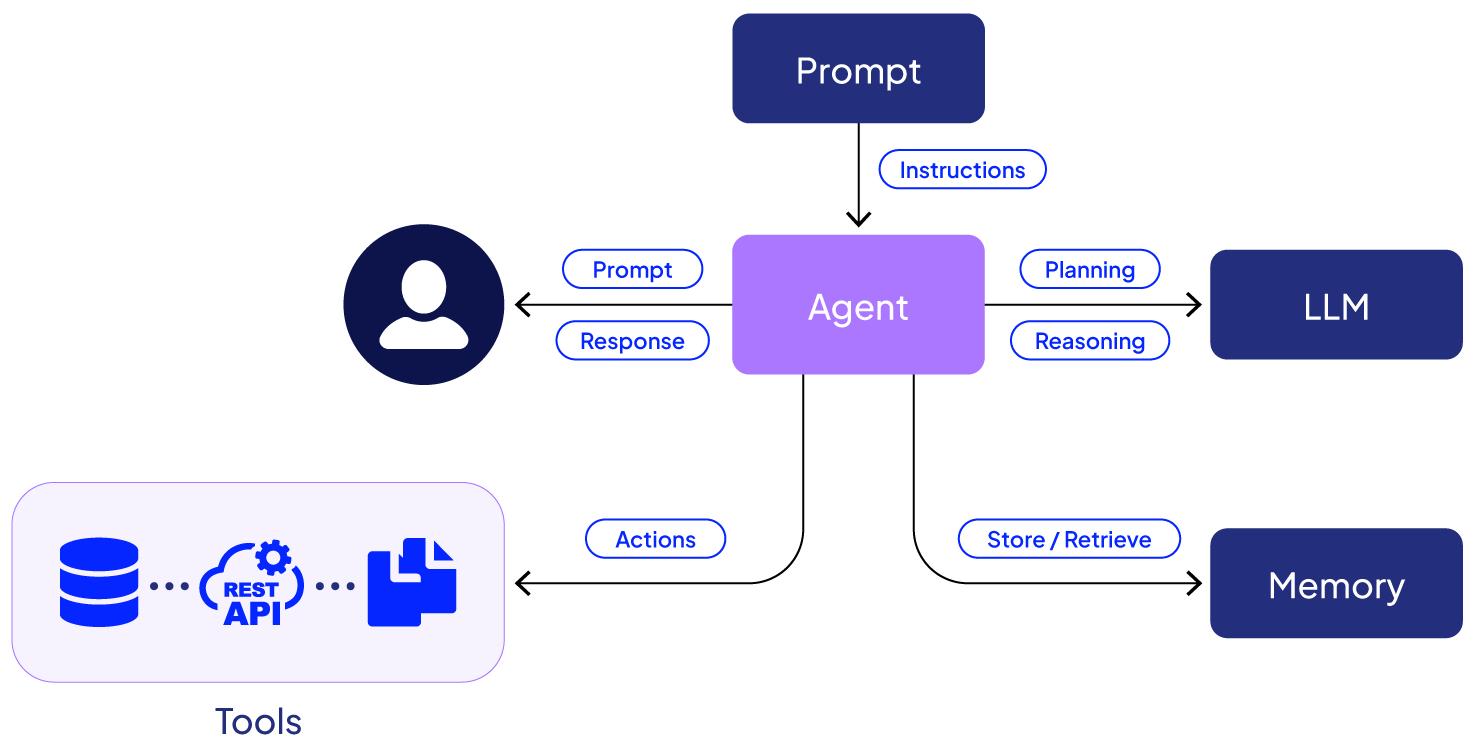
三、什么才是真正的 AI Agent?
很多人现在有一个误区:
“接一个大模型 API,就是 Agent。”
其实不是。
一个真正能够执行任务的 Agent,通常至少需要几部分能力:
             AI Agent
                 │
     ┌───────────┼───────────┐
     ↓           ↓           ↓
   大模型        工具        记忆
     │           │           │
   思考推理     真正执行     保存上下文
     │           │           │
     └───────────┼───────────┘
                 ↓
              工作流
                 ↓
             完成任务
可以简单记住:
模型负责想,工具负责做,记忆负责记,工作流负责组织。
这句话基本可以把 AI Agent 说清楚。
四、第一部分:大模型到底负责什么?
先别把大模型想得太神秘。
在 Agent 里面,大模型最核心的工作就是:
理解 + 推理 + 决策。
例如用户说:
“帮我整理一下今天的项目日志,然后找出异常。”
大模型首先要理解:
整理日志
+
寻找异常
接下来它可能自己拆分任务:
第一步:读取日志
第二步:分析日志
第三步:找到异常
第四步:整理结果
所以 Agent 并不是简单地把用户问题直接扔给模型。
而是:
让模型参与整个任务过程。
五、第二部分:为什么 Agent 一定需要工具?
这个特别重要。
假设你问:
“帮我看看服务器今天的 CPU 使用情况。”
大模型自己是不知道的。
因为:
模型不知道你的服务器现在发生了什么。
这时候怎么办?
给它一个工具。
例如:
def get_cpu_usage():
    # 获取服务器 CPU 使用率
    return 76
然后 Agent 就可以:
用户:
服务器 CPU 怎么样?

        ↓

Agent
        ↓
需要实时数据
        ↓
调用 get_cpu_usage()
        ↓
返回 76%
        ↓
Agent分析
        ↓
CPU 当前负载偏高
这时候 AI 才真正从:
“会回答”
变成:
“会干活”。
最近 CSDN 上关于“大模型技术全景”“工具调用实战”的内容,也明显在强调这一层能力。
六、工具调用到底是什么?
其实原理并没有大家想象中那么复杂。
例如你有:
def search_weather(city):
    return f"{city}今天晴天"
大模型收到:
“帮我查北京天气”
它可能不会直接回答。
而是先判断:
我需要天气工具。
然后生成类似:
{
  "tool": "search_weather",
  "arguments": {
    "city": "北京"
  }
}
你的程序看到以后:
调用 search_weather("北京")
得到:
北京今天晴天
再把结果交给大模型。
于是:
用户
 ↓
大模型
 ↓
选择工具
 ↓
Python函数
 ↓
工具结果
 ↓
大模型
 ↓
最终答案
这就是最基础的 Tool Calling。
七、第三部分:为什么 Agent 还需要“记忆”?
假设你第一次告诉 AI:
“我是 Python 开发者。”
过了一会儿你又问:
“帮我写一个 Agent。”
一个没有记忆的系统很可能不知道你之前说过什么。
所以 Agent 需要记忆。
现在 CSDN 上关于 Agent 记忆系统的讨论也越来越多,包括 Markdown、SQLite、向量检索以及 GraphRAG 等不同方案。
可以简单理解成:
短期记忆
↓
当前对话

长期记忆
↓
用户信息
↓
历史任务
↓
重要经验
↓
知识
未来的 Agent 真正好不好用,很大程度上取决于:
它到底记得住什么,以及什么时候应该想起来。
八、第四部分:Agent 为什么还需要工作流?
Agent 并不是永远自己乱跑。
实际项目里,一般会有一些固定流程。
比如一个 AI 写文章 Agent:
收集热点
   ↓
筛选主题
   ↓
搜索资料
   ↓
生成大纲
   ↓
生成正文
   ↓
检查内容
   ↓
生成图片
   ↓
发布文章
有些步骤需要 AI 自己决定。
有些步骤则最好固定下来。
所以真正的 Agent 系统,往往不是纯粹的“自由发挥”,而是:
固定工作流 + AI 动态决策
这也是为什么 LangGraph、Dify、OpenClaw 等相关内容在开发者圈一直有很高关注度。近期 CSDN 上也出现了 OpenClaw、LangChain、Dify、AutoGPT、CrewAI 等多种 Agent 框架的横向比较文章。
九、OpenClaw 为什么突然火了?
说到 AI Agent,现在就绕不开 OpenClaw。
OpenClaw 特别有意思的一点是:
它不是单纯让你聊天,而是把 Agent 放到了真实的执行环境里。
例如:
聊天软件
   ↓
OpenClaw
   ↓
Agent
   ↓
模型
   ↓
Tools
   ↓
文件 / 网络 / 命令 / 服务
官方文档目前已经把 Skills、Tools、Gateway、Agent 等能力做成比较完整的体系。
其中 Skill 本质上就是:
告诉 Agent 某一类任务应该怎么做。
OpenClaw 当前文档里,Skill 以 SKILL.md 为核心,通过说明和配置让 Agent 学会如何使用相关工具。
这就非常有意思。
十、Skill 到底是什么?
假设你希望 AI 学会:
“写 Git 提交信息。”
以前可能需要硬编码。
现在可以给 Agent 一个 Skill。
例如:
skills/
└── git-commit/
    └── SKILL.md
里面写:
---
name: git-commit
description: 自动生成规范的 Git 提交信息
---

当用户要求生成 Git 提交信息时:

1. 分析修改内容
2. 判断修改类型
3. 生成简洁的提交信息
4. 输出最终结果
以后 Agent 遇到相关任务,就可以使用这个 Skill。
OpenClaw 官方当前文档也明确采用这种基于 SKILL.md 的技能机制。
这意味着:
Agent 的能力可以不断扩充。
十一、MCP 又是什么?
最近你可能还经常看到另一个词:
MCP
很多新手第一次看到都会懵。
其实简单理解:
MCP 就像 AI 世界里的“统一插座”。
假设你有:
GitHub
数据库
搜索服务
文件系统
天气服务
企业内部系统
如果每个工具都让 Agent 单独开发接口,会非常麻烦。
而 MCP 想解决的就是:
统一 AI 与外部工具之间的连接方式。
所以:
                Agent
                  │
                 MCP
                  │
      ┌───────────┼───────────┐
      ↓           ↓           ↓
   GitHub        数据库       搜索
最近几天 CSDN 上甚至已经出现了“Code Agent 从零接入 MCP 外部工具生态”这样的连续实战内容。
十二、AI Agent 真正的完整结构是什么?
把刚才所有内容拼起来:
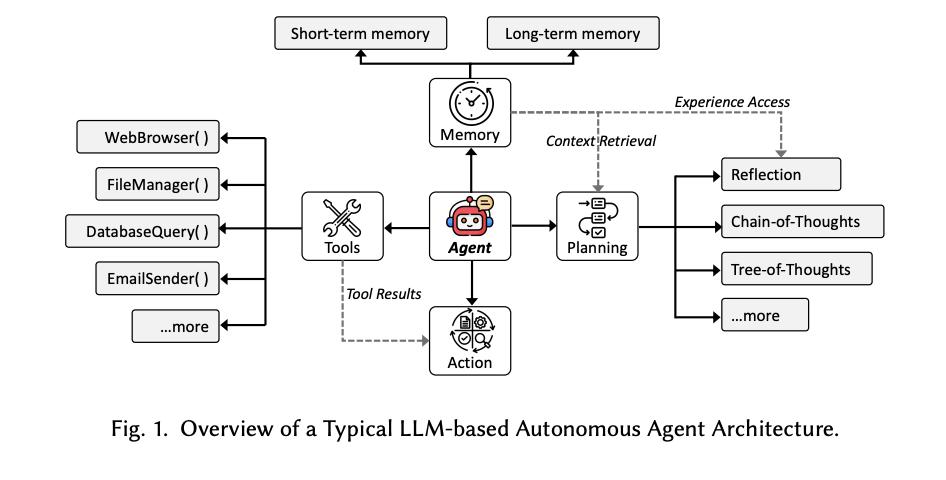
可以得到:
                      用户
                       ↓
                 ┌──────────┐
                 │   Agent   │
                 └─────┬────┘
                       ↓
                ┌─────────────┐
                │    大模型    │
                └──────┬──────┘
                       ↓
          ┌────────────┼────────────┐
          ↓            ↓            ↓
        记忆          Tools        Skills
          ↓            ↓            ↓
       上下文       外部系统      专业能力
          │            │            │
          └────────────┼────────────┘
                       ↓
                    工作流
                       ↓
                    执行任务
                       ↓
                    返回结果
这才是一个比较完整的 Agent。
十三、为什么 2026 年 AI Agent 会越来越重要?
我个人更看重的是一个变化:
以前:
AI 是一个工具。
现在:
AI 开始变成一个“执行者”。
未来一个软件系统可能不是:
用户
 ↓
点击按钮
 ↓
填写表单
 ↓
点击提交
 ↓
查看结果
而可能变成:
用户:
帮我把本月数据整理成报告

        ↓

AI Agent

        ↓

查询数据库
        ↓
分析数据
        ↓
生成图表
        ↓
生成报告
        ↓
检查错误
        ↓
发送给我
这就是:
从“软件等待人操作”变成“人给软件一个目标”。
这可能才是 Agent 真正有价值的地方。
十四、但千万别觉得 Agent 已经无所不能
现在的 Agent 依然存在不少问题。
例如:
1. 容易跑偏
目标描述不清楚时,Agent 可能执行错误方向。
2. 工具调用可能出错
工具本身有 Bug,Agent 再聪明也没办法。
3. 成本
复杂任务可能需要多次模型调用。
4. 安全
如果 Agent 拥有:
文件权限
+
命令执行
+
网络权限
+
数据库权限
风险会明显增加。
OpenClaw 当前文档也在工具权限、allowlist、sandbox、技能 gating 等方面提供越来越细的控制能力,这说明 Agent 的“能干活”与“不能乱干活”必须同时考虑。
十五、作为 Python 开发者,应该怎么学 AI Agent?
我不建议一上来就学几十个框架。
按照这个顺序会更容易:
Python基础
   ↓
大模型API
   ↓
Prompt
   ↓
Tool Calling
   ↓
RAG
   ↓
Agent
   ↓
Memory
   ↓
MCP
   ↓
工作流
   ↓
多Agent
   ↓
Agent工程化
其中有一个非常重要的点:
不要只学框架。
例如学 LangChain、LangGraph、OpenClaw、Dify 的时候,一定要搞清楚:
它们到底在帮我解决什么问题?
否则最后很容易变成:
会调用框架
不会设计 Agent
这才是最尴尬的。
十六、最后总结一句
最近 CSDN AI 内容有一个很明显的变化:
过去文章更多是在讲:
“什么是大模型?”
现在越来越多文章开始讲:
“怎么让大模型真正干活?”
从近期 CSDN 的热点内容来看,AI Agent、OpenClaw、MCP、Skills、Agent 记忆、AI 编程、工程化落地正在形成一条非常明显的技术主线。
所以理解 AI Agent,记住下面这句话基本就够了:
大模型让 AI 会思考,工具让 AI 会行动,记忆让 AI 能连续工作,工作流让 AI 能完成复杂任务。
而未来真正有竞争力的 AI 应用,大概率不会只是:
“一个会聊天的 AI。”
而是:
“一个能够理解目标、自己规划、调用工具并最终把事情做完的 AI。”
更多推荐


 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)