
AI电话手机-端到端手机AI电话语音外呼-实现原理浅析
端到端手机AI电话语音外呼-实现原理浅析
--AI电话手机
前面篇章中,我们通过一个很巧妙的方式不受Android手机机型的限制、免Root的实现了对手机通话事件和电话声音数据的拦截,并对声音进行后期的加工和处理。
时间来到了2026年底,现在市面上的AI算力已经获得了极大的提升。对于很多的手机电话用户而言,让手机电话装上“AI的大脑”已经不再是飘忽的想象,而变成一个正常合理的需求。
识别电话里对方在说什么,然后根据预设的话术和知识库进行有限的回答、不胡乱承诺、能接得住电话对方的语气情绪和开放性问题,这些都是AI电话应用中比单纯“开场白”要更加高级一些的常规需求。
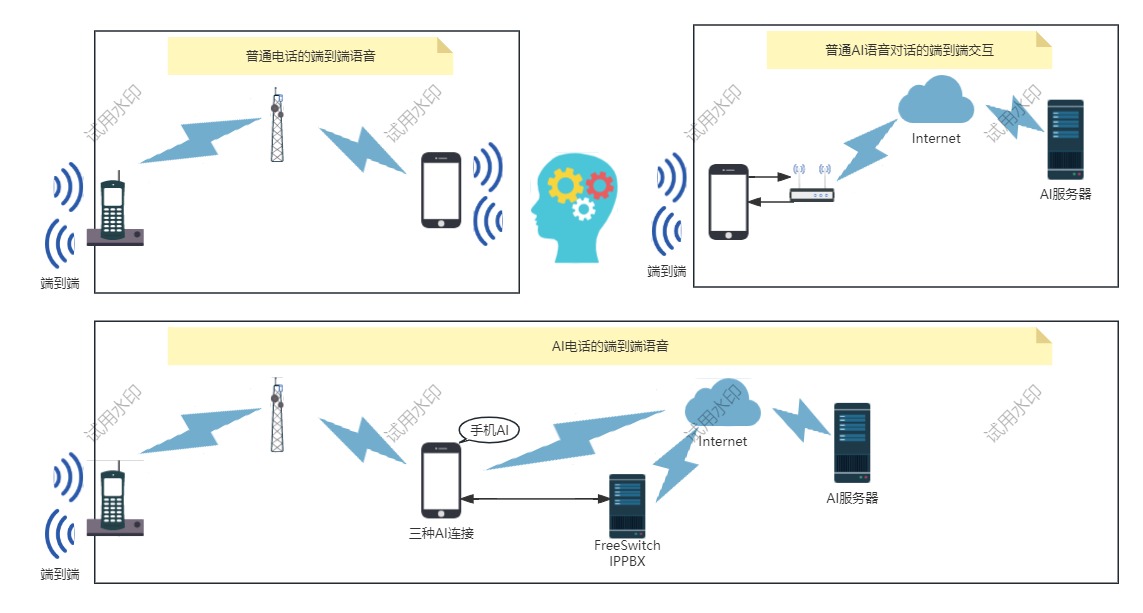
这样,对于手机电话而言,它“端到端”的概念就比一般的AI语音应用要更加严格:手机电话应用要求对方手机中输出的声音与采集到的说话声音,沟通效果要与真人沟通或普通的电话沟通的效果要基本一致。这就对AI响应和网络传输方面有了更高的要求,如下图所示:
- 二、手机通话端到端的实现方案
从上面的图示中很容易看出:我们最终的目的是要在手机的这一侧,实现一个电话对话的AI应答逻辑,用来代替人工进行语音应答。
按照当前市面上的AI机器人的内部架构,普通的AI机器人大致可以分为如下两类:
1)ASR+LLM+TTS:即包括语音识别、语义分析、语音合成等功能的自由组合的大模型。
2)端到端实时语音大模型:传入语音,它内部自己识别内容、语气、情绪,并输出应答语音的大模型。
因此,AI的响应逻辑就可以简单的按如下方式来进行分层实现:
1)把大模型全部塞进手机里,完全不依赖网络,只使用手机CPU和内存。将AI大模型通过手机不同的APP之间协同工作,实现手机本地的AI应答。
2)websocket直接调用讯飞/豆包/阿里/腾讯等云服务的AI端到端接口或流式语音交互接口,将语音数据通过tcp直接传输到AI云平台,并将它tcp返回的交互应答语音数据注入手机。
3)从SIP服务器统一调用AI平台的接口,手机先把电话声音通过SIP+RTP协议,传输到本地IPPBX,再经过呼叫中心(CallCenter)或CRM等平台统一对调用AI平台的电话语音数据进行AI响应。
按不同的集成办法,各有不同的优缺点。
方案一直接在手机上跑大模型,可能会面临手机性能不够,响应速度不足,大模型需要裁剪等问题。优点是完全不依赖网络,通话的音质数据完全不受手机网络波动的影响。
方案二直接用市面上最新版本的商用大模型,GPU加速,端到端时延极低,且更新迭代快。全程websocket采用tcp的方式传输,流式语音能得到保证。缺点是商用大模型按百万token等来付费,多路手机对AI平台有并发数的要求,且呼叫、话单、录音等均需要自己进行管理。
方案三是当前市面上的常用做法,如果用户本身就有在使用昆石VOS、OKCC、阿里云呼叫中心或者自己的CRM系统,有自己的SIP线路和现有呼叫方式。那么它就可以把手机当作新的电话线路来使用,直接将手机电话连接到现有的SIP系统,这样话单、录音、AI平台等方式均使用服务器平台对接的方式来做。
缺点是电话呼叫要经过【PSTN基站】-【手机设备】-【手机APP】-【RTP数据到SIP平台】-【websocket到AI平台】多个网络环节,走虚拟电话链路、udp数据、tcp数据等多层装包/拆包的处理,可能会对通话的稳定性造成影响。
- 三、手机本身能直接跑电话大模型吗
通常,我们有这种疑问的时候,想的绝对不是手机能不能跑在线的大模型,也不是动不动就消耗GPU消耗token的调用方式。而是特指能直接运行于手机CPU/NPU上的纯离线语音大模型。
但是怎么说呢,大模型和大模型之间也还是有区别的。我们前面说到【普通AI机器人】通常包含ASR(语音转文本)+LLM(大语言模型-语义理解)+TTS(文字转声音)这几个部分组成,部分平台在TTS的基础上扩充了语音合成、声纹克隆等辅助功能,使TTS输出的结果更加拟人贴近实际生产生活。
一般的理解中,TTS(文字转声音)消耗的CPU资源最少,普通手机的纯CPU完全能正常快速的输出。ASR(语音转文本)由于涉及【转文本】、【文本内容修正】和【给句子填标点符号】等辅助功能,以及对多国际语种与地区方言的支持等原因,导致需加载的模型库和CPU算力要求较高,通常这部分要对大模型进行量化和裁切,才能正常移植到手机上做纯本地的离线识别,最常见的如FunASR-SenseVoice、Vosk等。
LLM(大语言模型-语义理解)部分最为棘手。我们在实践中发现,哪怕是量化后的Qwen模型都有接近3个G的大小。目前暂时没有找到轻量级的部署和运行方式,而且手机CPU也带不动,时延响应要好几秒。通常我们认为:只有带NPU的新款旗舰级,才有可能跑得动LLM大语言模型,市面上绝大多数旧的二手机是没有办法直接用CPU来本地跑LLM模型和运行库的。
这样的话,其实在上述列举的三个电话通话AI方案中,根据对网络的依赖不同,我们可以单独组合出:语音在本地ASR解析出文字,然后网络只传输这个流式ASR的文本内容。云端的LLM大模型解析文本后,生成应答的回复文字传回手机。手机本地使用TTS来生成语音数据内容,再注入手机通话。通过这样的办法来降低网络传输的数据量、规避实时语音流中上行/下行数据率不匹配等问题。
- 四、如何缩短端到端的交互时延
从上面的图示可看出,交互时延的产生,主要是由网络分组交换的节点和LLM大语言模型引入的。很明显,如果能直接在手机上关掉WIFI/5G,只使用手机本身的算力就快速实现AI语音应答数据的注入。那么这个时延是最小的。
但是很明显大家都没有这个能力,现阶段我们也没有这个能力。
因此业内人士,咱们这一批大聪明,就和稀泥似的引出一批的“唤醒词”、“本地ASR”、“云端ASR”等概念,然后按用户实际的沟通的内容,动态进行决策和调度,提高响应速度和实际解决问题的能力。这种举措在汽车驾驶和智能音箱领域最为常见。
很多时候我们都在想:电话通话领域是否一定需要“生成式AI”?开放性话题到底有没有必要?早期电话服务中按DTMF数字菜单进行功能选择,不也照样用了很多年。是否直接利用手机本身的算力,ASR识别后做智能IVR菜单的应答,以此来提高电话的响应速度?
现在市面上各种OpenAI、讯飞星火、豆包火山引擎、阿里千问百炼、DeepSeek等平台推出的所谓“端到端实时语音模型”关键是ASR的标准没有统一,结果没有规范化的衡量,而且还在不停往里面扩充语气/情绪等辅助判断措施。
但是不管怎么说,在语音对话领域,它们都将“端到端时延”和“智能打断”等快速响应的理念做为衡量体验效果的指标。这对我们电话通话方向的【端到端手机AI电话语音外呼】的课题,具有积极的促进作用。
后续可能这么多大厂会统一坐下来,商讨出一个标准的RFC草案,制定行业标准和国家标准。或许到那个时候,语音交互领域的技术演进,就会明朗很多,我们拭目以待吧。
- 五、小结
从实际的电话外呼和来电接听需求出发,通常像电话销售,它们会按电话号码的来源对潜在客户的电话名单列表进行如下批次的呼叫和筛选分类:(从伪基站导出的号码和免费发鸡蛋统计的号码,电话号码列表和精准度肯定不同)
1)空号/不可信号码较多:AI估计就播放个开场白,开场白都没播放完就挂断了。这种估计AI+人工组合就可以了,AI负责拨打、接通、播放开场白,如果用户有兴趣就手动切换成人工接听和对话。
2)号码来源可靠,潜在客户较多:这个是当前较为常见的场景,不同行业有不同的话术,但如果能成交一单,就能大幅收回成本。这种情况下外呼的用户会愿意付一笔费用拉取到较精准的客户(如投放广告过滤意向人群等),这部分号码拨打后主要做分类过滤、或引导添加微信等进行详细沟通。目前生成式实时语音模型,主要也是以这部分用户做为样本发力。
3)高净值人群较多,需电话回访并促进成交的数量较多:这部分是分类过滤后的号码,一般都要真人拨打或回访,最终促进成交。
对于外呼为主的应用场景,通常大部分客户对AI和线路价格不敏感,因为有变现途径和场景,客户主要关注的是提效、减少无效的人工和沟通。
对于来电呼入的客服类应用场景,AI机器人的引入更多的是考虑降本增效,要求AI应答要对客户的开放性问题做应答的收敛,不要胡乱做出承诺。
写在最后,有些时候觉得如果只是想用一些低级的问答类型的判断式语音交互,或许也不需要去讯飞阿里抖音等平台做一大堆的【注册/生成Key/充钱/按token计费】这种繁杂的步骤,去获取“生成式AI”的能力。
毕竟连“拨打电话并播放开场白后转人工”这样基础的能力,都能够满足相当一部分外呼用户的需求,那么利用手机本身的算力,实现简单的智能IVR语音菜单式的应答,应该已经能满足市面上相当大一部分外呼的需求了。最主要的是这么搞,它是完全免费的!而且不需要手机联网,通话语音数据不出手机,在合法合规性上以及通话的安全性能够得到保障。
后面我们将分几个篇章,分别深入的分析一下【手机本机做电话语音的ASR+智能IVR应答】和【手机直接websocket将电话通话语音接入豆包火山引擎/阿里千问百炼等实时语音平台】的“端到端”电话AI应答的优势和劣势。
感兴趣的读者,可以关注我们,跟随我们一同去手工DIY深入探索手机电话的AI能力。
更多推荐

 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)