
计算机毕业设计hadoop+spark+hive智慧交通 交通客流量预测系统 大数据毕业设计(源码+论文+PPT+讲解视频)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
以下是一份关于《Hadoop+Spark+Hive智慧交通大数据分析平台》的任务书模板,供参考:
任务书:基于Hadoop+Spark+Hive的智慧交通大数据分析平台开发
一、项目背景
随着城市化进程加快,交通拥堵、事故频发、资源分配不均等问题日益突出。智慧交通系统通过采集、存储和分析海量交通数据,可实现实时监控、预测预警和智能调度。本任务书旨在构建基于Hadoop(分布式存储)+ Spark(实时计算)+ Hive(数据仓库)的智慧交通大数据分析平台,实现对交通流量、事故、信号灯等数据的深度挖掘与可视化应用。
二、项目目标
- 数据采集与存储
- 整合多源异构交通数据(如摄像头、传感器、GPS、社交媒体等)。
- 利用Hadoop HDFS实现海量交通数据的高效存储与容错管理。
- 实时数据处理与分析
- 基于Spark Streaming实现交通流量的实时监测与异常检测。
- 通过Spark MLlib构建交通预测模型(如拥堵预测、事故风险评估)。
- 数据仓库与查询优化
- 使用Hive构建交通数据仓库,支持复杂SQL查询与历史数据分析。
- 优化Hive表设计与分区策略,提升查询效率。
- 可视化与决策支持
- 开发可视化仪表盘,展示交通热点、拥堵趋势、信号灯优化建议等。
- 为交通管理部门提供数据驱动的决策支持(如动态调整信号灯配时)。
三、技术架构
| 模块 | 技术选型 | 功能说明 |
|-||-|
| 数据采集层 | Flume/Kafka | 实时采集传感器、摄像头、GPS等数据 |
| 存储层 | Hadoop HDFS + HBase | 结构化与非结构化数据存储 |
| 计算层 | Spark Core + Spark Streaming | 批处理与实时计算 |
| 分析层 | Spark MLlib + Hive | 机器学习建模与交互式查询 |
| 应用层 | Tableau/ECharts + Web服务 | 可视化展示与API接口 |
四、任务分解与进度安排
阶段1:需求分析与环境搭建(2周)
- 调研交通管理部门需求,明确数据源与业务场景。
- 搭建Hadoop集群(3节点)、Spark环境及Hive数据仓库。
- 配置Kafka/Flume数据采集通道。
阶段2:数据采集与存储开发(3周)
- 开发数据采集模块,接入摄像头、地磁传感器等数据源。
- 设计HDFS存储结构,实现数据分片与备份策略。
- 构建HBase表存储实时交通状态数据。
阶段3:数据处理与分析开发(4周)
- 批处理任务:
- 使用Spark清洗历史交通数据(去重、缺失值处理)。
- 通过Hive构建数据仓库,按时间、区域分区。
- 实时处理任务:
- 基于Spark Streaming计算实时交通流量。
- 实现拥堵阈值告警与异常事件检测。
- 机器学习建模:
- 利用Spark MLlib训练拥堵预测模型(LSTM/XGBoost)。
- 评估模型精度并部署为在线服务。
阶段4:可视化与系统集成(2周)
- 开发Web端可视化平台,集成ECharts展示交通热力图。
- 对接交通信号灯控制系统API,实现动态配时建议。
- 编写用户手册与系统部署文档。
阶段5:测试与优化(1周)
- 压力测试:模拟高并发数据采集与查询场景。
- 性能优化:调整Spark分区数、Hive索引策略。
- 修复漏洞并完善文档。
五、交付成果
- 完整的大数据分析平台源代码(GitHub仓库)。
- 《智慧交通大数据平台技术文档》(含架构图、API说明)。
- 可运行的集群环境(Docker镜像或虚拟机配置脚本)。
- 测试报告与性能优化记录。
六、资源需求
- 硬件资源:
- 服务器集群(至少3台,每台8核16G内存,500GB存储)。
- 软件资源:
- Hadoop 3.x、Spark 3.x、Hive 3.x、Kafka 2.x、MySQL(元数据存储)。
- 人员配置:
- 大数据开发工程师(2名)、交通领域专家(1名)、测试工程师(1名)。
七、风险评估与应对
| 风险类型 | 应对措施 |
|--||
| 数据质量差 | 加强数据清洗流程,增加人工校验环节 |
| 集群性能瓶颈 | 优化Spark资源分配,采用YARN动态调度 |
| 模型预测不准确 | 引入更多特征(如天气、节假日),迭代优化 |
八、验收标准
- 平台可稳定处理≥10万条/秒的交通数据。
- 拥堵预测模型准确率≥85%(MAPE指标)。
- 复杂查询响应时间≤5秒(Hive on Spark模式)。
项目负责人:
日期:
此任务书可根据实际需求调整技术细节与时间安排,重点突出Hadoop生态工具的协同工作与交通业务场景的结合。
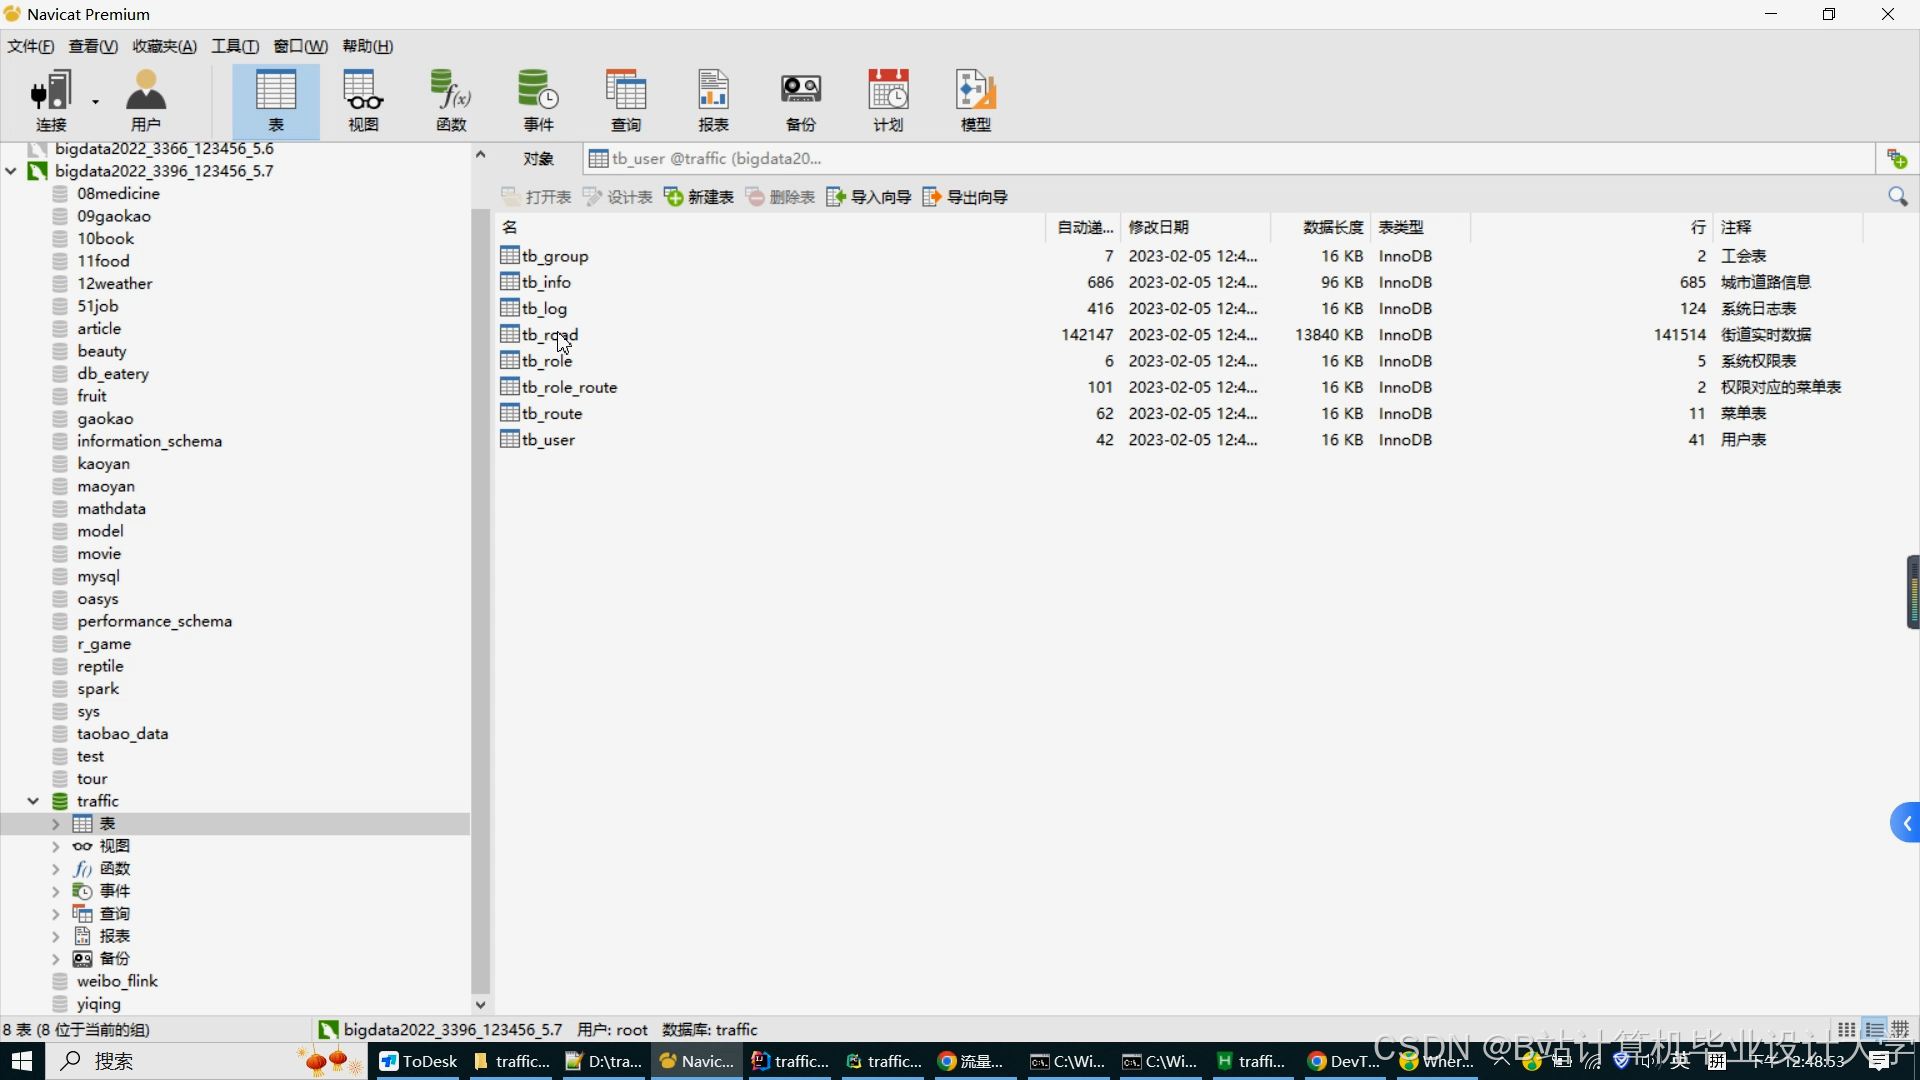
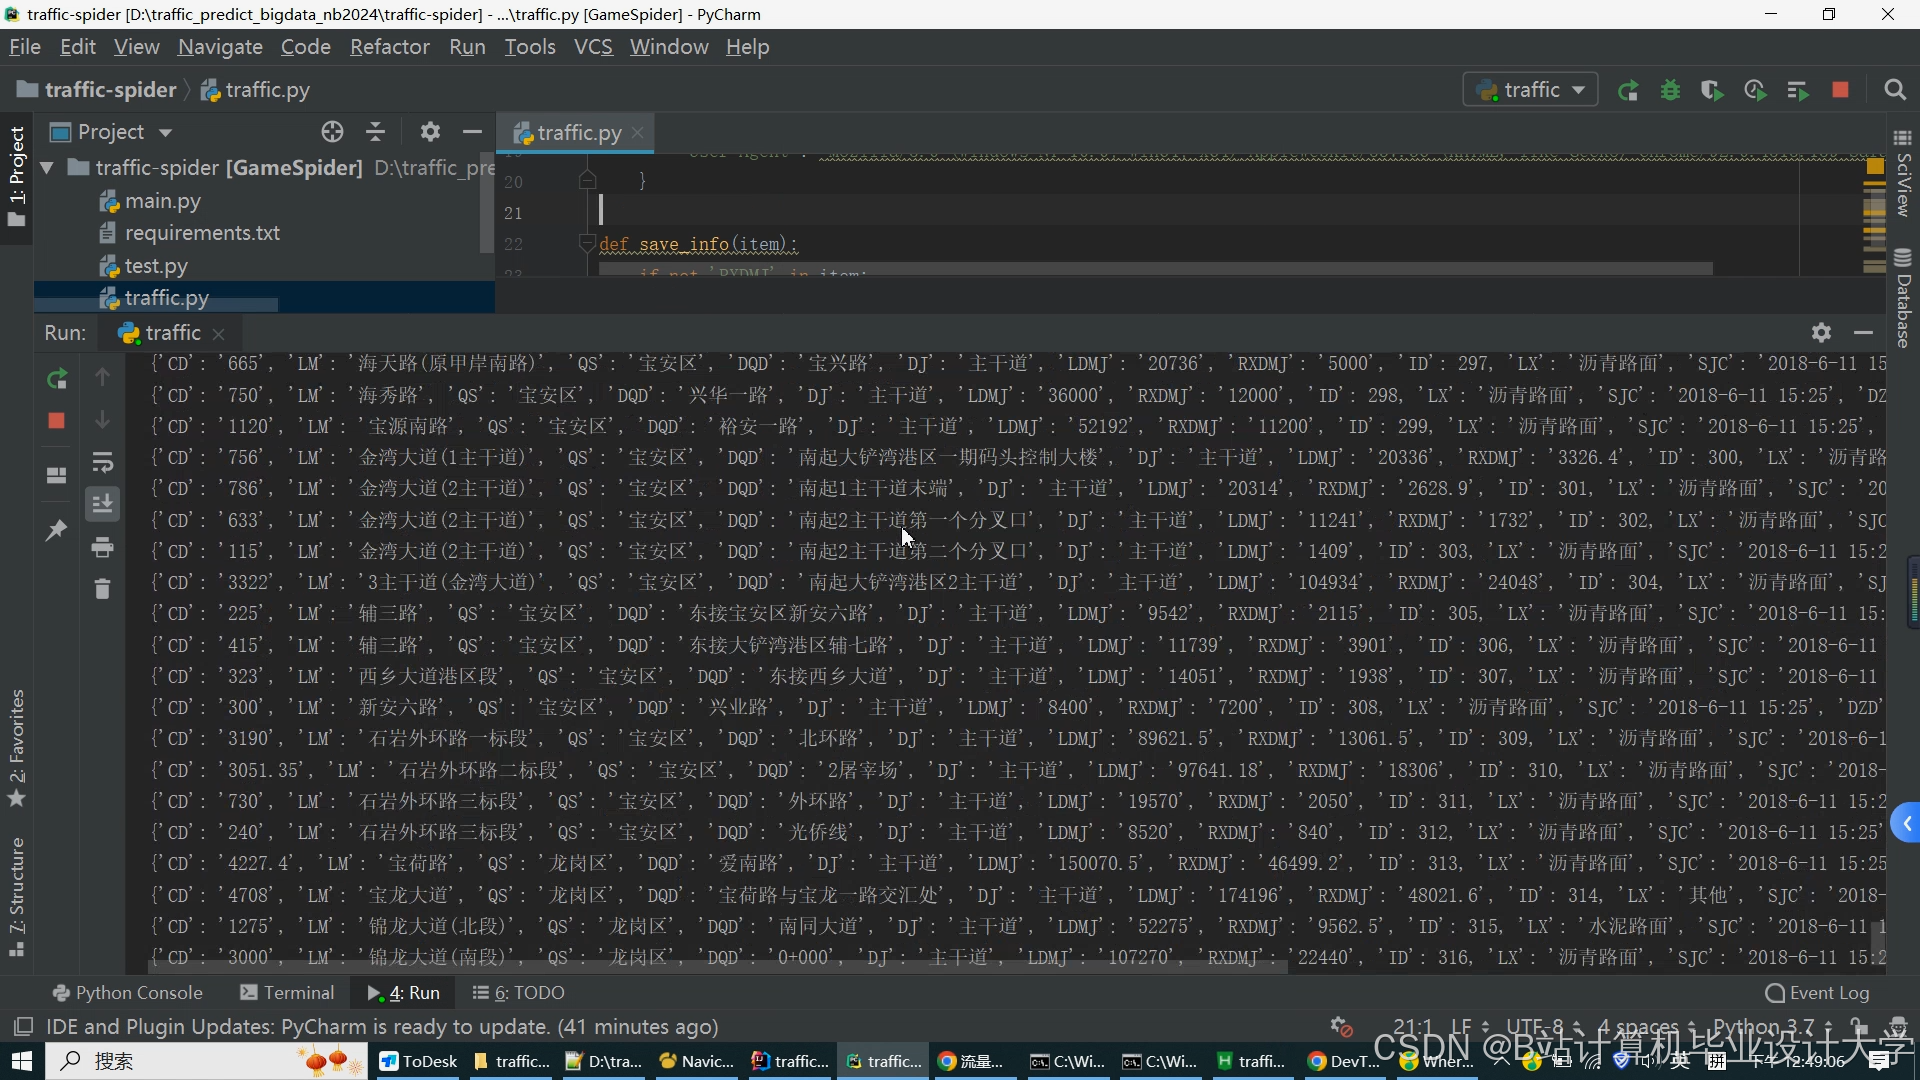
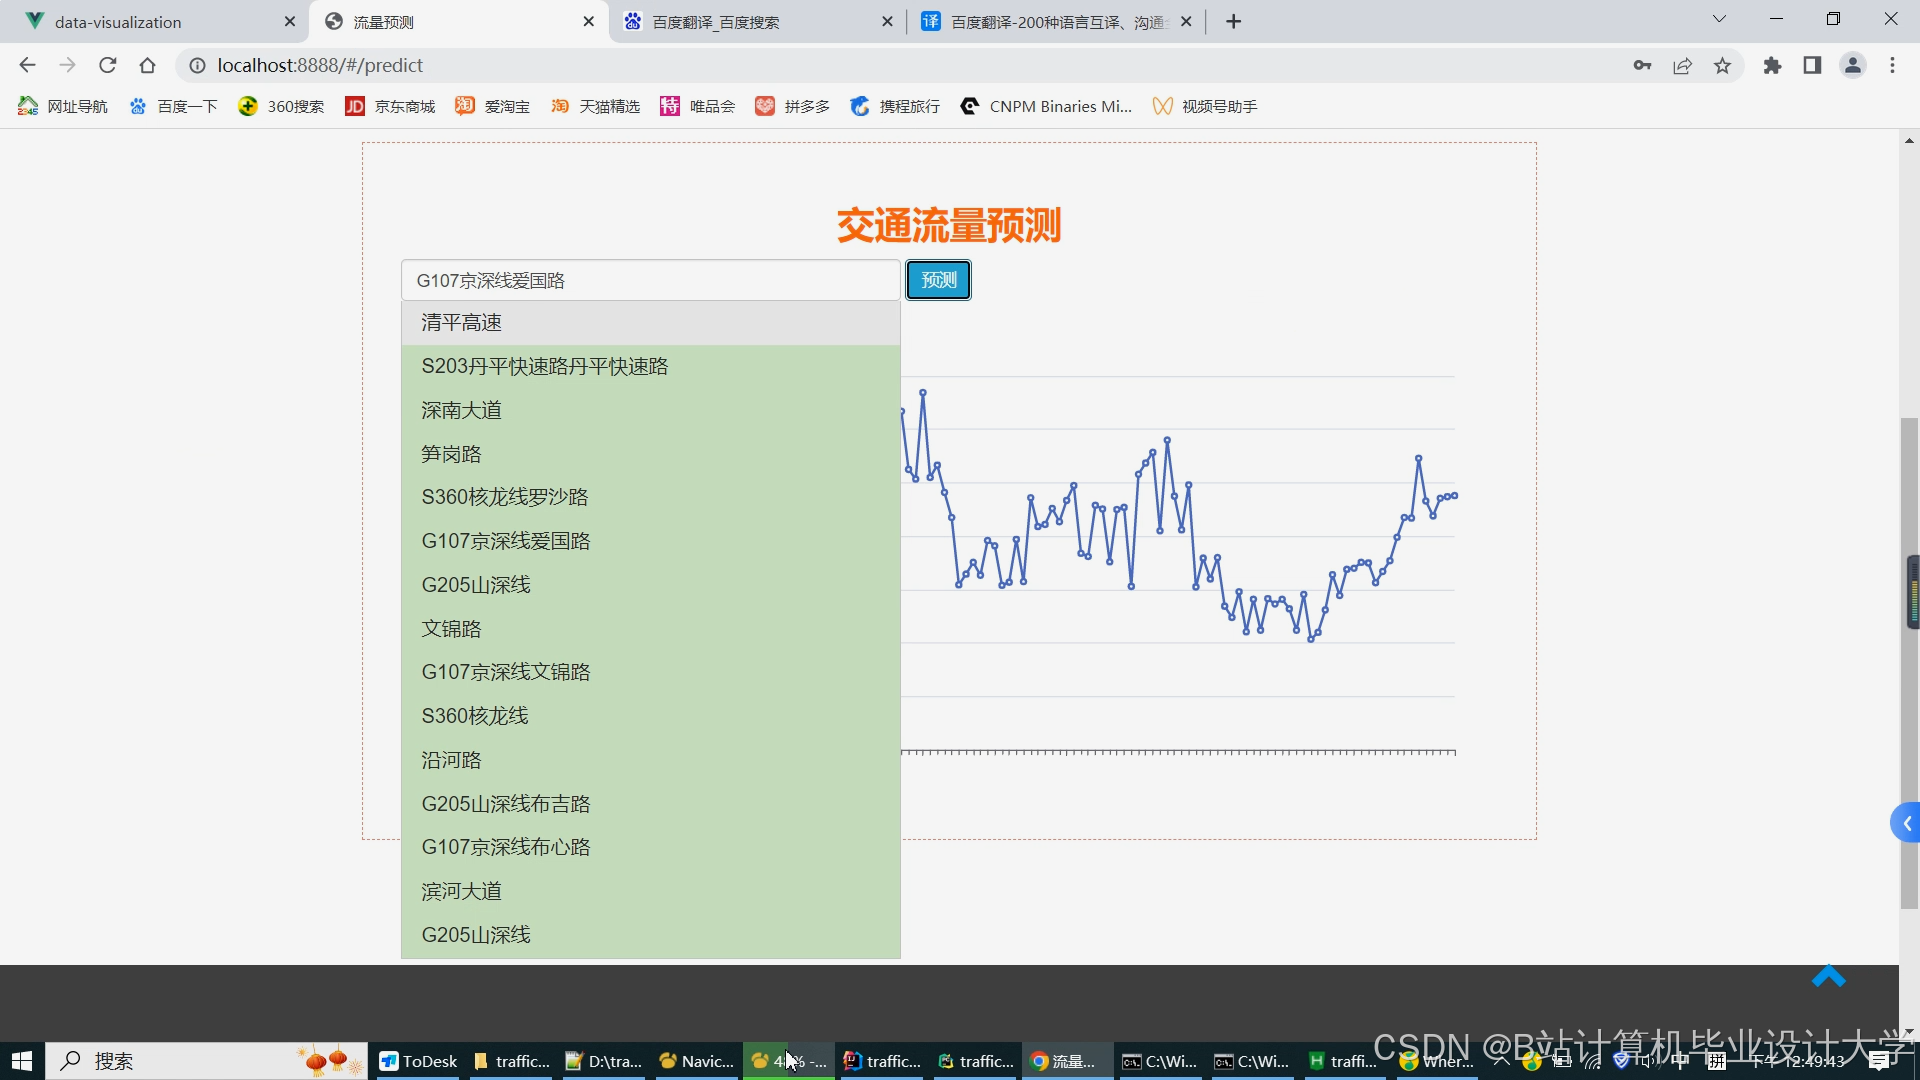
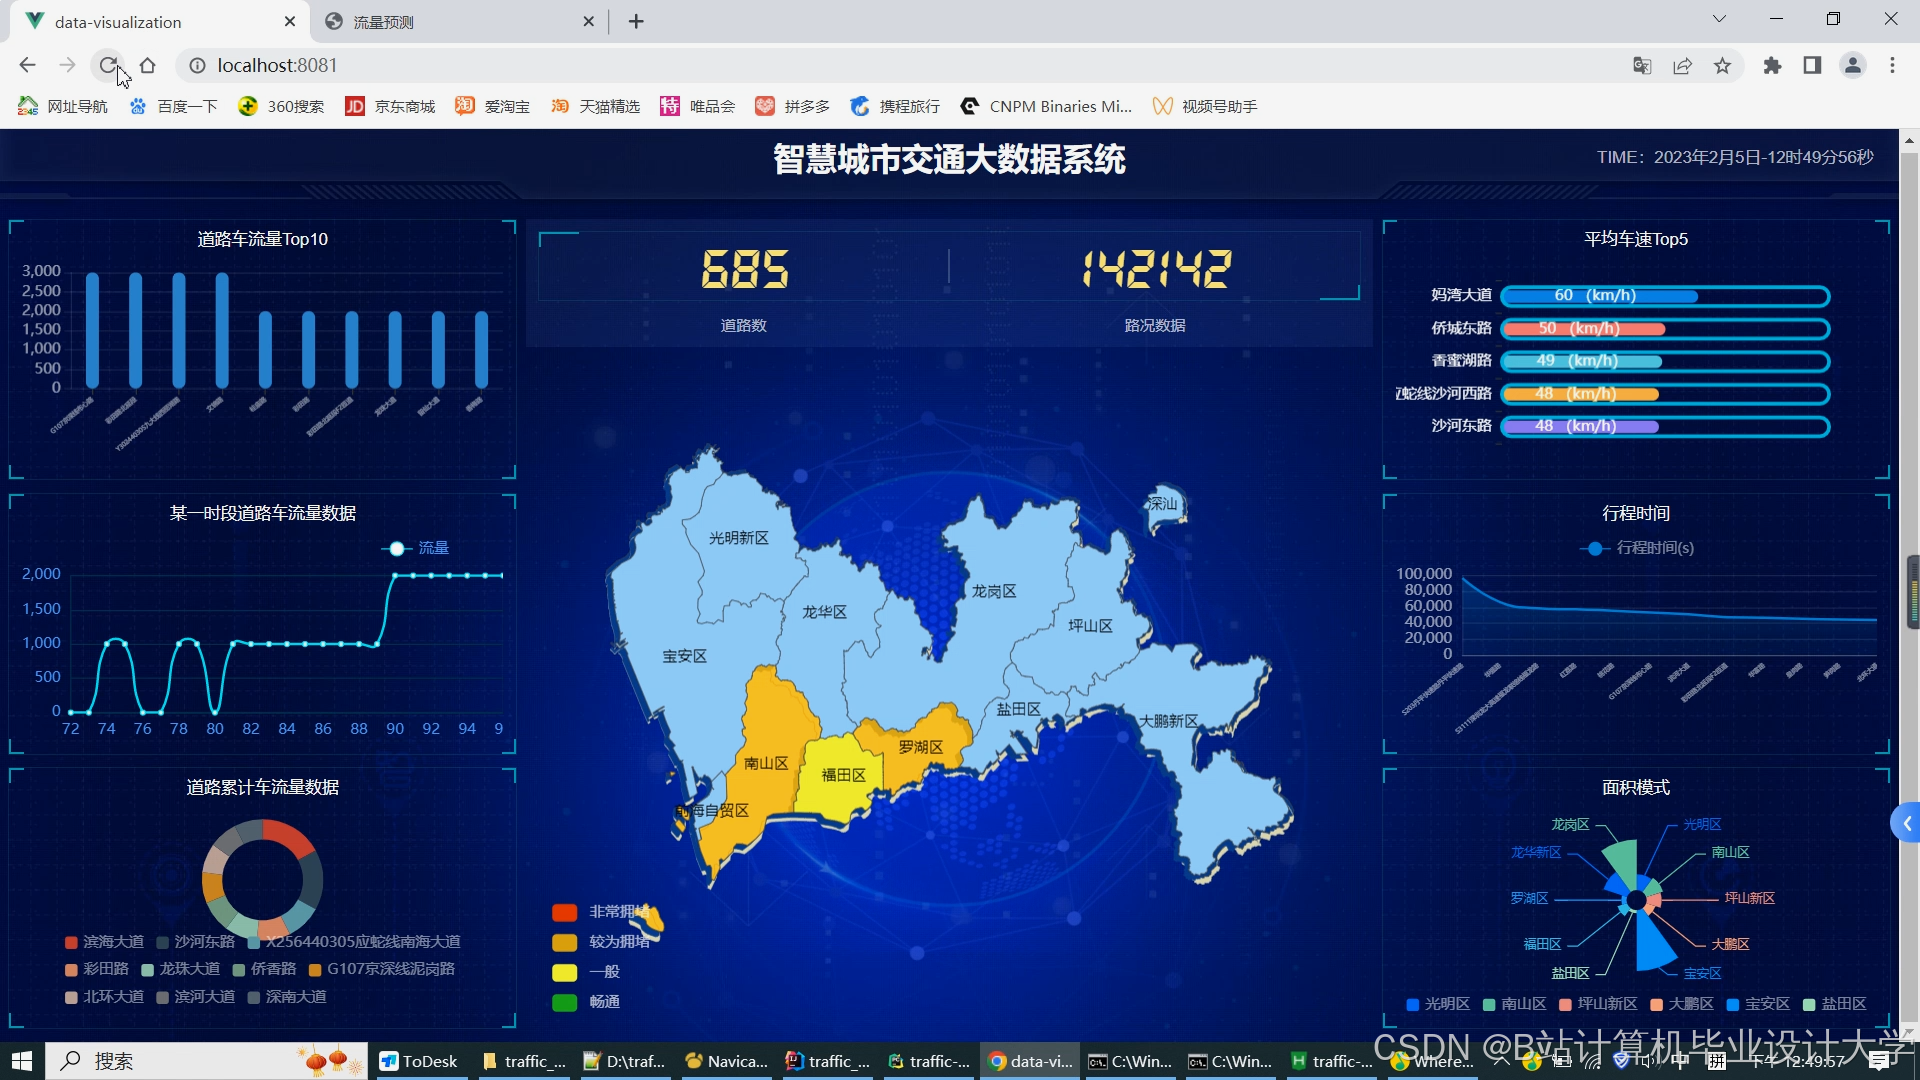
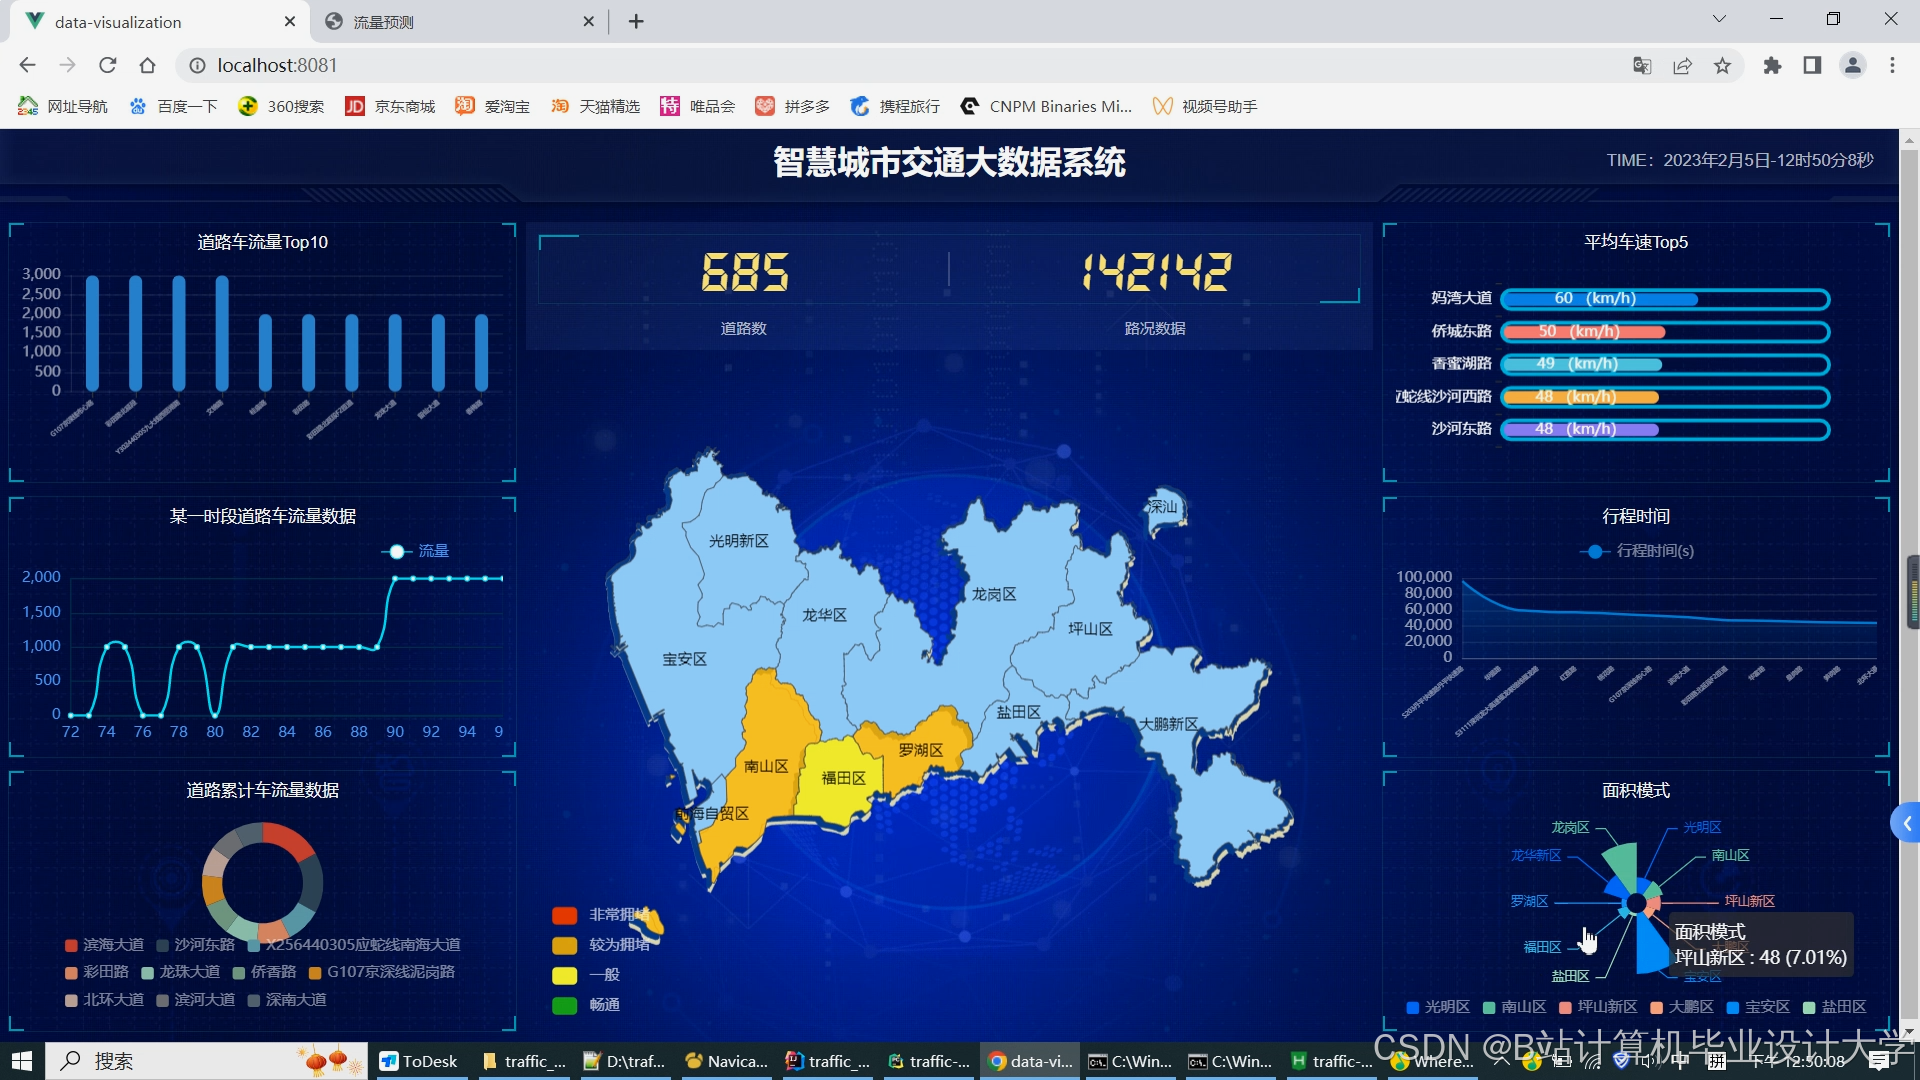
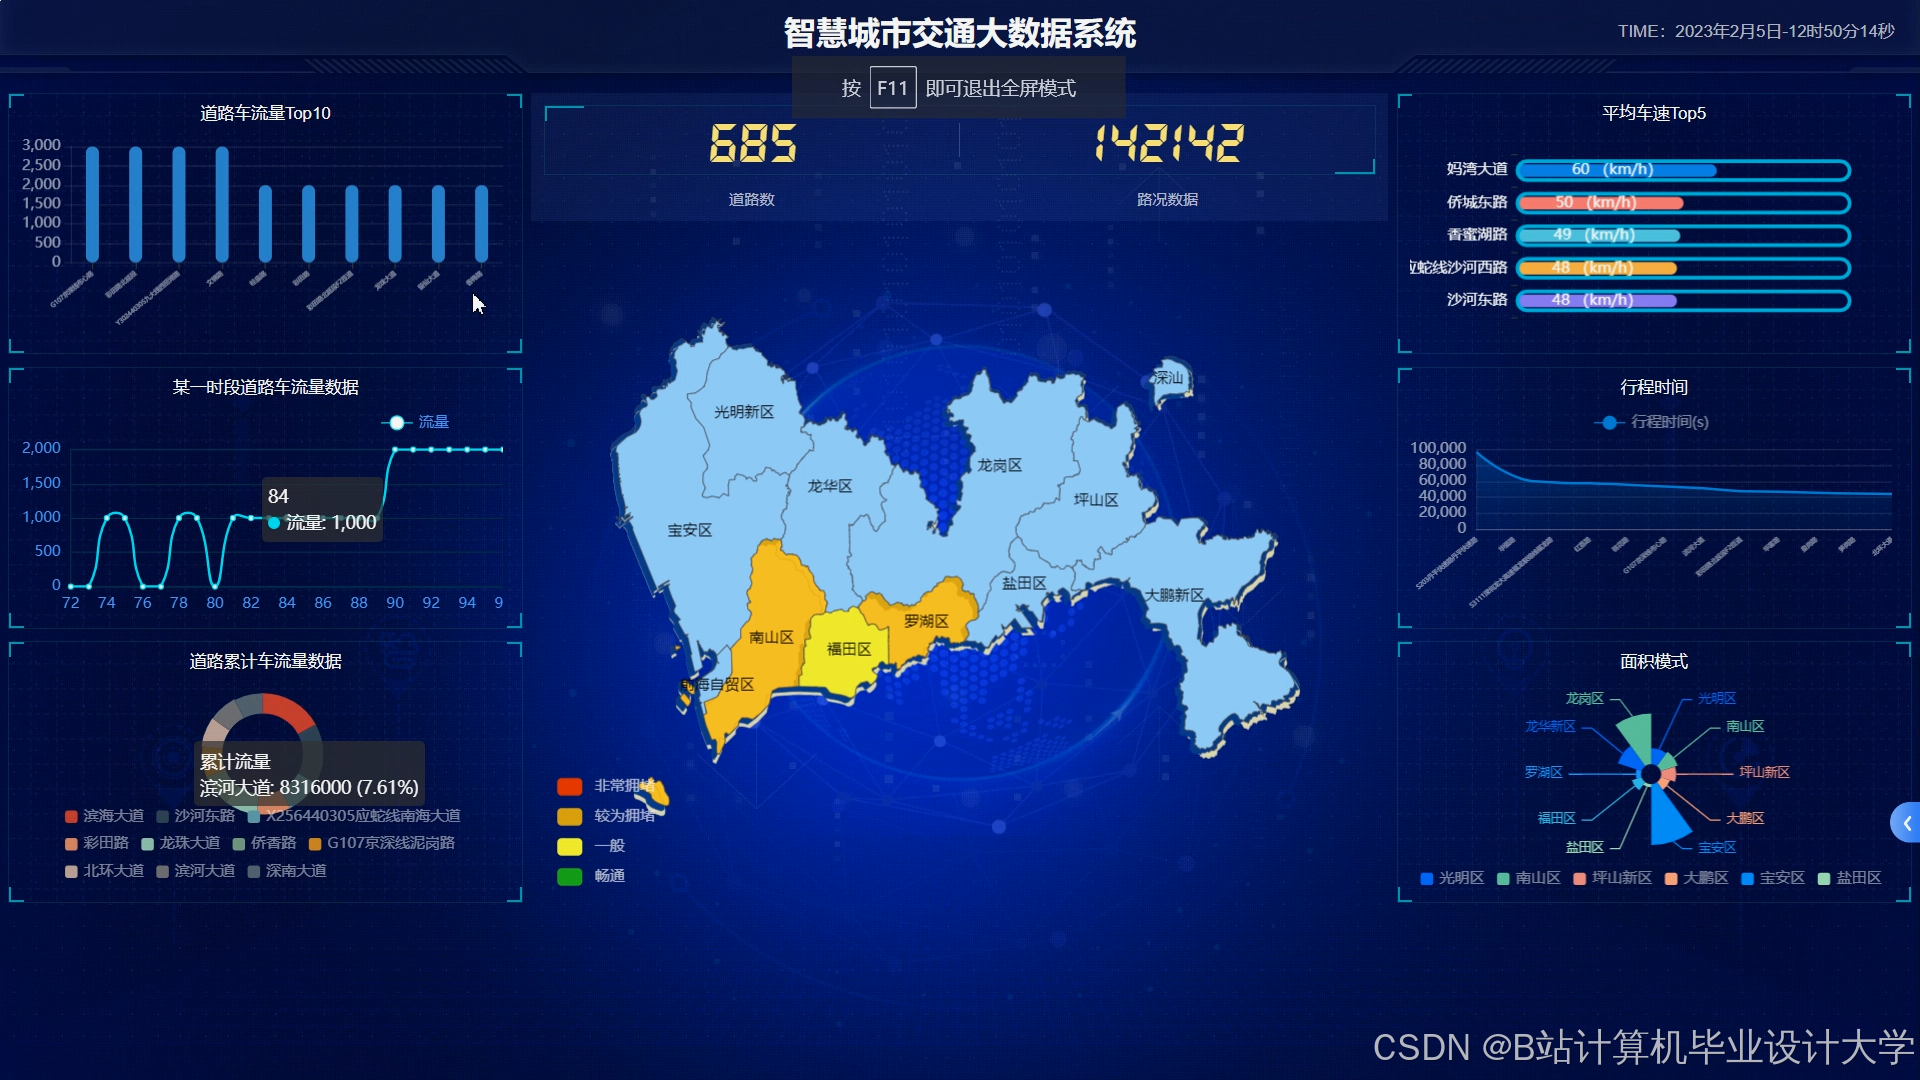
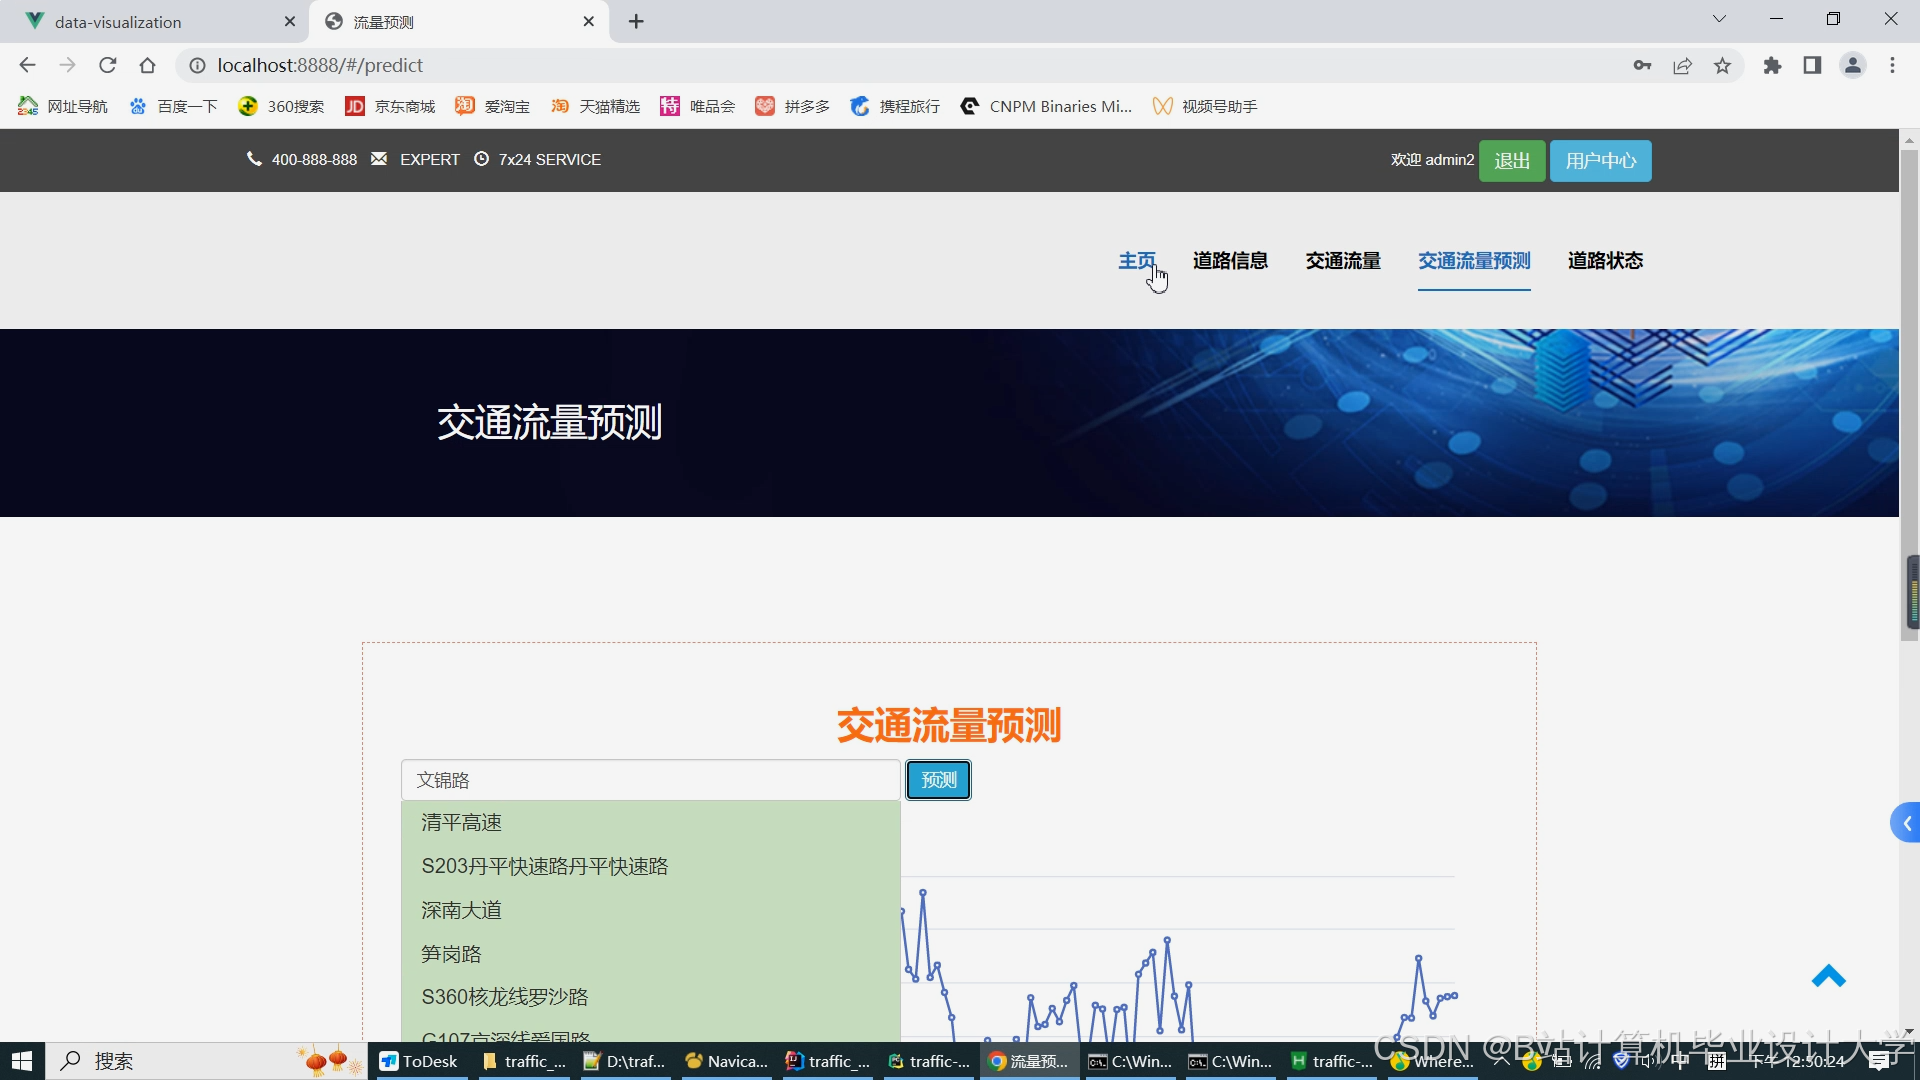
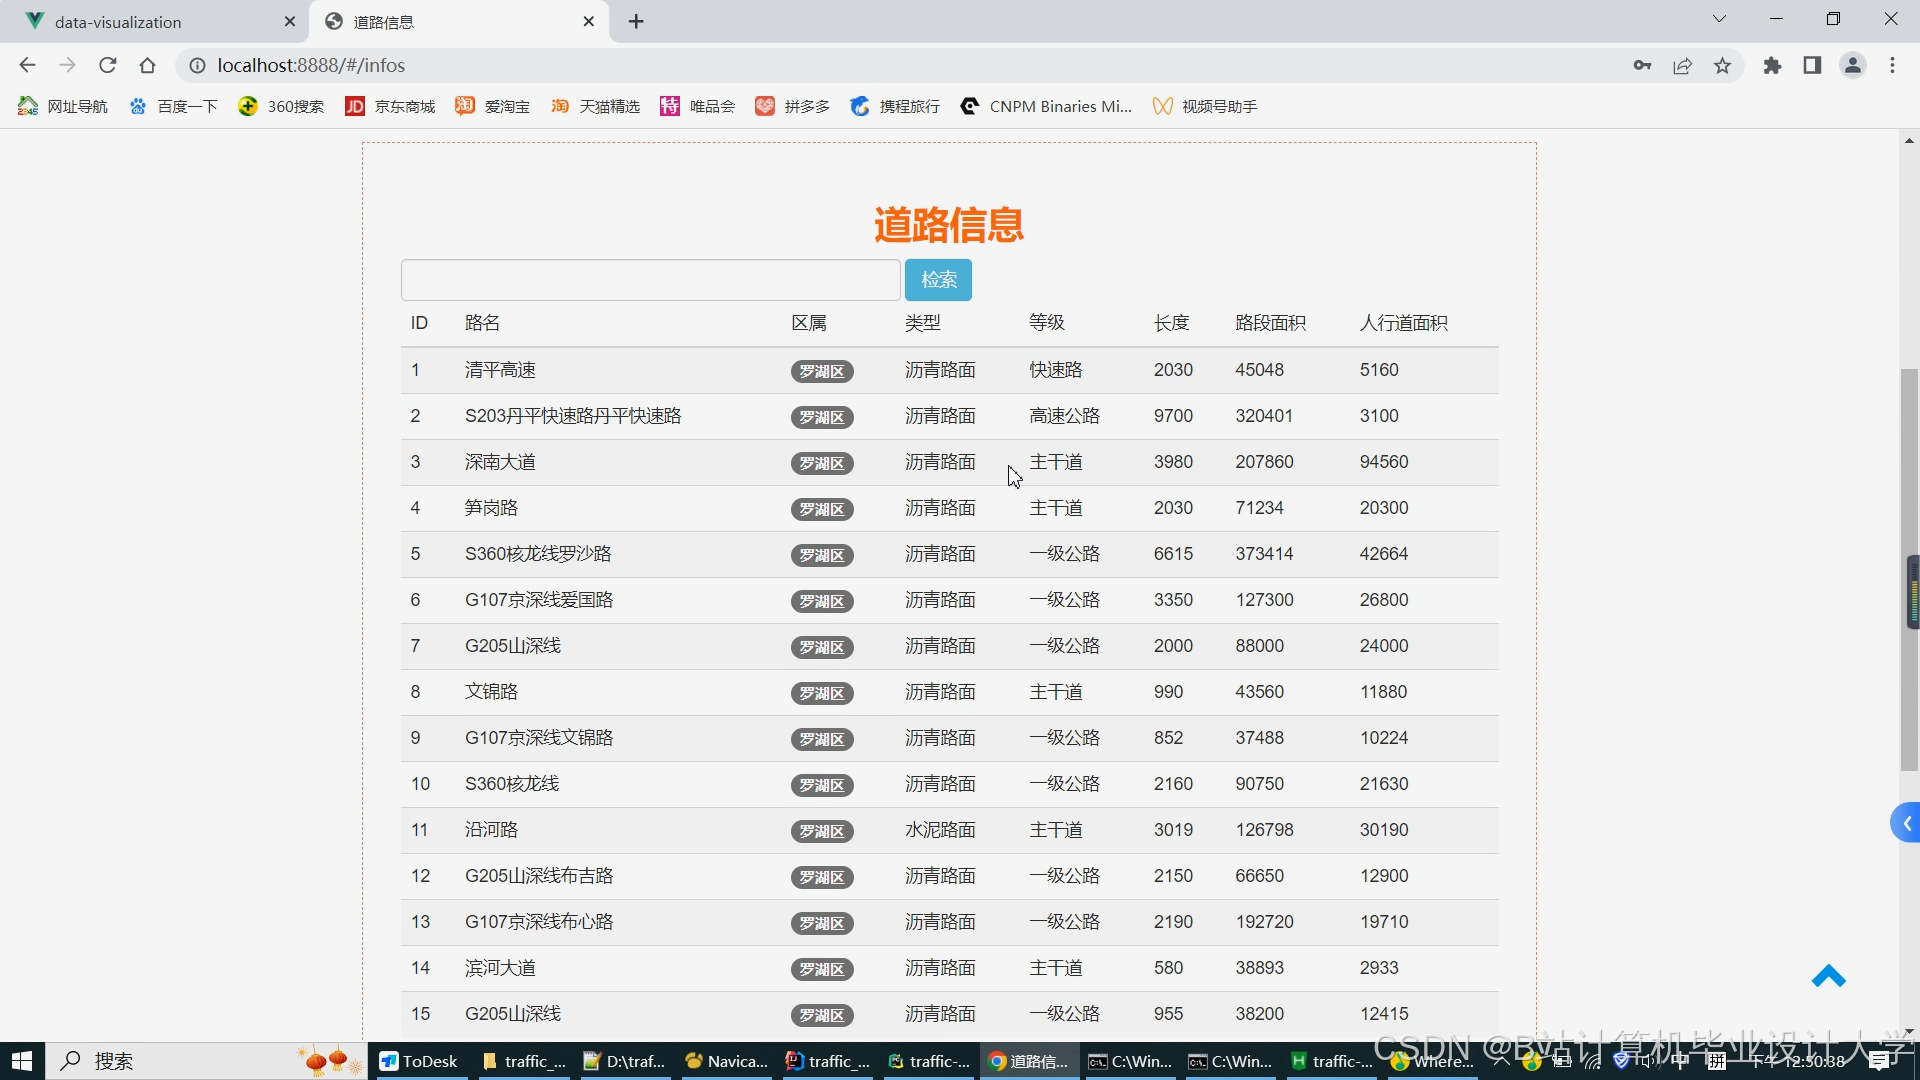
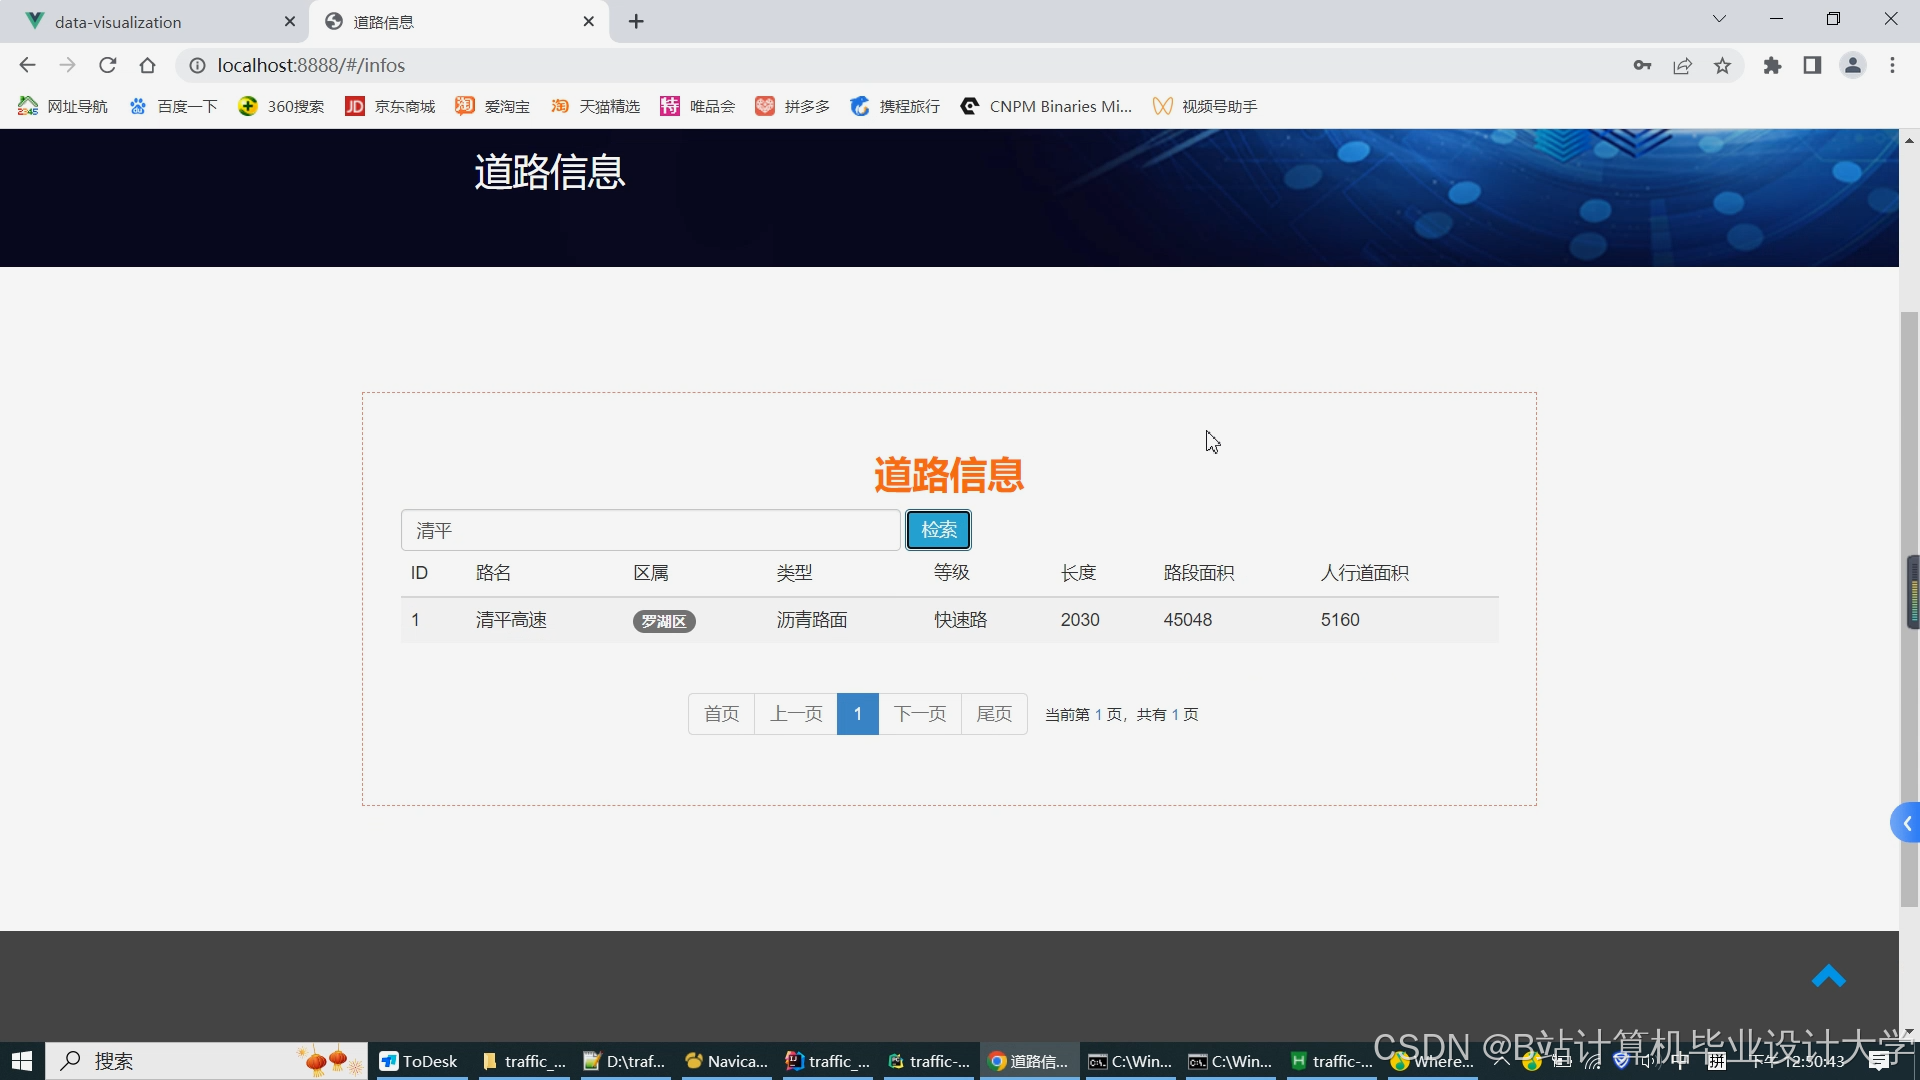
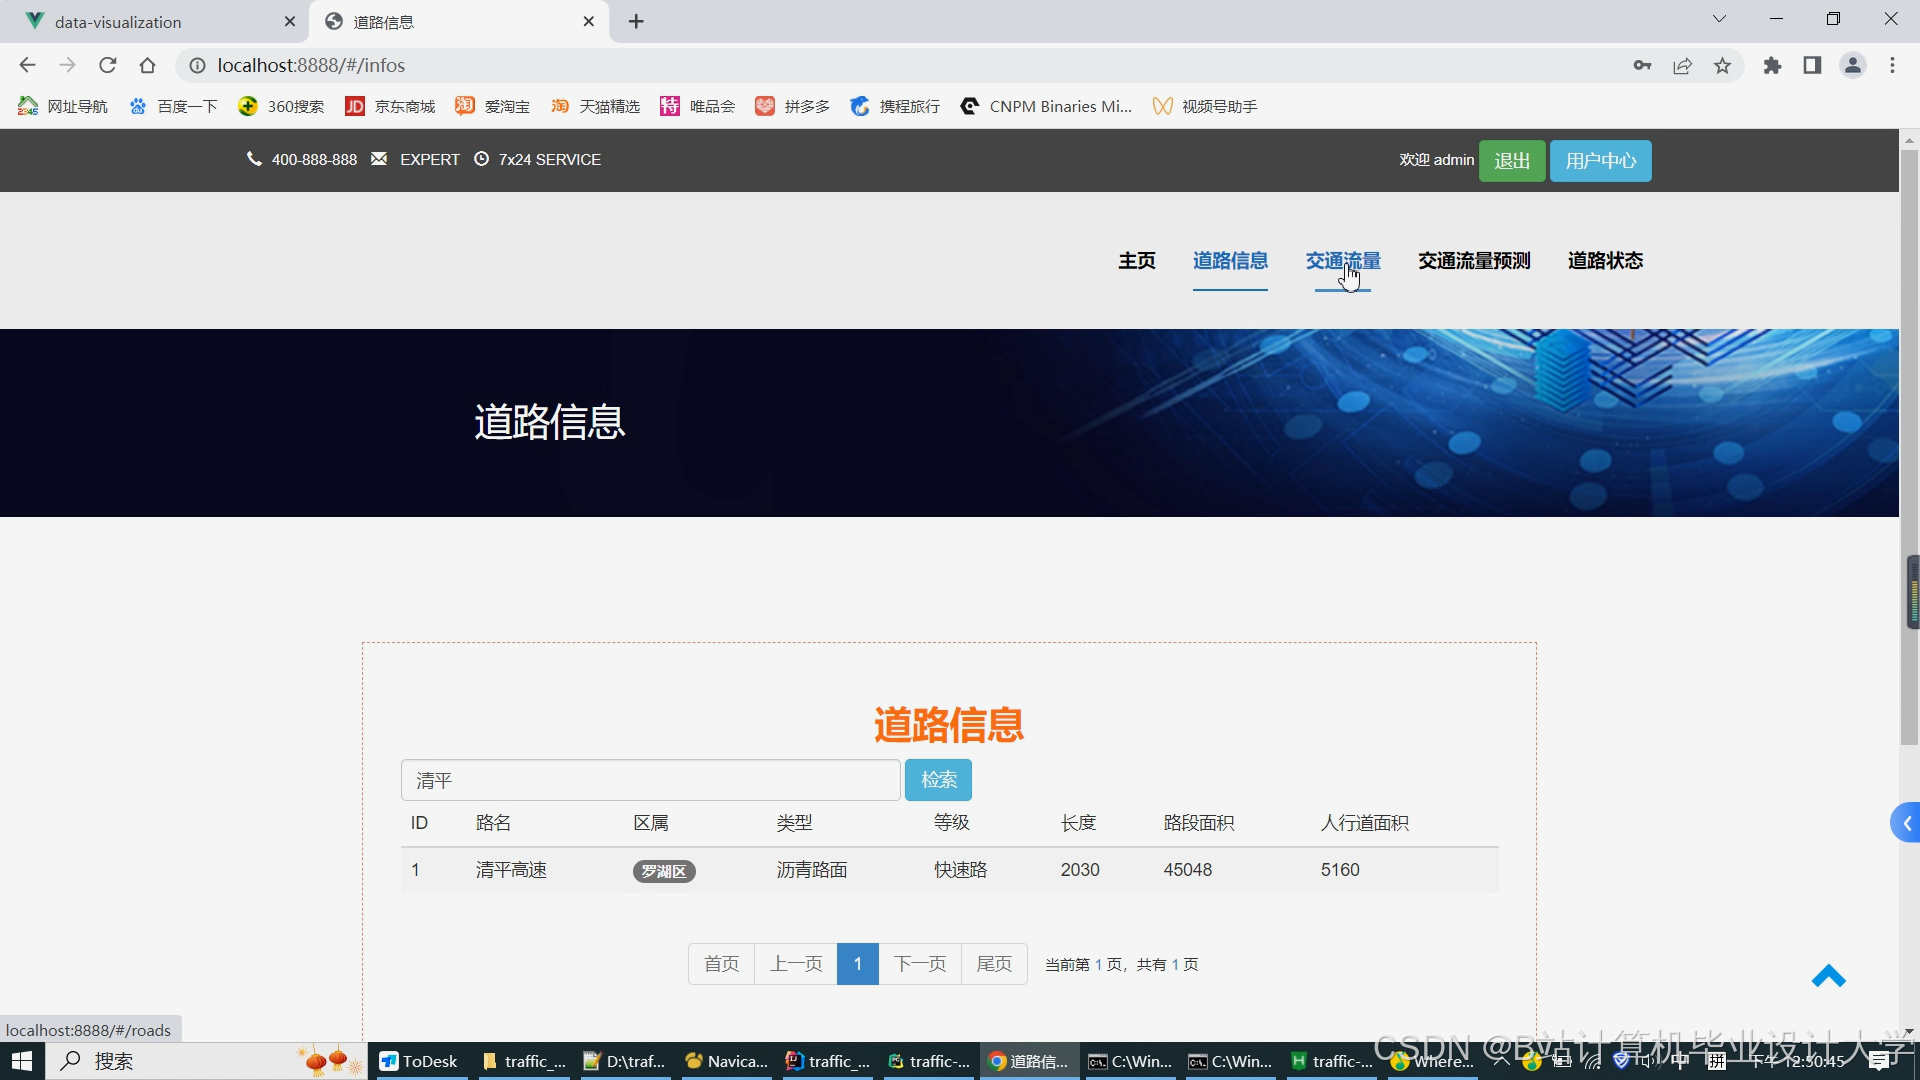
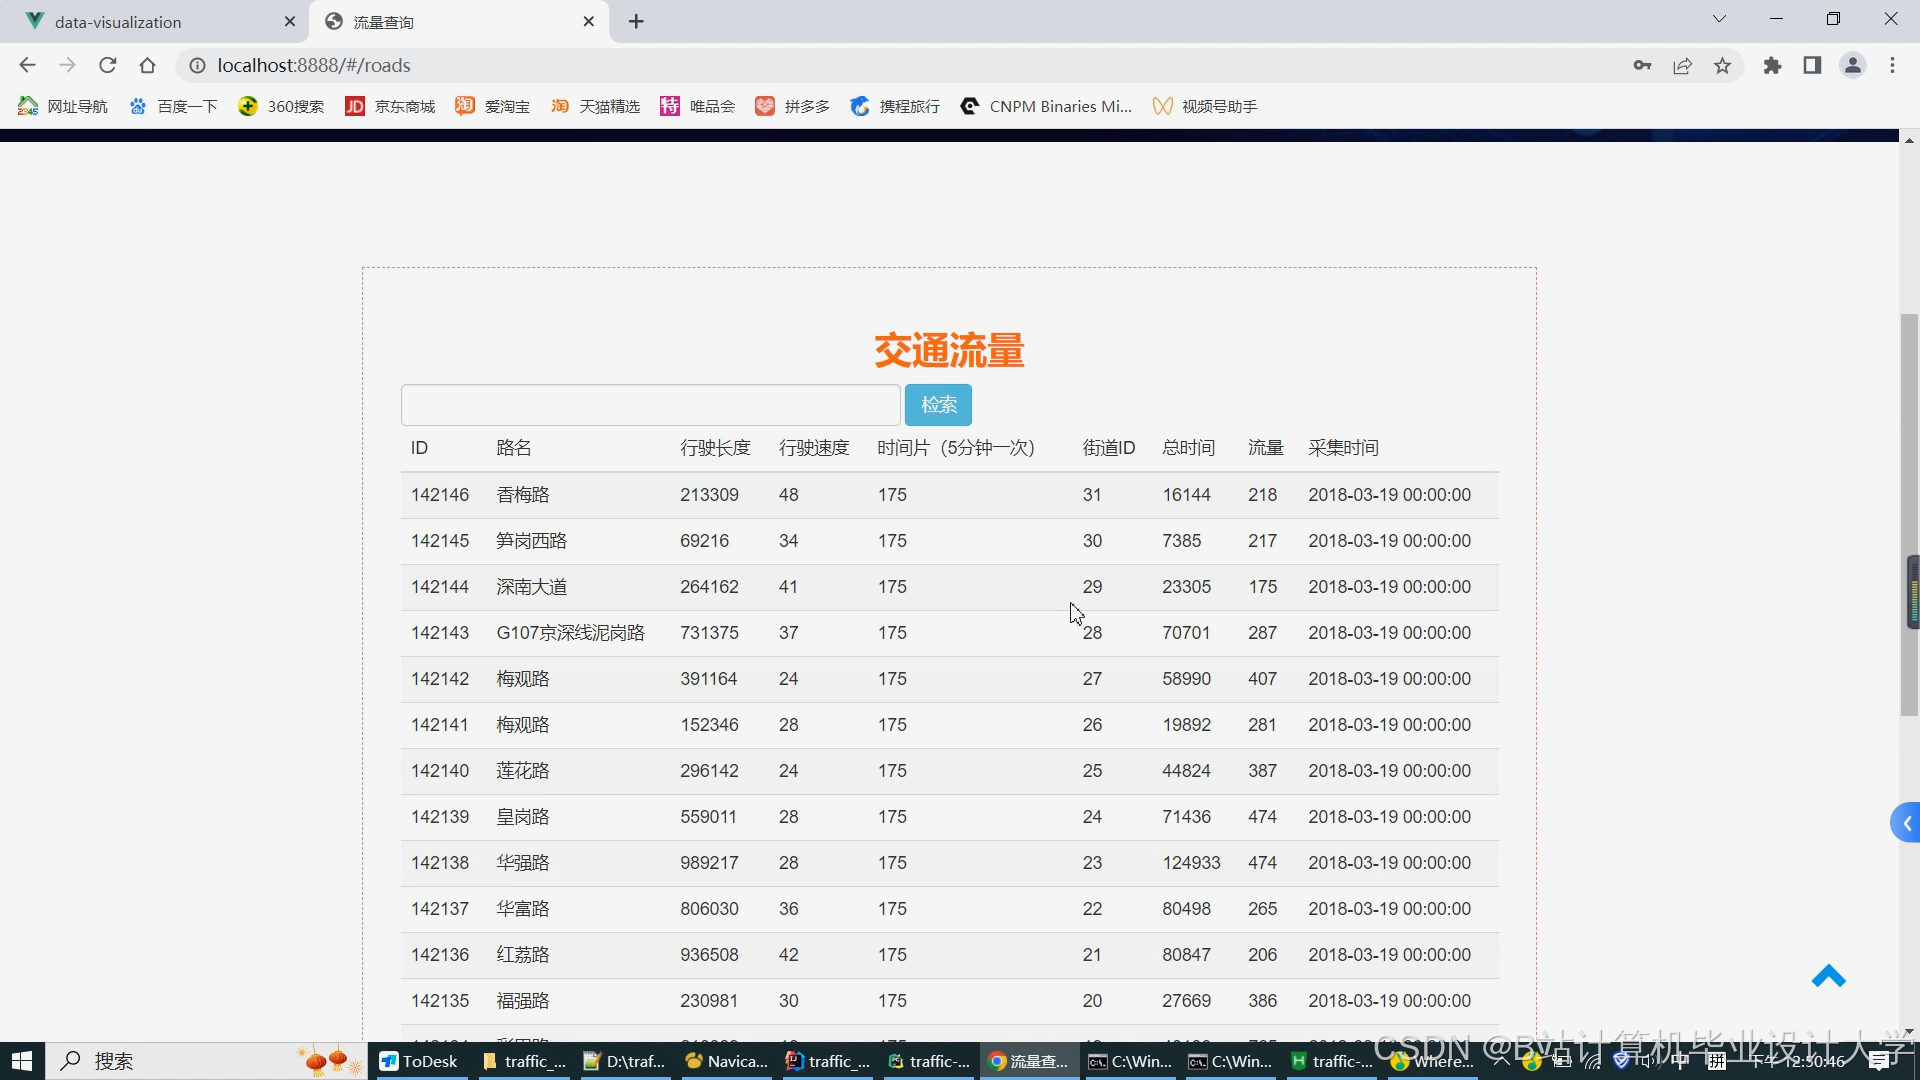
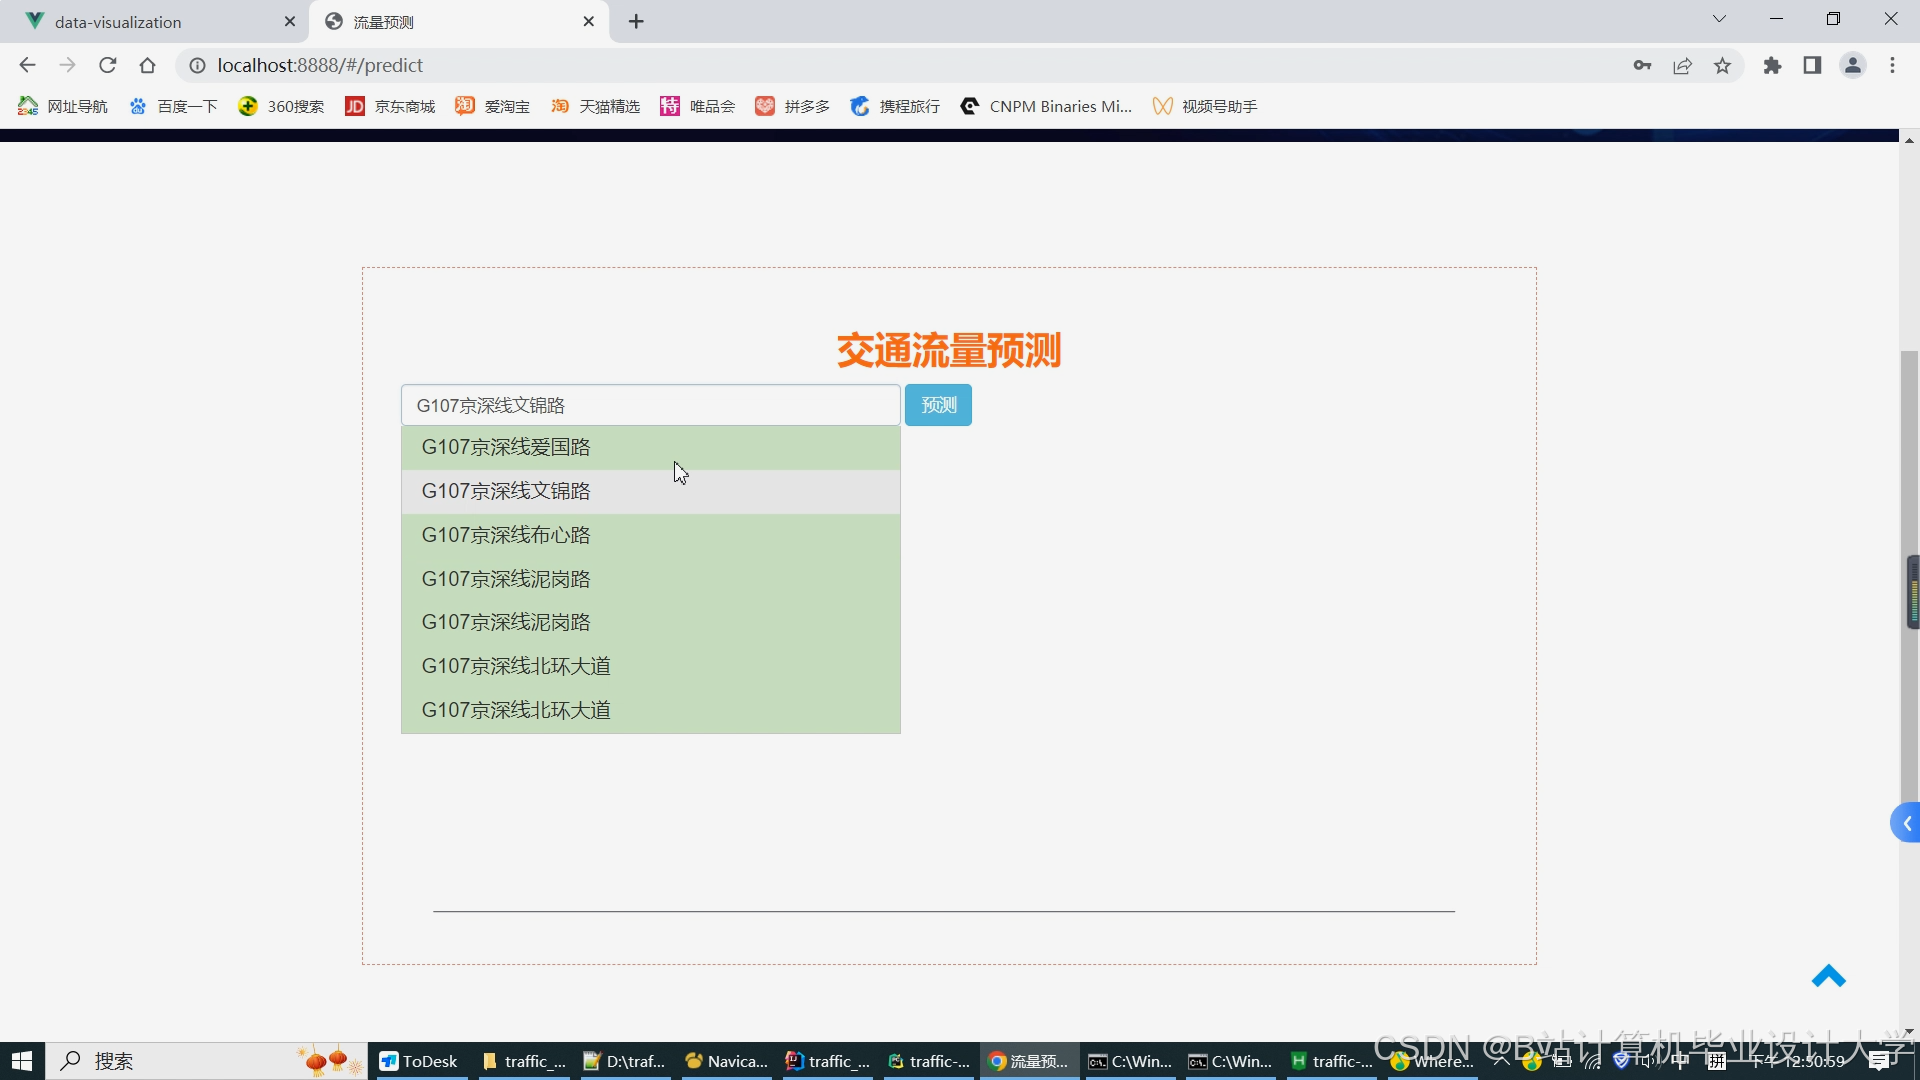
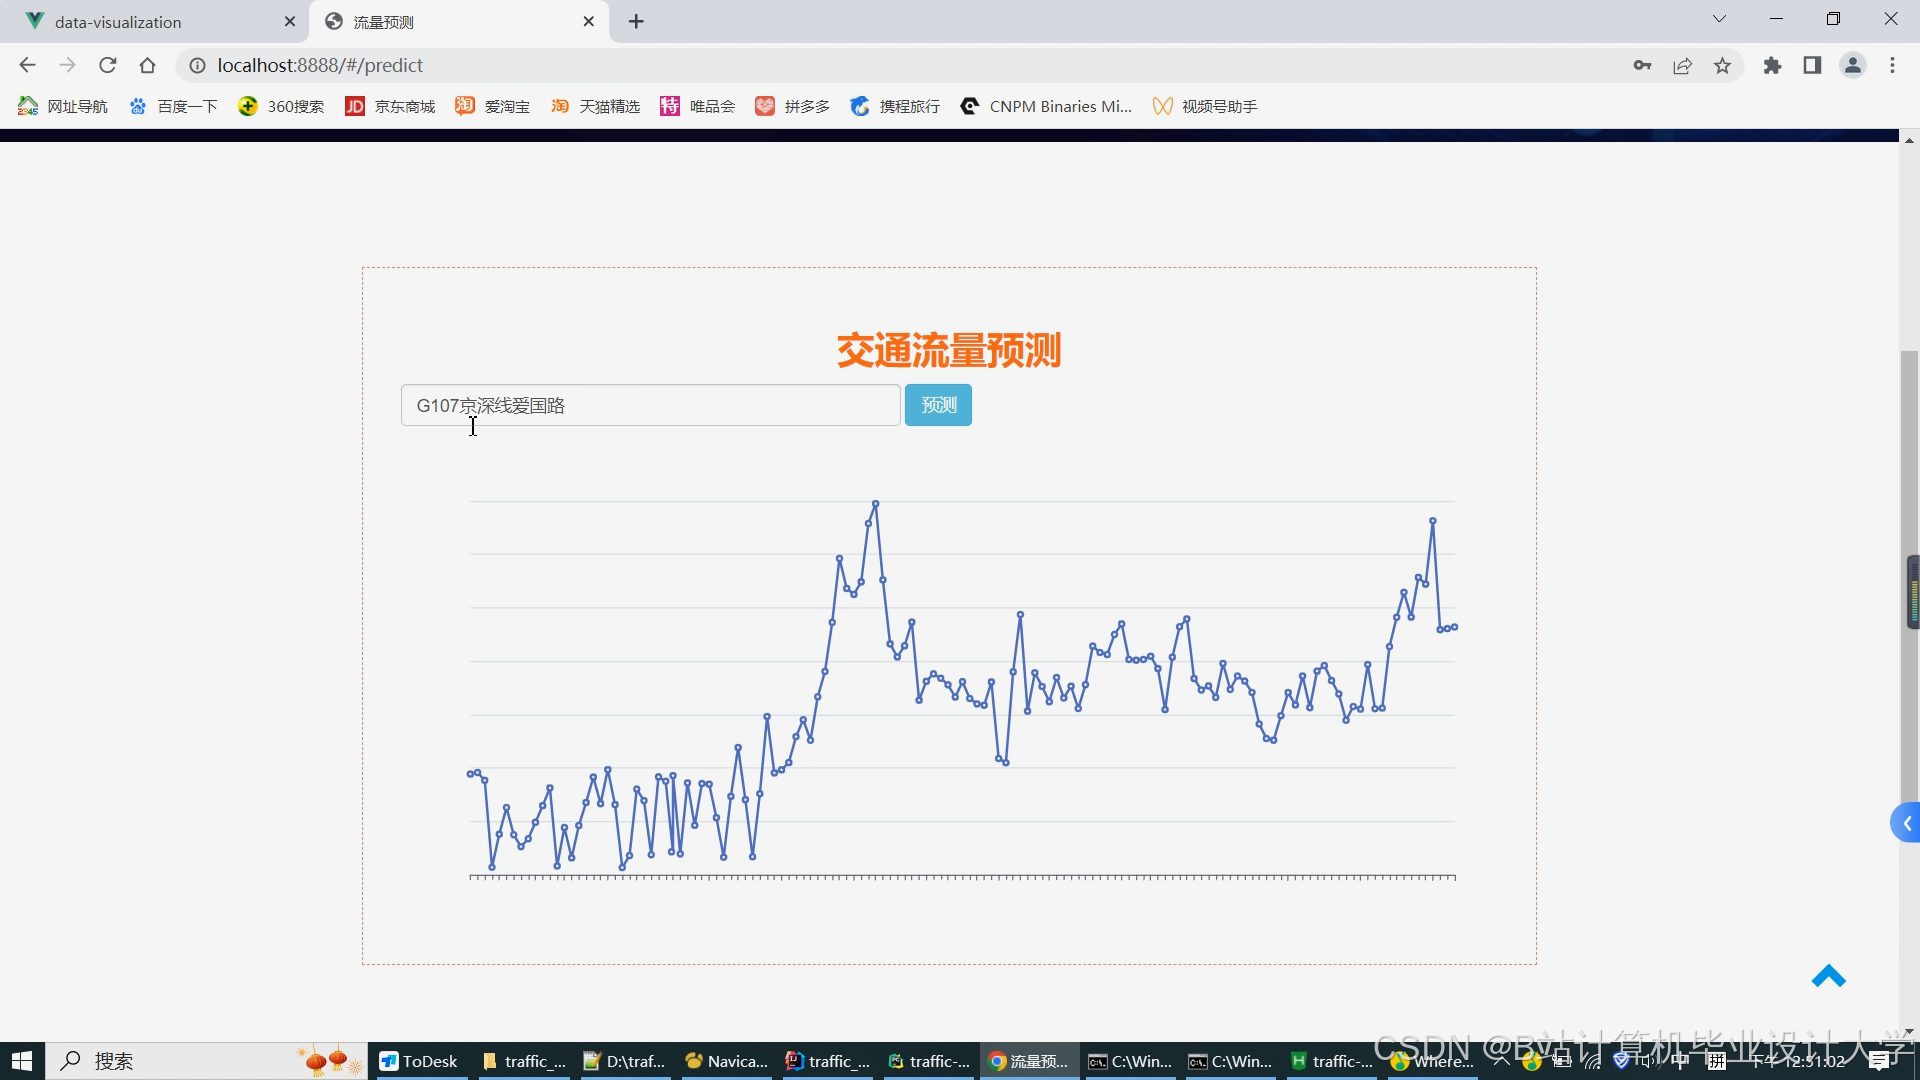
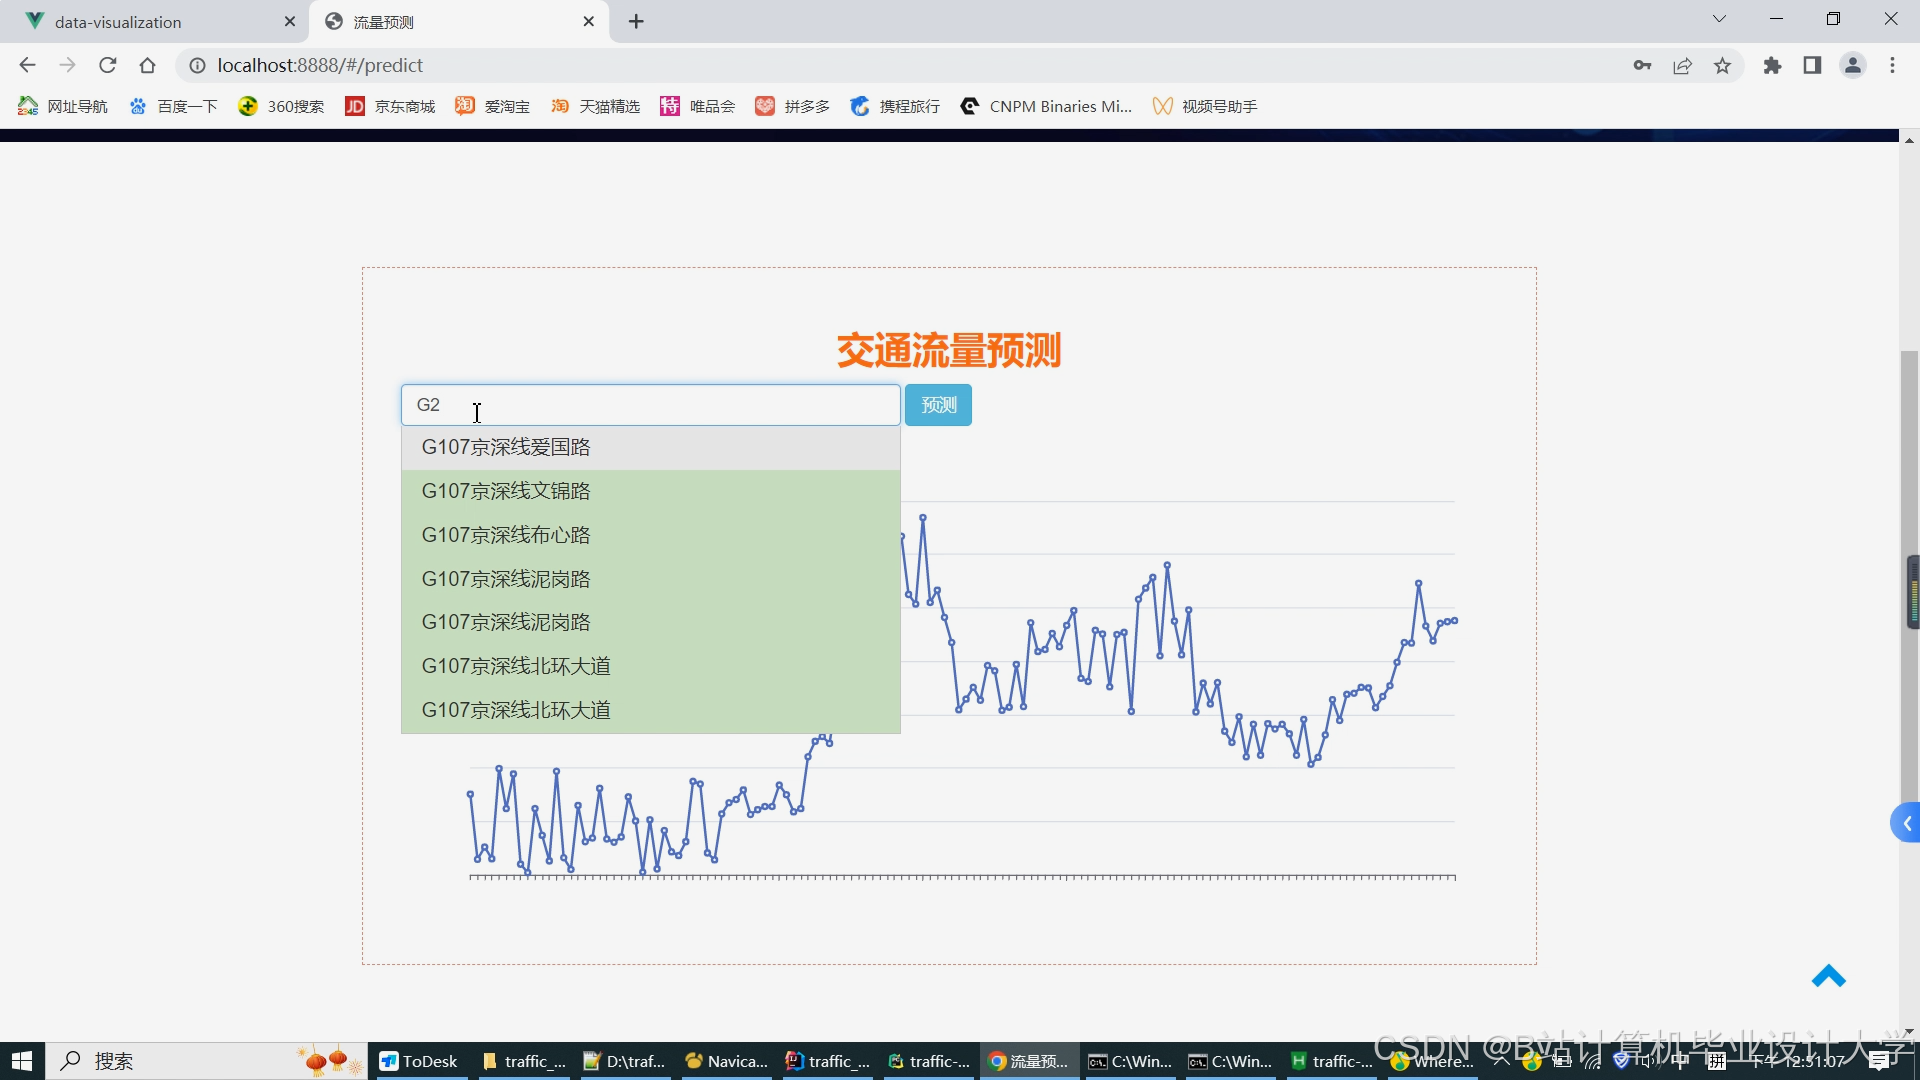
运行截图
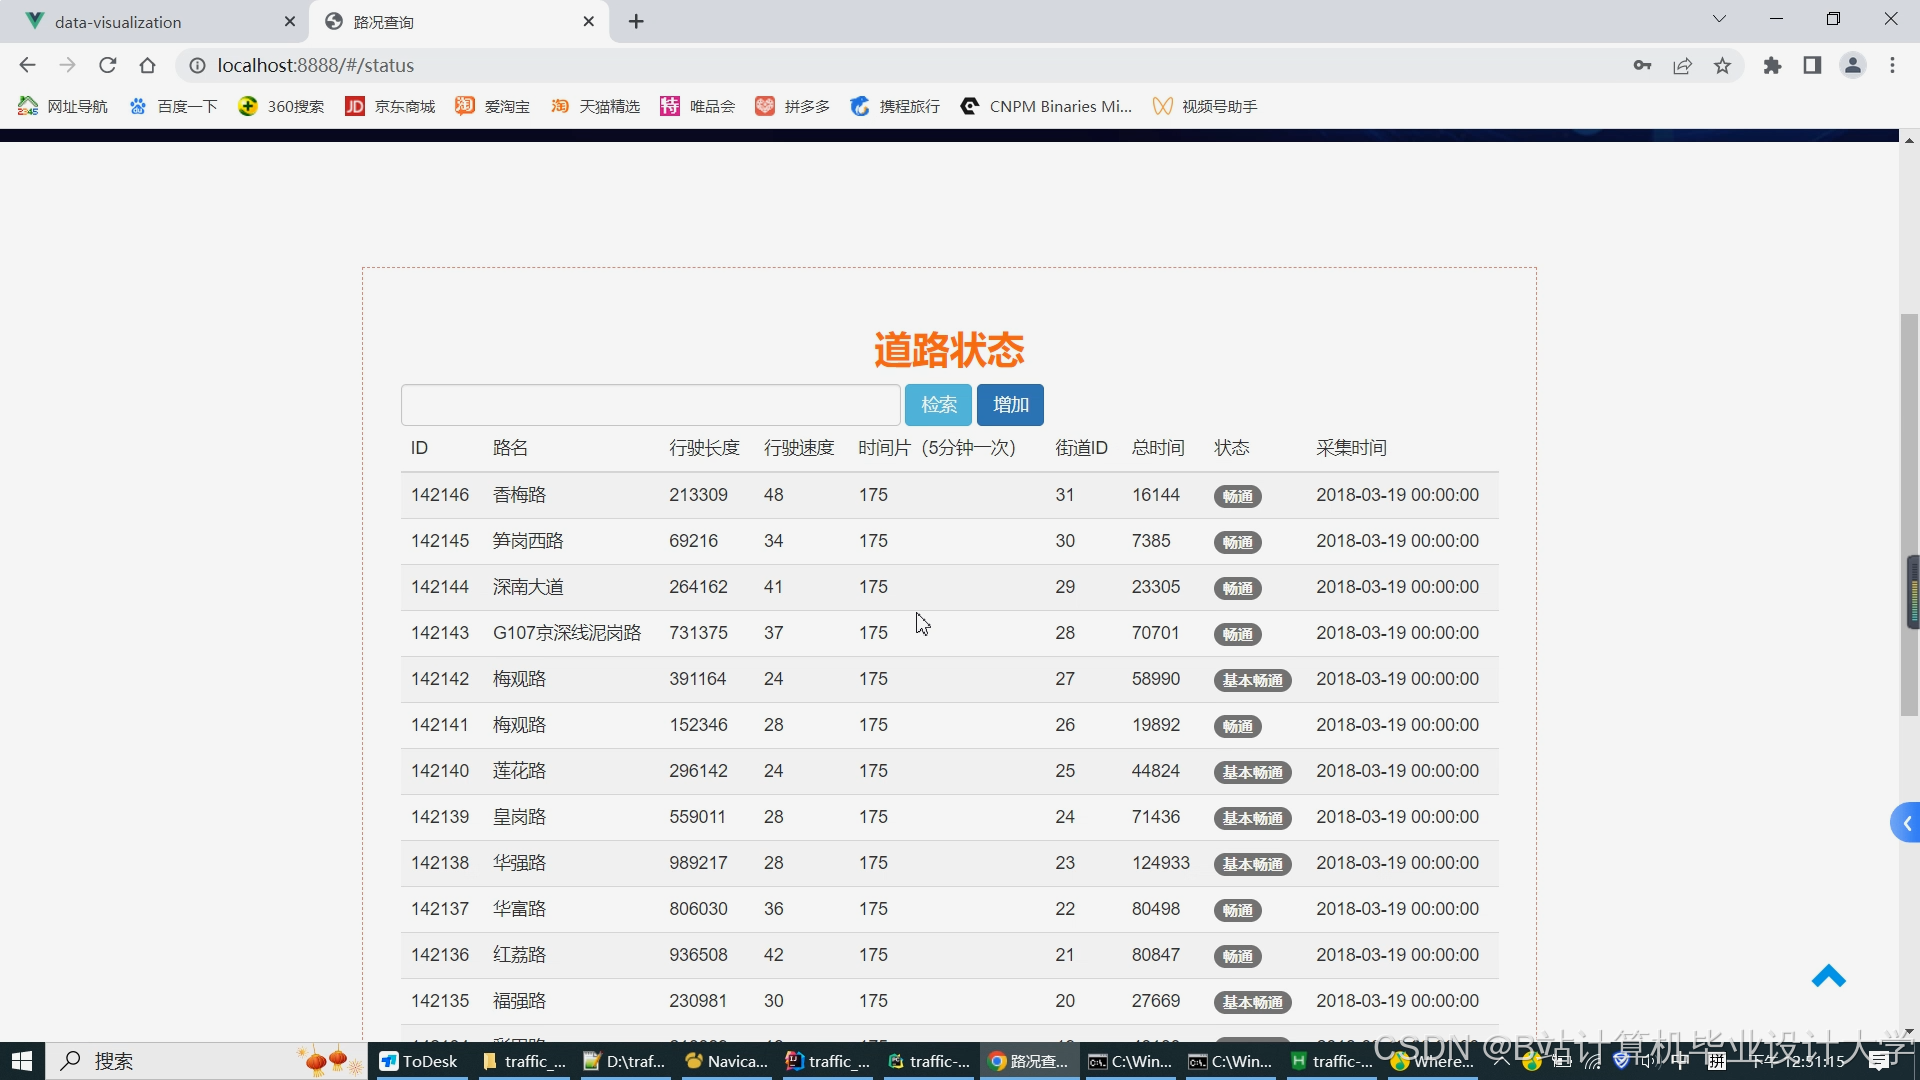
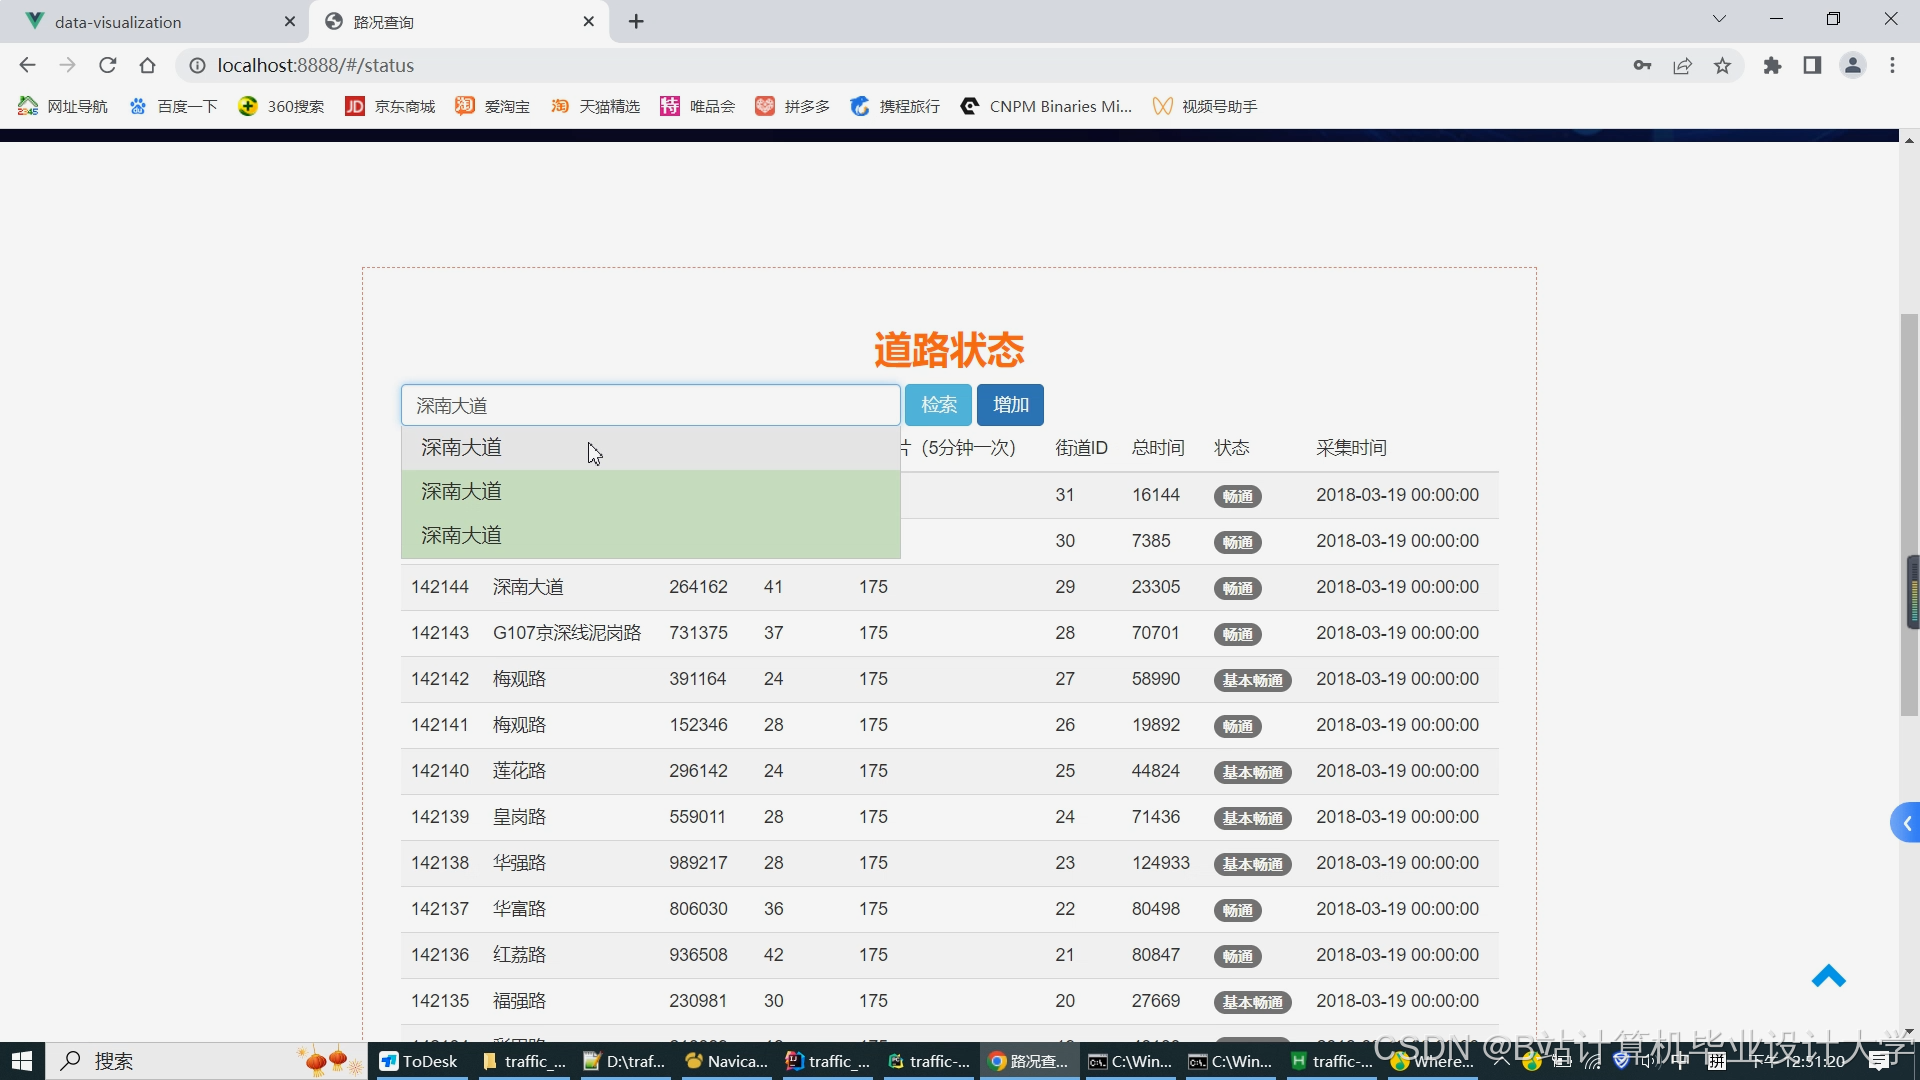
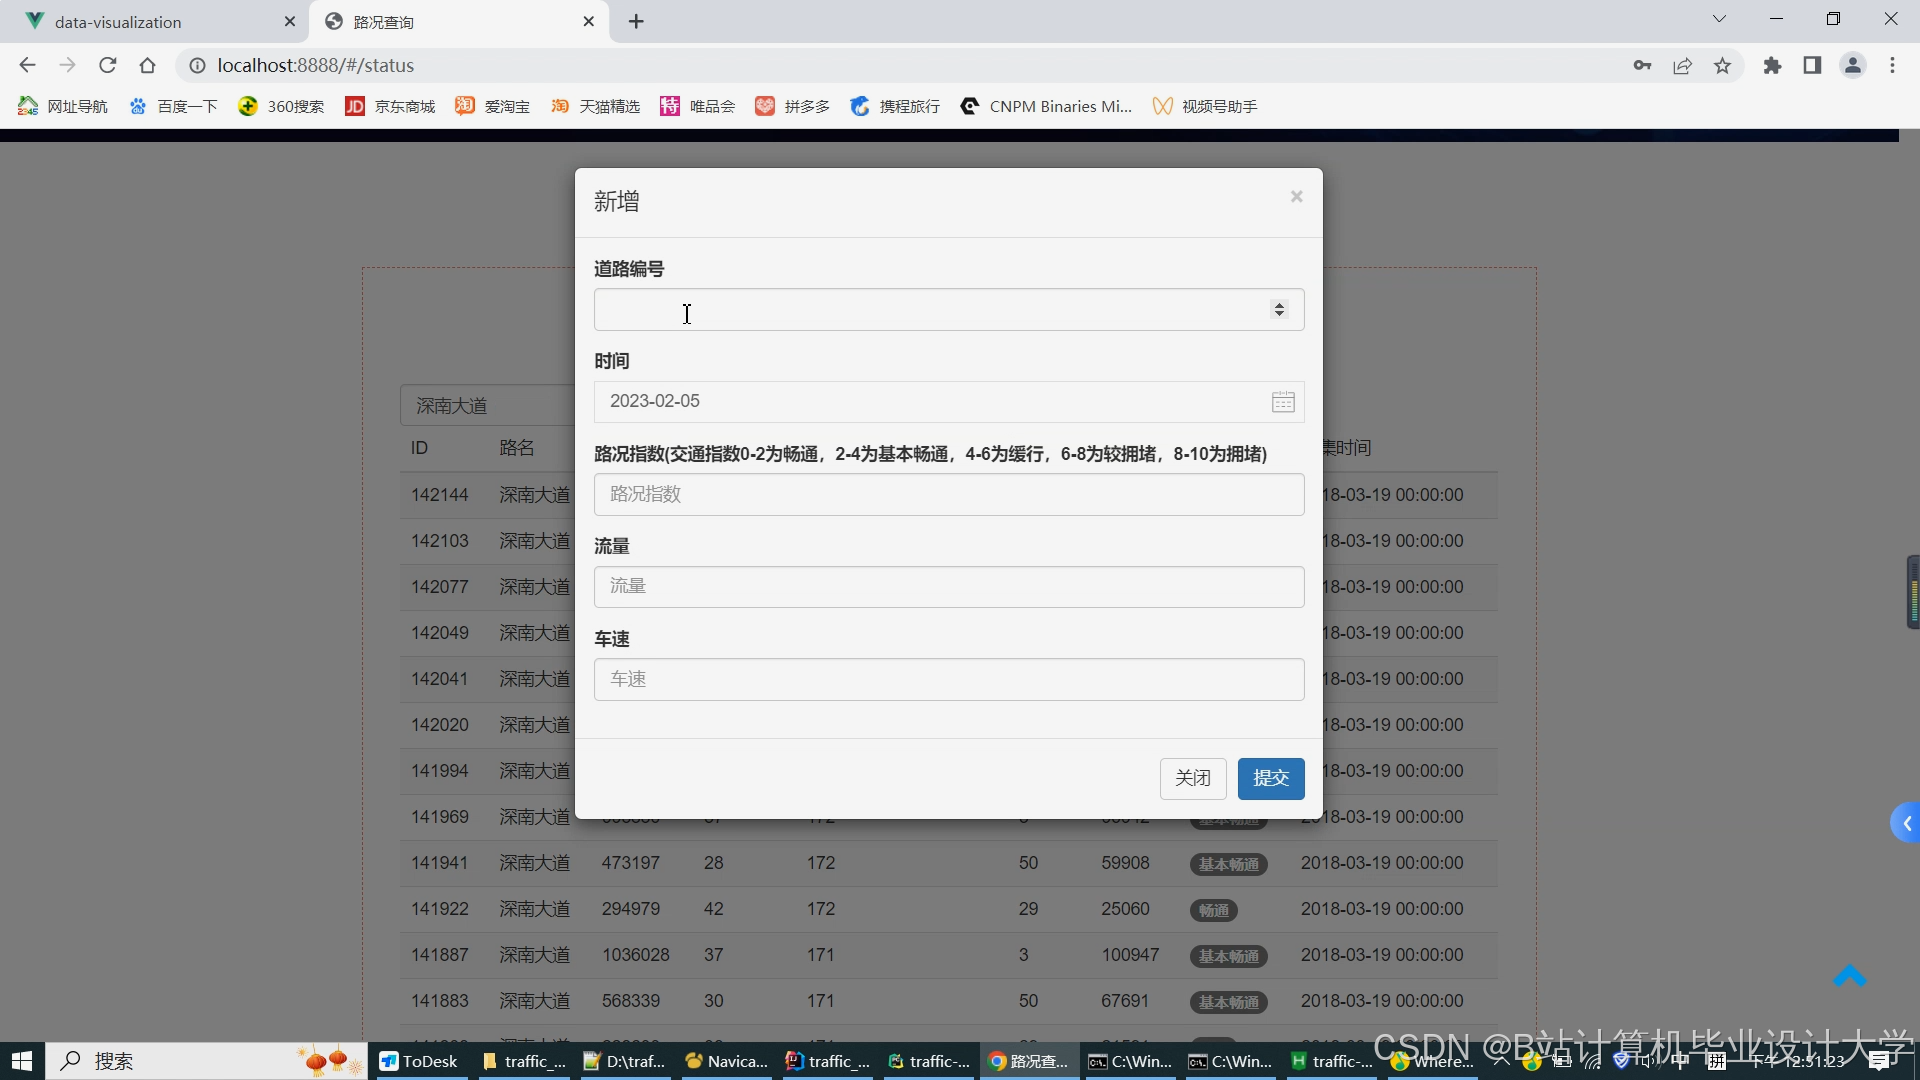
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
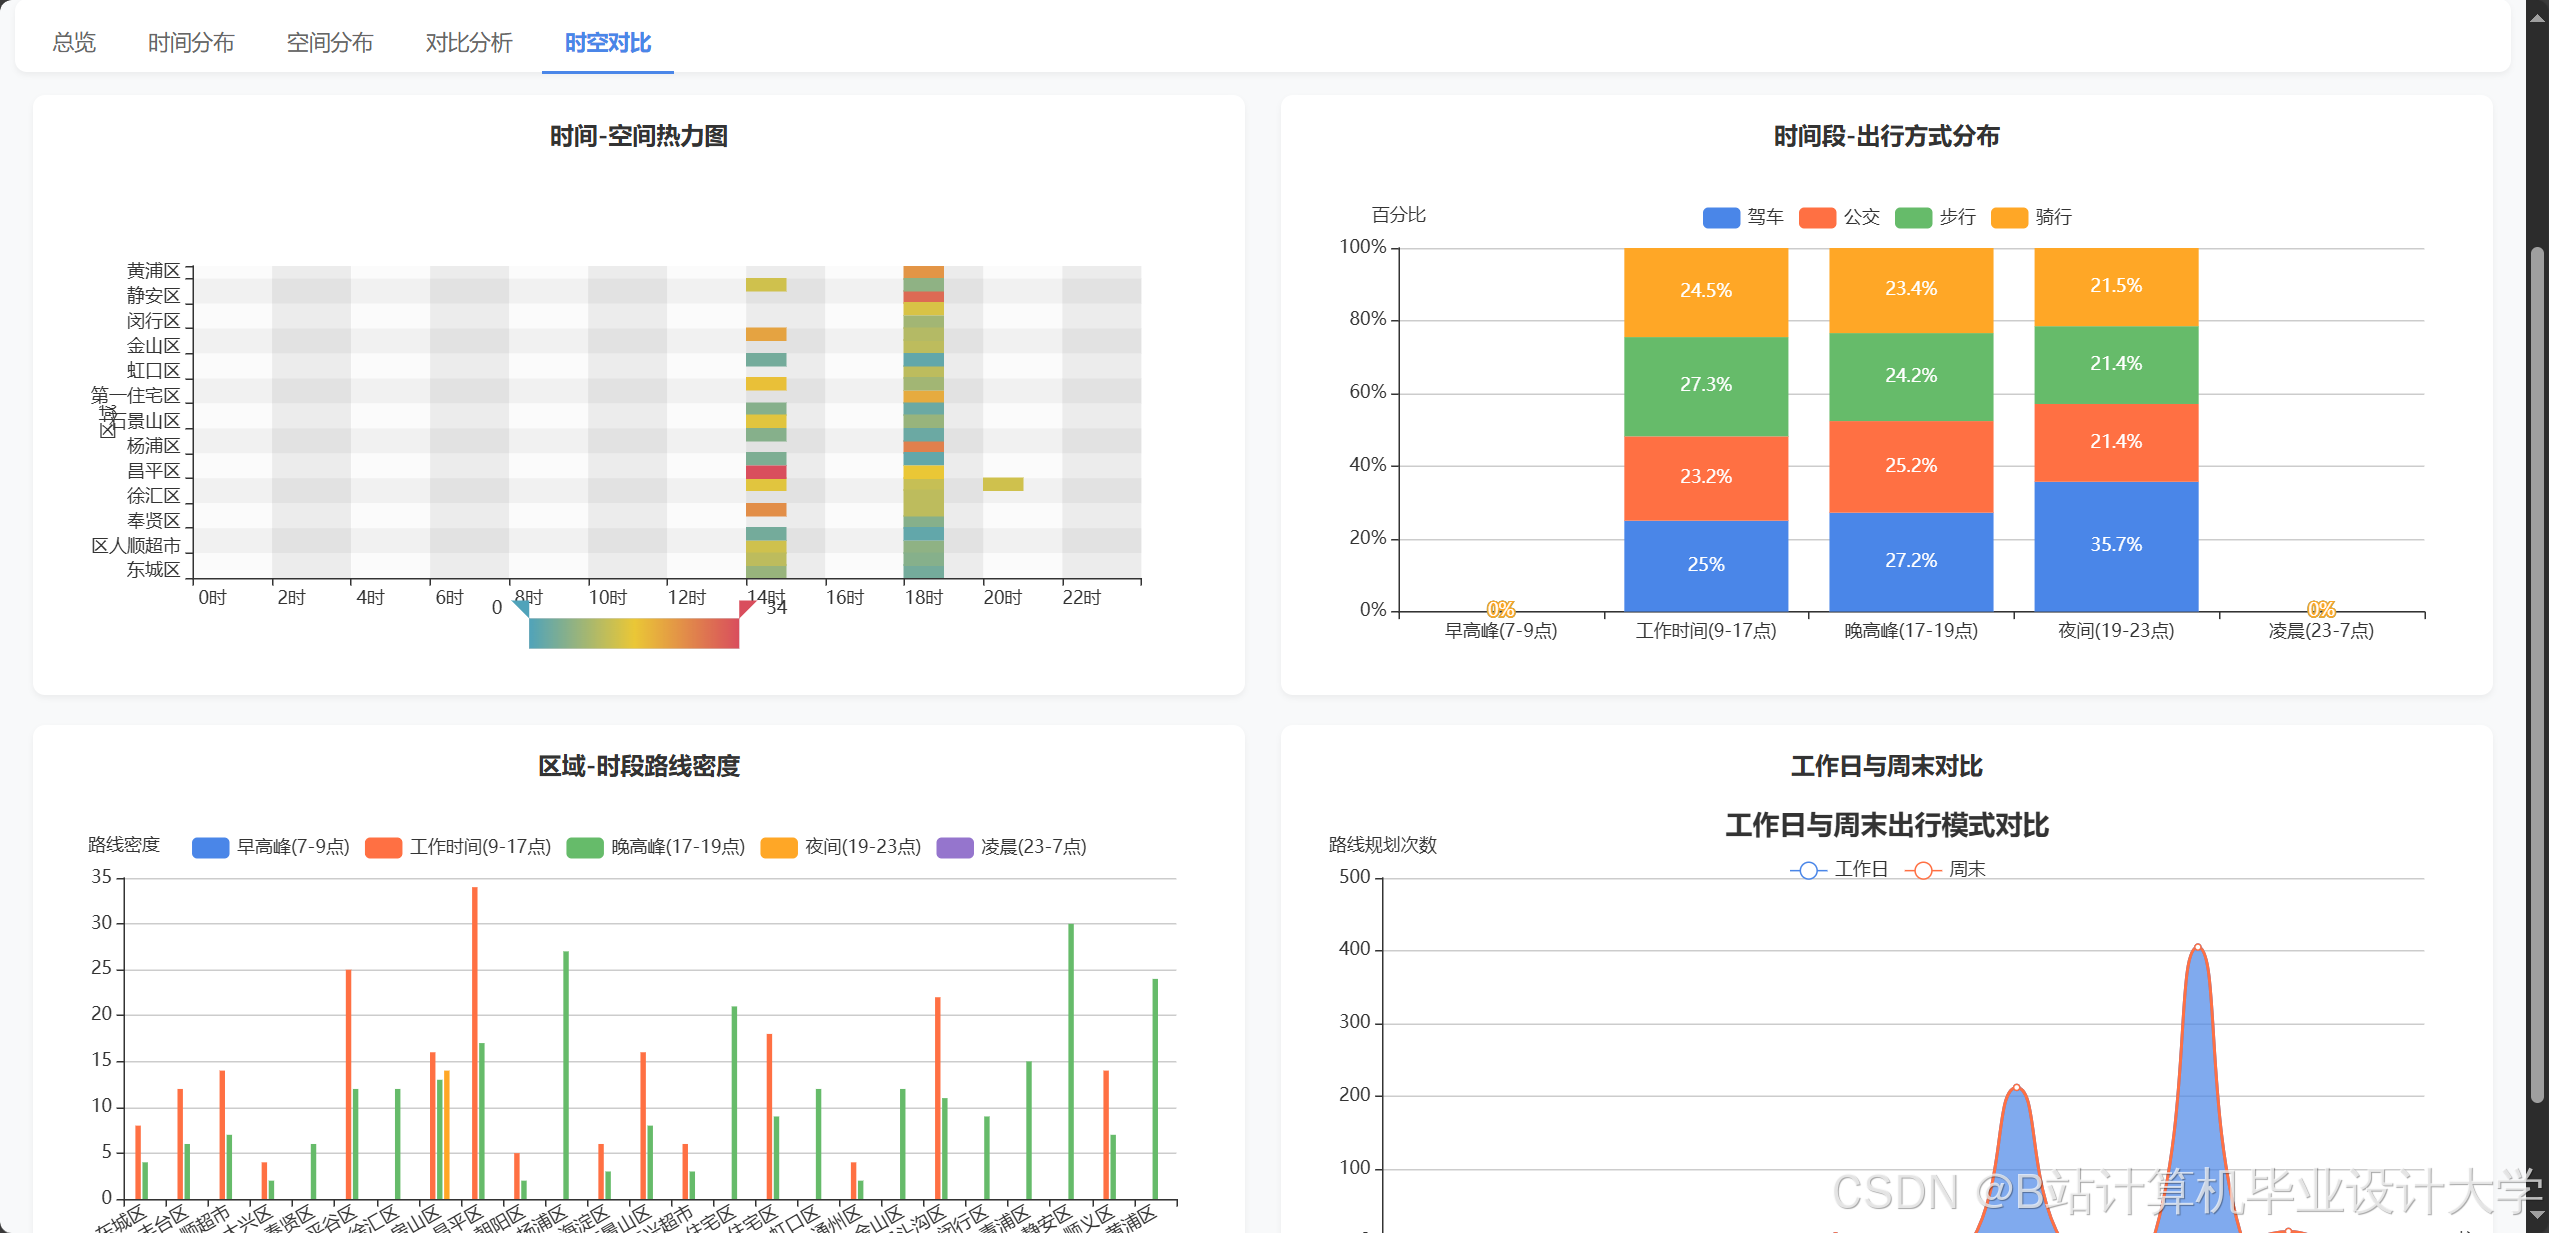
项目案例




优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓
更多推荐


 8
 0
- 0


 已为社区贡献610条内容

所有评论(0)