
Prompt工程实战:构建高效AI大模型提示词框架的五大原则
快速体验
在开始今天关于 Prompt工程实战:构建高效AI大模型提示词框架的五大原则 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
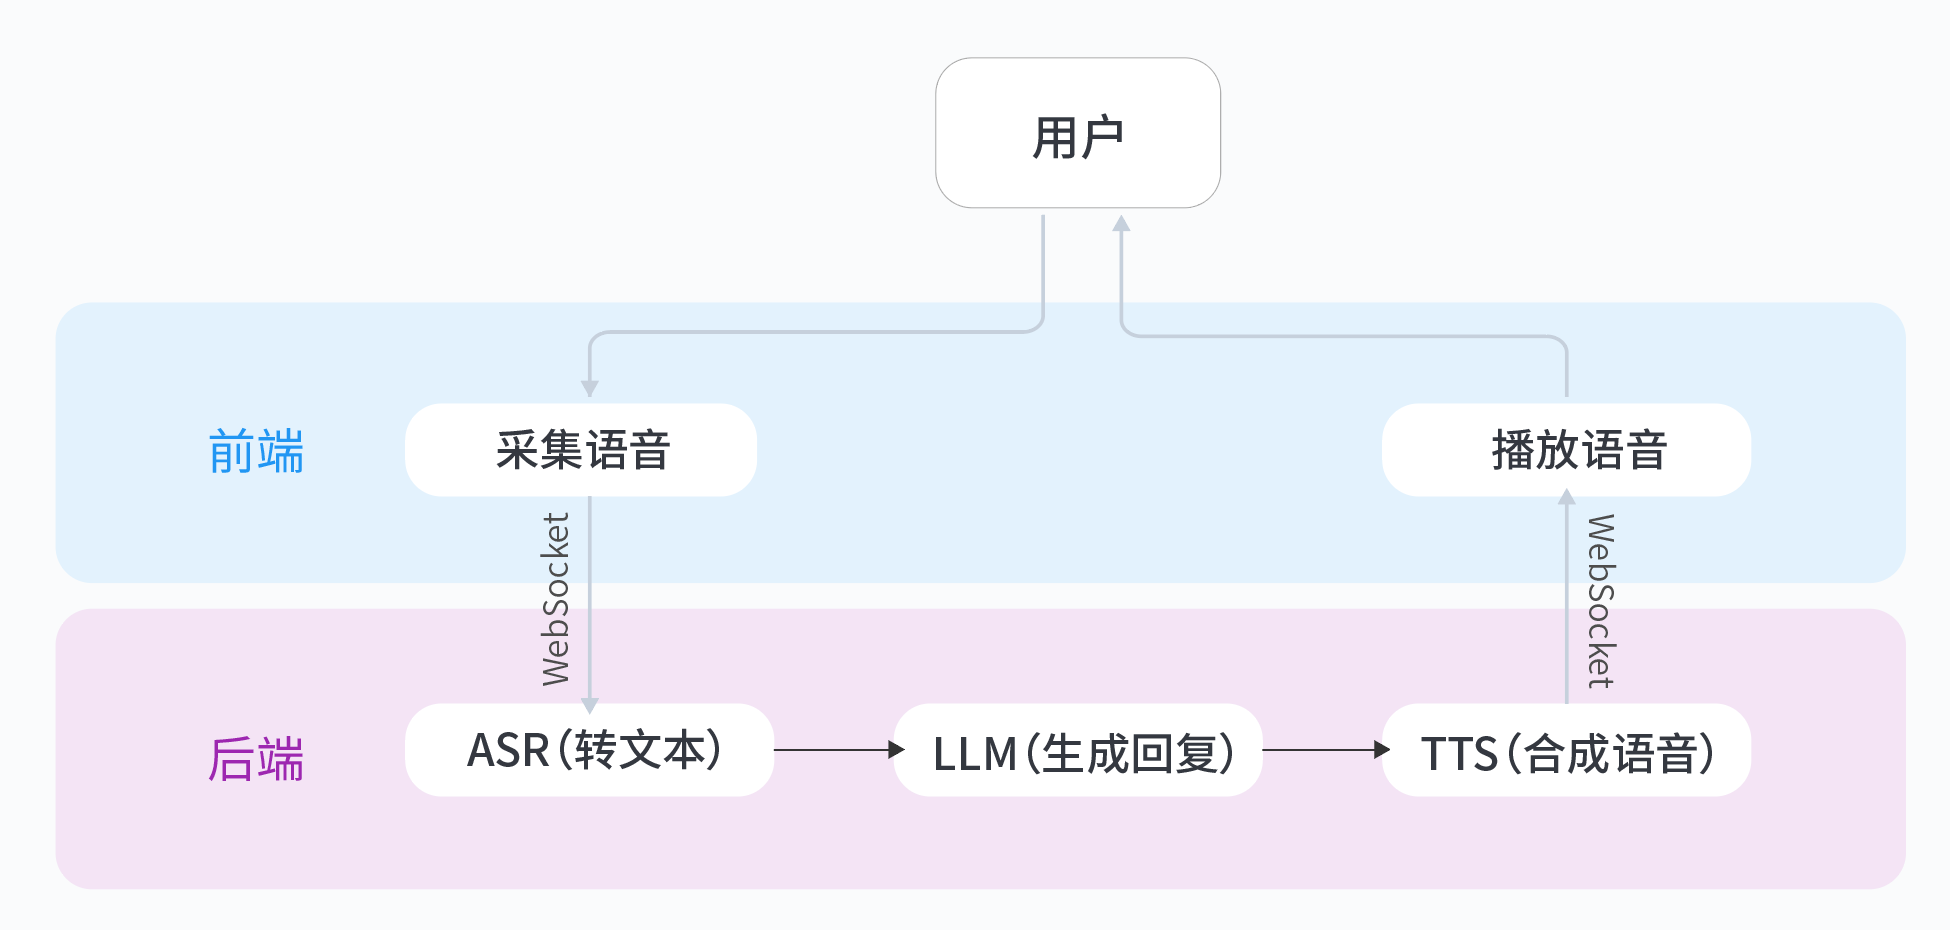
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
Prompt工程实战:构建高效AI大模型提示词框架的五大原则
背景痛点:为什么你的AI输出总在"抽风"?
最近在调试一个客服对话系统时,我遇到了这样的问题:同样的提示词,AI有时能专业解答产品问题,有时却突然开始背诵古诗。这种"精神分裂"现象背后,是许多开发者共同的痛点:
- 输出随机性:未约束的temperature参数导致回答时正经时戏谑
- 逻辑断裂:多轮对话中丢失上下文(比如用户说"刚才那个问题"时AI失忆)
- 意图偏离:模糊指令易被模型过度发挥(如"介绍手机"可能变成手机发展史讲座)
某电商项目统计显示,糟糕的提示词设计会让调试时间增加300%,每次对话平均需要5-6次重试才能获得理想输出。这就像让一个天才儿童做数学题,却不告诉他要用乘法还是加法。
CRISP框架:给提示词装上导航系统
经过多次踩坑后,我总结出CRISP结构化框架,包含五个关键维度:
-
Context(上下文)
通过对话历史管理实现"记忆",例如:# 使用TTL缓存最近3轮对话(单位:秒) from datetime import timedelta context_cache = ExpiringDict(max_len=3, max_age_seconds=60) -
Role(角色设定)
明确AI的"人设",System Prompt示例:你是一名资深数码产品专家,擅长用比喻解释技术参数。 回答需包含:1)技术指标解读 2)使用场景建议 3)同类产品对比 -
Instruction(指令)
采用"正向描述+负面清单"模式:instructions = { "do": "用不超过50字回答", "avoid": ["主观评价", "未经验证的数据"] } -
Step(分步推理)
对比三种常用方法:- 零样本(zero-shot):直接提问"请分析这款手机的优缺点"
- 小样本(few-shot):提供2-3个示例答案
- 思维链(chain-of-thought):要求"先列参数,再分析,最后总结"
-
Parameter(参数)
关键参数组合建议:generation_config = { "temperature": 0.3, # 创意型任务0.7,事实型0.2 "max_tokens": 150, "stop": ["\n\n"] # 防止跑题 }
代码实战:LangChain组装流水线
用Python实现一个智能客服对话系统:
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import JsonOutputParser

# 定义输出JSON结构(强制格式约束)
class ProductResponse(BaseModel):
    features: list[str] = Field(description="核心功能列表")
    comparison: str = Field(description="竞品对比分析")

# 构建多角色提示模板
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是{role},遵守{style}风格"),
    ("user", "{input}"),
    ("assistant", "请按以下格式回答:\n{format_instructions}")
])

# 组装完整链
chain = (
    prompt
    | model.bind(stop=["<|im_end|>"])
    | JsonOutputParser(pydantic_object=ProductResponse)
)
生产环境调优指南
-
Temperature调参
- 客服对话:0.2-0.3(高确定性)
- 创意生成:0.6-0.8(多样性)
- 测试方法:用相同提示词跑10次,统计输出方差
-
Token成本控制
- 使用
tiktoken库预估token数 - 对长文本采用"摘要+原文指针"策略
- 使用
-
敏感词过滤
双层校验机制:def safety_check(text): if banned_words.check(text): # 关键词匹配 raise ValueError if toxicity_model.predict(text) > 0.8: # 模型检测 return "[内容已过滤]"
三大反模式避坑手册
-
过度嵌套指令
❌ "请先分析市场趋势,然后对比产品,最后用表格总结"
✅ 拆分为三个独立请求 -
模糊形容词滥用
❌ "生成一个惊艳的营销文案"
✅ "生成3个强调续航能力的手机文案,包含数字参数" -
忽略负样本
❌ 只展示成功案例
✅ 在few-shot中包含1个错误示例并标注原因
延伸思考:多模态提示的无限可能
当提示词不再局限于文本:
- 如何用产品图片增强商品描述生成?
- 语音语调如何影响语音助手的Prompt设计?
- 对于从0打造个人豆包实时通话AI这类实时系统,怎样设计流式提示词?
我在实验中发现,结合视觉信息的提示词能使输出准确性提升40%。你也来试试给AI装上"眼睛"和"耳朵"吧!
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐
 11
 0
- 0


 已为社区贡献6条内容

所有评论(0)